登录社区云,与社区用户共同成长
邀请您加入社区
随着人工智能技术在电力行业的深入应用,行业智能化对 AI 计算性能、效率以及算力适配能力提出了更高要求。为推动 AI 技术与电力行业应用深度融合,本次大赛基于电力行业典型场景的实际需求设计赛题,组织开展昇腾行业算子开发与性能优化实践,探索高效、高质量的行业算力优化方案。赛事将联合产业伙伴,共同推动优秀成果开源、共享、应用,不断产生并积累实用算子、实际开发经验、优秀开发者,基于CANN开源社区电力S
B站预约链接:点击预约
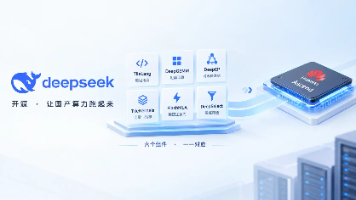
10 月上旬的公开信息里,有一条容易被当成软新闻:DeepSeek 在内蒙古乌兰察布规划建设大型数据中心,部署至少 16 万颗华为昇腾 950DT;同时把面向昇腾平台的整套基础设施组件开源:编译工具、计算库、分布式通信库,与面向英伟达平台的组件一一对应(来源:公开报道,多家中文科技媒体交叉核实)。
DeepSeek于2026年9月30日开源面向昇腾的六件套,官方称与英伟达组件“一一对应”,但对应仅在接口层,数据在内存中的布局仍需重新适配。其深层逻辑是生态套利:借TileLang把CUDA从默认地基变成可选项,同时与昇腾硬件代际深度绑定。99.8%等性能数字是限定芯片、软件版本和测试形状下的峰值,不能证明昇腾超越英伟达;竞争主战场转向机柜间通信,DeepEP成核心却未附许可证。六件套给的是工具
如果这个定位成立,那么 FlashMLA 与 FlashAttention 这类通用注意力实现的关系就不是替代关系:前者是面向特定模型结构的深度优化 kernel,后者覆盖更广的注意力变体集合。对迁移者的实际含义是:如果模型不用 MLA 结构,FlashMLA 的价值有限;如果用 MLA 结构,那么它是推理/训练路径上的关键 kernel,其正确性与数值行为需要单独验证,包括 softmax 缩放
依托昇腾与麒麟NPU同源的达芬奇(DaVinci)架构,以及CANN软件开发能力,开发者在昇腾上完成的部分模型适配与算子实现,可以继续沿用于麒麟端侧,在降低开发投入的同时,也有助于降低云侧推理成本。通过量化与裁剪,形成约0.6B的端侧版本模型,其核心计算模块及相关算子结构与云侧保持一致,面向昇腾的计算设计仍然适用,也为底层代码的端云共用创造了条件。昇腾与麒麟NPU均基于DaVinci架构,底层统一
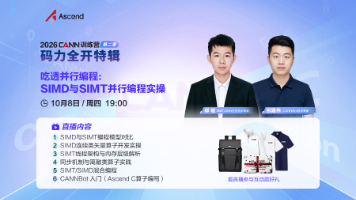
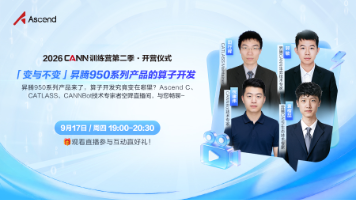
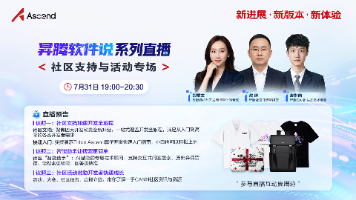
📲 关注【昇腾CANN】视频号,锁定最新直播信息,干货福利不错过!🎥 视频号、B站、昇腾社区多平台同步直播。🎁 戳链接参与互动,赢惊喜定制好礼。
近日,北京昇腾生态先锋中心在北京市门头沟区政府指导下,联合昇腾 CANN 开源社区、AtomGit AI 社区等,共同发起活动。门头沟区投促中心党组书记、主任杨帆、京西智谷董事长张鹏鹏、嘉环科技董事长宗琰、华为北京战略与业务发展部部长房思哲、华为昇腾生态发展部副部长陈海波等领导嘉宾共同参与本次活动。
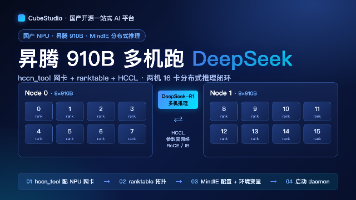
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾等国产算力,原生适配910B/310P NPU,实现DeepSeek等大模型的单机多卡与多机分布式推理。本文详解基于MindIE引擎的多机部署全流程:通过hccn_tool配置NPU参数面网络,生成ranktable.json拓扑文件,设置HCCL通信与环境变量(如RANK_TABLE_FILE、WORLD_SIZE),并结合C
定义LeNet模型华为的深度学习算法体系,以MindSpore框架为核心,以昇腾芯片为底座,以盘古大模型为标杆,构建了一个完整的国产AI技术栈。软硬协同:算法设计与芯片架构深度绑定,实现极致性能自动并行:大幅降低大规模分布式训练的门槛全栈自主:从芯片到框架再到模型,实现全链路自主可控展望未来,随着昇腾910B等新一代芯片的推出,以及盘古大模型向多模态、具身智能方向的演进,华为的深度学习算法将在更多
1、CANN整体技术架构与软件栈2、昇腾AI处理器计算核心概览3、主流算子开发编程语言对比4、 如何选择适合你的开发方式
本文按"算法演进 → 工程落地"的主线,系统梳理生成式推荐(Generative Recommendation, GR)这一方向的发展脉络。第一部分回顾传统级联推荐架构的系统性瓶颈;第二部分以 Meta GR(HSTU)和快手 OneRec 为代表,剖析两条主流的生成式推荐技术路线;第三部分聚焦工程落地,介绍 TorchRec 生态以及基于昇腾 NPU 打造的 RecSDK 框架,展示从算法到生产
本文以图像分类中的卷积算子优化为例。卷积运算是深度学习中最核心、最耗时的算子之一。在昇腾AI平台上,我们可以通过自定义算子(Custom Operator)的方式,针对特定场景优化卷积计算效率。输入:形状为的特征图卷积核:形状为输出:形状为"""昇腾TBE自定义卷积算子"""# 定义计算过程# 使用TVM表达式描述卷积计算# 卷积计算逻辑# ... 此处省略具体TVM表达式# 调度与编译# ...
在昇腾异构架构中,AI Core 计算单元只能直接读写片上 Local Memory,无法直接访问全局内存 GM。DataCopy:AscendC 提供的内存拷贝内置函数,负责在全局内存。
本实训围绕具身智能工业视觉与物联监护开展,完成工业相机环境搭建、昇腾终端部署,实现摄像头 OCR 文字识别;在华为云 IoTDA 创建温湿度计、吸顶灯产品模拟设备通信;借助 CodeArts 完成智慧路灯项目的构建与部署。
本文展示了工业视觉与物联网融合的全流程应用:基于昇腾Atlas200IDKA2开发板,结合工业相机取流、OCR文字识别(RapidOCR)与目标检测,实现工业场景下产品标签识别与目标实时分析;通过MobaXterm与MVS工具构建视觉环境,完成摄像头接入与数据处理。同时,在华为云IoTDA平台完成温湿度计、吸顶灯等设备建模与模拟数据上报,并借助CodeArts实现智慧路灯应用的快速构建、部署与远程
本实训开展具身智能工业视觉与物联监护综合演练,使用海康工业相机,基于 Python 实现实时 OCR 文字识别;熟悉昇腾边缘终端模型部署。借助华为云 IoTDA 完成物模型配置与 MQTT 设备调试,通过 CodeArts 完成智慧路灯项目构建部署,打通视觉‑AI‑物联网业务链路,提升工程实践调试能力。
【昇腾CANN】视频号、B站、昇腾社区多平台直播 ,观看直播,参与互动赢取惊喜定制礼品。扫码关注【昇腾CANN】视频号,掌握最新直播信息。
本文基于具身智能与工业视觉技术,实现基于PaddleOCR的中文OCR实时识别系统。通过构建Python虚拟环境、配置昇腾终端与网络摄像机,完成非CUDA环境下CPU推理的快速编码与运行。系统支持中文文字识别、结果可视化及图像保存,结合IoTDA平台完成温湿度计与吸顶灯设备的产品建模、实例化及数据交互,并在CodeArts上实现智慧路灯应用的构建与部署,形成从感知到应用的完整工业视觉解决方案。
👉 抢先解锁课前学习资源:2026昇腾CANN训练营-昇腾社区
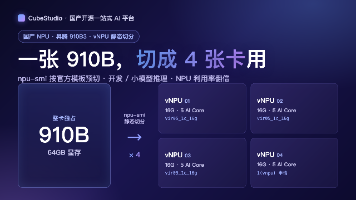
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾、寒武纪等国产算力,原生适配vNPU虚拟化。本文以昇腾910B3为例,详解通过npu-smi静态切分、device-plugin改造、K8s资源上报及PyTorch实测全流程,实现一卡多用,显著提升算力利用率。平台支持多租户、分布式训练与大模型微调,助力企业低成本高效部署AI应用。
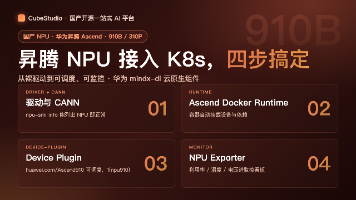
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾等国产异构算力,覆盖从数据到部署的全链路MLOps。本文详解昇腾硬件基础部署四步:驱动与CANN安装、Ascend Docker Runtime配置、K8s Device Plugin接入、NPU Exporter监控集成,实现昇腾卡在Kubernetes中可调度、可监控。后续将深入vNPU虚拟化与大模型分布式推理。平台开源免费
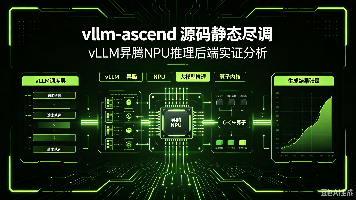
基于 vllm-ascend 固定源码快照开展静态实证工程审计。仓库采用 Python+C/C++ 混合架构,作为 vLLM 适配昇腾硬件的推理后端。本文分层拆解调度层、csrc 算子内核、测试与 CI 工程体系,四维治理评估工程完备度,重点分析 CANN 版本绑定、内核调试门槛等国产算力落地特有风险,为昇腾集群部署 vLLM 推理引擎提供可复现的源码尽调方案。
全新昇腾950系列课程上线,免费算力、多重好礼等你拿!📅 活动时间:即日起至2027年1月11日。
该命令用于启动一个具备NPU加速能力的Docker容器,通过--privileged和--device参数授权访问华为昇腾NPU设备(如davinci0~7、manager等),挂载驱动、工具及配置文件,并映射宿主机目录至容器内,适用于AI推理或训练场景。
实用工具包MindCluster ToolBox中包括Ascend DMI工具、日志收集工具和Ascend Cert工具。Ascend DMI工具主要为Atlas产品的标卡、板卡及模组类产品提供带宽测试、算力测试、功耗测试等功能。日志收集工具主要在故障分析定位时收集运行环境信息、昇腾NPU健康信息、昇腾软件日志、Device的系统级日志和MindEdge、MindSDK日志。
开源贡献这件事的门槛,从来都不在技术深度,看文档、逛论坛、加群潜水,这些动作对开发者来说都不难。难的是真正动手那一刻而流程经验,恰恰是最没法靠「看」学会的——你必须。能不能把「贡献 CANN」这件事,从一句口号,变成一次当场上手的实操?——于是,有了这场工坊。
MoE Dispatch,也就是把 token 送给不同专家的过程,则改成一个 token 只读取、只量化一次,再发给多个专家,分发延迟下降 25% 到 30%,端到端最多改善约 5%。除了已经上线的模型权重、基础推理代码和技术报告,Ascend Tribe 当前还能看到 ascend-training-system、openPangu-2.0-Infer、openPangu-2.0-Op、asc
低比特量化是降低大语言模型推理成本和资源需求的重要手段。随着部署场景对显存占用、带宽压力和计算效率提出更高要求,量化研究正逐渐从 8-bit 进一步推进到 4-bit。HiFloat4(HiF4)是昇腾自研的一种 4-bit 数值格式,通过三级缩放机制显著扩展了低精度数值的动态范围,使其更适配大模型权重和激活中常见的动态范围分布。将高精度权重直接转化为 4 比特格式通常会带来量化误差。因此,量化校
下面这张图可以支撑:HiF8和MXFP8在KV cache上均能保持较高量化保真度,KV cache不是HiF8相比MXFP8的主要精度风险来源,在KV cache SQNR上,未观察到HiF8相比 MXFP8的系统性退化,两种格式整体稳定在相近水平。该结果表明,HiF8在KV cache量化中未引入额外的小值置零风险,并可能相比MXFP8更好地保留低幅值cache信息,HiF8在KV cache
大模型量化是推理优化的关键能力之一。通过降低权重和激活的数值精度,量化可以减少模型存储、显存占用和计算开销,是大模型在实际业务中高效部署的重要手段。AMCT 是 CANN 社区提供的模型压缩与量化工具,面向昇腾 AI 处理器支持 LLM 模型高效量化,覆盖 BF16 基线评估、PTQ 离线数据提取、PTQ 参数训练、fake quant 精度评估等典型流程。本文与配套使用,提供一份可参考、可跑通的
鲲鹏920 + 昇腾910B×6 本地部署 Qwen3.8-Flash-Next 完整实录:从显存账目一步步推演出为什么只能选 W8A8 + TP4,到 msmodelslim 量化转换的逐参数讲解、vllm-ascend 启动脚本每个 flag 的人话翻译,再到 MTP 加速开关验证、大海捞针针测和并发上限实测定律。附常见故障速查表与扩展路线(第5-6卡副实例 / 内存 prefix 池)。零基
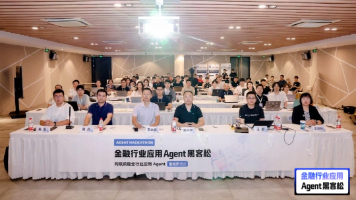
8 月 23 日,北京中关村创业大街 12 号,二十支参赛队伍、六位专业评审、五个小时赛程 —— 金融行业应用 Agent 黑客松总决赛路演在此落下帷幕。金融或许是 AI 最难啃、也最值得啃的行业之一。这是昇腾(Ascend)携手 AtomGit AI 社区创办本次赛事的初衷,也是贯穿整个赛季的“考纲”。
昇腾算力适配不是装个驱动就完事。本文按真实项目节奏拆解完整流程:环境准备、模型迁移、算子适配、性能调优、验收交付,每阶段给关键动作与常见坑。
昇腾、鲲鹏、海光、沐曦这些国产芯片,纸面算力已经相当能打,但业务软件跑上去时问题才暴露:算法库不兼容、框架版本对不上、算子缺失、性能调优没人做。- 软件栈适配:操作系统、编译器、运行时、算法库(BLAS、FFT、OpenCV)在国产架构上重新构建或替换。- 团队有遥感影像处理在鲲鹏+昇腾架构上的实战适配经验(遥感影像超分算法适配实践,CSDN 可查)- 提供遥感算力、昇腾遥感算力、遥感智能解译平台
是面向生命科学领域、负责建设昇腾原生算子库的开源兴趣小组,算子仓为bio-ops-molecule。SIG聚焦多组学数据处理、生物分子模拟和生物基础模型训练等场景,通过高性能行业算子解决计算效率、显存占用和数据访存等底层性能瓶颈。面向高校学生同时启动5大赛区:京津冀东北赛区、上合赛区、西北赛区、西南赛区、杭厦赛区,荣誉证书 +秋招机考面试绿卡+丰厚奖金 欢迎广大学生报名参加!CANN社区新开发者首
AI Studio则为同算力级别的算力盒,通过Type-C(USB4)接口连接台式机或笔记本使用,深度适配DeepSeek-R1蒸馏模型,支持本地离线部署,适合已有主机的用户扩展AI推理能力。对于依赖特定CUDA生态的项目,迁移成本需要纳入考量。总体而言,香橙派这一系列产品的价值在于提供了覆盖多场景的国产化AI算力硬件选择,特别是在边缘部署需求上升和AI应用多样化的背景下,为开发者提供了从原型到部
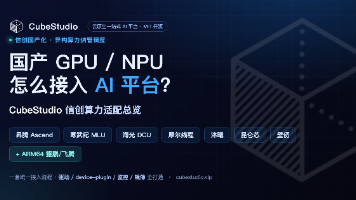
摘要: CubeStudio是一款国产开源AI平台,支持传统机器学习、深度学习与大模型全流程,适配昇腾、寒武纪等国产算力及x86/ARM架构,提供多租户管理、分布式训练、大模型微调、推理服务等功能。平台标准化国产算力接入流程,覆盖驱动安装、容器运行时、K8s插件等八步操作,并支持ARM64部署。针对信创需求,提供昇腾、海光等七家国产卡的落地文档,支持异构算力统一调度。开源免费商用,已服务数千家企业
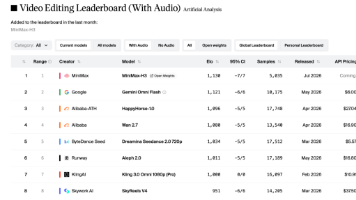
2026年8月3日,MiniMax新一代多模态生成模型MiniMax H3正式开源,在Artificial Analysis视频模型榜单中,视频编辑能力排名全球第一。作为MiniMax从“特化任务模型”迈向“通用多模态智能”的重要探索,H3不再以图片、视频、声音的生成、编辑和参考等单一任务为边界,而是在多模态上下文中统一理解创作意图,完成更加自然、连贯的生成与表达。
本文介绍了在鲲鹏920服务器(aarch64架构)和昇腾310P3 NPU卡上部署DeepSeek-R1-Distill-Qwen-1.5B大模型的两种方案。物理机部署需安装PyTorch 2.7.1、torch_npu插件、vLLM及vllm-ascend组件,通过指定参数启动服务。容器化部署推荐使用预置Docker镜像,需挂载NPU驱动和模型目录,并配置特权模式与设备映射。两种方案均提供了服务
本文档详细介绍了在鲲鹏920服务器(aarch64)上安装昇腾310P NPU驱动的完整流程。环境配置包括UOS V2500操作系统和CANN 8.3.RC2版本。主要内容包括:1)创建专用运行用户HwHiAiUser;2)通过yum更新源并安装Python依赖;3)校验并安装NPU驱动和固件包;4)系统重启后使用npu-smi验证驱动加载。文档还提供了三个常见错误的解决方案:内核开发包缺失、DK
GLM-5.2 KV Offload 系统优化实践Agent 赋能模型部署优化:Hy3 昇腾推理实践PyPTO 编程框架与 Agent 算子生成能力面向昇腾 950DT 的 DSpark 推理实现与性能优化Longcat 2.0:推理低时延优化SanaVideo 模型 NPU 单卡部署与性能优化实践。
从2019年昇腾910首次亮相到2026年WAIC上Atlas 950 SuperPoD真机登场,华为用七年时间走完了一条从追赶到重构的道路。达芬奇架构、Chiplet双Die方案、950系列PR/DT分型设计,每一步都不是简单的参数堆砌,而是对AI计算范式的重新定义。这不是一个关于追平的故事,而是一个关于系统重构的故事。
视频号、B站、昇腾社区多平台直播。