
DeepSeek一口气开源6个昇腾组件:TileLang、DeepGEMM-Ascend与FlashMLA如何对标CUDA生态
DeepSeek一口气开源6个昇腾组件:TileLang、DeepGEMM-Ascend与FlashMLA如何对标CUDA生态
9 月 30 日至 10 月 1 日,多个技术资讯渠道集中报道了 DeepSeek 与华为昇腾合作、一次性开源 6 个面向昇腾平台的基础软件组件的消息,组件包括 TileLang(昇腾版)、TileKernels、DeepGEMM-Ascend、DeepEP-Ascend、FlashMLA、DeepSelect,并被媒体概括为"与此前面向英伟达平台的开源组件一一对应"、“国产 AI 芯片软件生态的换轨时刻”[1]。同一批报道还提到,这套栈包含"TileLang 高级语言编译器及 DeepGEMM、FlashMLA 等核心计算与通信库"[2],并在行业日报中被归入"国产算力全栈突破"主线[3]。
本文不复述这些通稿式结论,而是做三件事:把六个组件放回加速器软件栈的分层结构里,逐个说明它们各自对应 CUDA 生态的哪一段、映射关系有多可靠;按开发者角色拆解从 CUDA 迁移到昇腾的真实成本层级;最后给出一套可自行复现的性能验证方法。需要先声明的是,本文可获得的全部材料均为 9 月 28 日至 10 月 1 日之间的中文资讯日报类二手转述[1][2][3][4],没有仓库 README、官方公告原文、License 文件或任何性能数据。因此下文会严格区分"转述中已出现的表述"与"基于技术常识的推断",凡涉及具体 API、版本号、芯片型号、性能数字处一律留白或标注待核实。
一、先把事实摆清楚:这次到底开源了什么
1.1 信息来源与证据分级
本文采用四级证据口径:
- A 级:官方仓库 / LICENSE / Release 页。当前材料中一条都没有提供,六个仓库的确切 URL、License 类型、版本号均未出现。
- B 级:官方公告或官方技术博客原文。当前材料同样没有直接给出。
- C 级:媒体独立报道。材料中《财联社》对 FTC 调查的报道被掘金日报转引[1],但与本主题无关。
- D 级:日报 / 资讯聚合的二手转述。本文关于本次开源的全部具体描述都来自这一级[1][2][3]。
这意味着一个必须写在前面的结论:“DeepSeek 联合华为昇腾开源全套基础软件栈”"实现国产算力全栈对标 CUDA"是媒体转述中的表述,不是本文已经验证的事实[2]。读者如果要把这些结论写进选型报告,应先回到 DeepSeek 与华为昇腾的官方组织页面核对仓库、License 与 README 自述定位。
时间线在转述中也存在细微差异:掘金日报明确写"9 月 30 日,DeepSeek 宣布开源面向华为昇腾平台的全套基础设施组件"[1],而另一篇日报把这一事件放在 10 月 1 日的当日要闻中[2][3]。合理解释是 9 月 30 日发布、10 月 1 日进入各资讯日报,但这仍属推断,发布日期与各组件是否同步发版需要在 Release 页确认。
1.2 六个组件的功能定位卡
下表整理自转述材料中出现的组件名称[1][2]。“定位"一列凡转述未说明的,一律标注"未给出”,不做补写。
| 组件 | 转述中的名称变体 | 转述给出的定位 | 主要使用者(推断) | 待核实项 |
|---|---|---|---|---|
| TileLang-Ascend | TileLang(昇腾版)、TileLang 高级语言编译器[1][2] | 高级语言编译器 / DSL 层组件 | 写自定义 kernel 的性能工程师 | 准确仓库名、是否与 CUDA 侧同源、后端切换方式 |
| TileKernels | TileKernels[1] | 转述未给出功能描述 | 待确认 | 全部;名称暗示为 kernel 集合,但官方定义缺失 |
| DeepGEMM-Ascend | DeepGEMM-Ascend、DeepGEMM[1][2] | 核心计算库(归入"计算与通信库")[2] | 框架与推理引擎开发者 | 面向的精度格式、shape 覆盖、是否含 MoE 特化 |
| DeepEP-Ascend | DeepEP-Ascend[1] | 转述归入通信类组件 | MoE / 大规模分布式团队 | 依赖的底层通信库、接口与 NVIDIA 版差异 |
| FlashMLA | FlashMLA[1][2] | 核心计算库(注意力方向)[2] | 推理引擎开发者 | 是否区分 CUDA / 昇腾两个实现、API 形态 |
| DeepSelect | DeepSelect[1] | 转述完全未给出功能描述 | 待确认 | 全部 |
这张表本身就说明了一件事:六个名字里,有两个(TileKernels、DeepSelect)在现有材料中没有任何功能说明。任何在此基础上猜测它们"对应 NCCL""对应专家负载均衡器"的说法都是编造,本文不做这种补全。
1.3 "全套基础软件栈"这句话的边界
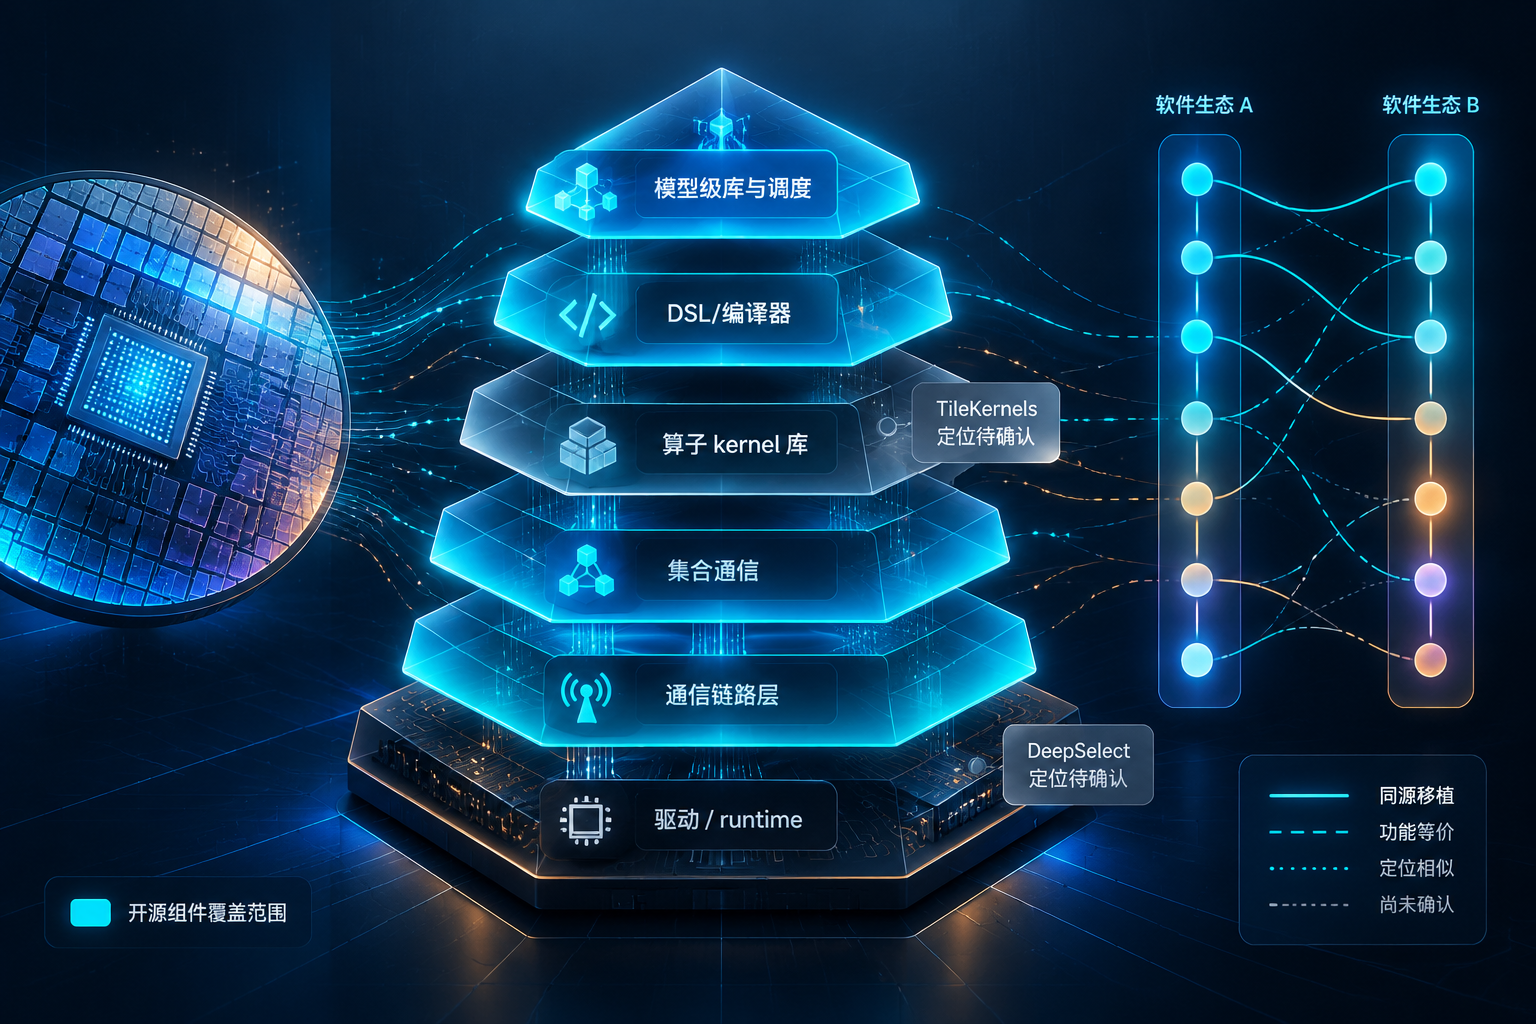
"全栈"在不同语境里指代的层完全不同。把加速器软件栈按依赖关系粗分,可以得到五层:
- 固件、驱动与 runtime;
- 集合通信库与互联拓扑管理;
- 算子 / kernel 库(GEMM、Attention、归一化、激活等);
- kernel DSL 与编译器、自动调优;
- 模型级库、调度与并行策略组件。
从转述看,本次开源至少覆盖第 3 层(DeepGEMM-Ascend、FlashMLA)、第 4 层(TileLang-Ascend),并疑似覆盖第 2 层的一部分(DeepEP-Ascend)与第 5 层(DeepSelect,功能待确认)[1][2]。第 1 层即驱动与 runtime 不在转述提及范围内,大概率仍由华为昇腾平台软件体系提供,而不是这六个开源仓库的组成部分。
所以更准确的说法是:这是一次面向高性能算子与编译层的开源补齐,而不是"把昇腾的全部软件栈开源了"。对开发者而言,迁移工作仍然要经过厂商提供的设备管理、算子覆盖、框架适配与工具链,这批组件主要降低的是"写高性能 kernel 与调通信"这一段的门槛。
二、逐一映射:从 CUDA 生态组件到昇腾组件
2.1 映射方法论:按栈层对照,而不是按名字对号入座
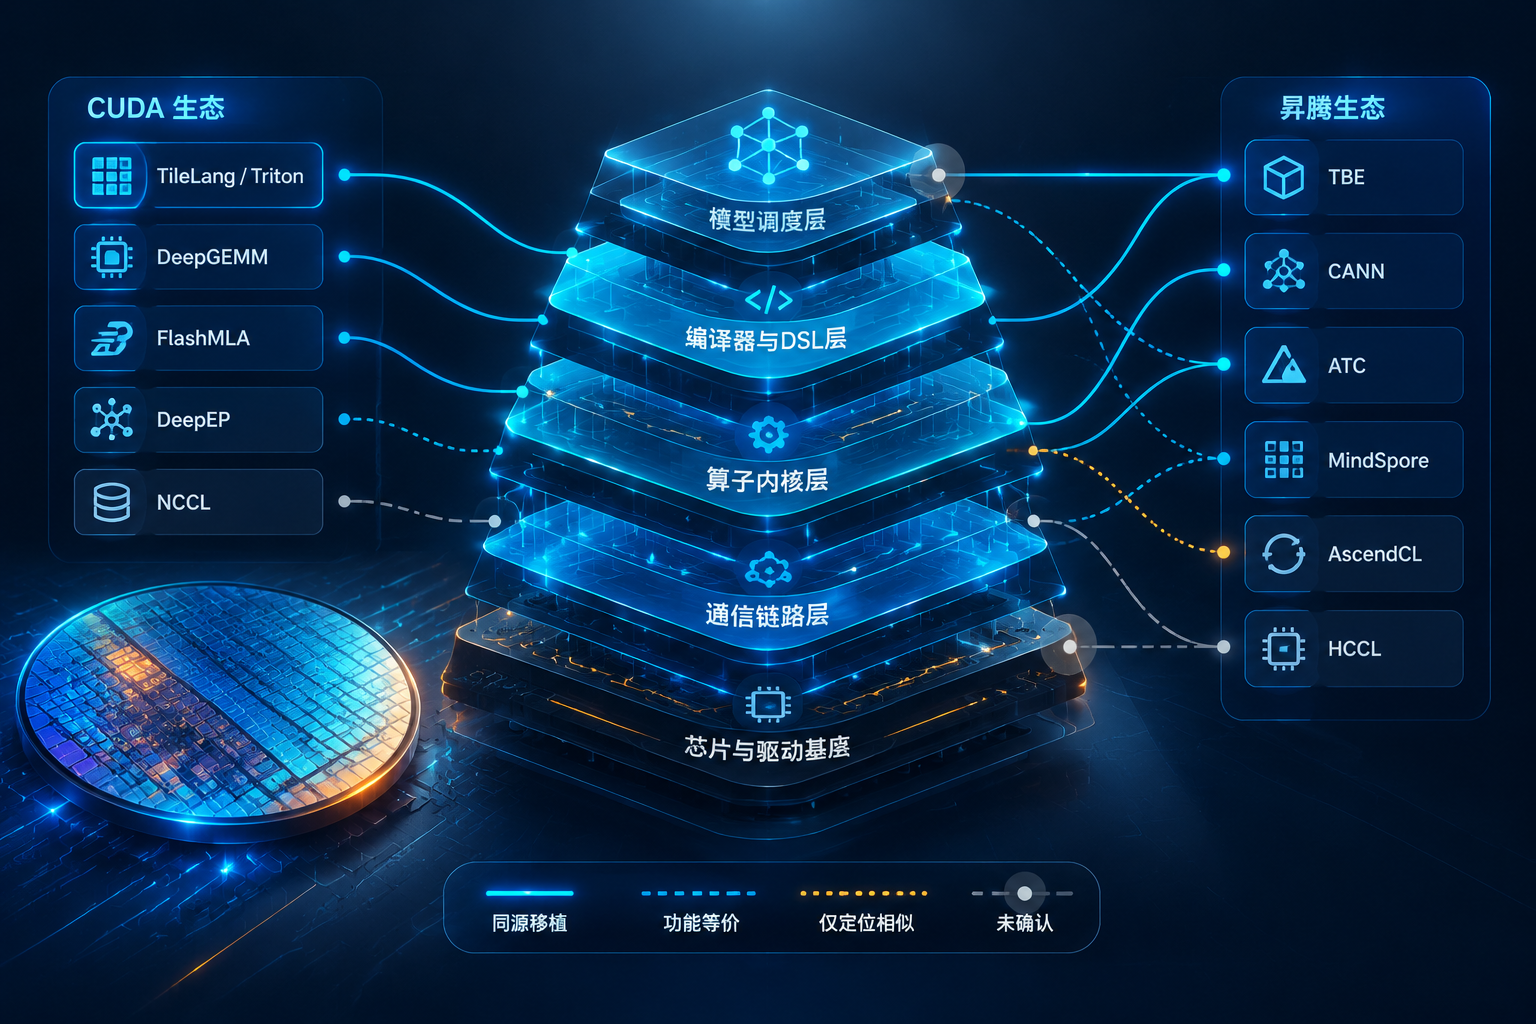
媒体使用了"一一对应"的说法[1]。在工程评估中,"对应"至少有三种强度,必须区分:
- M1 同源移植:同一份代码基线、同一套 API,换后端即可编译。迁移成本最低,但需要确认是否有大量
#ifdef或后端专用分支。 - M2 功能等价、API 独立:解决同一类问题,但接口、数据布局、调优参数各不相同,需要真实改代码。
- M3 仅生态位相似:处于同一栈层、服务同类上层组件,但设计目标不同,不能直接替换。
下面的映射矩阵中,“置信度"一列的依据是转述文本里是否有明确的对应表述。凡转述只给出组件名而未给出对应物的,一律记为"未确认”。
| 昇腾组件 | CUDA 生态侧的参照物 | 映射置信度 | 依据与差异 |
|---|---|---|---|
| TileLang-Ascend | TileLang(CUDA 后端) | M1 倾向,待核实 | 名称与"TileLang 昇腾版"表述暗示同项目多后端[1];是否同一仓库、同一源码需查证 |
| DeepGEMM-Ascend | DeepGEMM | M2 倾向 | 转述称"核心计算库"并使用 -Ascend 后缀[1][2],后缀通常表示移植/适配版本,API 兼容性未知 |
| FlashMLA | FlashMLA | 不确定 | 转述未区分该名字是否同时指代两个后端实现[1][2],需查仓库结构 |
| DeepEP-Ascend | DeepEP | M2 倾向 | 命名规则与 DeepGEMM-Ascend 一致[1];底层通信库依赖未说明 |
| TileKernels | 未确认 | 未确认 | 转述无对应表述 |
| DeepSelect | 未确认 | 未确认 | 转述无对应表述 |
2.2 DSL / 编译层:TileLang-Ascend 对标的是"写 kernel 的方式"
在 CUDA 生态里,写一个高性能算子通常有三条路:直接写 CUDA C++、用 CUTLASS 之类的模板库做 tile 级组合、或用 Triton 这类 Python 层 DSL 让编译器负责底层调度。TileLang 在社区认知中属于"tile 级 DSL + 编译器"这一类,用户声明 tile 划分、内存层次与计算原语,编译器生成目标后端代码。这一段描述属于技术常识层面的背景推断,本次材料没有提供 TileLang 的官方文档,具体编程模型、原语集合与自动调优能力需以仓库 README 为准。
TileLang-Ascend 的工程意义要看两个问题:
- 是否同一份源码可切换后端。如果是,那么在 CUDA 上积累的 TileLang kernel 有机会以较低成本迁到昇腾;如果只是"同名 DSL、不同实现",则要重新验证语义一致性。
- 昇腾后端的编译目标是什么。是落到昇腾自有算子指令层,还是经过某个中间表示再下沉到厂商编译器,这决定了编译耗时、可调试性与错误信息质量。
对性能工程师来说,这两个问题比"支持多少个算子"更重要,因为它们决定了一个新 kernel 从原型到上线的迭代周期。
2.3 稠密计算层:DeepGEMM-Ascend 不应被理解为 cuBLAS 的替代品
转述把 DeepGEMM 归入"核心计算与通信库"[2]。在 CUDA 生态里,GEMM 有两类定位截然不同的实现:一类是 cuBLAS 这种通用库,覆盖大量 shape 与精度组合,追求稳定与普适;另一类是 CUTLASS、DeepGEMM 这类面向特定场景深度调优的实现,常常服务于大模型训练/推理中的典型 shape、混合精度乃至 MoE 分组 GEMM。
因此评估 DeepGEMM-Ascend 时,应当问的是:
- 支持哪些精度组合(FP16 / BF16 / FP8 / INT8,转述未给出);
- 支持的 shape 范围与对齐要求,非典型 shape 是否退化;
- 是否包含 MoE 场景下的分组 GEMM 语义;
- 与框架默认算子的分派关系:是透明接管,还是需要显式调用。
把 DeepGEMM-Ascend 直接与 cuBLAS 做"全量覆盖对比"是无效的,把它的调优收益当成"昇腾 GEMM 性能整体水平"同样是无效的。
2.4 注意力层:FlashMLA 的关键词是"专用"
FlashMLA 的名字来自 MLA(Multi-head Latent Attention)这一注意力结构,它是 DeepSeek 系模型使用的注意力变体。这一背景来自社区通行认知,材料中没有给出 FlashMLA 的技术定义。如果这个定位成立,那么 FlashMLA 与 FlashAttention 这类通用注意力实现的关系就不是替代关系:前者是面向特定模型结构的深度优化 kernel,后者覆盖更广的注意力变体集合。
对迁移者的实际含义是:如果模型不用 MLA 结构,FlashMLA 的价值有限;如果用 MLA 结构,那么它是推理/训练路径上的关键 kernel,其正确性与数值行为需要单独验证,包括 softmax 缩放、KV 缓存布局、序列长度分块策略等。转述没有说明 FlashMLA 在昇腾侧是新实现还是移植实现,这一点必须查仓库提交历史。
2.5 通信与 MoE 层:DeepEP-Ascend 与集合通信库是互补关系
在 CUDA 生态里,NCCL 提供 all-reduce、all-to-all 等集合通信原语;DeepEP 这类项目则在其上实现面向 MoE 专家并行的高效通信与调度模式。这一层次关系是技术常识层面的推断,DeepEP-Ascend 在昇腾侧究竟建立在哪个通信库之上、是否复用厂商集合通信能力,现有转述完全未说明[1]。
评估 DeepEP-Ascend 需要确认三点:
- 底层依赖:是调用厂商集合通信库,还是自带传输实现;
- 语义:是否支持 MoE 的分发—组合(dispatch / combine)语义,粒度如何;
- 调优参数:通信计算重叠、chunk 大小、SM / 计算单元占用策略在昇腾上如何映射。
第 3 点最容易被低估:在 CUDA 上积累的重叠调优经验不能直接搬过去,因为计算单元占用模型、片上内存层次与互联拓扑都不同。
2.6 TileKernels 与 DeepSelect:明确留白
TileKernels 与 DeepSelect 在本文可获得的材料里只有名字[1]。合理的下一步是阅读仓库 README、目录结构与提交记录,确认 TileKernels 是否为若干 TileLang kernel 的集合实现、DeepSelect 是否与并行调度或专家选择有关——但在官方描述出现之前,这只是待验证的问题清单,不是结论。
三、这套栈补的是哪一段:从"能跑"到"能调优"
3.1 缺口分析:性能可预期性的三个来源
在昇腾 NPU 上跑通一个大模型训练或推理任务,与让它达到可预期的高性能,是两个不同难度的问题。后者依赖三个条件:
- 关键路径上有高效 kernel:GEMM 与 Attention 通常占据绝大部分计算时间,这两处不达标,端到端性能就没有讨论基础。
- 分布式通信不成为瓶颈:尤其在 MoE 模型里,专家并行的 all-to-all 通信经常比计算更容易成为短板。
- 第三方能以可承受的成本写新 kernel:模型结构、量化方案、稀疏化策略都在快速演化,如果每次变化都要等厂商出算子,生态就无法自我生长。
本次开源的组件大致对应这三条:DeepGEMM-Ascend 与 FlashMLA 对应第 1 条,DeepEP-Ascend 对应第 2 条,TileLang-Ascend 对应第 3 条[1][2]。这是从组件命名与转述定位得出的对应关系,属于本文的结构性分析,不是官方口径。
其中第 3 条的分量最重。算子库解决"今天能跑多快",DSL 与编译器解决"明天能不能自己调"。一个只有算子库的平台,本质上是把性能上限交给了有限的库维护者;一个有可用 kernel DSL 的平台,才有可能吸引第三方贡献者参与优化。
3.2 与模型侧开源动作的关系
值得注意的是,在 9 月 28 日前后,另一条相关消息是华为宣布 openPangu-2.0 的预训练、监督微调与后训练强化学习代码开源,面向昇腾集群提供一体化训练能力[4]。这与本次基础软件栈开源是互补关系,而不是同一件事:前者打开的是模型与训练流程,后者打开的是算子与编译层。两条线合起来才构成"从模型到硬件"的完整开放度,但二者的仓库、License、维护主体需要分别核查,不能因为都在昇腾生态里就混为一谈。
3.3 仍然没有被覆盖的部分
按现有材料,以下环节仍依赖厂商平台或需要单独解决:
- 驱动与 runtime 的版本节奏、兼容性承诺;
- 算子覆盖完整性:除 GEMM 与 Attention 外的长尾算子;
- Profiling 与调试工具:时间线、通信流水、片上内存占用的可视化能力;
- 量化工具链:校准、精度回退、误差分析;
- 框架级适配层:PyTorch 等框架的设备、流、随机数语义如何映射;
- 编译缓存、图编译、算子融合等运行时行为。
这几项恰恰是迁移过程中最花时间的部分。六个开源组件降低了 kernel 层门槛,但不等于降低了整体迁移门槛。
一个能说明问题的思想实验是"新增一个自定义 attention 变体 kernel"。在 CUDA 路径上,成熟团队通常有可复用的模板、成熟的 profiler、大量的社区参考实现;在昇腾路径上,即便有 TileLang-Ascend,团队仍需自行确认数值语义、性能瓶颈位置与调试工具链的成熟度。这一段是推演而非实测,目的在于提醒读者把验证成本计入预算。
四、开发者迁移成本:从 CUDA 代码搬到昇腾,到底要动哪些东西
4.1 迁移成本的四个层级
| 层级 | 内容 | 典型改动 | 成本性质 |
|---|---|---|---|
| L1 | 设备、张量搬运、流与同步 API | 设备声明、内存分配、事件计时替换 | 机械替换为主 |
| L2 | 算子调用与算子覆盖缺口 | 框架算子分派、缺失算子的临时实现 | 适配 + 少量重写 |
| L3 | 自定义 kernel | 用 TileLang-Ascend 或厂商算子接口重写 | 结构性重写 |
| L4 | 并行策略与通信原语 | MoE 专家并行、通信计算重叠、调度参数 | 策略级重构 |
需要强调的是,L3 的成本高度依赖 TileLang-Ascend 是否做到"一份源码多后端";L4 的成本高度依赖 DeepEP-Ascend 与 NVIDIA 版 DeepEP 的语义相似度。这两个变量在现有材料里都未确认,因此任何"迁移只需几天"或"迁移成本极高"的断言都不成立。
4.2 三类开发者的成本画像
只跑 PyTorch 训练的算法工程师:成本集中在 L1、L2。主要风险是算子覆盖缺口带来的回退实现,以及混合精度下的数值差异排查。建议先把固定随机种子的单步训练跑通,对比 loss 曲线与关键张量的相对误差,再谈吞吐。
写自定义 kernel 的性能工程师:成本集中在 L3。第一步不是重写,而是验证 TileLang-Ascend 能否表达现有 kernel 的关键结构(tile 划分、片上缓存使用、向量化访问)。选一个真实但足够小的算子做 POC,比通读文档更能暴露问题。
大规模 MoE / 推理 Infra 团队:成本集中在 L4。除了接口差异,还要重建性能模型:通信原语的开销特征、重叠策略、拓扑敏感性都需要重新测量。这部分往往要重做压测矩阵,不能沿用在 CUDA 上的调优结论。
4.3 迁移检查清单
以下清单可以作为迁移启动时的任务表:
- 固定并记录全部软件版本:驱动、runtime、编译器、框架适配层、各开源组件的 commit;
- 明确设备与流的语义映射,确认默认流、事件计时的行为是否与原实现一致;
- 固定随机种子,记录随机数生成器差异带来的数值偏差基线;
- 记录混合精度与量化格式的对应关系,避免精度格式被静默改变;
- 逐项登记算子覆盖缺口,并为每个缺口指定临时方案与验收标准;
- 重建 profiling 与计时口径,确认预热、编译、数据加载是否计入;
- 确认分布式启动方式、通信组划分与故障恢复行为;
- 保留一份可对照的 CUDA 侧基线,用于数值与性能双向比对。
4.4 一个端到端走查示例(示意骨架)
下面的代码只是迁移结构示意,不是可运行代码,函数名与签名一律以各仓库实际 API 为准:
# 示意骨架,非可运行代码
# TODO: 设备、流、计时、kernel 入口名称均以官方 API 为准

def build_baseline_case():
    # 1) 固定 shape 与精度,先保证两侧输入完全一致
    m, n, k = 4096, 4096, 4096
    dtype = "bf16"          # 精度格式以实际支持情况为准
    a, b = make_inputs(m, n, k, dtype, seed=2026)

    # 2) 记录软件栈版本,便于复现
    log_versions(driver=..., compiler=..., framework=..., component=...)

    # 3) 预热与编译阶段单独计时,不混入稳态结果
    with timer("compile_and_warmup"):
        for _ in range(10):
            out = gemm_or_attention(a, b)   # 具体入口待核对

    # 4) 稳态测量,报告 P50 / P99 而非单次结果
    latencies = []
    with timer("steady_state"):
        for _ in range(100):
            out = gemm_or_attention(a, b)
            latencies.append(elapsed())

    # 5) 数值一致性检查,容限需与精度格式匹配
    ref = reference_result(a, b)
    assert relative_error(out, ref) < tolerance_for(dtype)

    return summarize(latencies)
真正的迁移差异往往体现在第 5 步之外:如果 gemm_or_attention 在新平台上走的是另一条算子分派路径,那么即使数值正确,性能特征也可能完全不同。
五、性能验证怎么做:一套可复现的基准测试设计
由于现有材料没有提供任何性能数据[1][2][3],本文不给"谁快谁慢"的结论,只给验证方法。
5.1 基准测试的四个层次
| 层级 | 测试对象 | 关注指标 | 主要作用 |
|---|---|---|---|
| Micro | 单个 GEMM / Attention kernel | 达成算力、带宽利用率、延迟 | 判断 kernel 本身是否达标 |
| Kernel 组合 | 一层 MoE 或 FFN | 计算—通信重叠率、chunk 开销 | 判断组合损耗 |
| 子模块 | 单个 decoder layer | 层内耗时分布、内存峰值 | 定位结构级瓶颈 |
| 端到端 | 训练 step / 推理吞吐 | tokens/s、step time、P99 | 面向业务的最终口径 |
必须分层报告。只报端到端数字会掩盖 kernel 差异,只报 micro 数字又会忽略通信与调度开销。
5.2 环境对齐:必须控制的变量
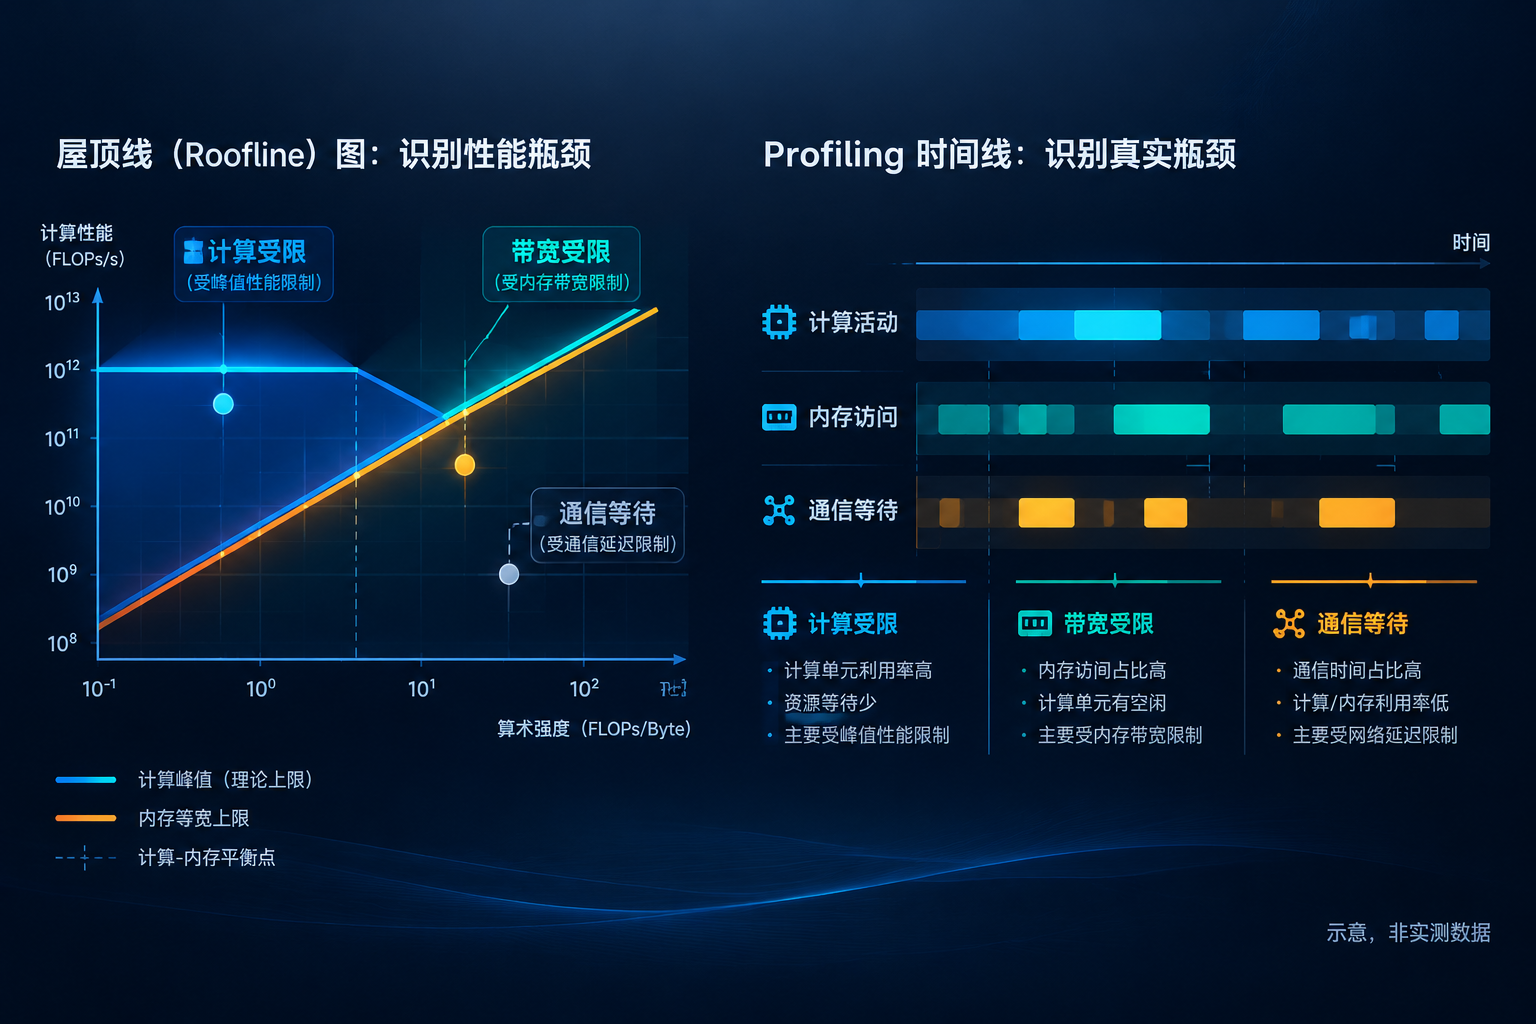
同代硬件、相同互联拓扑与卡数、固定软件版本、相同 batch 与序列长度、相同精度格式、相同编译与预热策略。拿不同代硬件或不同互联规模的设备对比 TFLOPS 是无效对照;把冷启动时间混进稳态吞吐同样无效。
一个容易被忽略的口径问题是"峰值算力"的来源。厂商公开的峰值与实际可达算力之间的差距,受 shape、精度、kernel 实现影响很大。报告中应同时写明:参照的峰值口径、实际测得的达成率、测试 shape。
5.3 指标与口径
建议至少包含:
- 达成算力与有效带宽利用率;
- 延迟分布(P50、P99),而非平均值;
- 通信时间占比与计算—通信重叠比例;
- 端到端 tokens/s 或 step time;
- 数值一致性:相对误差分布与最大偏差;
- 内存占用峰值与编译/预热耗时。
常见口径陷阱包括:是否包含数据加载、是否包含编译、是否开启融合优化、是否使用图形捕获或等价机制、卡数变化后通信占比是否可比。
5.4 最小验证套件
对一个刚开始评估的团队,最小可行套件是:
- 跑通:一个 GEMM 基准 + 一层 attention,确认环境、版本、计时正确;
- 对齐:在 CUDA 侧跑同一 shape、同一精度,建立数值与性能基线;
- 归因:用 profiling 工具确认时间分布,区分计算、通信、空转与同步等待;
- 放大:扩到完整 decoder layer 与小规模分布式,观察组合损耗;
- 固化:把脚本、版本记录与结果写进报告模板,作为向厂商或内部决策的可复现证据。
基准报告模板(建议字段)
- 测试目的:
- 硬件与互联拓扑:
- 软件栈版本清单:
- 测试 shape / batch / seq / 精度:
- 预热与计时规则:
- 基线来源与口径:
- 各层级结果(Micro / 组合 / 子模块 / 端到端):
- 数值一致性结果:
- 已知偏差与未解释现象:
- 结论与后续验证项:
六、工程与生态风险:开源之后还有哪些不确定性
License 与治理。现有材料没有给出任何一个组件的许可证类型[1][2]。商用、修改、再分发、专利条款都需要逐一确认。此外要看贡献流程是否开放、修复是否会回流到通用上游项目,这决定了长期维护是"单厂商路线"还是"共享生态"。
版本与兼容承诺。芯片型号、平台软件版本、框架版本之间的兼容矩阵是否存在、是否有明确的版本支持周期,是生产落地的前提。缺少兼容矩阵时,团队只能自行 pin 版本并承担升级成本。
社区信号的正确读法。star 数、issue 响应速度、示例完整性、文档语言与深度都是可观察指标,但必须在同一时间点抓取同一仓库的真实数据。本批材料中的 GitHub 热榜 star 增量属于其他项目,与这六个组件无关,不能借用作影响力论据;同时这批资讯条目的热度字段均记录为 0,无法用来论证事件影响力。
尽调清单:License 与专利条款、仓库活跃度与维护主体、兼容矩阵、官方 benchmark、迁移指南与示例、问题响应机制、上下游回流策略。每一项都应附证据链接与核实日期,而不是印象分。
七、结论:给三类开发者的行动清单
算法工程师:先跑通最小训练或推理路径,重点排查算子覆盖缺口与数值一致性,把 loss 曲线对比作为第一验收项,把吞吐放在第二阶段。
Kernel 工程师:选一个真实算子做 TileLang-Ascend 的可行性 POC,验证三个问题——能否表达现有 kernel 结构、编译与调试体验如何、性能差距出在哪里。这个 POC 的结论比任何转述都有价值。
技术决策者:把"六个开源组件"与"完整可用生态"严格区分,要求供应商按分层基准模板提供可复现数据,并把 License、兼容矩阵、维护承诺写进评估报告。
综合来看,这次开源动作更准确的定位是:降低昇腾生态在高性能算子与 kernel 编程层面的进入门槛。它是否构成真正的"换轨",取决于三件事的后续兑现——TileLang-Ascend 的多后端真实成本、性能数据能否被第三方复现、以及兼容承诺与社区治理是否持续。在这些证据出现之前,"全栈对标 CUDA"应被视为媒体表述而非工程结论[2],而"6 个组件开源"这一事件本身,值得每一个做国产算力评估的团队认真跟进与独立验证。
参考资料
[1] 今日AI大事件 | 2026.10.01:FTC 立案调查"失控AI智能体"、Google 发布 Gemini 4 Argon、DeepSeek 昇腾全套开源,掘金,https://juejin.cn/post/7691219326315626511
[2] AI 日报(2026年10月1日)今日主题:Google Gemini 4 Argon 发布,中美 AI 算力与政策博弈,掘金,https://juejin.cn/post/7691160156303163392
[3] 2026年10月1日AI行业日报 | Gemini 4 Argon 正式发布,全球AI监管收紧,国产算力全栈突破,CSDN,https://blog.csdn.net/Smoothly_Lu/article/details/166937993
[4] AI 资讯日报 | 2026年9月28日:OpenAI 因智能体越界再停前沿训练,华为盘古2.0全栈开源,英伟达加码玻璃基板与代理安全,CSDN,https://blog.csdn.net/IT_ORACLE/article/details/166827913

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)