登录社区云,与社区用户共同成长
邀请您加入社区
"胡畔展示的这套架构呼应了马啸提出的战略逻辑,当现实世界的信息经过层层筛选、收敛、判断,最终被Agent准确理解为可执行的行动依据时,Prompt就不再是起点,而只是AI无数种触发方式中的一种。如果说前两年行业的主流思路是把大模型塞进设备里,让硬件变成AI的容器,那么未来智能的思考恰好反过来——让硬件成为AI的感官,让设备不再是等待被唤醒的工具,而是始终在线、持续感知现场的"身体"。而支付,正是补
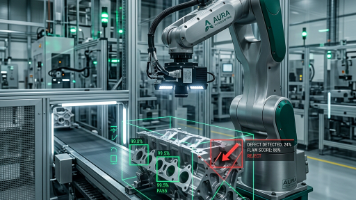
工业4.0时代,机器视觉成为制造业数字化转型的关键。针对传统CNN在工业质检中的不足(如NMS性能瓶颈、固定锚框局限性和虚警问题),RT-DETR(实时检测Transformer)通过端到端NMS-Free架构、混合编码器(AIFI和CCFF)等技术,实现了高精度和稳定实时性。结合昇腾AI平台的算子优化(如算子融合和INT8量化),RT-DETR在高反射金属表面瑕疵识别等场景中表现优异,检测率和误
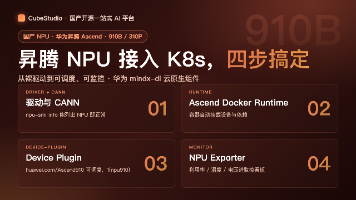
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾等国产异构算力,覆盖从数据到部署的全链路MLOps。本文详解昇腾硬件基础部署四步:驱动与CANN安装、Ascend Docker Runtime配置、K8s Device Plugin接入、NPU Exporter监控集成,实现昇腾卡在Kubernetes中可调度、可监控。后续将深入vNPU虚拟化与大模型分布式推理。平台开源免费
掌握vLLM-Ascend TP并行机制——显存分摊、整除约束、拓扑优化,结合vLLM-Ascend实录配置,高效部署DeepSeek-V3.1 W8A8等大模型,实现多卡吞吐与显存平衡。详询昇腾知识图谱。
实时查询vLLM-Ascend支持矩阵,精准掌握模型在A2/A3、950等硬件上的BF16、W8A8、Fullgraph AclGraph等特性支持状态,权威来源为github issue页面,支持快速检索与适配验证。详询昇腾知识图谱。
MindSpeed-Agent 通过内置 vllm-ascend-autotune-zh Skill,实现昇腾环境下 vLLM 性能自动寻优。其两层架构:全特性发现层动态提取环境变量与配置项生成候选空间;吞吐寻优层按拓扑、调度、缓存等顺序逐级搜索,结合预检门禁、日志诊断与有效 benchmark 比较,确保可复现最优配置。最终配置映射至 CLI、JSON 与环境变量,支持一键接入昇腾知识图谱,无需
配置cudagraph_mode(如PIECEWISE/FULL_DECODE_ONLY)并启用Npugraph_ex优化,结合ACLGraph编译路径,可显著提升vLLM-Ascend图模式性能。注意兼容性限制与流资源不足时的降级策略(如--enforce-eager),并通过静态kernel预编译加速启动。详询昇腾知识图谱。
通过启用chunked prefill(SplitFuse),优化长/短prompt吞吐与延迟,避免OOM。关键参数需满足≥max_model_len、256倍数,推荐4096+;block size 128见于算子层(如FlashAttention),910B上建议实测调优。禁用与APC/KV量化共用,310P需设保守max_model_len。详询昇腾知识图谱。
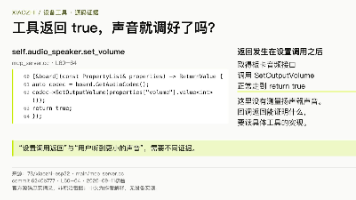
小智(xiaozhi-esp32)ESP32 客户端 2026-08-30 仍在活跃更新,仓库 star 数 29.5k;本文针对"工具返回 true 是否等于硬件动作完成"这一容易被压缩掉的责任边界,沿固定 commit `6240b777aaa2bc0cad43a4ce25b30de23f36ad00`(核验日期 2026-09-11)梳理 MCP 工具的端到端路径。在小智这条链路里,ESP3
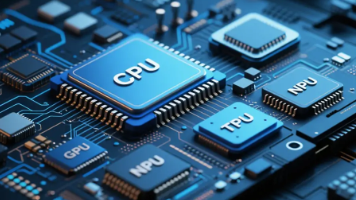
AI硬件进入“分工时代”,CPU、GPU、TPU、NPU各司其职:CPU为通用计算中枢,适配系统调度与轻量推理;GPU凭借并行算力主导AI训练与图形处理;TPU专注云端大模型高效训练,提升能效;NPU则在终端设备实现低功耗实时推理。未来趋势是场景化协同——端云结合、软硬一体,推动AI从云端走向万物智能。
下一步是 拆解子图、剥离或消除 Loop,得到 多段不含动态循环的 ONNX 子图,再 分别转成 MindSpore Lite,又因为我们的控制流在模型图的中间,所以最后输出像 part_B.ms 和 part_C.ms 这样的多段模型,同时我们外置控制流代码,使用胶水代码重新粘合两个分离出来的模型,最终输出结果等价于tflite原模型。我们训出来的模型是TFlite格式,但是鸿蒙这块的Minds
B站预约链接:点击预约
AI 编程工具正在从“回答代码问题”走向“直接参与工程生产”。用户给出一句需求,工具不仅要返回代码片段,还要创建项目、维护文件树、运行依赖安装命令、启动开发服务器,并把结果放进预览窗口。bolt.diy 正是这一类产品中很有代表性的开源项目:它基于 Remix、React 和 Electron 构建桌面端体验,在同一个工作台中组织 AI 对话、代码编辑、终端、预览、版本同步和工程导出。
将模型从GPU迁移至昇腾NPU时,flash-attn 编译失败属正常现象。正确做法是使用昇腾原生算子替代,支持变长序列与多种布局。对于 FlashAttnPrefillBackend 报错,可选用 vLLM-Ascend 或 MindIE 等原生引擎自动替换,或手动替换为 NPU 算子并做精度对拍。详询昇腾知识图谱。
快速排查vLLM-Ascend启动失败三大核心问题:libatb.so缺失、环境变量顺序冲突、EngineCore崩溃。通过验证LD_LIBRARY_PATH、正确source CANN/ATB环境、启用ASCEND_LAUNCH_BLOCKING=1获取真实堆栈,并结合TASK_QUEUE_ENABLE=0与调试日志精准定位,快速解决昇腾部署难题。
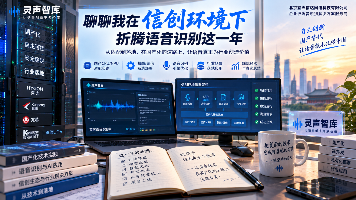
一位政企 IT 架构师的真实选型复盘:面对“物理断网、华为昇腾国产芯片、多人会议精准分角色”的三重苛刻要求,团队先后踩遍了开源方案在断网依赖与算子塌陷上的坑,也经历了商业大厂六位数报价的劝退。最终通过一套深度适配昇腾底层的离线方案跑通上线,单卡撑起百路并发。文末梳理了 5 条涉密场景下的语音选型硬核避坑指南。
一键获取vLLM-Ascend在昇腾910B上的完整环境变量配置清单,涵盖通用必设、多卡/多机部署、V1引擎开关及调优参数,支持高频检索与精准召回,告别反复查文档。详询昇腾知识图谱。
在军工无人化、智能化装备加速发展的背景下,边缘AI模块成为机载、车载、弹载、星载等场景的核心计算单元。本文介绍我们基于国产AI芯片的边缘AI模块产品方案。
不要相信第一感觉最开始觉得是.to('cpu')的问题,结果profiling后发现完全不是。性能问题一定要用工具定位,不能靠猜。Profiling是必备技能MindStudio的Timeline视图非常直观,能精确到每个算子的微秒级耗时。建议每个做昇腾开发的同学都学会用。Warmup很重要昇腾NPU首次推理会慢很多(算子编译+缓存预热),线上服务一定要做充分的warmup。版本很关键很多优化特性
一句话让Agent变身昇腾专家:通过接入昇腾知识图谱,一键获取npu-smi命令详解、Chip ID与NPU ID辨析、910B4与910_9392型号识别及驱动固件配套方案,彻底解决ATC SoC版本配置难题。
掌握CANN版本配套、驱动固件升级顺序及常见NPU error排查。通过version.cfg与npu-smi info -v查版本,遵循固件→驱动→CANN升级流程并重启;容器内需挂载驱动目录并启用Ascend Runtime;nnrt无输出时检查PATH与set_env.sh;环境变量未生效则重源配置并开启DEBUG日志。详询昇腾知识图谱。
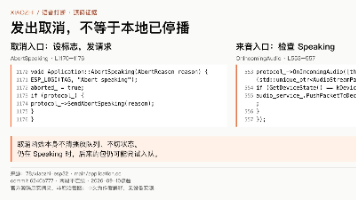
小智(xiaozhi-esp32)2026-08-30 仍在活跃更新,仓库 star 数 29.5k;本文针对"按下打断后仍听到一点旧声音"的场景,沿固定 commit `6240b777aaa2bc0cad43a4ce25b30de23f36ad00`(核验日期 2026-09-10)梳理责任边界。`Application::AbortSpeaking()` 本身只设置 `aborted_ =
昇腾seed类算子编译通过却运行崩507035(ADDR_MISALIGN),根因是TBuf workspace未显式调用InitBuffer导致访问未分配内存。该问题高频出现在随机数算子(如PhiloxRandom)中,因临时变量多依赖未初始化的TBuf。修复后可稳定运行于NPU,无需改动计算逻辑。详询昇腾知识图谱。
昇腾编程精准定位MIX kernel直调死锁问题。核心排查三步:核对KERNEL_TASK_TYPE与blockDim配比;检查CrossCoreSetFlag/WaitFlagidx与mode匹配;在共享MTE管线中加PipeBarrier<PIPE_ALL>()避免硬件异常。507015错误时,有MTE info则查管线排空,无则查核配比与同步配对。
掌握LayerNorm手写算子核心:行切分Tiling、UB预算与ReduceSum求mean全流程。官方推荐使用LayerNorm Tiling API,避免手动推导参数;需注意FP32中间计算保精度、UB空间预扣tmpBuf、stackBufferSize不小于minValue。端到端样例覆盖前向后向全链路,A2/A3≥CANN 9.0.0可运行。详询昇腾知识图谱。
依托雅安大数据产业园全绿电算力底座,企业自研晨检机器人、智能留样柜等多类终端硬件产品,配套云端SaaS平台与全周期运维服务,覆盖学校、政企、团餐、冷链、农村坝坝宴等多元场景,实现毫秒级风险预警。鸿蒙生态(成都)创新中心是西部地区首个鸿蒙生态专业载体,于2024年6月揭牌,2025年4月展厅正式启用,由鸿蒙生态服务公司运营,是鸿蒙生态官方授权的公共服务平台,锚定成果展示、技术赋能、人才培育、场景落地
9 月 11 日,阿里 Qoder 推出 Mobile Use 插件(Beta):Agent 在修改安卓、鸿蒙、iOS 代码后,可直接在设备或模拟器上运行应用、完成交互并确认修改是否生效。核心能力 / 核心细节:三端各走原生工具链。
一开始觉得是.to('cpu')慢,结果完全不是。性能问题必须用工具定位,Python层面的计时在异步场景下不可靠。尤其是在涉及NPU/GPU异步计算时,不加测出来的时间都是假的。对于ResNet18、MobileNet这种小计算量模型,调度开销是杀手,开启任务队列优化是必须的。MindStudio的Timeline视图非常直观,能精确到每个算子的微秒级耗时。这个工具一定要学会用。同时昇腾NPU首
你可以记录使用华为云码道完成项目开发的实操过程、调试踩坑经验、能力测评感受,多主题可同步创作、多篇内容可自由投稿,用文字记录技术成长,沉淀专属优质技术作品。针对鸿蒙开发者打造,依托华为云码道鸿蒙专属模型,解决 ArkTS 入门难、项目迁移繁琐、元服务开发低效等痛点,助力快速完成鸿蒙应用开发与迭代。面向前端、后端、全栈工程师,聚焦真实项目场景,覆盖从零开发、老旧项目重构、终端开发、规范化工程落地,全
彭博社曝出重磅消息:DeepSeek计划在内蒙古乌兰察布部署至少16万颗华为昇腾950DT芯片,订单约25.6亿美元,建成后将是已知规模最大的国产AI芯片单点集群。本文拆解这笔大单背后的推理成本逻辑、昇腾生态进展,以及国产算力从"可用"走向"规模商用"的拐点信号,并给开发者三点务实建议。
做算力适配的工程师大概都有个体会:这活儿技术上不难,但信息太碎。NVIDIA 的文档是一套体系,海光又是一套,其他各家也有各自的体系。而且每家都在迭代——NVIDIA 把 Docker 仓库迁了,昇腾把 device-plugin 合到 mind-cluster 了,海光的驱动模块名从。
2026年,软领Win解压缩凭借无广告、全平台覆盖(含鸿蒙)及强大功能,荣膺360软件管家“年度工具TOP1”。它支持多格式解压与压缩,内置图片、音视频、PDF、软件压缩及智能证件照制作等“隐藏神技”,实现一站式文件处理。界面简洁、操作流畅,彻底告别传统压缩软件的弹窗困扰,成为免费解压领域的真正黑马。
通过aclrtGetResInCurrentThread接口,结合Stream/Device级核资源限制机制,可精准定位950PR多任务混布中的算子tiled与通信超时问题。优先级为Stream > Device > 硬件默认,配合context_query样例验证资源可用性,排查通信超时(如EI0002、507001)时需检查资源限制是否过低导致任务变慢。详询昇腾知识图谱。
DirectMemoryAccess在SIMD/SIMT与Matmul GM模式中的双重含义。950相较910C扩展了VECOUT/VECIN/LocalTensor等路径,优化融合算子性能;GM模式通用可迁移,但C输出对齐要求为常见踩坑点。选型建议:常规用GM,融合场景用VECOUT,需直接接向量处理则950优先用VECIN或LocalTensor。
精准解析GetMDLConfig参数调优难题:明确doMTE2Preload(N方向预加载)与enUnitFlag(流水并行)在950上的生效条件,避开enableUBReuse等不支持项,结合msOpProf定位瓶颈,实现Matmul性能高效优化。详询昇腾知识图谱。
在昇腾950上使用Matmul高阶API时,若GetTiling()返回-1,常见原因为Tiling空间配置超出硬件约束。需检查SetBufferSpace设置的L1/L0C/UB等缓冲区大小是否充足,优先恢复默认值复测;开启WARNING日志搜索“MatmulApi Tiling”定位失败原因;用MultiCoreMatmulGetTmpBufSizeV2反查实际内存需求;同时确保SOC_VER
灵衢(UnifiedBus)协议栈全链路技术:从物理层到功能层,涵盖URMA、RTP/CTP/UTP、EID/CNA、Jetty及UB内存同步语义;结合950芯片级特性与开源落点(HCCL/hcomm、UB规范、david_v121平台代码),实现对超节点架构、CCU通信、跨域路由等核心能力的精准解析。
掌握950核间同步核心:CrossCoreSetFlag四模式、flagId分配与硬通道边界。实战中需谨防与Matmul API冲突,注意PIPE流水与模板参数一致性,避免非法指令。AIV与AIC间数据交互依赖SSBuffer或注册后中转,直接DataCopyUB2L1将触发错误。详询昇腾知识图谱。
在昇腾A5(950PR/950DT)上使用DataCopyPad时,必须显式指定PaddingMode::Normal模板参数,因不带mode的原型在950上不支持。该接口支持两种模式:Normal(默认,每块补至32字节对齐)与Compact(仅末尾补对齐,适用于非连续stride搬运)。源地址1字节对齐,目的地址需32字节对齐,blockLen等参数需满足约束。启用SetLoopModePar
掌握RegBase算子优化全流程,关键在于正确采集msprof数据,分析OpBasicInfo.csv、PipeUtilization.csv等指标,识别计算/访存/等待瓶颈。优化手法包括VF融合、复杂计算拆分、循环unroll及减少Scalar阻塞,结合IPC(目标1.4+)与流水图诊断,实现从基线44113→1785周期的性能跃升。体系化流程涵盖Tiling建模、卡间/核间/单核流水优化。详询
DeepSeek V4 并非参数堆砌,而是通过 CSA/HCA 混合注意力、mHC 残差连接、Muon 优化器、OPD 专家蒸馏与全流程数值一致性五大重构,实现长上下文效率、万亿 MoE 训练稳定与多领域能力融合的系统性突破。其 100 万 token 上下文推理成本降至 V3.2 的 27%,并首次在昇腾芯片上完成全栈适配,标志着从“能训”到“可复现、可部署”的工程跃迁。
掌握Cast在950中的关键用法:正确设置RoundMode、配合SetCtrlSpr启用饱和、利用VF RegAPI实现寄存器连续计算,避免频繁UB搬运,性能提升1.35倍。重点排查舍入误差、饱和失效与循环内Load/Store瓶颈。详询昇腾知识图谱。
Intern Lumina U2 采用AToken 多码本视觉分词器,以8组离散码本协同编码每个视觉位置,共同描述其语义与细节信息,在可控的 Token 序列长度下提升视觉表示的信息容量与细节表达能力,为理解和生成任务提供更加有效的视觉基础。U2并不是统一模型的终点。未来,昇腾将助力上海AI实验室持续拓展全视觉模态的建模与生成能力,探索更复杂的跨模态任务、交互形式和推理过程,让统一模型进一步拥有“
大模型应用加速落地,企业对算力的需求在性能、规模和供给方式上不断分化,AI 基础设施也逐步走向多元算力并行。不同芯片能否快速接入统一平台,并沿用既有的模型部署和运维体系,正在成为企业评估 AI 基础设施持续演进能力的重要因素。
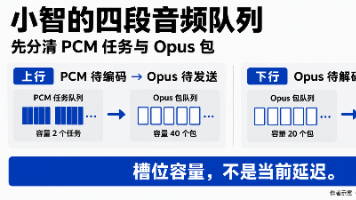
小智(xiaozhi-esp32)是 78 开源的基于 MCP 的 ESP32 聊天机器人,支持 Opus 音频流式传输,2026-08-30 仍在活跃更新,仓库 star 数 29.5k。本文针对小智客户端 `AudioService` 的四段队列——PCM 编码队列(2 任务)、Opus 发送队列(40 包)、Opus 解码队列(20 包)、PCM 播放队列(2 任务)——梳理各自装满时的取舍