
DeepSeek手撕CUDA绑定,昇腾份额反超英伟达:国产AI算力的“破壁时刻“已至
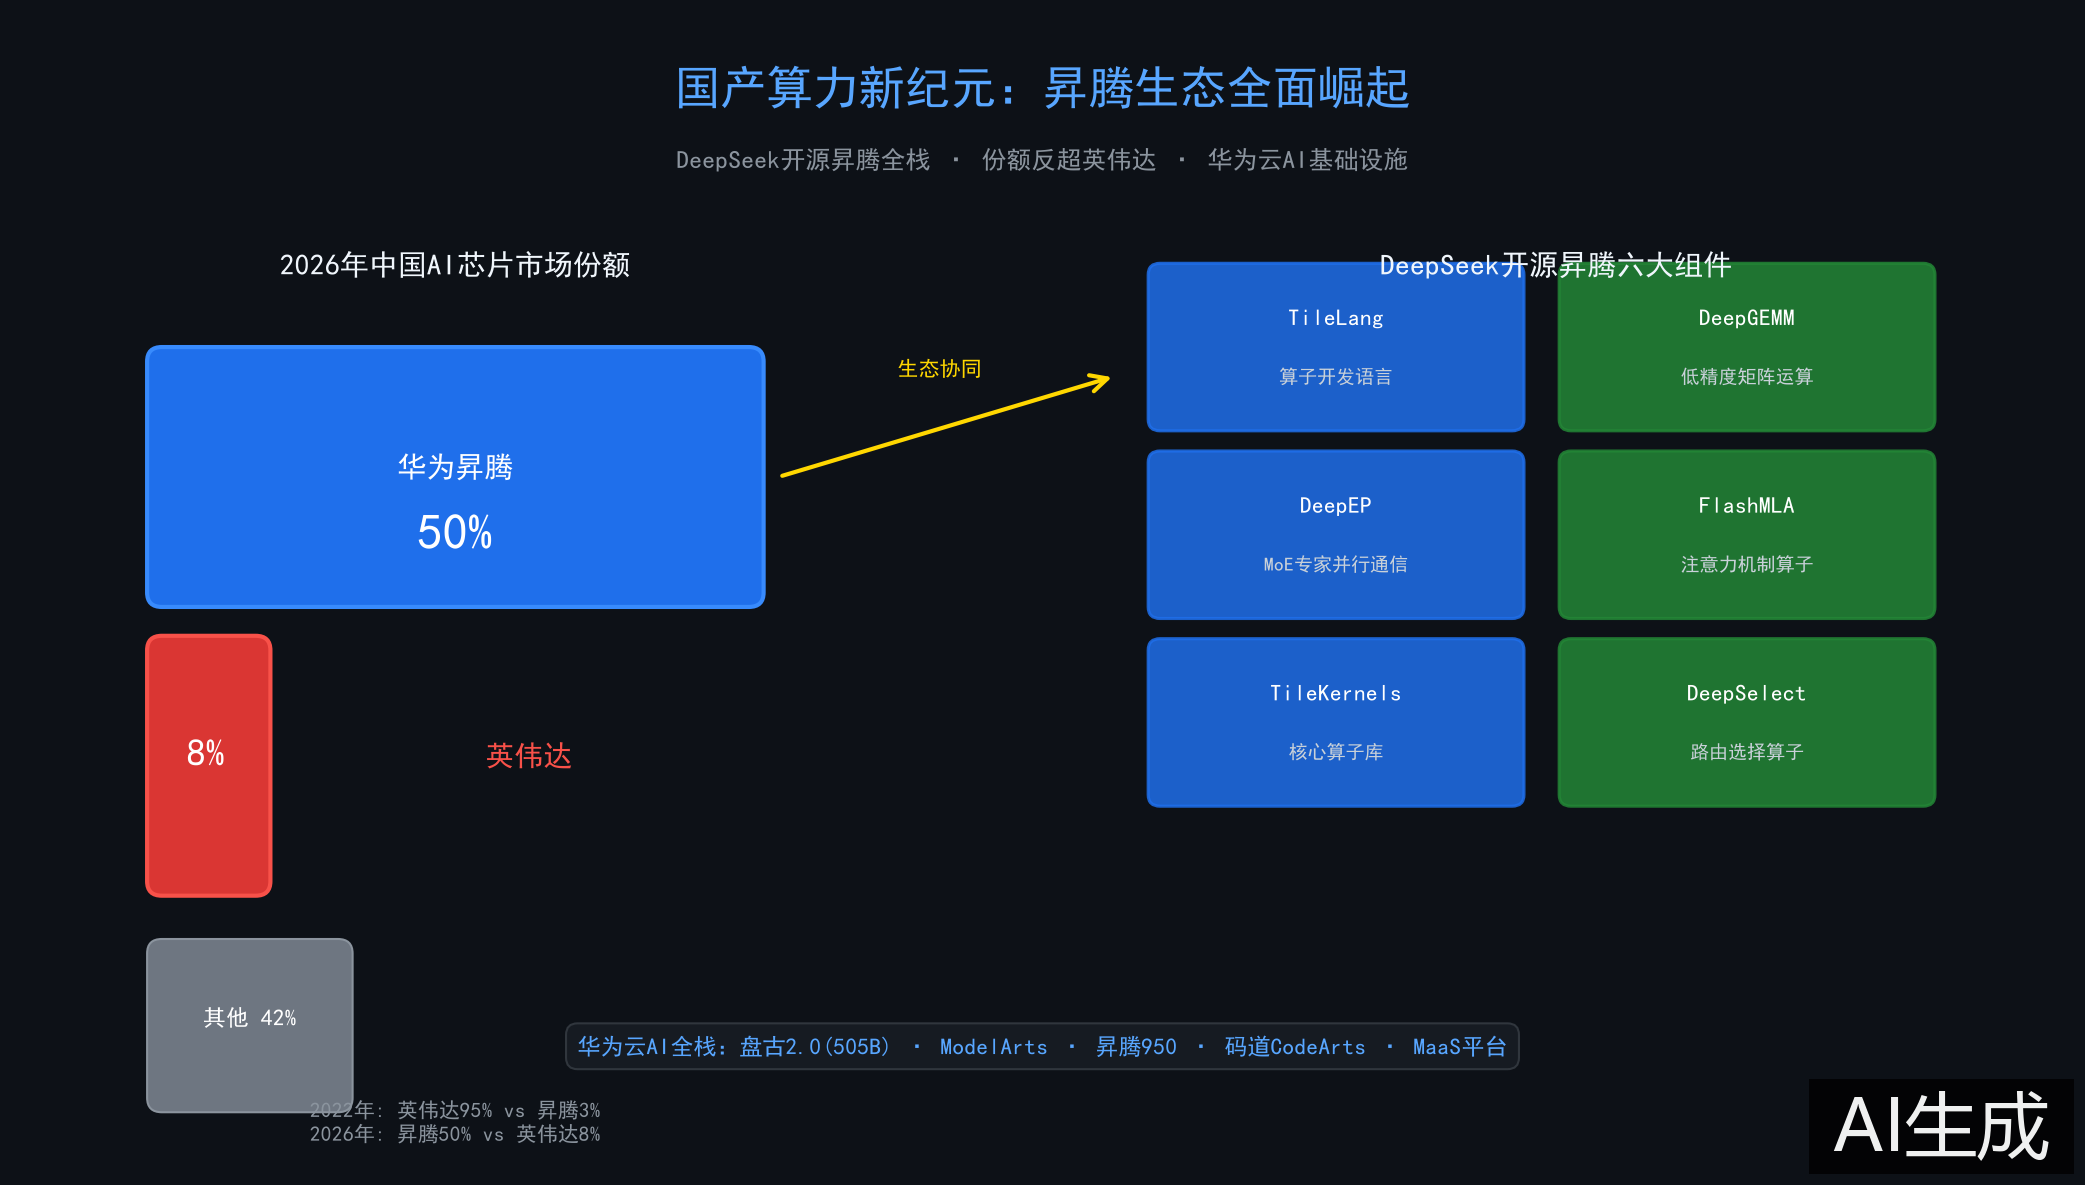
2022年,英伟达独占中国AI芯片市场95%份额,昇腾仅3%。2026年10月,华为轮值董事长徐直军公开宣布:昇腾在中国市场份额已超过英伟达。第三方数据更触目惊心——昇腾约50%,英伟达约8%。四年间,一场彻底的格局逆转悄然完成。而就在同一周,DeepSeek正式开源面向华为昇腾的全套基础设施组件,六大核心库一一对标CUDA生态。这不是巧合,这是国产AI算力生态的"破壁时刻"。
一、从"备胎"到"主力":一场被逼出来的突围
把时间拨回2022年。国内头部互联网大厂、智算中心几乎别无选择——英伟达A800、H800是唯一选项,昇腾只能勉强切入边缘推理场景。彼时的昇腾,在开发者眼中约等于"政策性备胎"。
转折来自外部约束的持续收紧。2023年起,高端AI加速器出口许可不断收紧,后续甚至覆盖了更广泛的计算单元。当海外巨头主动退场,庞大的采购订单必须寻找承接者。华为昇腾凭借多年研发积累的存量和产能迅速补位。
但"补位"不等于"胜任"。真正的考验在于:开发者愿不愿意用?生态跟不跟得上?软件栈够不够成熟?
这就是DeepSeek这次开源的真正意义所在。
二、DeepSeek开源昇腾六大组件:把"国产芯片的软件生态"从零搭起来
2026年9月30日,DeepSeek做了一件在国产AI圈堪称"地震级"的事:把给英伟达GPU写代码的全套工具链,原样铺到了华为昇腾950 NPU上。
这不是简单的"适配"或"兼容",而是成对镜像式的开源——每一层昇腾侧实现都指名道姓地标注了自己在CUDA生态中的对应物:
| 昇腾侧组件 | CUDA侧对应物 | 解决的核心问题 |
|---|---|---|
| TileLang Ascend后端 | TileLang CUDA后端 | 算子开发语言,降低写算子门槛 |
| DeepGEMM-Ascend | DeepGEMM CUDA版 | 低精度矩阵乘法,榨干芯片算力 |
| DeepEP-Ascend | DeepEP CUDA版 | MoE专家并行通信,大模型推理关键路径 |
| FlashMLA-Ascend | FlashMLA CUDA版 | 多头潜在注意力,长上下文推理加速 |
| TileKernels-Ascend | TileKernels NVIDIA版 | 核心算子库,覆盖高频计算模式 |
| DeepSelect-Ascend | DeepSelect CUDA版 | MoE路由选择,专家分配优化 |
这种发布方式在工程上信息量极大。它让开发者可以绕开"国产化"叙事,直接追问一组更硬的问题:CUDA侧这一层究竟在解什么题?昇腾侧要重新解的是同一道题,还是一道同构但不同的题?
答案令人振奋:同一道题,同样的解法,不同的硬件后端。
做过AI底层开发的人都知道,"写算子"是门槛最高、耗时最久的工作之一。一张芯片的理论算力上限很高,但如果底层算子写得不达标,芯片内部计算单元大量时间在等数据流转,几万块钱的芯片可能只发挥出20%的性能。TileLang的价值在于:把底层晦涩的硬件指令包装成人类可读的代码,让开发者不用死磕硬件细节,也能写出高性能算子。
一句话概括:这不是一次普通的开源,而是把"国产芯片的软件生态"从零开始搭起来,并且公开给所有人。
三、行业痛点:CUDA垄断下的三重困境
在DeepSeek这次开源之前,全球AI行业苦CUDA垄断久矣。具体来说,开发者面临三重困境:
痛点一:算子开发"手工作坊"时代
以最常见的矩阵乘法(GEMM)为例,要想榨干一张AI芯片的算力,开发者需要手动管理三级缓存、调度线程块、搞定数据预取流水线,甚至深入到寄存器分块和指令重排层面。这些知识高度绑定CUDA编程模型,换一块芯片就得从头来过。
痛点二:迁移成本高企
2026年4月,DeepSeek-V4选择在昇腾平台首发时,底层代码从CUDA体系整体迁移到华为自研CANN框架,据说涉及200多个算子的重写。这种迁移成本对绝大多数团队来说是不可承受的——不是技术做不到,而是人力和时间不允许。
痛点三:供应链单点风险
当95%的AI算力依赖单一供应商、单一芯片架构、单一软件栈时,任何环节的波动——出口管制、产能瓶颈、价格波动——都会传导到整个产业链。这不是假设,而是2023年以来正在发生的事实。
四、华为云的答案:从芯片到云端的AI全栈基础设施
DeepSeek开源昇腾组件是"破壁"的第一步,而华为云要做的,是让每一个开发者都能在云端直接用起来。
4.1 算力底座:昇腾950 + SuperPoD
华为选择了一条"系统替代单品"的路线。单芯片制程受限,就用Peerium架构和灵衢总线(UnifiedBus)把百万颗处理器连成一台计算机,以集群规模弥补单卡差距。
昇腾950超节点方案已支持大规模芯片对等互连,打破传统主从设计范式,大幅提升大模型训练的模型浮点运算利用率(MFU)。海思首席科学家廖恒博士指出:两年前昇腾最大障碍在于PyTorch与CUDA形成的软件壁垒,但随着新编译器语言不断涌现,前沿实验室已不再过度依赖CUDA,软件差距正大幅缩小甚至趋于平衡。
4.2 大模型底座:开源盘古2.0
2026年HDC大会上,华为发布开源盘古openPangu 2.0,包含Pro和Flash两个版本:
- openPangu-2.0-Pro:总参数量505B,激活参数量18B,支持512K上下文
- openPangu-2.0-Flash:总参数量92B,激活参数量6B
关键优势在于:更亲和昇腾算力,单卡吞吐率可达其他业界主流开源模型的2倍。这不是纸面参数,而是实际推理效率——在昇腾NPU上训练,针对昇腾推理优化,从芯片到模型形成闭环。
余承东坦言,华为自身可用算力相对有限,因此更注重模型在时延、吞吐率等推理效率上的优化。这种"务实路线"恰恰是工程团队最看重的——不是参数最大,而是推理最快、成本最低。
4.3 开发平台:ModelArts Studio + 码道CodeArts
华为云ModelArts Studio提供从提示工程、数据集建设、模型训练到Agent低代码开发的全链路工具。盘古大模型落地实操手册覆盖五大模块:提示词写作、数据集构建、多模式训练、模型调优、Agent开发。
更值得关注的是码道CodeArts代码智能体——搭载GLM-5.2旗舰代码大模型,支持项目级代码生成、续写、研发知识问答、单元测试生成。2026年9月,码道面向鸿蒙开发者全面升级,上线"鸿蒙编码大模型+码道鸿蒙智能体+鸿蒙开发者实践中心"三大核心能力:
- 训练数据覆盖10万+鸿蒙高质量数据,高频开发场景组件100%覆盖
- 千行代码错误率降低80%以上
- 一次编译通过率提升78%以上
- 单次任务Token消耗降低20%以上
4.4 模型即服务:MaaS平台
华为云MaaS平台已接入GLM-5.2、PixVerse V6等多款主流模型,开发者无需自建推理集群,通过API即可调用。这意味着:即使你的团队没有昇腾硬件,也能通过华为云享受到昇腾优化的推理性能。
五、对比分析:国产算力生态 vs CUDA生态
| 维度 | CUDA生态(英伟达) | 昇腾生态(华为) | 差距评估 |
|---|---|---|---|
| 算子开发语言 | CUDA C/C++ | TileLang + Ascend C | TileLang已原生支持,差距快速缩小 |
| 核心计算库 | cuBLAS/cutlass | DeepGEMM-Ascend | 一一对应,能力对标 |
| 通信库 | NCCL | DeepEP-Ascend | MoE场景已覆盖 |
| 注意力算子 | FlashAttention | FlashMLA-Ascend | 长上下文推理已支持 |
| 框架支持 | PyTorch原生 | PyTorch + CANN | 适配完成,原生支持中 |
| 云端服务 | AWS/GCP GPU实例 | 华为云ModelArts+MaaS | 全链路一体化优势 |
| 市场份额(中国) | ~8% | ~50% | 已逆转 |
| 开源模型 | 依赖第三方 | 盘古2.0原生开源 | 软硬协同闭环 |
核心差异点:CUDA生态的优势在于全球开发者惯性和工具链成熟度;昇腾生态的优势在于软硬协同——从芯片(昇腾950)到算子(TileLang)到模型(盘古2.0)到云服务(ModelArts),全部出自同一体系,优化链路更短,迭代更快。
六、给技术从业者的实操建议
如果你正在评估国产算力方案,以下是基于当前生态成熟度的实操路径:
第一步:在华为云MaaS平台上试用盘古2.0模型
不需要购买昇腾硬件,通过API直接调用openPangu-2.0-Flash(92B)或Pro(505B),感受昇腾优化后的推理时延和吞吐率。与同参数量模型对比性价比。
第二步:用ModelArts Studio跑通微调流程
从提示工程入手,逐步过渡到数据集构建和模型微调。ModelArts提供了完整的可视化界面和预置算子,降低了从0到1的门槛。
第三步:评估TileLang算子开发
如果你有自定义算子需求,尝试用TileLang编写一个GEMM算子,对比CUDA版本的开发体验和性能。TileLang的设计目标是"写一次、到处跑",降低多平台维护成本。
第四步:关注DeepSeek-V4在昇腾上的推理性能
DeepSeek-V4已从CUDA整体迁移到CANN框架,是当前昇腾生态最重量级的验证案例。关注其推理延迟、吞吐率和成本指标,作为自身迁移决策的参考。
七、写在最后:从"可用"到"好用"的拐点
2026年10月,不是一个终点,而是一个起点。
昇腾份额反超英伟达,DeepSeek开源全栈组件,盘古2.0模型开源——这三件事在同一时间窗口发生,标志着国产AI算力从"政策驱动的备胎"走向"市场选择的主力"。
但挑战依然真实存在:产能瓶颈(昇腾950连国内需求都喂不饱)、HBM高带宽内存供应紧张、先进封装产能受限。徐直军没有开"庆功会",他给出的判断很克制:产能是当前最真实的瓶颈。
对开发者而言,最好的参与方式不是观望,而是动手。华为云MaaS平台已开放盘古2.0模型调用,ModelArts Studio提供全链路开发工具,TileLang已开源——门槛已经低到一次API调用。
当CUDA的墙被拆掉,剩下的不是空地,而是一片新大陆。而华为云,正在这片新大陆上铺设基础设施。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 2
 0
- 0


 已为社区贡献10条内容

所有评论(0)