
把小智的耳朵搬到板子上:用 sherpa-onnx 跑通本地 VAD + ASR + TTS 的一次完整改造
本篇速览
- 把语音助手的链路从"设备 + 服务器"压成"一块板子",LLM 只是其中一环;本篇处理剩下的三环:VAD(语音活动检测)、ASR(语音识别)、TTS(语音合成)。
- 一个仓库 sherpa-onnx 同时覆盖这三环,外加关键词唤醒、说话人识别与分离、语音增强、标点恢复,且提供 12 种语言绑定,省去各引一个库的麻烦。
- 它的 README “Supported NPUs” 表明确列出 Qualcomm NPU (QNN)、Rockchip NPU、Ascend NPU、Axera NPU、Intel NPU (OpenVINO) 五类加速——同一份 ONNX 模型有机会走硬件算子卸载。
- 改造不是一次全换:VAD / ASR / TTS 各自独立验证,再串联;接口差异(采样率、通道数、字节序、流式块大小、回调 vs 轮询)是主要工作量。
- 三条边界必须写明:小语种/方言识别质量、TTS 音色数量与自然度、NPU 不可用时必须有 CPU 回退路径。
一、目标与基线
1.1 改造命题
第一章把小智的 LLM 大脑换成了板上的本地服务(OpenAI 兼容接口,改 base_url 指向本机)。但那时声音还是"借来的":VAD、ASR、TTS 三环要么走云端接口,要么走另一台机器上的服务。
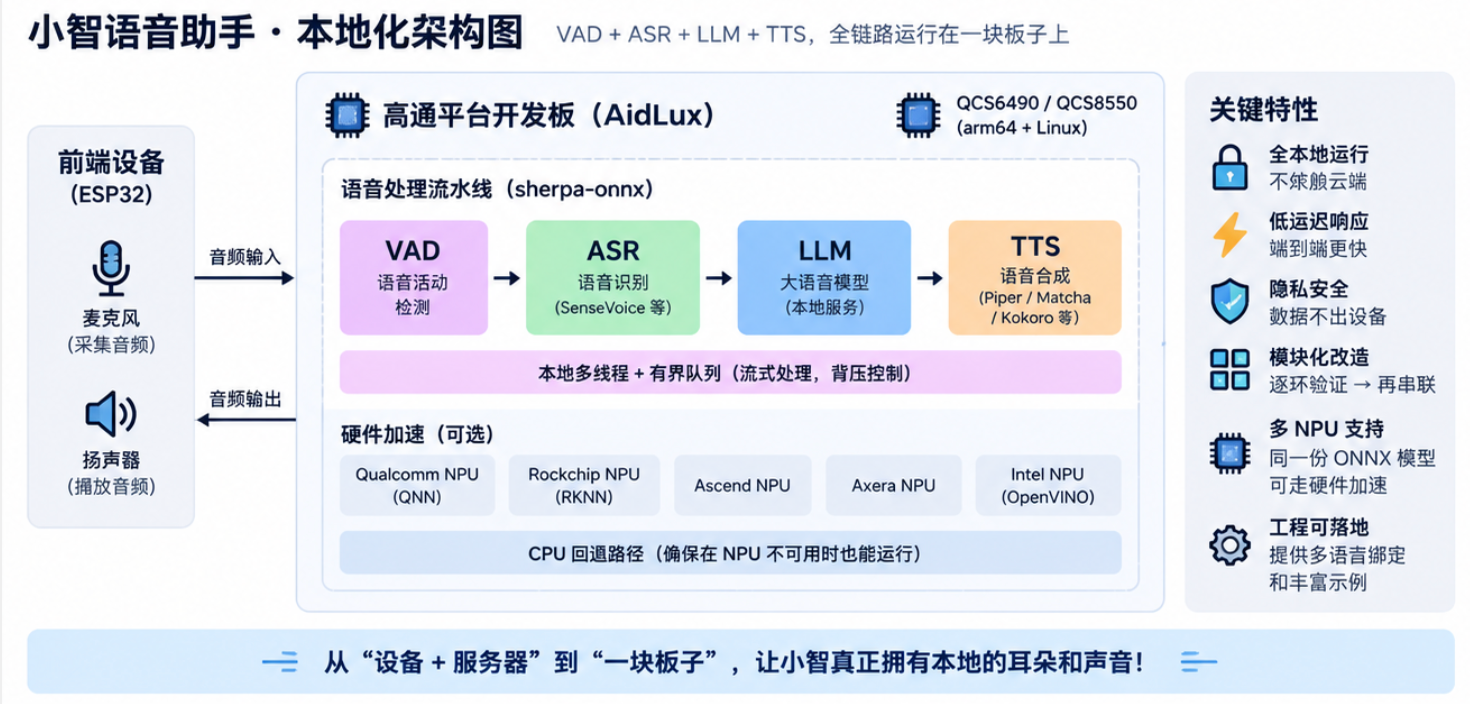
本篇接着把耳朵和声音也搬过来,让整条链路真正落在一块板子上。目标结构从原来的
ESP32(采集/播放) ──音频──▶ 服务器(VAD→ASR→LLM→TTS) ──结果──▶ ESP32
变成
板子(采集/播放 + 本地 VAD→ASR→LLM→TTS→本地播放)
这里的"板子"沿用第一章的设定:一块跑 AidLux 的高通平台开发板(QCS6490 或 QCS8550 档),LLM 已由本地服务承担。本篇不重复 LLM 部分,只讲 VAD/ASR/TTS 三环的本地化,并在结尾与第一章的 LLM 数字串成整链路。
1.2 为什么选 sherpa-onnx 而不是各引一个库
语音链路如果每环引一个库,会出现三个麻烦:依赖版本互相打架、C/C++ 与 Python 的胶水代码各写一套、出问题时不知道是哪环的锅。sherpa-onnx 用同一个 ONNX Runtime 后端把多环收敛到一个库里,配套的语言绑定和示例也统一了,工程上更省心。
更重要的是对照实验干净:第一章的原链路 ASR 用的是 FunASR 的 SenseVoice。sherpa-onnx 自带 sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17——和原方案同一族模型。同一族模型、一条走 FunASR 服务端、一条走本地 ONNX 推理,这种对照最有说服力,因为变量被控制到了最小。
1.3 基线要记什么(改造前)
动手前先在小智原架构上跑一遍,记录三件事,作为后面对照的分母:
| 记录项 | 记什么 | 怎么记 |
|---|---|---|
| 链路形态 | 音频去哪、结果怎么回、走没走网络 | 画一张原链路拓扑图 |
| 各环耗时 | VAD 判定、ASR 识别、TTS 合成各多少毫秒 | 在链路里打时间戳 |
| 资源占用 | 服务端内存、CPU 占用 | free -h、top |
这些基线数字属于引用或推算范畴,写稿时须标注"引自项目文档/原链路实测占位",不得当作本方案实测。本篇的对照表会在真机跑通后填入实测列,发布前不许留空。
1.4 编排骨架:三环之间靠什么连起来
串联三环时,最容易低估的是"环与环之间的数据交接"。小智原服务端是 VAD→ASR→LLM→TTS 的句级流式,本篇沿用第一章的"本地多线程 + 有界队列"骨架。具体来说,每个环节是一个独立线程,环节之间通过有界队列传递音频块或文本:
采集线程 → [原始音频队列] → VAD 线程
VAD 线程 → [语音段队列]  → ASR 线程
ASR 线程 → [文本队列]    → LLM(第一章已做)
LLM     → [回复文本队列] → TTS 线程
TTS 线程 → [音频队列]    → 播放线程
"有界队列"是关键:队列满了就背压,避免某一环突然变慢把内存撑爆。比如 ASR 偶发卡顿,原始音频队列会堆积,采集端应停止入队或丢最旧帧,而不是无限增长。这个骨架在第一章讲 LLM 时就定下了,本篇只是把 VAD/ASR/TTS 三个新环节塞进对应位置,而不是另起一套。
二、环境调研
2.1 项目是什么(事实层,取自 README 与仓库元数据)
sherpa-onnx 是新一代 Kaldi(k2-fsa)社区维护的端侧语音推理框架,用 ONNX Runtime 做推理。按 README 的明确表述,它覆盖的任务包括:ASR(流式与非流式)、TTS、VAD、说话人识别与分离、说话人确认、口语语言识别、语音增强、音源分离、关键词唤醒、标点恢复、音频标记。仓库元数据(GitHub API)显示约 15.1k star,C++ 实现,Apache-2.0 许可,最近 Release 为 v1.13.8(2026-09-10)。
数据归属:star 数、许可证、版本号取自 GitHub 仓库元数据,核实日期 2026-10-08。发布前建议再核一次,因为项目迭代快。
2.2 平台与语言绑定(为什么它能落地到板子)
README 的 “Supported platforms” 表覆盖五种架构(x64 / x86 / arm64 / arm32 / riscv64)与六个操作系统(Windows / macOS / Linux / Android / iOS / HarmonyOS),其中 riscv64 标注为"仅 Linux"。语言绑定明确列出 12 种:C++、C、Python、JavaScript、Java、C#、Kotlin、Swift、Go、Dart、Rust、Pascal(Object Pascal),并注明支持 WebAssembly。
对高通平台开发板而言,关键点是 arm64 + Linux 这一格是明确打勾的,Python 和 C++ 绑定也都可用。这意味着无论上层用 Python 编排还是用 C++ 集成,都有原生路径,不用自己造轮子。
2.3 NPU 支持(与硬件主线最契合的一点)
README 的 “Supported NPUs” 表明确列出五类加速:
| NPU | 备注 |
|---|---|
| Qualcomm NPU (QNN) | 我们的高通平台正落在这里 |
| Rockchip NPU (RKNN) | 瑞芯微平台 |
| Ascend NPU | 昇腾 |
| Axera NPU | 爱芯元智 |
| Intel NPU (OpenVINO) | 英特尔核显/加速 |
这一点是本次选型里与系列硬件主线最贴合的事实。但须注意:README 写的是"支持",不等于"每个模型在每个 NPU 上都开箱即用"。能否真正卸载到 QNN,取决于模型是否经过对应 EP(Execution Provider)的导出与验证。本文把 NPU 路径作为可选加速,主线仍按 CPU 推理走通,NPU 作为对照实验。
2.4 模型清单怎么看
README 的 “Some pre-trained ASR models” 分 Streaming(流式) 与 Non-Streaming(非流式) 两张表。几个对本篇有用的型号:
- 流式
sherpa-onnx-streaming-zipformer-bilingual-zh-en-2023-02-20(中英双语);以及...-zh-14M-2023-02-23,README 注明 “Suitable for Cortex A7 CPU”(面向极低端 CPU,可作为板端轻量候选)。 - 非流式
sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17(多语言、含中文方言,与第一章 FunASR 同源);sherpa-onnx-paraformer-zh-2024-03-09(中文,支持多种方言)。 - VAD 模型文件名明确给出:
silero_vad.onnx。 - TTS 模型在 README 的示例集中出现的是 Piper(英/德)、Matcha(中/中英/英)、以及第三方项目描述的 Kokoro-82M 与 VITS;TTS 的预训练模型总入口是一个 release tag
tts-models。
选型策略:先用非流式 SenseVoice 做"先跑通"的基线(与第一章对照最直接),再上流式 Zipformer 做"边说边出字"的体验版本。TTS 先用预训练英文 Piper 验证链路,中文再换 Matcha 或 Kokoro 系。
2.5 安装方式(以官方文档为准)
README 片段未给出具体的 pip 命令与 PyPI 包名,安装方式以项目文档站为准。本文不写死安装命令,避免版本漂移带来的误导;真机部署时按官方文档站的当前写法执行,并把实际版本写入 env.txt。
2.6 怎么确认 NPU 到底有没有用上
这一节是很多"号称支持 NPU"的改造最后翻车的地方:代码里写了 EP,日志里也没报错,但你不能确定算子真的跑了 NPU 还是悄悄退回了 CPU。可做的确认步骤:
- 加载时显式指定 EP(如 QNN),并打开 ONNX Runtime 的算子落点日志,看关键算子是否落在 QNN 而非 CPU。
- 对比同一段音频在"强制 CPU"与"启用 QNN"下的耗时与功耗——如果两者一致,基本说明 NPU 没真正参与。
- 看进程是否真的拉起了 NPU 相关的动态库与驱动节点(如
/dev下相关设备、进程 maps 里出现的厂商库)。
只有这三点能交叉印证,才能写"NPU 加速已生效"。否则一律按"CPU 路径验证"来汇报,NPU 作为"待复测"项,不夸大。
2.7 许可证为什么对改造友好
sherpa-onnx 采用 Apache-2.0。对要把改造落地到产品里的团队,Apache-2.0 与 MIT 一样宽松,但多了一条明确的专利授权条款,在遇到专利纠纷时能提供额外保护。这一点在选型时值得记一笔——很多团队只关心"能不能免费用",忽略了许可证的专利维度。本文不替你做法律结论,但会把它作为选型事实标清楚,方便后续走内部开源合规流程。
三、操作步骤
3.1 总体顺序:逐环验证再串联
不要一次性把三环都换掉。正确顺序是:
第 1 步  VAD 单独验证      能稳定判定"有人说话/没人说话"
第 2 步  ASR 单独验证      非流式先通,再上流式
第 3 步  TTS 单独验证      能合成一个 wav 并播放
第 4 步  三环串联           VAD → ASR → (LLM,第一章已做) → TTS
第 5 步  整链路验证         说一句,听到回答
每一步都先确认"这一环本身对",再进下一步。否则三环同时上,出问题不知道该怪谁。
3.2 第 1 步:VAD 验证
VAD(语音活动检测)的作用是告诉后续环节"用户开始说话了 / 说完了"。这一步看似简单,却是实时链路里最影响体验的一环——阈值太松会误触发,太紧会切掉句首句尾。
sherpa-onnx 的 VAD 模型是 silero_vad.onnx。验证要点:
- 确认它能区分"环境噪声"和"真实语音",在安静与有背景声两种条件下各测几轮。
- 记录判定延迟:从用户开口到 VAD 给出"开始"标记,这段延迟直接进入首字体验。
- 关注三个参数的实际影响(坑点一节展开):语音阈值、静音判定时长、最小语音段。
3.3 第 2 步:ASR 验证
先把非流式跑通,因为它最容易判断"识别对不对":录一段完整音频,丢进去,看输出文本。用 SenseVoice 非流式模型能直接和第一章的 FunASR 基线对照——同一族模型、不同推理后端,变量最小。
再上流式:流式 ASR 的输入不是完整音频,而是切成小块不断喂入,边喂边出字。需要确认两块:一是"块大小"怎么选(块太大延迟高、太小开销大),二是"边说边出字"的呈现怎么做。
3.4 第 3 步:TTS 验证
TTS 单独验证的判据是"能合成一个可播放的 wav"。注意两个前置:一是采样率对齐(模型输出采样率要和声卡的播放采样率一致,否则要么变调要么播放失败),二是文本前端(中文要先把字转成音素/拼音,这一步 sherpa-onnx 的 TTS 示例通常需要搭配一个 g2p 工具)。
3.5 第 4 步:三环串联
串联的编排沿用第一章的"本地多线程 + 有界队列"骨架(小智原服务端也是 VAD→ASR→LLM→TTS 的句级流式)。差别在于:第一章的 LLM 已经是本地服务,本篇把 VAD/ASR/TTS 也换成板上的本地调用。
数据流变成:
麦克风 → VAD(本地) → ASR(本地) → LLM(本地 OpenAI 兼容服务)→ TTS(本地) → 扬声器
没有一个环节出板子。断网、断外设以外的部分,整套依然能跑——这正是后面验证"离线可用"的依据。
3.6 第 5 步:整链路验证
最后做一轮真实对话:说一句"今天天气怎么样",听到一个本地合成的回答。验收分两级(沿用第一章纪律):
- 链路级:每一环都返回了,没有静默失败。
- 体验级:首字延迟、整轮延迟在可接受范围,识别准确、合成能听。
3.7 跨环节的数据格式契约
三环能串起来,靠的是一份隐形的"数据格式契约"。每一环对输入音频的要求必须被显式约定,而不是各环自己猜:
| 环节 | 期望采样率 | 通道数 | 字节序 / dtype | 来源 |
|---|---|---|---|---|
| 采集 | 设备原生(常为 48000) | 1(单声道) | int16 小端 | 声卡 |
| VAD | 16000 | 1 | float32 | 模型要求 |
| ASR | 16000 | 1 | float32 | 模型要求 |
| TTS 输出 | 模型决定(如 22050) | 1 | float32 / int16 | 模型决定 |
| 播放 | 声卡支持(常为 48000) | 1 | int16 小端 | 声卡 |
这份表里凡是有不一致的地方,都要在链路上做显式转换(重采样、改通道、转 dtype),并写清楚"谁负责转换"。遗漏任何一格,都会在某一环出现"能跑但效果怪"的玄学问题。
四、关键代码(接口形态,非完整工程)
下面给出接口形态片段,用于说明调用方式。完整工程以官方示例为准;以下片段里的模型路径、采样率为示意,真机请替换为实际值。
4.1 VAD 的调用形态(Python)
# 接口形态示例:sherpa-onnx 的 VAD 通过配置对象传入模型文件
# 实际 API 以官方文档当前版本为准
vad_config = {
    "model": "silero_vad.onnx",
    "threshold": 0.5,          # 语音判定阈值
    "min_silence_duration_ms": 700,   # 静音多久算"说完了"
    "min_speech_duration_ms": 250,   # 至少要说这么久才算语音
}
# 伪代码:把音频小块喂入,得到"开始/结束"事件
# vad.accept_waveform(sample_rate, chunk)
# events = vad.frontend_proc()
要点:阈值和静音时长是最该调的两个量。阈值决定"多小的声音算语音",静音时长决定"停顿多久切句"。这两个值在不同环境(安静房间 vs 有电视声)下该分别调,不存在放之四海皆准的取值,要按场景记录。
4.2 ASR 的调用形态(非流式 → 流式)
# 非流式:整段音频一次识别
asr_config = {
    "model": "sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17/model.onnx",
    "tokens": "tokens.txt",
    "language": "auto",          # 或显式 zh / en
}
# result = asr.decode(waveform, sample_rate)

# 流式:逐块喂入,边喂边出
# stream = asr.create_stream()
# stream.accept_waveform(sample_rate, chunk)
# while stream.has_pending_result():
#     text = stream.get_result()
非流式适合"录完再说",流式适合"边说边出字"。两者不是二选一,而是体验分层:对短指令用流式更跟手,对长段听写用非流式更稳。
4.3 TTS 的调用形态
# 接口形态示例(实际 API 以官方文档为准)
tts_config = {
    "model": "vits-xxx/model.onnx",
    "tokens": "tokens.txt",
    "vocab": "vocab.txt",
    "sample_rate": 22050,        # 必须与播放采样率对齐
}
# audio = tts.generate(text)
# play(audio, sample_rate=22050)
关键判据:TTS 模型的输出采样率和声卡播放采样率必须一致。不一致时的表现要么是播放失败,要么是音调异常(类似快进/慢放)。这一项在坑点一节单独讲。
五、坑点
5.1 采样率与格式不一致(最高频)
端侧语音链路里有三处采样率,必须对齐:麦克风采集的采样率、ASR/VAD 模型要求的采样率、TTS 模型输出与声卡播放的采样率。任何一个不一致,轻则识别率下降,重则直接报错。
排查方式:先确认每个模型的文档要求(sherpa-onnx 的模型 README 通常写明 input sample rate),再确认链路里有没有做重采样。如果模型要求 16000Hz 而你喂了 48000Hz,需要在喂入前做一次重采样,而不是指望模型自己处理。一个简单的重采样片段:
import numpy as np
def resample_48k_to_16k(int16_48k):
    # 示意:把 48000Hz 的 int16 音频重采样到 16000Hz
    f = int16_48k.astype(np.float32) / 32768.0
    # 实际用 resampy / soxr 等库做高质量重采样,这里只表达意图
    ratio = 16000 / 48000
    n = int(len(f) * ratio)
    f16 = np.interp(np.linspace(0, len(f) - 1, n), np.arange(len(f)), f)
    return (f16 * 32768.0).clip(-32768, 32767).astype(np.int16)
重点是:重采样这一步必须存在且被正确调用,而不是依赖"模型应该能处理"。
5.2 路径与权限(改造类通病)
模型文件较大、下载耗时,很多人用 root 下载到 /opt 或 /root 下,然后以普通服务账号运行——结果打不开。排查时逐级看路径权限(namei -l <完整模型路径> 能一眼看出哪一级缺权限),不要只在模型文件本身上看。
另一个通病是相对路径:托管运行时的工作目录和手动执行时不同,相对路径解析结果不同。模型路径一律写绝对路径,这是第一章就强调的硬规矩,本篇再次适用。
5.3 NPU 不可用时的回退
NPU 路径是锦上添花,不是前提。必须保证:当 NPU 不可用(模型未适配、驱动缺失、EP 加载失败)时,能自动回退到 CPU 推理。否则会出现"在开发机上能跑、到某块板子上就崩"的尴尬。
实现上,加载时先尝试带 EP 的配置,捕获异常后回退到纯 CPU 配置。回退路径要在真机上显式验证一次,而不是只在代码里写了 try。
5.4 流式块大小与前瞻
流式 ASR 把音频切成小块喂入。"块大小"和"前瞻窗口"决定延迟与准确率:块太大,用户说完了还要等一块传完才出字;块太小,上下文不足、识别抖动。这一步没有理论上的标准取值,要在真机上用几段不同长度的语音试出来,并记录下来。
5.5 中英混说与方言
SenseVoice 模型标注支持中文、粤语、英语、日语、韩语,但"支持"和"在你这个口音/场景下达标"是两回事。方言、中英混说、专有名词(人名、设备名)是实测最容易翻车的点。验证时要专门准备一组"带口音 + 混说 + 专有名词"的测试句,而不是只念标准普通话。
5.6 静音切句与"说的太快被吞"
min_silence_duration_ms 设得太短,会把正常停顿当成句尾,一句话被切成两句;设得太长,用户说完还要等很久才出结果。这个值要和"用户对响应速度的容忍度"一起调,最好做成可配置、按场景切换。
5.7 一个排障决策树
当三环串联后"没声音"或"识别不动"时,按下面顺序定位,能省掉大量瞎试:
能采集到音频吗?(存一段 wav 听) ──否──▶ 声卡/权限问题
      │是
VAD 有"开始/结束"事件吗? ──否──▶ VAD 阈值/采样率问题
      │是
ASR 出文本吗?(脱离 LLM 单独喂音频) ──否──▶ ASR 模型/采样率问题
      │是
LLM 出回复吗?(第一章已验证) ──否──▶ 回第一章
      │是
TTS 出 wav 吗?(存下来听) ──否──▶ TTS 采样率/文本前端问题
      │是
能播放吗? ──否──▶ 播放采样率/声卡问题
这个树的核心思想是:每一环都能脱离上下游单独验证。任何一环不能单独跑通,就不要先急着串联。
5.8 ONNX Runtime 版本与算子兼容
sherpa-onnx 依赖 ONNX Runtime 做推理,但模型是用某个版本的 ORT 导出的。板子上的 ORT 版本如果太旧,可能缺少模型用到的算子,表现为"operator X is not registered"或"unsupported op"之类报错。排查方向有两个:看模型导出时依赖的 ORT 版本,板子上用不低于该版本的 ORT;或者反过来,用板子上的 ORT 版本重新导出模型。这条在跨平台搬运时尤其容易踩——在 x86 开发机上能跑,到 ARM 板子上同一个 ORT 版本号却可能因为构建选项不同而缺算子,不要想当然认为"版本号一样就一样"。
六、验证
6.1 逐环验收(先小后大)
- VAD:在安静与有噪声两种环境下,各录 10 段,统计"漏唤醒"(该触发没触发)与"误触发"(不该触发却触发)的次数。
- ASR:准备一组固定测试句(含方言、混说、专有名词),统计字错误率(CER)与句正确率。
- TTS:合成一组固定文本,主观听感打分(自然度、有无破音),并记录合成耗时与首帧延迟。
6.2 整链路验收
跑一轮真实对话,记录端到端延迟各段占比:
| 段 | 改造前(引用/推算) | 改造后(实测,待真机填入) | 测量条件 |
|---|---|---|---|
| VAD 判定 | 200-400ms(引用小智文档) | 待真机填入 | 安静/噪声 |
| ASR 识别 | 500-800ms(引用) | 待真机填入 | 固定测试句集 |
| LLM 首 token | 300-600ms(引用) | 第一章已测,待回填 | 同第一章条件 |
| TTS 首帧 | 200-400ms(引用) | 待真机填入 | 固定文本 |
| 端到端 | 1000-1300ms(引用,区间 800-1800) | 待真机填入 | — |
引用数据引自小智项目公开文档(配置 FunASR + Qwen2.5-72b-Instruct + CosyVoice),属引用而非本方案实测。改造后的实测列必须在真机跑通后填入,发布前不许留空,也不许用引用数据冒充实测。
6.3 离线验证(优势的硬证据)
拔掉网线(或关闭外网),跑一轮对话。如果三环都在本地、LLM 也已本地化,整链路应当不受影响——这正是"数据不出设备 + 离线可用"两条优势的直接证据。把拔网线前后的延迟对照贴在文里,比任何形容词都有力。
6.4 一次端到端走查示例(数字为引用/推算,标注清楚)
为了把"延迟怎么累加"讲透,这里用一组引用/推算的数字做一次走查(非本方案实测,仅演示累加逻辑):
用户开口 → VAD 判定开始:+300ms(引用区间中值)
VAD 段内语音 → ASR 识别:+650ms(引用区间中值)
ASR 文本 → LLM 首 token:+450ms(引用区间中值)
LLM 后续生成(一句):+400ms(推算,按生成吞吐估算)
LLM 文本 → TTS 首帧:+300ms(引用区间中值)
TTS 整句合成:+350ms(推算)
────────────────────────────
估算端到端:约 2450ms(注意:这是"引用+推算"的混合,仅用于说明累加结构)
注意最后一行是引用 + 推算的混合,必须在真机实测后用纯实测数字替换,不能把这段推算直接当实测发表。它的价值只在于让你看清"延迟不是某一环的责任,而是五段叠加",优化时要找占比最大的一段下手。
七、资源预算(板子上的空间与算力账)
把三环搬上板子之前,要先算清楚"装不装得下、跑不跑得动"。第一章算的是 LLM 的内存账,本篇的三环是在那本账之外再叠一层。这一节给出可复用的预算方法,所有数字都标为推算,必须用真机实测替换。
7.1 三环一起跑要占多少内存
| 组件 | 量级(推算) | 说明 |
|---|---|---|
| VAD(silero_vad) | 数 MB 级 | 模型很小,几乎可忽略 |
| ASR(SenseVoice 非流式) | 数百 MB 级 | 权重为主,是语音三环里的大头 |
| TTS(VITS/Matcha 类) | 数十至数百 MB 级 | 取决于音色与模型 |
| ONNX Runtime 运行时 | 数十 MB 级 | 与模型共享 |
| LLM(第一章) | 另算 | 已在内存账里单独列过 |
叠加时不是简单相加——ONNX Runtime 与 aidllm 的运行时、操作系统的缓存都会占一份。务实做法是:先在板子上只加载三环(不加载 LLM),用 free -h 看空闲内存前后差,得到三环的真实占用;再加上第一章 LLM 的实测占用,才是"全本地链路"的总账。两者之和必须明显小于板子可用内存,留出系统与其他任务的余量。
7.2 存储账
模型文件是存储的主要消耗者。ASR 的非流式模型常为数百 MB,TTS 的模型与音色文件另计,VAD 很小。再加上 AidLux 系统本身与你的应用,板载存储要预留足够空间。具体数值以你下载的模型版本为准,下载后用一个命令记录真实体积并写入 env.txt,不要凭印象填。
7.3 CPU 占用与散热
VAD、ASR、TTS 三个线程加上第一章的 LLM 推理,会争夺同一组 CPU 核心。语音链路是"常驻"的(一直在听),它对核心的占用会和 LLM 的生成任务打架,表现为说话时 LLM 变慢,或反之。板子没有主动散热时,持续高负载会触发降频,后半段任务普遍变慢。
测量方法:分别记录"空闲"“仅语音链路常驻”"语音链路 + LLM 对话"三档下的 top CPU 占用与表面温度(或 /sys/class/thermal 下的温度节点)。只有拿到这三档数据,才能判断"常驻语音链路"对整机的代价有多大,进而决定要不要给 VAD/ASR 限核、或把某些环节挪到更低优先级。
7.4 一个可复用的预算模板
把上面三张账收敛成一张记录表,每次换板子或换模型都重填:
| 项 | 测量命令 | 记录值 | 备注 |
|---|---|---|---|
| 三环内存占用 | free -h 前后差 | 待填 | 不含 LLM |
| 全链路内存占用 | free -h 前后差 | 待填 | 含 LLM |
| 模型存储总体积 | du -sh <模型目录> | 待填 | 写入 env.txt |
| 常驻 CPU 占用 | top | 待填 | 仅语音链路 |
| 负载下温度 | thermal 节点 | 待填 | 决定要不要限核 |
这张表的价值在于:下次换更小模型或换板子,直接对照就能判断"能不能上",而不是凭感觉。
八、常见问题(FAQ)
问:sherpa-onnx 能在一块高通开发板上跑吗?
arm64 + Linux 这一格在 README 的 Supported platforms 表里是明确支持的,Python 和 C++ 绑定都可用。能否卸载到 Qualcomm NPU (QNN) 取决于具体模型是否经过对应 EP 验证,主线建议先按 CPU 推理跑通,NPU 作为对照加速。
问:语音识别一定要流式吗?
不一定。短指令用流式更跟手,长段听写用非流式更稳。两者可以并存,按场景切换,不是二选一。
问:为什么 TTS 和 ASR 的采样率要单独对齐?
因为 TTS 模型有自己的输出采样率,声卡也有播放采样率,ASR/VAD 模型有要求的输入采样率。任两处不一致都会导致识别率下降或播放异常,必须在链路里做明确的重采样与对齐。
问:SenseVoice 模型和 FunASR 的 SenseVoice 是同一个吗?
是同一族模型。sherpa-onnx 自带 sherpa-onnx-sense-voice-zh-en-ja-ko-yue-2024-07-17,与第一章原链路的 FunASR SenseVoice 同源,因此可以做"同一模型、不同推理后端"的干净对照。
问:模型文件很大,放在哪、用什么权限?
绝对路径、放服务账号能读的位置。常见坑是用 root 下载到 /opt 或 /root,再以普通账号运行导致打不开。逐级看路径权限(namei -l)能快速定位。
问:NPU 加速一定要上吗?
不是前提。NPU 是可选的加速路径,主线应按 CPU 推理跑通;NPU 不可用时必须有 CPU 回退,且回退路径要在真机上验证过。
问:怎么判断 NPU 是不是真的用上了?
只看代码里写了 EP 不够。要做三件事交叉印证:打开算子落点日志看关键算子是否落在 QNN、对比强制 CPU 与启用 QNN 的耗时与功耗、检查进程是否真拉起了厂商库与驱动。三者一致才能下结论。
问:串联后"没声音",第一步该查什么?
按排障决策树从采集端往上查:先确认能采到音频(存 wav 听),再确认 VAD 有事件、ASR 出文本、TTS 出 wav、最后能播放。每一环都能脱离上下游单独验证,任何一环不能单独跑通就先别串联。
问:改造后识别或音质变差了,怎么定位是哪环?
用"逐环隔离"法:把每一环的中间产物落盘——VAD 落语音段 wav、ASR 落识别文本、TTS 落合成 wav,然后每段单独听/看。哪里单独看就差,锅就在哪环;单独看都好、串起来差,问题在交接(采样率/格式/队列)。这比整体试错快得多。
问:能不能只本地化 VAD+ASR,TTS 仍走云端?
可以,而且是对"离线不是硬需求、但想省云端 ASR 费用"场景的务实折中。但要注意:只要 TTS 还出设备,链路就不满足"数据不出设备",且断网时仍会哑。本文把三环全本地作为闭环目标,中间态由你按产品需求取舍,取舍要在文章里写清。
问:改造后延迟比云端慢很多,正常吗?
正常,而且是预期内的取舍。本地链路把计算从云端搬到了算力弱得多的板子上,单环延迟通常会高于云端。换来的是离线可用、数据不出设备、零调用成本。如果延迟超出体验阈值,优化思路是找端到端走查里占比最大的一段(往往是 LLM 生成或 ASR),而不是笼统地"换更快的库"。
九、结论与可带走物
本篇把小智链路里"耳朵和声音"三环(VAD、ASR、TTS)搬到了板子上,和第一章已本地化的 LLM 合起来,整条链路不再出板子。选型用一个仓库(sherpa-onnx)收敛三环,省掉了多库依赖与多套胶水代码;它 README 明确列出的 Qualcomm NPU (QNN) 支持,又给后续的性能优化留了口子。
可带走的产出有四份:
- 逐环验证顺序(VAD→ASR→TTS 各自先通再串联),避免"三环同时上、出问题不知道怪谁"。
- 对照表模板(6.2 节),引用基线已填、实测列待真机填入,发布前不许留空。
- 两个通病清单:采样率/格式对齐、路径与权限——这两类在改造类项目里反复出现。
- 一份数据格式契约表与排障决策树:把"环与环之间传什么"和"出问题先查哪"固定下来,比凭直觉排查省力得多。
三条边界再强调一次:小语种与方言的识别质量需要专门测,不能想当然;TTS 的音色数量与自然度通常不如云端服务,这是取舍不是缺陷;NPU 路径务必有 CPU 回退,且回退要在真机验证。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)