
【HCIA- AI(正课)】练习题和解析
判断题
- PyTorch、MindSpore等Al开发框架通常提供内置的数据处理功能用于数据采集、数据清洗、特征选择和归一化等操作。✅
LSTM是改进版RNN。序列很长的时候,RNN 记不住很早之前的信息。
LSTM 专门解决原生 RNN长序列训练时的梯度消失问题,擅长学习长距离的时序信息。
原文要点
PyTorch:torch.utils.data、torchvision.transforms 提供数据加载、清洗、归一化等预处理;
MindSpore:mindspore.dataset 数据集引擎,内置数据变换、归一化、数据增强流水线。
AI开发框架不只是搭建神经网络,自带一整套数据处理能力。
记忆方法
框架自带数据预处理工具箱,归一化、数据变换都是内置功能。
- LSTM的遗忘门决定了从细胞状态中丢弃哪些信息,丢弃弃的信息将其系数置为0,保留的信息系数置为1。❌
原文要点:
LSTM 遗忘门通过 Sigmoid 激活函数输出 0 到 1 之间的数值,是连续值,不是只有 0 和 1。数值大小代表保留信息的比例,不是单纯置 0 或置 1。
记忆方法
口诀:遗忘门是软开关,0 到 1 连续算,不是非 0 即 1 硬判断
区分:硬开关只有 0/1;LSTM 门控是 Sigmoid 输出,小数代表保留程度。
- 量化是一种模型压缩技术,可以减少模型存储占用和推理理延迟。✅
原文要点:
模型量化是典型模型压缩技术,降低参数精度,减小模型存储空间,加快推理速度,降低推理延迟,常用于端侧、昇腾硬件部署。
记忆方法
口诀:量化降精度,体积变小,推理变快
一句话记忆:量化 = 压缩模型,省空间、跑得快。
- RNN中不同时刻的权重参数是共享的。✅
RNN (循环神经网络)是专门处理序列数据的深度学习网络。序列数据就是有先后顺序的数据:句子文字、语音波形、股票时间序列。
普通神经网络每次输入独立,RNN 自带记忆(隐藏状态 hidden state):处理当前输入的时候,会带上前面时刻学到的信息。
原文要点:
RNN 在序列不同时间步之间共享权重参数。权重共享让 RNN 参数量不会随序列长度增加而变大,能够提取时序特征。
记忆方法
口诀:RNN 时间步,共用一套权重
联想:读一句话里每个字,用同一个神经网络去处理,不用单独给每个字单独造一个网络。
容易混淆:CNN 也有权重共享(卷积核滑动);RNN 是时序维度权重共享。
5.MindSpore中构建神经网络类,需要继承nn.Module。❌
原文要点:
MindSpore 中 Cell 是神经网络的基础单元,自定义网络类需要继承 nn.Cell;PyTorch 才使用 nn.Module 作为网络基类。
一句话区分:
PyTorch → 继承 nn.Module,前向写 forward()
MindSpore → 继承 nn.Cell,前向写construct()
- 使用MindSpore构建神经网络时,应继承Module类,并重写_init一方法与forward方法。❌
- K-折交叉验证中,k一般大干等干2.实际操作时一般从3开始取,只有在原始数据集合数据量小的时候才会尝试取2。❌
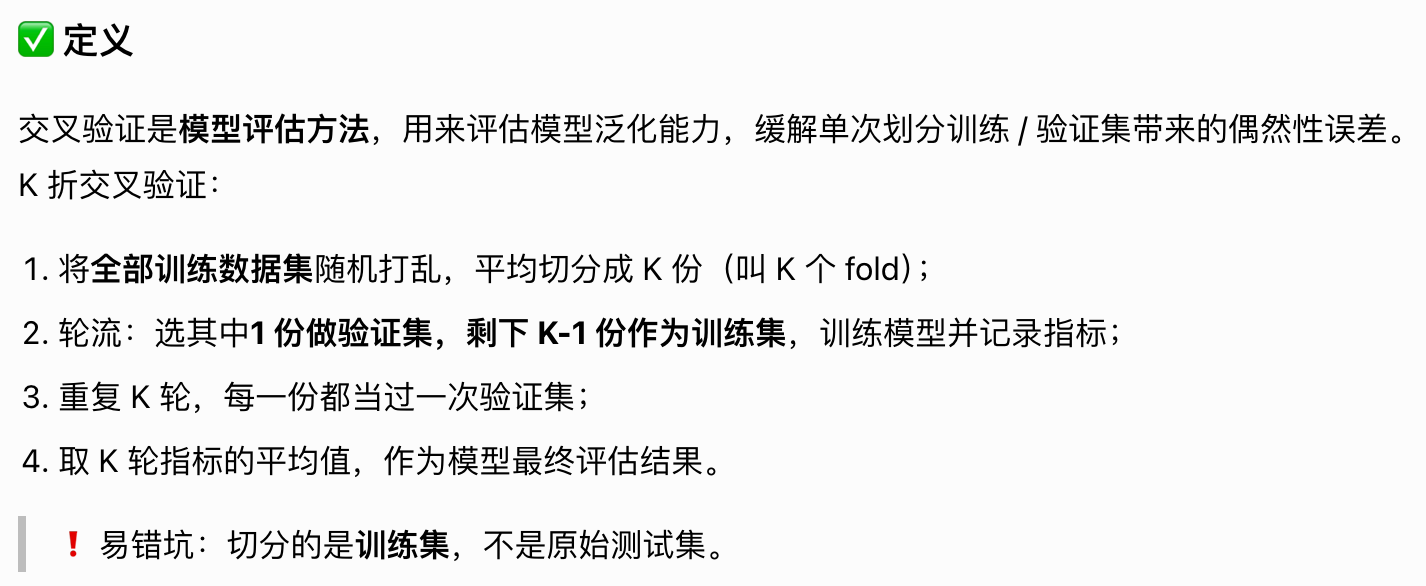
数据集很小的时候,不能用 k=2;小数据集反而应该取更大的 k,比如留一法 LOO(k 等于样本总数)
- L1正则化添加的成本与权重系数的平方成正比。❌

原文要点:
L1 正则化在损失函数中增加权重绝对值的惩罚项,可以产生稀疏权重,实现特征选择;
L2 正则增加权重平方的惩罚项,使权重趋向变小,不会产生稀疏权重。
记忆口诀:
L1 绝对值,L2 平方值;L1 能稀疏,L2 缩权重。
- 多层感知机具备非线性分类的能力,这种能力来自类似f(x)=ax这样的激活函数和多层网络结构。❌
(f(x)=ax) 是线性函数(一次函数)。
原文要点:
多层网络如果全部采用线性激活函数,则多层网络可以化简为单层线性变换,不具备非线性表达能力。
多层感知机的非线性拟合能力来源于非线性激活函数,而不是线性函数。
多层结构配合非线性激活,才能学习复杂非线性边界。
记忆口诀
线性激活叠多层,仍然只是线性模型;非线性激活加多层,才有非线性分类能力。
- MindSpore中的损失函数可以分为内置的损失函数和自定义损失函数数,其中自定义损失函数需要通过继承nn.Cell或者
nn.LossBase来实现。✅
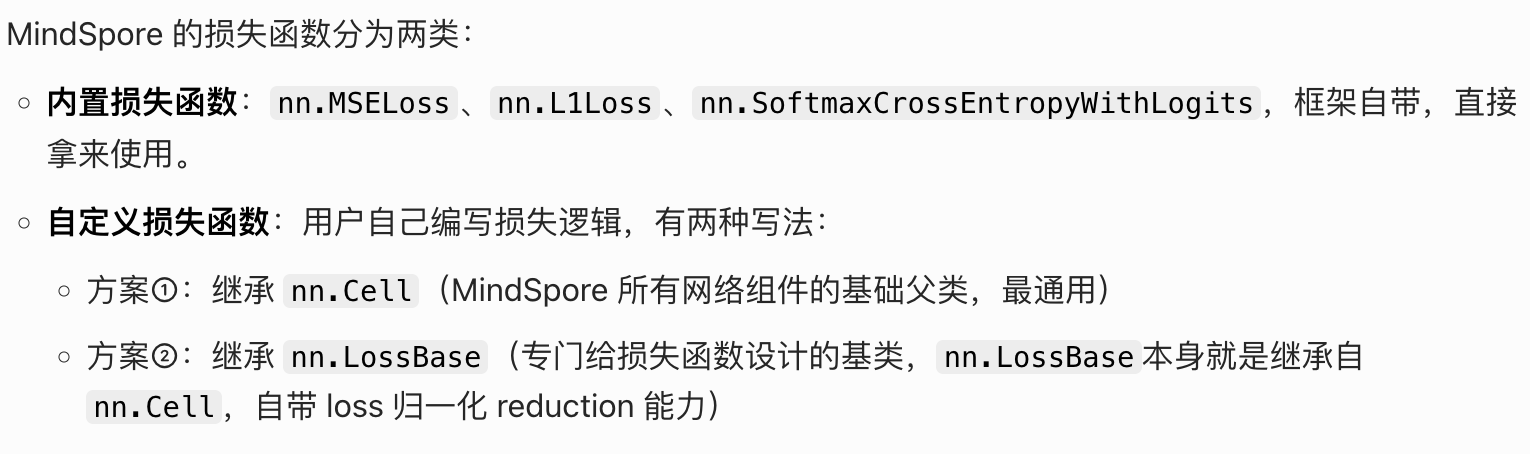
原文要点:
MindSpore 提供多种内置损失函数,同时支持自定义损失函数。自定义损失函数,既可以继承基础网络基类nn.Cell,也可以继承损失专用基类nn.LossBase,并重写construct方法实现损失计算逻辑。
记忆口诀
损失两类:内置、自定义;自定义二选一:继承 Cell 或者 LossBase。
- K折交叉验证是指将训练集划分成K-1个子数据集。❌
原文要点:
K 折交叉验证将原始数据集划分为 K 个互不相交的子集。每次选取其中 1 个子集作为验证集,其余 K-1 个子集作为训练集;迭代
K 次,取平均评估结果。数据集总共划分成 K 份,不是 K-1 份。
记忆口诀
K 折,就是切成 K 块;每次留 1 块做验证,剩下 K-1 块训练。
- Dropout会在训练过程中,随机丢弃大部分神经元,此时丢弃部分对应的参数不会更新。✅
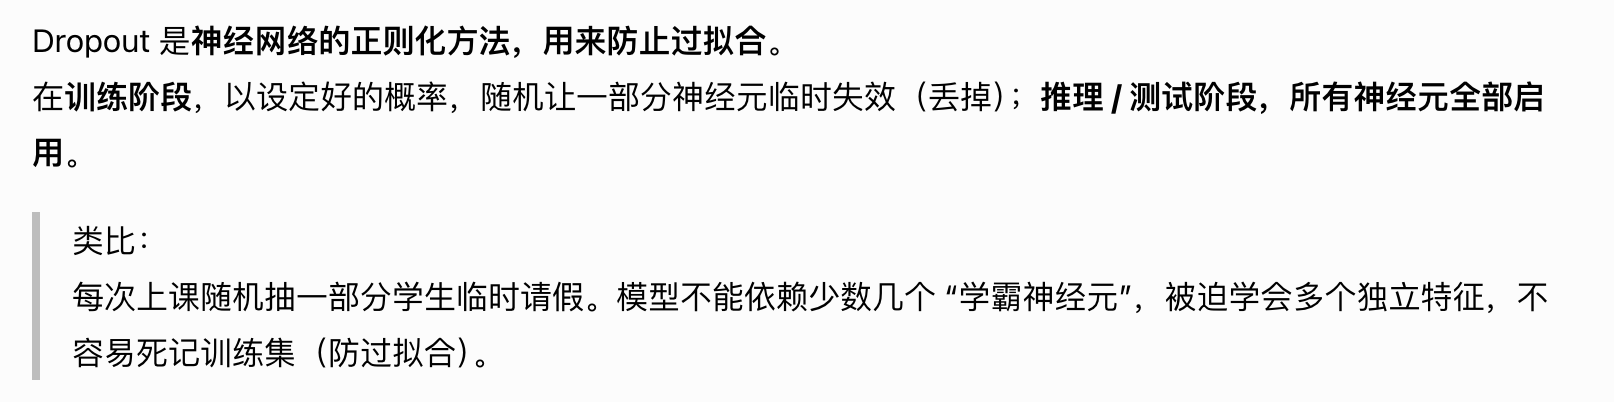
原文要点
Dropout 是深度学习中防止过拟合的正则化手段。仅在训练阶段生效,随机屏蔽部分神经元;本轮被屏蔽神经元不参与前向与反向计算,对应参数本轮不更新。测试阶段所有神经元全部激活
- 循环神经网络可以捕捉序列化数据中的动态信息,t-1时刻前的每一时刻信息对下一时刻信息同等重要。❌
RNN(循环神经网络)能够处理序列数据,把前面时刻的信息传递到后面。
但是前面所有时刻的信息并不是同等重要:
距离当前时刻越近的信息,影响通常更大;
久远的历史信息会随着时间步不断衰减(RNN 长期依赖问题,梯度消失)。
原文要点:
循环神经网络 RNN 适合处理序列数据,可以保存历史时序信息。但 RNN 存在梯度消失问题,较早时刻的信息会不断衰减,不同时刻的信息对下一时刻的贡献并不相同。
记忆口诀
RNN 记序列,远近不一样;近的影响大,远的会遗忘;信息不同权,不是同等强。
- John想要将TensorFlow框架训练的模型迁移到PyTorch中,他可以火将模型保存为ONNX格式。✅
ONNX(Open Neural Network Exchange,开放神经网络交换)是跨框架的模型中间格式。
原文要点:
ONNX 是一种通用模型文件格式,支持在不同深度学习框架之间转换模型。TensorFlow、PyTorch、PaddlePaddle 等主流框架都支持导出 / 导入 ONNX,用于模型跨框架迁移。
- MindlE是华为推出的一个部署框架,底层可以对接PyTorch和MindSpore。✅
MindIE(昇腾推理引擎),华为昇腾的高性能推理部署框架
原文要点:
MindIE 是华为昇腾推出的推理部署框架,提供多框架适配能力,可对接 MindSpore 和 PyTorch 模型,在昇腾硬件上实现统一高性能推理。
- 屏思MindSpore是一个全场景深度学习框架,提供了MindAKG用于算子优化,提升框架执行性能。✅
MindSpore(昇思)是华为推出的端边云全场景深度学习框架。
MindAKG(MindSpore AKG)是 MindSpore 配套的算子编译器,负责算子自动生成与优化,挖掘硬件算力,提升框架执行性能。

- 深度学习中前向传播和反向传播,都依赖于矩阵运算,所以在AI开发框架中矩阵为基础数据结构。✅
- 损失函数与激活函数是一类函数。❌
原文要点:
激活函数用于给网络引入非线性;
损失函数用于评估预测值与真实标签的误差,二者功能不同,不是同一类函数。
- John在实现图像分割模型时,为了增加开发效率使用了动态图的形式开发。在部署时为了提升执行效率,应该使用静态图模式进行部署。✅
原文要点:
动态图便于调试开发;
静态图预先完成计算图编译优化,执行效率更高,适合模型部署场景。
记忆口诀
动态图,好调试,开发写代码;
静态图,先编译,部署速度佳。
- 当问题的解决方案很复杂,或者问题可能涉及到大量的数据却没有明确的数据分布函数时,比较适合使用机器学习方法。✅
原文要点:
传统程序依赖人工定义规则与数据分布;机器学习适合规则复杂、数据量大、难以得到明确数据分布函数的场景,从数据中自动学习规律。
-
数据样本不平衡问题是指数据集中存在矛盾的、有差异的记录是。❌
-
在Self-Attention计算过程中,Query、Key和Value都是由输入序存列通过不同的线性变换得到的。✅
-
CPU不适合做Al计算的原因是因为单个算术逻辑单元的算力较弱,而NPU和GPU的较强。❌
不是 CPU 单个计算单元弱,而是CPU 计算单元数量太少,并行能力差。
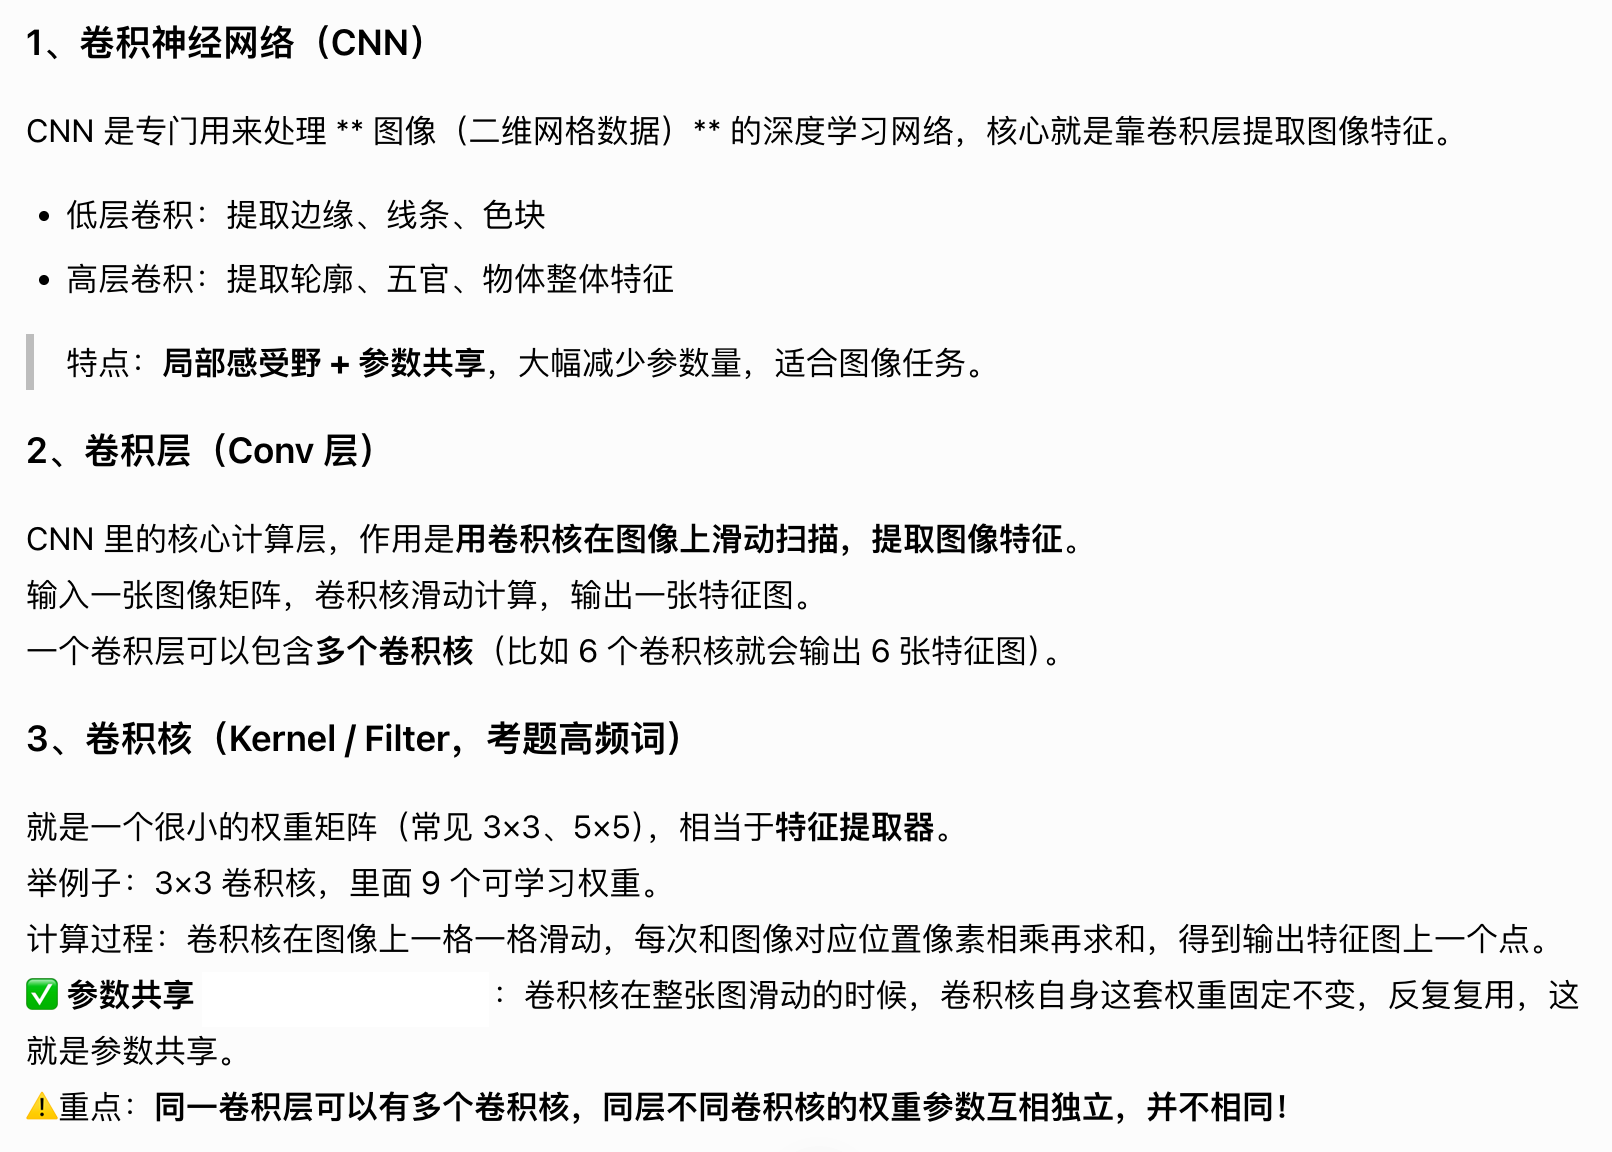
- 卷积神经网络中的卷积层可以实现参数共享,减少网络参数。参数共享是指在同一层中使用的全部卷积核参数一致,不同层使用的卷积核参数是不同的。❌
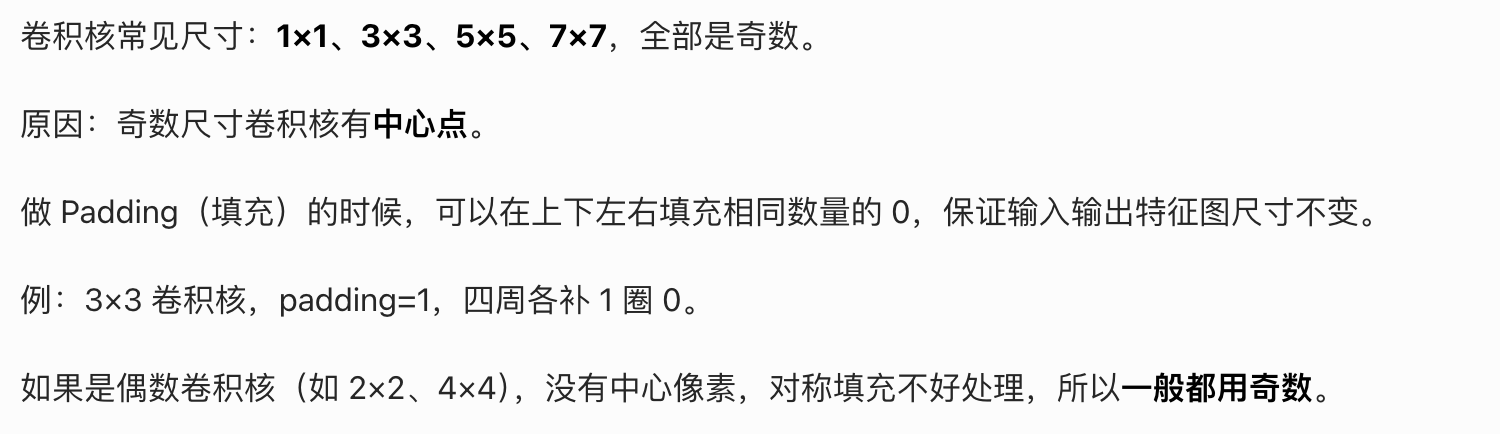
- 卷积神经网络中,卷积核的大小通常为奇数。✅
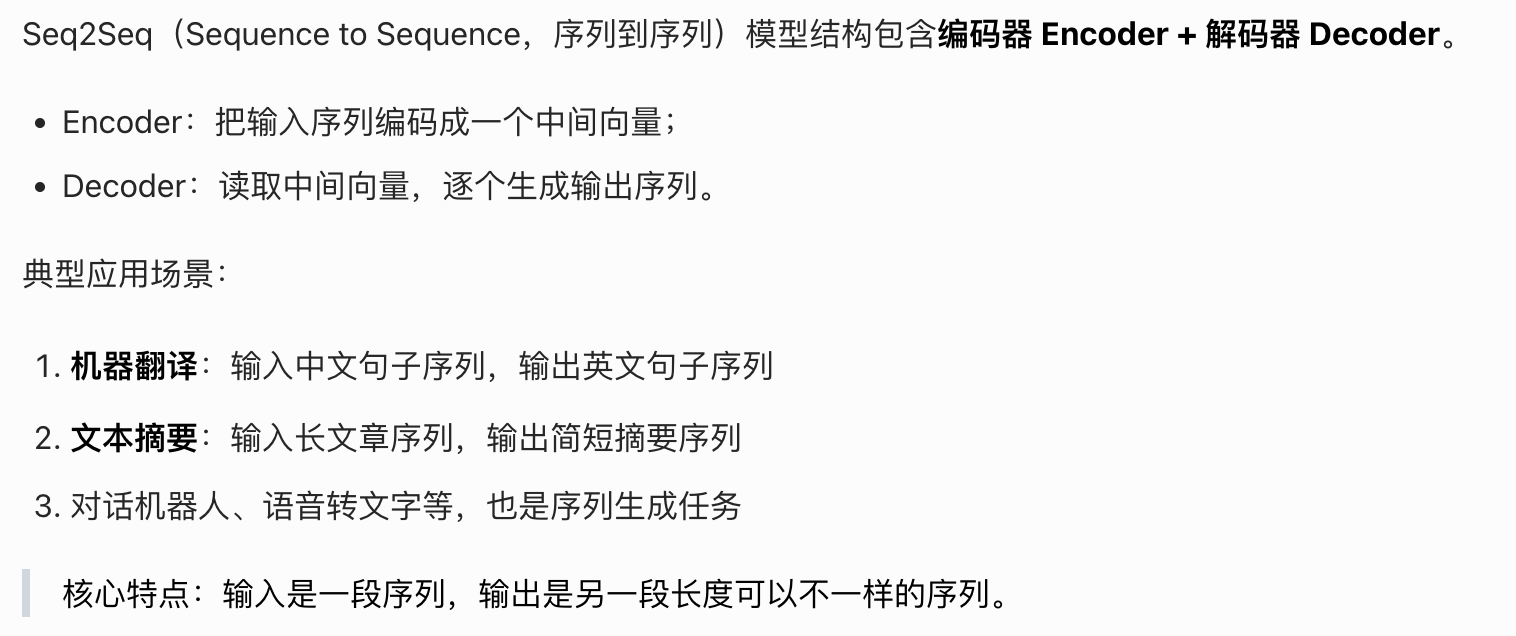
- Seq2Seq 模型常用于机器翻译、文本摘要等序列生成任务。✅
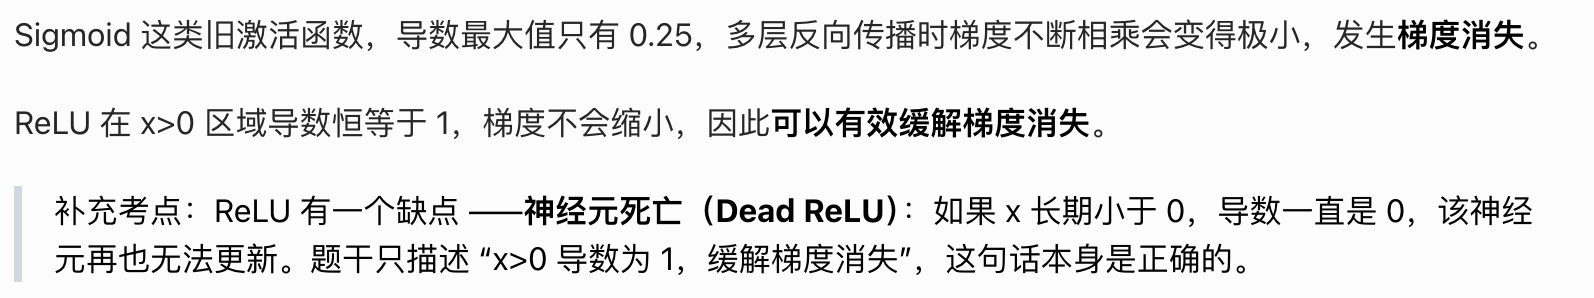
- ReLU激活函数在x>0时导数为1,可缓解梯度消失问题。✅
- 随机森林是一种集成学习算法,通过多个决策树的投票得到最终结果。✅
- DeepSeek-R1 是特定领域(大语言模型)的 AI,仅能完成语言相关任务,属于弱人工智能(专注单一任务);强 / 通用 / 超人人工智能目前尚未实现。❌
“仅能完成语言相关任务” 这句话不对。
-
Atlas系列产品覆盖训练、推理场景,服务器、边缘计算、加速模块等产品形态。✅
-
关于机器学习算法的理性认识,其本质就是得到一个输出,使得输出与真实结果尽可能的接近。✅
-
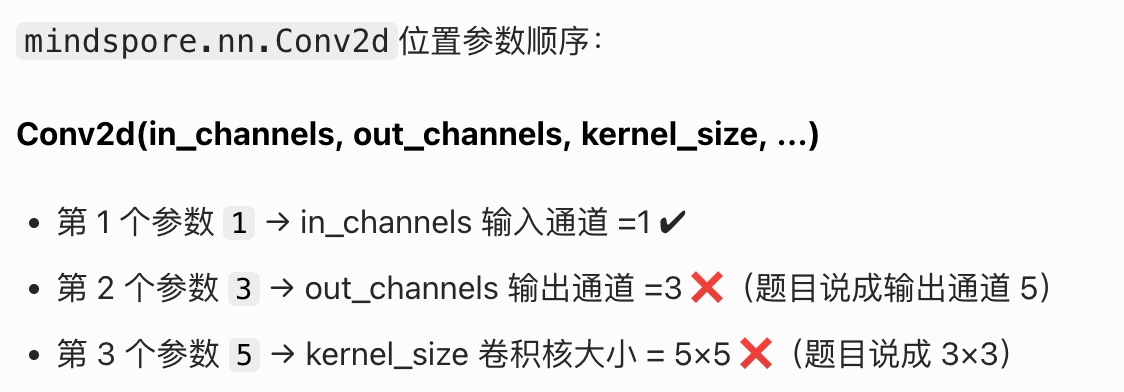
使用mindspore.nn.Conv2d (1,3,5, has_bias=False, weight_init=‘normal’)接口,可以创建输入通道数为1、输出的通道数为5、卷积核大小为3*3、使用normal算子初始化参数的卷积层。错
-
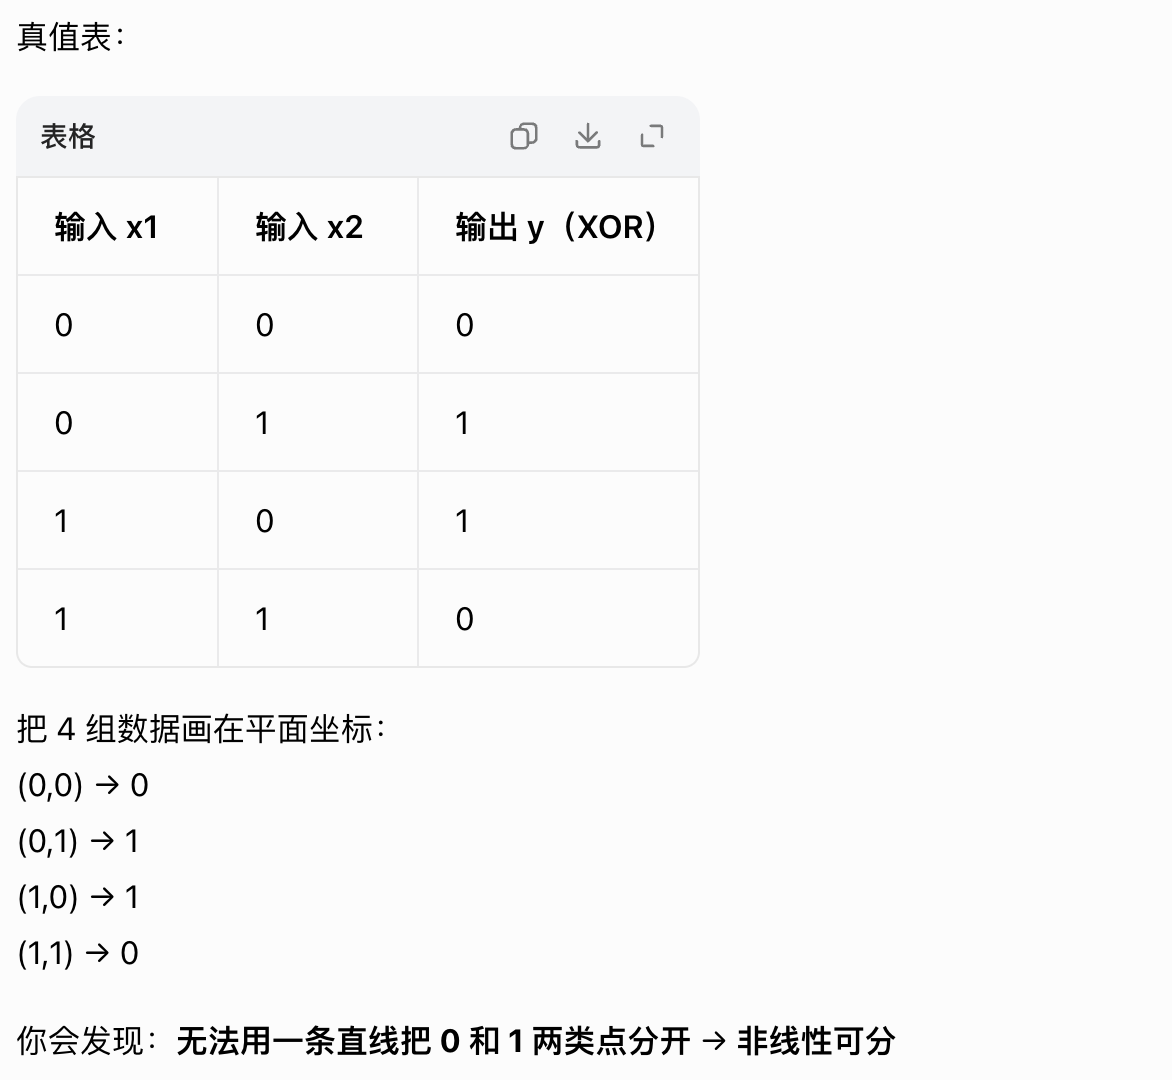
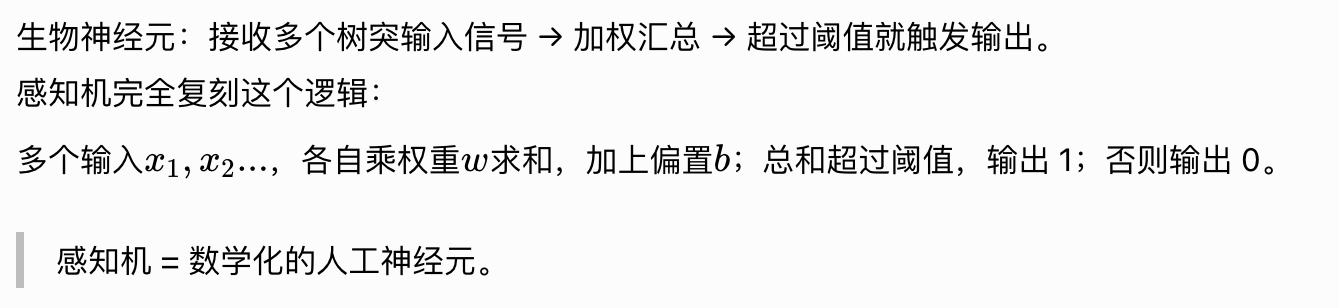
单层感知机无法解决 XOR 问题,成为了阻碍深度学习发展的一个重要原因。✅
XOR(异或)是一个二输入逻辑运算:两个输入不一样 → 输出 1;两个输入一样 → 输出 0
- AIGC 会对殡葬业增加连接设计。❌
- 对于 AI 业务应用来说,训练环节不会对模型进行压缩,而推理部署环节则需要。❌
原文:模型压缩分为训练阶段压缩与训练后(推理部署前)压缩。训练阶段可采用量化感知训练、训练剪枝、知识蒸馏等方式完成模型轻量化;推理部署阶段也可以做训练后量化、剪枝。因此模型压缩并非只存在推理部署环节。
- RNN 跟前馈神经网络最大的区别在于每次都会将前一时刻的计算结果,带到下一时刻的隐藏层中,一起训练。
前馈神经网络FNN(多层感知机MLP、卷积神经网络CNN)
- 信息单向流动:输入层 → 隐藏层 → 输出层。
- 信号只向前传,不会回头、不会把上一轮结果存下来传给下一组输入,没有循环回路。无记忆
RNN 循环网络:有记忆,把前一时刻隐藏状态传给下一时刻
- Softmax 回归是逻辑回归的一般化,只适用于二分类的问题。❌
原文:Softmax 回归是逻辑回归的一般化推广。逻辑回归解决二分类问题;Softmax 回归适用于多分类任务,可以输出各个类别的概率分布。
都属于分类算法,用于算出样本属于各个类别的概率。
-
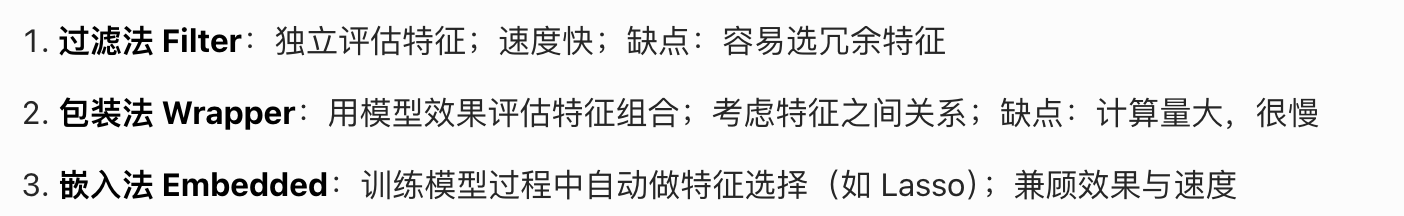
特征选择过滤法的局限性:过滤方法倾向于选择冗余的变量,因为它们没有考虑特征之间的关系。✅
-
昇腾 AI 处理器中 AI Core 控制单元包含标量指令处理队列和向量指令处理队列。✅
-
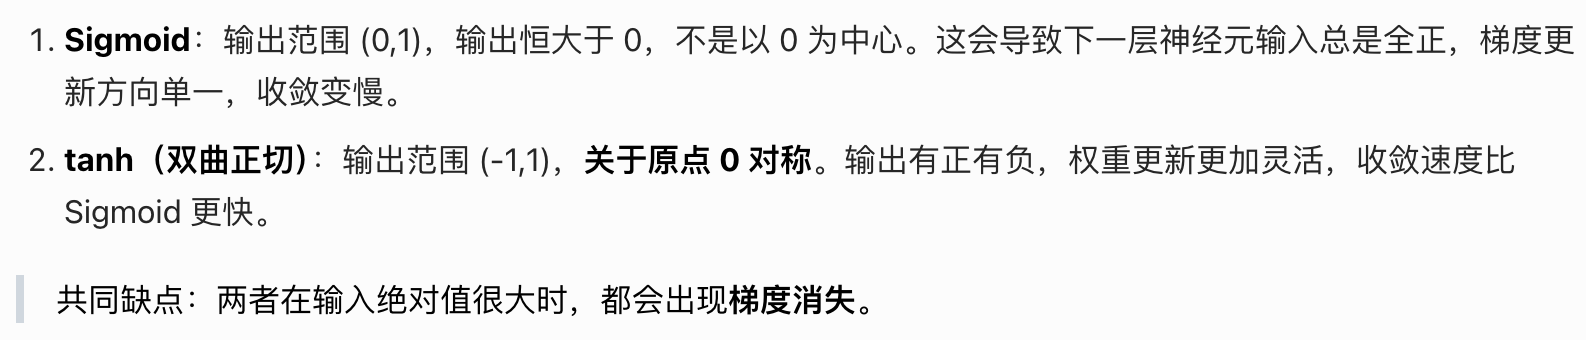
tanh 激活函数输出关于 0 点对称,相比于 Sigmoid 函数可以加快模型的收敛。✅
-
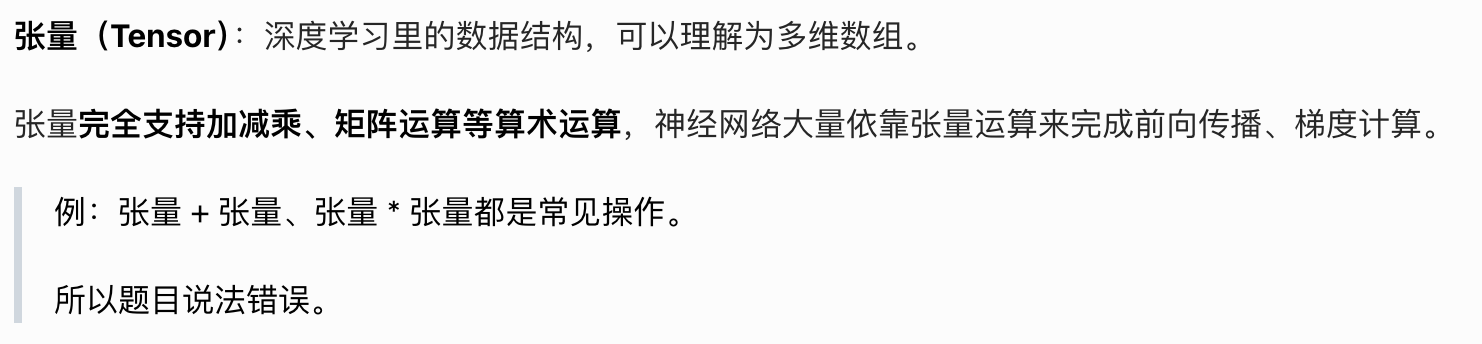
张量无法进行加减乘等算术运算。❌
-
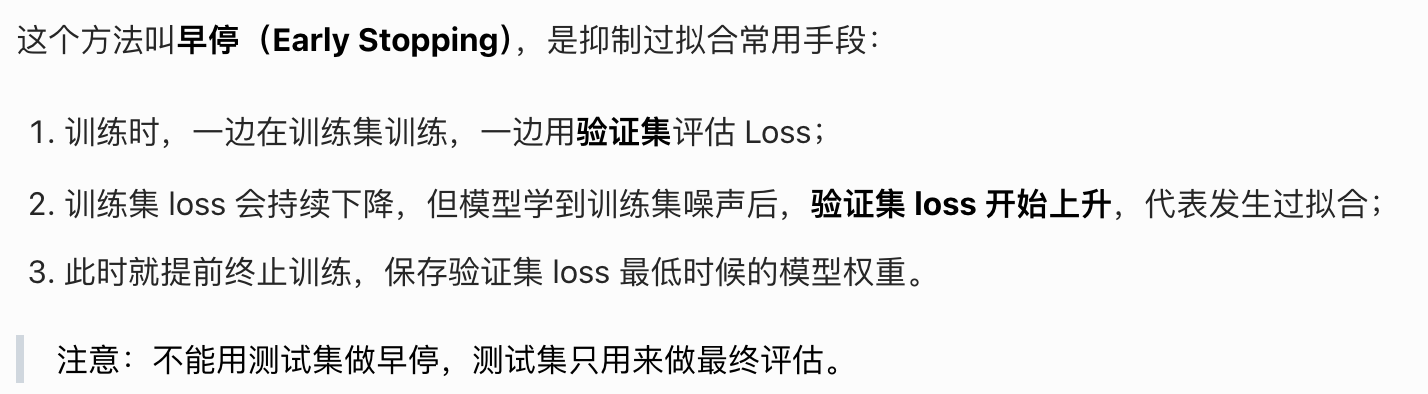
为防止过拟合,在训练过程中,可以插入验证集数据的测试。当发现验证集数据的 Loss 上升时,提前停止训练。✅
-
Self-Attention 和 RNN 功能类似,可以处理时序相关问题,同时它们计算时的并行度相对都不高。❌
-
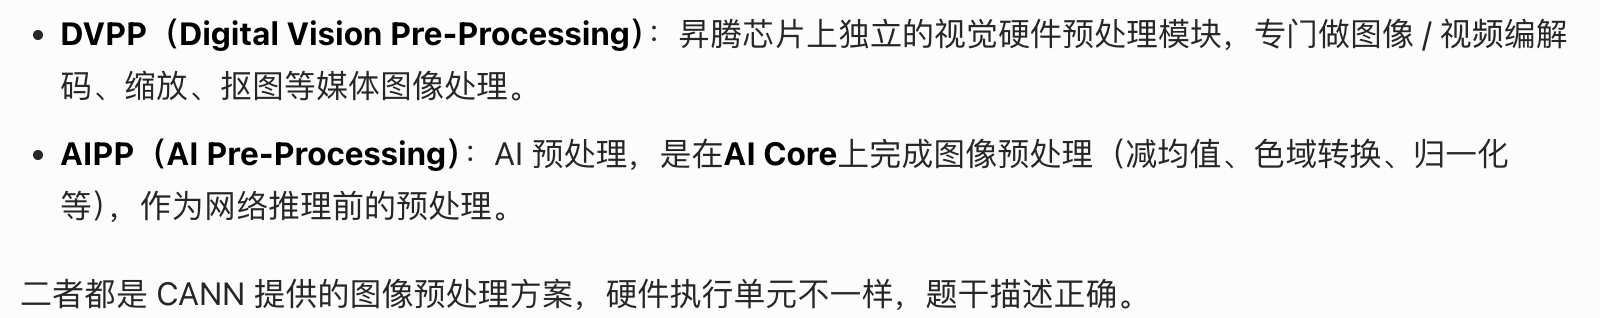
CANN 中提供了 DVPP 和 AIPP,前者使用昇腾 AI 处理器中的 DVPP 模块对图像进行处理,后者使用 AICore 对图像进行处理。✅
-
朴素贝叶斯算法假设样本特征之间相互独立,且对于样本缺失值较为敏感。❌
朴素贝叶斯是概率分类算法
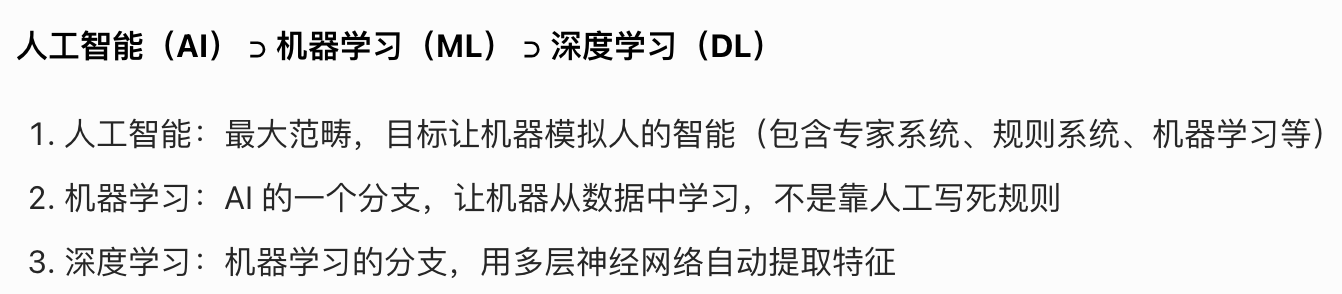
- 机器学习是深度学习的一部分,人工智能也是深度学习的一部分。❌
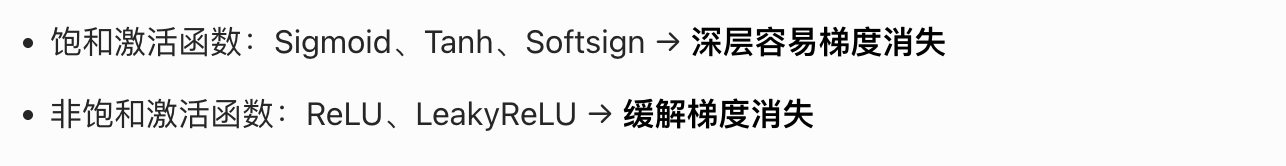
- Sigmoid、tanh 和 Softsign 这些激活函数在网络层数加深时,都不能避免梯度消失的问题。✅
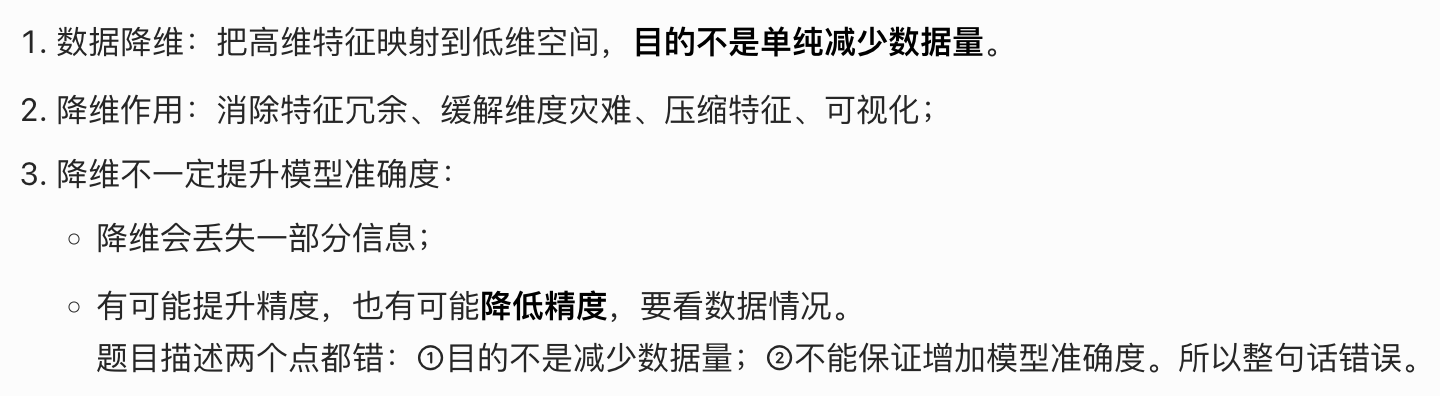
- 数据降维的目的是减少数据量,增加模型的准确度。❌
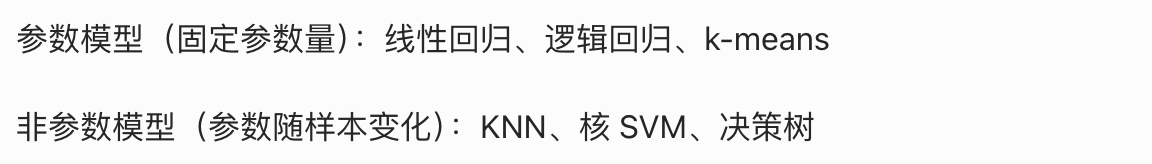
- SVM、k-NN 和 k-means 都属于非参数模型。❌
原文:
参数模型拥有固定数量的模型参数;非参数模型参数数量会随训练样本数量变化。k-NN、核 SVM属于非参数模型;k-means、线性回归属于参数模型。
- 昇腾 AI 处理器只提供了 DDR 接口,可以外接 DDR4 内存。❌
这句话错误,关键点在 “只提供 DDR 接口”。
-
AscendCL 可以基于第三方框架开发推理类应用,但是需要通过 ATC 工具先对模型进行转换。✅
-
AI 芯片会针对矩阵运算做加速设计。✅
-
当前 AI 开发框架动态计算图和静态计算图语法兼容,可以直接进行相互转换。❌
-
前馈神经网络接收前一层的输出,并输出给下一层。采用一种单向多层结构,每一层包含若干个神经元,同一层的神经元之间没有互相连接,层间信息的传送只沿一个方向进行。✅
-
异常数据在模型训练过程中不需要删除,大量的异常数据可以提升升模型的泛化能力。❌
-
John 在使用 PyTorch 框架实现 AI 模型训练时,他应该先通过 set_context 设置模型训练相关参数,如设备 ID、计算图模式等。❌
-
理论上,训练时的精度会随着模型复杂度的上升和训练时间的增加不断减小。❌
-
与 FPGA 相比,相同工艺下,基于 ASIC 的 AI 芯片功耗更大,因此不适合用于手机等终端设备上。❌
-
CPU 可以通过提高频率的方式提升 AI 计算性能。✅
CPU 主频代表单位时间能执行指令的次数。提高 CPU 频率,单位时间内可以完成更多运算,因此 AI 计算性能会得到提升。
-
AI 开发框架的功能是对开发者提供网络模型接口,模型训练过程中的前向传播和反向传播需要开发者自己完成。❌
-
MoE 是一种混合专家模型,这种方案可以有效增强模型的容量和能力,同时在推理时能够动态决定哪些专家模型工作。✅
-
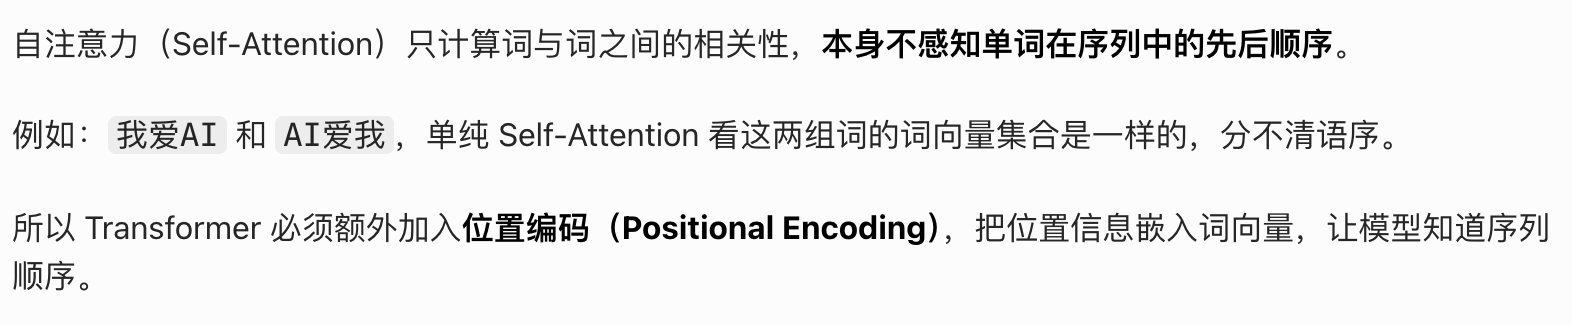
Self-Attention 机制无法捕捉到序列的位置信息,因此在 Transformer 模型中需要添加位置编码。✅
-
在随机森林中,基学习器所使用的特征衡量指标需要是基尼系数。❌
原文:随机森林基学习器为决策树,分类时可选用基尼系数或者信息熵,回归使用方差,并非必须使用基尼系数。
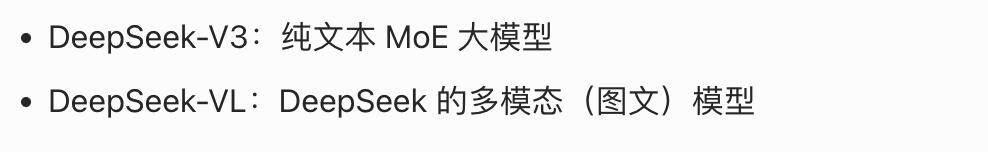
- DeepSeek V3 是一个基于 GPT 结构的多模态模型,较 V2 版本相比,其训练成本和推理速度都有很大的提升。❌
多选题
- 在构建RAG应用的Prompt模板设计中,以下哪些措施可以减少幻觉风险?
B.明确系统指令,要求模型仅基于提供的资料回答
C.动态插入检索到的相关文档片段
- 根据AI终端白皮书,以下哪些选项是AI达到L3级以后人类需要做的事情?
A.人与AI协作,人类监督
B.人类授权
D.人类参与

- 在RAG系统中,以下哪些选项是对文档进行预处理的步骤?
B.去除噪声数据
C.向量化
D.文本分词
原文:RAG 文档预处理流程:文档加载 → 清洗去噪声 → 文本分词 / 分句 → 文本分块 → Embedding 向量化 → 存入向量数据库。
- 卷积神经网络在图像检测中具有平移不变性,以下哪些层共同作用实现了该功能?
C.卷积层
D.池化层
原文:卷积神经网络的平移不变性由卷积层和池化层共同实现。卷积层利用参数共享,实现特征的平移等变;池化层降低对位置的敏感性,获得局部平移不变。全连接层、输出层不具备平移不变特性。
- 有大量销售数据,但没有标签的情况下,企业想甄别出VIP客户,以下哪些选项可以完成此任务?
A.K-means
D.层次聚类
没有标签 = 无监督学习(聚类、降维)
有标签才用监督学习。
甄别 VIP 客户:把客户自动分成不同群体,找到高价值客户群,属于聚类任务。
原文:无监督学习在没有标签的数据中挖掘内在结构,典型聚类算法包含 K-means、DBSCAN、层次聚类。
线性回归、逻辑回归、SVM、决策树、随机森林 属于监督学习,训练数据集需要预先标注标签。
降维:PCA 主成分分析
6. 昇腾AI处理器支持接入以下哪些种类的内存?
B.DDR
C.HBM

- 在神经网络中常有权重共享现象,以下哪些神经网络会发生权重共享?
A.卷积神经网络
D.循环神经网络
- 卷积神经网络CNN:空间维度上共享权重。同一个卷积核在整张图滑动,全程使用同一套参数
- 循环神经网络RNN:时间维度上共享权重。在不同时间步,共用同一套权重。不管是 t1、t2、t3 时刻,循环单元的参数不变
- 在神经网络训练过程中,使用以下哪些激活函数不容易产生主梯度消失的现象?
A.Swish函数
C.ReLU函数
Sigmoid 和 Tanh 是梯度消失经典代表。
| 激活函数 | 公式简述 | 导数特点 | ✅梯度消失 | 常考考点 |
|---|---|---|---|---|
| Sigmoid | σ(x)=11+e−x\sigma(x)=\frac{1}{1+e^{-x}}σ(x)=1+e−x1 | x绝对值大时导数趋近0 | ❌极易梯度消失 | 输出0~1;多用于二分类输出层;缺点:饱和、梯度消失 |
| Tanh | Tanh(x)=ex−e−xex+e−x\text{Tanh}(x)=\frac{e^x-e^{-x}}{e^x+e^{-x}}Tanh(x)=ex+e−xex−e−x | x绝对值大时导数趋近0 | ❌容易梯度消失 | 输出-1~1;零中心化;依然有饱和区,深层网络容易梯度消失 |
| ReLU | KaTeX parse error: Can't use function '\)' in math mode at position 13: \\(\max(0,x)\̲)̲ | x>0时导数=1;x<0导数=0 | ✅不容易梯度消失 | 最常用;问题:神经元死亡(Dead ReLU),注意:神经元死亡≠梯度消失!考题高频坑 |
| Swish | x⋅σ(x)x\cdot\sigma(x)x⋅σ(x) | 平滑曲线,正数区间导数稳定 | ✅不容易梯度消失 | ReLU的平滑升级版,无硬截断,不容易梯度消失 |
| Sign符号函数 | x>0输出1;x<0输出−1;x=0输出0x>0输出1;x<0输出-1;x=0输出0x>0输出1;x<0输出−1;x=0输出0 | 除x=0外导数全部为0 | ❌完全梯度消失 | 几乎无法用于训练,仅理论了解 |
- A企业在某个实例分割项目中(基于MindSpore实现)使用了大量的图片数据,为了节省时间,AI工程师将数据转化为了MindRecord格式,以下关于此描述正确的选项有哪些?
A.转化为MindRecord后,减少磁盘1/0、网络1/0开销,缩短开发周期
B.转化为MindRecord后,实现数据统一存储、访问,方便数据管理
C.转化为MindRecord后,可以有效压缩数据体积,方便数据存储
D.转化为MindRecord后,可以提升模型的训练计算速度,缩短开发周期
- 知识图谱的主要组成部分有以下哪些选项?
A.实体
B.属性
D.概念
知识图谱三要素:实体、概念、关系、属性
- 以下参数中属于模型超参数的是哪些选项?
A.随机森林当中的树的棵数
B.训练神经网络的学习速率、迭代次数和批次大小
D.KNN中的K
超参数:训练【之前】人手动设置,训练过程不会自动学出来;
模型参数:训练【过程中】模型自己从数据学习得到。

- 以下对于数据转换的描述中,哪些选项是正确的?
A.在数据维度较小时,也会对现有变量进行组合或转换以生成新特征,比如平均数
B.机器学习中常对特征进行归一化、标准化,以保证同一模型的的不同输入变量的值域相同
D.处理图像数据,如颜色空间转换、灰度化、几何变化属于数据转换
- 关于小批量梯度下降算法(MBGD),以下哪些描述是正确的?
B.MBGD每次使用一小批固定尺寸的样例来更新权值
C.MBGD中的BatchSize是一个超参数,可由人为设定
D.MBGD兼顾了效率和梯度的稳定性,容易冲过局部极小值,是实际工作中最常用的梯度下降算法

- 已知全连接神经网络的某一层的参数总量为410,则上一层和本层的神经元数量不会是以下哪些选项?
C.40和9
D.10和41

- 达芬奇架构计算单元主要包含以下哪些选项?
A.向量计算单元
C.标量计算单元
D.矩阵计算单元

- 以下哪些选项是模型压缩的好处?
A.降低内存(显存)容量需求
B.降低数据搬运开销
D.提升推理速度
模型压缩目的:减少模型参数量与计算量,降低显存 / 内存占用,减少数据传输搬运开销,加快推理速度。模型压缩通常会造成精度损失
- 以下哪些选项属于图像识别技术应用场景?
D ❌ 语者识别
A.周界检测
B.安防监控
C.快递机器人
- 深度学习任务中常常遇到哪些问题?
A.数据不平衡问题
B.梯度消失问题
C.梯度爆炸问题
D.过拟合问题

- 以下哪些选项属于计算机视觉(CV)任务?
A.目标检测
B.图像分类
D.语义分割
D ✅ 语义分割:对图像每个像素分类,划分不同物体区域,CV 任务
20. 以下哪种技术可以用于缓解大模型的过拟合问题?
A.数据增强
B.正则化(L1/L2)
C.Dropout
- 大模型训练中,"梯度累积"的主要目的是?
B.模拟更大的批次大小(BatchSize)
C.减少显存占用
梯度累积(Gradient Accumulation):在显存有限的条件下,将一个大批次拆分为多个小批次,多次前向、反向计算梯度并累加,累积若干步之后再更新一次参数。核心目标:模拟更大的有效 batch size,降低单次计算所需显存。代价是训练时间变长。
- 在深度学习中,以下哪种优化器可以自适应调整学习率?
C.Adam
D.RMSprop

- 以下哪些选项属于无监督学习算法?
A.k-means
B.DBSCAN

- 特征选择的必要性体现在以下哪些选项?
A.减少训练的时间
B.提升模型泛化能力,避免过拟合
C.避免维度爆炸问题
D.简化模型,使之容易被解释
特征选择是从原始特征集中挑选子集,剔除无关、冗余特征。
作用:
降低特征维度,缓解维度灾难;
减少训练开销,缩短训练时间;
降低模型复杂度,防止过拟合,提升泛化能力;
减少特征数量,提升模型可解释性。
- 特征选择:从原有特征里挑一部分,不创造新特征
- 特征提取(PCA 这类降维):将旧特征组合,生成全新的特征
- 以下哪些步骤在卷积神经网络中由模型自动完成?
A.特征选择
D.特征提取
- B. 模型训练 ❌模型训练是整个流程的过程,不是 CNN 网络层内部自动完成的一个步骤,需要人为设置数据集、优化器、启动训练流程。
- C. 分析定位任务 ❌分析定位任务属于人工业务设计。是人来判断这是分类 / 检测 / 分割任务,不是模型自动分析要做什么任务。
- 以下哪些框架支持动态计算图模式?
A.PaddlePaddle
B.MindSpore
C.PyTorch
D.TensorFlow

- 动态图:边写代码边执行,一行一行跑,方便调试(PyTorch 风格)
- 静态图:先把整个网络定义编译成图,再统一运行,部署性能好(TF1 旧版本风格)
- 昇腾AI处理器中的AlCore包含存储控制单元,这个单元可以完成以下哪些操作?
A.补零
D.解压缩
AI Core 存储控制单元内的存储转换单元,负责 AI Core 内部缓冲区之间的数据读写,可完成:补零、转置、Img2Col、解压缩这类数据格式转换操作。
- 以下关于朴素贝叶斯算法的描述中,错误的是哪些选项?
B.现实中大多数数据符合朴素贝叶斯对于特征之间独立性的假设
C.朴素贝叶斯算法对于数据缺失值较为敏感
D.贝叶斯分类器具有较高的准确性,但计算速度较慢

- 以下哪些优化器可以在每次迭代时自适应地调整每个参数的学习率?
A.RMSprop优化器
C.Adam优化器
D.Adagrad优化器
自适应学习率优化器:每个参数拥有独立学习率,根据历史梯度自动更新学习率;
动量(Momentum):学习率全局固定,只引入梯度的惯性,不会为每个参数单独自适应调学习率。
- 以下哪些方法可以减少过拟合的问题?
A.使用Dropout方法,随机丢弃一部分神经元
B.提前停止训练
C.添加L1或L2正则惩罚项
D.扩充数据集,引入噪声
- 当前大模型基本上都是基于Transformer架构修改而来,以下哪些大模型使用了decoder-only结构?
A.GPT-2
B.Llama3.1
D.GLM-4

- 以下关于前馈神经网络描述正确的是哪些选项?
A.前馈神经网络中后一层的神经元的值受到前一层全部神经元值的影响
B.前馈神经网络中每一个连接处都有一个与之对应的参数

- 人工智能的发展取决于以下哪些要素?
A.数据
B.算力
C.算法


- 以下方法中属于特征选择过滤法(Filter)的是哪些选项?
A.方差法
B.皮尔逊相关系数
D.卡方系数法

- 以下属于通用机器学习整体流程的是哪些选项?
A.模型训练
B.特征提取与选择
C.数据准备
D.数据清洗

37. 以下关于模型中参数与超参数的描述中,哪些选项是正确的?
A.可以使用超参数来控制训练
B.超参数由人工手动设定
C.模型中不但有参数,还有超参数的存在
- 正则化是传统机器学习中重要且有效减少泛化误差的技术,以以下哪些技术属于正则化?
A.Dropout
B.L2正则化
D.L1正则化

- 与FPGA相比,以下哪个选项是ASIC的优点?
B.设计和制造工艺成熟
D.量产后成本低
| 对比项 | ASIC(专用芯片) | FPGA(现场可编程) |
|---|---|---|
| 灵活性 | 流片后不可修改 | 可编程,反复修改,灵活 |
| 开发周期 | 长 | 短 |
| 研发风险 | 高(流片失败损失巨大) | 低,不用流片 |
| 芯片面积 | 同等功能面积更小 | 同等功能面积更大 |
| 功耗 | 功耗低 | 功耗更高 |
| 成本 | 前期流片贵;大批量量产单片便宜 | 单片一直贵,量产也不降价 |
| 启动方式 | 上电直接运行,无需加载配置 | 上电需要加载配置文件才能运行 |
- 以下哪些选项是构建知识图谱的主要步骤?
A.确定领域
B.信息抽取
C.获取数据

- 与ASIC芯片相比,以下哪些选项是FPGA芯片的特征?
A.实现相同功能时,需要的芯片面积更大
D.研发风险较低
- 以下哪些选项属于终端设备上所使用的AI芯片特征?
C.高性能❌
A.低成本
D.低延迟

- John在使用AI框架实现并行训练时,选择了通过梯度累积的为方式进行,以下关于他操作的描述中,错误的是哪几项?
A.为了保证训练结果与原批量训练可以进行对比,梯度累积一般不使用优化器参考
B.梯度累积的实现,不需要进行任何代码的调整
C.PyTorch、MindSpore等框架实现方式大致相同,都可以直接使用,不需要进行调整

- LSTM网络结构中由哪些模块共同决定了当前细胞状态需要保留的信息?
A.上一层的隐藏状态
B.当前的输入信息
D.上一层的细胞状态
旧隐态、当前输入、旧细胞状态,一起决定保留多少历史记忆;当前层隐藏状态是结果,不是输入。
- 在深度学习任务中,遇到数据不平衡的问题时,可以用以下哪些方法进行解决?
A.过采样
C.随机欠采样


- 以下哪些属于机器学习中常用的特征工程操作?
A.特征归一化
B.特征离散化
C.特征交叉


- 以下哪些结构属于LSTM?
B.输出门
C.输入门
D.遗忘门
LSTM 通过三门机制解决传统 RNN 梯度消失问题

- 如果深度神经网络出现了梯度消失或梯度爆炸问题,以下哪些选项是常用的缓解方式?
A.使用Relu激活函数
D.梯度剪切

- 在智慧医疗场景下,以下技术与应用对应合理的是?
B.虚拟助理-语音识别❌
C.疾病风险预测-数据挖掘
D.医学影像-计算机视觉
- 以下哪些场景更需要Al计算而不是通用计算?
C.流体仿真❌
A.自然语言处理
B.图像识别

49. MindSpore中,mindspore.nn.Conv2d()构建卷积层时,可能会使用到以下哪几项参数?
B.kernel_size
C.padding
D.has_bias

- 以下关于ReLU激活函数优点的描述,正确的是哪些项?
C.一定程度上缓解了梯度消失的问题
D.相对Sigmoid激活函数,计算简单
A ❌:ReLU 输出是 (max(0,x)),输入越大输出越大,输出无界;Sigmoid 才是输出有界(0~1)。
- John在学习MindSpore框架时,学习了Callback的使用并准备用于AI模型训练中,以下他可以使用Callback的场景有哪些?
A.监控训练过程中的Loss
C.提前终止训练
D.保存模型参数
MindSpore 的 Callback 是训练过程中的回调钩子,可以在训练的不同阶段执行自定义逻辑:监控指标、保存 checkpoint、早停、动态调整学习率等;不能修改网络结构、更换激活函数。

- John使用PyTorch实现一个两层全连接结构的网络:
fc1 = nn.Linear (input_size, hidden_size)
fc2 = nn.Linear(hidden_size, output_size)
现在他将MNIST数据集(282828*1,共10个类别)放入到网络中运进行训练,以下关于他赋值操作正确的有哪些选项?
A.input_ size = 784output_size = 10
C.output size = 10hidden_size = 784

- John想要实现一个用于语音识别的深度学习模型,他可以选择以下哪些框架实现?
B.TensorFlow
C.MindSpore
D.PyTorch

- 小艺是华为手机上的智慧助手,它的强大功能得益于以下哪些因素?
B.手机芯片的发展
C.Al算法的发展
D.通信技术的发展
- John在使用AI开发框架实现AI应用时,以下操作可由相在架实现的有哪些选项?
B.计算图优化
C.调用硬件算力实现模型训练
D.自动微分
- John在使用AI开发框架训练完成模型后,想要只保存完整模型,他可以将模型保存为以下哪些格式?
A.onnx
B.pth

- John想要创建一个AI应用服务团队,为保证团队盈利,他应该考虑以下哪些问题?
A.训练数据成本
B.应用场景
C.算力平台价格
D.算法研发难度
- CPU可以通过以下哪些方式提升AI性能?
A.增加专用AI计算单元
B.增加核数
C.增加指令集
D.提升频率
- 以下哪些选项属于AI开发框架提供的功能?
A.跨平台分布式训练
B.数据预处理
C.算子API
D.自动模型调优
- 以下描述中属于包装法(Wrapper)局限性的是哪些选项?
A.其特征选择的方法通常为特定类型的模型提供了性能最好的特性集
C.因为包装法为每个子集训练一个新模型,所以它们的计算量非常大

Wrapper 包装法:用学习器评估特征子集,优点是能考虑特征交互、对当前模型效果好;
缺点:计算量大、选出的特征偏向适配特定模型,泛化能力弱。
Filter 过滤法不依赖模型,速度快,但忽略特征之间的相互关系,容易选出冗余特征。
- 以下关于机器学习的描述中,哪些选项是错误的?
A.机器无法自动学习规则
B.如果决策规则简单,机器学习会更加适用

- 昇腾AI处理器主要的硬件架构包括以下哪些选项?
A.芯片系统控制CPU
B.数字视觉预处理模块
C.Al计算引擎
D.多层级的片上系统缓存或缓冲区
- DeepSeek-R1可以用于以下哪些场景中?
D.3维模型渲染❌
A.代码生成
B.文本创作
C.智能问答
- MindSpore向用户提供了多个不同层次的API,支撑用户进行Al应用(算法模型)开发,包括以下哪些选项?
A.Medium-Level API
C.High-Level API
D.Low-Level API
MindSpore 向用户提供了 3 个不同层次的 API,支撑用户进行网络构建、整图执行、子图执行以及单算子执行,从低到高分别为 Low-Level Python API、Medium-Level Python API 以及 High-Level Python API。
- 以下哪些选项属于ModelZoo一站式模型开发与体验工具?
A.昇腾镜像仓库
B.自动迁移工具
C.精度对比工具
D.ModelShow
- 以下关于AI应用开发流程的描述,错误的有哪些选项?
B.模型训练过程中,为保证拟合效果要尽可能的增加训练时云
C.模型训练完成后,只将超参数保存为模型文件方便后续调角
D.数据收集阶段要尽量获取更多的数据,数据的数量比质量更重要


- John使用Al框架创建了一个tensorA,A具备以下哪些属性?
A.数据类型
B.维数
C.形状
D.存储位置
张量(Tensor)是 AI 框架的基础数据结构,包含核心属性:数据类型 dtype、维数 ndim、形状 shape、存储设备位置
device。
- 深度学习是比较火热的人工智能技术,但是在做深度学习任务时常常会遇到各种各样的问题,以下哪些问题会在深度学习任务中出现?
A.梯度爆炸问题
B.梯度消失问题
C.过拟合问题
D.数据不平衡问题
- 企业在实例分割项目中(MindSpore)将图片转为MindRecord格式,以下正确描述有哪些?
C.提升模型的训练计算速度,缩短开发周期❌
A.实现数据统一存储、访问,方便数据管理
B.有效压缩数据体积,方便数据存储
D.减少磁盘IO、网络IO开销,缩短开发周期

- 某工程师使用一个全连接神经网络实现了10分类任务,此网网络有2层隐藏层,每层均有32个神经元,输出层有10个神经元,
输入层有20个神经元。现在需要修改此网络结构以实现2分类任务,以下哪些修改不能实现该功能?
B.将隐藏层和输出层神经元数量减半
C.减少输入层神经元数量
D.减少一层隐藏层,将剩下的隐藏层神经元数量减半

- 深度学习中,数据增强是一种有效防止过拟合的方法。以下关于数据增强的描述中,正确的有哪几项?
A.在图像分类任务中对图片进行旋转、缩放
B.语音识别任务中对输入数据添加随机噪声
D.在图像分类任务中调节图片亮度或对比度
数据增强是对原有样本做合理变换生成新样本;
图像常用旋转、缩放、亮度对比度调整;
语音常用加噪声;
- 当使用机器学习建立模型的过程中,以下哪些属于必备的操作?
A.特征选择
B.数据获取
C.超参数调节
D.模型构建
- 某工程师想要部署DeepSeekV3模型进行推理,他需要考虑以下哪些问题?
B.是否使用量化/量化方式
C.模型结构
D.设备显存/内存容量
微调数据属于模型微调训练环节,不属于推理部署环节。
- 昇腾Al处理器包含AlCore模块,这个模块包含以下哪些选项?
A.矩阵计算单元
B.存储控制单元
C.指令发射模块
D.寄存器
- 在昇腾AI处理器中,AlCore的存储控制单元可以完成以下哪些操作?
A.转置
B.补零
C.解压缩
D.Img2Col
- 以下关于大模型和小模型的对比描述正确的有哪些选项?
A.小模型在部署和使用上更加灵活
B.行业大模型通常使用微调的方式训练

- 以下哪些选项不是决策树用于划分节点的依据?
B.频率
D.期望
决策树通过特定指标选择特征进行节点分裂。
ID3 使用信息增益,
C4.5 使用信息增益率,
CART 分类树使用基尼系数,
CART 回归树使用方差。
频率、期望不属于决策树节点划分指标。
- 以下哪些选项不能用于聚类任务?
A.DNN
D.PCA

无监督学习包含聚类和降维两类典型任务。
聚类代表算法:k-means、DBSCAN;
降维代表算法:PCA;
DNN 属于有监督深度学习模型,多用于分类、回归,不属于聚类算法。
- 以下哪个选项是归并排序的基本思想?
B.把它分成两个个数大致相同的子数组,对这两个子数组分别别采用归并排序的方法排序
D.把它分成两个个数大致相同的子数组,然后在把这两个子数组合并


- 使用AI芯片训练模型时,对芯片以下哪些能力要求较高?
A.可扩展性
C.算力
D.精度

- 以下对数据的操作中可以增加模型泛化能力的有哪些选项?
A.对图片数据进行裁剪、反转操作
C.对文字类数据进行随机删除
D.对音频类数据添加噪声

- John在使用Al框架构建并训练模型时,选择了通过静态图的为方式进行,以下关于他操作的描述中,错误的是哪几项?
B.为了保证网络各层之间的维度可以进行计算,随时输出一些中间结果作为参考
D.Pytorch、MindSpore等框架默认为静态图模式,他可以直接使用,不需要做其他配置


- 关于卷积神经网络池化层,以下哪些描述是正确的?
A.池化操作采用扫描窗口实现
B.常用的池化方法有最大池化和平均池化
C.池化层可以减小特征图的尺寸

- 机器学习中模型总会存在误差,误差包括哪些部分?
A.偏差
D.方差
机器学习泛化误差分解为:偏差(Bias)、方差(Variance)、噪声(不可约误差)
- 以下关于决策树的描述中,哪些选项是错误的?
B.ID3,C4.5,CART等决策树算法都可以用于回归问题
C.纯度的量化指标不包括方差


- 评判分类模型的F1值是以下哪些指标的调和均值?
A.精确度(precision)
D.召回率(recall)

单选题

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)