
拆英伟达的墙,从架空地基开始:DeepSeek 昇腾六件套开源的成色与裂缝
一、六件套清单:对应有实证,但只到接口层
2026 年 9 月 30 日,DeepSeek 通过官方公众号宣布开源面向华为昇腾算力平台的基础设施组件,官方称所有组件与此前面向英伟达平台的组件"一一对应"。完整清单是六件套:TileLang(昇腾后端)、TileKernels、DeepGEMM-Ascend、DeepEP-Ascend、FlashMLA、DeepSelect——负责 MoE 跨设备通信的 DeepEP 就是"分布式通信库"的对应物,别漏了它。
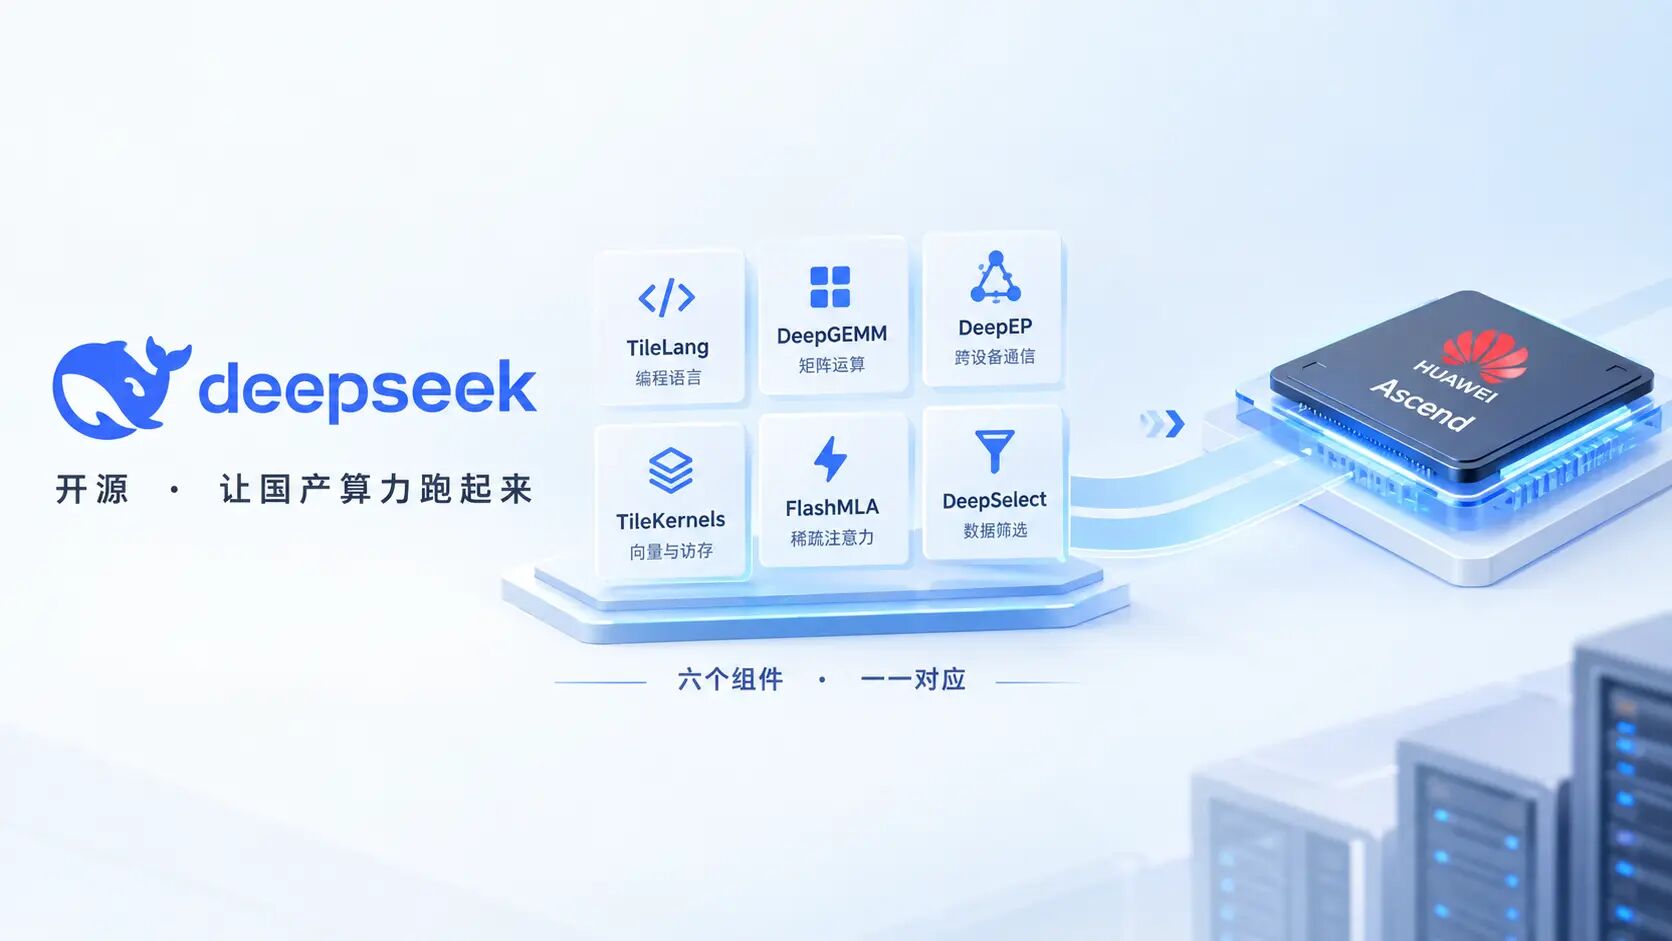
"一一对应"在仓库层面有实证,但只到接口层:TileKernels 里每个算子都是 *_kernel.py(共享)+ *_cuda.py + *_asc.py 三件套,运行时自动选后端;DeepEP-Ascend 的公共接口与英伟达版对齐,训练和推理共用同一套 API;FlashMLA 在同一仓库内构建期自动探测平台。
但"API 对齐"之下有一处错位。简单说:接口能对上,数据在内存里的摆法不一样。打个比方:插头形状一样,插上去能通电,但电压和零火线顺序不同,直接插可能烧板子。具体到工程:DeepGEMM 低精度计算的缩放因子,K 维的 UE8M0 在昇腾上要成对打包进 int16、按 MN-major 存储。调用代码可以原样复用,但权重数据的物理排布必须重新适配。清单对应的是接口契约,不是内存现实——平移是真的,但平移的是接口,不是数据。
二、真正的故事不是迁移,是套利
这次开源最深的一层逻辑,被 DOIT 点破:DeepSeek"没有把 CUDA 当成要攻克的堡垒,而是把它当成要架空的地基"。注意,"不正面攻克"不等于"不拆"——架空 CUDA 这个默认地基之后,墙的承重会松动。
拆开看,这是一个标准的生态套利:第一步,TileLang 先在英伟达平台上被充分验证——V4 系列训练绝大多数算子基于 TileLang 实现,生态、文档、用户心智都在 CUDA 世界积累;第二步,以"新增后端"的方式落到昇腾上,开发者"留在原地,只是硬件选项多了一个"。
时间上有一个值得咂摸的间隔:V4 于 2026 年 4 月发布时即宣布在昇腾 NPU 上完成了细粒度专家并行方案的初步验证(EP 加速 1.50–1.73 倍),但 DeepSeek 同时声明训练仍使用合规渠道获得的英伟达 GPU;从 4 月方案验证到 9 月全栈开源,隔了整整五个月。有理由推测——但暂无公开证据佐证——这五个月不是打磨性能的充裕期,而是底层工程(固件、CANN 版本、编译器后端)与华为深度耦合的磨合期,这也解释了为什么华为对这次开源的贡献被表述为"毫无保留"。
套利有另一面:绑定。TileLang 的昇腾后端不是翻译层,它针对 Cube 矩阵单元与 Vector 单元实现专用编译转换、调度与同步。假设 960 代际调整了 Cube 单元的累加器布局,代码生成模板大概要改——小时级;但累加器布局直接决定流水线 stage 的切分和同步原语的使用,调度器大概率要重写——周级甚至月级。"中立"不是一次架构决策,而是跟随华为每一代硬件持续投入的工程状态。模型能力被折算成了抽象层的标准制定权:DeepSeek 在做的事,是把"用哪个后端"从一道长期学习成本极高的选择题,变成编译期的一个选项——代价是与昇腾硬件代际的同步绑定。
三、99.8% 成了宣传口径里的常客:一个被精心挑选的峰值
DeepGEMM-Ascend 官方 README 的完整性能表如下,测试条件是昇腾 950DT、CANN 9.20、冷 L2 缓存、单一形状 4096×7168×16384:
|
类型 |
算力 |
硬件上限 |
利用率 |
|---|---|---|---|
|
BF16×BF16 |
431 TFLOPS |
432 | 99.8% |
|
FP8×FP8 |
861 |
865 |
99.5% |
|
FP8×FP4 |
861 |
865 |
99.5% |
|
FP4×FP4 |
1701 |
1730 |
98.3% |
只有 BF16 那一格是 99.8%,但这个数字被反复引用,成了宣传口径里的常客。它的适用边界有三条:限定昇腾 950 单一芯片代际(其他代际支持"尚未确立")、限定 CANN 9.20 单一软件版本、限定单一测试形状。另一个组件的条件更苛刻:DeepEP-Ascend 报出的 373–375 GB/s dispatch 带宽,基于的是手动配置的 PoC HDK 与未公开固件,商用 HDK 要到 10 月中旬才发布——这组带宽数字暂不纳入比较。此外,DeepGEMM 的 API 兼容性声明本身也标注着"未经独立测试"。
FlashMLA 的数字反而更可信:prefill 410 TFLOPS(峰值 95%)、decode 360 TFLOPS(83%)——decode 掉到 83% 说明访存瓶颈真实存在,这个"不完美"比 99.8% 更像真的。一句话:99.8% 证明的是软件榨取单芯片的效率,不证明昇腾 950 比英伟达最新芯片强——横向对等的公开基准目前仍不存在。
四、主战场不在单卡,在机柜之间
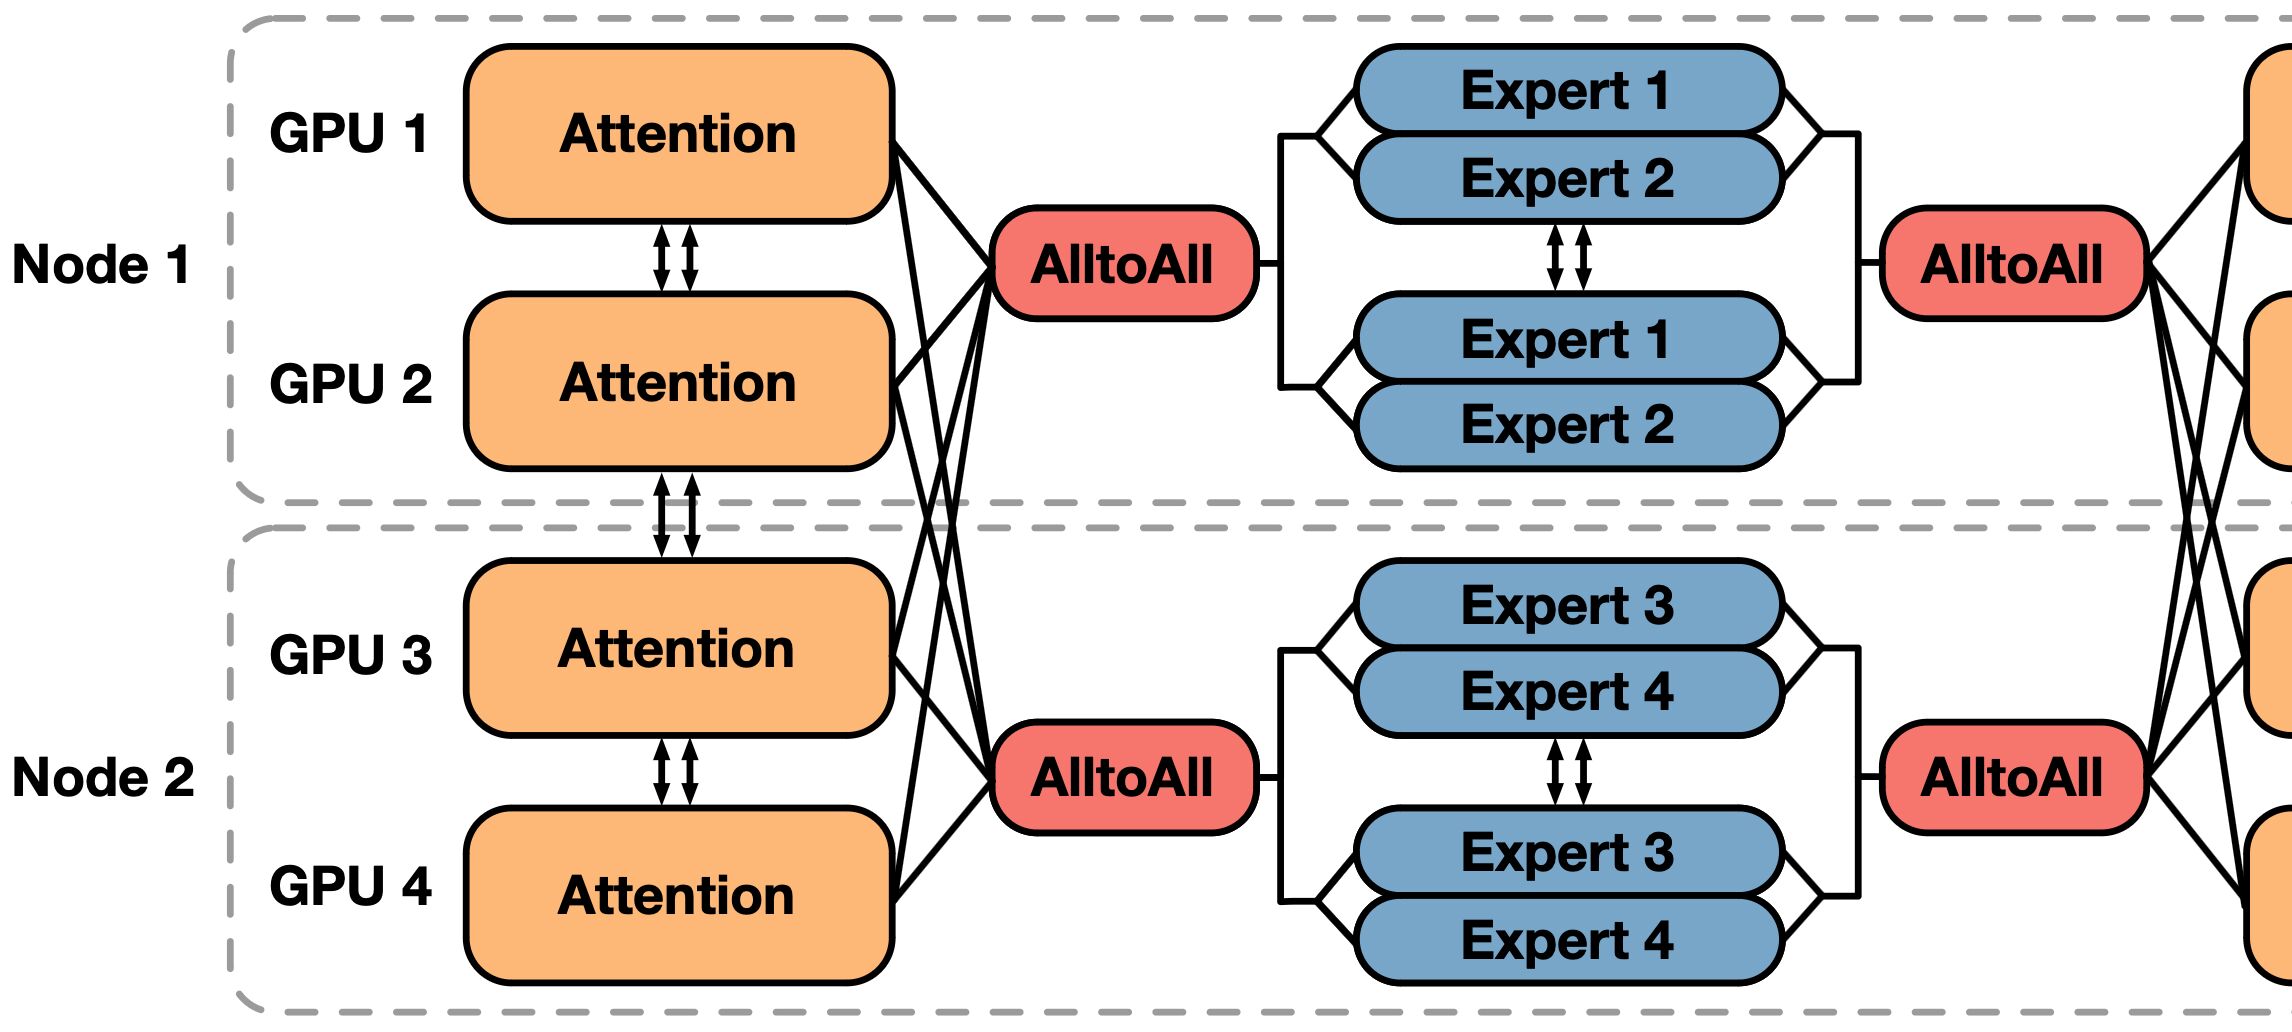
MoE 每个解码步都要做一次专家并行的 all-to-all 通信,通信带宽直接决定加速器利用率。这是 DeepEP 成为六件套战略核心的原因,也是 128 卡超节点必须与通信库联合设计的原因。
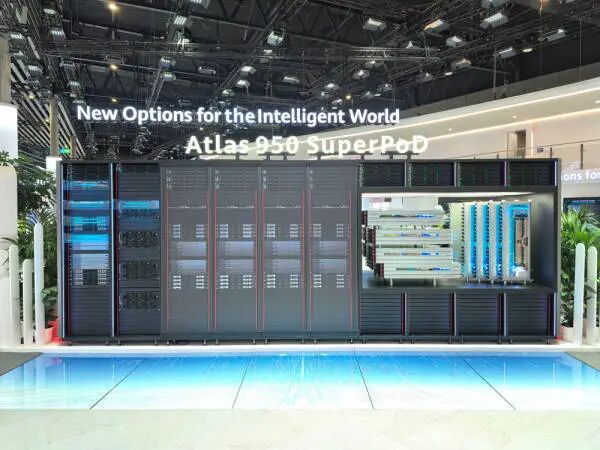
硬件侧的底牌是双方联合定义的 SuperPoD Flex:128 卡一级 scale-up 网络 3.2 Tbps,二级 scale-out 至 256K 卡,配套 ASC-COMM 通信算子库与大 EP 低延迟推理、长上下文 KV 池化等 CANN 社区 recipe。华为同时宣布 960DT 训练芯片提前至 2027 年一季度。
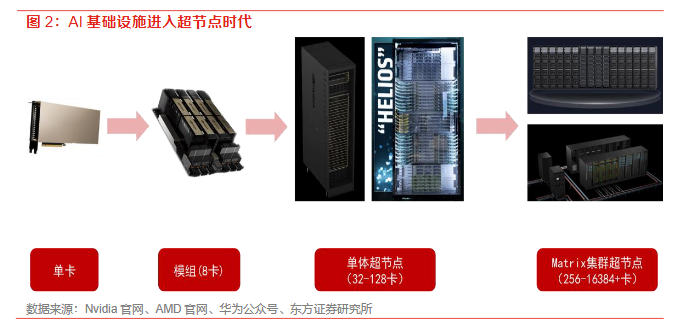
给这套"机柜叙事"一个普通读者能理解的参照系:券商测算,达到同等算力(相比英伟达方案),华为方案需要约 3.2 倍的芯片数量和约 2.3 倍的系统功耗;采购侧的锚点是中国移动 2026–2027 年超节点集采——6208 张加速卡、折合 776 套设备,最高投标报价约 20.7 亿元。"另起地基"的真实代价,是用规模、功耗和资本开支换生态自主。行业竞争的计量单位正在从"单卡"变成"机柜";机柜级互联的技术胜负手是通信库,而通信库的复用障碍是另一回事——DeepEP-Ascend 尚未附许可证。
五、生态博弈:英伟达生态的墙没有被正面推倒,但默认选项地位已被侵蚀
先把英伟达生态的墙看成三层:心智层(写 GPU 代码默认 CUDA,就像写网页默认 JavaScript)、迁移层(代码、工具链、调优经验全绑在 CUDA 上)、锁定层(买了英伟达的卡就只能在 CUDA 生态里)——而 CUDA 是这堵墙的默认地基。DeepSeek 这次动的是心智层:TileLang 让"写算子"不再默认等于"写 CUDA kernel",一个开发者写 *_kernel.py,运行时自动选 *_cuda.py 还是 *_asc.py,新一代开发者的肌肉记忆可能不再是从 __global__ 开始的。
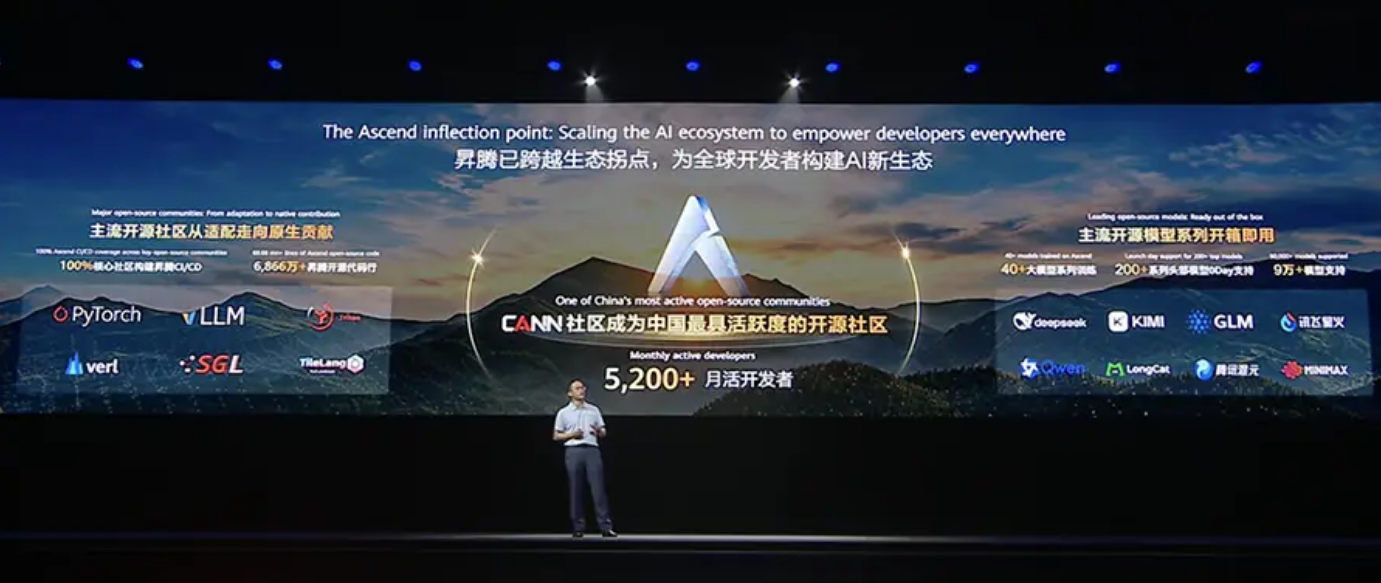
数字的对比也要选对口径:一边,CUDA 有约四百万开发者,二十年沉淀的工具链、文档与问答社区;另一边,按华为发布会自己公布的口径,CANN 社区月活开发者约 5,200——这里指的是官方开发者社区的月活,而非昇腾生态的实际开发者总数。两者不是同一口径,不能直接比较;但即便只看活跃指标,差距方向仍然明显。
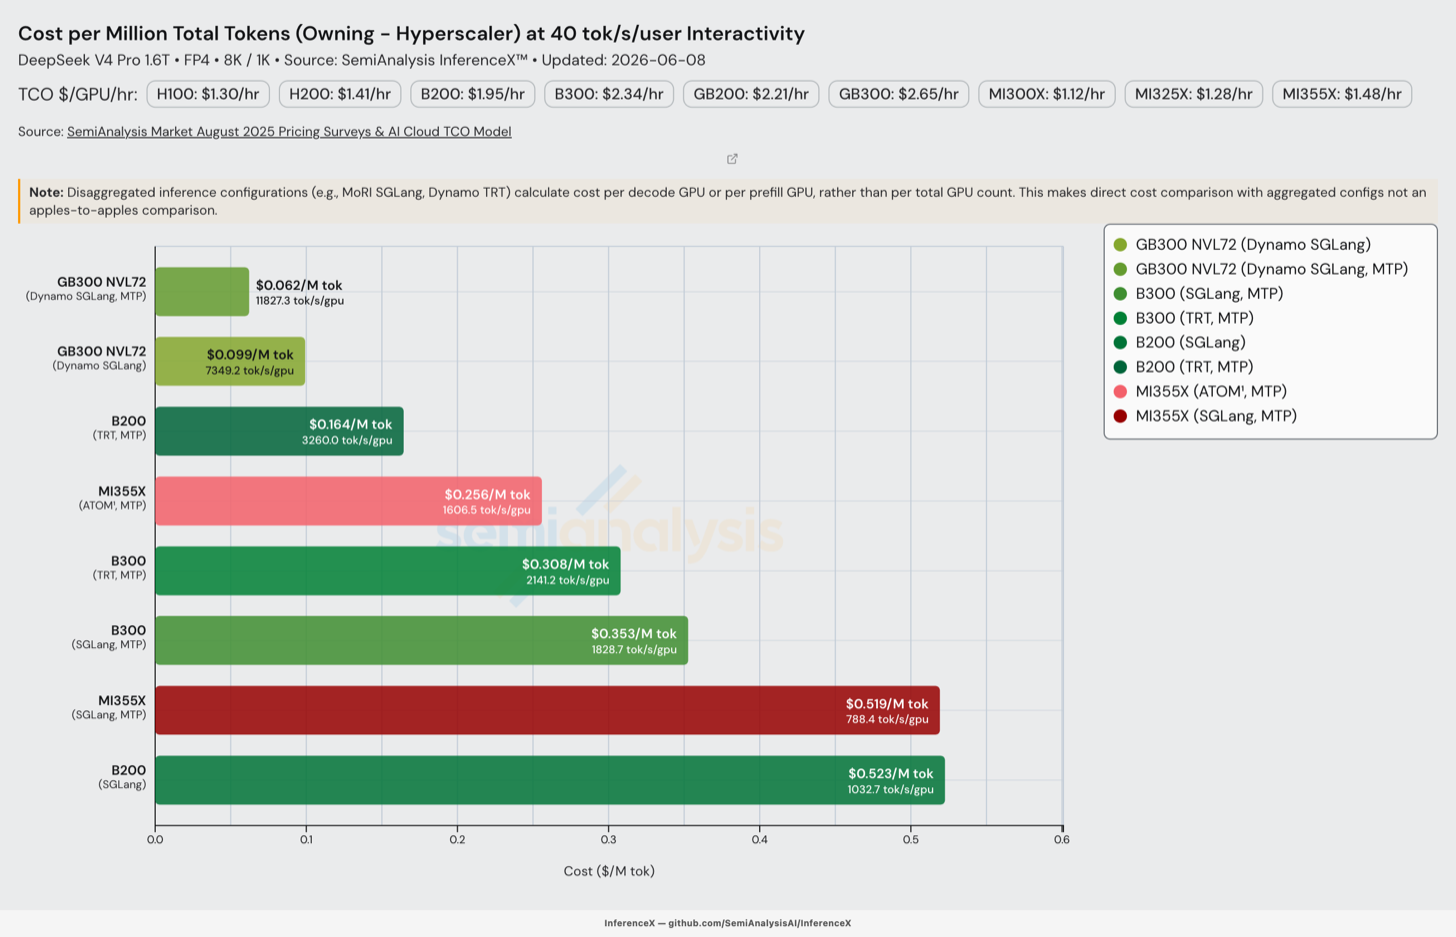
侵蚀会不会从推理蔓延到训练?链条是这样的:推理部署相对标准化、硬件选择弹性大、成本敏感,是墙最薄的一段,六件套里 FlashMLA、DeepSelect 正是打在这里;推理侧沉淀的 TileLang 算子和工程经验,与训练框架自定义算子共享同一套抽象;当算子层与硬件解耦,训练框架更换后端的边际成本随之下降。推理场景的硬件弹性又直接反映在每百万 token 的 TCO 上。生态战争最终要在成本曲线上见分晓。
英伟达生态的墙不会被一次开源推倒,但 CUDA 的"默认选项"地位正在被一种更安静的方式侵蚀——这才是真正的拆。
六、从能编译到能调优:隔着生态最贵的一段路
硬件限定为昇腾 950 系列;软件栈要 CANN 9.20 + torch_npu + Python 3.10+ + C++20,需要克隆源码、运行 develop.sh 链接头文件、再 pip 安装;DeepEP 的完整性能要等 10 月中的商用 HDK;跑完整模型则依赖社区维护的 vLLM-ascend。
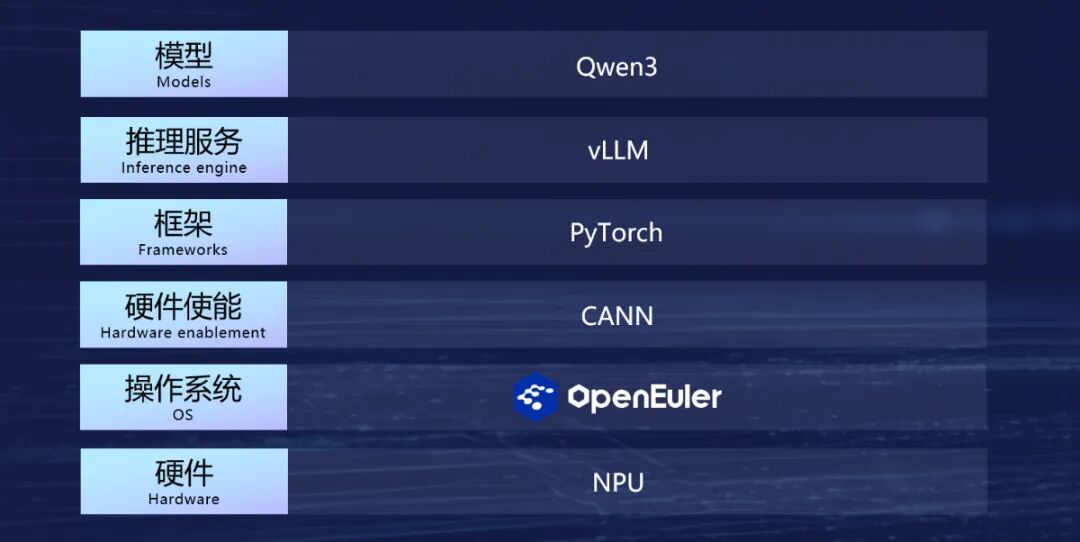
六件套给的是工具,不是工具链:没有 Nsight 对等的性能分析器,没有成熟调试器,调优仍要下沉到 Ascend C。社区里"CANN 多次重构、版本混乱、门槛高"的吐槽,指向同一个缺口——从"能编译"到"能调优",隔着生态最昂贵的一段路。当前可及性是:算子可用、栈可用、全模型推理仅实验可用、生产级复制暂不可复现。对一个开发者而言,"能不能跑通一次推理"远比"99.8% 的峰值算力"重要。
七、三块未砌牢的砖:数据布局、工具链、第三方复现
第一块砖是数据布局。第一节所述的错位,尚未看到公开的通用消除方案:UE8M0 打包与 MN-major 存储意味着任何跨平台权重迁移都要做物理排布适配,而"API 兼容"的声明本身未经独立测试。调用代码零改动的前提,是权重数据先过一道手工的坎。
第二块砖是工具链。第六节所述的缺口同样没有补齐时间表:没有性能分析器,没有成熟调试器,vLLM-ascend 仍靠社区维护。工具可以由六件套交付,工具链只能由生态积累——这是用钱和代码都换不来的部分,只能靠时间。
第三块砖是第三方复现,也是最关键的一块。截至 10 月 1 日的公开信息,六件中唯独 DeepEP-Ascend 未附许可证文件,其余五件均为 MIT;DeepEP-Ascend 在许可证明确前,第三方不能合法复用。而全栈复现又绕不开 DeepEP-Ascend——它是六件套里与超节点硬件耦合最深的通信核心。值得追问的不是"是否疏忽",而是"为何偏偏是通信库":DeepEP 与超节点硬件耦合最深、最依赖底层指令,暂时的缺证更像一种法律或商业保护姿态。而只有当与 DeepSeek、华为均无利益关系的第三方,在公开市场采购的硬件上复现出可审计的生产级结果时,一切"生态拐点"的表述才站得住;在那一天到来之前,都应是试探性的。
结语
回到"地基"这个隐喻:接口契约这一层已经对齐,算子效率接近封顶,但数据布局、工具链、第三方复现三块砖还没砌牢。另起地基的人手里已经有了路线图,而第三方复现这一环,仍卡在 10 月中的商用 HDK 和 DeepEP-Ascend 的许可证上。
国产算力多了一个开发与实验可用的选项,但还不是一个"无脑替换"的选项。而真正的验收标准只有一个:无利益关系的第三方,在公开市场采购的硬件上,复现出可审计的生产级结果。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)