
昇腾 NPU 一卡多用怎么做?CubeStudio 昇腾 vNPU 静态切分实操(910B3:npu-smi 切分 + K8s 挂载 + PyTorch 验证)
CubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
官网:https://www.cubestudio.vip | GitHub:https://github.com/data-infra/cube-studio | Gitee:https://gitee.com/data-infra/cube-studio
关键词:CubeStudio、cube-studio、昇腾、Ascend、vNPU、NPU 虚拟化、NPU 切分、910B、910B3、npu-smi、create-vnpu、vir05_1c_16g、presetVirtualDevice、ASCEND_VNPU_SPECS、MindX DL、device-plugin、torch_npu、国产 NPU、信创、Kubernetes、一卡多用、算力利用率
一张昇腾 910B 显存 64G,而开发调试、小模型推理往往只需要十几 G——整卡独占的结果就是昂贵的 NPU 大量闲置。昇腾的 vNPU 虚拟化允许把一张物理卡按官方模板切成多张虚拟卡(如 1/4 颗粒度切 4 张),各自独立挂给不同 Pod,一卡多用。
本文是 CubeStudio 昇腾三部曲第二篇:以 910B3 为例,走通「主机切分 → device-plugin 改造 → K8s 资源验证 → PyTorch 实测」全流程。
一、切分方案总览
| 项目 | 说明 |
|---|---|
| 切分方式 | 静态切分:npu-smi 按官方模板预切(本文);MindX DL 也支持任务时动态创建 |
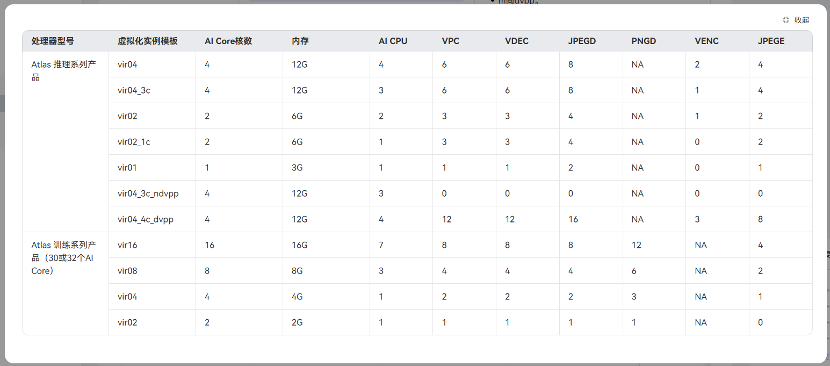
| 模板体系 | 按卡型提供固定规格模板,如 vir05_1c_16g(5 AI Core / 1 CPU / 16G 显存,910B3 的 1/4 颗粒度) |
| 挂载限制 | 一个 Pod 只能占一张 vNPU |
| 重启保留 | vnpu-cfg-recover 开启后设备重启切分配置不丢 |
| 平台申请 | CubeStudio 里 1(vnpu),资源名按实际切分规格配置 |
二、主机切分 vNPU(npu-smi)
1. 设置虚拟化模式为容器模式(仅物理机需要执行;0=容器模式,1=虚拟机模式):
npu-smi info -t vnpu-mode      # 查看当前模式
npu-smi set -t vnpu-mode 0     # 改为容器模式
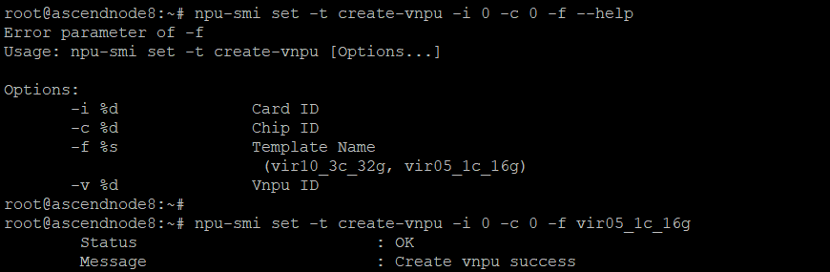
2. 查看本卡型支持的切分模板(-i 卡号、-c 芯片号、-f 模板):
npu-smi set -t create-vnpu -i 0 -c 0 -f --help
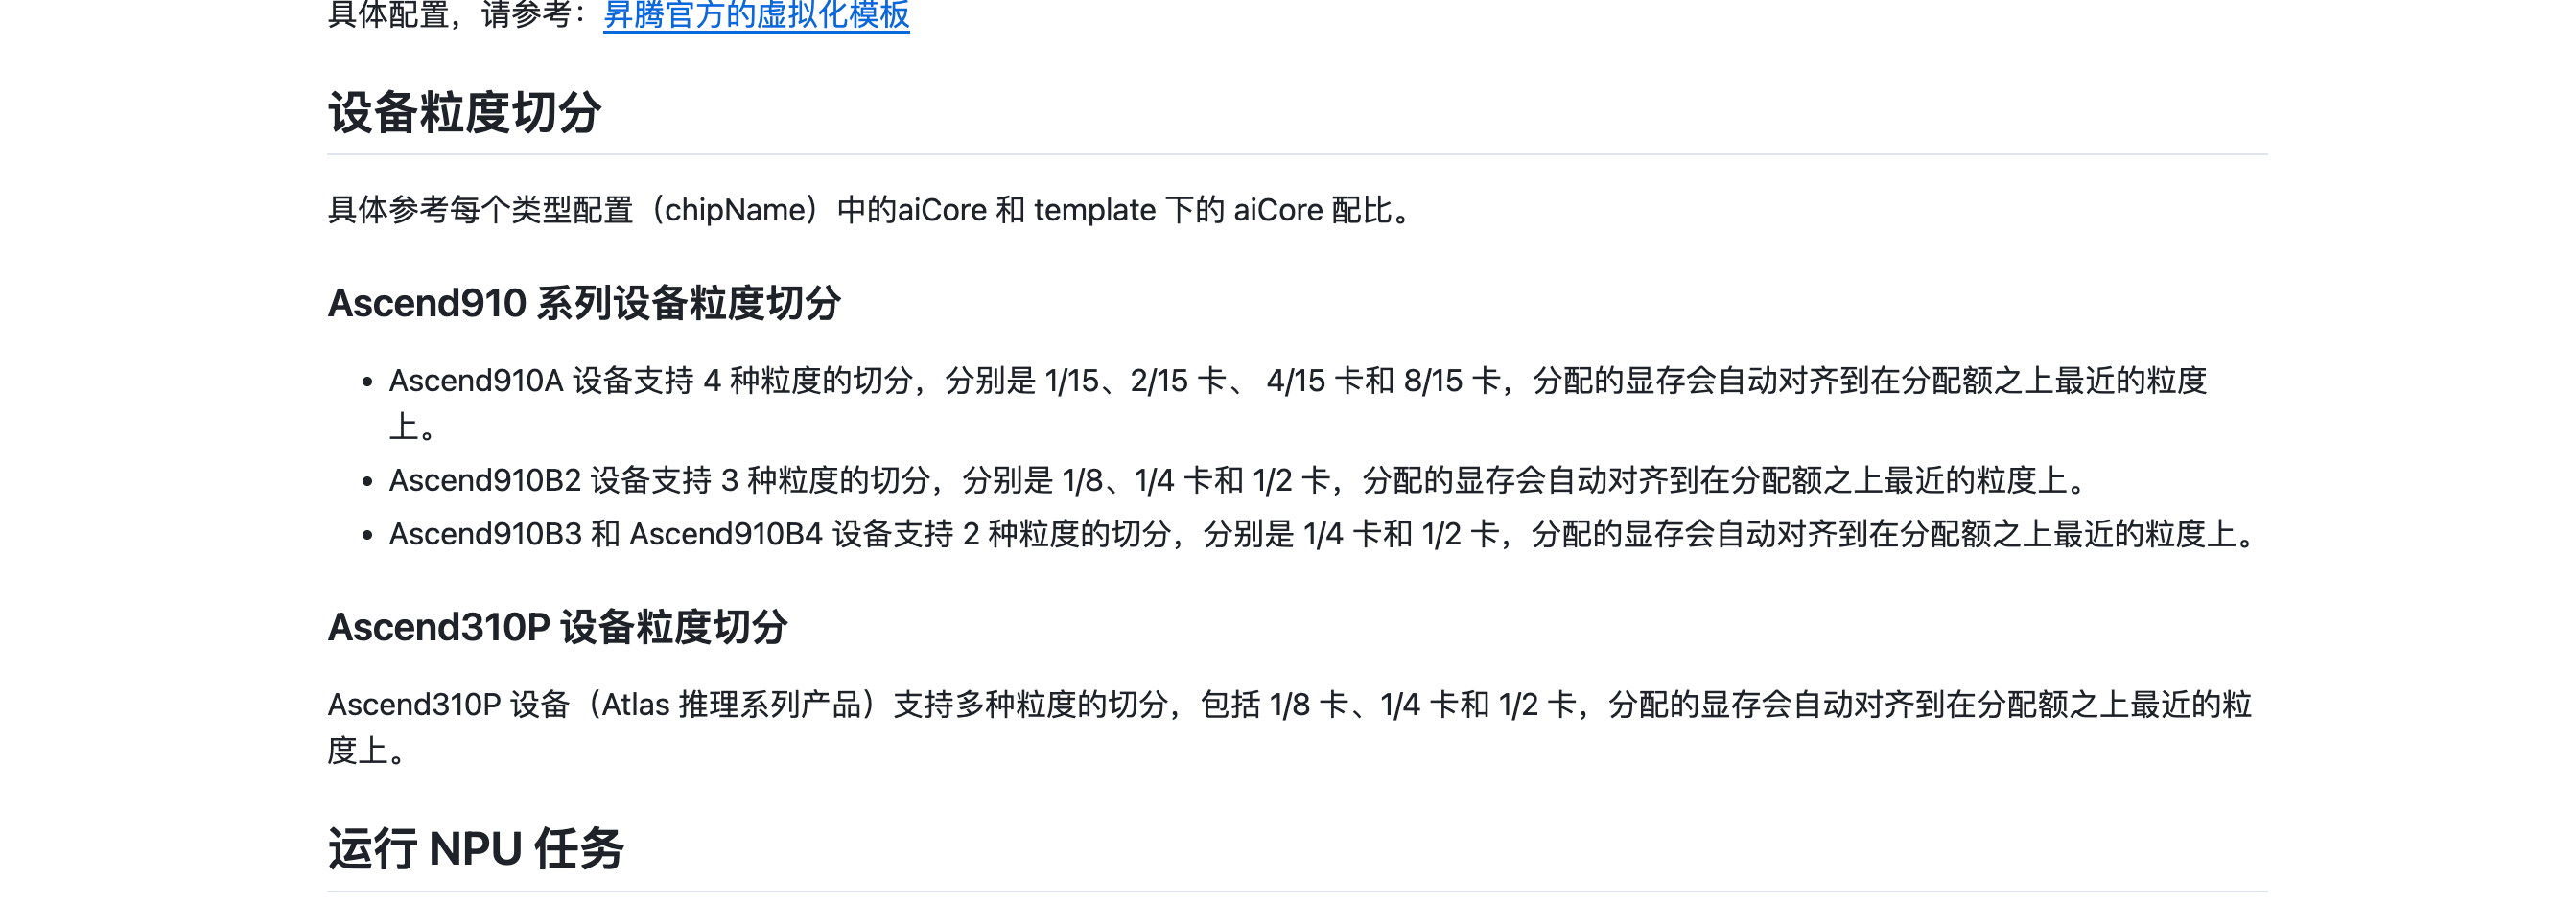
模板名即规格(可按名称对出配置):
3. 创建 vNPU(vir05_1c_16g 为 1/4 颗粒度,可执行 4 次切 4 张):
npu-smi set -t create-vnpu -i 0 -c 0 -f vir05_1c_16g
4. 开启重启保留(设备重启后切分配置依然有效):
npu-smi set -t vnpu-cfg-recover -d 1
5. 查看 / 销毁:
npu-smi info -t info-vnpu -i 0 -c 0                # 查看(含 vnpu id)
npu-smi set -t destroy-vnpu -i 0 -c 0 -v <vnpu_id> # 销毁
两个补充:① 用 MindX DL 动态虚拟化时无需预切,任务运行时自动创建;② Ascend Docker Runtime 也支持拉容器时用
ASCEND_VISIBLE_DEVICES+ASCEND_VNPU_SPECS直接从物理芯片切出 vNPU 挂载。
三、device-plugin 切换到 vNPU 模式
在 device-plugin 容器的 args 中添加 -volcanoType=false -presetVirtualDevice=true:
containers:
- image: swr.cn-south-1.myhuaweicloud.com/ascendhub/ascend-k8sdeviceplugin:v6.0.0
  name: device-plugin-01
  command: [ "/bin/bash", "-c", "--"]
  args: [ "device-plugin -useAscendDocker=true -volcanoType=false -presetVirtualDevice=true -logFile=/var/log/mindx-dl/devicePlugin/devicePlugin.log -logLevel=0" ]
  securityContext:
    privileged: true
    readOnlyRootFilesystem: true
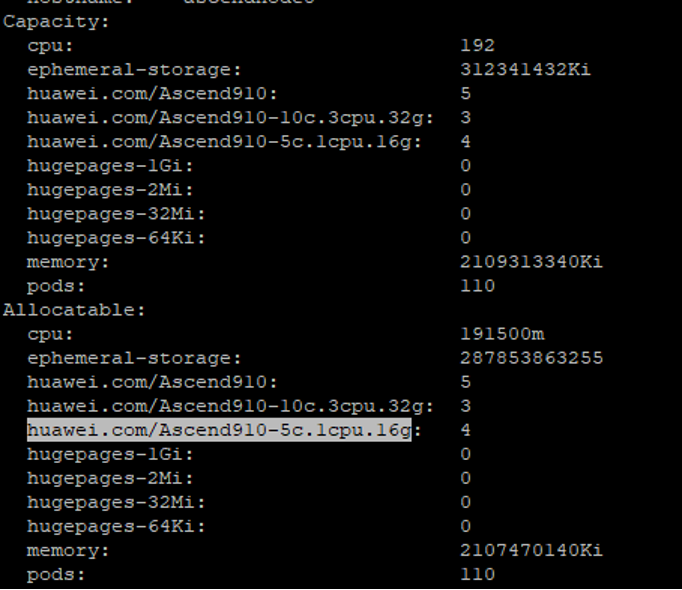
四、验证 K8s 上报 vNPU 资源
kubectl describe node <nodename>
节点资源里出现 vir05_1c_16g 规格的资源即成功:
五、PyTorch 实测
用昇腾 PyTorch 镜像起测试 Pod(记住:一个 Pod 只能占一张 vNPU):
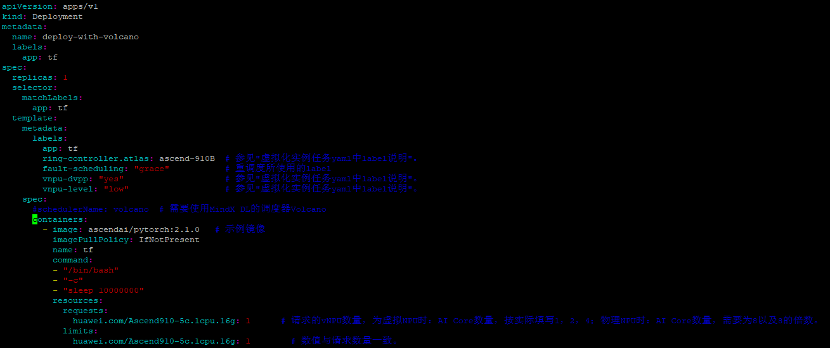
容器内验证(如报 libgomp1 错误先 apt-get install -y libgomp1):
source /usr/local/Ascend/ascend-toolkit/set_env.sh
import torch
import torch_npu   # torch_npu 2.5.1+ 可省略手动导包

a = torch.randn(3, 3).npu()
b = torch.randn(3, 3).npu()
c = torch.matmul(a, b)
print(c.cpu())
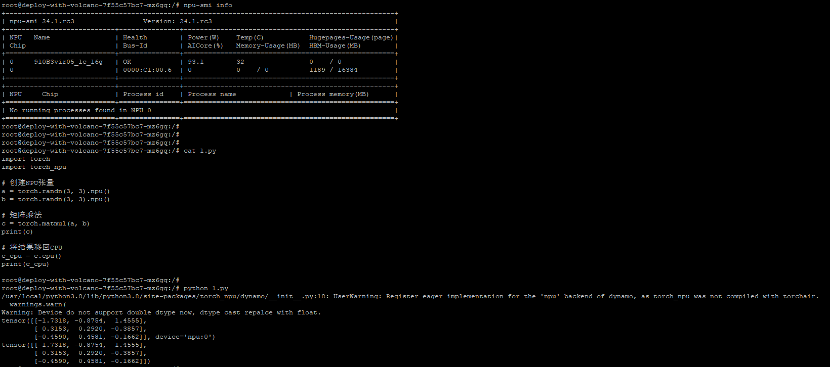
矩阵乘法在 vNPU 上正常执行,切分生效。
六、平台侧配置
CubeStudio 的 GPU_RESOURCE 已预置 vNPU 资源项,按你实际切分的规格调整资源名即可:
GPU_RESOURCE = {
    ...
    "vnpu": "huawei.com/Ascend910-5c.1cpu.16g",   # 按实际 vNPU 切分规格填写
}
用户在 Notebook / 推理服务的 GPU 字段填 1(vnpu) 即可申请一张虚拟卡——开发调试、小模型推理场景下,一张 910B 服务四个人,NPU 利用率直接翻倍以上。配合平台的多资源组、项目组配额与计量计费,可实现昇腾算力的精细化运营。
本系列下一篇:MindIE 大模型分布式推理——在 910B / 310P 上部署 DeepSeek 级大模型。
了解更多
CubeStudio 采用 MIT 开源协议,开源免费商用并支持源码交付与二次分发,开源版本已有数千家企业私有化部署。
- 官网与在线文档:https://www.cubestudio.vip
- 开源仓库(GitHub):https://github.com/data-infra/cube-studio
- 开源仓库(Gitee):https://gitee.com/data-infra/cube-studio

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献5条内容

所有评论(0)