登录社区云,与社区用户共同成长
邀请您加入社区
围绕NPU算力卡切分和动态资源配置,通过vNPU和NPU DRA能力,实现昇腾 NPU 的精细化管理与灵活调度;同时新增超节点拓扑亲和调度能力,有效提升业务性能。InferNex进一步优化大模型部署能力与推理性能,多轮对话场景相比基线首token时延最高降低45.8%,总吞吐量最高提升67.5%。新增Agent沙箱调度能力,实现沙箱并发创建调度吞吐量>3000 实例/s。
2026年AI竞争已从模型层下沉至算子、编译器与芯片驱动。DeepSeek将TileLang等底层组件成功迁移至华为昇腾,实现跨架构统一编程,突破国产算力生态瓶颈。其核心意义在于:用抽象语言描述计算意图,编译器自动适配NVIDIA/昇腾/AMD后端,大幅降低开发摩擦。同时,OpenAI探索大模型辅助EDA,推动芯片设计智能化。未来真正壁垒不在模型,而在算子语言、编译优化、系统调度与软硬协同能力。开
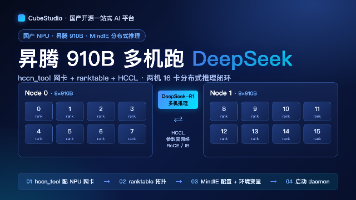
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾等国产算力,原生适配910B/310P NPU,实现DeepSeek等大模型的单机多卡与多机分布式推理。本文详解基于MindIE引擎的多机部署全流程:通过hccn_tool配置NPU参数面网络,生成ranktable.json拓扑文件,设置HCCL通信与环境变量(如RANK_TABLE_FILE、WORLD_SIZE),并结合C
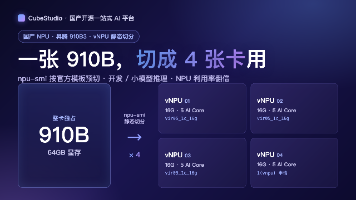
CubeStudio是一款国产化、云原生的一站式开源AI平台,支持昇腾、寒武纪等国产算力,原生适配vNPU虚拟化。本文以昇腾910B3为例,详解通过npu-smi静态切分、device-plugin改造、K8s资源上报及PyTorch实测全流程,实现一卡多用,显著提升算力利用率。平台支持多租户、分布式训练与大模型微调,助力企业低成本高效部署AI应用。
Volcano:批量调度的事实标准,队列/优先级/Gang/公平调度一站式解决;HAMi:异构虚拟化中间件,一张昇腾卡切成多个细粒度实例,多芯适配(昇腾/海光/寒武纪)贴合信创诉求;两者互补:调度层决策"往哪跑",设备层解决"怎么共享",是昇腾 NPU 集群资源池化的成熟路径。多芯异构统一池:同一集群纳管昇腾 + 海光 + NVIDIA,用统一资源名做跨芯调度;任务队列治理:结合公司多租户场景设计
AI硬件端侧化趋势明显,苹果2nm芯片、英伟达边缘计算平台相继发布;具身智能迎来资本热潮,小鹏机器人估值创新高;新能源汽车充电基础设施持续完善,自动驾驶责任认定纳入立法议程;半导体产业链受AI需求驱动,存储芯片价格大幅上涨。
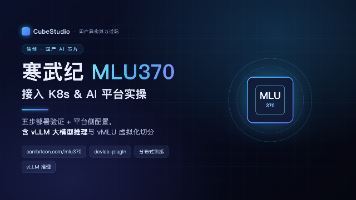
摘要: CubeStudio作为国产开源AI平台,全面支持寒武纪MLU370芯片的Kubernetes调度与AI任务全流程。本文详细介绍了从驱动安装、K8s组件部署到平台集成的五步操作方案,实现MLU卡在Notebook开发、分布式训练及vLLM大模型推理中的应用。平台通过资源映射机制(如1(mlu370)格式申请)统一管理异构算力,并支持vMLU虚拟化切分。该方案已适配昇腾、海光等国产芯片,助力
点量云流深耕六年,率先完成国产操作系统、CPU及GPU的全栈适配,并上架鸿蒙应用市场。以“数据不落地”的实时云渲染方案,让三维应用在信创环境下流畅运行,助力国产化替代成为体验与安全的升级。
问题出在DCMI 24.1.rc1 对 310B1 芯片返回的 AI Core 数量是浮点数1.000000(310B1 只有 1 个物理 AI Core)。函数将其转为int64(1),然后检查[8, 36]的合法范围——1 < 8,直接被拒绝。device-plugin 的 AI Core 数量范围默认假设芯片至少有 8 个 AI Core,而 310B1 只有 1 个。这是一个代码层面没有考
GPUInventory Port 的统一抽象——这是根基。如果调度器看到的是两套不同的 API(`nvidia-smi` 和 `npu-smi`),混合部署就永远停留在运维手册层面,无法成为平台能力。HAMi 的跨芯片虚拟化——昇腾 vNPU 切分和 NVIDIA MIG/vGPU 切分在 HAMi 层完成统一建模,对上层暴露完全一致的资源申请语义(`gpu-memory: 16GB, gpu-
适合工程项目,测绘CAD放样,检测鉴定图纸标记,环保装备现场巡查等场景应用。
改完环境变量后,后续所有 modelscope/huggingface 操作都自动走大分区,无需每次手动指定路径。恢复方法:停止 Docker,将旧目录内容 mv 到新路径,再启动 Docker。对应 CANN 9.0,可在页面右上角切换版本,选与驱动版本匹配的(本机驱动 25.5.2)。(内核 6.6.0-159.x),SP4 内核与驱动预置的闭源二进制模块不兼容,会导致。Root Dir 被改
昇腾NPU强化学习训练实战——从PPO到GRPO的完整落地
昇腾 NPU 在 Kubernetes 上的落地实战指南
《欧拉系统:华为服务器算力底座与行业生态适配》深入解析了华为欧拉操作系统作为鲲鹏、昇腾算力集群底层软件的核心架构。文章从四层模块化架构(内核优化、集群调度、算力适配、行业生态)展开工程化拆解,揭示其如何实现服务器资源高效调度与行业适配。针对当前工程落地痛点,提出双路径解决方案:原架构优化可提升40%算力利用率,而本源架构重构方案更能实现80%的性能提升。作为系列第7篇,该文完整呈现了欧拉系统在华为
图注:Ascend C 算子逻辑架构。左侧 Host 负责切分策略(Tiling),右侧 Device (Kernel) 负责计算执行。图片来源:昇腾社区 CANN 8.3 文档当我们谈论“CANN的新架构体验”时,我们实际上是在谈论Ascend C 的 SPMD(单程序多数据)编程模型。这不是替代了CANN原有的架构图,而是将物理硬件的抽象直接映射到了代码逻辑中。Host 侧决定“怎么切”,De
Kurator开源项目实践分享 从用户视角切入Kurator分布式云平台,通过解决多集群监控安装问题首次贡献开源社区。从文档修正到功能优化,逐步深入参与Feature开发,体验开源协作全流程。 核心收获 文档贡献是开源入门最佳路径 真实需求驱动技术深度探索 开源设计需平衡创新与克制 关注专栏《零基础学鸿蒙开发》,获取完整学习路径!
摘要:本文介绍了在昇腾NPU上部署Qwen3大模型并打包为可移植镜像的完整流程。通过docker commit固化运行环境,利用docker-compose.yml管理启动参数,配合.env文件配置可变路径,实现模型服务一键部署。重点解决了环境一致性、路径适配和跨机器迁移问题,并提供了常见错误排查方法,为昇腾NPU用户提供了一套高效可靠的模型部署方案。(149字)