登录社区云,与社区用户共同成长
邀请您加入社区
samba 4.21.0(SMB/CIFS 标准实现)在鸿蒙 PC(HAD-W24 / aarch64 / musl)上的适配全过程
适配QEMU 11.1.1至鸿蒙PC aarch64环境,攻克三大难点:静默回退的平台识别、OHOS签名与RUNPATH双门槛、CI中Python venv环境焊点。通过3个上游补丁及配方级修复,实现qemu-system-riscv64等7个可执行文件的签名交付。上游104项测试95通,消费者测试全通过,CI问题均定位至环境根因。项目已合并入主干,为鸿蒙PC生态提供RISC-V系统模拟底座。
Zeek 8.2.1成功移植至鸿蒙PC(aarch64)面临四大核心挑战:私有生成器工具链兼容、libc++标准库缺失(std::ranges/std::pmr)、CMake交叉模式ALIAS展开缺陷,以及测试链断裂。通过76个可移植补丁与2个零平台宏shim,修复10类差异,实现上游单测26/26通过,消费者测试在真机回放4/4
mpd 0.24.12 鸿蒙 PC 适配实录:40 个可移植源码补丁、8 个 pkg-config shim、meson 交叉编译;上游测试 16/16(170 例)、消费者 9 断言(含 null 输出播放闭环);CI 7 轮 4 绿,PR#13375合入 main并入制品仓。
lldb 0.0.1(llvmorg-22.1.0)鸿蒙PC aarch64 standalone 适配:8 个 CMake 补丁,消费制品仓预编译 llvm/clang 不重编 LLVM;上游测试全量执行 65025(lit 33638 @94.52% + gtest 31387 @99.91%,后者已含于前者逐用例条目,不可相加),120 个失败全归因(零适配缺陷);CI 11 轮 6 绿 5
小智的数字仓库通过动态数组与指针实现灵活管理,核心变量size(已存数量)、length(总容量)协同工作。添加数据时自动检测是否满员,若满则扩容至原容量两倍,确保存储可持续。功能涵盖增删改查、排序及批量删除,均通过函数封装提升可读性。输入采用do-while校验,防止越界错误。打印时仅遍历size范围,避免输出空位。整体设计兼顾安全性与扩展性,体现C指针在动态内存管理中的实战价值。
libadwaita 1.8.8 移植鸿蒙 PC(aarch64):1 个 portability 补丁、10 项适配解决 9 项环境差异。无显示下,63 个上游测试因 SIGTRAP 阻塞;2 个纯计算测试的 105 条公共 API 断言 1:1 通过,加扩展共 124 条消费者探针 124/124 全过;137 条私有 API 断言因符号未导出,分类留证。按“可移植断言子集”和“无显示 API
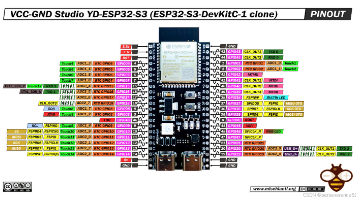
丰富GPlO:提供多达45个可编程GPlO,支持PWM、SPl、12C、UART、12S、SDI0等通信协议。·丰富GPIO:提供多达45个可编程GPIO,支持PWM、SPI、I2C、UART、I2S、SDIO等通信协议。.PSRAM:8MB(R8表示PSRAM容量),扩展动态内存,支持复杂应用(如图形显示、音频处理)。·USB功能:内置USB OTG(On-The-Go),可直接连接USB设备(
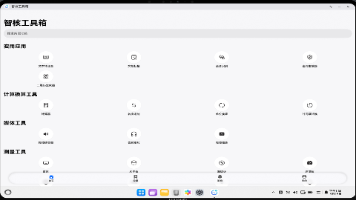
智核工具箱已上架华为应用市场,支持鸿蒙5及以上设备。集文本转语音、视频转音频、单位换算、随机抽号器于一体,搭载HarmonyOS 7同款沉浸光感视效,支持小艺智能体实时唤醒与智感握姿交互,操作更智能便捷。欢迎下载体验并留下建议,助力产品优化!
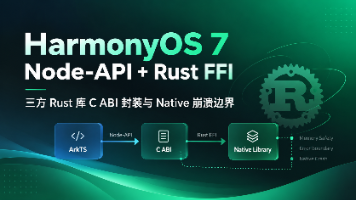
本文分享了在 HarmonyOS 中集成 Rust 库的实战经验,以感知哈希库为例,构建了“ArkTS → Node-API → C++ 桥接 → Rust C ABI → 第三方库”的四层架构。核心思想是:不为用 Rust 而用,而是通过严格边界隔离,确保错误可控。关键措施包括:Rust 仅暴露稳定 C 接口,使用 catch_unwind 捕获 panic 防止跨 FFI 爆炸;C++ 桥接层
本文以感知哈希库接入 HarmonyOS 为例,阐述 Rust 与 ArkTS 跨语言交互的可靠性设计。通过三层架构(ArkTS → Node-API → C++ Bridge → Rust C ABI),实现参数校验、异常捕获与崩溃防护。关键在于:Rust 仅暴露稳定 C ABI,使用 catch_unwind 阻止 panic 穿越边界;C++ 桥接层专注类型转换与错误映射;ArkTS 侧仅处
C语言初学者在鸿蒙PC的实操中关于vim文件意外退出导致报错的解决方法分享
算子是神经网络中对数据进行线性与激活处理的基本单元,由名称、类型和数据容器(张量)构成。在昇腾AI处理器中,算子计算主要由AICore完成,其采用达芬奇架构,包含Scalar、Vector、Cube三大计算单元及DMA搬运单元,实现“控制与计算分离、搬运与计算并行”。通过AscendCL统一接口调用算子,结合LocalMemory高速缓存与GlobalMemory数据交互,提升计算效率。使用Asc
用户拿着手机绕着东西走一圈,App 里就能 360° 转着看这个模型。听起来像"调个相机 + 调个模型加载"的活。我打开官方文档准备抄一段示例,结果第一眼就发现事情不对:**我在网上搜到的那些 ArkTS 重建代码,在官方文档里根本找不到对应接口。**这件事值得先说,因为它决定了你这三天的调研方向是不是从一开始就跑偏了。
本文基于学校实验《鸿蒙PC C++三方库交叉编译及应用》的流程,把实验里用的 cups、libplacebo 换成更常用的 OpenSSL,带你完整走一遍「环境搭建 → 编写 HPKBUILD → 一键交叉编译 → HNP 打包 → ABI 校验 → DevEco Studio 集成调用」的标准化移植链路。适合:第一次在 Ubuntu 上给鸿蒙 PC 交叉编译 C/C++ 三方库的开发者;以及想给
(显示芯片型号、实时温度、当前功耗、12GB NPU 内存占用等),那么恭喜您,您的整套系统和硬件联调已经完美成功,随时可以展开您的昇腾边缘端 AI 算法开发之旅了!切换,非常麻烦 [1.1.2]。(注:在 Linux 终端中输入密码时,屏幕上不会显示任何星号或波动,直接输完敲回车即可!执行完毕后,您下次在 MobaXterm 新建 SSH Session 时,(注:请务必看清容量,千万不要勾选电
摘要:Type-C一线通已成为工业、车载、信创等设备的标准接口,但传统多芯片视频转换方案存在兼容性差、布局复杂等问题。GSV6155单芯片方案集成了Type-C信号接收、DP转换、多路视频分发、DSC编解码和PD控制功能,支持4K@60Hz输出,适配国产操作系统与算力平台。其低功耗、小型化设计满足消费级和工业级设备需求,显著简化硬件开发流程,缩短量产周期。该方案与国产PCIe交换、存储芯片协同,完
深度学习模型的性能高度依赖高效算子实现,但面向专用加速器开发高性能算子仍耗时耗力,且对开发者专业能力要求极高。现有研究证明大语言模型(LLM)可生成正确、高性能的GPU算子;但针对神经网络处理器(NPU)的算子生成领域仍缺乏充分探索——根源在于NPU具备领域专属编程模型、公开开发案例稀缺、配套文档匮乏。若直接使用大模型生成昇腾C(AscendC)算子,代码正确率极低,充分凸显了GPU与NPU算子自
高度重合风险:AscendKernelGen已完整覆盖本方案全部诉求(32B基座、CoT数据集、SFT+RL训练、昇腾内核生成),若跳过基线评测直接从零自研,存在严重重复造轮子问题,技术评审、对外成果输出均存在短板;方法论统一:全赛道SOTA项目均采用两阶段训练,原方案仅SFT单阶段存在明显技术缺陷,必须补充RL执行反馈环节;数据集对标:Ascend-CoT v3样本量级、场景覆盖度远超本方案初始
国产CPU(龙芯、飞腾)、国产操作系统(鸿蒙PC版、统信UOS)、数据库内核,这些底层全是用C/C++堆起来的。:智能汽车的车载OS(AUTOSAR)、小家电的RT-Thread、甚至你手里的蓝牙耳机芯片,跑的还是C。既然你还在纠结这个问题,说明你对技术有敬畏心,这本身就比那些跟风转码的人强多了。如果你是科班,把《计算机组成原理》和《汇编》捡起来,C语言只是你的“刀”,而计算机体系结构才是你的“武
情绪热力图(Mood Heatmap)借鉴了 GitHub 贡献热力图的设计:横轴是星期一到星期日(7 列),纵轴是当月的周次(4-6 行),每个格子代表一天,格子的颜色深浅由当天情绪强度决定。与 GitHub 热力图的一个关键区别:GitHub 用绿色深浅表示代码提交量(越多越绿),我们的情绪热力图用颜色梯度表示情绪状态——越开心越绿,越难过越红。这是一个语义对用户的直接映射,不需要额外的图例学
FFI(Foreign Function Interface)顾名思义,是让一种编程语言调用另一种"外国"语言编写的函数接口。Dart FFI 从 Dart 2.5 开始作为dart:ffi包引入(Dart 2.12 稳定),允许 Dart 代码直接调用 C 语言的函数,无需通过 Platform Channel、无需序列化、无需异步等待。核心优势在于零拷贝的直接调用│ FFI 调用 vs Pla
2026年高端电视市场三大技术阵营对比分析:画质派(如索尼X85L)专注色彩与对比度,适合夜间观影;音效派(如东芝Z700MF)强化声场沉浸感,提升观赛体验;智慧派(华为智慧屏MateTV)以鸿蒙生态为核心,实现画质、音效、交互全面升级,成为2万元以上高端市场占比超35%的标杆产品。选购建议:画质党选OLED旗舰,氛围党重音响配置,家庭用户推荐华为智慧屏,预算有限优先保证基础画质。未来电视竞争正从
在 AI 计算场景中,算子的执行效率直接影响模型训练与推理的整体性能。Ascend C 作为面向昇腾 AI 处理器的算子开发语言,提供了丰富的编程接口与硬件抽象能力。然而,要充分发挥硬件潜力,开发者需要系统性地识别并消除性能瓶颈。本文从搬运、内存、API 使用、流水、Tiling 及头开销等六大方向出发,结合实际案例,总结了一套可复用的性能优化方法论,帮助开发者快速定位问题并实施有效优化。
Android 手机 APP 通过 WiFi TCP 协议远程控制搭载麦克纳姆轮的 STM32 小车,将药盒自动运送至指定房间(客厅/卧室/厨房),配合分级语音提醒,确保老人或患者按时准确服药。通过 HC-SR04 超声波传感器非接触式实时监测宠物水碗水位,当水位连续检测低于阈值时自动启动水泵补水,同时通过 I2C LCD1602 显示屏实时展示水位状态和系统提示。的全场景宠物服务智能应用,个人独
CNSH 不是把英文关键字翻译成中文,而是为中国技术主权场景重新设计的一门脚本语言。本文从龙芯、鸿蒙、欧拉等底座出发,解释为什么中国人需要自己的脚本语言,并给出 Hello CNSH 与批量归档日志的实战代码。
工业机器人操作系统分类指南 工业机器人操作系统分为三大类: 底层实时RTOS:负责运动控制与安全,如VxWorks(ABB/KUKA等采用)、QNX(协作机器人常用)、实时Linux(国产主流)及国产系统(SylixOS、鸿蒙等),需微秒级硬实时能力。 整机厂商专用系统:如FANUC的ROBOTGUIDE、ABB的RobotWare,基于VxWorks/Linux封装,含专属编程语言与工艺包,用于
AscendC = 昇腾 AI Core 专用算子开发语言, 不是 CUDA for 昇腾. 它用 CopyIn → Compute → CopyOut 三段式 + 显式 TBuf/TQue 内存管理 + 用户写 Tiling 函数实现多核并行, 是 2026 年新算子项目的推荐方案.三个关键事实范式 = 三段式 + 显式数据搬运: 与 CUDA 完全不同, 数据从 Global 到 Local
场景推荐模式适配算法库(PyTorch/vLLM)算子框架研究原型 / 性能验证直调需要图模式 / 算子融合算子框架需要 MIX 并行算子框架(直调不支持)
本文详细解释了Ascend C编程中CopyIn、CopyOut和DataCopy的区别与联系。CopyIn和CopyOut是Vector编程范式的两个核心流水线阶段,分别负责数据搬入和搬出;而DataCopy是实现这两个阶段数据搬运的具体API接口。CopyIn阶段通过DataCopy将数据从全局内存(GM)搬入本地缓存(UB)的VECIN队列,Compute阶段执行矢量计算后将结果存入VECO
本文系统介绍NAPI(Node-API)在HarmonyOS中的使用方法,帮助开发者实现ArkTS与C/C++代码的互操作。主要内容包括: NAPI核心概念:介绍napi_env、napi_value等关键概念及模块注册机制 开发环境配置:详细说明工程配置、CMake设置和类型声明 开发全流程:从函数编写、参数获取到类型转换和模块注册的完整步骤 数据类型转换:覆盖数值、字符串、布尔值、数组等类型的
本文介绍了在鸿蒙应用开发中集成C/C++三方库的完整流程,以libmediainfo为例,重点讲解了如何通过NAPI机制实现ArkTS与C/C++的交互。文章对比了直接链接和dlopen动态加载两种集成方式,推荐使用直接链接方法,并详细说明了项目结构设计、SO文件放置、头文件管理和NAPI桥接层的实现。通过编写C++包装代码,将三方库的C接口转换为ArkTS可调用的NAPI接口,最终实现在鸿蒙应用
以下是基于技术文档的摘要(150字): GR3-Fourier V13.0鸿蒙级工业系统底层代码库提供10项核心算法源码,包括自适应模糊PID控制、三相SPWM调制、电池SOC估算等关键工业控制技术,均采用C语言实现高效嵌入式开发。配套1201-1600号超规格工业参数集,涵盖伺服系统(320Hz响应带宽)、精密机床(0.0015mm径向跳动)、液压控制(NAS6级油液过滤)等高端制造领域性能指标
atvoss(Ascend Template Vector Operator Subroutine Set)是一个高性能向量算子子程序库,旨在通过复用高频计算片段提升开发效率。它将常见计算模式(如归约、分块加载、softmax等)抽象为模板化的子程序,避免重复实现和修改不一致问题。atvoss与完整算子模板atvc形成互补关系,前者提供细粒度的基础组件,后者调用这些组件构建完整算子。子程序分为内存
电力系统暂态稳定性NPU加速仿真 该技术方案提出了利用NPU加速电力系统暂态稳定性分析的方法。核心是并行求解上百台发电机的摇摆方程——描述转子运动的二阶非线性微分方程组。传统CPU串行计算需15分钟处理一个故障场景,而该方案通过以下创新实现毫秒级响应: NPU并行计算架构: 所有发电机状态同步推进 雅可比矩阵分块LU分解使用Cube单元加速 网络拓扑切换采用批量代数运算 关键技术实现: 四阶Run
摘要 本文提供了昇腾CANN算子双版本模板代码的详细解析,包含CCE仿真测试和ACL设备运行两种模式的实现。代码通过宏分支区分编译环境,并兼容两种运行方式:CCE_KT_TEST模式用于本地CPU模拟调试,标准ACL模式用于真实昇腾硬件部署。模板演示了完整的ACL标准执行流程,包括资源初始化、内存分配、核函数调用和资源释放等关键步骤,并解释了aicore、Gm全局内存、blockDim等核心概念。
本文介绍了在CANN框架下开发自定义算子FusedSiLU(SiLU激活与残差加法融合)的完整跨仓库协作链路,涵盖5个关键环节: pyasc仓库:使用Ascend C DSL编写算子原型,实现融合计算(MatMul+SiLU+Add)以减少HBM读写; opbase仓库:提供基础组件(AscendCContext、TensorDesc等)支持; ops-nn仓库:完成kernel实现与注册(Inf
在昇腾CANN生态体系中,算子开发面临着效率与性能的双重挑战。catlass项目作为CANN生态中的模板库,承担着连接上层框架与底层算子实现的重要职责。该项目通过模板化设计,实现了与ops-math、ops-blas等算子库的高效协作,为开发者提供了一套可复用的算子开发范式。
昇腾算子开发“从入门到精通”——Ascend C开发者贡献指南
本文介绍了昇腾 CANN 的 Vector 算子开发模板库 atvoss,它能显著提升算子开发效率。该库封装了常见算子模式(逐元素运算、Reduce、Broadcast等),通过模板化处理数据搬运、地址对齐等重复代码,使开发代码量减少50%。文章以 Swish 激活函数为例,展示了如何使用 VecElementwise 模板快速实现算子,同时对比了手写代码与模板性能差异(约5-8%)。atvoss
本文介绍了pyasc(Python Ascend C Binding),这是一个用于昇腾NPU的快速算子原型验证工具。它允许开发者用Python语法编写算子,自动转换为Ascend C代码并在NPU上执行,性能可达手写Ascend C的80-88%。文章展示了如何使用pyasc实现Softmax等算子,对比了与手写Ascend C的性能差异(约10-15%差距),并列举了支持的核心操作(数学运算、
摘要: 本文探讨了华为AR Engine的ARSession与空间建模系统的协同工作方式。ARSession作为AR Engine的核心组件,负责实时追踪相机姿态和环境信息,而空间建模系统则利用PushARFrame接口接收这些数据完成3D重建。文章对比了手动PushFrame与PushARFrame的优劣,强调后者在实时扫描场景中的优势,并详细说明了两个系统的生命周期管理顺序(ARSession
本文介绍了在昇腾NPU上使用Ascend C语言开发自定义算子的完整流程。主要内容包括:1)算子开发背景,说明深度学习框架需要自定义算子来支持新功能或优化性能;2)详细开发流程,涵盖算子设计、实现、编译、部署和测试五个步骤;3)代码示例,展示了AddOne和MatMul算子的核心实现;4)性能优化技巧,如内存对齐、流水线设计等;5)实测数据表明,使用Ascend C开发的算子性能接近理论峰值。文章
昇腾CANN技术栈包含多个层次的设计抽象,其中PTO指令集(pto-isa仓库)和Ascend C编程语言是两个容易混淆但定位完全不同的技术组件。本文从指令集架构设计的角度,剖析PTO指令集的设计原则,以及它与Ascend C之间的协同与边界。
本文介绍了如何使用Ascend C语言在昇腾平台上开发自定义矩阵乘法算子。主要内容包括: 开发环境准备:安装CANN工具包并创建算子工程框架 算子原型定义:通过头文件和实现文件定义算子的输入输出及属性 核心算子实现: 使用GlobalTensor和LocalTensor管理内存 实现基本的矩阵乘法计算流程(GM->UB->计算->GM) 提供优化版本建议(使用Cube Unit加速) 文章详细展示