登录社区云,与社区用户共同成长
邀请您加入社区
暂无图片
为遵守国家网络实名制规定,未绑定将限制内容发布与互动
体系系统整合带来的问题:1. 跨平台API不一致,增加开发成本2. 体系系统更新频繁,导致应用频繁适配3. 封闭体系限制第三方创新,形成技术孤岛去年某社交应用团队在秋季新品季面临技术选择困境:是优先适配新旗舰手机的AI功能,还是专注于提升现有功能的稳定性。开发者需要建立技术评估框架,包括:1. 用户实际需求与使用场景2. 开发成本与维护难度3. 技术成熟度与长期支持4. 市场竞争与差异化需求面对秋
鸿蒙“一次开发,多端部署”指用一套代码适配手机、平板、手表、车机、电视等多设备。其核心是统一底座(ArkUI框架)、能力抽象(统一API)与自适应渲染(响应式布局),结合声明式UI、分布式软总线和Ability框架,实现跨设备无缝协同。开发者只需专注业务逻辑,系统自动适配不同终端,大幅降低开发与维护成本。
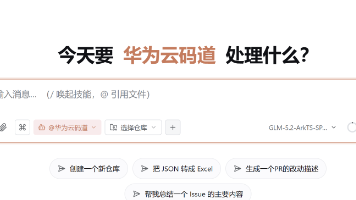
把一个鸿蒙 App 的开发全部扔给了 华为云码道 CodeArts 智能体,自己只负责"提要求、查验收",可行吗?这次我做了个测评:把一款 HarmonyOS 英语学习 App 的完整开发过程——需求、评审、编码、修复——全部交给华为云码道 CodeArts 代码智能体,自己只负责提需求、做验收。这篇文章记录整个过程,包括踩过的坑,以及与传统开发流程的真实对比。先给大家看看,要开发的App长啥样:
本文记录我参加开源鸿蒙 PC 专项积分赛、完成 aegisub 字幕编辑器核心库适配的全过程。从源码获取、meson 构建配置、依赖链处理到 gtest 全量测试,覆盖高难度库适配完整链路。适配过程中遇到 wxWidgets GUI 模块缺失、LuaJIT 平台检测失败、Boost 模块裁剪、.pc 文件 prefix 错误、iconv 边界差异 5 个真实踩坑问题,逐一给出定位思路与最终解法。
桌面上也想看见时间,进“我的”加桌面卡片:长按桌面空白处,选服务卡片,找到小羊时钟,尺寸有 1×2、2×2、2×4、4×4。卡片上的时间自己走,用 12 小时还是 24 小时、要不要显示秒,跟应用里的设置走;左右滑换模拟、数字、翻页、文字、双钟:翻页放床头挺安静,双钟同时看这边和另一座城市,另一边默认伦敦,进“更多”里的时钟设置,第二时区可以换。夜里想一直亮着,到“我的”打开屏幕常亮,全屏时钟期间
零基础在 PyCharm 用 CPU 跑通第一个 MindSpore / 昇腾模型,含虚拟环境、安装报错、MNIST 训练全流程和真实踩坑,新手照着做就能跑。
这两天在上海的华为全联接大会上,华为丢出了一个挺炸的东西——昇腾960超节点。名字听着绕口,翻译成人话就是:华为想用一套全新的连接方式,把成千上万张AI芯片拼成「一台电脑」。这事要是真成了,国产AI算力可能就要换个玩法了。百万张卡连成一台电脑,这次真的有谱了过去大家拼算力,都是拼单张芯片有多强。但大
在大语言模型的后训练阶段,如何高效利用教师模型的知识来提升学生模型性能,是一个核心挑战。传统强化学习(RL)信号稀疏,监督微调(SFT)存在分布偏移问题。On-Policy Distillation(OPD)结合两者优势:让学生从自身分布采样轨迹,同时由教师提供逐 token 的密集反馈,从而在避免分布偏移的同时大幅提升信号密度。本文从原理、变体到工程实现,系统解析 OPD 的设计思路与落地细节。
昇腾平台当前已支持slime框架本文是 slime 源码走读系列的推理架构部分的下篇。上篇介绍了 slime 的推理整体架构——服务化推理、四级层级、三条通信路径、SGLangEngine 遥控器、sgl-router 等。如果还没读过、强烈建议先读上篇,本文会反复引用其中的设定。如果不想跳回去翻,简单复述一下走读配置和架构骨架。走读配置--actor-num-gpus-per-node 4 \
昇腾平台当前已支持slime框架前不久搞了一段时间的 OpenClaw-RL,算是第一次在 slime 框架上完成了一次实战。此前只停留于源码走读,并不深入,趁着这个机会,刚好整理一下对 slime 框架推理部分的源码走读。本文走读所参照的启动配置来自--actor-num-gpus-per-node 4 \ # 训练占 4 GPU--rollout-num-gpus 4 \ # 推理占 4 GP