
从级联架构到生成式推荐:推荐算法演进与昇腾落地
作者:昇腾实战派
知识地图:https://blog.csdn.net/Lumos_Lovegood/article/details/161601003
简介
本文按"算法演进 → 工程落地"的主线,系统梳理生成式推荐(Generative Recommendation, GR)这一方向的发展脉络。第一部分回顾传统级联推荐架构的系统性瓶颈;第二部分以 Meta GR(HSTU)和快手 OneRec 为代表,剖析两条主流的生成式推荐技术路线;第三部分聚焦工程落地,介绍 TorchRec 生态以及基于昇腾 NPU 打造的 RecSDK 框架,展示从算法到生产部署的基本链路。
第一部分:算法演进——为什么需要生成式推荐
1.1 传统级联架构的三大系统性瓶颈
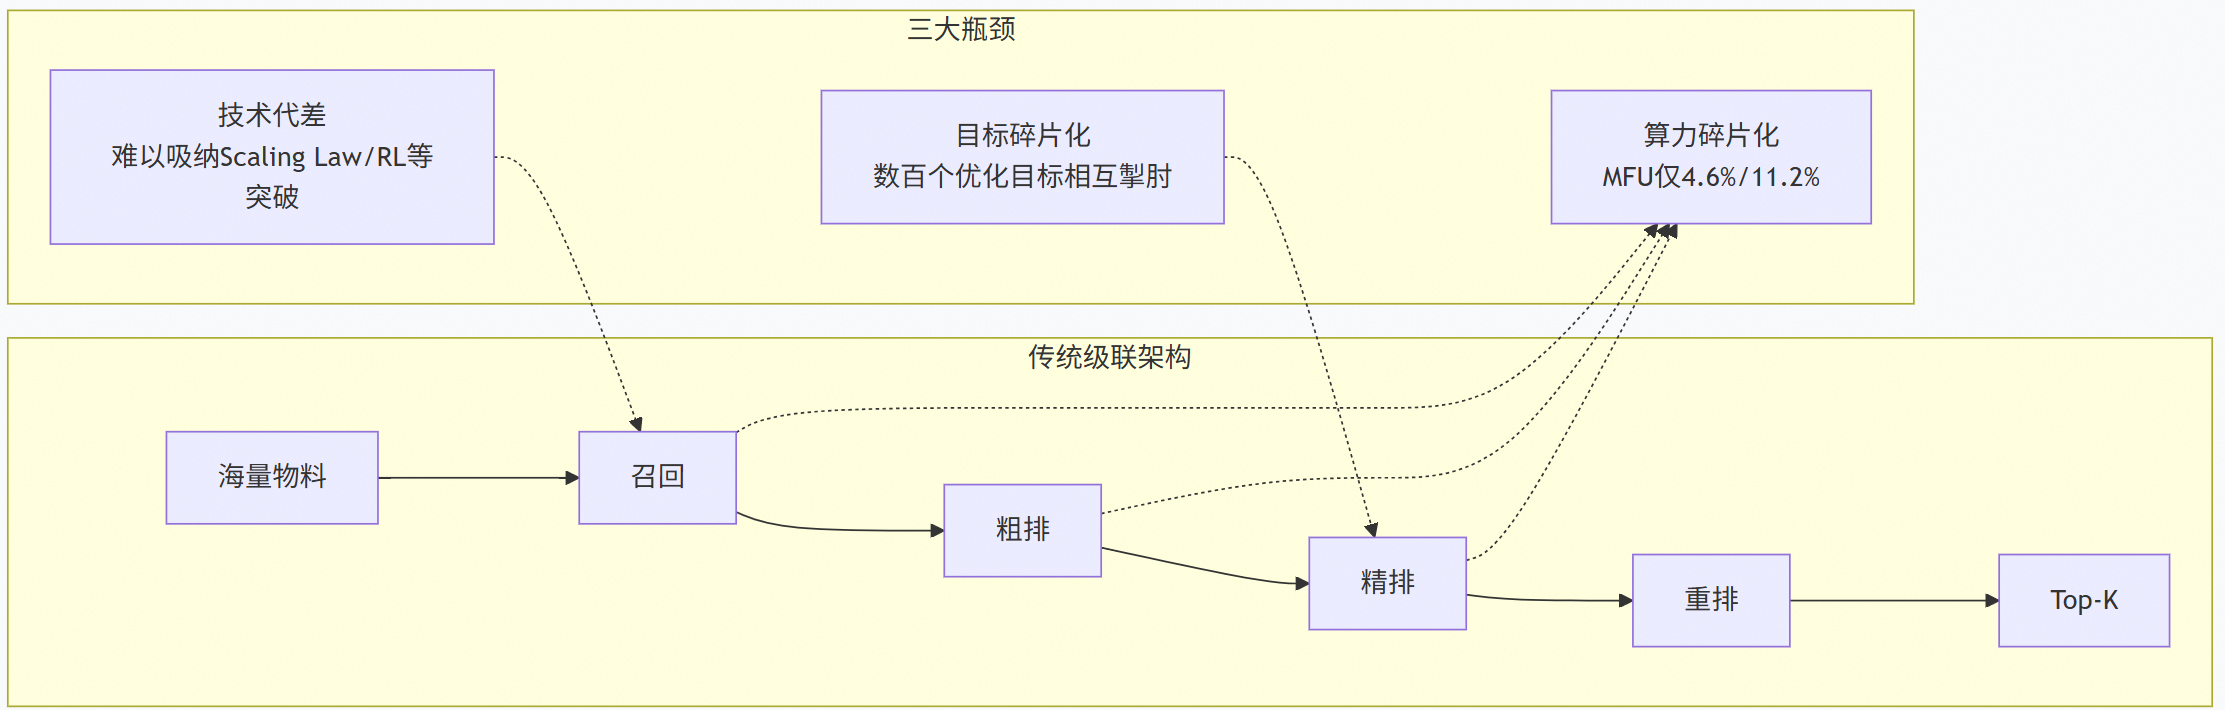
- 瓶颈一:算力碎片化:快手相关论文指出,在快手传统推荐算法中即使是计算复杂度最高的精排模型SIM,在旗舰GPU上的MFU仅为4.6%(训练)和11.2%(推理),远低于大语言模型40%-50%的水平。超过50%的算力被通信和存储开销消耗,而非核心计算。
- 瓶颈二:目标碎片化冲突:级联架构(召回 → 粗排 → 精排 → 重排)各阶段目标不一致,存在信息损失与误差累积。此外,平台可能需要同时优化用户、创作者和生态系统的数百个目标,这些目标在不同阶段相互掣肘,导致系统整体的一致性和效率持续恶化。
- 瓶颈三:技术代差逐渐拉大:现有架构中,模型容量受限于单点目标优化,难以吸纳Scaling Law、强化学习等AI领域的最新突破,且无法充分利用最新计算硬件的潜能
1.2 生成式推荐的两条技术路线
业界目前有两种典型范式:
- Meta 路线(HSTU):将推荐建模为"用户行为序列上的下一个 token 预测"问题,用 Transformer-like 架构统一召回与排序,通过工程优化让超长序列建模在生产可承受的成本内完成。
- 快手 OneRec 路线:通过"语义分词器 + 编码器-解码器"将整个推荐链路重构为生成式任务,结合 RLHF 风格的偏好对齐,实现端到端的会话级推荐。
下面分别展开。
第二部分:算法详解
2.1 Meta GR:用 HSTU 重塑召排
2.1.1 传统推荐系统问题
大规模传统推荐系统存在的主要问题:
- 特征缺乏显式结构(特征乱):海量异构特征,包括高基数ids、统计特征等,缺乏显性的表达;
- 庞大的动态词汇表(词表变):大规模推荐系统词汇表基数为数十亿级别,远高于语言模型数十万级别规模;持续新增,词汇表无固定边界;训练和推理成本巨大;
- 计算成本成为主要瓶颈(算不动):长序列大规模训练,推荐系统需要处理的tokens数量比语言模型在1-2个月内处理的数量还要大好几个数量级。
2.1.2 解决方案:从特征统一到统一架构
针对上述问题,Meta GR将用户行为定义为和文本、图像等同地位的新模态,便于不同模态信息充分交叉以及后续异构特征统一适配;同时,Meta GR重塑推荐系统中的召回和排序问题为生成式任务;在这种新的范式下,Meta GR设计了新的Encoder架构HSTU,并通过稀疏优化、算子融合等工程优化实现性能加速。
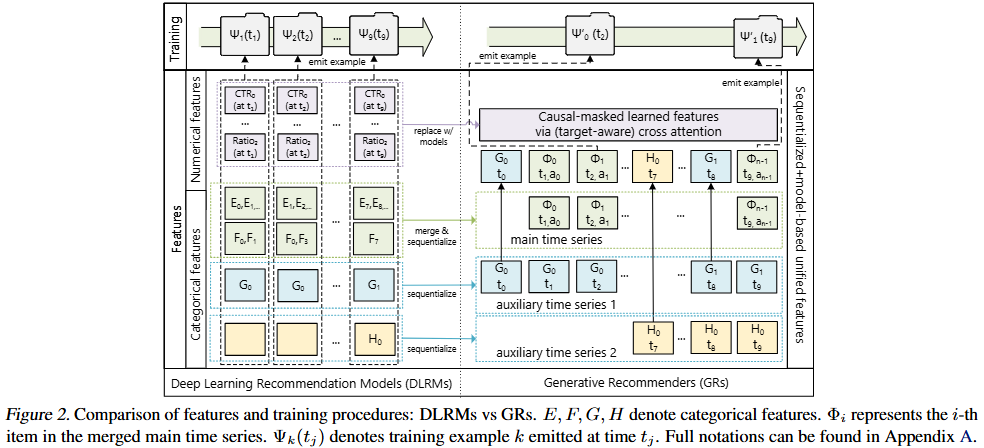
异构特征统一适配
推荐模型使用大量的类别特征和数值特征进行训练,Meta GR用一条行为时序序列统一异构特征。
- 类别(稀疏)特征:通常是离散的特征,如用户喜欢的item、语言、城市等。对于这类特征,Meta GR选择最长的时间序列作为主序列,包括交互itemID、交互行为、时间戳等;辅助序列包括关注的用户等,这类特征随时间变化缓慢,因此只保留每个连续片段的最早几项并合并至主序列,从而控制序列长度。
- 数值(稠密)特征:通常是连续特征,如点击率(CTR,click through rate)特征。这类特征变化频率高,Meta GR大胆舍弃了这类特征的手动建模,通过端到端时序建模捕捉长序列中的用户偏好,从而节省计算与存储开销。
统一后的序列结构消除了异构特征差异,无需离散/连续分别处理,无需人工特征交叉,所有特征在同一空间被注意力联合建模。
重塑召排问题
基于统一的特征空间,Meta GR将推荐系统中的召回和排序问题重新建模为序列直推任务(sequential transduction tasks)。关于归纳式学习和直推式学习,参考:如何理解 inductive learning 与 transductive learning?
如下图所示,给定用户历史交互内容
Φ
i
Φ_i
Φi和对应的用户行为(如点赞收藏等)
a
i
a_i
ai,以及行为所对应的时间点
t
i
t_i
ti,序列直推任务在给定掩码
m
i
∈
{
0
,
1
}
m_i∈\{0,1\}
mi∈{0,1}的条件下,输出预测token
y
i
y_i
yi。
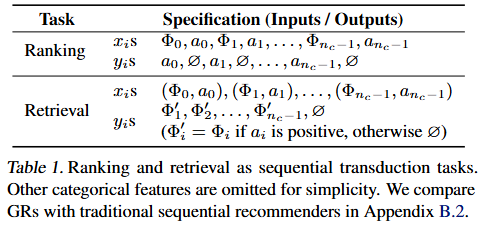
1. 召回任务
对于召回任务,生成式训练学习概率分布
p
(
Φ
i
+
1
∣
u
i
)
p(Φ_{i+1}\mid u_i)
p(Φi+1∣ui),其中
u
i
u_i
ui是在时间步i的用户表征,学习目标为
arg
max
Φ
∈
X
c
p
(
Φ
∣
u
i
)
\arg\max_{Φ\in X_c}p(Φ\mid u_i)
argmaxΦ∈Xcp(Φ∣ui)。
和标准的自回归方式存在两个差异:
- 下一个token可能是负样本(如曝光未点击);
- 下一个token是用户属性等元特征,并不是交互的物料;
对于上述情况,Meta GR设置 m i = 0 m_i=0 mi=0进行标识,不参与自回归loss的计算。
2. 排序任务
对于排序任务,Meta GR在输入序列上交错插入item和action,实现target和历史行为在底层进行交叉(target-aware),得到序列$\Phi_{0}, a_{0}, \Phi_{1}, a_{1}, … 。其中, a c t i o n 对应的 。其中,action对应的 。其中,action对应的m_{i}=0$,计算每个item打分的loss。
在排序任务中,将候选item插入到历史行为序列末尾进行交叉和预测,通过encoder编码后的特征接入到多个任务塔进行多目标训练。同时,这种方式还能实现所有item同时计算,节省了大量算力。
需要注意的是,所有候选item之间没有时序性,历史item对于当前item应当是不可见的,因此需要设置对应的掩码为0,防止候选item之间产生交互。
HSTU:Hierarchical Sequential Transduction Unit
为了处理海量非稳态词表,在工业级推荐系统中扩展GR,Meta GR设计了一种高性能的自注意力encoder架构:层次序列转换单元(HSTU,Hierarchical Sequential Transduction Unit)。
传统的注意力机制在处理推荐系统的数据时面临以下问题:
- **高基数词表:**推荐系统的词表规模达数十亿级别,远超语言模型的词表;
- **非平稳数据:**物料数据动态增加,数据分布持续变化;
- **兴趣强度:**用户与某个item的交互频率反映了用户的偏好,是一种强特征,而标准 Softmax 容易将其“抹平”。
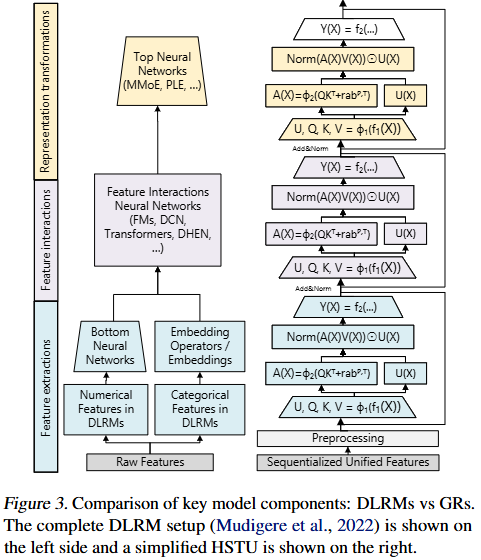
如上图所示,HSTU通过多个层堆叠,层与层之间通过残差连接,每个层可以拆解为如下三个步骤。
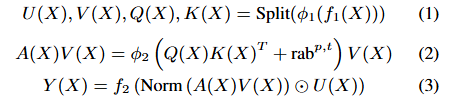
- Pointwise Projection:对应于公式(1), f ( ⋅ ) f(·) f(⋅)和 ϕ ( ⋅ ) \phi(·) ϕ(⋅)分别表示MLP和SiLU激活函数。与标准注意力机制不同,HSTU除了映射得到Q、K、V以外,还生成了一个门控权重 U ( X ) U(X) U(X)。
- Spatial Aggregation:对应于公式(2), r a b p , t rab^{p,t} rabp,t为偏置项,用于结合位置 p p p和时间 t t t的信息。与标准注意力机制不同,HSTU放弃了softmax归一化,采用pointwise aggregated attention机制。
这里可以这么理解:
1)softmax本质是“归一化分布”,会削弱某个item交互频率所代表的偏好强度信息,不适合推荐场景偏好强度建模,HSTU进行逐点聚合以更好地捕捉用户偏好强度。
2)softmax具有抗噪声鲁棒性,不适合处理推荐场景下流式数据的非平稳动态词表。
- Pointwise Transformation:对应于公式(3)。亮点在于使用门控权重 U ( X ) U(X) U(X)与聚合结果进行逐元素相乘,类似于MoE中的门控机制。
2.1.3 工程优化
1. 稀疏优化
- GPU底层推理加速:输入的多数用户历史序列较短,少数长序列导致输入稀疏,Meta GR利用稀疏性提高encoder效率。具体地,开发了一种高效GPU注意力kernel,将注意力计算拆分为不同大小的分组GEMM操作。该方法实现2~5倍吞吐量提升,注意力计算以内存为bound,按 Θ ( Σ i n i 2 d q k 2 R − 1 ) \Theta\left(\Sigma_{i}n^{2}_{i}d^{2}_{qk}R^{-1}\right) Θ(Σini2dqk2R−1)进行scaling,其中 n i 、 d q k 、 R n_{i}、d_{qk}、R ni、dqk、R分别是序列长度、注意力维度及寄存器大小。
- 算法层优化:用户历史序列具有时间重复性,适当减少序列长度可以显著降低计算成本且不会明显降低模型质量。Meta GR在训练阶段截取随机序列长度(SL,Stochastic Length),引入稀疏性,降低计算成本。方法如下图所示,其中
n
c
,
j
n_{c,j}
nc,j为该序列样本长度,
N
c
=
m
a
x
j
n
c
,
j
N_{c}=max_{j}n_{c,j}
Nc=maxjnc,j。
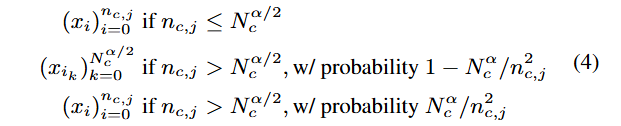
2. 生成式训练(流式训练)
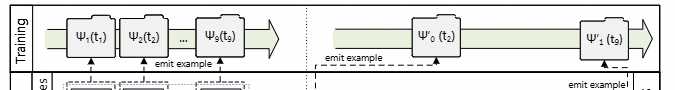
- 如上图所示,传统的DLRMs采用曝光级训练(impression-level training),每个行为都会产生一个训练样本,每个样本都包含历史序列和当前目标item。不同样本会重复执行与行为序列的交叉计算。
这种情况下,传统Transformers的计算复杂度为
∑ i n i ( n i 2 d + n i d f f d ) → O ( d f f ) = O ( d ) N = m a x i n i O ( N 3 d + N 2 d 2 ) {\textstyle \sum_{i}^{}}n_{i}(n^{2}_{i}d + n_{i}d_{ff}d) \xrightarrow[O(d_{ff})=O(d)]{N=max_{i}n_{i}}O(N^{3}d+N^{2}d^{2}) ∑ini(ni2d+nidffd)N=maxiniO(dff)=O(d)O(N3d+N2d2)
其中, n i n_{i} ni为用户 i i i的输入序列长度,括号内的两项分别来自self-attention和MLP层。
- 在生成式训练中,整个用户序列被视为一个训练样本,模型只需要进行一次前向计算,并行计算所有预测结果,从而分摊了原来encoder多次训练的计算开销。
这种情况下,以采样率 s u ( n i ) s_{u}(n_{i}) su(ni)进行采样可降低计算复杂度为
∑ i s u ( n i ) n i ( n i 2 d + n i d 2 ) → s u ( n i ) = 1 / n i O ( N 2 d + N d 2 ) {\textstyle \sum_{i}^{}}s_{u}(n_{i})n_{i}(n^{2}_{i}d + n_{i}d^{2}) \xrightarrow[]{s_{u}(n_{i})=1/n_{i}}O(N^{2}d+Nd^{2}) ∑isu(ni)ni(ni2d+nid2)su(ni)=1/niO(N2d+Nd2)
通过在流式训练上应用生成式训练范式,训练的计算复杂度大幅降低。
3. 内存优化
- HSTU简化设计
a. 将注意力之外的线性层数量减少至两个,减少了不必要的线性层;
b. 对Dropout、MLP等进行算子融合;
c. 避免中间显式保存各个子层的激活值
传统 Transformer 每层中间激活内存占用 33d,HSTU 每层激活内存为 14 d = ( 2 d + 2 d + 4 h d q k + 4 h d v + 2 h d v ) 14d=(2d + 2d + 4hd_{qk} + 4hd_{v} + 2hd_{v}) 14d=(2d+2d+4hdqk+4hdv+2hdv)。
每层激活内存占用约为Transformer的一半以下,支持网络层数扩展为2倍以上。
- 优化器
a. Meta GR将优化器状态在行级别共享(rowwise);
b. 将优化器状态移至DRAM;
c. 将每个浮点数的HBM占用从12字节降低至2字节
2.2 OneRec:端到端生成式推荐
2.2.1 协同感知多模态语义分词器
OneRec-V1在Tokenization环节实现了关键创新。传统的语义ID生成仅基于内容特征,而OneRec引入了协同感知的多模态分词方案。
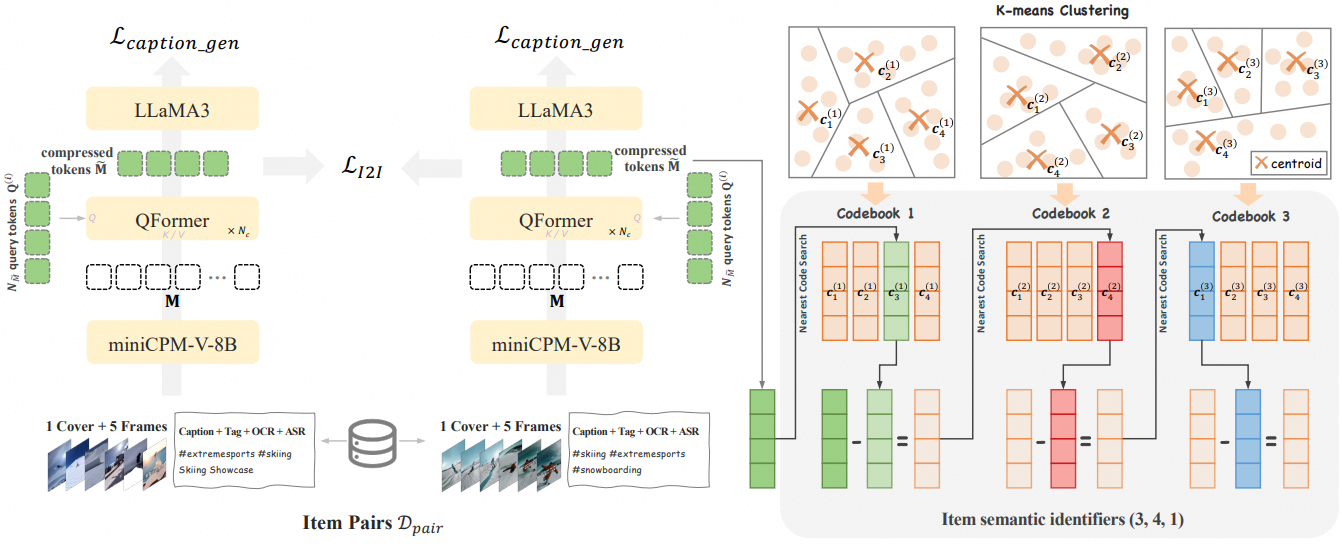
先将具有高协作相似性的物品对的多模态表示对齐,以获得协作多模态表示,然后使用 RQ-Kmeans 将这些表示分词为离散语义 ID。
RQ-Kmeans具体公式:
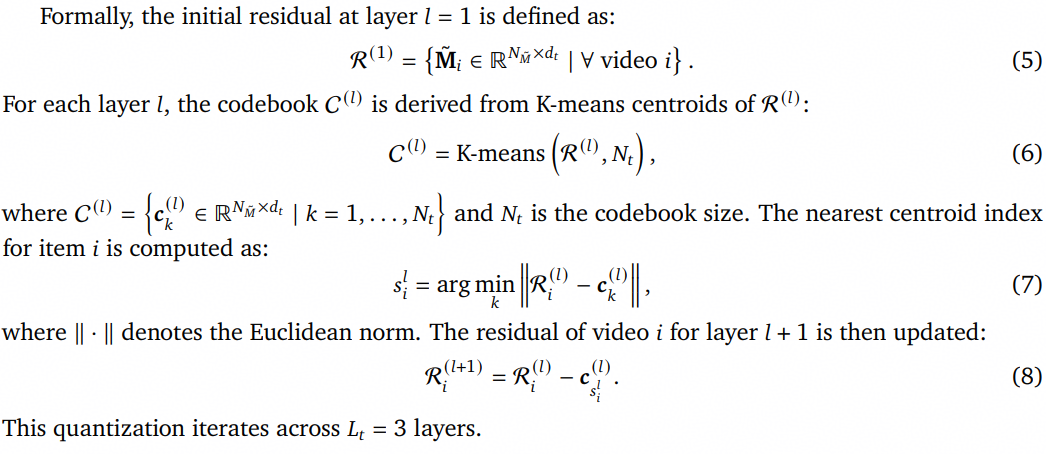
2.2.2 多尺度用户编码器
编码器整合四种用户行为路径:
| 路径 | 输入规模 | 处理方式 | 目标 |
|---|---|---|---|
| 静态特征 | 固定 | Embedding层 | 年龄、性别、地区等画像 |
| 短期行为 | 最近20条 | 直接Attention | 捕捉即时兴趣 |
| 正反馈 | 256条 | 强化Attention权重 | 点赞、转发等高参与度内容 |
| 终身历史 | 10万+ | KMeans聚类压缩 + QFormer提炼 | 长期兴趣建模 |
终身历史路径的压缩策略尤为关键:先用分层KMeans将相似视频聚类,每簇选代表,压缩至约2000条"精华";再用带128条可学查询向量的QFormer进一步浓缩
2.2.3 MoE 增强的解码器与会话级生成
解码器采用逐点生成策略,自回归地预测下一个视频的语义ID序列。核心创新包括:
MoE(Mixture of Experts)架构:每个解码层的FFN被替换为多个专家网络,通过路由机制每次仅激活Top-K个专家:
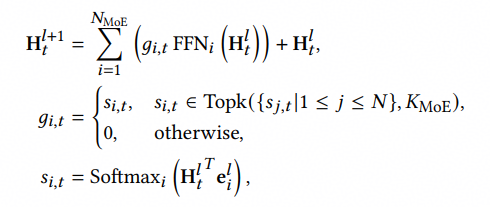
其中门控值g(i,t)仅Top-K被激活。
会话级列表生成:不同于传统逐个物品预测,OneRec生成一个包含5-10个视频的会话列表。
训练时,每个视频前添加s[BOS]标记,解码器预测下一个token:
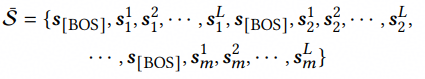
训练目标为下一个token预测交叉熵损失:
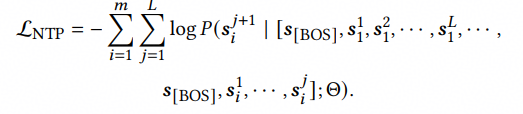
2.2.4 基于真实用户反馈的偏好对齐
OneRec-V2摒弃了代理奖励模型,转向直接利用真实用户反馈进行偏好对齐。
时长感知奖励塑形
原始观看时长受视频长度影响较大(长视频天然获得更长时长)。论文提出校正公式:
r w a t c h = f ( r r a w , d u r a t i o n ) r^{watch}=f(r^{raw},duration) rwatch=f(rraw,duration)
其中 f f f为时长校正函数,使奖励信号更准确反映内容质量而非时长优势。
自适应比率裁剪
在策略优化过程中引入自适应比率裁剪机制,有效降低训练方差,同时保持收敛性保证:
c l i p ( ρ t ( θ ) , 1 − ϵ , 1 + ϵ ) ⋅ A t clip(ρ_t(θ),1−ϵ,1+ϵ)⋅A_t clip(ρt(θ),1−ϵ,1+ϵ)⋅At
对于负优势样本( A < 0 A<0 A<0)进行更严格的梯度截断,防止梯度爆炸。
奖励系统设计
OneRec构建了完整的奖励系统:
| 奖励类型 | 目标 | 实现方式 |
|---|---|---|
| 偏好奖励(P-Score) | 对齐用户偏好 | 多塔MLP融合点击、点赞、时长等信号 |
| 格式奖励 | 确保生成合法序列 | 对能映射到真实视频的序列给予奖励 |
| 工业场景奖励 | 满足业务约束 | 如抑制低质内容、扶持新作者 |
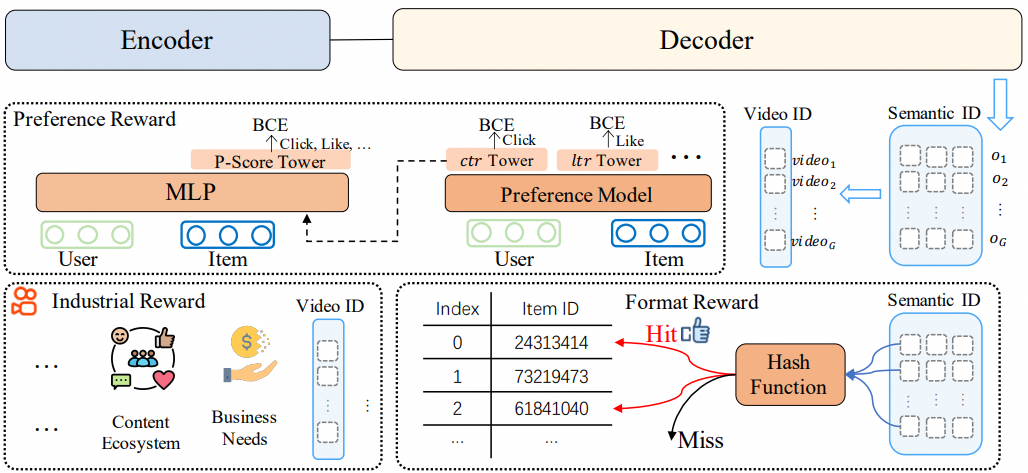
奖励系统由三部分组成。它们分别为模型生成的视频分配偏好奖励(P-Score)、格式奖励和特定行业奖励
2.3 两条路线的对比与共性
| 维度 | Meta GR (HSTU) | 快手 OneRec |
|---|---|---|
| 核心范式 | 行为序列上的下一个 item 预测 | Encoder-Decoder 生成 item 序列 |
| Item 表示 | Embedding ID | 多模态语义离散 ID(codebook) |
| 架构核心 | HSTU(改良 Transformer) | MoE Decoder + 多尺度 Encoder |
| 训练目标 | 序列预测 + 工业指标 | 生成 + 偏好对齐(RLHF 风格) |
| 替换的环节 | 召回 + 排序 | 全链路(召回 → 重排) |
两条路线共性明显:用单一大模型替换多阶段级联,让推荐系统真正享受 Scaling Law 的红利。差异在于 Meta 路线更接近"把推荐看成 LM",OneRec 更接近"把推荐看成 Seq2Seq + RLHF"。
无论哪条路线,落地到生产环境都面临同一个工程难题——Embedding 表动辄数 TB、ID 空间无界、需要在大规模分布式异构硬件上训练与服务。这就引出本文第三部分:工程落地。
第三部分:工程落地——从 TorchRec 到昇腾 NPU 上的 RecSDK
3.1 TorchRec 生态:业界主流的推荐训练框架
本节系统介绍 TorchRec 的核心组件。
3.1.1 背景
- TorchRec定位:TorchRec是一个基于 PyTorch 的领域专用库,旨在为大规模推荐系统(RecSys)提供常用的稀疏性与并行计算原语。TorchRec 支持在多个 GPU 上分片存储的大型嵌入表的模型训练与推理,目前已广泛应用于 Meta 的多个生产级推荐系统模型中。
- 参考文档:Welcome to the TorchRec documentation! — TorchRec 1.0.0 documentation
以一个电商点击率预测的极简例子:
用户特征: 用户ID、用户商品序列
商品特征: 商品ID
** 原生 torch.nn.Embedding 版本**
import torch
import torch.nn as nn

class SimpleCTR(nn.Module):
    def __init__(self, num_users=100000, num_items=500000, embedding_dim=64):
        super().__init__()
        self.user_emb = nn.Embedding(num_users, embedding_dim)
        self.item_emb = nn.Embedding(num_items, embedding_dim)

        self.mlp = nn.Sequential(
            nn.Linear(embedding_dim * 3, 128),
            nn.ReLU(),
            nn.Linear(128, 1),
            nn.Sigmoid()
        )

    def forward(self, user_ids, candidate_ids, history_ids):
        user_emb = self.user_emb(user_ids)
        candidate_emb = self.item_emb(candidate_ids)
        history_emb = self.item_emb(history_ids).mean(dim=1)  # 历史序列pooling

        combined = torch.cat([user_emb, candidate_emb, history_emb], dim=-1)
        return self.mlp(combined)

# 训练
model = SimpleCTR().to("cuda:0")
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

for epoch in range(5):
    for _ in range(50):
        user_ids = torch.randint(0, 100000, (32,)).to("cuda:0")
        candidate_ids = torch.randint(0, 500000, (32,)).to("cuda:0")
        history_ids = torch.randint(-1, 500000, (32, 10)).to("cuda:0")
        labels = torch.randint(0, 2, (32,)).float().to("cuda:0")

        optimizer.zero_grad()
        predictions = model(user_ids, candidate_ids, history_ids).squeeze()
        loss = nn.BCELoss()(predictions, labels)
        loss.backward()
        optimizer.step()

# 推理
model.eval()
with torch.no_grad():
    user_ids = torch.tensor([1, 2, 3]).to("cuda:0")
    candidate_ids = torch.tensor([101, 102, 103]).to("cuda:0")
    history_ids = torch.randint(0, 500000, (3, 10)).to("cuda:0")
    predictions = model(user_ids, candidate_ids, history_ids)
TorchRec 分布式版本
import torch
import torchrec
from torchrec import EmbeddingBagConfig, EmbeddingBagCollection
from torchrec.sparse.jagged_tensor import KeyedJaggedTensor

class SimpleCTR_TorchRec(nn.Module):
    def __init__(self, num_users=100000, num_items=500000, embedding_dim=64):
        super().__init__()
        self.ebc = EmbeddingBagCollection(
            device="meta",
            tables=[
                EmbeddingBagConfig(
                    name="user_table",
                    embedding_dim=embedding_dim,
                    num_embeddings=num_users,
                    feature_names=["user"],
                    pooling=torchrec.PoolingType.SUM,
                ),
                EmbeddingBagConfig(
                    name="item_table",  # 候选和历史共用同一个表
                    embedding_dim=embedding_dim,
                    num_embeddings=num_items,
                    feature_names=["candidate", "history"],  # 两个特征共用
                    pooling=torchrec.PoolingType.SUM,
                )
            ]
        )

        self.mlp = nn.Sequential(
            nn.Linear(embedding_dim * 3, 128),
            nn.ReLU(),
            nn.Linear(128, 1),
            nn.Sigmoid()
        )

    def forward(self, features):
        embeddings = self.ebc(features)
        return self.mlp(embeddings.values())

# 分布式训练
model = SimpleCTR_TorchRec()
distributed_model = torchrec.distributed.DistributedModelParallel(
    model.ebc, device=torch.device("cuda")
)
optimizer = torch.optim.SGD(model.mlp.parameters(), lr=0.01)

for epoch in range(5):
    for _ in range(50):
        batch_size = 32
        max_history_len = 10

        user_ids = torch.randint(0, 100000, (batch_size,))
        candidate_ids = torch.randint(0, 500000, (batch_size,))
        history_lengths = torch.randint(1, max_history_len, (batch_size,))
        total_history_items = history_lengths.sum().item()
        history_ids = torch.randint(0, 500000, (total_history_items,))

        # 构建KeyedJaggedTensor
        all_lengths = torch.cat([
            torch.ones(batch_size),      # user: 每个样本1个
           torch.ones(batch_size),      # candidate: 每个样本1个
          history_lengths              # history: 变长
        ])

        all_values = torch.cat([
         user_ids,
         candidate_ids,
         history_ids
        ])

        features = KeyedJaggedTensor.from_lengths_sync(
         keys=["user", "candidate", "history"],
         lengths=all_lengths,
         values=all_values
        ).to("cuda")

        labels = torch.randint(0, 2, (batch_size,)).float().to("cuda")

        optimizer.zero_grad()
        predictions = distributed_model(features).wait().squeeze()
        loss = nn.BCELoss()(predictions, labels)
        loss.backward()
        optimizer.step()

# 推理
distributed_model.eval()
with torch.no_grad():
    features = KeyedJaggedTensor.from_lengths_sync(
        keys=["user", "candidate", "history"],
        lengths=torch.tensor([1, 1, 3]),
        values=torch.tensor([1, 101, 201, 202, 203])
    ).to("cuda")
    predictions = distributed_model(features).wait()
主要问题:embedding很大。
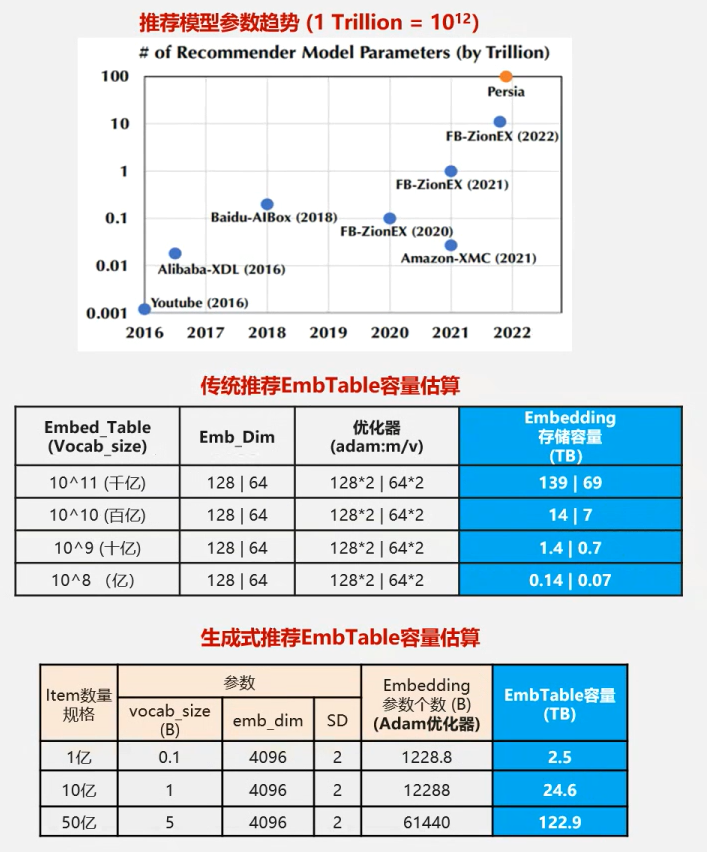
- 稀疏特征:torch.tensor vs KeyedJaggedTensor
- torch.tensor:标准张量,假设所有序列长度相同,需要padding,内存效率低
- KeyedJaggedTensor:TorchRec专用稀疏数据结构,支持变长序列,无需padding,通过lengths/offsets和values高效存储
- Embedding:torch.nn.Embedding vs EmbeddingBagCollection
- torch.nn.Embedding:PyTorch原生嵌入层,单设备限制,无法处理超大规模嵌入表
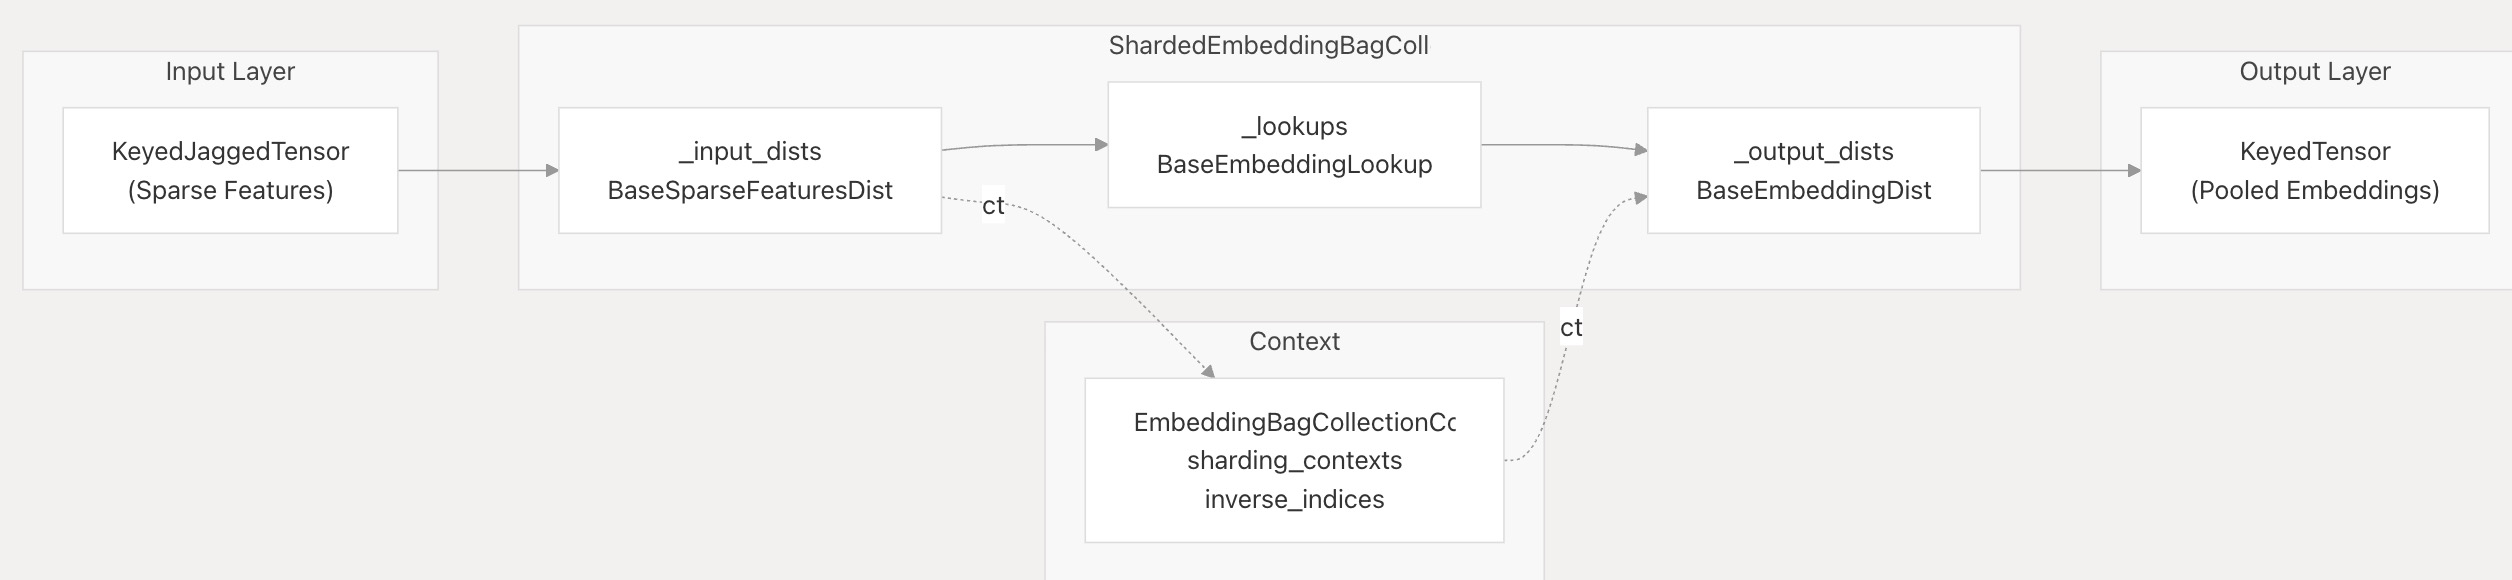
- EmbeddingBagCollection:TorchRec统一嵌入模块,支持多特征共享嵌入表,可分布式分片到TB级
- DistributedModelParallel:TorchRec的核心分布式训练入口,自动收集sharders、生成最优分片计划、实际分片模型并分配内存
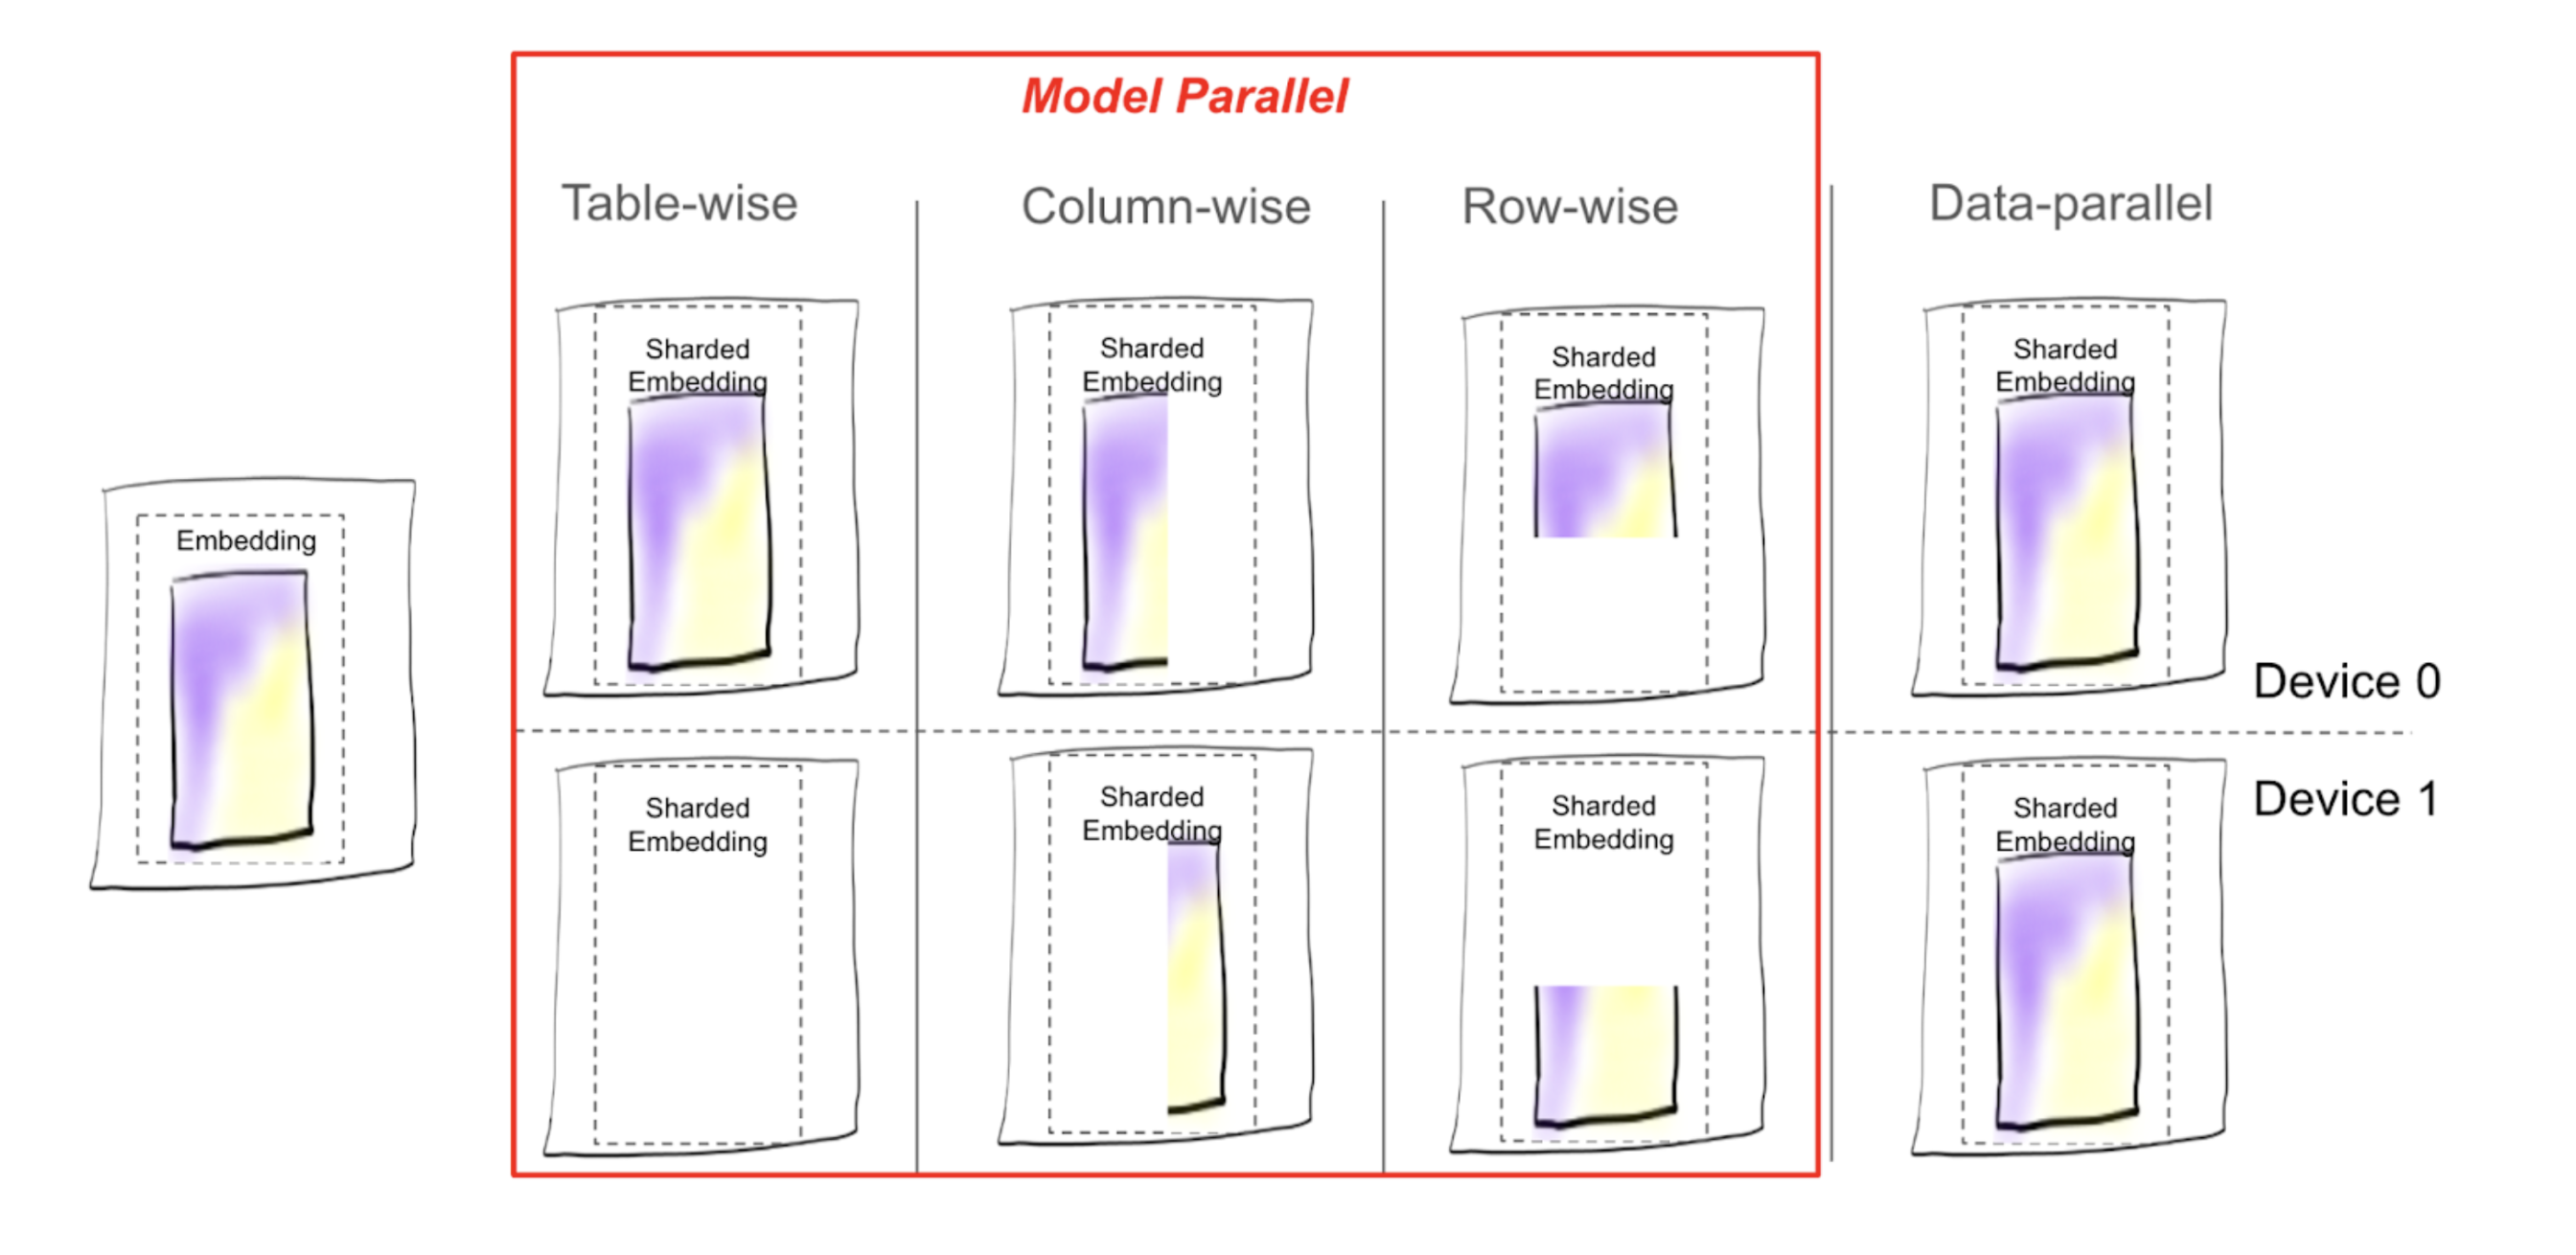
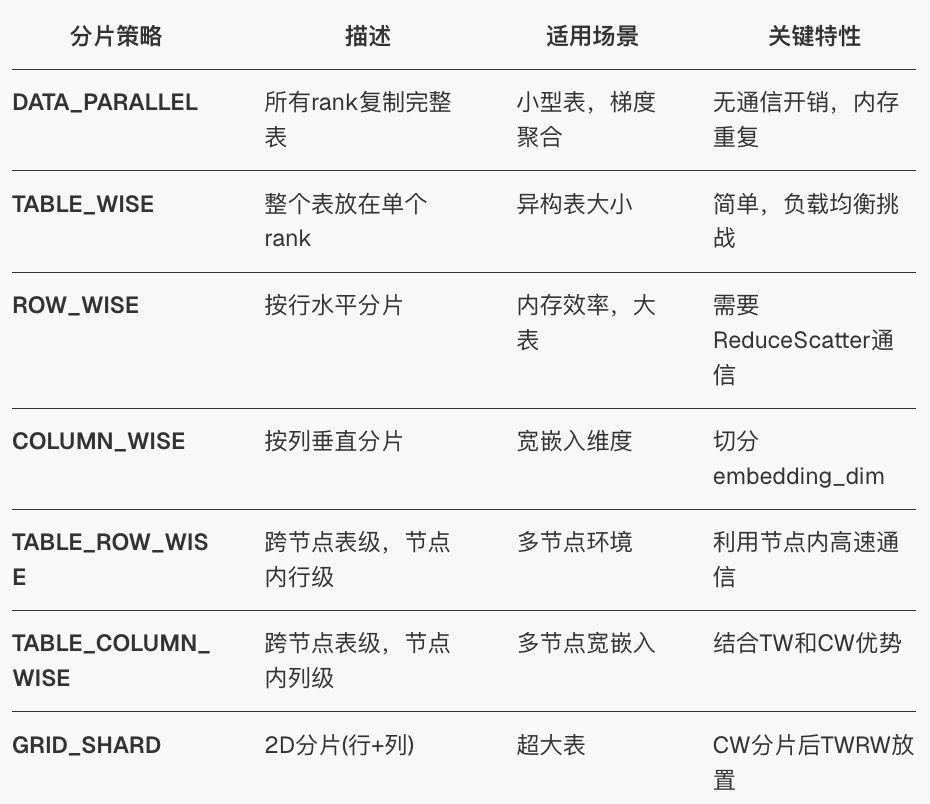
- ShardingStrategies: 支持7种分片策略:table-wise、row-wise、column-wise、table-wise-row-wise、grid-shard、data-parallel
- AutomaticShardingPlanner:自动评估内存约束、计算需求、硬件带宽等因素,生成最优分片计划
- TrainingPipeline:流水线训练,重叠数据加载、设备传输、通信和计算,提升30-50%吞吐量
- FBGEMM:Facebook开发的优化内核库,为TorchRec提供高性能嵌入查找、量化推理等底层优化
总的来说,KeyedJaggedTensor作为输入格式,EmbeddingBagCollection处理嵌入,DistributedModelParallel协调分布式训练,Planner优化分片,Pipeline提升性能,FBGEMM提供底层加速。

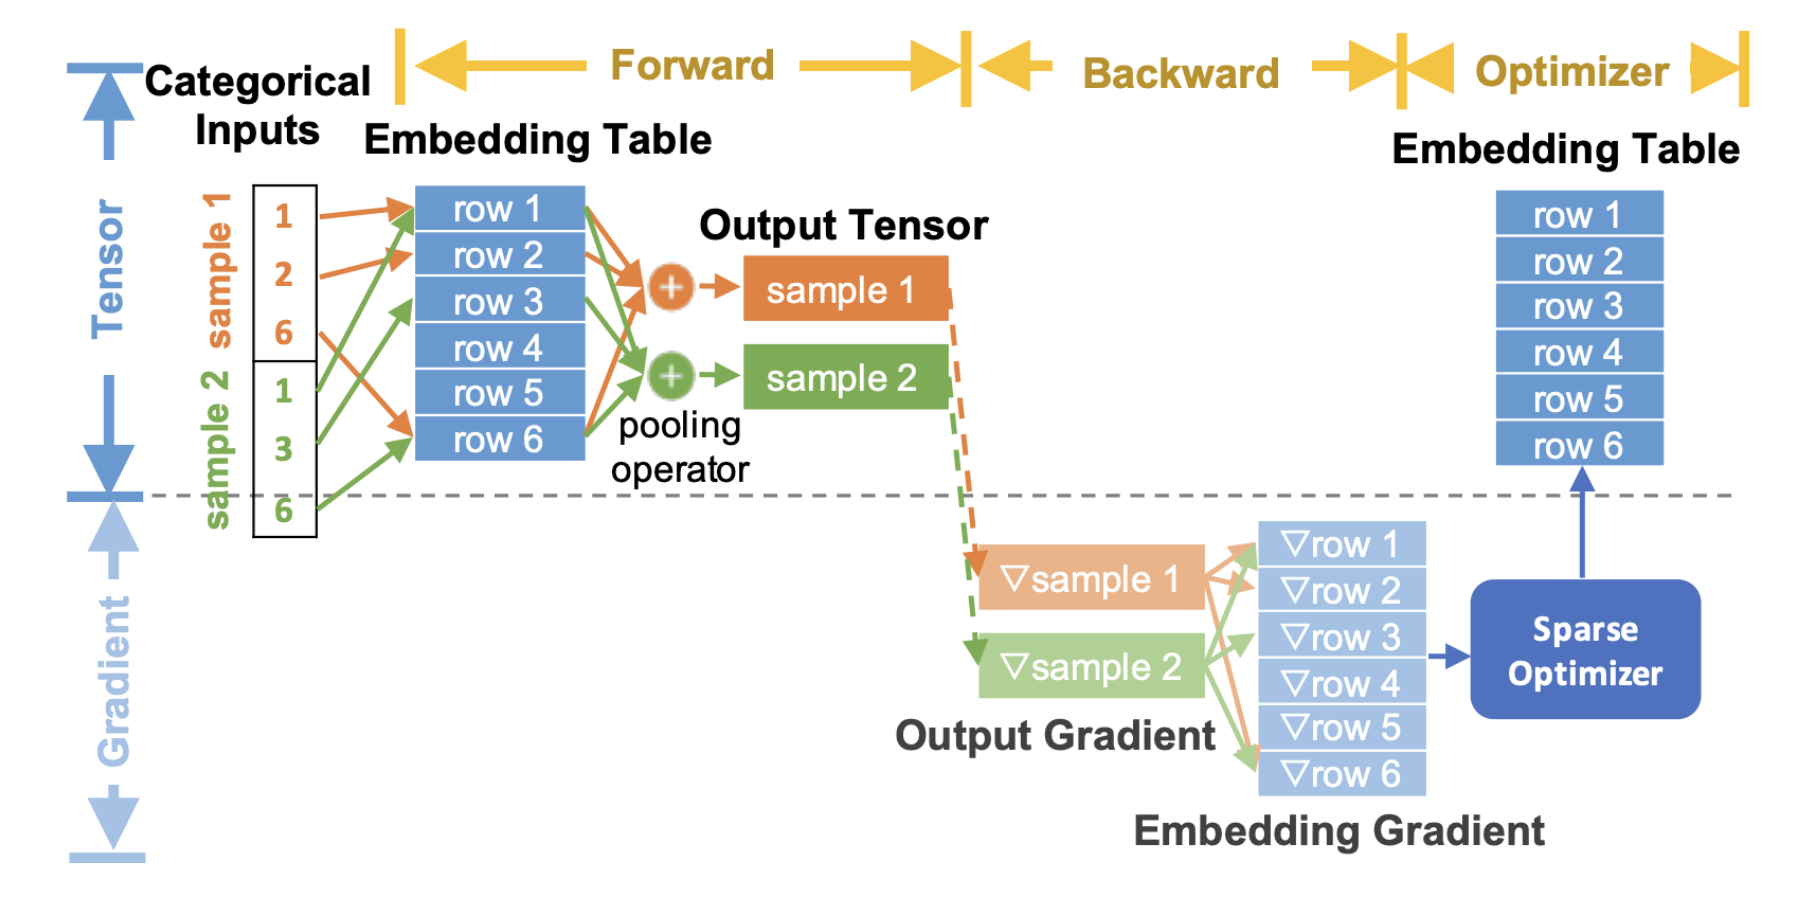
3.1.2 KeyedJaggedTensor(KJT)
KeyedJaggedTensor是 TorchRec 中用于高效表示稀疏特征的核心数据结构,专门处理变长序列数据,无需填充。
- keys:特征名称列表,如 [“user”, “item”]
- values: 1D张量,包含所有特征的值
- lengths: 每个序列的长度
- offsets: 每个序列在values中的起始位置(可选)
from torchrec.sparse.jagged_tensor import KeyedJaggedTensor # 创建包含用户和商品特征的KeyedJaggedTensor
kjt = KeyedJaggedTensor.from_lengths_sync(
    keys=["user", "item"], lengths=torch.tensor([2, 3, 1, 2]), # 用户1:2个, 用户2:3个, 商品1:1个, 商品2:2个
    values=torch.tensor([101, 102, 201, 202, 203, 1001, 1002, 1003]) )
print(kjt) # 输出:
    # KeyedJaggedTensor({ # "user": [[101, 102], [201, 202, 203]],
         # "item": [[1001], [1002, 1003]] # })
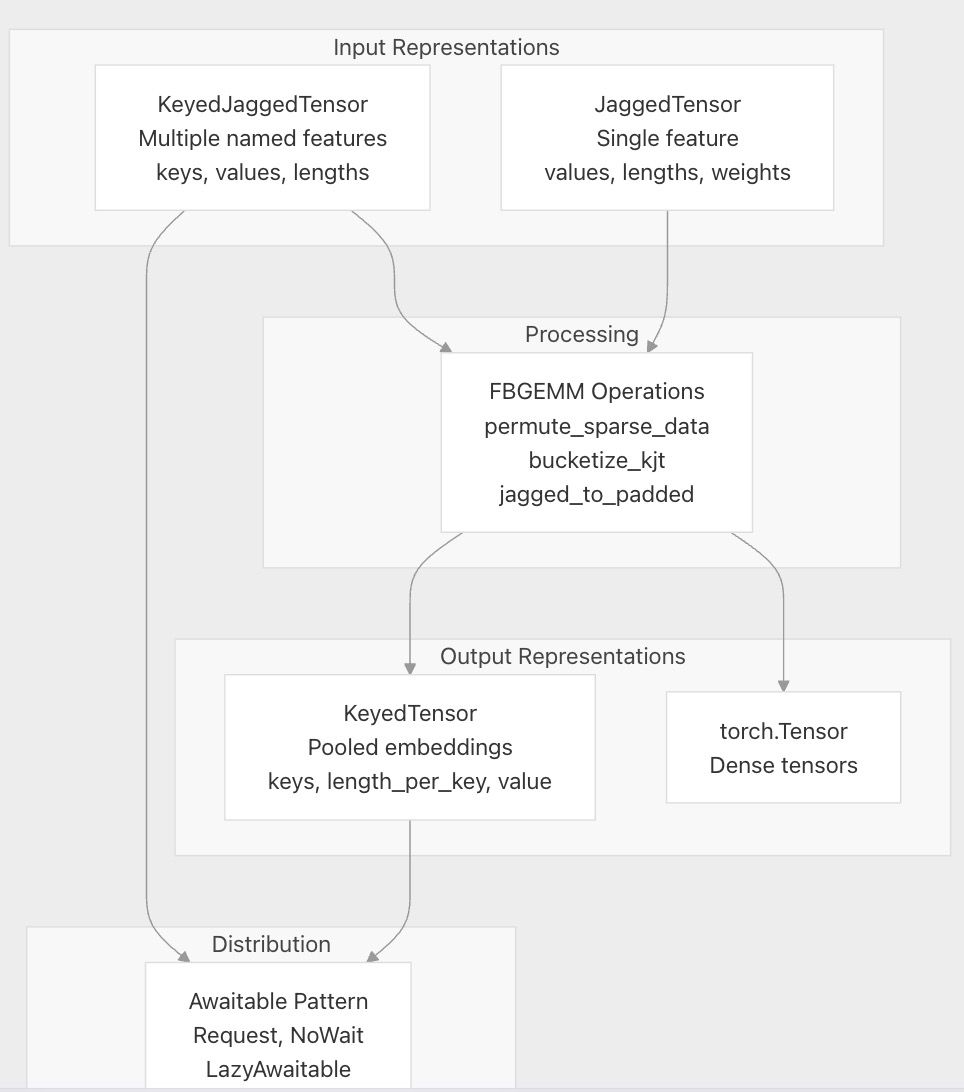
3.1.3 Embedding 模块
- 模型并行
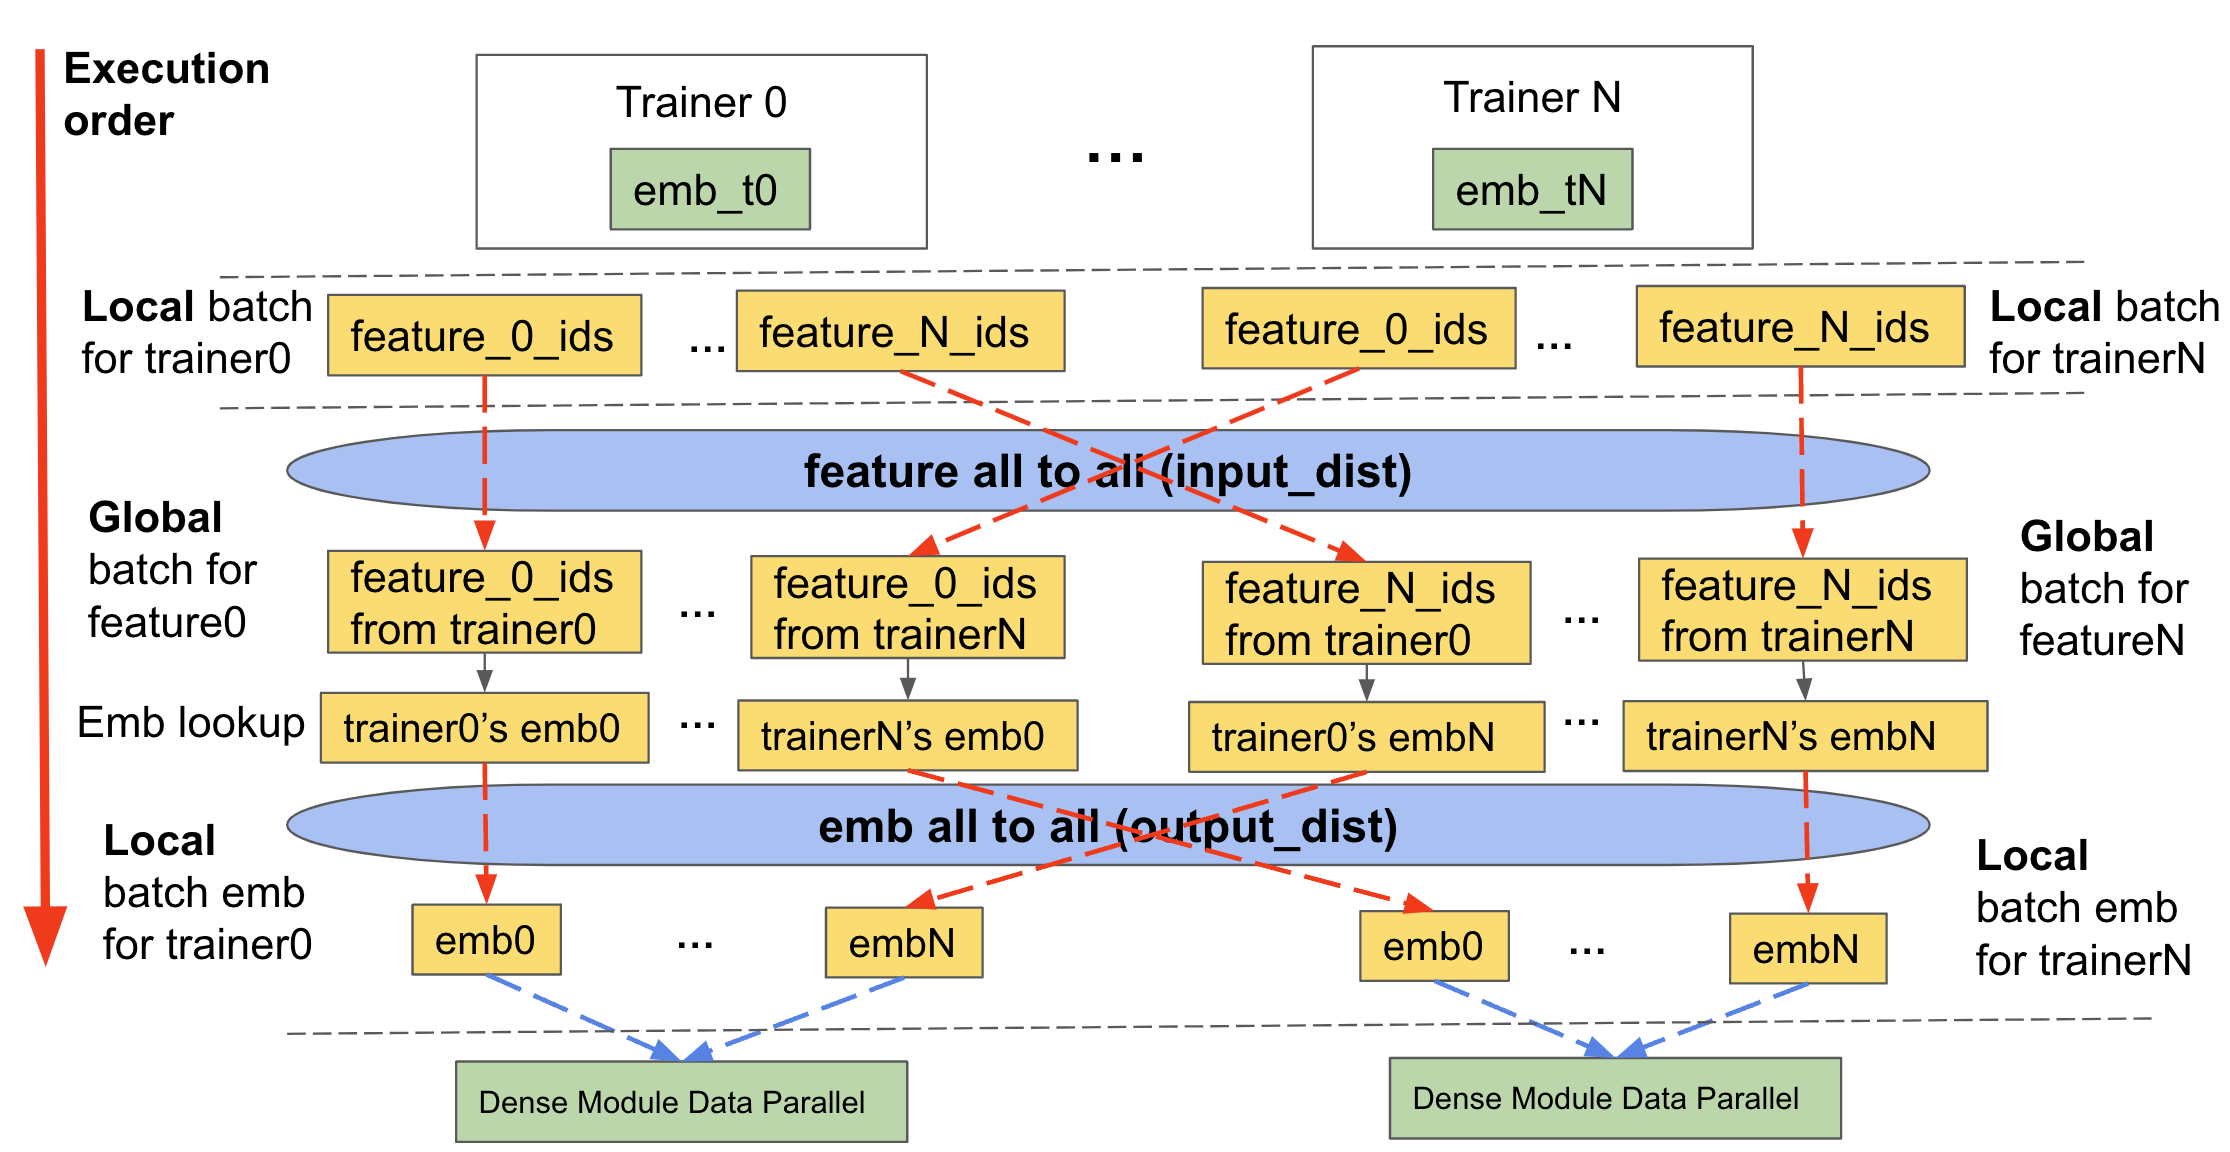
- embedding lookup:三阶段
3.1.4 DistributedModelParallel(DMP)
总的来说,DistributedModelParallel 执行以下操作:
- 通过设置进程组和分配设备类型来初始化环境。
- 如果未提供 Sharder,则使用默认 Sharder,默认 Sharder 包括
EmbeddingBagCollectionSharder。 - 接收提供的分片计划,如果未提供,则生成一个。
- 创建模块的分片版本并替换原始模块,例如,将
EmbeddingCollection转换为ShardedEmbeddingCollection。 - 默认情况下,使用
DistributedDataParallel包装DistributedModelParallel。
3.1.5 ShardingStrategies
分片类型:
自动分片:
AutomaticShardingPlanner,评估内存约束、计算需求和硬件带宽等因素,自动生成最优分片计划。
- Enumerator:生成所有有效分片选项
- Proposer:使用不同搜索算法探索候选计划
- Partitioner:将分片分配到具体设备
- PerfModel:评估计划性能质量
- 在 rank 0 上运行,广播结果到所有 rank
3.1.6 TrainPipeline
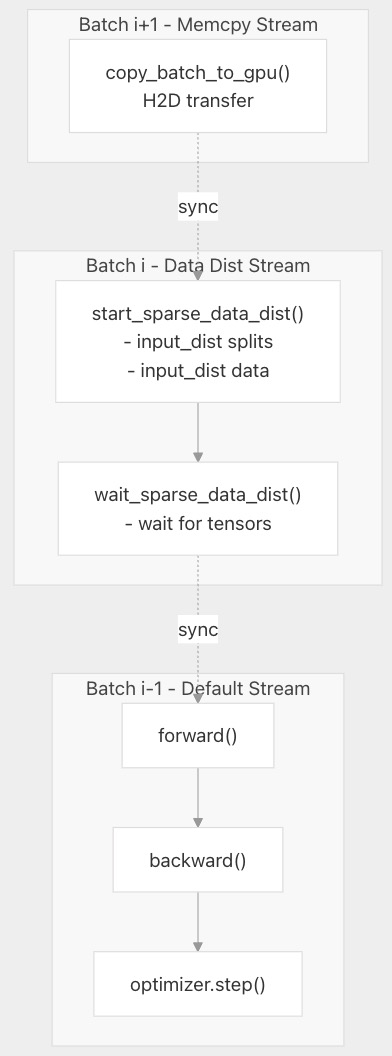
介绍一个常用的,TrainPipelineSparseDist
- batches[i-1]: forward/backward,计算
- batches[i]: input distribution,通信
- batches[i+1]: H2D copy,搬运
3.1.7 FBGEMM
FBGEMM 是 Facebook 开发的高性能嵌入操作库,fbgemm_gpu 是其 GPU 版本,为 TorchRec 提供底层优化内核 。
核心作用
- embedding(TBE) 优化
- 支持多个embedding表的一次性内核调用,避免逐表查找
- 提供 13-23 倍的性能提升相比原生 EmbeddingBag
- 优化器融合
- 在反向传播中直接执行优化器更新,无需存储梯度
- 显著减少内存使用,特别是大型嵌入表
- 多种计算内核
- SplitTableBatchedEmbeddingBagsCodegen: 训练时的embedding查找
- IntNBitTableBatchedEmbeddingBagsCodegen: 推理时的量化嵌入
3.1.8 DynamicEmbedding
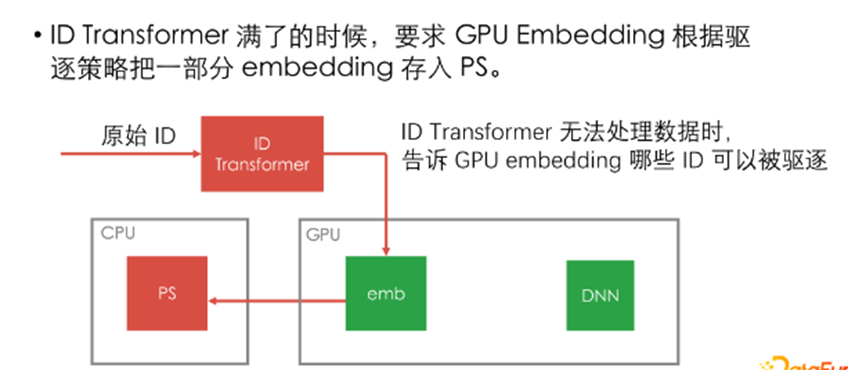
Embedding的动态增删需求,例如删除一周没有访问过的 ID,新的ID。
微信团队
微信基于 PyTorch 的大规模推荐系统训练实践 - 知乎
“假如 GPU embedding 里面只能存下 n 个 ID,而总 ID 有 N 个,甚至无穷多个。可以将全局的 ID 按顺序映射到 0、1、2、3…,并把映射关系存在一个叫 ID transform 的结构中,让 GPU embedding 利用映射的结果进行正常的训练。当 GPU embedding 放满了,也就是 ID transformer 中 n 对映射的时候,再批量驱逐 ID 至 PS”。
recsys-example
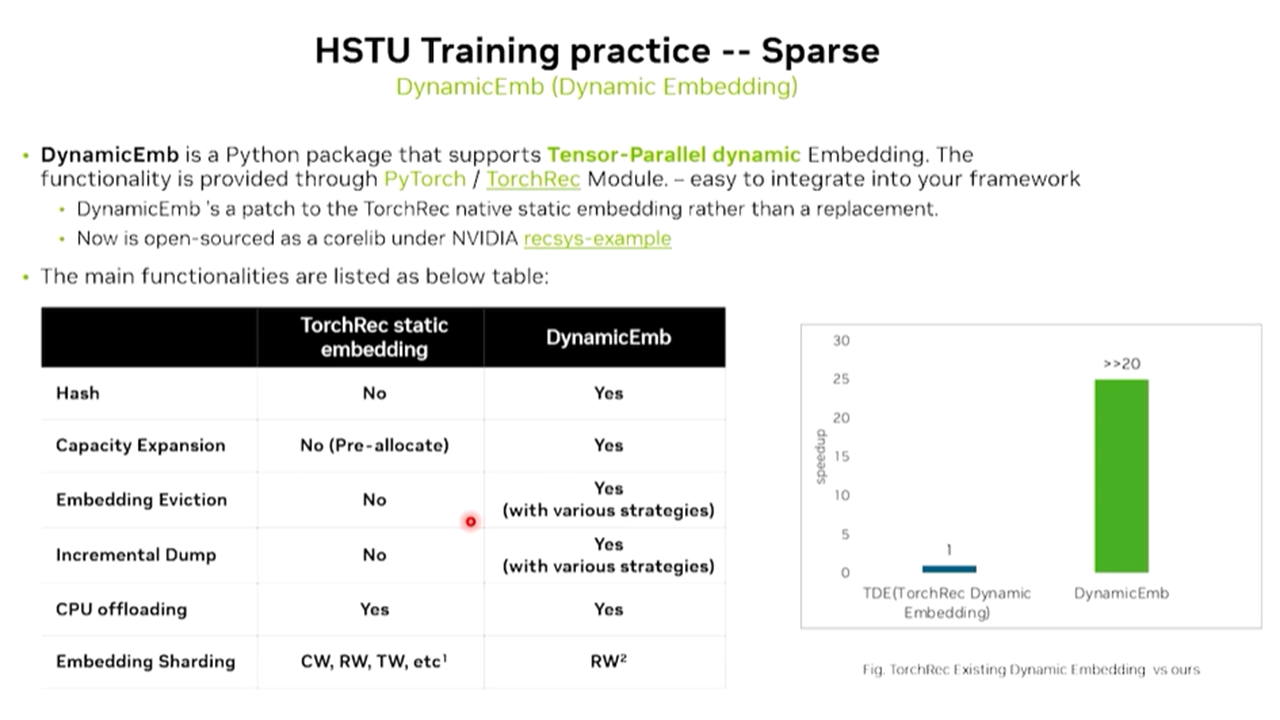
NVIDIA recsys-examples: 生成式推荐系统大规模训练推理的高效实践(上篇)
基于hkv,对齐torchrec接口,20倍tbe。
3.2 RecSDK:昇腾 NPU 上的推荐训练框架
3.2.1 全局地图——一次训练迭代的完整调用栈
在展开任何模块之前,先确认一个问题:在已有 TorchRec 的情况下,为什么还需要 RecSDK?
原因有二:
- 算子生态:CUDA 生态下,上游 TorchRec 和 fbgemm_gpu 的大量算子默认走 CUDA 路径,无法直接复用;
- 通信后端:昇腾的集合通信走 HCCL 而非 NCCL,分布式训练的通信层无法直接复用 TorchRec。
RecSDK 首先解决这两件事。下面是一次完整训练迭代的调用栈:
dataloader.next()
  │
  ▼
pipeline.progress(dataloader_iter)
  │
  ├─ [SPLIT]          数据拆分:将 KJT 按 world_size 分桶
  │    └─ bucketize_kjt_before_all2all()    ← 3.2.3
  │
  ├─ [FIRST_ALL2ALL]  第一轮通信:发送长度信息
  │    └─ FusedKJTListSplitsAwaitable       ← 3.2.3
  │
  ├─ [SECOND_ALL2ALL] 第二轮通信:发送实际数据
  │    └─ KJTListAwaitable.wait()           ← 3.2.3
  │
  ├─ [POST_INPUT]     后处理:哈希去重 + ID 映射
  │    └─ UniqueHashFeatureProcess          ← 3.2.4
  │    └─ IdsMapper.UniqueAndLookup()       ← 3.2.4
  │
  ├─ [COPY2NPU]       拷贝:pin_memory → NPU 设备
  │    └─ kjt_list_to_device()
  │
  └─ [COMPUTE]        计算:前向 + 反向 + 优化器更新
       └─ HybridGroupedPooledEmbeddingsLookup  ← 3.2.4
       └─ model.forward() + backward()
       └─ optimizer.step()                      ← 3.2.7
这六个阶段由 HybridTrainPipelineSparseDist(3.2.5 节)编排为多 batch 流水线,最多 12 个 batch 同时在不同阶段执行。当 Embedding 表超出设备内存时,torchrec_embcache(3.2.6 节)在 POST_INPUT 和 COMPUTE 之间插入缓存换入换出逻辑。
子模块速览
RecSDK 由三个子模块构成:
| 维度 | hybrid_torchrec(核心层) | torchrec_embcache(缓存扩展层) | torchrec_npu(适配层) |
|---|---|---|---|
| 存储范围 | 仅 NPU 内存 | NPU + Host DDR + 磁盘 | N/A(不涉及存储) |
| 适用场景 | NPU 内存足够放下模型 | 模型超出 NPU 内存,涉及换入换出 | 所有场景(底层依赖) |
| 核心类 | HashEmbeddingBagCollection | EmbCacheEmbeddingBagCollection、EmbcacheManager | N/A |
| 关键路径 | hybrid_torchrec/hybrid_torchrec/ | torchrec_embcache/src/torchrec_embcache/ | torchrec_npu/*.patch |
版本矩阵(参考):
Ver1 = PyTorch 2.6.0 + torch_npu 2.6.0 + TorchRec 1.1.0+npu + fbgemm_gpu 1.1.0+cpu;
Ver2 = PyTorch 2.7.1 + torch_npu 2.7.1 + TorchRec 1.2.0+npu + fbgemm_gpu 1.2.0+cpu。
支持 Atlas 800T A2 / 200T A2 / 900 A3,OS 支持 Debian 12、CentOS 7.6、OpenEuler 22.03。
小结: RecSDK torch_rec_v1 的架构可以一句话概括——在 NPU 上用哈希表管理 Embedding、用 Row-Wise 分片 + AllToAll 做分布式、用多阶段流水线隐藏通信延迟、用三级缓存突破内存限制。接下来从具体的问题开始:Embedding ID 管理。
3.2.2 哈希 Embedding——动态 ID 空间的管理
问题
推荐场景中的特征 ID 有三个特点:稀疏(活跃 ID 远少于全量 ID 空间)、动态(新用户、新广告持续出现)、无界(ID 空间理论上没有上限)。
传统的 nn.Embedding(num_embeddings, dim) 要求在建模时就确定词表大小。这意味着要么预留一个巨大的词表(浪费内存在低频 ID 上),要么定期重建词表(工程成本高且有中断风险)。对于 10 亿+ ID 规模的工业推荐模型,这两条路都走不通。
方案
RecSDK 用哈希表替代静态数组——HashEmbeddingBagCollection 将任意全局 ID 通过哈希映射到本地 Embedding 槽位,把固定大小的数组变成了动态字典。
类层级关系如下:
HashEmbeddingBagConfig          ← 扩展 TorchRec 的 EmbeddingBagConfig,增加哈希表选项
  │
  ▼
HashEmbeddingBagCollection      ← 管理多张表的集合,对外暴露 forward()
  │
  ├─ HybridHashTable            ← 底层哈希表模块,封装 torch.nn.EmbeddingBag
  └─ IdsMapper                  ← 全局 ID → 本地偏移的映射器(C++ 实现)
相比 TorchRec 原生的 EmbeddingBagConfig,HashEmbeddingBagConfig 的核心差异只有一处——增加了 HashTableOption:
@dataclass
class HashTableOption:
    init_capacity: int = 0       # 哈希表初始容量
    max_capacity: int = 0        # 最大容量(0 = 不限)
    max_npu_memory_for_vectors: int = 0  # NPU 内存上限
    max_bucket_size: int = 0     # 桶大小(冲突处理)
哈希表让 Embedding 行可以在训练过程中按需分配——低频 ID 不占内存,新 ID 随时新建。
参数约束: Embedding 维度 8~4096(必须是 8 的倍数)| 最大表数量 10,000 | 单表最大 ID 数 10 亿 | 数据类型仅 FP32 | 池化类型 SUM / MEAN / NONE
设计思考
为什么选哈希映射而非 feature hashing(取模映射到固定槽位)? 这是一个关键的设计决策。Feature hashing 更简单,但会导致多个不同 ID 映射到同一个 Embedding 行,产生梯度干扰——A 用户的梯度更新会影响到 B 用户的向量表示。更致命的是,per-ID 的优化器状态(Adam 的两个动量)在 feature hashing 下是共享的,语义完全错误。哈希映射虽然引入了哈希表管理开销,但保证了每个 ID 独立维护自己的 Embedding 和优化器状态,这对生产模型的效果至关重要。
小结: 哈希 Embedding 解决了词表问题——用动态字典替代静态数组,按需分配、独立维护。但它引入了新问题:当有 10 亿个 ID 和多块 NPU 时,哪个 ID 放在哪块卡上?这就是下一节要解决的分片问题。
3.2.3 分片与通信——Row-Wise + AllToAll
问题
一张 10 亿 ID × 128 维 × FP32 的 Embedding 表占约 477GB 内存,必须切分到多块 NPU 上。但切分之后,一个训练 batch 里的 ID 可能分布在任意卡上,每块卡都需要从其他卡拉取自己需要的 Embedding 向量。分片策略决定了通信模式,通信模式决定了训练吞吐。
方案
RecSDK 选择 Row-Wise 分片:每个 ID 通过 hash(ID) % world_size 确定性地分配到某块 NPU。查找时通过 AllToAll 通信将请求发送到对应设备,再将结果收回。
四种分片策略对比:(其他分片策略见3.1.5 TorchRec相关章节)
| 分片策略 | 通信模式 | 内存均衡 | 适用场景 |
|---|---|---|---|
| Row-Wise(已选) | AllToAll(全交换) | 好(哈希均匀分布) | 大规模稀疏表,ID 分布近似均匀 |
| Column-Wise | AllGather(每卡广播) | 差(每卡存全部行) | 小表、宽维度 |
| Table-Wise | 按表分配 | 不均(大表独占一卡) | 表大小差异小 |
| Data-Parallel | AllReduce(全量梯度聚合) | 最差(完整复制) | 小型 Embedding |
Row-Wise 在 ID 均匀分布时内存最均衡,配合哈希映射(3.2.2 节),这个条件天然满足。
两轮 AllToAll
分片通信不是一次 AllToAll,而是两轮。
为什么?因为稀疏特征是变长的(KeyedJaggedTensor,不同样本的特征 ID 数量不同)。接收方在收到数据之前,不知道对方要发多少数据过来,也就无法预分配接收 buffer。所以:
- 第一轮 AllToAll(FIRST_ALL2ALL):交换每个 feature 的长度信息。每块卡告诉其他卡"我要给你发多少个 ID"。
- 第二轮 AllToAll(SECOND_ALL2ALL):基于第一轮拿到的长度信息预分配 buffer,然后交换实际的 ID 值和权重。
这两轮通信对应流水线中的 TaskType.FIRST_ALL2ALL 和 TaskType.SENCOND_ALL2ALL(见 hybrid_train_pipeline.py:65)。
分桶函数
bucketize_kjt_before_all2all() 是分片的入口函数,它的两个 bool 参数揭示了设计意图:
def bucketize_kjt_before_all2all(
    kjt: KeyedJaggedTensor,
    num_buckets: int,
    ...
    do_unique: bool = False,    # 是否在通信前做本地去重
    enable_admit: bool = False, # 是否在通信前做准入过滤
) -> Tuple[...]:
do_unique 的意义在于:同一个 batch 里可能有多个样本引用同一个 ID。如果不去重,这个 ID 会被重复发送到目标设备,白白浪费 AllToAll 带宽。在通信前去重,AllToAll 的 payload 可以显著减小。
enable_admit 配合多级缓存使用(3.2.6 节):对于不满足准入条件的低频 ID,直接在通信前过滤掉,不浪费通信和查找开销。当 do_unique 和 enable_admit 同时开启时,函数返回 KeyedJaggedTensorWithCount(携带频次信息),供下游的淘汰策略使用。
线程池
分桶操作在 CPU 端执行(因为 NPU 不擅长这类不规则计算),通过 InputDistThreadPoolExecutorSingleton 异步化:
DEFAULT_INPUT_DIST_THREADS = 6
MAX_INPUT_DIST_THREADS = 12
# 通过环境变量 INPUT_DIST_THREADS 控制
默认 6 线程,最大 12 线程。线程数太少,CPU 分桶跟不上 NPU 计算速度;线程数太多,线程切换开销反而拖慢。这个值没有自动调优,用户需要根据模型特征数量和 CPU 核数手动调整。类似地,后处理阶段也有一个独立的线程池 ThreadPoolExecutorSingleton(默认 6 线程,通过 POST_INPUT_THREADS 环境变量控制)。
设计思考
Row-Wise 的 AllToAll 通信量随设备数呈 O(world_size²) 增长。 在 8 卡场景下问题不大,但扩展到 64 卡甚至 128 卡时,AllToAll 成为主要瓶颈。这也是 3.2.5 节流水线并行的直接驱动力——不是因为计算慢,而是因为通信慢。
小结: Row-Wise 分片 + 两轮 AllToAll 解决了"哪个 ID 放哪块卡"的问题。但 AllToAll 之后,每块卡拿到的是一堆全局 ID——还需要映射到本地哈希表、去重、查找向量。这条"从原始 ID 到向量"的查找路径,是下一节的主题。
3.2.4 Embedding 查找路径——从原始 ID 到向量
问题
AllToAll 通信完成后,每块 NPU 收到一组它负责的特征 ID。接下来需要四步操作:
- 映射:全局 ID → 本地哈希表偏移量
- 去重:同一 batch 中重复的 ID 只查找一次
- 查找:用偏移量从 Embedding 表中取向量
- 池化:将同一样本的多个向量聚合为一个(SUM / MEAN)
这条路径每个 batch 都完整执行一遍,延迟直接影响训练吞吐。
方案
RecSDK 的做法是:步骤 1-2 用 C++ 引擎完成,步骤 3 复用 fbgemm_gpu 的高性能内核。
(fbgemm_gpu 是 Meta 为 CUDA GPU 设计的高性能 Embedding 库,RecSDK 通过 torchrec_npu 的 patch 将其适配到 NPU。这意味着 RecSDK 继承了 fbgemm_gpu 的所有接口约束(如 FP32-only),同时需要跟踪上游的 API 变更。好处是复用了经过大规模验证的 Embedding 内核实现,坏处是适配层的维护成本。)
扩展稀疏张量
TorchRec 原生的 KeyedJaggedTensor 只携带 keys、values、lengths 等基本信息。但经过映射和去重后,需要携带更多元数据。RecSDK 定义了 KeyedJaggedTensorWithLookHelper,新增了 5 个字段:
| 字段 | 类型 | 含义 | 来源 |
|---|---|---|---|
_hash_indices | Tensor | 哈希映射后的本地偏移 | IdsMapper C++ 算子 |
_unique_indices | Tensor | 去重后的唯一索引 | Unique C++ 算子 |
_unique_inverse | Tensor | 唯一索引 → 原始位置的反向映射 | Unique C++ 算子 |
_unique_offset | Tensor | 唯一索引的偏移量 | Unique C++ 算子 |
_unique_ids | Tensor | 唯一 ID 列表 | IdsMapper C++ 算子 |
注意"来源"列——每个字段都是某个 C++ 算子的输出。KeyedJaggedTensorWithLookHelper 本质上是一个中间结果容器,把映射和去重的产物打包传给下游的 Embedding 查找内核。
另一个扩展类 KeyedJaggedTensorWithCount 额外携带特征频次(counts),供缓存的准入/淘汰决策使用(3.2.6 节)。
C++ 引擎——融合去重、映射
核心 C++ 算子位于 hybrid_torchrec/src/,通过 libhybrid_cpp.so 暴露给 Python:
| 算子 | 功能 | 关键方法 |
|---|---|---|
IdsMapper | 全局 ID → 本地偏移映射 | UniqueAndLookup()、ParallelUniqueHashOut() |
Unique | 并行唯一值去重 | 基于并行哈希实现 |
Bucketize | CPU 端分桶 | BlockBucketizeSparseFeaturesCpu() |
这里的关键设计是 UniqueAndLookup() 将去重和查找融合为单次哈希表遍历。如果分成两步——先去重再查找——需要遍历哈希表两次,内存流量翻倍。融合后只遍历一次,对于百万级 ID 的 batch,性能差异显著。
计算内核分发
HybridGroupedPooledEmbeddingsLookup 根据配置分发到不同的计算后端:
| 计算内核 | 后端 | 适用场景 | 性能层级 |
|---|---|---|---|
| FUSED | fbgemm_gpu SplitTableBatchedEmbeddingBagsCodegen | 纯设备内存模式 | 最高 |
| KEY_VALUE | KeyValueEmbeddingBag | 多级缓存模式 | 中等 |
| DENSE | PyTorch 原生 | 调试/回退 | 最低(未实现,返回 NotImplemented) |
分派逻辑很直白(embedding_lookup.py:52-73):检查 config.compute_kernel,FUSED 走 HybridBatchedFusedEmbeddingBag,KEY_VALUE 走 KeyValueEmbeddingBag,其他直接报错。值得注意的是 DENSE 内核当前返回 NotImplemented,即生产环境只有 FUSED 和 KEY_VALUE 两条路。
小结: 查找路径的核心设计是"C++ 融合去重+映射,fbgemm_gpu 高性能查找"。单个 batch 的查找路径已经清楚了,但训练不是一个 batch 一个 batch 串行跑的——下一节看流水线如何把多个 batch 的不同阶段交叠起来。
3.2.5 流水线并行——隐藏 AllToAll 延迟
问题
先算一笔账。假设 AllToAll 通信耗时 10ms,NPU 前向+反向耗时 15ms。如果串行执行:
[通信 10ms] → [计算 15ms] → [通信 10ms] → [计算 15ms] → ...
总耗时 = 25ms/batch,NPU 利用率 = 15/25 = 60%
40% 的时间 NPU 在等通信。随着集群规模增大,AllToAll 延迟还会进一步增长(3.2.3 节提到的 O(world_size²)),NPU 利用率会更低。
方案
HybridTrainPipelineSparseDist 将训练拆为 6 个阶段,用多条"流水线"让不同 batch 在不同阶段并行执行:
class TaskType(Enum):
    SPLIT = 0            # CPU 端分桶
    FIRST_ALL2ALL = 1    # 第一轮 AllToAll(发长度)
    SENCOND_ALL2ALL = 2  # 第二轮 AllToAll(发数据)
    POST_INPUT = 3       # 哈希去重 + ID 映射
    COPY2NPU = 4         # pin_memory → NPU
    # COMPUTE 阶段不在枚举中,因为它是 progress() 函数体本身
多 batch 交叠的时序图:
时间轴 →

Batch 0: [SPLIT] [ALL2ALL-1] [ALL2ALL-2] [POST_INPUT] [COPY2NPU] [COMPUTE]
Batch 1:         [SPLIT]     [ALL2ALL-1] [ALL2ALL-2]  [POST_INPUT] [COPY2NPU] [COMPUTE]
Batch 2:                     [SPLIT]     [ALL2ALL-1]  [ALL2ALL-2]  [POST_INPUT] [COPY2NPU] [COMPUTE]
         ──────────────────────────────────────────────────────────────────────────────────────────→
当流水线填满后,每个时间片内有多个 batch 同时在不同阶段执行。NPU 在处理 Batch N 的 COMPUTE 时,Batch N+1 的数据已经在 COPY2NPU,Batch N+2 在做 POST_INPUT,以此类推。通信延迟被"藏"在了其他 batch 的计算时间里。
关键实现细节
AwaitableAdapter 模式:TorchRec 的 Awaitable 是同步用 .wait() 调用。RecSDK 用 AwaitableAdapter 将其包装进线程池:
class AwaitableApapter(Awaitable):           # 注意源码中的拼写
    def __init__(self, awaitable) -> None:
        super().__init__()
        self.future = InputDistThreadPoolExecutorSingleton().executor.submit(
            get_awaitable_result, awaitable  # 在线程池中异步等待
        )

    def _wait_impl(self) -> Any:
        return self.future.result()           # 调用时才阻塞
HybridPipelinedForward:自定义前向传播类,在调用 compute_and_output_dist() 前先做 Stream 同步——确保 COPY2NPU 阶段的数据搬运已完成。这里用了 torch_npu.npu.current_stream().wait_stream(self._stream)。
流水线深度权衡
流水线深度 (pipe_n_batch) | 延迟隐藏效果 | 内存开销 | 调试复杂度 | 建议场景 |
|---|---|---|---|---|
| 1(无流水线) | 无 | 基线 | 最低 | 调试 |
| 3(推荐) | 好 | 3x 上下文内存 | 中等 | 多数生产场景 |
| 6(默认值) | 较好 | 6x 上下文内存 | 高 | 通信延迟较大的集群 |
| 12(上限) | 最大 | 12x 上下文内存 | 极高 | 特殊超大规模通信场景 |
MAX_PIPE_N_BATCH = 12(hybrid_train_pipeline.py:59)。每多一级流水线,就多一套 HybridTrainPipelineContext(包含 batch 数据、各阶段 Awaitable、模块上下文),内存开销线性增长。对于多数工作负载,pipe_n_batch=3 就能覆盖 80%+ 的通信隐藏收益,6 和 12 只在通信延迟特别大(如跨机跨节点 AllToAll)时才有必要。
设计思考
流水线的本质不是"计算加速",而是"通信隐藏"。 如果瓶颈在 NPU 计算本身,增加 pipe_n_batch 不会有任何帮助,反而浪费内存。只有当 profiling 显示 AllToAll 占比 > 30% 时,才值得尝试更深的流水线。
流水线深度与缓存的 maxVersionDiff_ 存在隐式耦合(3.2.6 节详述)。简单说:缓存的追踪窗口必须 ≥ 流水线深度,否则可能出现"某个 batch 还在用某个缓存槽位,但该槽位已经被后续 batch 的换入换出覆盖"的竞态条件。
小结: 流水线通过多 batch 交叠隐藏了 AllToAll 延迟,让 NPU 利用率从 60% 提升到接近 100%。但以上讨论都假设 Embedding 表放得下设备内存。当表大到 10TB 时,设备内存显然不够——需要一套缓存机制将数据在设备内存、主机内存和磁盘之间动态调度。这就是下一节的主题。
3.2.6 多级缓存
问题
Atlas 800T A2 的 NPU 设备内存约 64GB。一张 10TB 的 Embedding 表需要 ~160 块卡才能放下(不算优化器状态),而 Adam 优化器还要额外 2x 内存存储动量。即使做了 Row-Wise 分片,单卡分到的 Embedding 数据量仍可能超过设备内存。
向外扩展存储有两个层级:主机 DDR(随机访问延迟 ~100ns)和磁盘(随机访问延迟 ~100μs)。相比 NPU 设备内存(~10ns 级),DDR 慢 10 倍,磁盘慢 10000 倍。直接用 DDR/磁盘做 Embedding 查找会让训练慢到不可接受。
方案
torchrec_embcache 实现了一套三级缓存:
┌─────────────────┐
│  NPU 设备内存    │  ← (当前活跃 ID 的 Embedding + 优化器状态)
│  (最快,最小)   │
└────────┬────────┘
         │ swap-in / swap-out
┌────────▼────────┐
│  主机 DDR        │  ← (近期访问过的 ID)
│  (中速,中等)   │
└────────┬────────┘
         │ load / save
┌────────▼────────┐
│  磁盘            │  ← (所有 ID 的持久化存储)
│  (最慢,最大)   │
└─────────────────┘
核心调度器是 EmbcacheManager(C++ 实现),它在每个训练步中决定:哪些 ID 需要从 DDR 换入设备内存(swap-in),哪些不再活跃的 ID 需要从设备内存换出到 DDR(swap-out)。
淘汰策略
当设备内存中的缓存满了,需要选择哪些 ID 被换出。RecSDK 提供四种策略 + 自定义扩展:
| 淘汰策略 | 逻辑 | 优势 | 弱点 |
|---|---|---|---|
| LRU | 最近最少使用的 ID 先淘汰 | 简单,适合时间局部性强的场景 | 一次扫描就能把高频 ID 全部挤出 |
| LFU | 最不频繁使用的 ID 先淘汰 | 适合频率局部性强的场景 | 曾经热门但已过时的 ID 迟迟不被淘汰 |
| EpochLRU | 按 Epoch 粒度统计的 LRU | 比 LRU 更抗扫描污染 | |
| EpochLFU | 按 Epoch 粒度统计的 LFU | 比 LFU 更快适应分布变化 | |
| Customized | 用户自定义 | 完全灵活 | 需要用户理解缓存行为 |
准入策略
淘汰策略决定"谁离开",准入策略决定"谁进来"。不是每个新出现的 ID 都值得占用宝贵的设备内存:
| 准入策略 | 逻辑 | 适用场景 |
|---|---|---|
POLICY_COUNT | 某 ID 出现次数 ≥ 阈值后才准入 | 通用场景,过滤一次性低频 ID |
POLICY_SHOWCLICK | 基于展示-点击率评分(alpha * clicks + beta)决定准入 | 广告推荐场景,CTR 信号比纯频次更有区分度 |
完整的特征生命周期如下:
新 ID 到来 → 准入判断(频次/展示点击率)→ [不满足] → 丢弃,不进缓存
                                         → [满足]   → 换入设备内存
                                                      │
              缓存满时 → 淘汰策略选择 → 换出到 DDR/磁盘
C++ 缓存引擎的关键数据结构
SwapInfo 结构(embcache_manager.h)封装了每一步的换入换出计划:
struct SwapInfo {
    vector<vector<int64_t>> swapoutKeys;   // 要换出的 Key
    at::Tensor swapoutOffs;                 // 换出偏移量
    vector<vector<int64_t>> swapinKeys;    // 要换入的 Key
    at::Tensor swapinOffs;                  // 换入偏移量
    at::Tensor batchOffs;                   // Batch 偏移量
};
整个 C++ 引擎包含 24+ 个头文件/源文件:
| 子模块 | 功能 |
|---|---|
EmbcacheManager | 核心调度——决定何时换入换出、选择牺牲者 |
SwapManager | 执行换入换出操作,维护 key2off_ 映射(基于 ska::flat_hash_map) |
HashTable | 高性能哈希映射,桶式冲突处理 |
FeatureFilter | 准入/淘汰策略的具体实现 |
FileSystem | 磁盘持久化抽象(本地文件系统) |
关键常量揭示了 I/O 设计思路:
MAX_EMB_TABLE_NUM = 10000MAX_EMB_DIM = 4096ONE_TIME_IO_WRITE = 100000— 单次 I/O 写 10 万行ONE_TIME_LOAD_DIM_4096 = 100000— 单次加载 10 万行(Adam 优化器下约 4.58GB/次)
ONE_TIME_LOAD_DIM_4096 这个常量值得多说一句:每次换入操作加载 10 万行,对于 dim=4096 + Adam(3 个 tensor:weight + momentum1 + momentum2)= 4096 × 4 bytes × 3 × 100000 ≈ 4.58GB。这个粒度是精心选择的——太小则 I/O 开销占比过大,太大则单次换入阻塞时间过长。
设计判断
MIN_EVICT_STEP_INTERVAL = 10(train_pipeline.py:64)意味着淘汰操作最快每 10 个训练步执行一次。 这是防止驱逐抖动(thrashing)的保护机制——如果每步都做淘汰,可能出现"换出的 ID 下一步又被换入"的恶性循环。但 10 步的间隔也意味着系统对突发分布变化(如突发热点新闻导致某些 ID 瞬间变热)的响应至少有 10 步延迟。
SwapManager 的版本追踪窗口与流水线深度存在隐式耦合。 SwapManager 内部维护一个 maxVersionDiff_(默认值 3),用于追踪同一个缓存槽位在最近 N 个训练步中的 key 变化。这个值必须 ≥ 流水线深度——因为流水线中有多个 batch 同时在飞,某个 batch 在 POST_INPUT 阶段读取的缓存槽位,不能在该 batch 到达 COMPUTE 阶段之前被另一个 batch 的换入操作覆盖。如果 pipe_n_batch > maxVersionDiff_,就可能触发这个竞态条件。这是一个跨模块的不变量约束,但源码中没有显式检查。
小结: 多级缓存通过"热数据驻留设备、冷数据沉降磁盘"的策略突破了设备内存墙,让 10TB+ 的 Embedding 表可训练。但缓存里的 Embedding 向量不只是被查找——反向传播时还要更新优化器状态。下一节看优化器如何与哈希 Embedding 集成。
3.2.7 优化器集成——融合查找+更新
问题
工业推荐模型几乎都用 Adam 或 Adagrad 优化器,这意味着每个 Embedding 行除了权重外,还要维护优化器状态:
| 优化器 | 每行额外状态 | 内存倍率 |
|---|---|---|
| SGD | 无 | 1x |
| Adagrad | 1 个累积量 | 2x |
| Adam | 2 个动量(m, v) | 3x |
对于 10 亿 ID × 128 维的 Embedding 表,Adam 的优化器状态额外占用 ~954GB(= 477GB × 2)。这些状态同样存储在哈希表中,按 ID 索引。
如果前向传播和反向传播分别遍历哈希表——前向查 weight,反向查 weight + momentum1 + momentum2——等于对同一组 ID 做了两次哈希查找。对于百万级 ID 的 batch,两次哈希遍历的内存流量和计算开销都是可观的。
方案
RecSDK 将 Embedding 查找和优化器更新融合到单次哈希表遍历中:
hybrid_torchrec/hybrid_lookup_invoke/
├── hybrid_lookup_sgd.py       # SGD 融合内核
├── hybrid_lookup_adam.py      # Adam 融合内核
├── hybrid_lookup_adagrad.py   # Adagrad 融合内核
└── hybrid_lookup_args.py      # 公共参数结构
HybridCommonArgs 将 weight 放置策略、偏移量、缓存位置等信息打包为一个结构体,传给融合内核。融合内核在一次遍历中完成:读取 weight → 计算前向输出 → 反向传播时用同一次查找的结果更新 momentum 和 weight。
设计思考
融合不只是"性能优化",而是架构上的必要选择。 如果不融合,反向传播时需要重新对每个 ID 做哈希查找以定位其优化器状态。对于哈希表这种随机访问的数据结构,两次查找的 cache miss 率几乎翻倍。融合后,一次哈希定位同时服务于前向读取和反向更新,将哈希表访问量减半。
FP32-only 限制, 如果支持 BF16 Embedding + FP32 优化器状态(业界常见做法),内存占用可以从 3x FP32 降到约 2.5x(BF16 weight + FP32 m + FP32 v)。
小结: 融合优化器将"查找"和"更新"合为一次哈希遍历,是对哈希 Embedding 架构的必然配套设计。至此,核心训练路径已经完整:Embedding 管理(3.2.2)→ 分布式分片(3.2.3)→ 查找路径(3.2.4)→ 流水线编排(3.2.5)→ 缓存扩展(3.2.6)→ 优化器融合(3.2.7)。
3.2.8 NPU 适配与运维关注点
NPU 补丁机制
torchrec_npu 通过 patch 文件将上游 TorchRec 适配为支持昇腾 NPU 的版本:
torchrec1.1.0_npu.patch— 适配 TorchRec 1.1.0(基于 commit2c5f6ee)torchrec1.2.0_npu.patch— 适配 TorchRec 1.2.0(基于 commit5db1a21)
Patch 的核心改动包括:将 CUDA stream 操作替换为 NPU stream、将 NCCL 后端替换为 HCCL、修改设备类型检查等。
模型存储
Saver 类(torchrec_embcache/saver.py)管理分布式 checkpoint:
checkpoint_dir/
├── rank0/
│   ├── embedding/slice.data      # Embedding 权重
│   ├── key/slice.data            # 哈希表键
│   ├── momentum1/slice.data      # Adam 动量 1
│   ├── momentum2/slice.data      # Adam 动量 2
│   └── slice.attribute           # 元数据
├── rank1/
│   └── ...
每个 rank 独立保存自己负责的 Embedding 分片,检查点按时间戳组织。恢复时按 rank 加载对应分片即可。
从 TorchRec 迁移
从原生 TorchRec 迁移到 RecSDK 的接口改动很小,核心映射如下:
| TorchRec 原生接口 | RecSDK 接口 | 变更说明 |
|---|---|---|
EmbeddingBagConfig | HashEmbeddingBagConfig | 增加哈希表选项 |
EmbeddingBagCollection | HashEmbeddingBagCollection | 支持动态 ID |
get_default_sharders() | get_default_hybrid_sharders() | 使用 Hybrid 分片器 |
TrainPipelineSparseDist | HybridTrainPipelineSparseDist | 6 阶段流水线 |
3.2.9 典型使用流程
# 1. 配置 Embedding 表
configs = [HashEmbeddingBagConfig(
    num_embeddings=1000000, embedding_dim=128,
    name="user_table", feature_names=["user_id"],
    pooling=PoolingType.SUM,
)]

# 2. 创建模型
ebc = HashEmbeddingBagCollection(tables=configs, device=torch.device("meta"))
model = MyRecModel(ebc=ebc)

# 3. 应用优化器(必须用 apply_optimizer_in_backward)
apply_optimizer_in_backward(Adagrad, model.ebc.parameters(), {"lr": 0.01})

# 4. 分片部署
sharded_model = shard(model, create_sharding_plan(model, get_default_hybrid_sharders()), env)

# 5. 创建流水线并训练
pipeline = HybridTrainPipelineSparseDist(
    model=sharded_model, optimizer=optimizer,
    device=npu_device, pipe_n_batch=3,  # 推荐值
)
for epoch in range(num_epochs):
    for batch in dataloader:
        loss = pipeline.progress(dataloader_iter)

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)