登录社区云,与社区用户共同成长
邀请您加入社区
中国移动发布《2026-2027年新一代人工智能超节点设备集中采购项目》招标公告,拟采购1024卡级液冷超节点设备20,480张,配套无损交换机448台及智算存储、分布式文件存储系统。项目强调“算力普惠”,要求全链路支持内存统一编址、高带宽低时延互联(如800G RoCEv2)、AI卡直通显存、KVCache外置存储等先进特性,突出对昇腾950等国产加速卡生态的深度依赖。硬性门槛包括仅限原厂投标、
本文基于MindSpore-Transformers实现多源数据集混合预处理,解决格式不一、权重配比、分布式训练等问题。通过适配器统一字段为prompt-response格式,支持加权采样与全局打乱,结合Tokenizer完成SFT分词,并在昇腾NPU上实现分布式分片与缓存加速。框架可灵活接入指令、对话、领域数据,提升微调数据质量,保障训练稳定性与效率。
本文基于MindSpore2.4与昇腾910B环境,提出通过get_gpt_layer_local_spec实现GPT大模型从PyTorch向MindSpore分布式训练的高效迁移。该接口精准划分各Rank的层范围,支持层粒度并行与权重分片加载,解决跨框架权重错位、内存溢出及初始化不一致问题。结合本地分片模型构建与映射加载策略,实现仅加载本卡所需权重,显著降低内存开销,打通PyTorch→Mind
本文基于MindSpore实现工业级SwiGLU-MLP模块,完成独立推理、Decoder集成、MindIR导出及昇腾Ascend 910B优化。通过静态图编译、图内核融合、自动混合精度与权重拼接等技术,显著降低矩阵乘算子访存开销,提升推理效率。代码可直接部署于昇腾集群,支持离线推理与分布式扩展,为大模型高效推理提供完整解决方案。
MindSporeTransformers(MindFormers)通过monitor_config实现大模型训练的非侵入式实时监控,支持超长时预训练与分布式微调。该配置模块可统一采集loss、学习率、梯度、显存/昇腾NPU内存等指标,自动输出至TensorBoard、JSON日志或控制台,并支持异常告警与自定义回调扩展。适用于单机及昇腾910B集群场景,提供完整YAML配置、启动代码、可视化对接
本项目基于国产化软硬件栈(鲲鹏920、昇腾910B、openEuler、MindSpore),构建全链路信创语音识别平台,采用Conformer+CTC架构,实现客服录音批量转写与300路并发流式识别,支持热词优化、小样本微调与INT8量化,达CER≤6.5%、RTF<0.45。通过MindSpore原生适配,训练效率提升显著,推理性能稳定,三年TCO降低40%以上,实现从训练到部署的自主可控闭环
mindspore.dataset是专为大模型设计的高性能数据处理引擎,支持文本、图像、多模态数据的全流程预处理。其基于C++后端加速、多线程并行与流水线调度,实现数据加载、清洗、分词、编码、截断、填充、掩码生成等操作的高效并行执行,显著提升训练吞吐。通过链式变换、分布式分片、数据下沉等机制,有效解决“算力空转”问题,适配昇腾AI芯片与鲲鹏服务器。本文结合完整代码实战,系统讲解LLM与多模态预处理
本文基于昇思MindSpore与昇腾NPU,构建了覆盖模型收敛、任务精度、训练性能与硬件指标的全周期评估体系,实现Loss、PPL、单步耗时等核心指标的实时监控与早停控制。结合昇腾硬件特性,提出分层优化策略:通过混合精度、重计算降低显存占用;利用图模式融合、数据下沉提升算力利用率;采用分布式通信优化与梯度累积支持多机训练。配套提供可落地的工程代码,形成“评估—诊断—优化”闭环,有效解决大模型训练中
MindSpore Transformers为昇腾NPU提供原生大模型预训练方案,通过静态图编译、自动并行、混合精度与重计算技术,实现7B~13B模型高效训练。支持单机多卡及多机扩展,显存降低60%以上,训练速度提升2~4倍。结合异步数据流水线与优化配置,显著提升吞吐与稳定性,无需复杂改造即可开箱即用,全面释放昇腾硬件性能。
本文系统阐述了基于昇腾硬件与MindSpore框架的大模型预训练数据质量过滤体系。针对噪声、重复、低质等常见问题,提出规则粗过滤、统计特征过滤、相似度去重、模型打分四层递进式过滤架构,结合MindSpore的分布式数据流水线能力,实现TB/PB级语料高效清洗。通过完整代码示例与工程优化建议,构建端到端、可扩展、高可靠的过滤链路,从源头保障大模型训练数据质量,提升模型性能与安全性。
MindSpore通过Callback+日志收集+MindInsight可视化构建了大模型训练的在线监控体系,支持每步采集loss、lr、梯度、权重及NPU资源使用情况,自动保存最优模型并异常中断。MindSpore Transformers封装开箱即用组件,结合昇腾NPU适配,实现训练过程实时监控与可视化分析,显著提升训练稳定性与效率。
昇腾RAG SDK通过智能语义分块、多表征索引、分层架构与NPU原生加速,实现检索精度提升30%、构建速度提升8倍、存储成本降低60%。其四层优化架构深度融合算法与硬件,支持百万级文档毫秒级检索,显著解决大模型幻觉、知识滞后等落地难题,为行业提供高效、低成本的知识增强方案。
本文介绍MindSpore Transformers如何解决大语言模型(LLM)训练中的算力与显存瓶颈。通过自动并行、3D并行策略及混合精度、重计算等显存优化技术,实现千亿参数模型高效分布式训练。框架提供统一接口,支持预训练与微调无缝切换,并基于昇腾AI处理器实现单卡训练13B模型、8卡线性加速比达0.97,显著提升训练效率与稳定性。
msModelSlim是昇思(MindSpore)推出的专为大模型设计的一站式轻量化工具,通过INT8/INT4量化、紧凑存储与mmap内存映射加载,实现模型体积缩小50%~75%,加载速度提升3~8倍,显存占用降低50%~75%,支持秒级启动。其核心优势在于低比特量化+硬件原生解析+预计算参数,显著优化冷启动、多模型调度、边缘部署等场景下的性能瓶颈,是昇腾生态大模型工程化落地的必备利器。
本文基于MindSpore Transformers框架,设计并实现一套无侵入、轻量化的训练监控回调套件,涵盖实时loss与学习率追踪、梯度异常检测、NPU/CPU资源监控、可视化日志输出及自动止损功能。通过自定义Callback机制,实现大模型训练过程的全维度在线监控,显著提升调试效率与训练稳定性,适用于昇腾NPU/GPU环境,有效解决大模型训练“黑盒”问题,助力高效、安全、无人值守训练。
MindSpore依托昇腾NPU,通过因果语言建模、高质量多域语料、长上下文支持(FlashAttention/NTK-RoPE)、混合精度训练与分布式并行,高效完成7B~70B大模型预训练。结合SwiGLU激活、Pre-Norm结构等架构优化,显著提升模型的逻辑推理、知识记忆与任务泛化能力,实现从“语法通顺”到“能思考、会解题”的跃迁,为零样本、少样本任务提供强大基础。
MindSpore tools是昇思框架自带的轻量级二进制工具集,无需Python环境,直接在openEuler+昇腾NPU上运行,支持模型转换、精度调试、性能剖析、离线推理、权重管理与加密等全流程操作。核心工具如converter_lite.bin、benchmark.bin、checkpoint.bin等基于C++实现,调用AscendCL/MindRT,性能比Python脚本高5~20倍,适
本文系统讲解了雅克比矩阵在昇思MindSpore框架中的原理与实战应用。从雅克比矩阵定义出发,结合MindSpore的自动微分机制,详细阐述其在神经网络、科学计算等场景下的实现方法。通过基础、进阶与批量数据三类代码示例,展示了如何利用mindspore.jacobian高效计算向量函数梯度,并突出其在昇腾NPU上的硬件加速优势。文章强调了静态图优化、内存高效与端到端支持等核心特性,助力开发者掌握高
MindSpore Transformers集成TensorBoard实现昇腾NPU上LLM训练的实时监控,无需代码改造即可可视化损失、学习率、精度、梯度、权重及计算图等关键指标。通过SummaryCollector自动采集,支持分布式多卡、低开销实时刷新,结合浏览器访问实现跨平台可观测性。适用于预训练、微调全流程,助力快速排错、优化超参与模型复现,是企业级高效训练的标准方案。
safetensors是由Hugging Face推出的新型安全张量存储格式,取代传统不安全的bin/ckpt/pth文件。其核心优势包括:无代码执行风险、加载速度提升300%~1000%、支持内存映射与分片读取、跨框架通用。在MindSpore Transformers昇思生态中,safetensors实现原生支持,全面适配昇腾NPU,支持极速加载、零拷贝传输与大模型分片部署。从预训练加载、微调
昇思(MindSpore)大模型转换工具基于AscendIR统一中间表示,通过手写或生成JSON/INI格式的单算子描述文件,实现PyTorch、TensorFlow等框架模型向昇腾NPU可执行格式的高效转换。该技术解决了大模型中自定义算子不支持、计算图断裂、精度损失等问题,支持LLaMA、Qwen等主流大模型全图贯通部署,转换成功率提升至100%,精度损失低于0.5%,显著缩短适配时间,是昇腾生
msModelSlim是昇腾生态专为大模型设计的一站式量化压缩工具,支持INT4/INT8等多精度量化与混合策略,可将千亿级模型显存占用降低50%-75%,精度损失控制在1%以内。其核心优势包括逐通道量化、SmoothQuant激活优化、敏感层回退及离群值抑制,适配LLaMA2、Qwen3、DeepSeek等主流模型,显著提升推理效率与部署可行性,是昇腾NPU上大模型轻量化部署的核心利器。
在昇腾NPU上部署PyTorch环境需严格匹配CANN驱动、Python版本、系统库及昇腾适配包,任一组件异常均导致NPU不可用。建议遵循“检查→安装→验证”流程,使用一键检查脚本自动校验NPU状态、环境变量、PyTorch连通性与模型推理功能,确保环境稳定。常见问题如torchnpu缺失、环境未加载、版本不匹配等,可通过重装昇腾源包、source环境脚本、统一版本等快速修复。
本文针对PyTorch与MindSpore在数据加载、增强、格式及分布式读取上的差异,提出小模型迁移中的数据准备标准化方案。通过分析核心差异,构建“数据集定义→清洗→转换→增强适配→管道构建”五步流程,提供图像与文本分类场景的可运行迁移代码,实现数据分布、增强逻辑、输出格式的1:1对齐。重点保障归一化参数、增强概率、批处理等关键配置一致,并结合昇腾NPU优化,确保精度无损与训练高效。
MindSpore Transformers 提供轻量级、无侵入的实时训练监控能力,通过自定义 Callback 实现 loss、学习率、速度等指标的动态曲线可视化,支持终端打印、Web 展示与文件持久化。无需依赖第三方平台,适配昇腾/鲲鹏国产化环境,开箱即用,助力大模型训练过程透明化,提升调试效率与稳定性。
昇思 MindSpore 是面向大模型训练、推理与部署的全场景 AI 框架,模型转换工具作为其核心配套组件,主要实现主流框架模型向 MindSpore 格式的迁移、精度对齐、格式适配与优化,打通 PyTorch、TensorFlow、ONNX 等模型到昇腾 NPU、鲲鹏服务器的部署链路。随着大模型快速普及,大量基于 PyTorch 训练的 LLM、多模态模型需要迁移至 MindSpore 生态进行
MindSpeed 大模型预训练融合优化,通过算子融合、计算通信重叠、内存压缩、多并行协同四大核心技术,构建了昇腾硬件专属的高性能训练体系。它将原本分散的算子执行、通信操作、内存管理进行深度融合,从内核到框架层消除性能瓶颈,实现训练吞吐与显存利用率的双重突破。
昇思ONNX转换工具(onnx2ms)支持PyTorch/TensorFlow大模型一键转为昇思MindSpore格式,无缝迁移至昇腾芯片,实现国产化高性能推理。工具内置算子映射、图优化与精度校准,转换后精度损失<0.5%,推理性能提升30%+,全面支持Transformer、BERT、LLaMA等主流大模型结构,兼容动态输入、量化部署与端边云协同,助力AI模型高效国产化落地。
昇思MindSpore RAG技术通过文档切片、向量化编码、向量检索与重排序四大核心操作,构建轻量高效、国产化、低幻觉的检索增强生成体系。依托昇腾NPU加速,实现万级知识库检索耗时低于20ms,幻觉率降低60%。全流程代码可运行,无第三方依赖,显著提升行业知识问答准确率,是大模型落地应用的关键方案。
MindConverter是昇思MindSpore官方推出的TensorFlow到MindSpore跨框架转换工具,支持TensorFlow 1.x/2.x模型(PB/SavedModel)一键迁移至昇腾AI生态。通过全图解析、算子自动映射(覆盖200+算子)、权重精准对齐及昇腾NPU优化,实现结构等价、精度无损,性能提升20%-40%。适用于CV/NLP大模型快速迁移,提供完整转换流程与代码实践
<think>我们根据要求生成摘要,字数限制150字以内。需要概括核心价值、架构、部署、代码实现、优化优势和应用场景。精简内容。注意摘要需简洁,不超过150字。</think>昇思RAG检索器基于昇腾NPU与MindSpore生态,融合MxRAG与MindFAISS,实现文档预处理、向量检索、重排序及大模型对接,解决知识滞后与幻觉问题。全链路NPU加速,混合检索提升召回,支
<think>我们需要理解任务:根据给定的内容,生成不超过150字的文章摘要。内容是关于昇思MindSpore Transformers (Mcore) 和昇腾NPU集群的月级别预训练,涉及大模型如Llama 3-70B等。摘要需要概括核心内容,控制字数。 首先,内容结构:月级别预训练是核心阶段,耗时1-3个月,决定模型能力。需要解决三大难题。然后描述了三阶段策略和核心技术。最后是价值
<think>我们根据要求生成≤150字的文章摘要。摘要需涵盖核心内容:Blended Megatron DataLoader的主要特点、原理、性能优势等。语言简洁。</think>Blended Megatron DataLoader 是面向千亿级 LLM 预训练的高效多源数据加载方案,采用三级分层架构与二进制索引存储,支持多数据集权重混合和分布式并行加载,显著提升 IO
说加速卡是"完整嵌入式系统",不是夸张。算力核心(AI 算力芯片)——相当于 CPU;存储(HBM 模组)——相当于内存;输入输出(主机 PCIe 接口)——相当于外设总线;供电(高精度供电模块)——相当于电源;散热(液冷/风冷模块)——相当于散热器;电路板(PCB 基板)——相当于主板;芯片间通信(卡间互联接口)——相当于内部总线。一块加速卡,本质上是一台被压缩到一张板子上的、专职做 AI 计算
MindSpeed 是华为昇腾生态面向大模型预训练的全链路加速套件,核心包含 MindSpeed-LLM(大语言模型训练)、MindSpeed-MM(多模态训练)、MindSpeed-Core(底层加速库),深度适配昇腾 NPU,通过并行优化、内存管理、算子加速、通信优化四大核心能力,将预训练吞吐量提升 30%-50%,内存占用降低 30% 以上,是百亿至万亿级模型训练的核心工具。
训练:Loss 收敛速度、最终精度(Accuracy/F1)、梯度无 NaN/Inf、权重更新稳定;推理:与 GPU 基线误差 < 1e-3、Top-1 精度损失 < 0.5%、无明显精度漂移。昇腾 NPU 精度调优的核心是 **“分层精度控制 + 动态溢出防护 + 确定性计算”:通过 O2 混合精度平衡性能与精度,保护敏感层为 FP32,用动态 Loss Scale 和梯度裁剪解决溢出,固定随机
你可能会想:CPU 里也有乘法单元,为什么训练芯片要专门排一个二维阵列?答案在并行度和数据复用。同一个数据可以被反复使用。算 A×B 时,A 的每一行要和 B 的每一列相乘,一个数据会被用到几十次、几百次。二维阵列的妙处,就是让数据"横向流、纵向流":权重从一侧流入,激活值从另一侧流入,每个交叉点上的计算单元同时做乘加。这样,几千个单元可以同时工作,而不是像 CPU 那样一个接一个地算。这里的关键
上图展示有点问题,实际一个Node的Level1里是一个交换芯片的7个虚拟平面,不是7个交换芯片。UB交换芯片Level1使用量0.392*2/2*8*2=6.272 Tb/s, Level2 交换芯片使用量0.056/2*8*48=10.752Tb/s,芯片性能对标博通TH3.B300出1.8TB双向带宽,Nvswitch单芯片容量28.8Tb,整机57.6Tb(性能对标博通TH5),交换芯片容
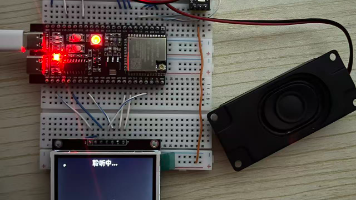
本文记录了从Arduino转向ESP-IDF开发ESP32-S3 N16R8的全过程,重点解决硬件适配问题。通过浏览器烧录小智AI固件后,因TFT屏幕引脚不兼容转向VS Code+ESP-IDF开发环境搭建。
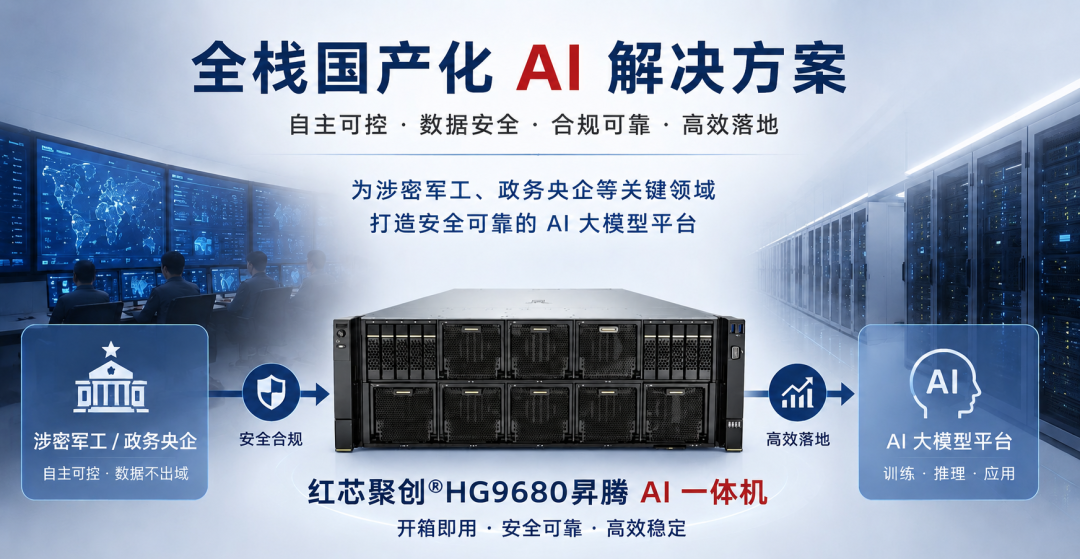
# HG9680 4U AI服务器:8卡昇腾910架构拆解与选型分析 8颗昇腾910 NPU、2.2 PFLOPS FP16算力、256GB HBM片上内存、8×200GE RoCE网络——这些参数
昇腾NPU精度调优指南:基于达芬奇架构的FP32/FP16/BF16/INT8多精度计算优化 摘要:本文针对昇腾NPU(910/310系列)在深度学习训练和推理中的精度问题,系统解析了达芬奇架构下的多精度计算特性(FP32/FP16/BF16/INT8)及误差来源,包括硬件浮点特性差异、算子实现偏差和混合精度策略缺陷。提出了五大调优方法:1)O2级自动混合精度+动态Loss Scale训练策略;2