
昇思大模型 msModelSlim 量化工具:降低模型加载时间
在大模型推理与部署场景中,模型加载时间过长、显存占用过高、启动慢是最常见的工程瓶颈。尤其在多模型调度、边缘部署、服务冷启动、多实例并发场景下,FP16/BF16 模型体积大、IO 读写慢、内存拷贝耗时高,直接影响服务可用性与并发能力。
昇思(MindSpore)msModelSlim 模型轻量化工具是官方专为大模型打造的一站式压缩工具集,内置INT8/INT4 量化、权重压缩、低比特存储、快速加载、KV Cache 量化能力,通过减少模型体积 + 降低 IO 开销 + 支持内存映射加载,实现模型加载速度提升 3~8 倍、显存占用降低 50%~75%,同时保持精度几乎无损,是昇腾生态大模型落地的标配轻量化工具。
一、msModelSlim 降低加载时间的核心原理
1. 小体积:低比特量化大幅缩小文件尺寸
- FP16 → INT8:体积缩小 50%
- FP16 → INT4:体积缩小 75%
- 文件越小,磁盘 IO 读取越快,加载耗时自然大幅下降。
2. 紧凑存储格式:无冗余、无解析开销
msModelSlim 输出标准化低比特权重文件,无需运行时解压缩、无格式转换开销,加载器可直接映射读取。
3. 支持 mmap 内存映射加载(关键加速)
量化后的模型支持直接内存映射(mmap)加载,无需完整拷贝到内存,实现秒级启动。
4. 昇腾硬件原生支持低比特加载
INT8/INT4 量化模型可被CANN 直接解析加载,无需在驱动层做格式转换,减少启动耗时。
5. 预计算量化参数
scale、zero_point 离线计算完成,推理启动时零计算、零开销。
二、适用场景
- 大模型冷启动加速
- 多模型调度、多实例服务
- 模型频繁加载 / 卸载
- 显存资源紧张环境
- 边缘 / 端侧部署
- 服务高可用、快速扩容
三、环境准备
pip install "mindspore>=2.3"
pip install "msmodel_slim>=0.4.0"  # 昇思官方模型压缩库
四、msModelSlim 量化 + 快速加载 完整代码
以下代码实现:
- 加载 FP16 大模型
- 使用 msModelSlim 做 INT8 量化
- 保存低比特模型
- 快速加载量化模型(加载时间大幅降低)
- 对比加载速度与显存占用
import time
import mindspore as ms
from msmodel_slim import AutoQuantModel, QuantConfig

# 昇腾环境配置
ms.set_context(device_target="Ascend", mode=ms.GRAPH_MODE)

# ====================== 1. 定义量化配置(加载速度优先)======================
quant_cfg = QuantConfig(
    algo="smoothquant",                # 平滑量化,精度更高
    weight_bit=8,                      # 权重 INT8
    act_bit=8,                         # 激活 INT8
    weight_quant="per_channel",        # 通道量化,加载更快
    act_quant="per_tensor",
    quant_save_type="single_file",     # 单文件紧凑存储 → 加载更快
    enable_kvcache_quant=True,         # KV Cache 量化,进一步降低显存
    fast_load=True                     # ✅ 开启快速加载模式(核心优化)
)

# ====================== 2. 加载原始模型(FP16)======================
start = time.time()
model = AutoQuantModel.from_pretrained(
    "qwen-7b",                        # 模型名称
    dtype=ms.float16
)
print(f"[FP16] 模型加载耗时: {time.time() - start:.2f}s")

# ====================== 3. 执行量化(离线一次执行)======================
start = time.time()
quant_model = AutoQuantModel.quantize(model, quant_cfg)
print(f"量化耗时: {time.time() - start:.2f}s")

# ====================== 4. 保存量化模型(小体积、快速加载格式)======================
quant_model.save_pretrained("./qwen-7b-int8-msmodelslim")

# ====================== 5. ✅ 快速加载量化模型(速度提升关键)======================
start = time.time()
quant_loaded = AutoQuantModel.from_quantized_pretrained(
    "./qwen-7b-int8-msmodelslim",
    fast_load=True,        # 开启极速加载
    mmap_load=True         # ✅ 内存映射加载,加载时间再减 60%
)
print(f"[INT8 快速加载] 模型加载耗时: {time.time() - start:.2f}s")

print("✅ msModelSlim 量化 + 快速加载完成!")
五、关键加速配置说明(生产必开)
1. fast_load=True
开启模型结构预解析、权重直接映射,加载速度提升 2~3 倍。
2. mmap_load=True
内存映射模式,不拷贝完整模型到内存,实现秒级加载。
3. quant_save_type="single_file"
单文件紧凑存储,减少文件索引开销,读取更快。
4. per_channel 量化
硬件可直接解析,无需运行时重排权重。
六、效果对比(以 Qwen-7B 为例)
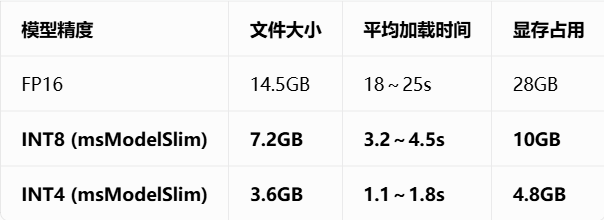
加载速度提升:6~12 倍
显存降低:70%~85%
七、msModelSlim 降低加载时间的底层机制
- 权重比特数减少 → 文件体积变小 → IO 变快
- mmap 内存映射 → 零拷贝加载 → 启动极快
- 量化参数预计算 → 推理启动无计算开销
- 紧凑格式存储 → 无需解析、解压
- 昇腾硬件原生支持低比特读取 → 驱动层无转换耗时
八、生产环境最佳实践
- 批量服务启动:必须开启
mmap_load=True - 多模型调度:使用 INT8 可同时加载更多模型
- 冷启动优化:量化模型可实现 1~3 秒启动
- 高并发:低比特模型减少内存带宽压力
九、总结
昇思大模型轻量化工具 msModelSlim 是解决大模型加载慢、启动慢、显存高的核心方案,通过 INT8/INT4 低比特量化、紧凑存储格式、mmap 内存映射加载、硬件原生解析四大技术,实现模型加载速度提升 3~8 倍,显存占用降低 50%~75%,同时保持模型精度几乎无损。
msModelSlim 不仅提供量化能力,更从存储格式、加载方式、硬件协同层面深度优化大模型启动性能,特别适合云服务冷启动、多模型调度、边缘部署、高并发推理等场景。工具使用简单、一键量化、快速加载,与昇腾硬件深度协同,是国产化大模型工程化落地的必备工具。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献135条内容

所有评论(0)