
AtomGit华为云码道CodeArts上鸿蒙仿京东商城的完整生成过程逐帧拆解,附新手手写与 AI 生成项目在需求澄清、工程结构与验收环节的对比
一键开通华为云码道 CodeArts 代码智能体:https://developer.huaweicloud.com/codeartsco.html?source=dmzntgwatomgit1&sourcead=dmzntgwatomgithd
摘要| 我们最初的需求很小:做一个能跑起来的轻量游戏功能。但"能跑起来"这四个字放在鸿蒙工程里一点都不轻——Stage 模型、
module.json5的资源引用、hvigor 构建脚本、oh-package 依赖清单、ArkTS 声明式 UI,缺一个环节工程就打不开。为了看清楚 AI 编程智能体到底做了哪些事,我把一次完整的鸿蒙应用生成过程全部截图留档:从需求澄清、环境自检、子代理调度,到 43 个文件、2481 行 ArkTS 的工程落地,再到 git 初始化与远程仓库推送。本文按时间顺序还原这条链路,并与新手从零手写的做法逐项对比,文中附环境检测结果表、交付物统计表、操作链路流程图和九项能力对照表。
一、先说说这次要做的"小东西"
关键词| HarmonyOS · ArkTS · ArkUI Stage 模型 · AtomGit · 华为云码道 · AI 编程智能体 · 需求澄清 · 子代理调度
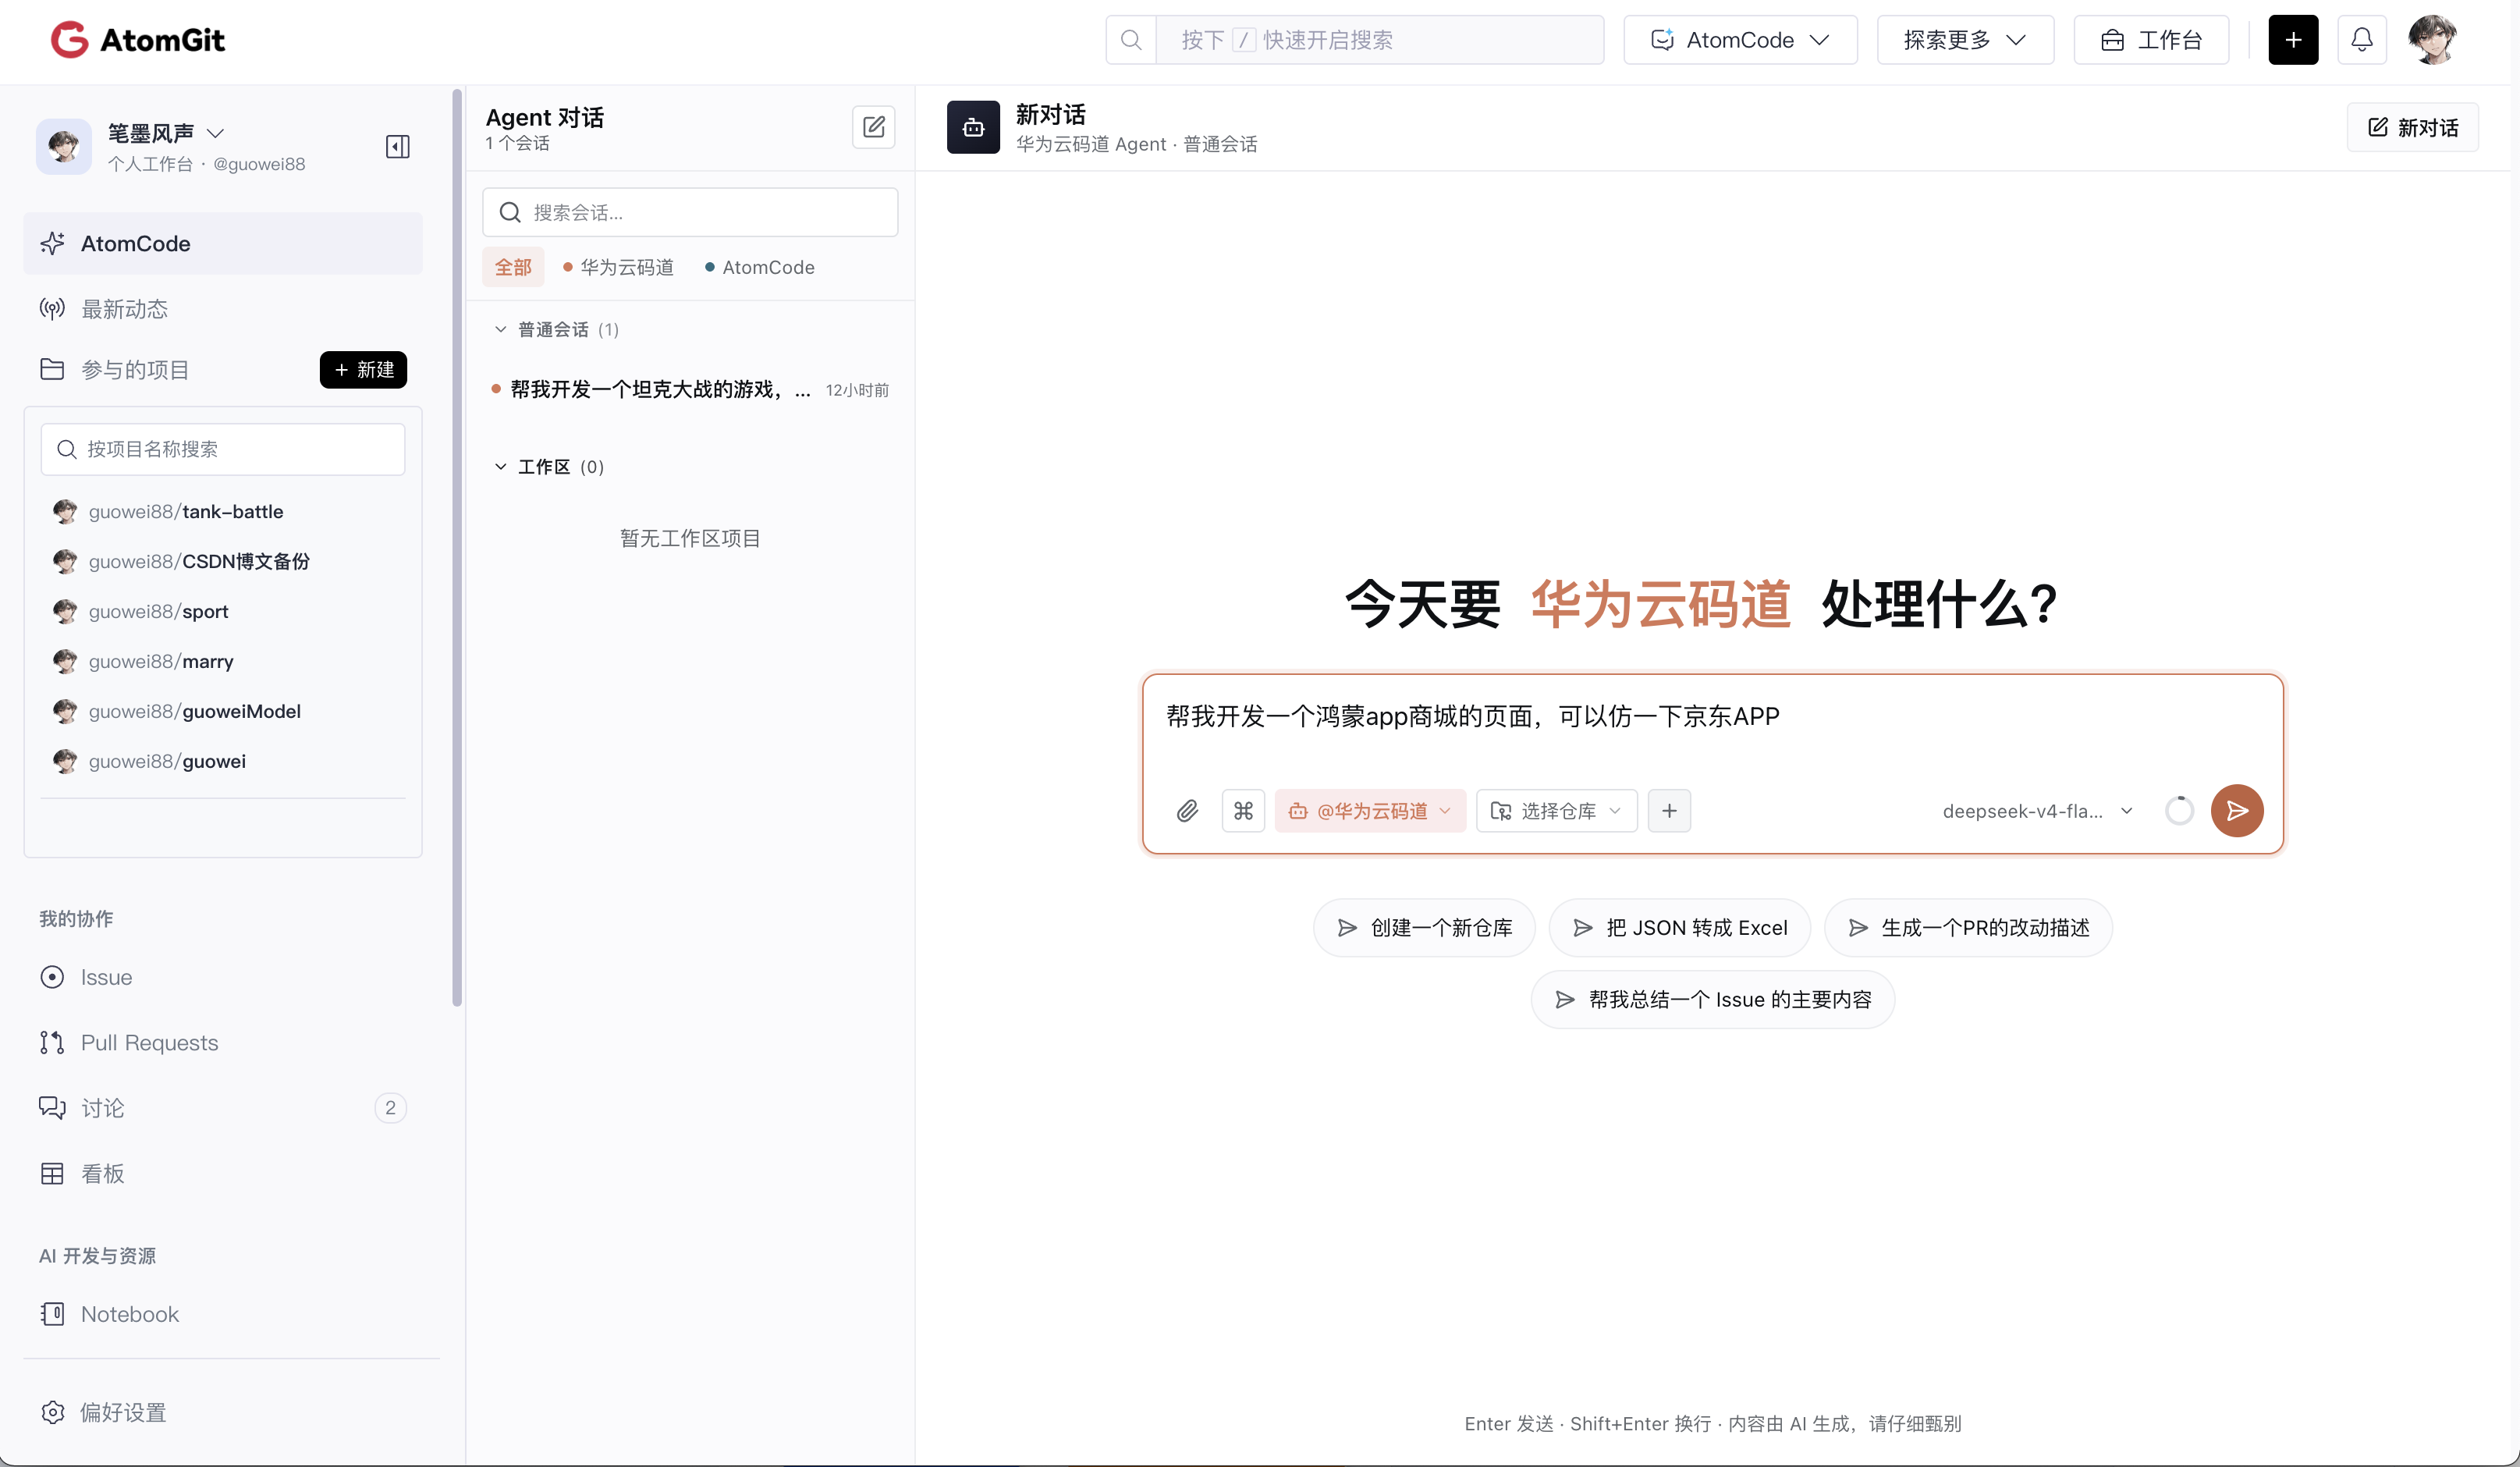
背景很朴素:我们需要一个能跑起来的简单游戏功能。截图左侧的会话列表里就躺着那句原始需求——“帮我开发一个坦克大战的游戏”。这类需求的典型特征是:功能边界清楚、体量不大、但要真正跑起来,得有一套完整的工程外壳撑着。
写游戏和写商城,在鸿蒙这套体系里遇到的"拦路虎"是同一批。ArkTS 的页面得挂在 pages 清单里,应用图标得能从 $media:icon 解析到实体文件,模块的 module.json5 得声明清楚 ability 和入口,构建脚本 hvigorfile.ts 与 oh-package.json5 一个都不能少。新手在这里摔的跟头,基本都不是算法问题,而是"配置没对齐、资源找不到、依赖没同步"这类工程性问题。
所以我做了一个更划算的选择:把同一套操作链路,放在一个界面元素更丰富的样本上完整跑一遍,并把每一步都截图留存。这个样本就是图片里那个仿京东商城的鸿蒙应用。下面所有分析都来自这批截图,没有补拍,也没有事后美化——包括中途那次"模型配额不足"的报错。
二、它没有先写代码,而是先开了一场三轮"需求会"
我在 AtomGit 网页端的 Agent 对话里选了 @华为云码道,然后输入了一句话:
帮我开发一个鸿蒙app商城的页面,可以仿一下京东APP
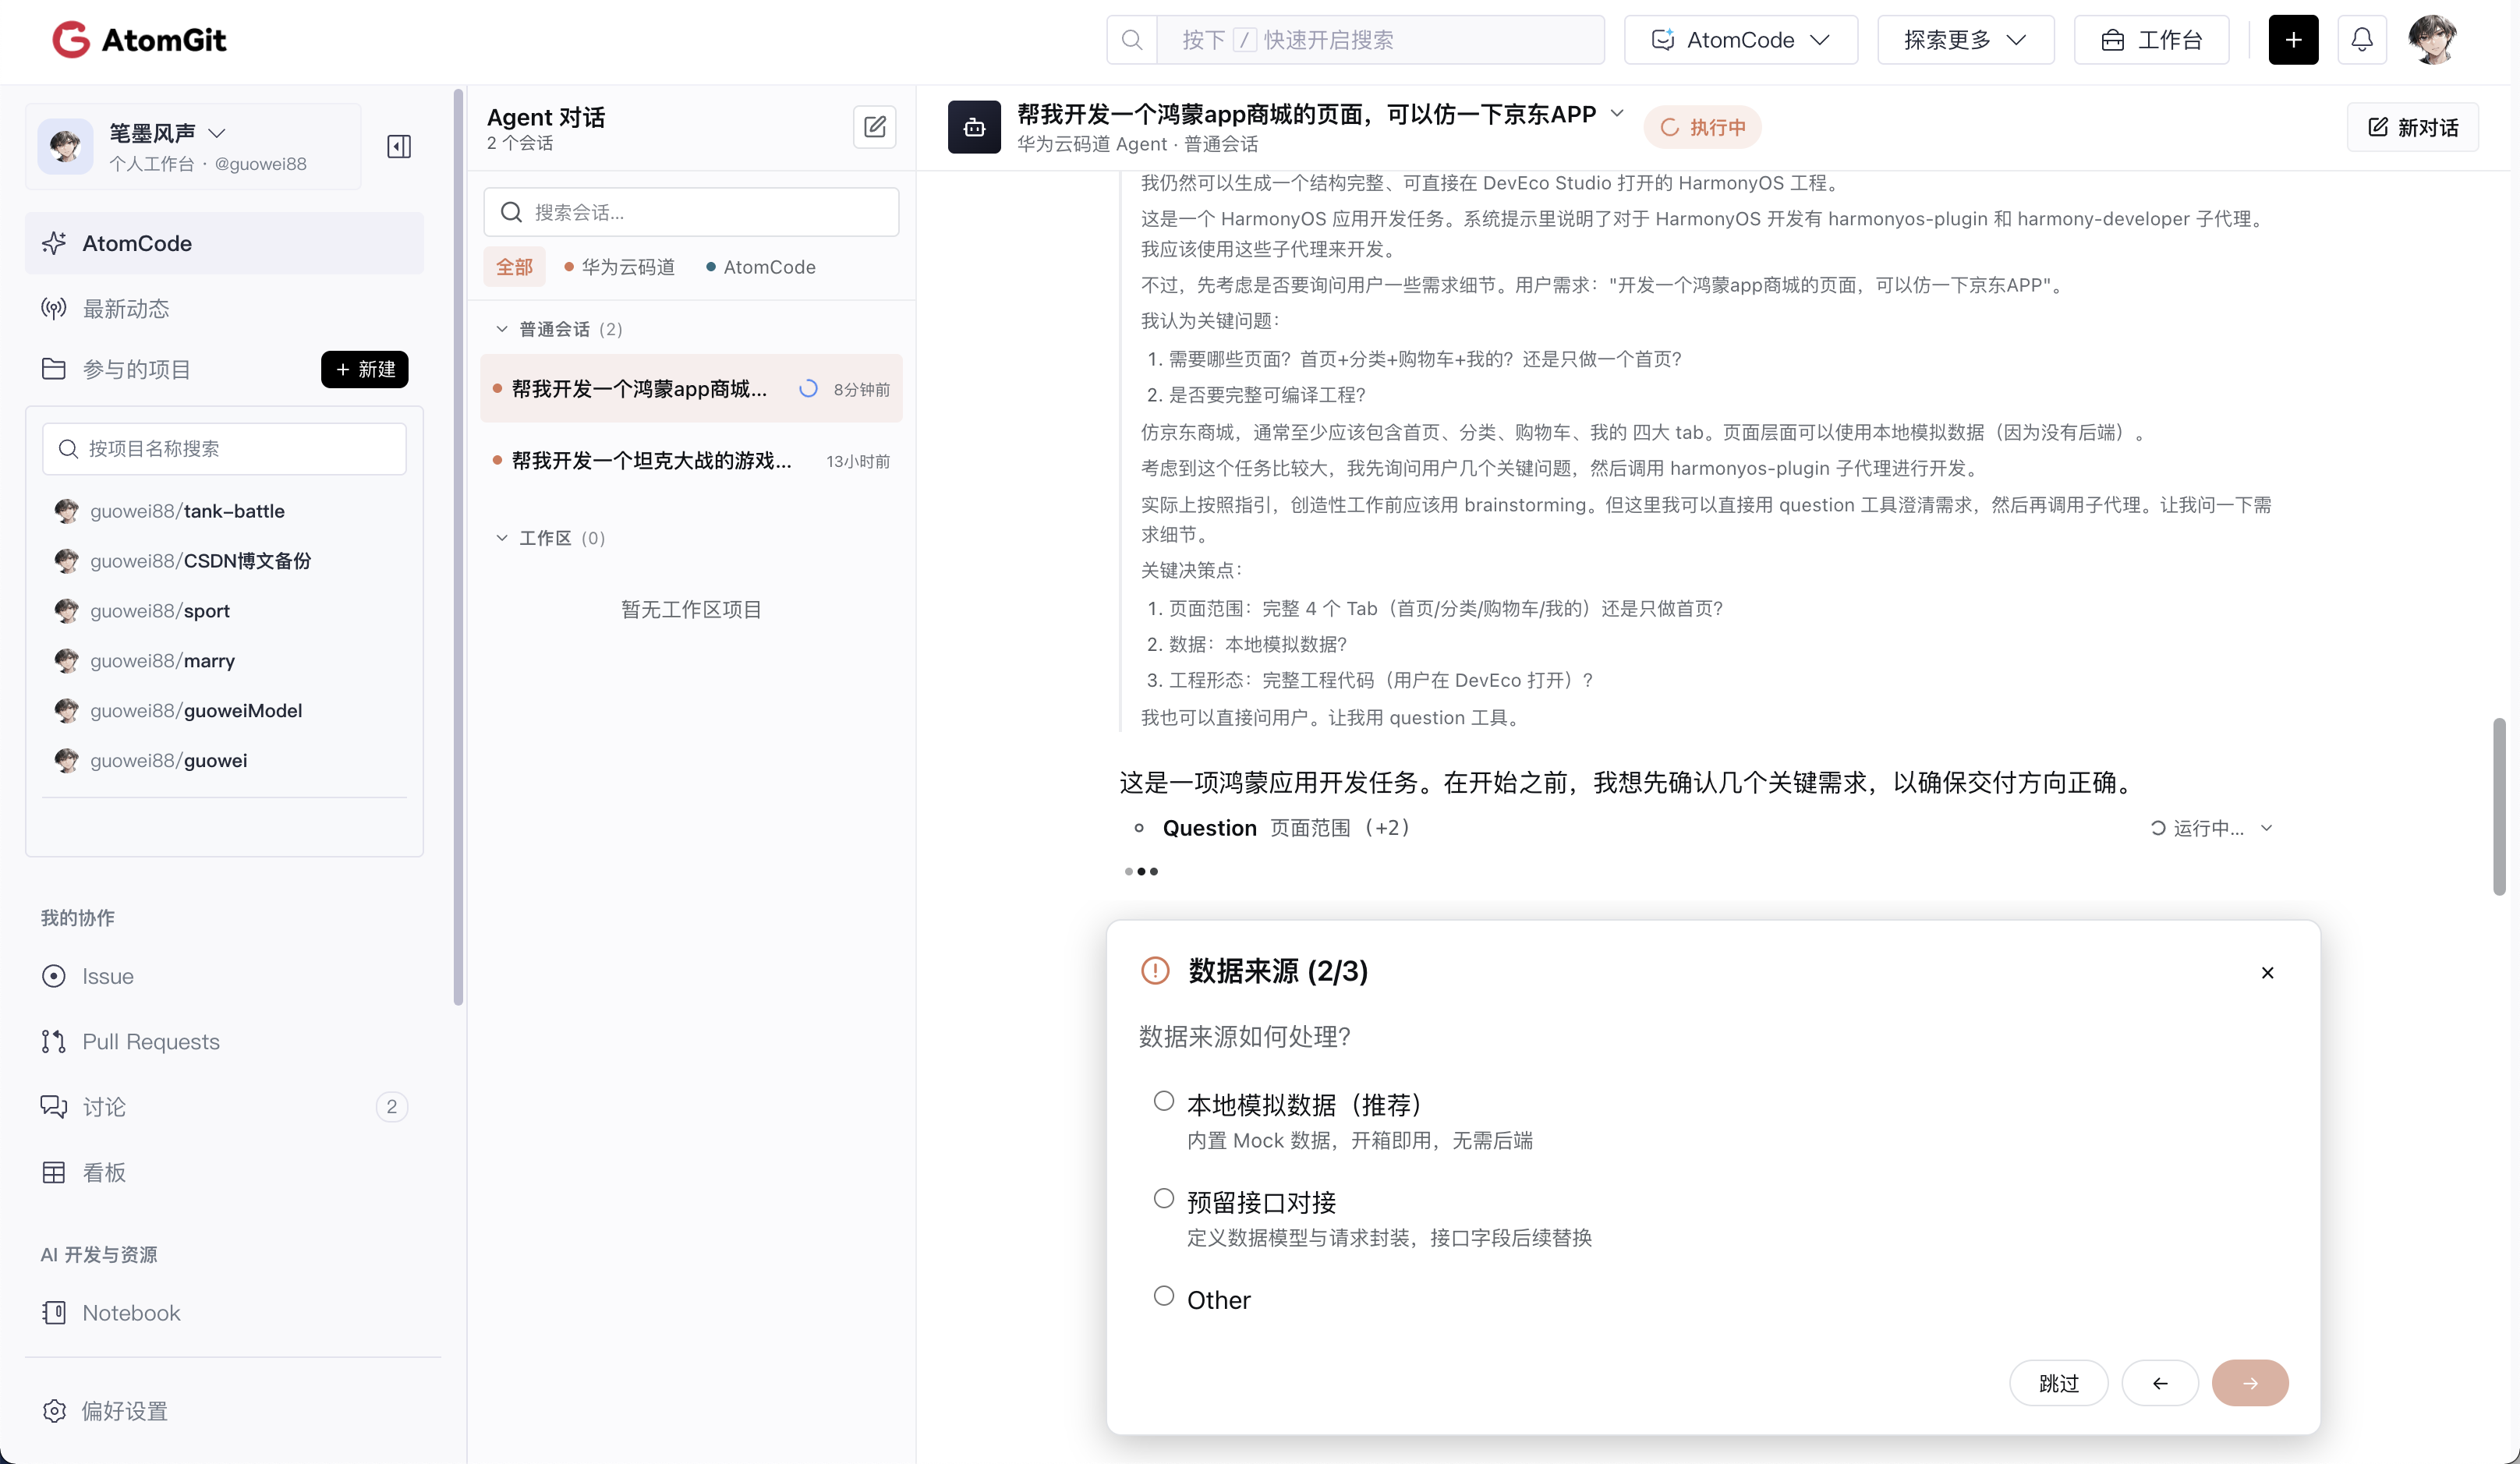
图 1:AtomGit 网页端 Agent 对话界面,左侧会话列表里还留着那句"帮我开发一个坦克大战的游戏"。本轮需求只有一行字。
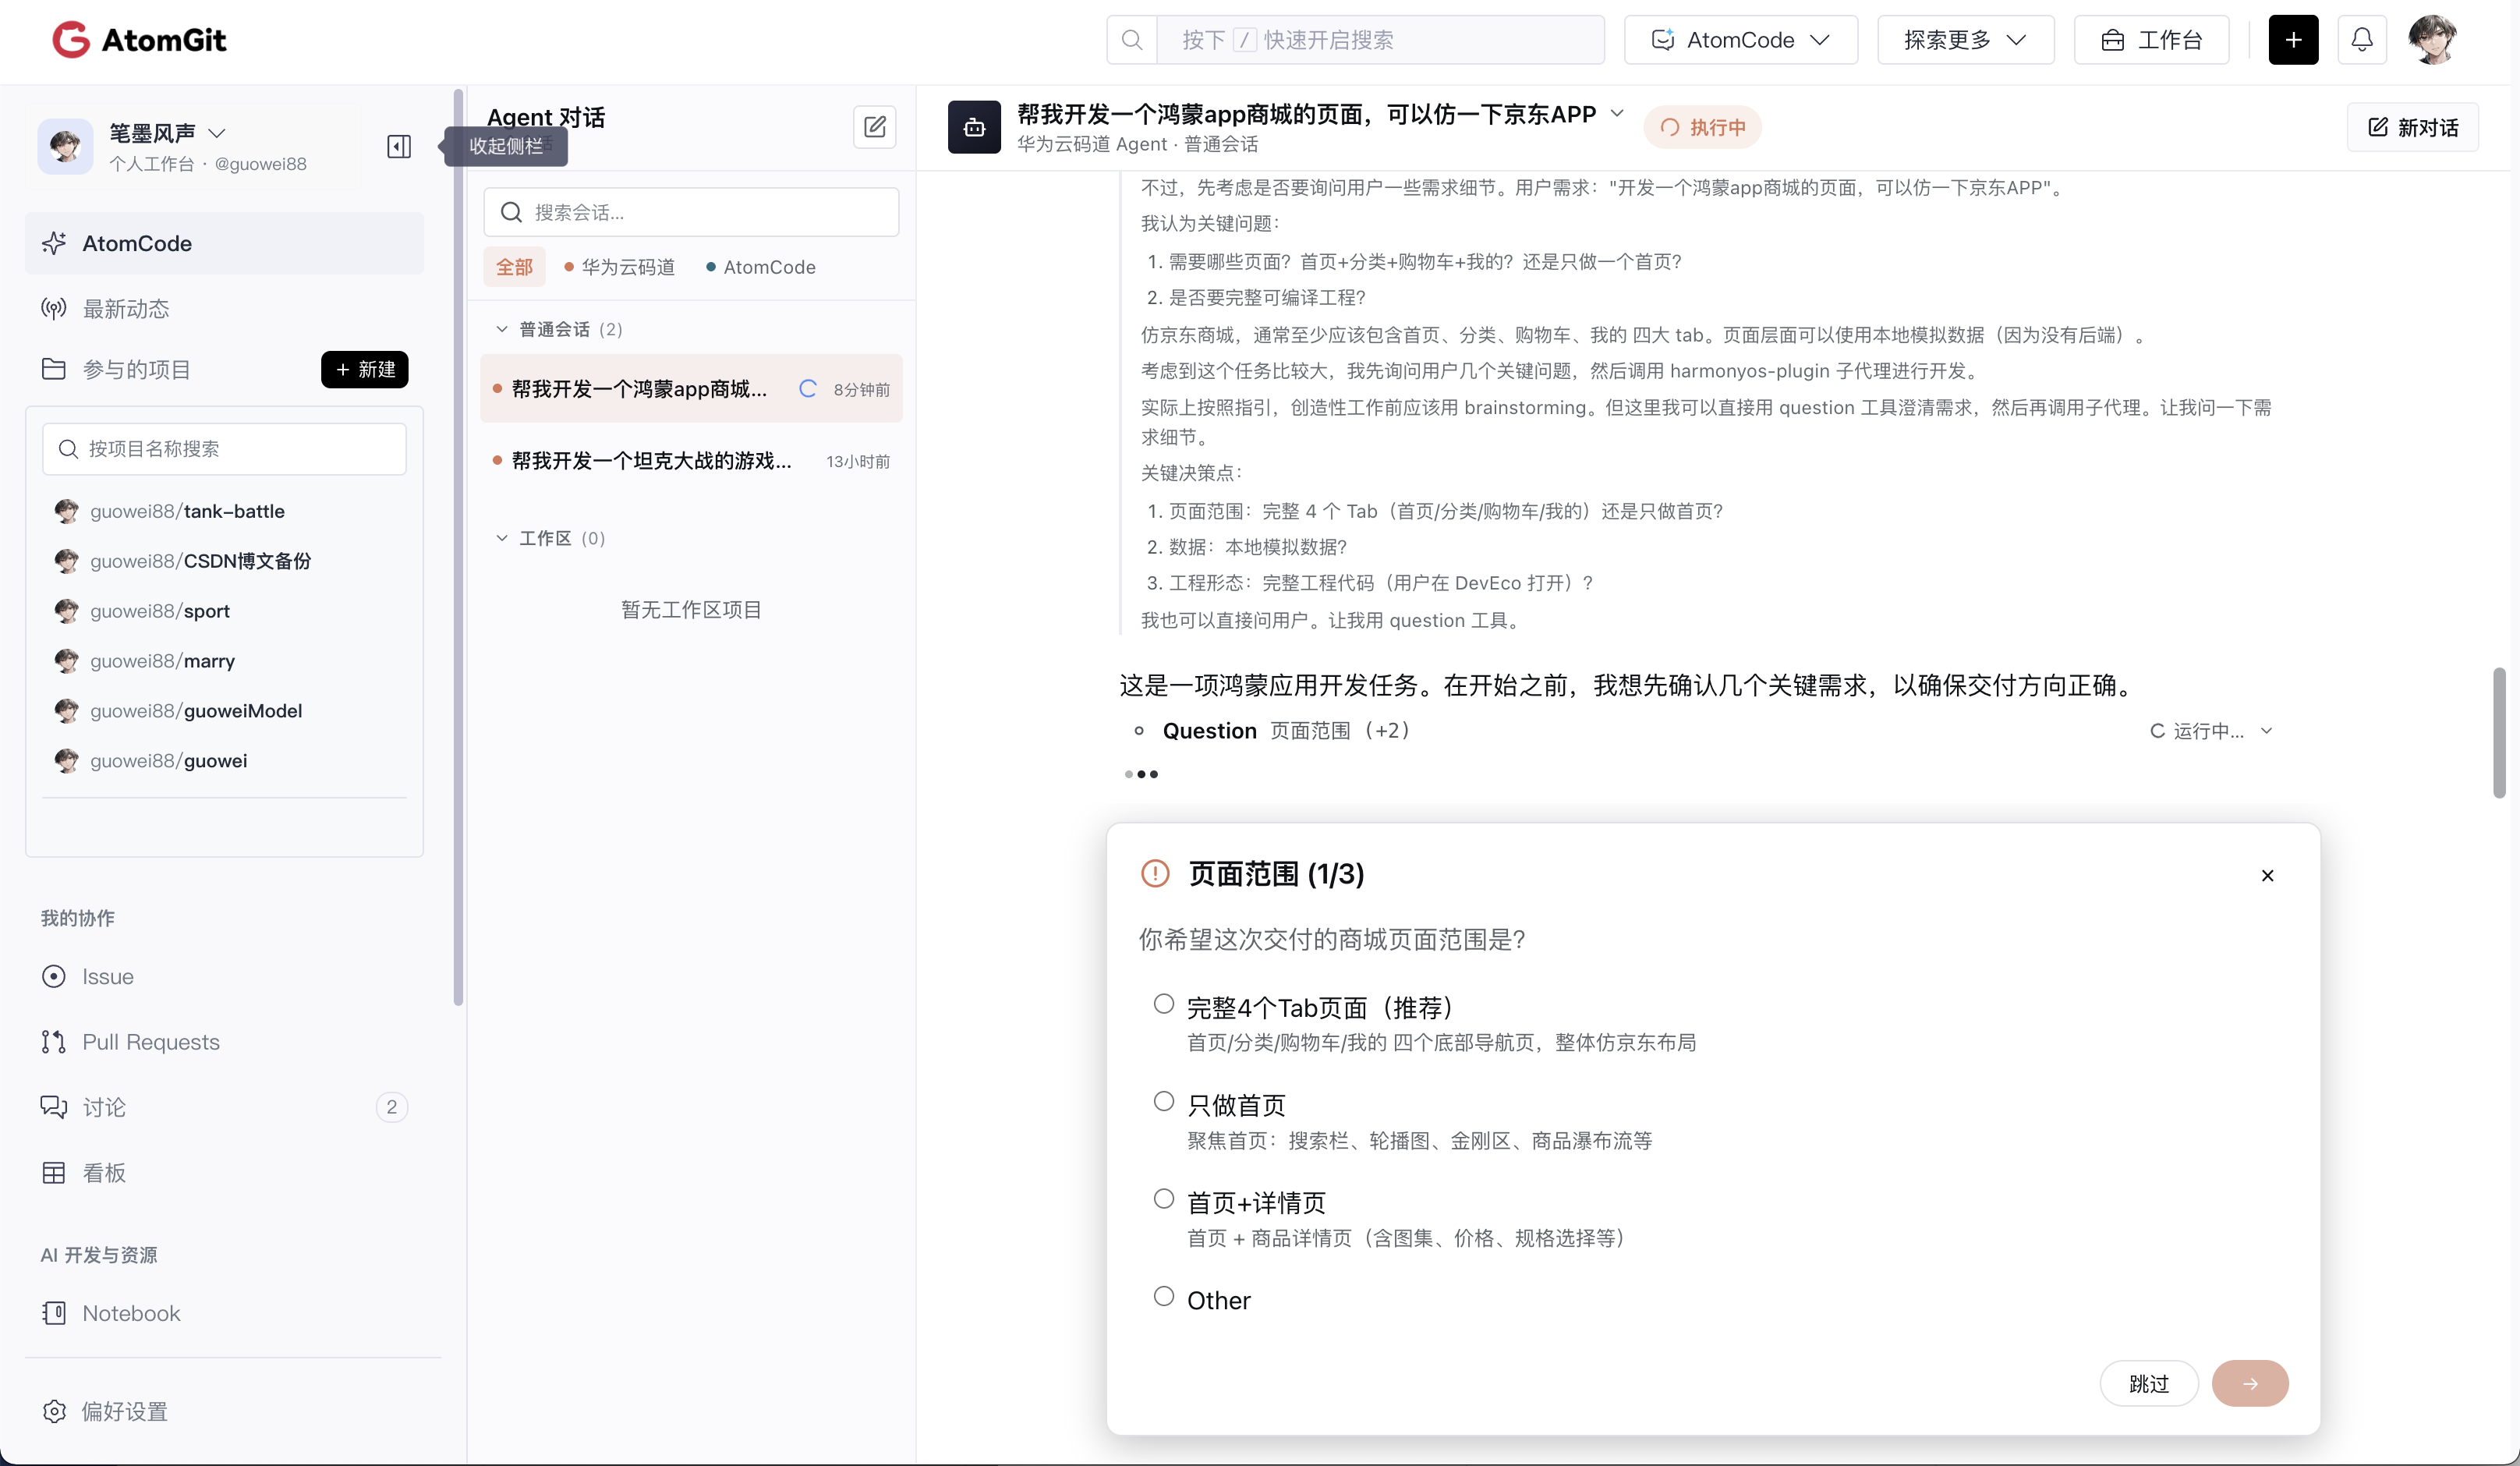
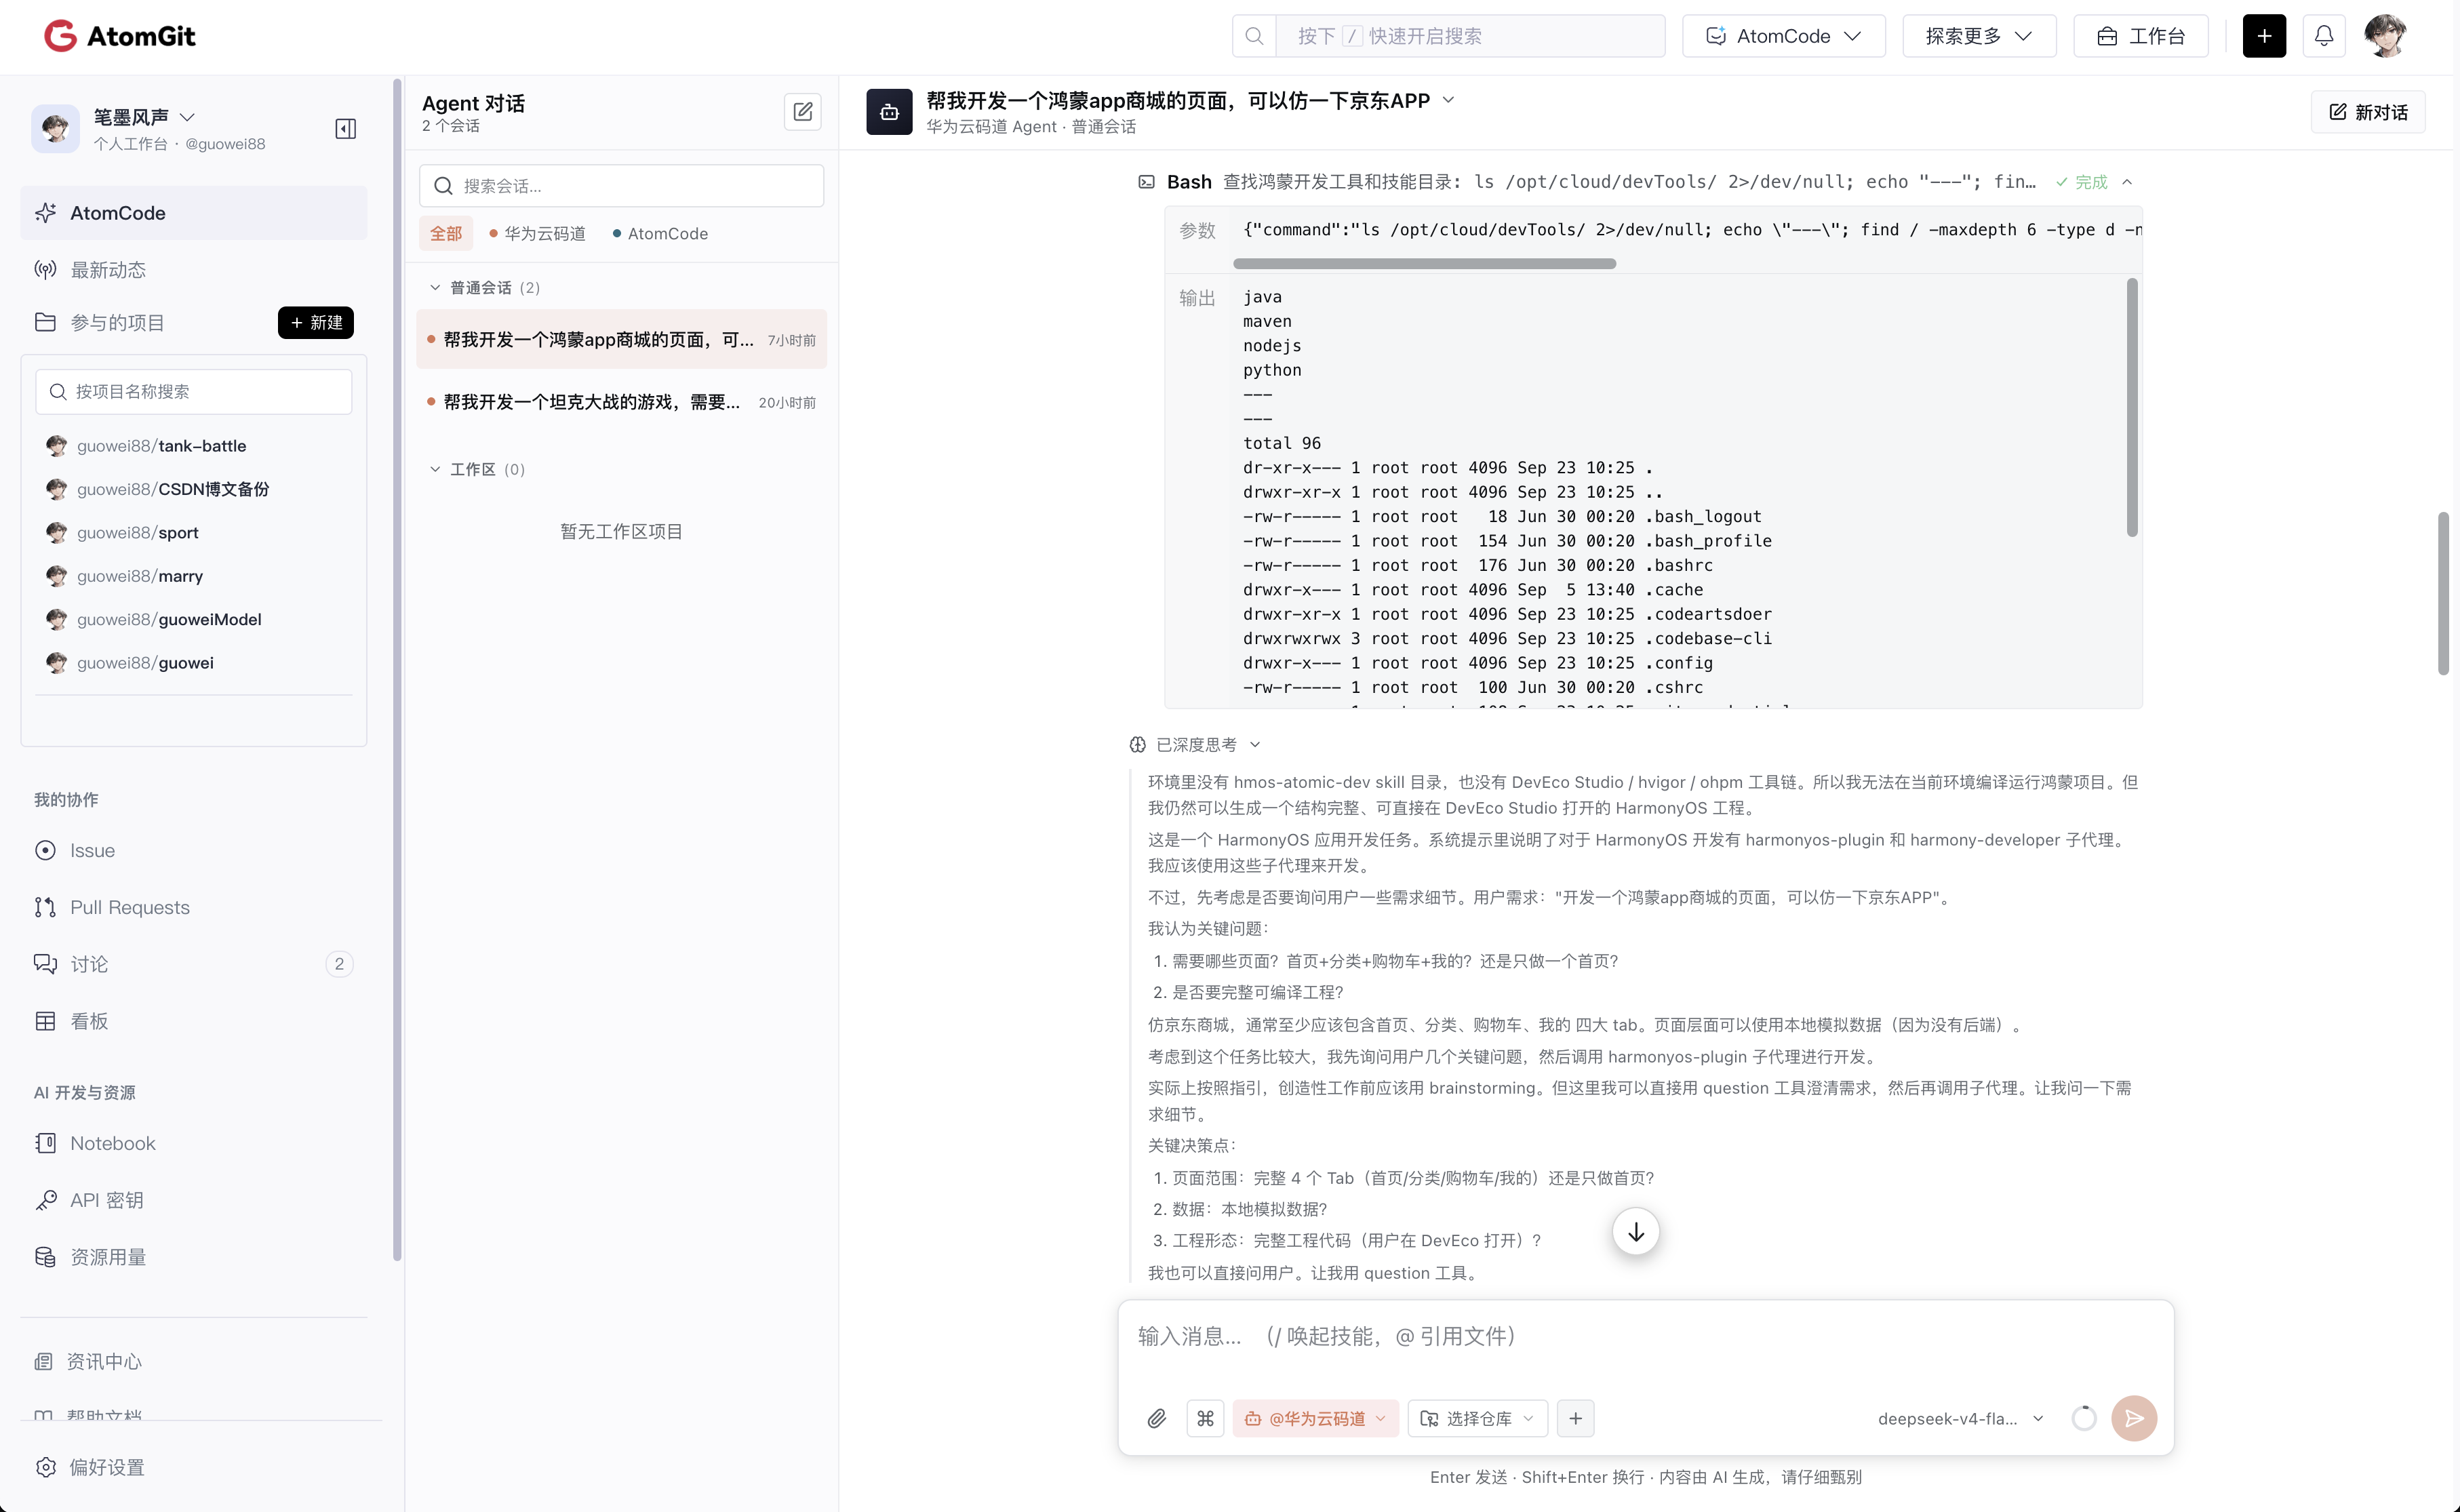
按新手的惯性,接下来应该是"新建工程 → 拖组件 → 报错再说"。但这次发生的事把这个顺序反过来演了一遍:它一个字都没急着写,先连着问了我三个问题。三张截图的选项是逐轮递进的,只有答完上一轮,下一轮才会出现。
| 轮次 | 它问的问题 | 给出的选项 | 我的选择 | 它真正想确定的事 |
|---|---|---|---|---|
| 1/3 | 你希望这次交付的商城页面范围是? | 完整 4 个 Tab 页面(推荐)/只做首页/首页+详情页 | 完整 4 个 Tab | 工作量边界:是"一个页面"还是"一个应用" |
| 2/3 | 数据来源如何处理? | 本地模拟数据(推荐)/预留接口对接 | 本地 Mock 数据 | 能不能开箱即用:是否需要后端与网络 |
| 3/3 | 工程交付形式? | 完整 HarmonyOS 工程(推荐)/仅 Page 代码 | 完整工程 | 交付物是否"可编译":拷贝即用地直接运行 |
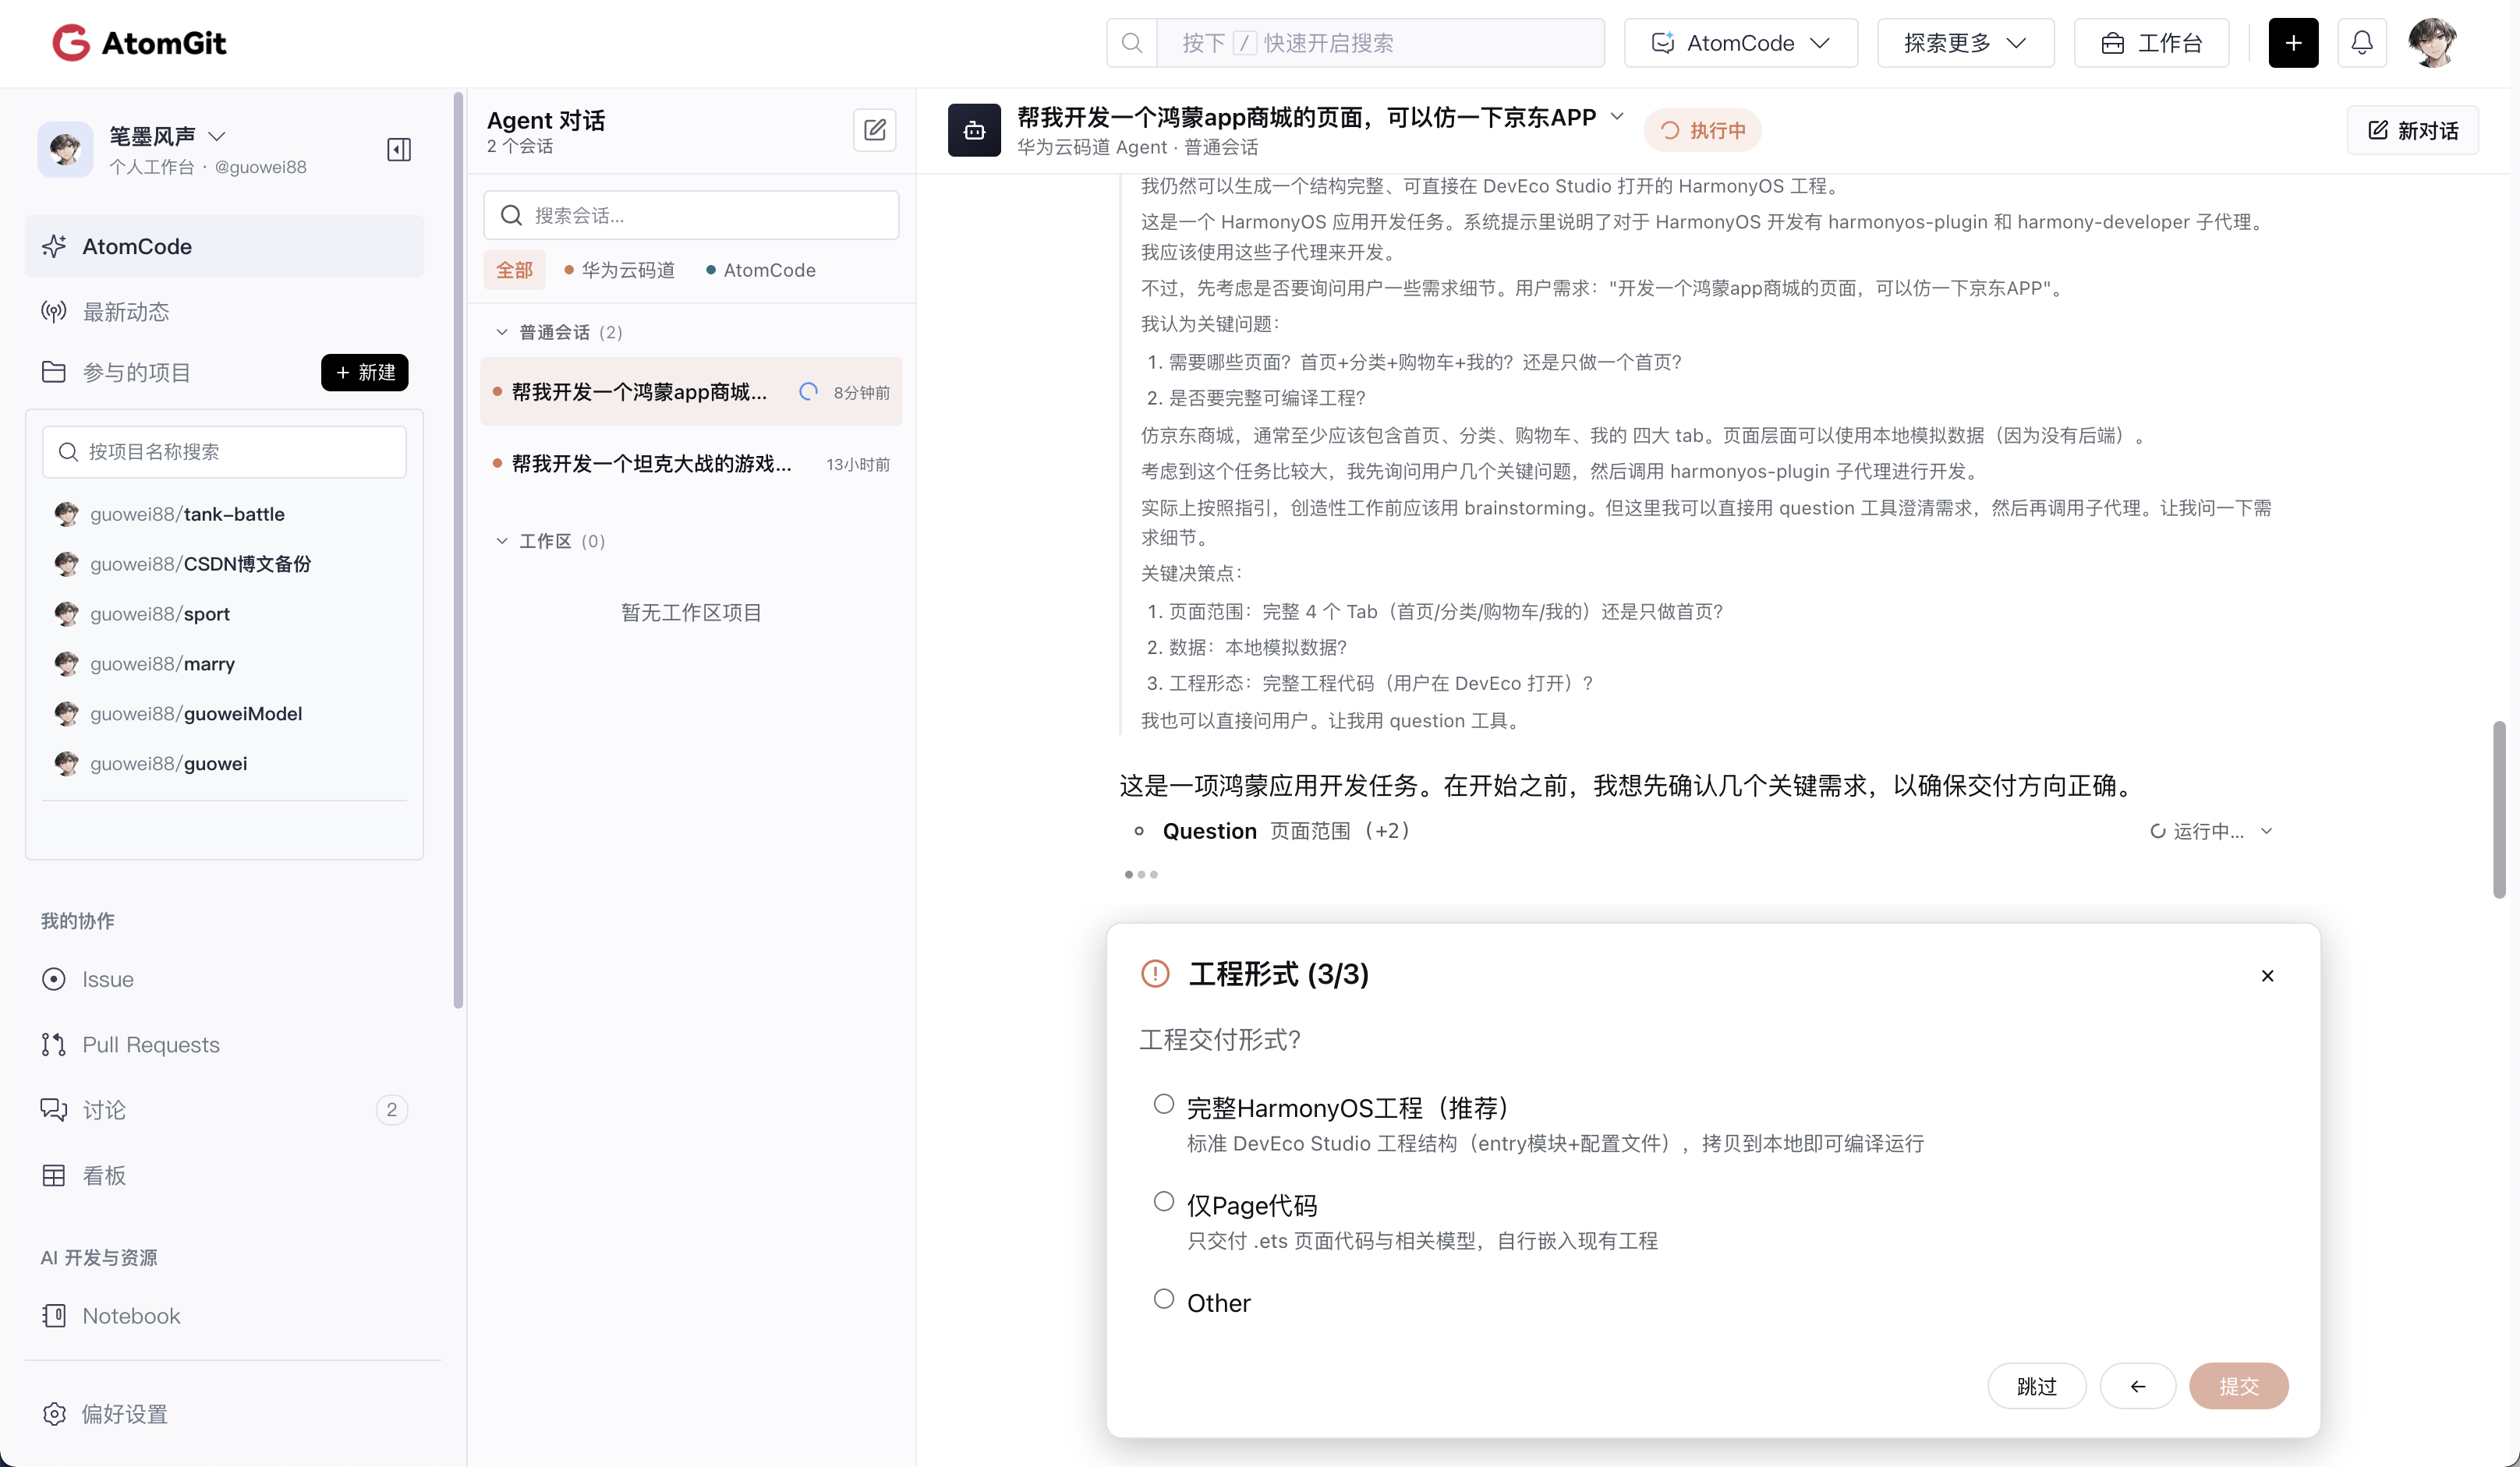
图 2:第一轮提问,页面范围,选项里"完整 4 个 Tab 页面"被标注为推荐。
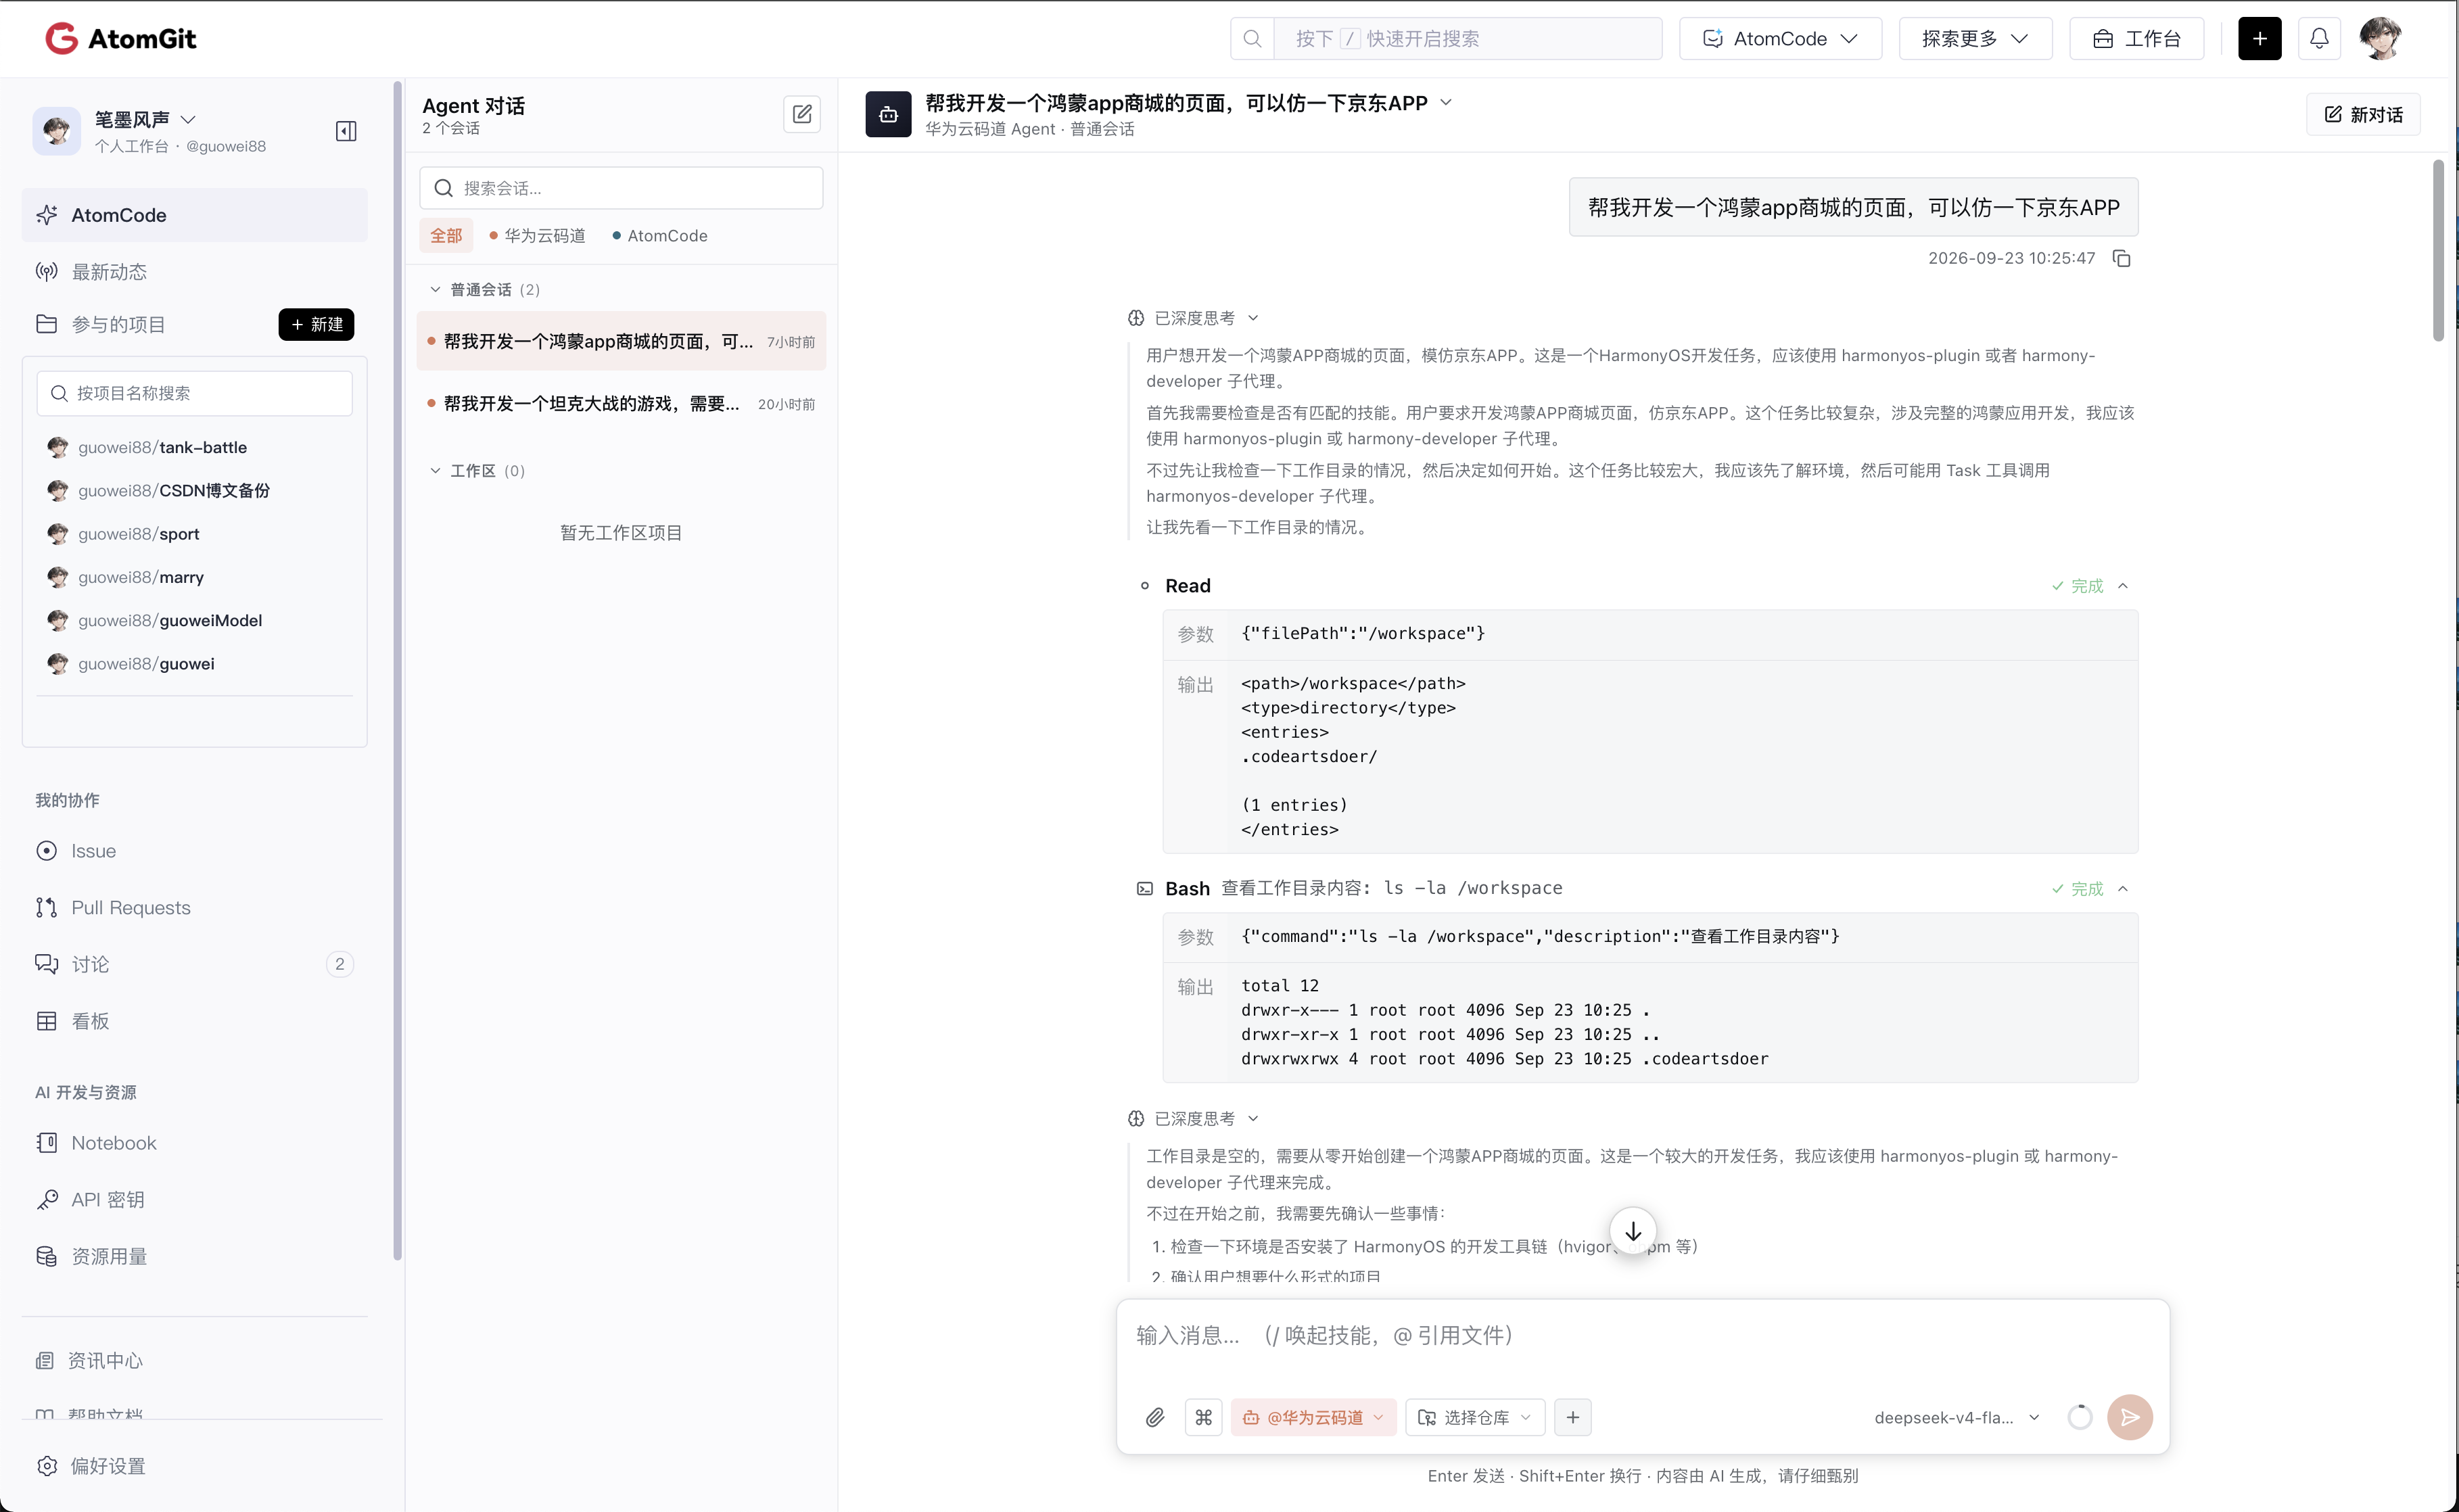
图 3:第二轮提问,数据来源,它明确写出"因为没有后端",所以推荐本地 Mock 数据。
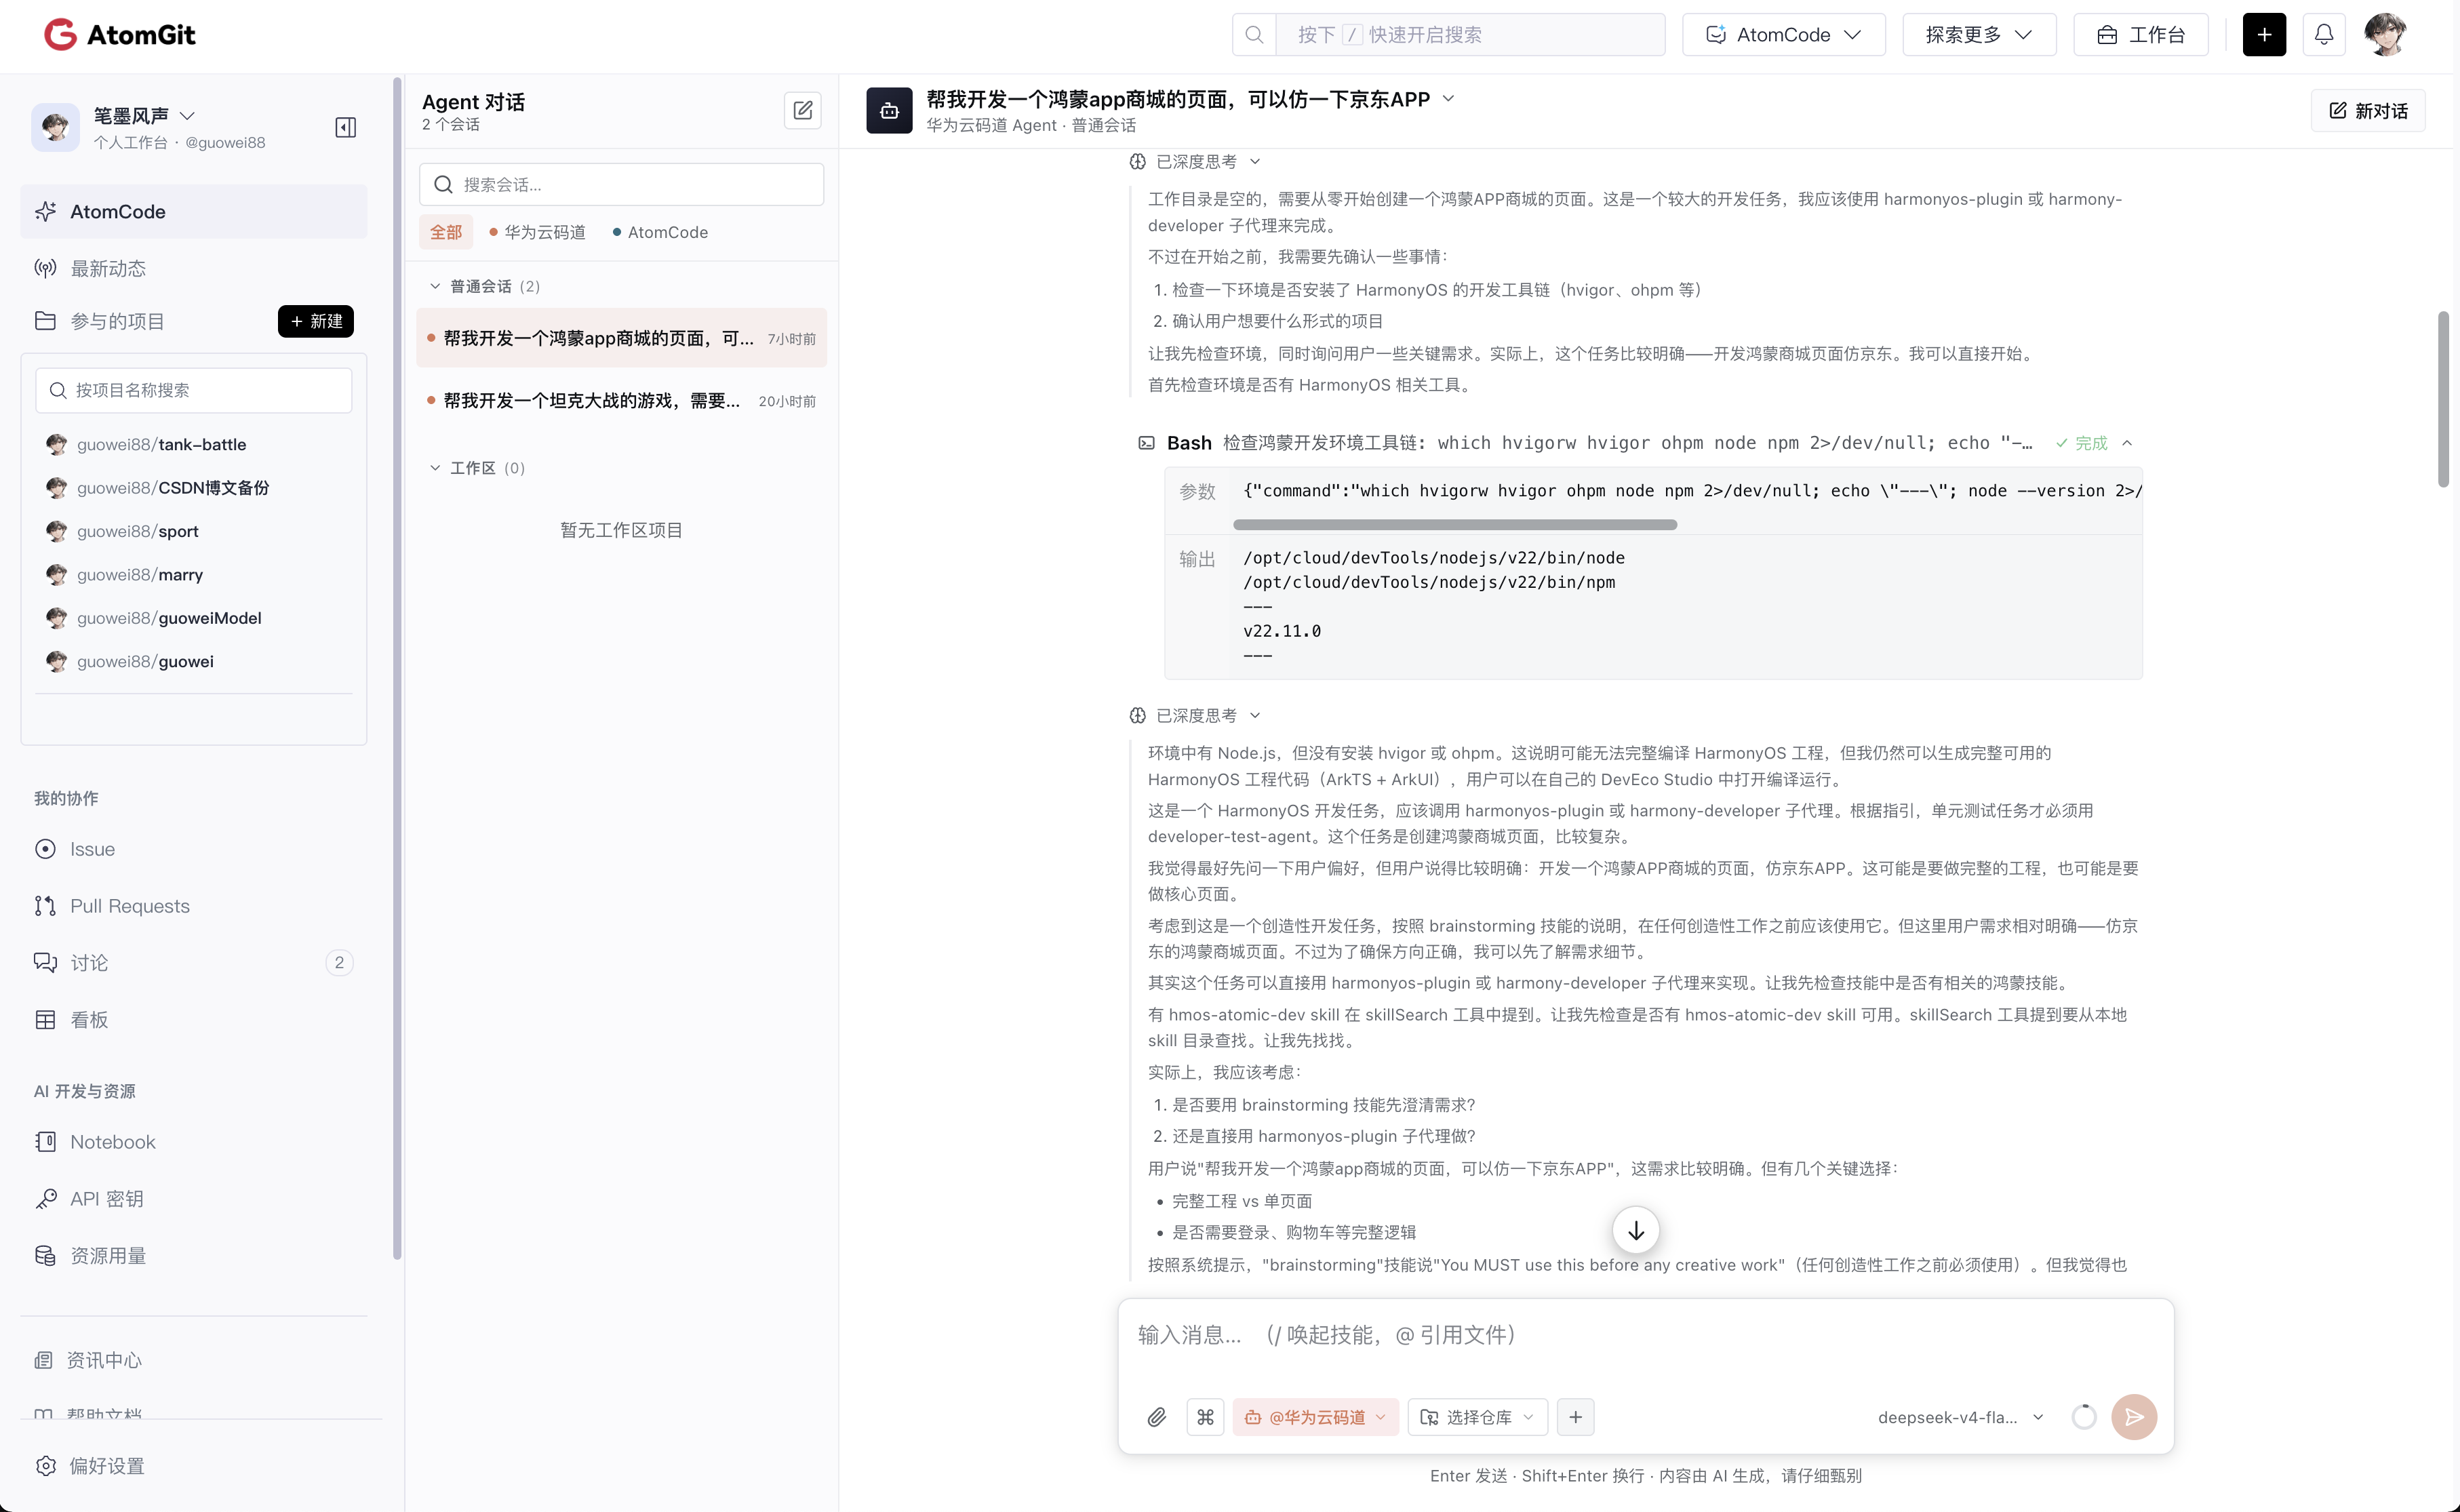
图 4:第三轮提问,工程交付形式,"完整 HarmonyOS 工程"对应的是标准 DevEco Studio 工程结构与 entry 模块。
有意思的是它自己的思考过程。截图里它写得很直白:仿京东商城,通常至少应包含首页、分类、购物车、我的四个 Tab,页面后面可以使用本地模拟数据(因为没有后端),接着又说 考虑到整个任务比较大,我先问用户几个关键问题,然后再调用子代理。也就是说,这三次提问不是走流程,而是它先把任务在心里估了一遍工作量,判断出"这是一项鸿蒙应用开发任务",才决定停下来对齐需求。
这四个技术判断,值得单独拎出来看
- 页面范围决定的是工程骨架,而不是页面数量。 选"完整 4 个 Tab"意味着要建底部导航容器、要做页面路由、要让四个页面共享一份状态;选"只做首页"则只需要一个
Index.ets。这个选择直接决定了后面是生成 8 个文件还是 43 个文件。 - 数据来源决定的是"能不能立刻验证"。 本地 Mock 数据的好处是零外部依赖——不用后端、不用配域名、不用声明网络权限就能跑出效果;而"预留接口对接"虽然更接近生产形态,却会把一次验收拆成"前端调通"和"后端联调"两段。
- 工程形式决定的是交付物形态。 这一条最容易被新手忽略。"仅 Page 代码"听起来轻,但拿回本地后还得自己补到现有工程里,资源、路由、模块声明全要手工对齐;"完整工程"重,但它保证了
Open 目录 → 等 ohpm 同步 → Run这条路径是通的。 - 把澄清放在写码之前,省的是返工的钱。 三个问题问完不到一分钟,但换来的是一条不会再改的技术路线。反过来说,新手常见的"写完首页才发现用户要的是完整应用",损失的时间远不止一分钟。
三、开工前先做环境自检:一个连 hvigor 都没有的沙箱
问答结束,它做的第一件事不是写代码,而是查环境。截图里三条命令依次是:看工作目录、探 Node.js、找鸿蒙工具链。
第一条 ls -la /workspace,输出只有一行 drwxr-xr-x .codeartsdoer——空目录,确认要从零开始搭。
图 5:需求对齐之后并没有立刻写码,它先用 Read 看目录、用 Bash 列目录,两条命令的原始输出都留在对话里。
第二条探到的是 Node.js:node v22.11.0,路径在 /opt/cloud-devTools/nodejs/v22/bin/node。这条结果说明运行时是齐的。
第三条是全链路搜索,它把 hvigor、ohpm 一次性都找了:
which hvigor hvigor ohpm node npm 2>/dev/null; echo "---"; node --version 2>/dev/null
ls /opt/cloud-devTools/2>/dev/null
find / -maxdepth 6 -type d -name "*hvigor*" 2>/dev/null | head -20
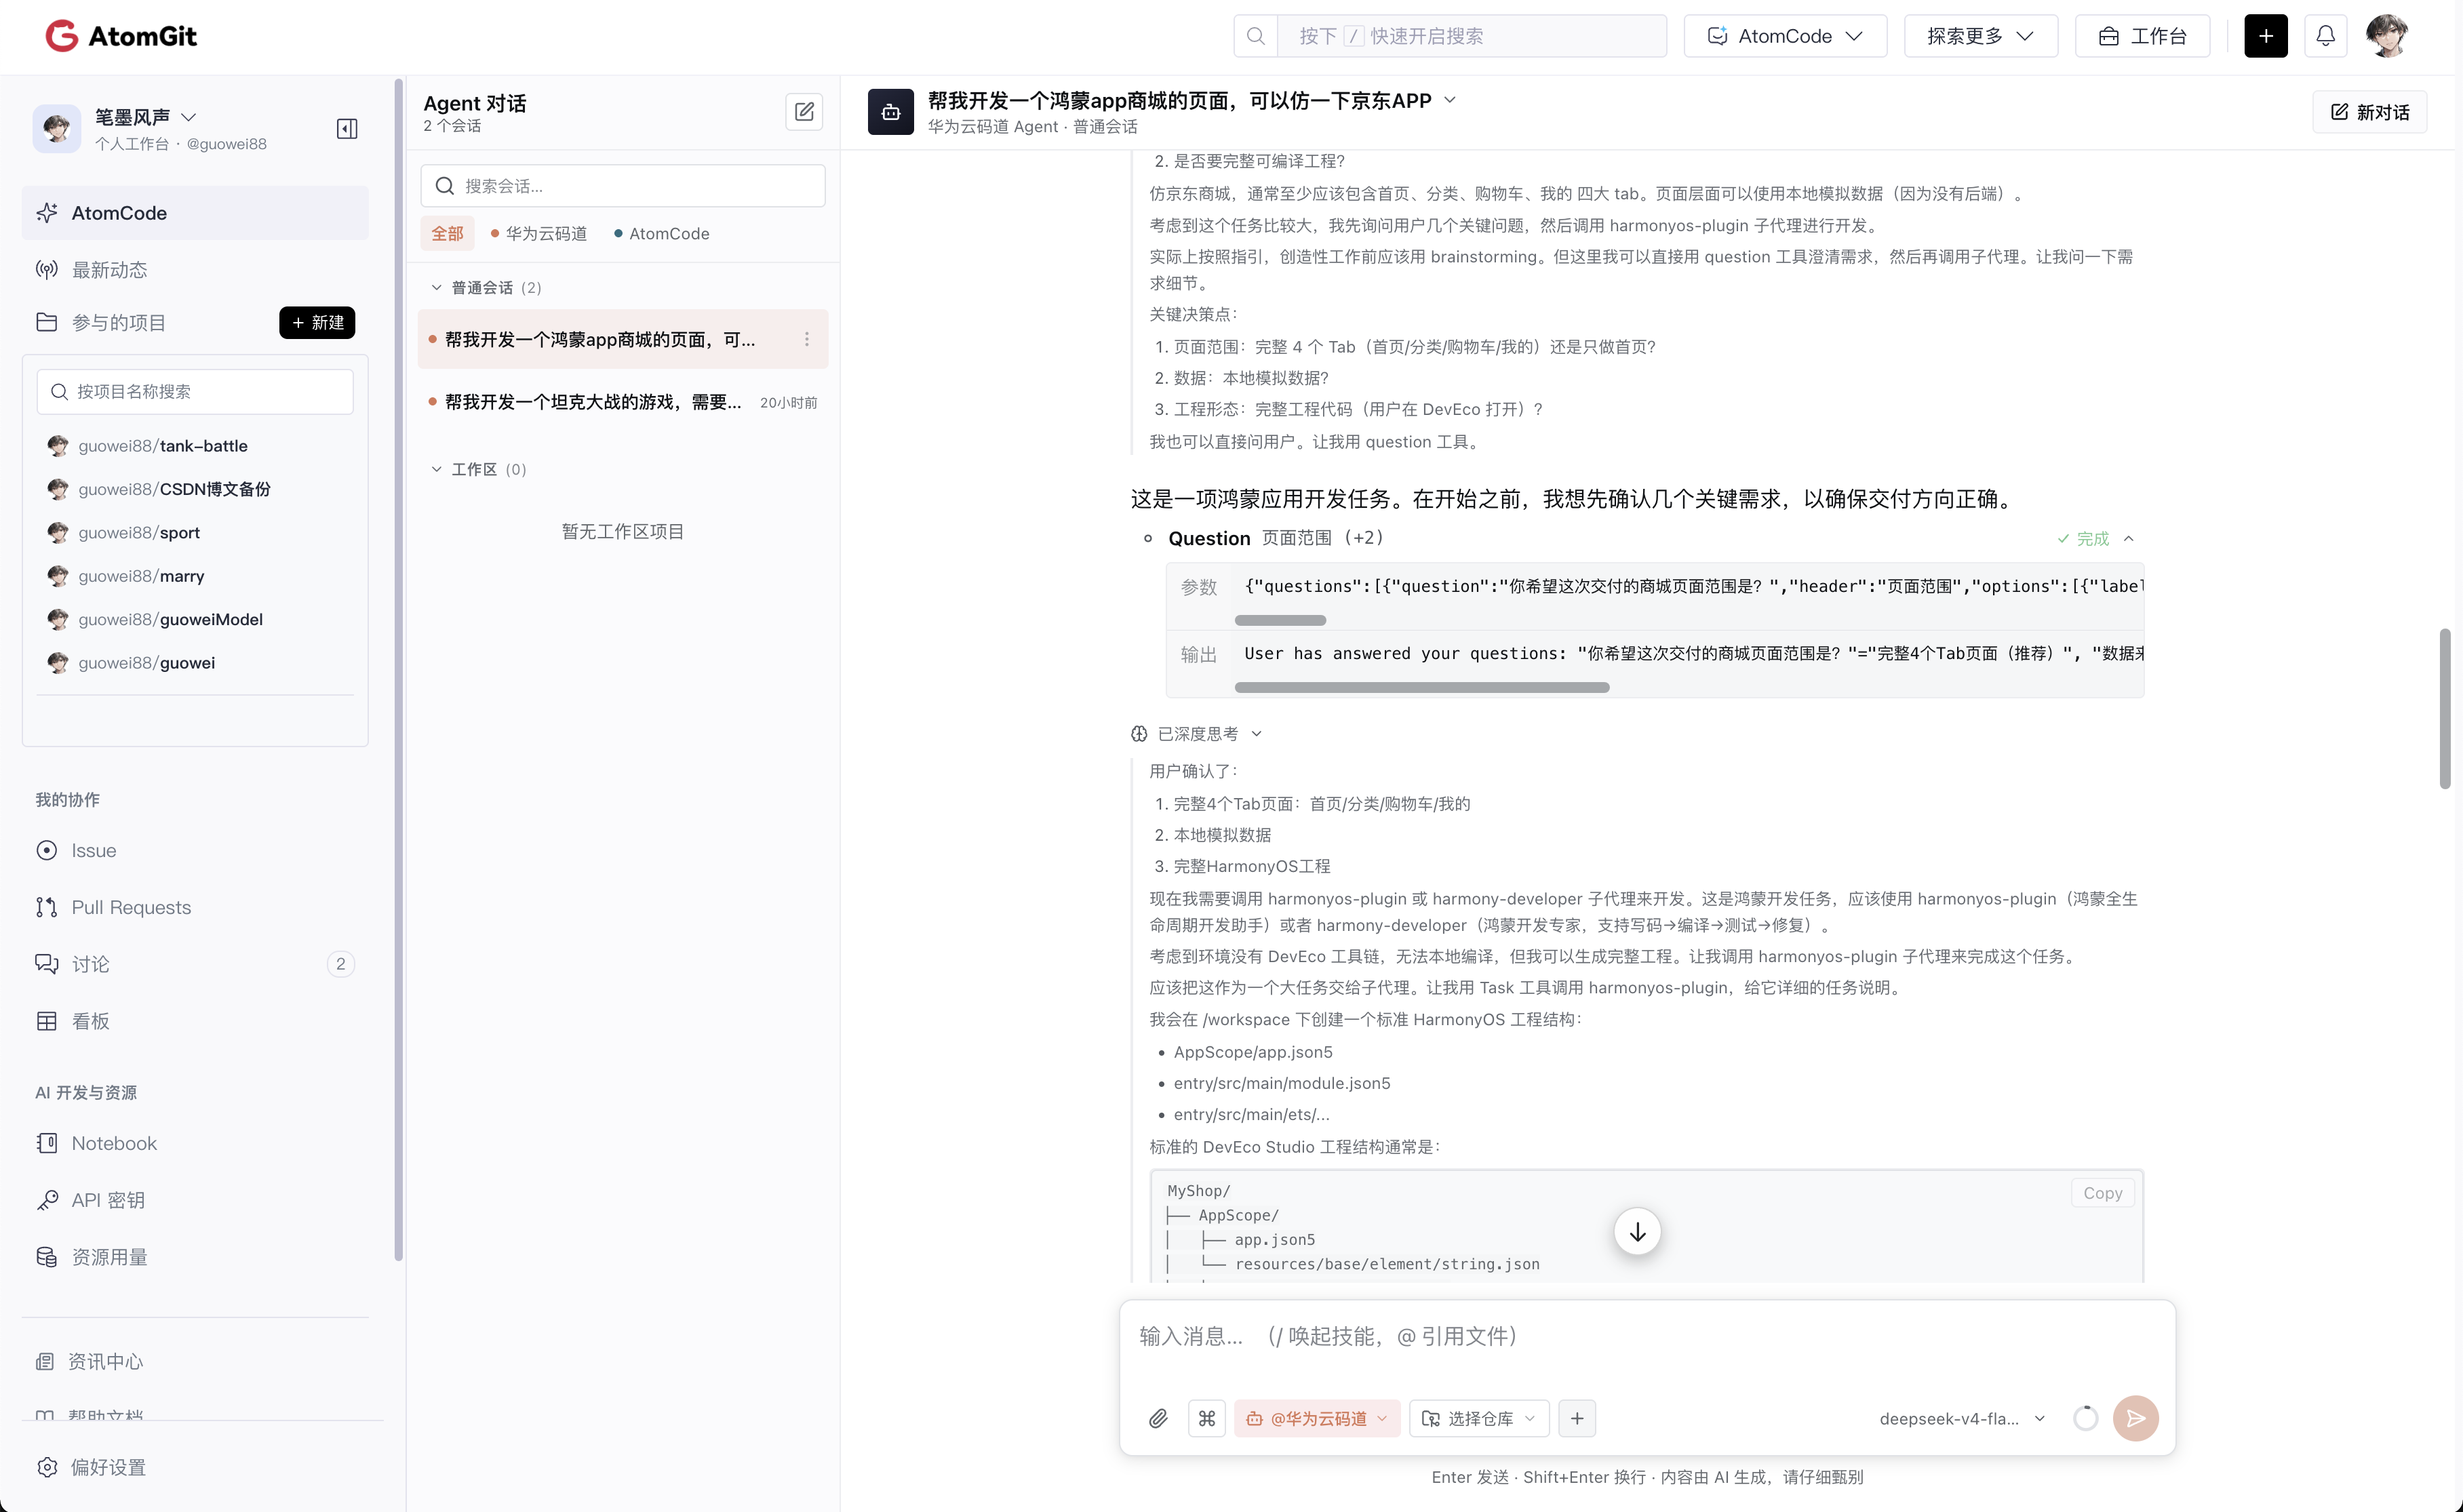
结果是 java / maven / nodejs / python 四个目录,没有鸿蒙 SDK,没有 hvigor,也没有 ohpm。它据此得出的结论写得很克制:环境中没有 Node.js,也没有安装 hvigor 或 ohpm,这时候可能无法完整编译鸿蒙OS 工程,但紧接着补了一句关键判断——可以生成完整可用的 HarmonyOS 工程代码(ArkTS + ArkUI),用户可以在自己的 DevEco Studio 中打开编译运行。
图 6:环境探测的输出,node v22.11.0 可用,但 hvigor 与 ohpm 全线缺失。
图 7:find / -maxdepth 6 -type d -name "*hvigor*" 全盘搜索,只翻出 java、maven、nodejs、python 四个目录,鸿蒙工具链确实不存在。
| 检测项 | 探测命令 | 实际结果 | 对交付的影响 |
|---|---|---|---|
| 工作目录 | ls -la /workspace | 仅 .codeartsdoer/ 一个目录 | 空沙箱,工程需从零搭建 |
| Node.js | node --version | v22.11.0 | 可用,能跑辅助脚本 |
| hvigor 构建器 | which hvigor | 未找到 | 沙箱内无法执行构建 |
| ohpm 依赖管理 | which ohpm | 未找到 | 无法同步三方依赖 |
| 鸿蒙 SDK | ls /opt/cloud-devTools/ | 仅 java/maven/nodejs/python | 无 DevEco 工具链,无法本地编译 |
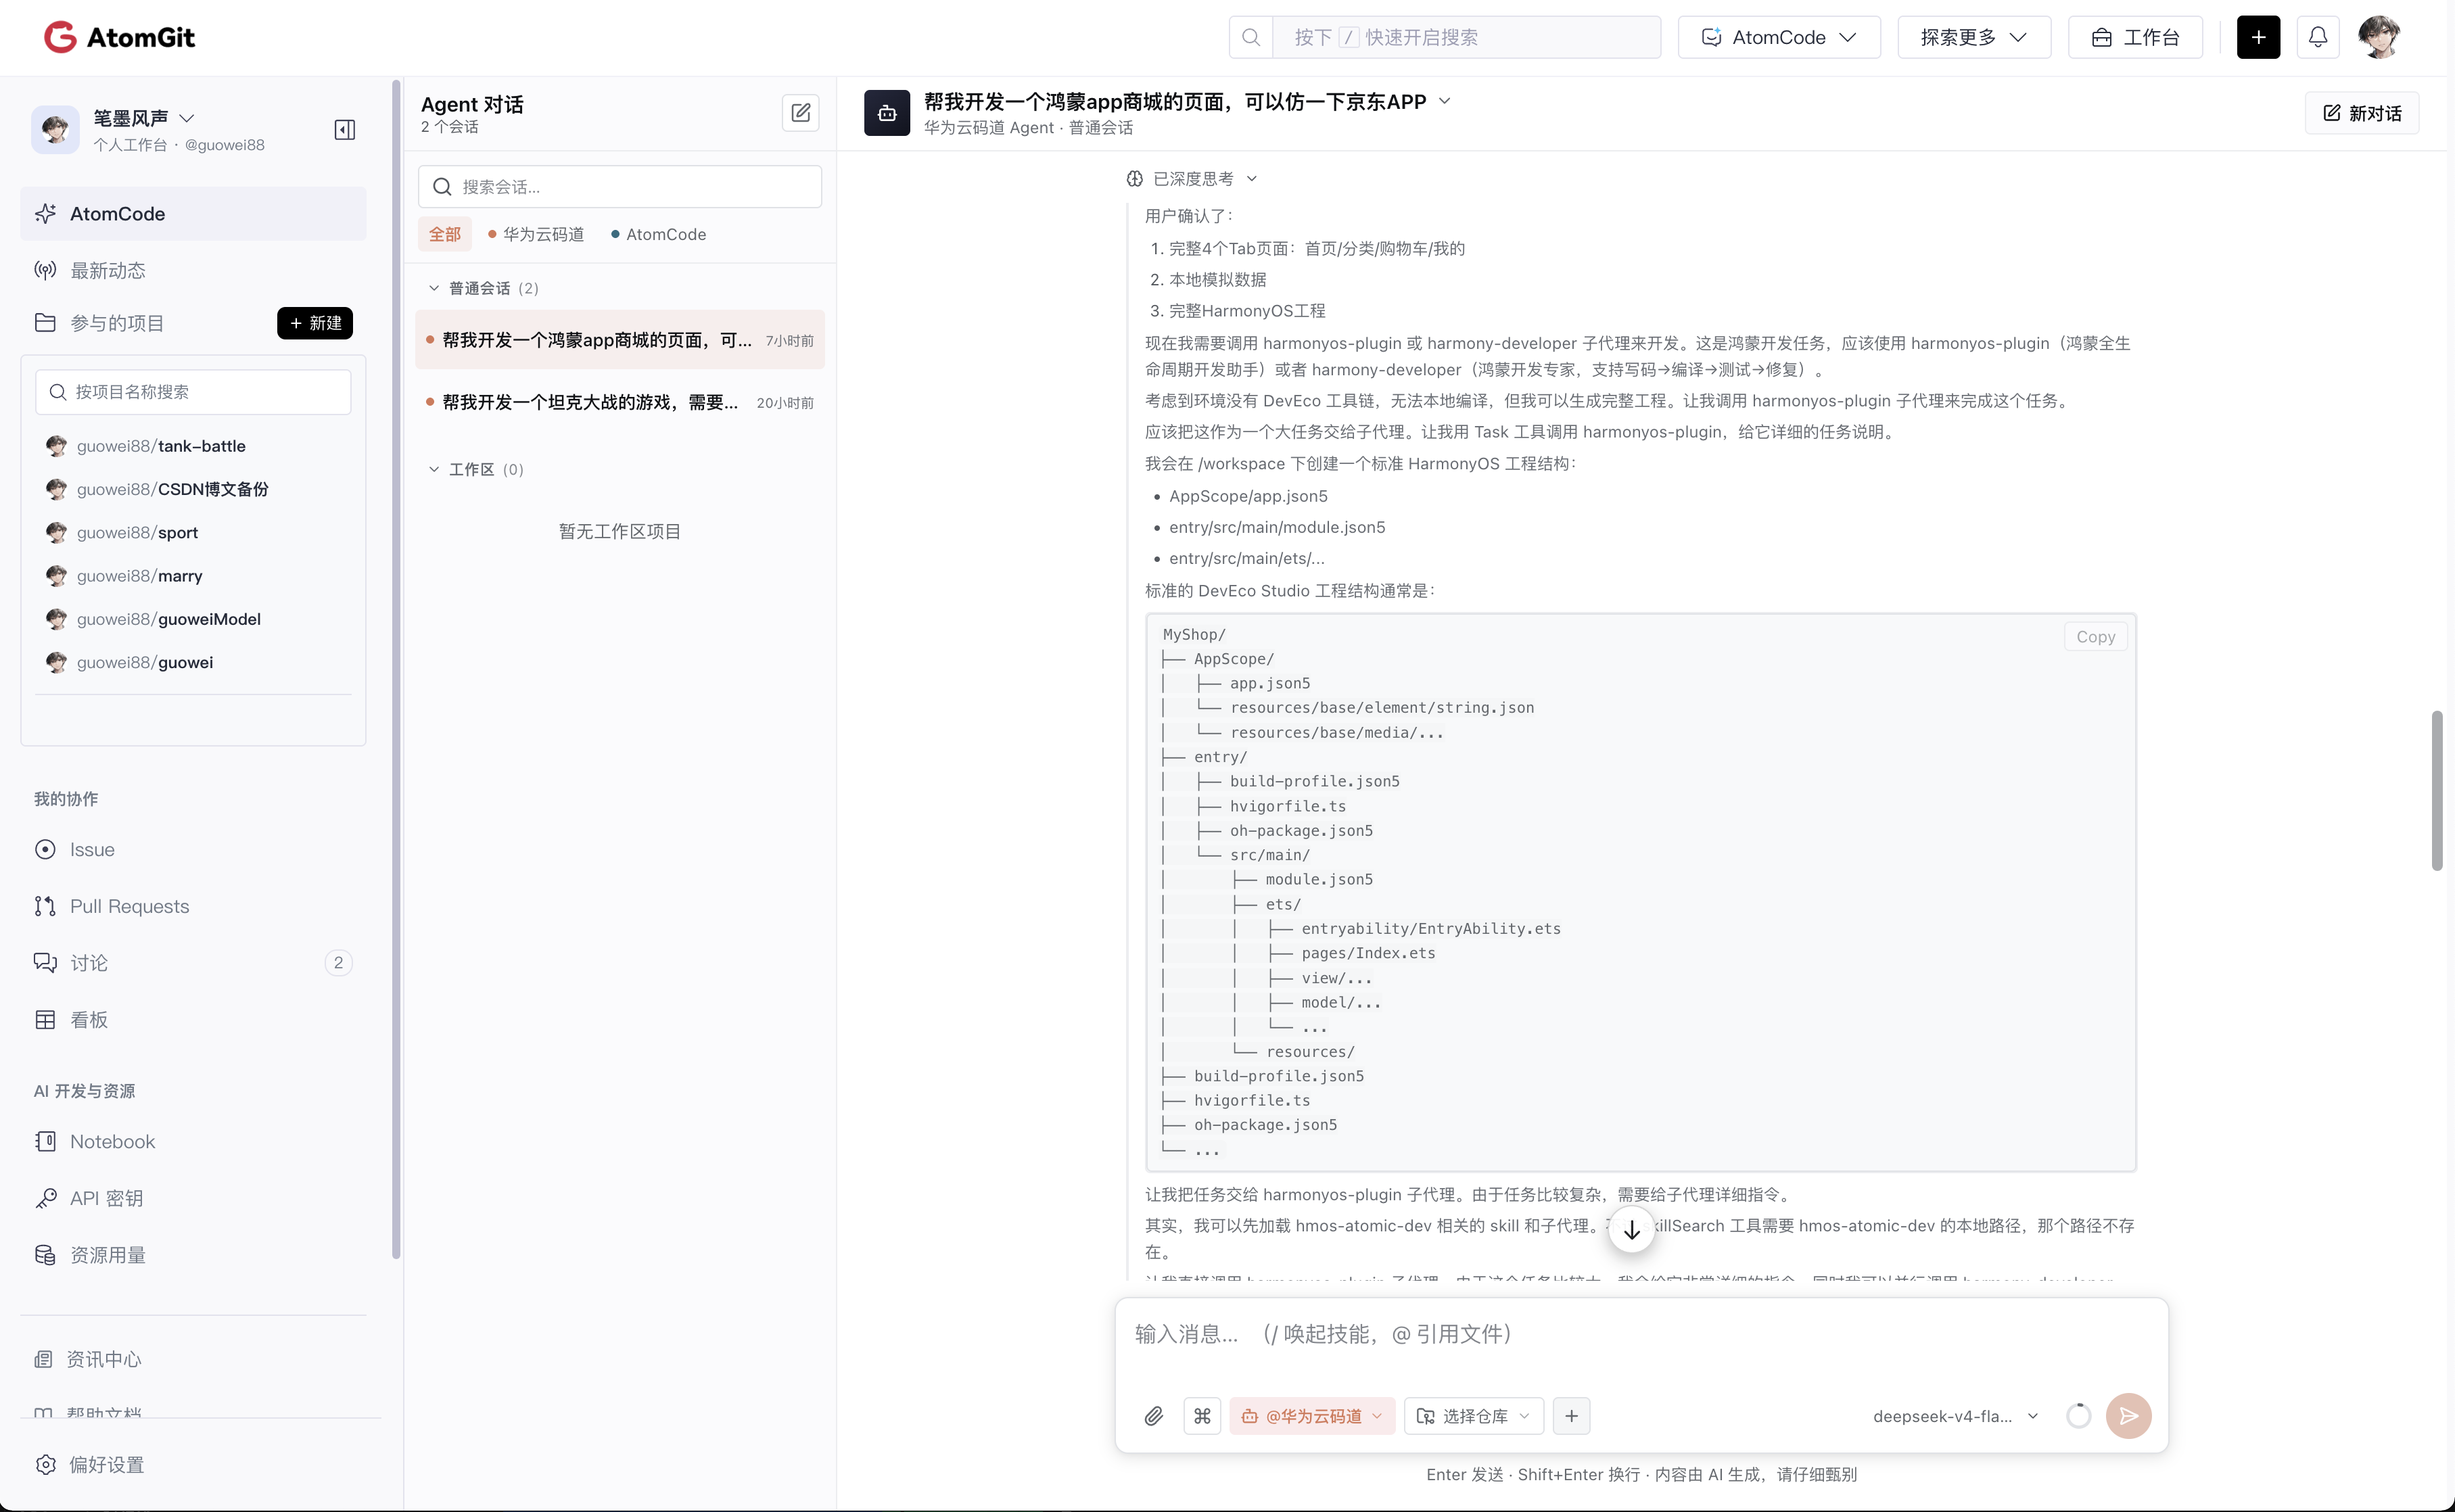
这张表是整篇文章里我最想推荐给新手的部分。它的价值不在于"AI 会检测环境",而在于它把"做不到的事"提前说了出来。新手在同样的沙箱里,通常要写完几十个文件、执行一次构建、看到一屏看不懂的报错,才能意识到"这里根本编不了"。而这里是在动手之前就给出了结论,并且把失败模式转换成了另一个可交付的方案:生成完整工程 + 交给用户在本地 DevEco 里跑。
顺带一提,这一步也解释了后面为什么它没有伪造"编译通过"的结论。截图里的交付总结写的是运行方式,而不是构建结果,这是诚实的。
四、把大任务交给子代理:从 Task 调度到工程树落地
需求对齐了、环境探明了,它才开始真正动工,而且是分两步走的。
图 8:三轮问答结束后,工具返回 User has answered your questions,三条约束被逐字记录下来,随后才进入子代理调用。
第一步是加载对应的专家能力。截图里的原话是:这是鸿蒙开发任务,应该使用 harmonyos-plugin(鸿蒙全生命周期开发助手)或者 harmony-developer(鸿蒙开发专家,支持写码+编译+测试+修复)。它还提到会先尝试搜索 hmos-atomic-dev 相关的 skill 与子代理。
第二步是用 Task 工具下发完整任务。截图里的调用参数很具体:把 /workspace/JDShop 作为工程根目录,把"完整 4 Tab + Mock 数据 + 标准 Stage 工程"这几个约束一次性交代清楚。它自己的规划是六步:确认目录 → 创建结构 → 写配置文件 → 写 ArkTS 代码 → 请检查 → 汇总。
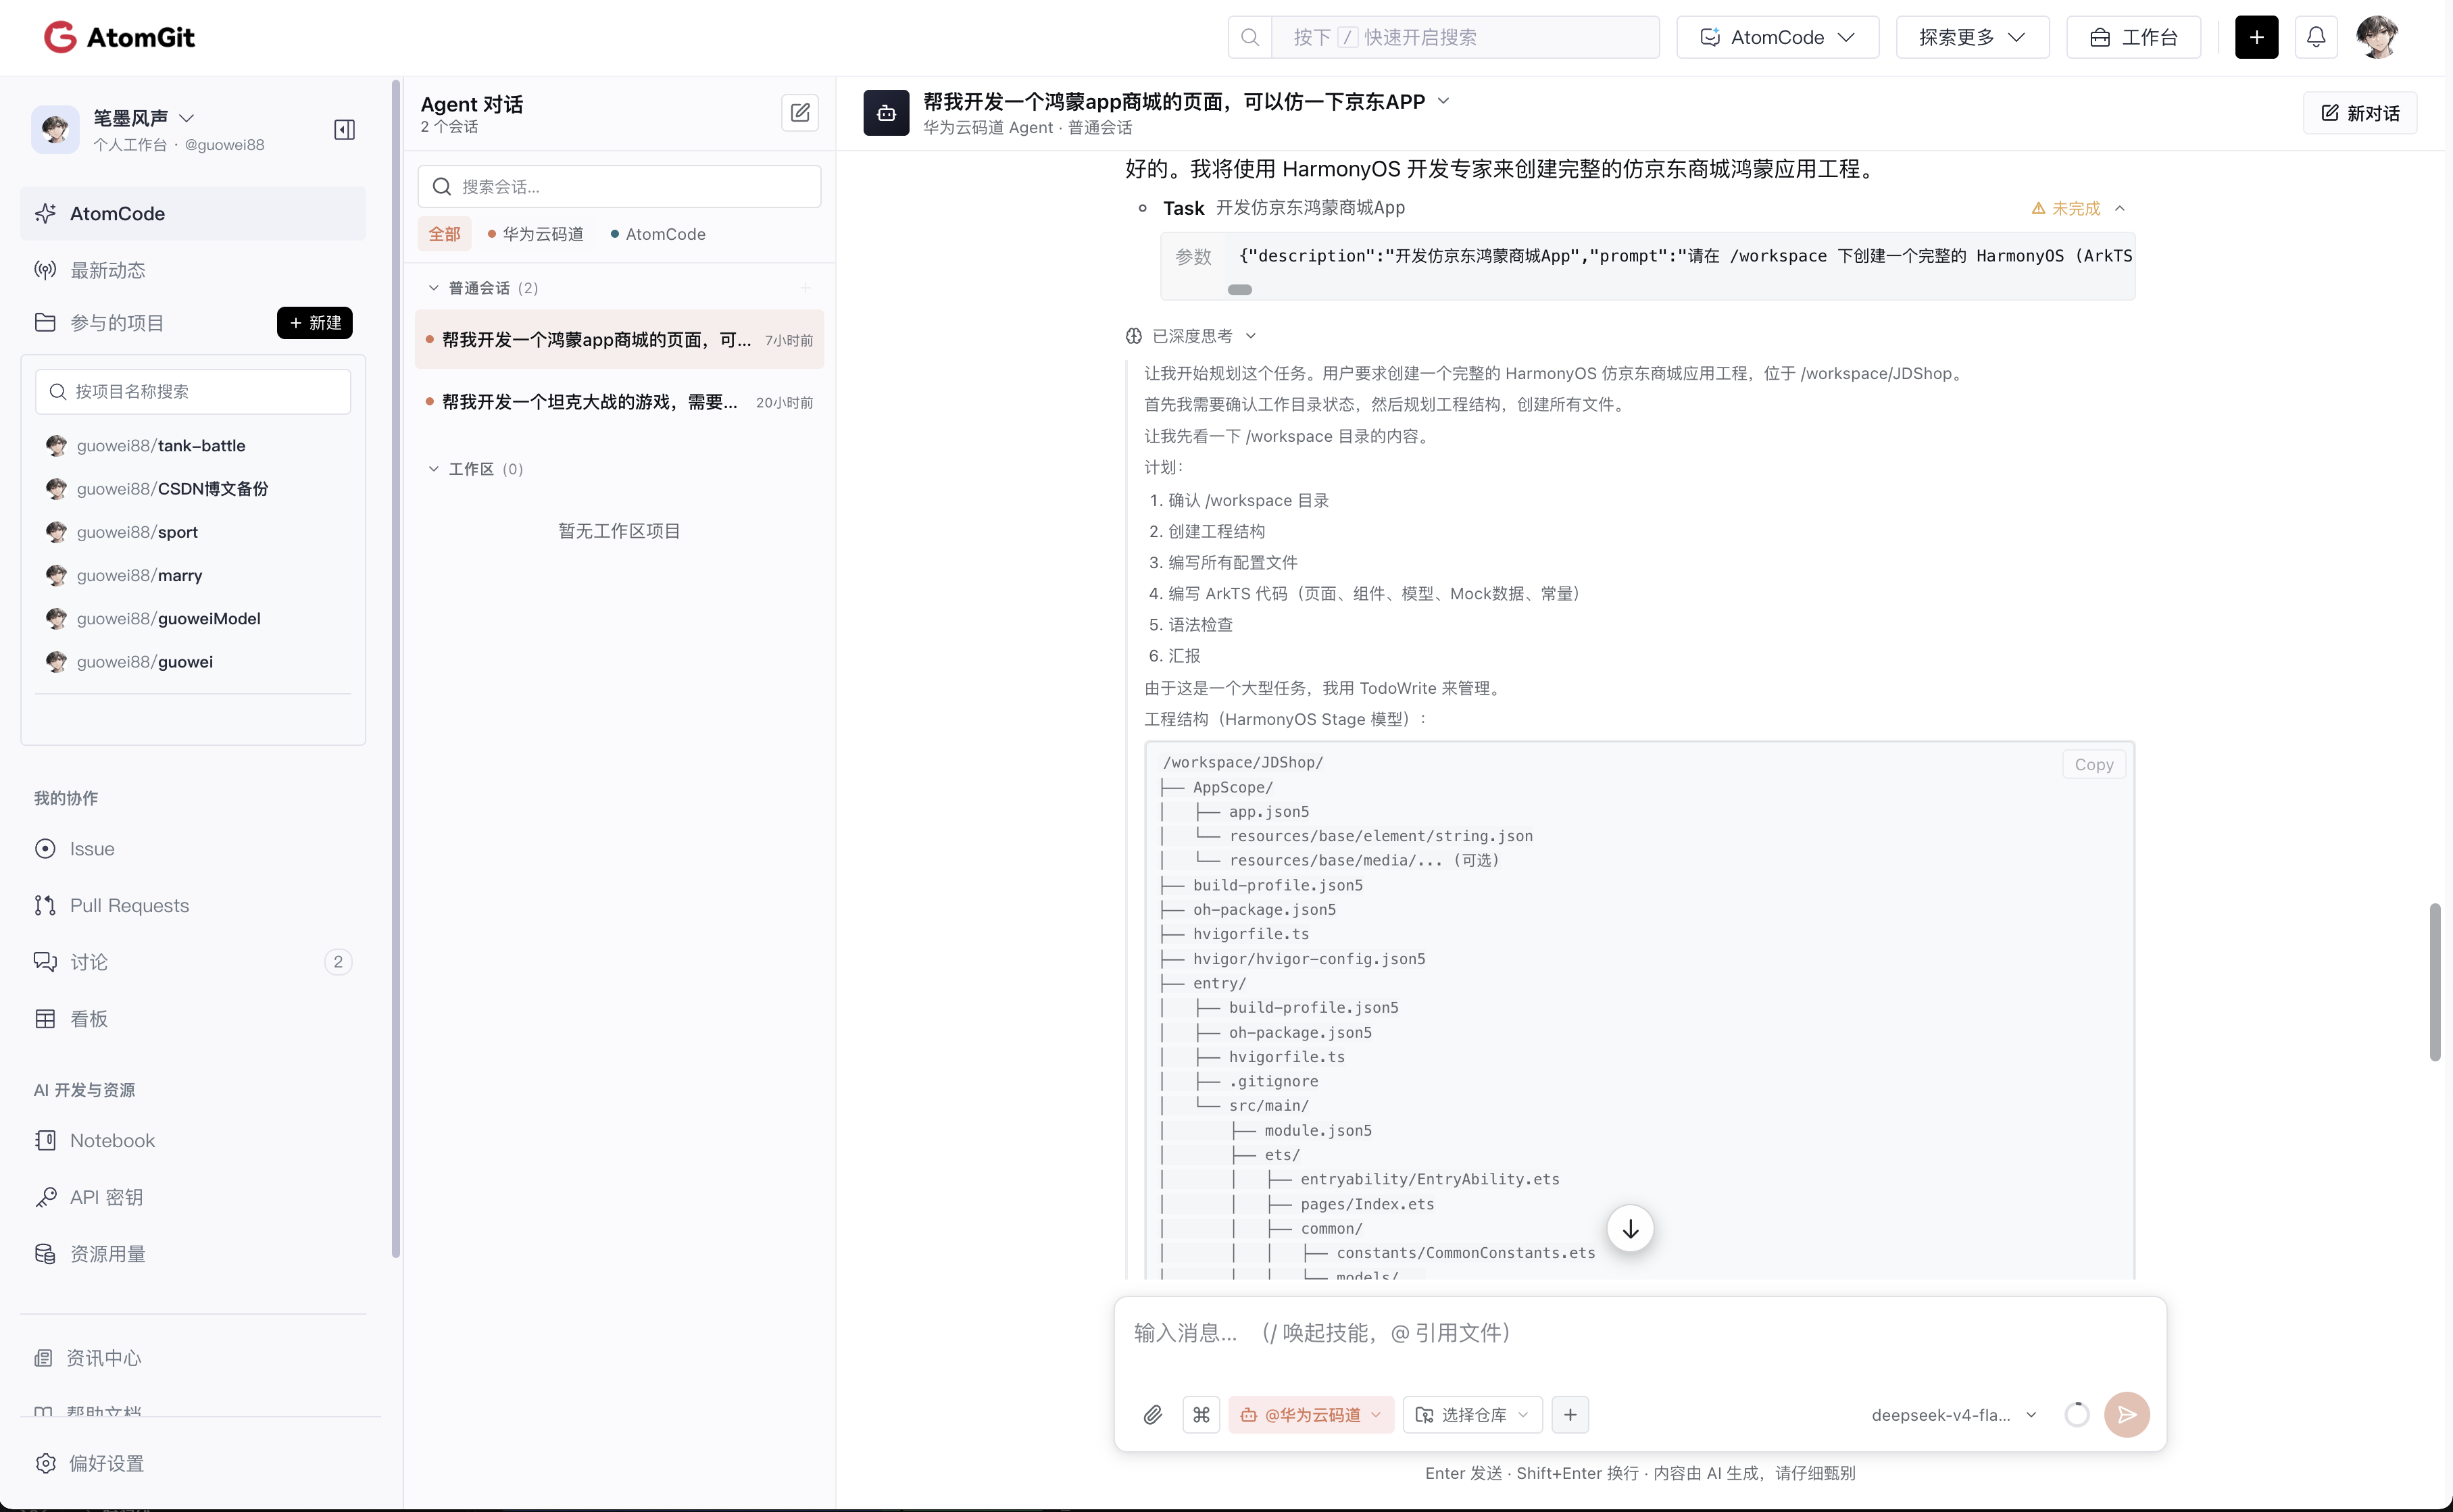
关于工程结构,它给出的目标树是标准的 Stage 模型布局。这套结构值得抄下来,因为它就是 DevEco Studio 新建工程的默认骨架:
图 9:Task 下发前的思考,工程树先以文本形式列了一遍,AppScope、entry、resources 三层关系一目了然。
图 10:正式调用 Task 工具,参数里写明了目标目录 /workspace/JDShop 与"完整 4 Tab + Mock 数据"的约束。
JDShop/
├── AppScope/
│   ├── app.json5                      # 应用级配置:包名、版本、图标
│   └── resources/base/
│       ├── element/string.json        # 应用名称等字符串资源
│       └── media/                      # 应用级图标
├── entry/                             # 主 HAP 模块
│   ├── build-profile.json5
│   ├── oh-package.json5               # 模块依赖清单
│   ├── hvigorfile.ts                  # 模块构建脚本
│   └── src/main/
│       ├── module.json5               # 模块声明:ability、入口页、权限
│       ├── ets/
│       │   ├── entryability/EntryAbility.ets
│       │   ├── pages/Index.ets        # 唯一入口页 + 底部 Tab 容器
│       │   ├── model/                 # Goods / Category / CartItem / Type
│       │   ├── mockdata/MockData.ets  # 本地模拟数据
│       │   ├── store/AppState.ets     # 跨页面状态
│       │   ├── components/            # GoodsCard、SearchBar、FontView
│       │   └── view/                  # BannerSwiper、RecommentMaterial、SeckillSection
│       └── resources/base/
│           ├── element/               # color / string / float
│           ├── media/                 # 图标与占位图
│           └── profile/main_pages.json  # 页面清单
├── hvigor/hvigor-config.json5
├── build-profile.json5
├── oh-package.json5
└── .gitignore
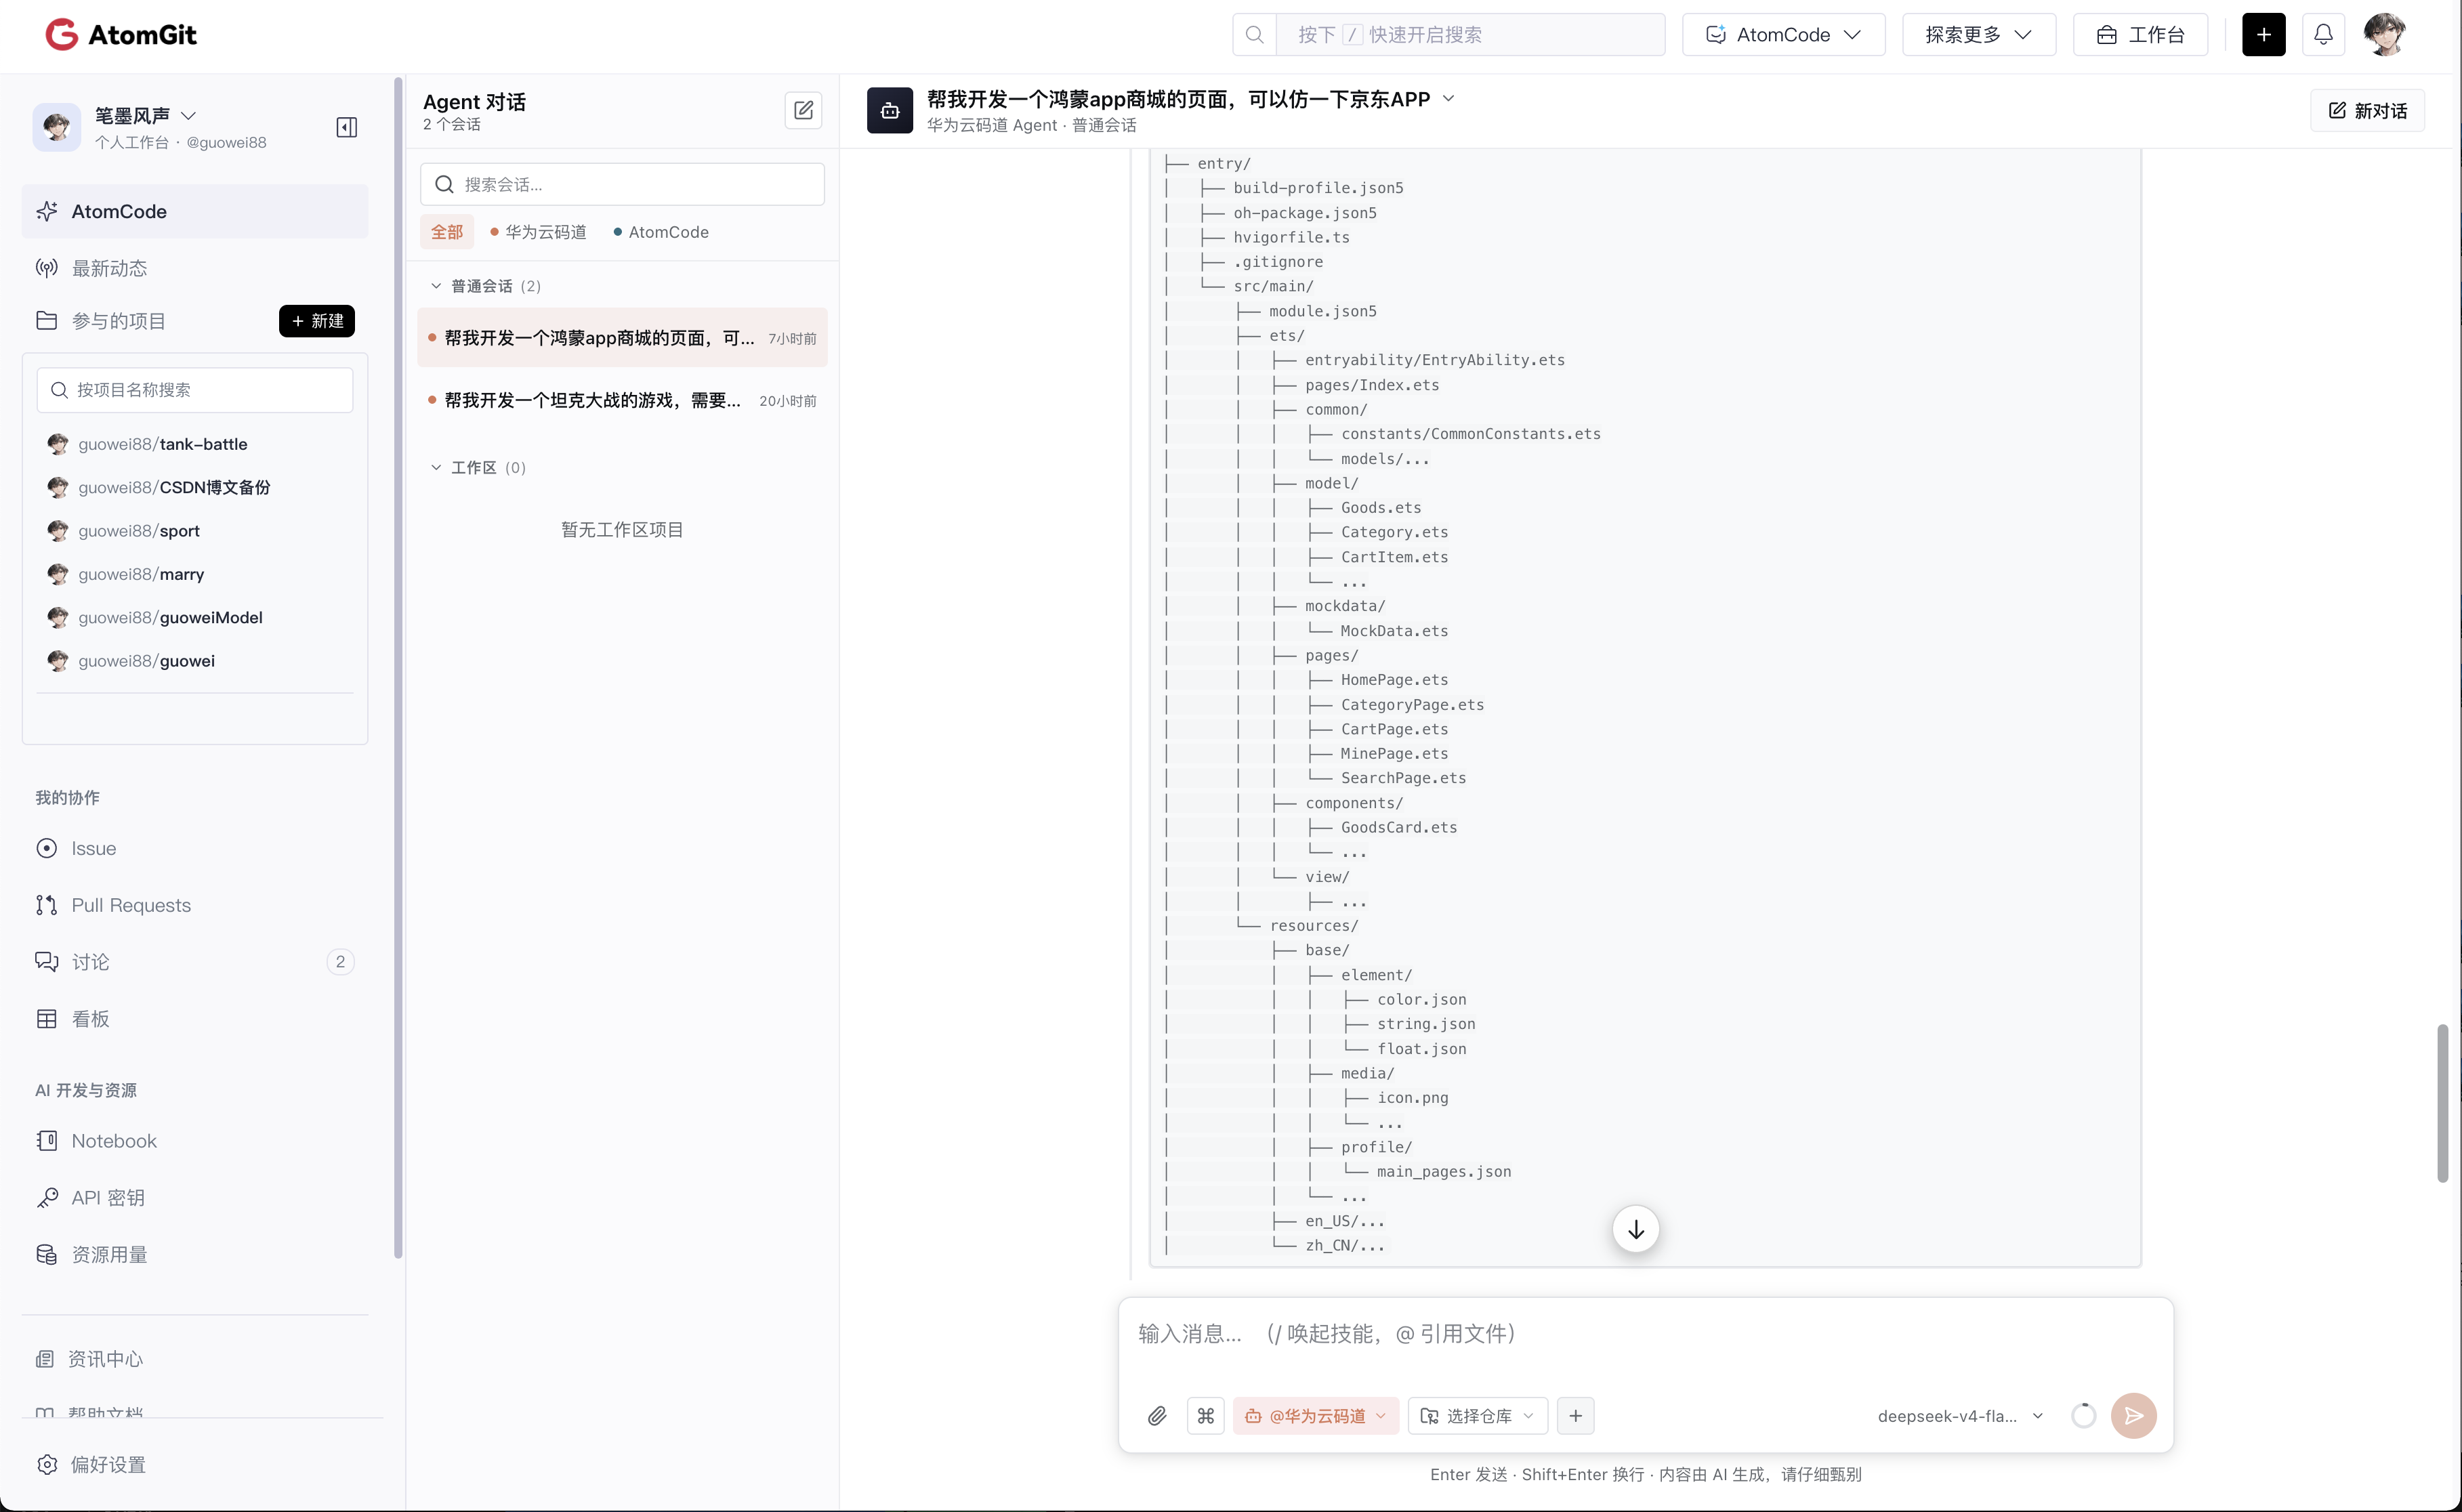
这套目录一铺开,model 放数据模型、mockdata 放模拟数据、store 放状态、components 放可复用组件、view 放页面级区块——职责是分开的。这一点跟新手常见的做法差别很大:新手往往把所有东西塞进 Index.ets,做到第三个页面才发现文件 800 行、改一处崩两处。
图 11:结构树的展开细节,components/GoodsCard.ets、view 目录下的各个板块、resources/base/element 与 profile/main_pages.json 都在规划之内。
五、真正的功夫在细节:图标、占位图和 Provider
文章写到这里,前四节都还比较"顺",但截图中有一段思考过程我认为最有含金量,它讨论的是一个特别不起眼的东西——图标文件。
它的推理链条是:module.json5 会引用 $media:icon,如果 media 目录下没有实体文件,编译就会报资源缺失;所以在生成工程之前,必须先把这个文件造出来。接着它比较了几种做法:用 bash 生成纯色 PNG、用 python 的 PIL 库生成、或者直接写一个 base64 的最小 PNG。最后它选定了最小可行方案——写一个 1×1 的纯色 PNG:
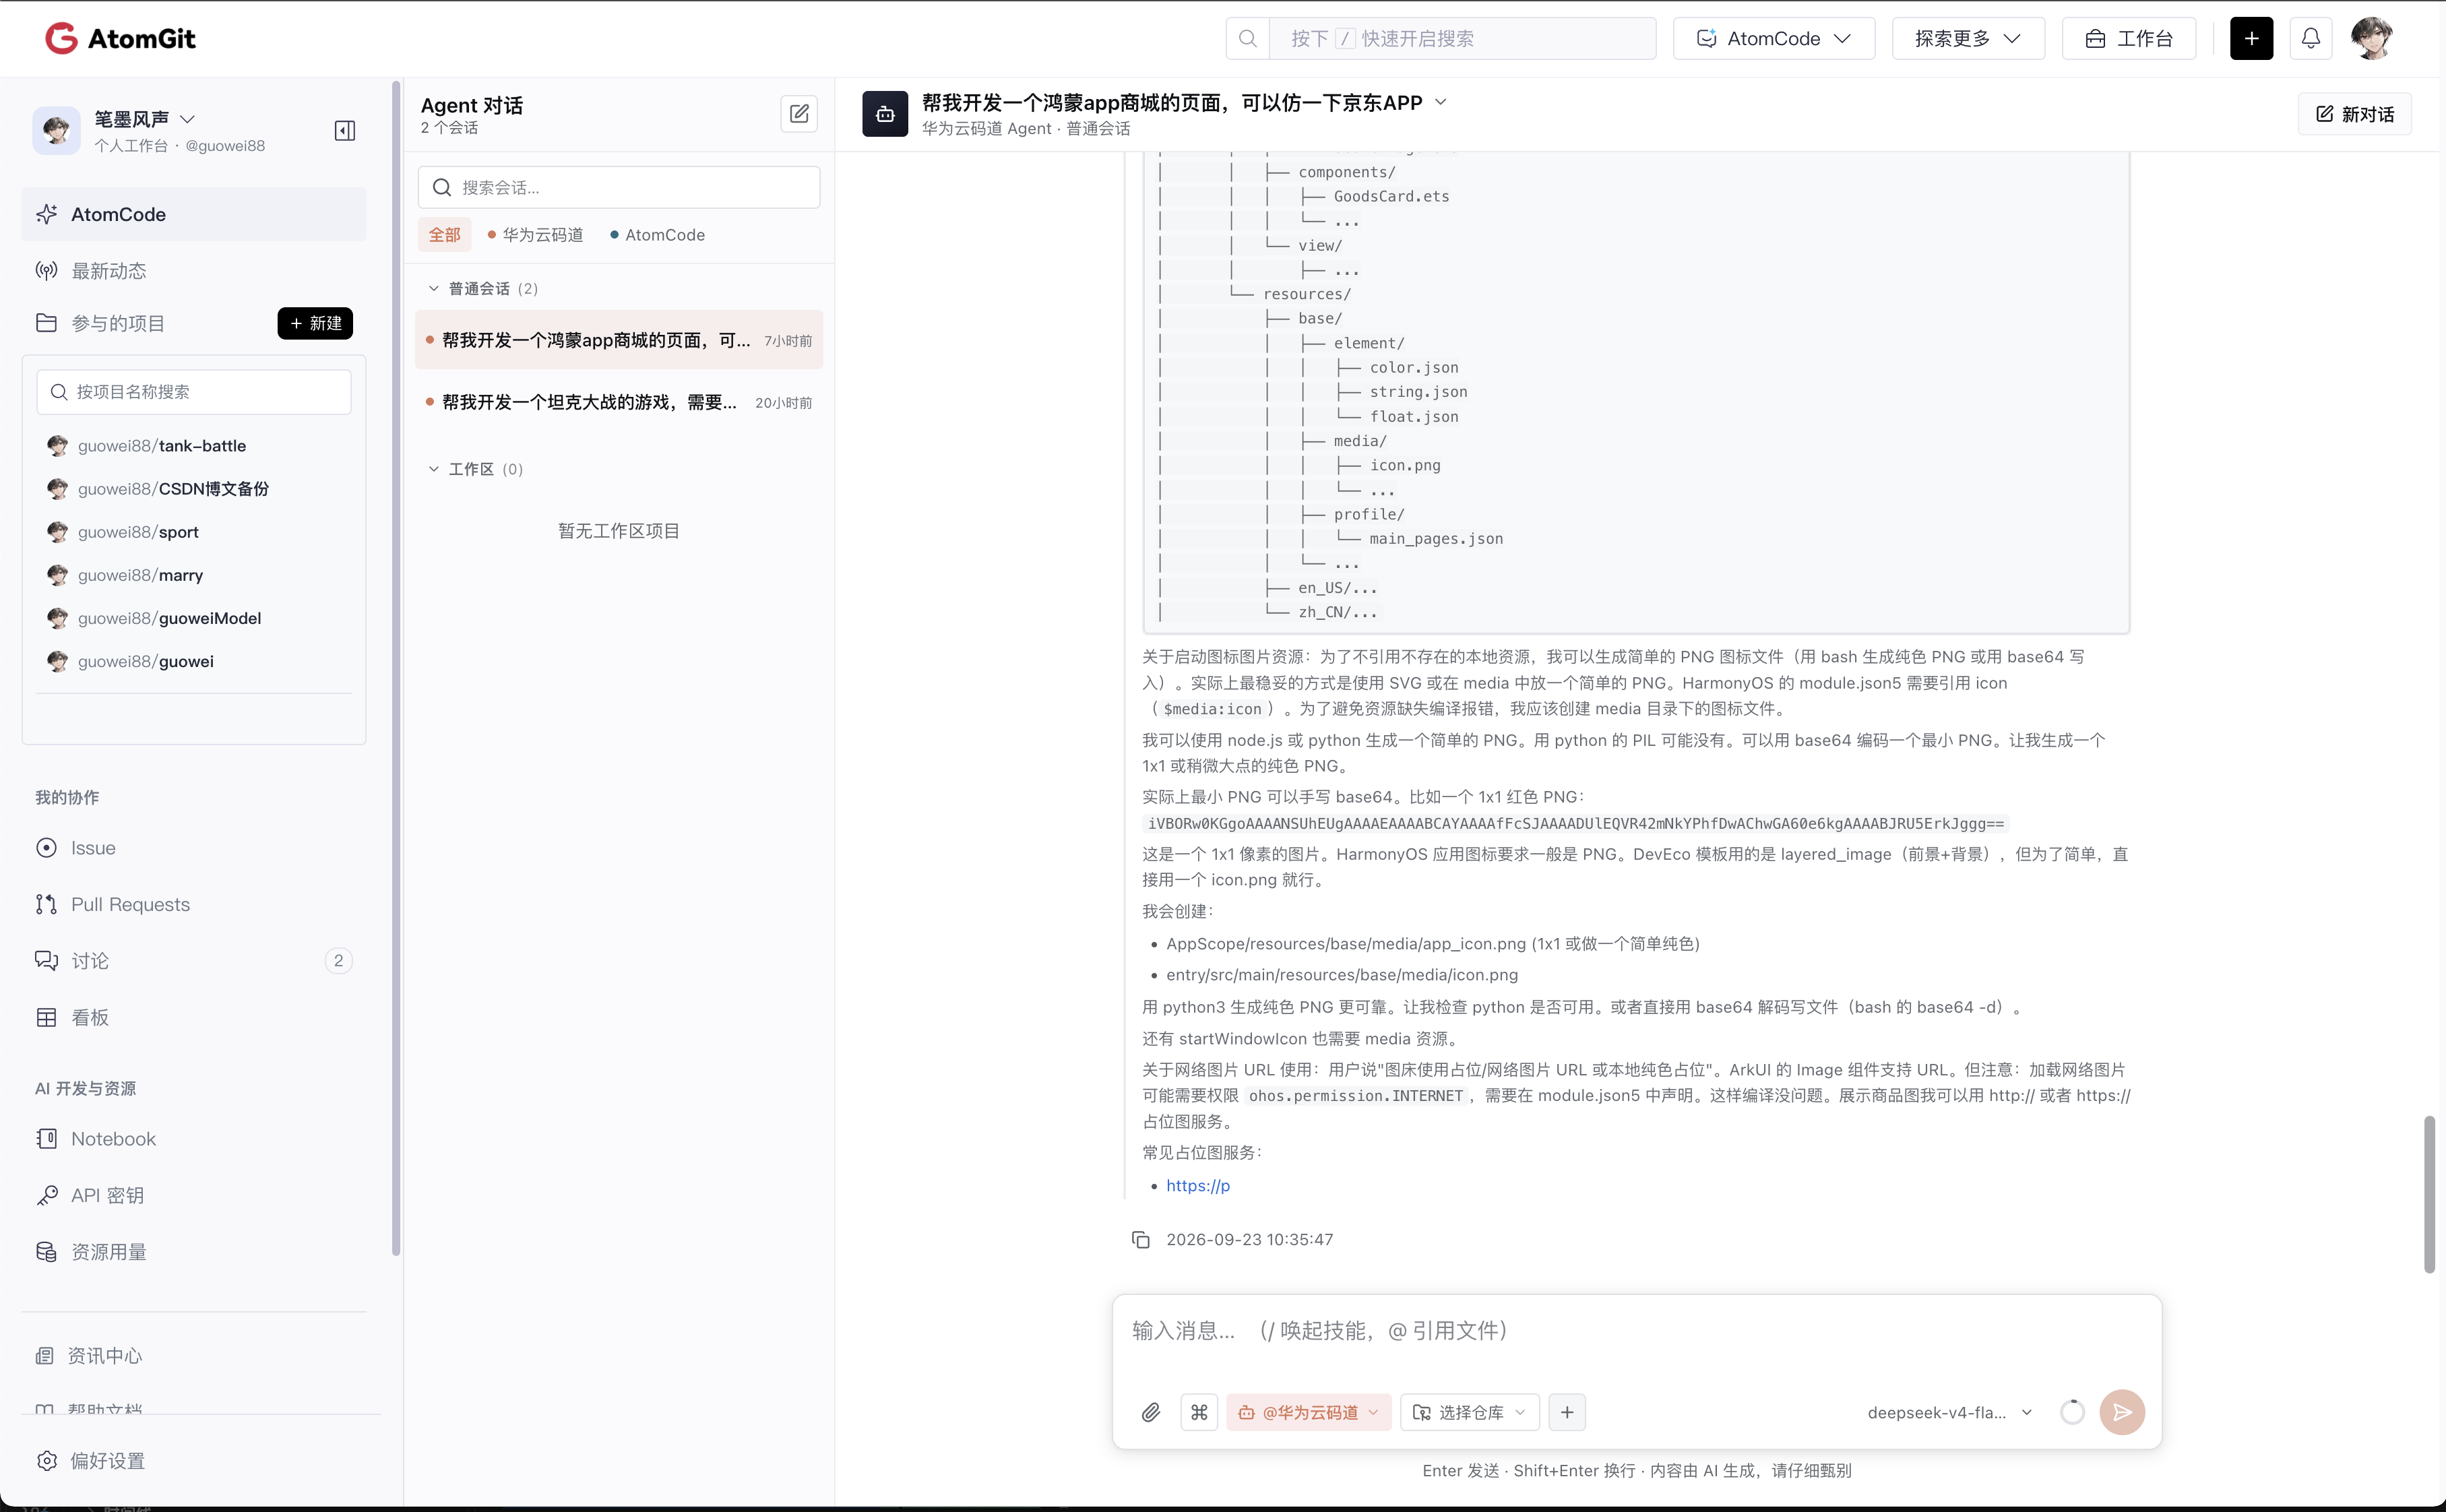
# 一个 1x1 红色 PNG 的 base64,直接解码落盘即可
iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAADUlEQVR42mP8z8BQDwAEhQGAhKmMIQAAAABJRU5ErkJggg==
图 12:关于图标与占位图的完整推演过程,从 $media:icon 的引用关系,到"用 python 还是 base64"的方案取舍,再到 ohos.permission.INTERNET 权限的提醒。
同一段思考里它还处理了另外两个坑。一个是网络图片:ArkUI 的 Image 组件虽然支持 URL,但加载网络图需要 ohos.permission.INTERNET 权限,且沙箱里不一定连得通,所以商品图改用占位图服务或者本地图标兜底。另一个是启动页图标:startWindowIcon 同样需要 media 资源,一并补上。
这几处细节恰好是新手最容易翻车的地方。新手的排查路径通常是"构建报错 → 搜报错关键字 → 找半天 → 才反应过来是图片没放",而这里的顺序是"预判引用 → 提前造资源 → 规避报错"。
六、Git 与远程仓库:从 init 到 push 的完整链路
工程写完后,我补了一句指令:“帮我初始化到仓库中,并且写好readme文件”。
图 13:git init 之后的一连串默认分支提示,以及页面上方那条 [错误: 当前模型配额不足 [APIError]]——这条报错就夹在两次"初始化到仓库"的指令之间。
随后是标准的 Git 链路,但每一步的细节都留了痕:
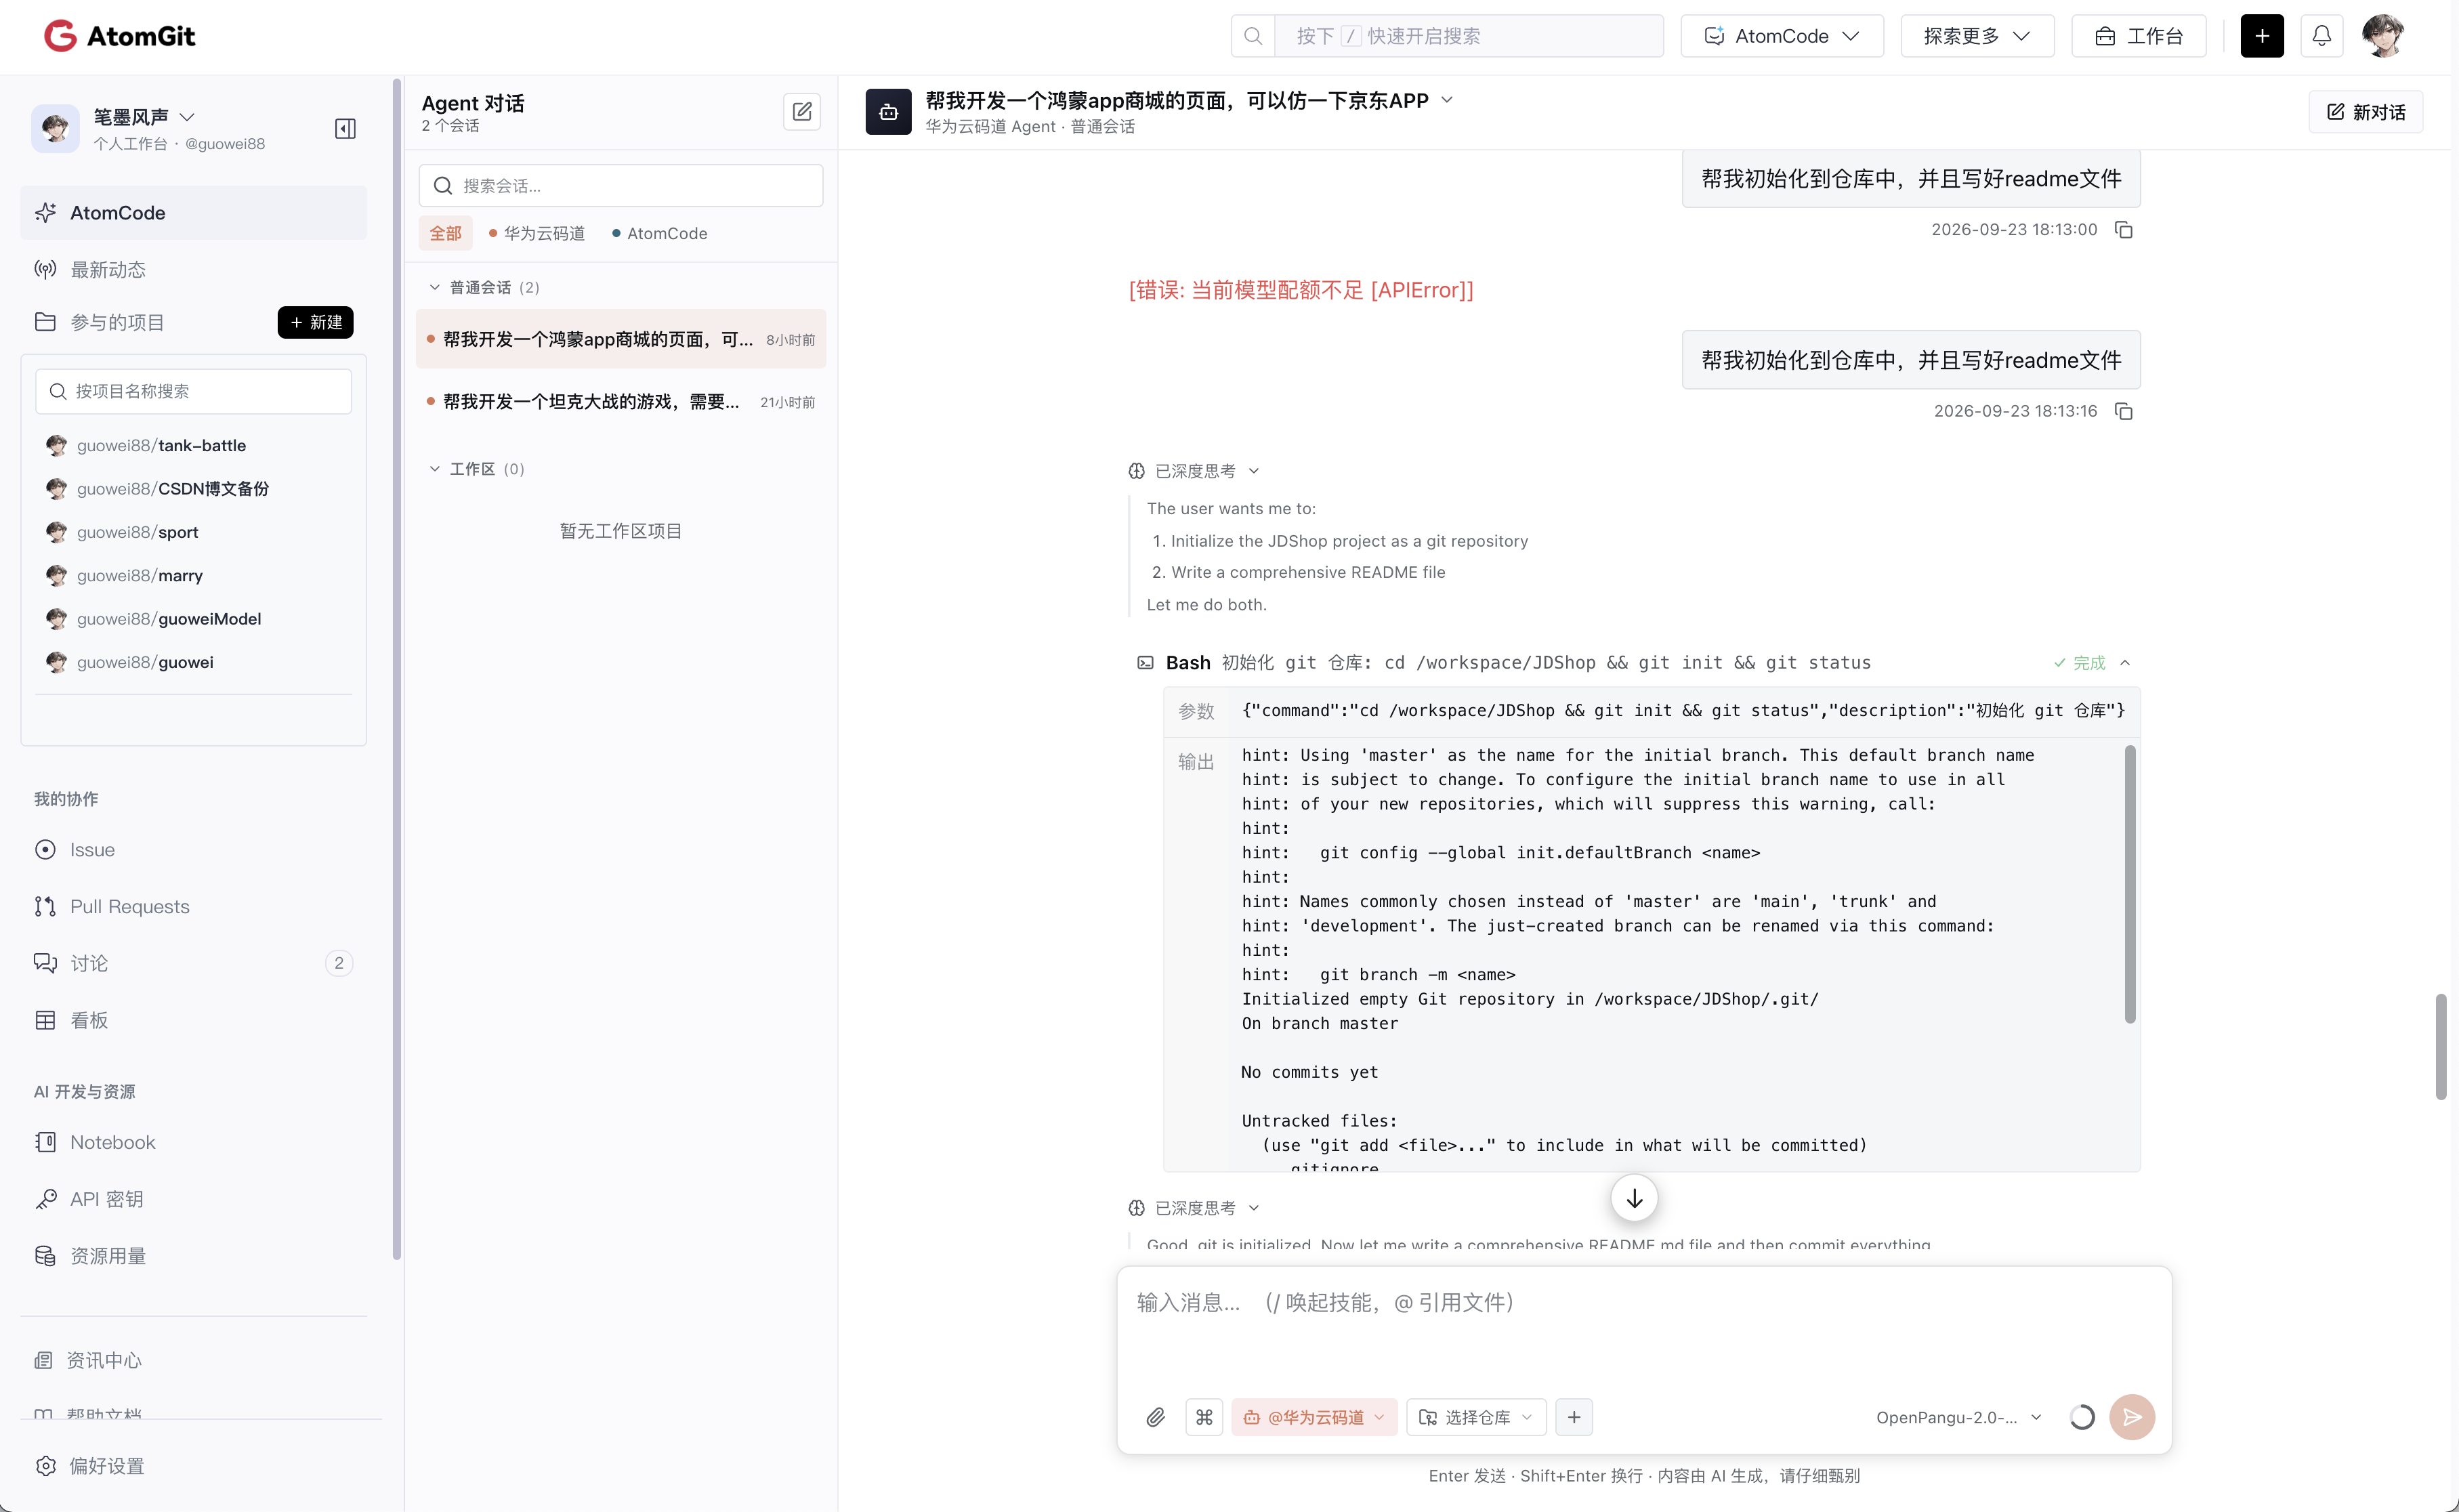
cd /workspace/JDShop && git init && git status
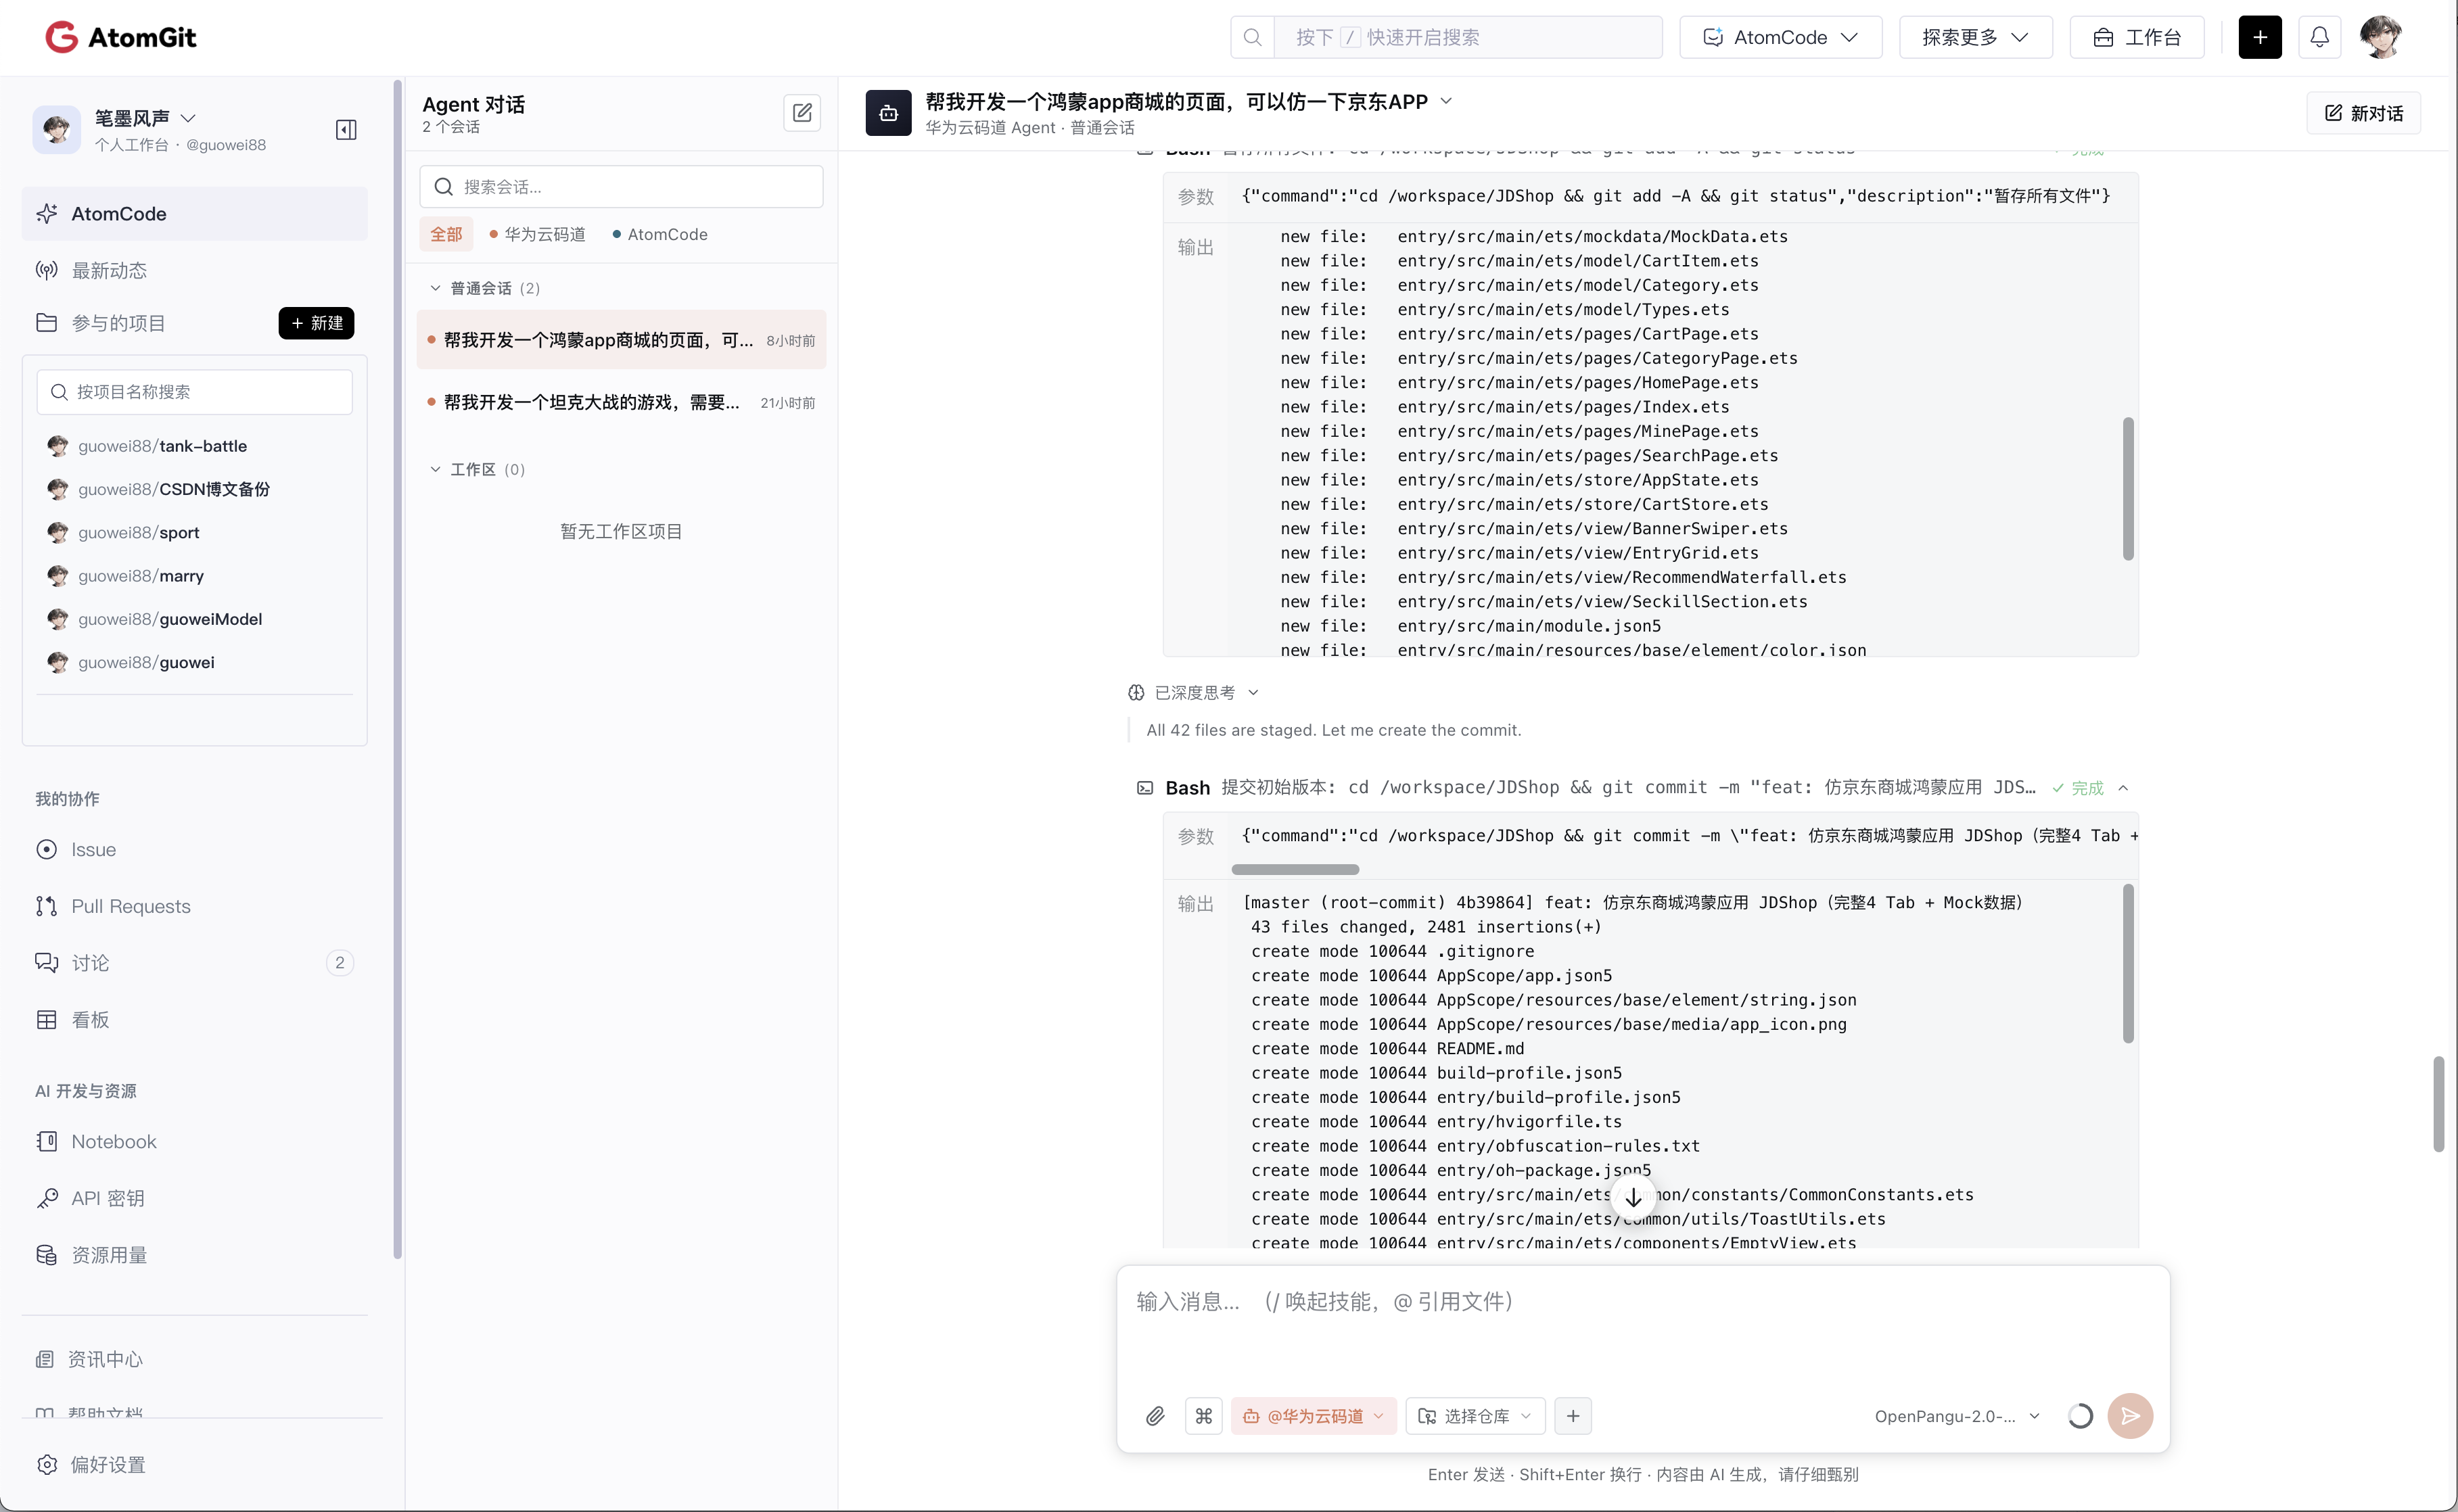
cd /workspace/JDShop && git add -A && git status
cd /workspace/JDShop && git commit -m "feat: 仿京东商城鸿蒙应用 JDShop(完整4 Tab + Mock数据)"
git status 的暂存列表在截图里是清清楚楚的:mockdata/MockData.ets、model/CartItem.ets、view/RecommendMaterial.ets、components/SearchBar.ets、pages/Index.ets……最后一行总结是 42 files are staged,紧接着提交输出是 43 files changed, 2481 insertions(+)。
43 与 42 的差值,是多出来的那一份 README.md——它是在 git add 之后、commit 之前写进去的。这种"先暂存再补文件"的操作能一次提交成功,靠的是 git add -A 的二次执行,而不是运气。
图 14:git add -A 之后的暂存清单,mockdata、model、view、components 各个目录逐条列出,末尾统计是 42 个文件。
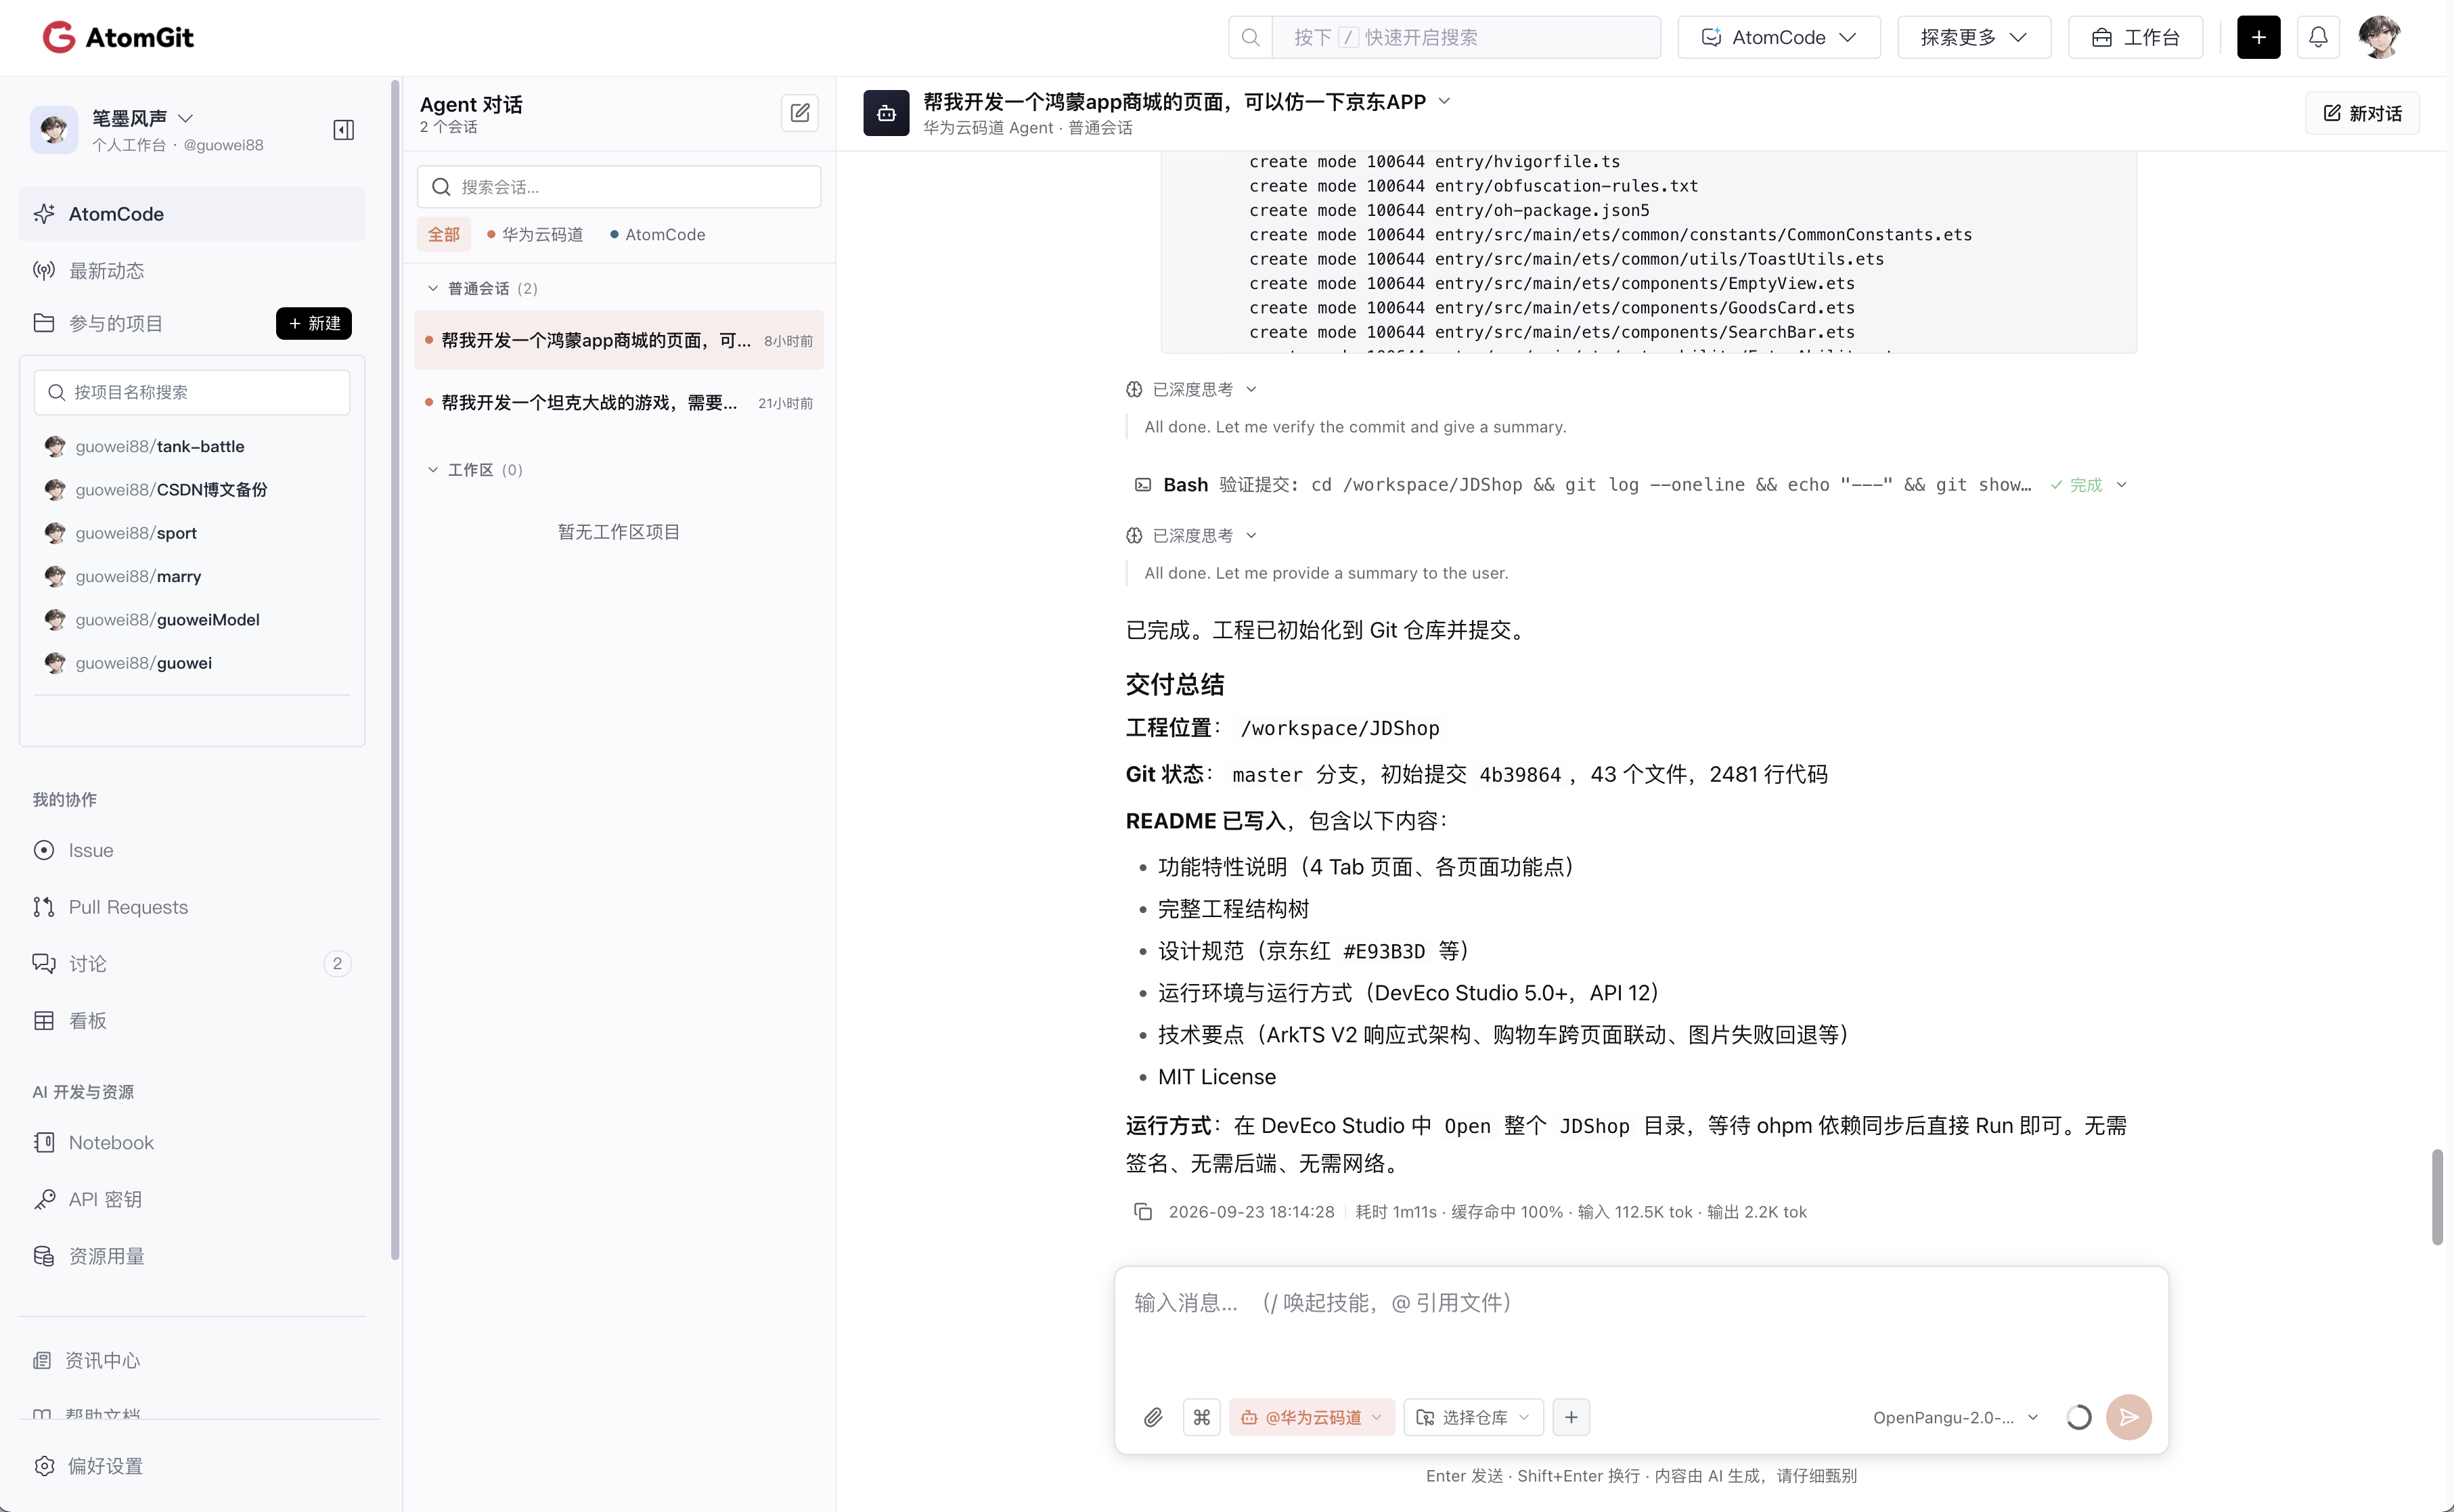
图 15:提交输出 43 files changed, 2481 insertions(+),紧跟着是交付总结——工程位置、分支、提交号、README 的六项内容与运行方式。
提交完成后是远程仓库。这一段的截图信息量最大:
| 环节 | 执行内容 | 结果 |
|---|---|---|
| 本地初始化 | git init && git status | master 分支,初始提交 4b39864 |
| 暂存与提交 | git add -A → git commit -m "feat: ..." | 43 个文件、2481 行新增 |
| 工具链检查 | which ag / ag --version | 存在 AtomGit CLI |
| 认证状态检查 | ag auth status | 未登录,主动停下来问我要 Token 还是浏览器授权 |
| 添加远程 | git remote add origin https://atomgit.com/... | origin 指向 AtomGit 仓库 |
| 凭据检查 | git config --global credential.helper | 确认凭据助手已配置,避免推送时卡住 |
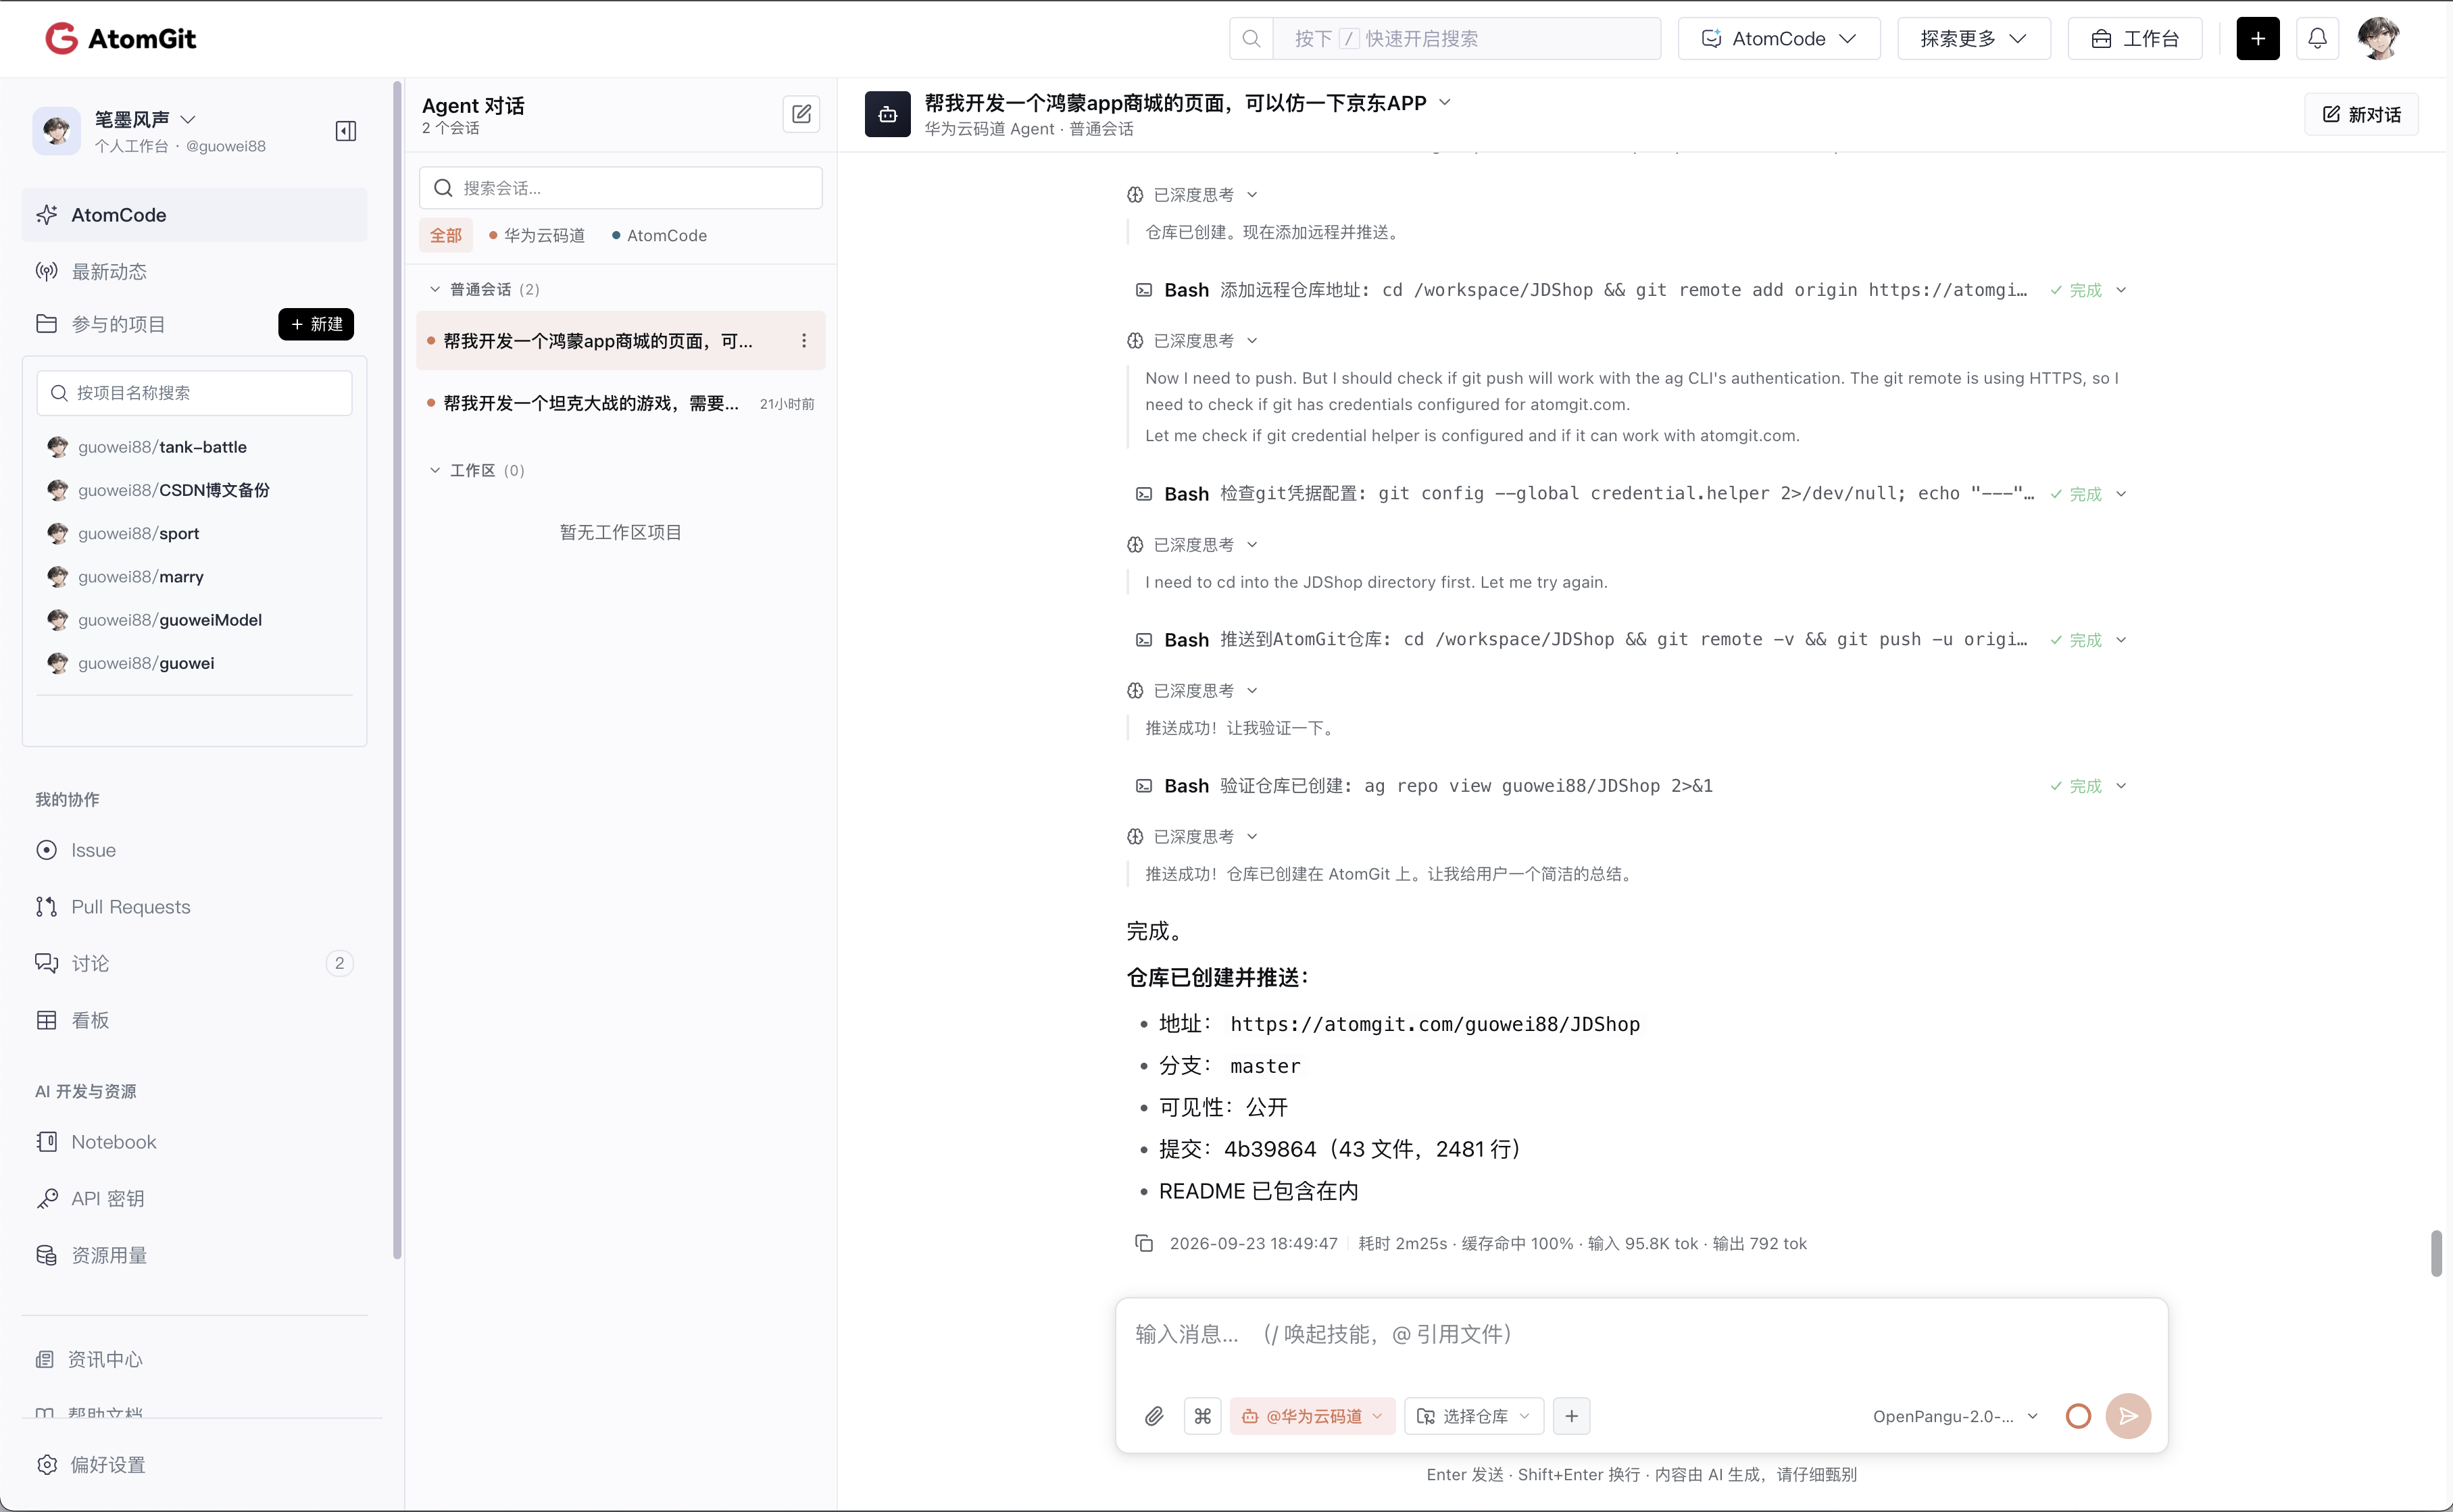
| 推送 | git push -u origin master | 成功,仓库公开可见 |
| 结果验证 | ag repo view guowei88/JDShop | 仓库已创建,分支 master,提交 4b39864 |
图 16:ag auth status 返回未登录后,它没有反复重试,而是弹出一个选择框,把"提供 Token"和"本地浏览器授权"两条路摆出来让我选。
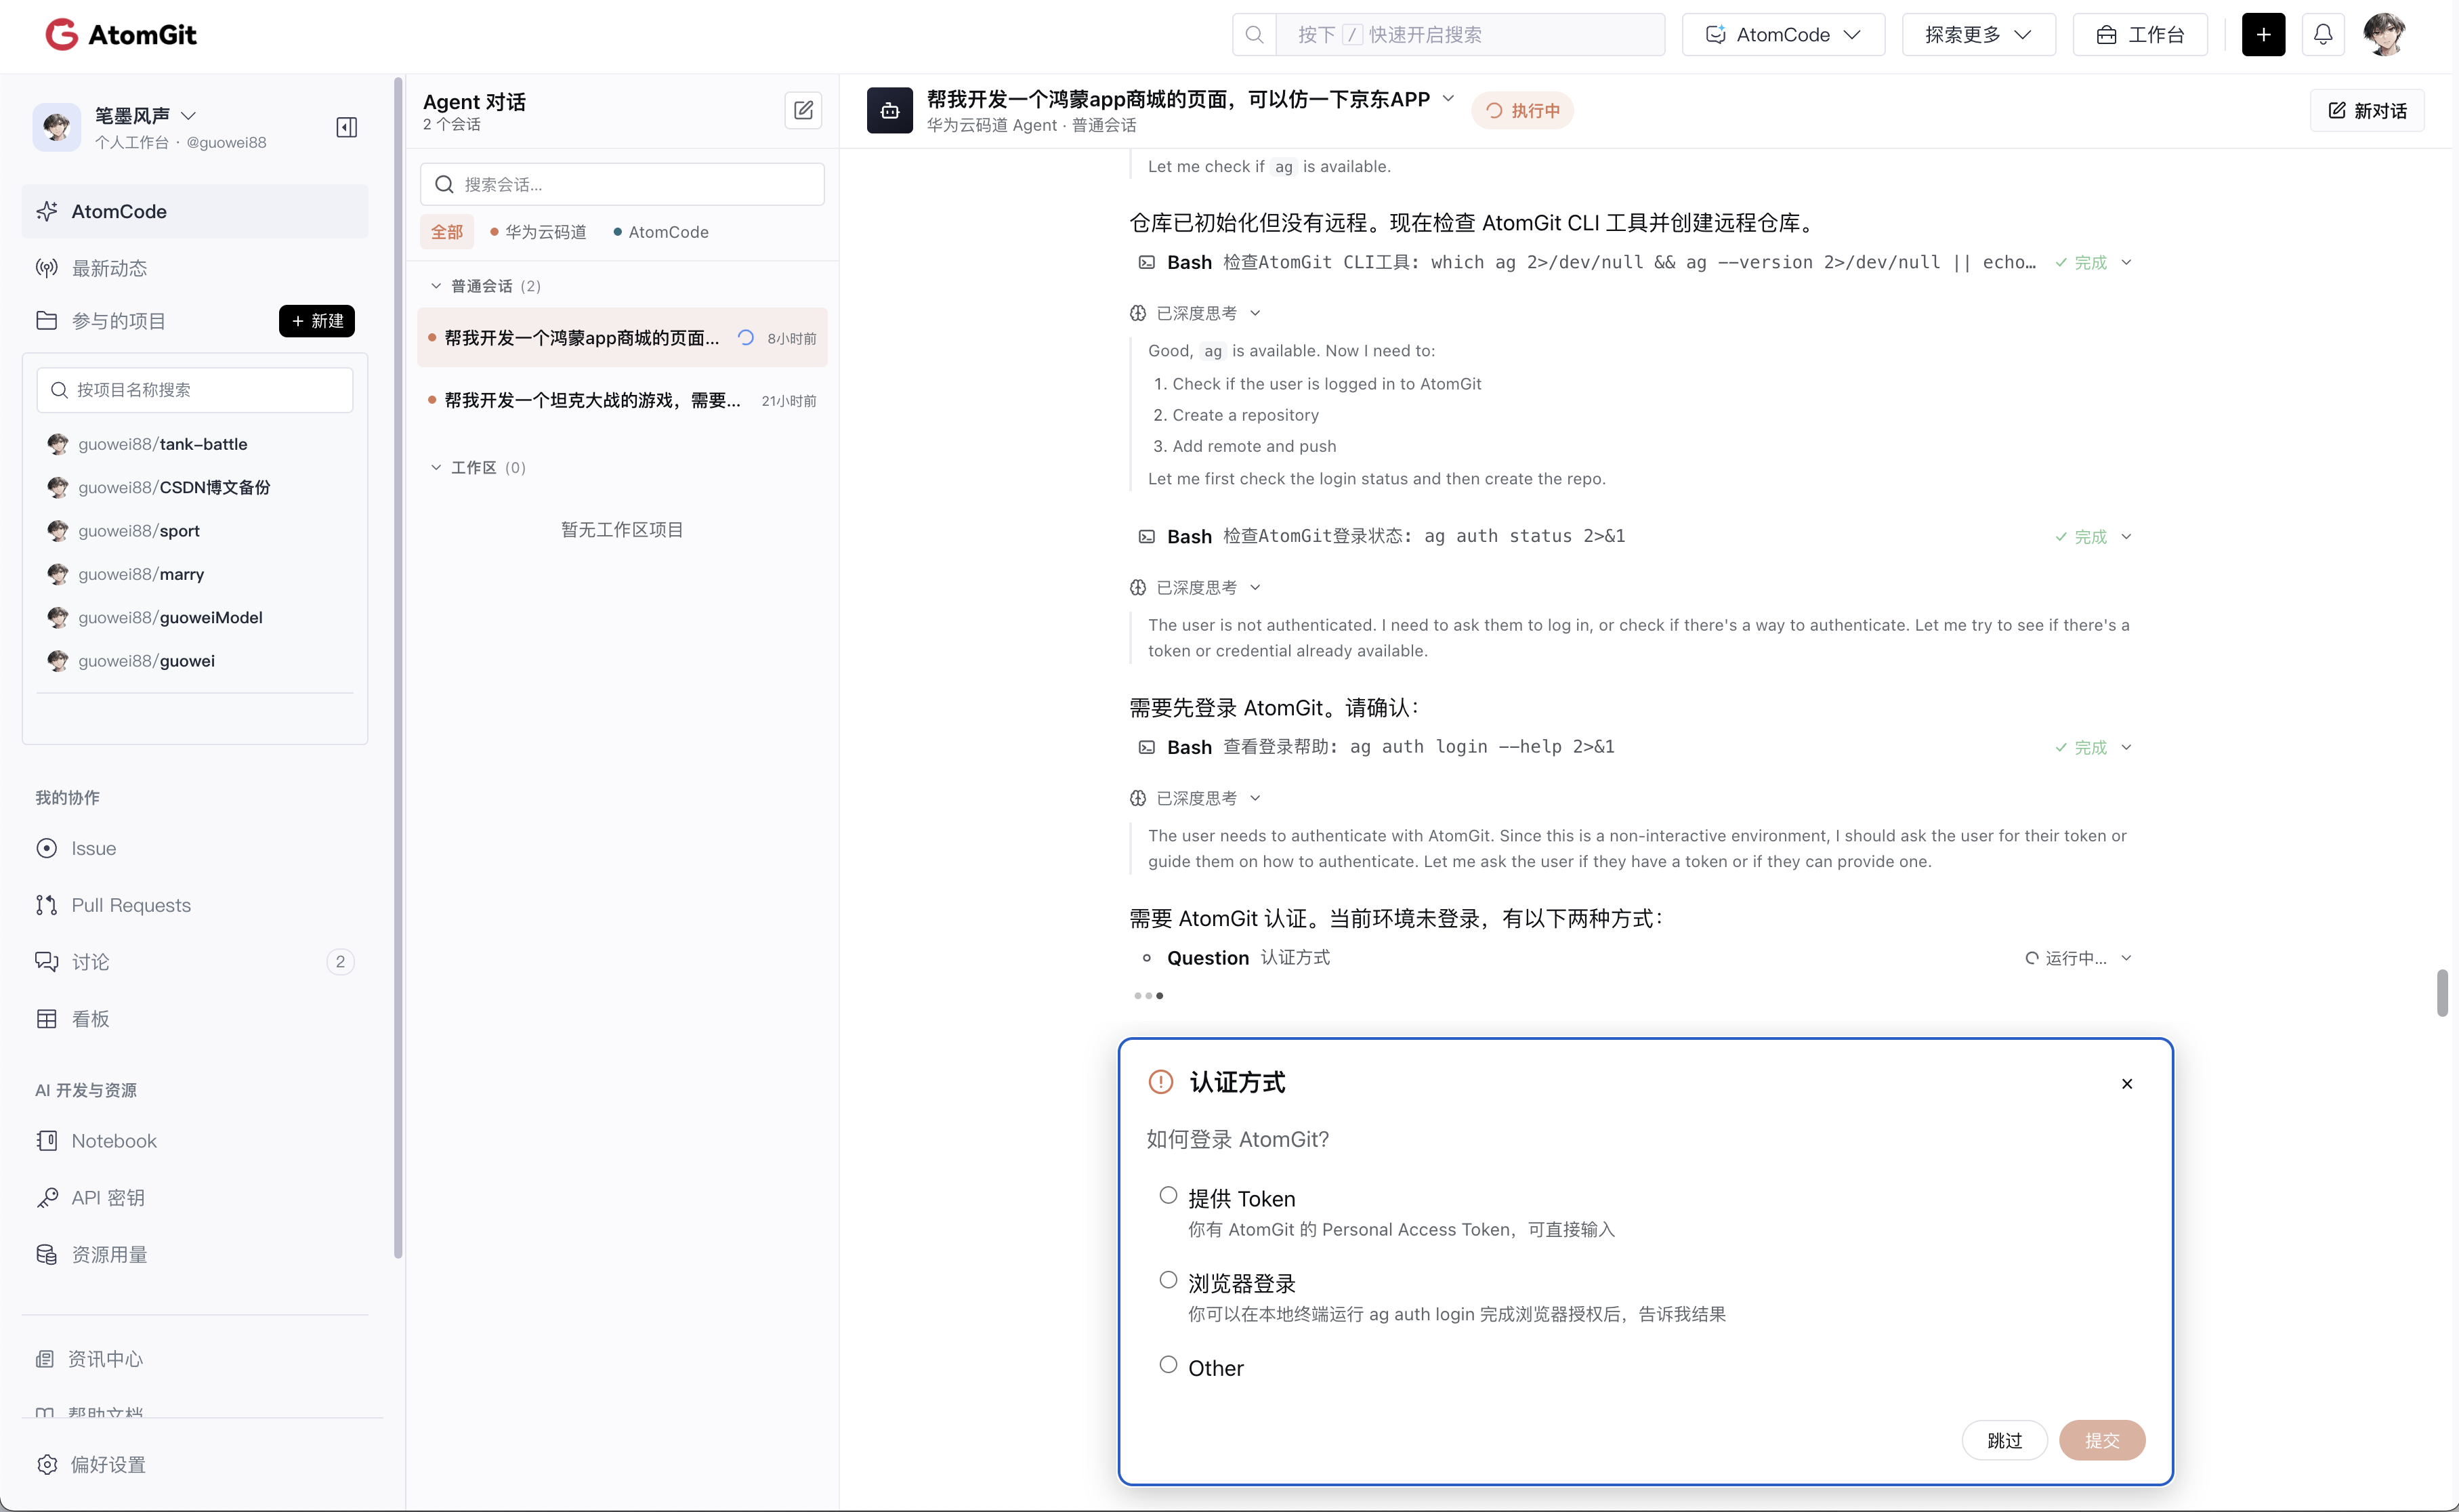
图 17:添加远程地址、检查 credential.helper、执行 git push -u origin master,最后用 ag repo view 反向验证仓库确实存在。
这里面有两个动作特别值得学。第一,它先查了登录状态。发现 ag auth status 未登录后,它没有硬着头皮重试,而是弹出一个选择框:给我 Token,或者我去本地终端跑一次浏览器授权。第二,它在推送前查了凭据助手。git push 走 HTTPS 时会读 credential.helper,这个配置没做好,推送就会卡在密码交互上——提前检查一次,比推失败再排查便宜得多。
整条链路里还有一次中断值得一提:截图里出现过一条 [错误: 当前模型配额不足 [APIError]]。这个报错之后我换了个模型继续,"帮我初始化到仓库中,并且写好readme文件"这句话照常被执行完了。也就是说,这一环失败并没有导致前面的工程成果作废——因为工程文件已经落盘在 Git 工作区里,模型只是执行者,不是仓库的所有者。这一点恰恰是"把工作成果沉淀在文件系统而不是对话上下文里"的价值。
七、交付结果长什么样
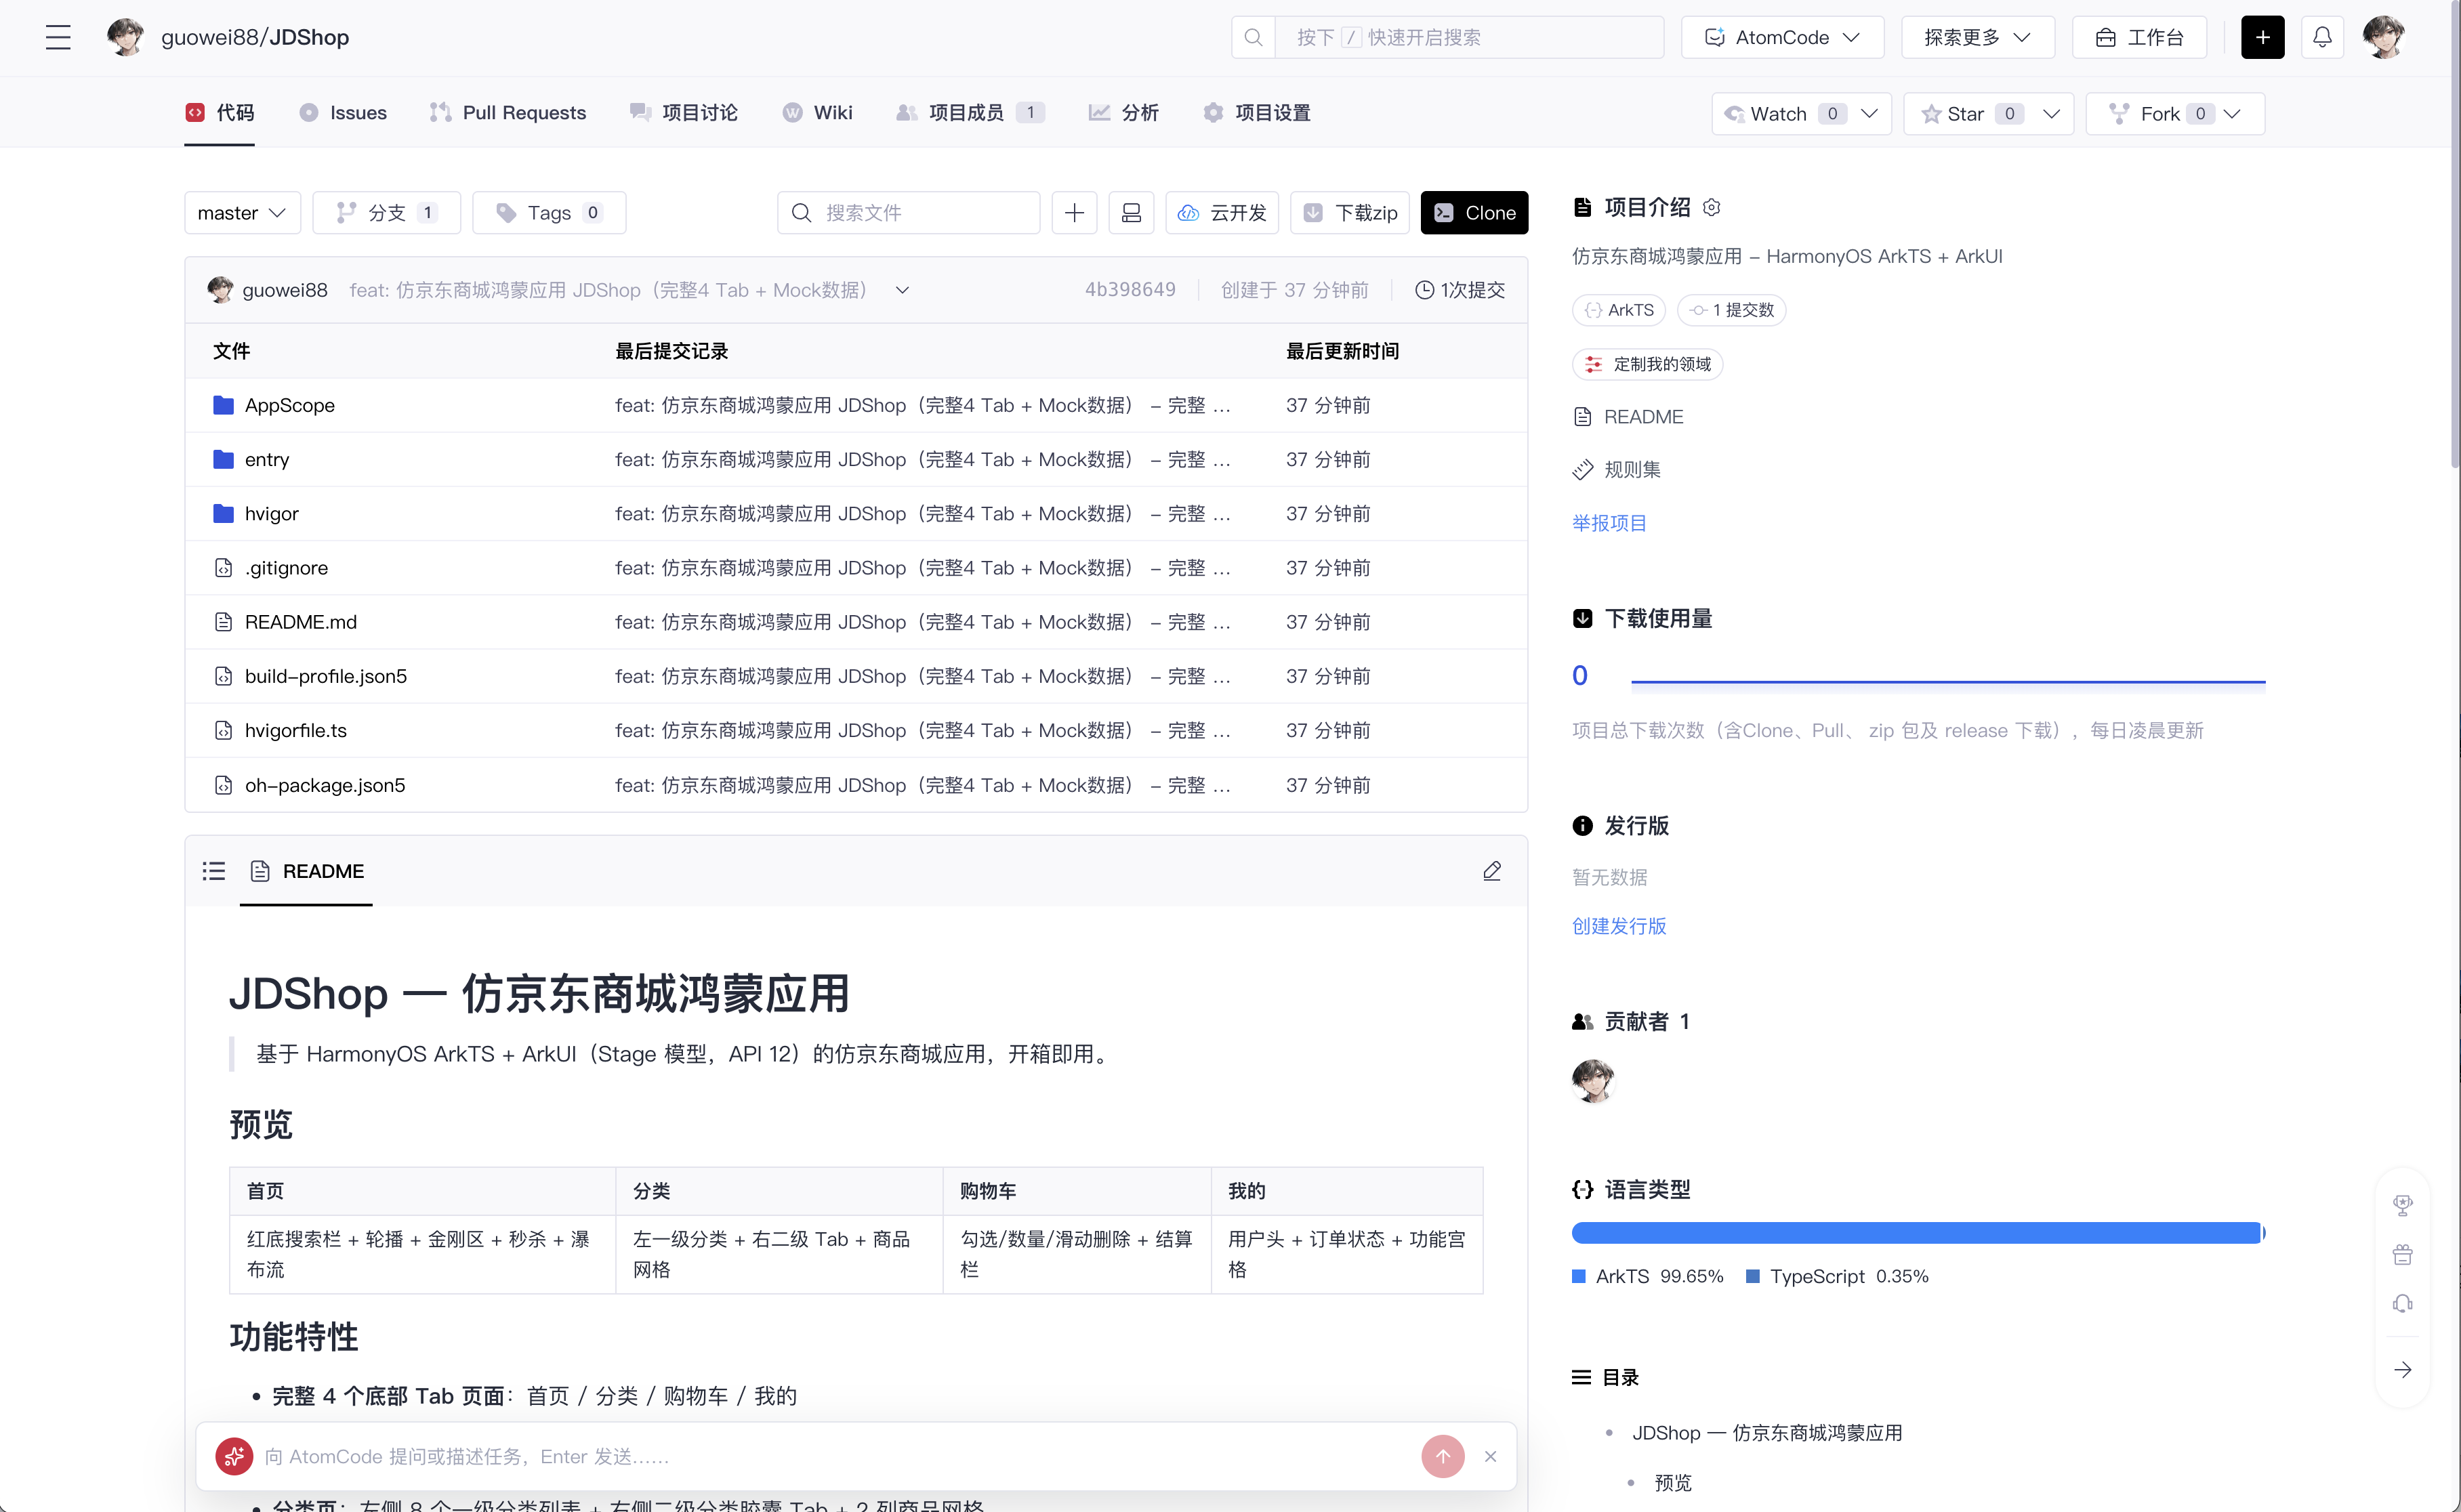
最终仓库返回的总结是这样几行:位置 /workspace/JDShop,分支 master,初始提交 4b39864,43 个文件、2481 行代码,耗时 1 分 11 秒(首次生成),缓存命中 100%。
| 交付指标 | 数值 |
|---|---|
| 工程路径 | /workspace/JDShop |
| 文件总数 | 43 |
| 代码行数 | 2481 |
| 默认分支 | master |
| 初始提交 | 4b39864 |
| 语言占比 | ArkTS 99.65% / TypeScript 0.35% |
| 运行要求 | DevEco Studio 5.0+,API 12,无需签名、无需后端、无需联网 |
| 远端地址 | https://atomgit.com/guowei88/JDShop |
仓库首页的 README 也不是一句占位说明,而是按功能特性、工程结构树、设计规范(京东红 #E9383D)、运行环境与运行方式、技术要点(ArkTS V2 响应式架构、购物车跨页面联动、图片失败回退)、MIT License 分了六块。首页、分类、购物车、我的四个 Tab 的功能点都有对应描述。
图 18:AtomGit 仓库首页,master 分支、43 个文件全部就位,语言占比 ArkTS 99.65%,README 的"预览"一节甚至用表格列出了四个 Tab 各自负责什么。
八、操作链路全景:一张图看清它做了什么
把前面六节串起来,这条链路的形状是清楚的——先对齐、再探路、后施工,最后交付并验证。
九、新手手写 vs AI 生成:把同一条链路拆成两列
接下来是本文的核心对比。我不打算讲"AI 更快"这种没有信息量的话,而是按具体环节逐项对照。
| 环节 | 新手手写 | AI 智能体生成 | 差距的本质 |
|---|---|---|---|
| 需求澄清 | 需求散在脑子里,边写边改 | 三轮 question,锁定范围/数据/形态 | 返工成本是否被前置 |
| 技术选型 | 容易卡在版本与配置组合上 | 直接落到 ArkTS + ArkUI Stage 模型 + API 12 | 经验密度 |
| 工程骨架 | 目录随手建,做到第三页才重构 | 一次性铺出标准 Stage 工程树 | 有没有"先定结构"的意识 |
| 环境问题 | 遇到编译报错再回头查 | 动手前先探 hvigor/ohpm/SDK,并如实说明局限 | 失败模式是否被提前规避 |
| 资源缺失 | 图标缺失导致编译失败,反复试 | 预判 $media:icon 与 startWindowIcon,生成占位 PNG | 对隐式引用的掌握程度 |
| 编码产出 | 四个 Tab 通常要跨天完成 | 43 个文件 / 2481 行,单次会话产出 | 产量不是一个量级 |
| 版本管理 | 手动 init/add/commit,容易漏 .gitignore | 全流程自动执行,并在推送前检查凭据 | 流程规范度 |
| 文档 | 常被省略,或只写一句"启动方式" | 自动产出六段式 README,含契约与边界 | 交付完整性 |
| 异常中断 | 报错即卡住,进度停摆 | 遇到配额错误、未登录,仍能换方案续做 | 恢复能力 |
| 最终验收 | 靠肉眼点一遍 | 同样需要人工打开页面核对 | 这一段谁都不省 |
这张表里有两列我想单独说明。
第一列是"环境问题"和"资源缺失"。这两项是新手和 AI 差距最大的地方,但差距不在"AI 懂得多",而在于它把排查从"事后救火"改成了"事前设防"。新手是在构建失败之后才认识 hvigor 的,而它是在动手之前就确认了 hvigor 不存在,并且据此改了交付策略。这个习惯是可以学的:动工前花三十秒把工具链和隐式资源依赖过一徧。
第二列是最后一项"最终验收"。上一节开头那份 README 写得再全,也挡不住页面在真机上跑起来是歪的。43 个文件和 2481 行代码是"产出量",不是"可用度"。 沙箱里既没有 hvigor 也没有设备,图片失败回退、购物车跨页联动、四个 Tab 的滚动惯性这些事,只有把工程拉到 DevEco Studio 里打开、运行,才知道成不成。这一点上,AI 没有任何优势,它只是把"该你验的部分"给你留得更清楚了。
十、写在最后
如果把我这次记录压缩成三句话,大概是这样的。
第一,AI 生成的起点不是代码,是问题。 三张截图里的三轮提问,看起来只是几句选择,实际上决定了后面生成 43 个文件还是 8 个文件。对新手来说,最该先学的不是写 ArkTS,而是"动手前把范围问清楚"。
第二,它最可靠的能力是把工程骨架和配置引用一次对齐。 从 Stage 模型目录到 $media:icon 的占位处理,这些是纯经验活,新手要摔几次才能记住,而它一次就能做对。这部分的收益是实打实的。
第三,它替代不了你打开页面那一眼。 沙箱没有工具链、没有设备,编译不了也跑不起来。真正决定这个应用能不能用的,还是把工程拷到本地 DevEco 里运行的那一刻。
回到最初那个"简单的游戏功能"需求上。如果现在让我重做一次,我会把这套流程照搬一遍:先用三轮问题把范围、数据、交付形态钉死,让它铺出标准工程骨架和占位资源,拿到一套能编译的起点;然后自己接管核心玩法逻辑——因为游戏的手感、节奏、反馈这些东西,从来不是配置问题,也不是脚手架能替你决定的。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献116条内容

所有评论(0)