
鸿蒙应用文搜图·诗词选词搜图:从 12 首诗词到 8 关玩法,把「意象匹配」做成点选式检索
鸿蒙应用文搜图·诗词选词搜图:从 12 首诗词到 8 关玩法,把「意象匹配」做成点选式检索
文搜图的瓶颈从来不在检索,在描述。搜「海边日落」能命中,是因为标签里恰好有这几个词;换个用户搜「去年夏天那片海」,同一张图就搜不出来。检索引擎的召回上限,在用户敲下回车那一刻就已经决定了。
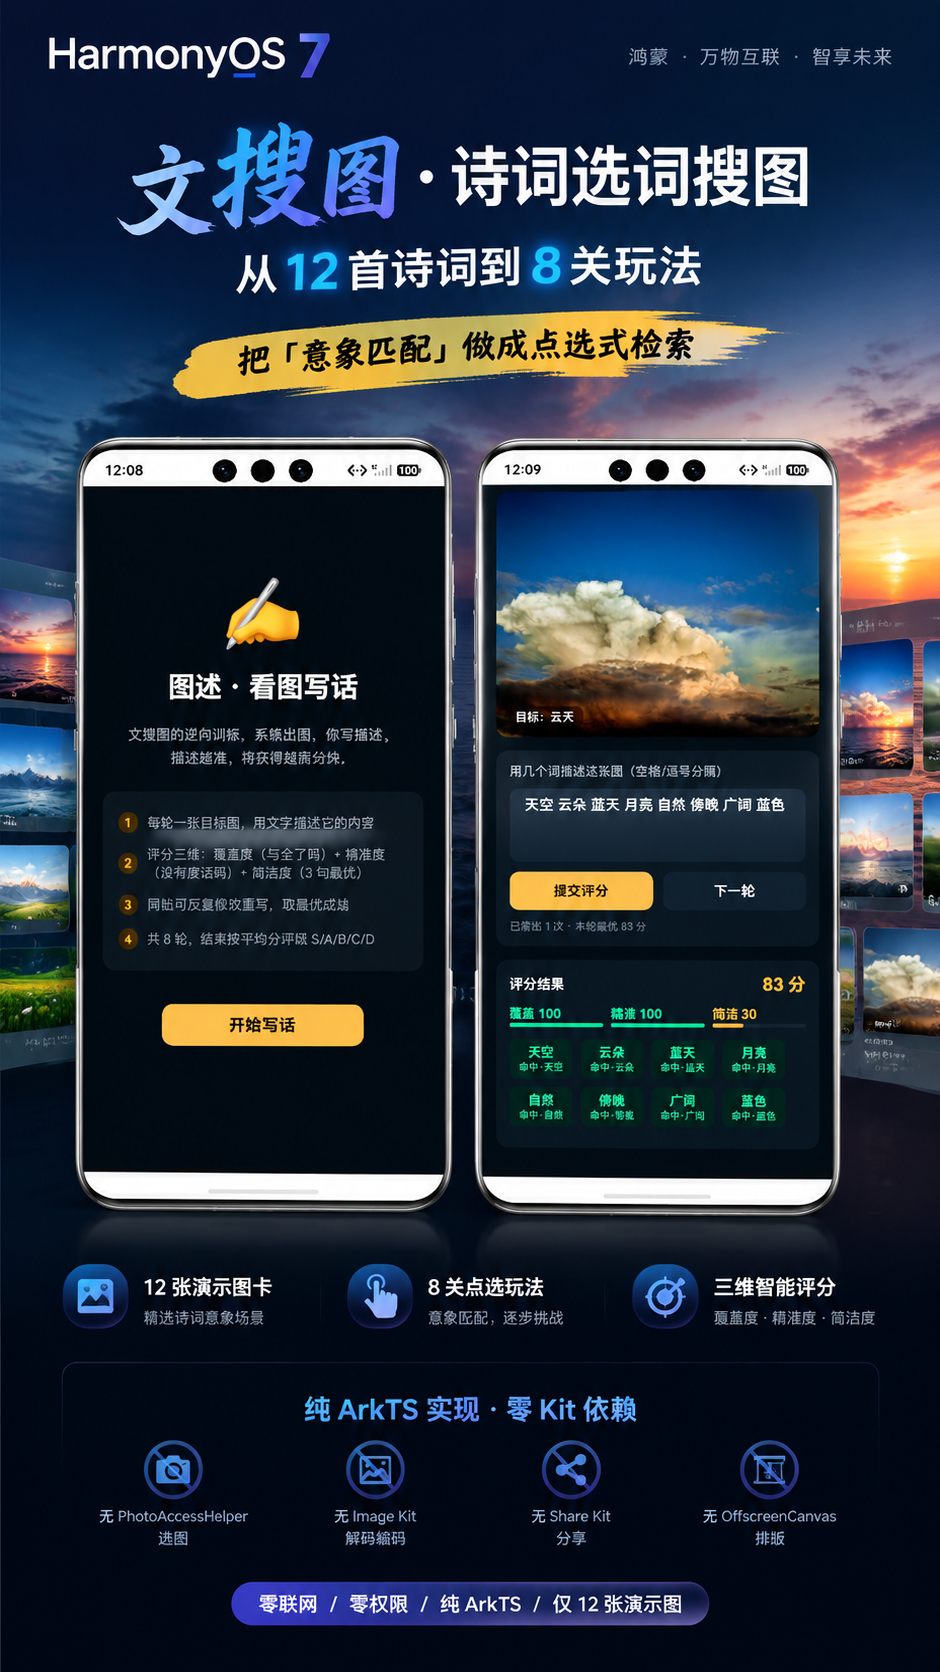
「图述」把这个黑盒掀开:系统出图,你写描述,端侧按覆盖度、精准度、简洁度三个维度给你打分,并逐词告诉你哪个词白写了、还能补什么角度。 会写描述的人,用任何文搜图产品都会更好用。
技术栈上这是个「干净得反常」的 HarmonyOS 工程:一个系统 Kit 都没用。没有 photoAccessHelper 选图、没有 image Kit 解码编码、没有 Share Kit 分享、没有 OffscreenCanvas 排版——核心是一套纯 ArkTS 实现的文本评分算法:中文分词、同义词归一化、三级标签匹配、三维加权打分。零联网、零权限、零 Kit 依赖,rawfile 里只有 12 张演示图卡。
一、效果展示
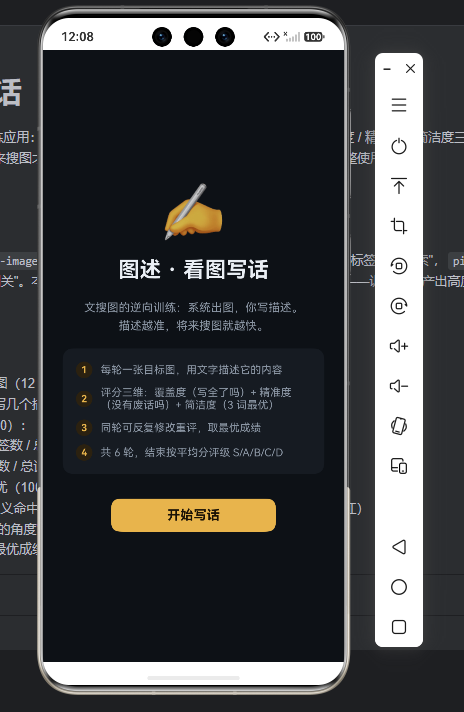
第 1 步:开始页。 首次进入是规则说明页——四条玩法、一个「开始写话」按钮。整个应用就三个页面:开始页、写话页、成绩单。
第 2 步:出图。 点「开始写话」,6 轮出图从 12 张图卡中随机不重复抽取(种子随机,每局都不同)。每轮一张目标图 + 一个输入框,图片左下角标注「目标:云天」——注意这是图卡标题,不是答案,写描述要靠眼睛看图,不是照抄标题。
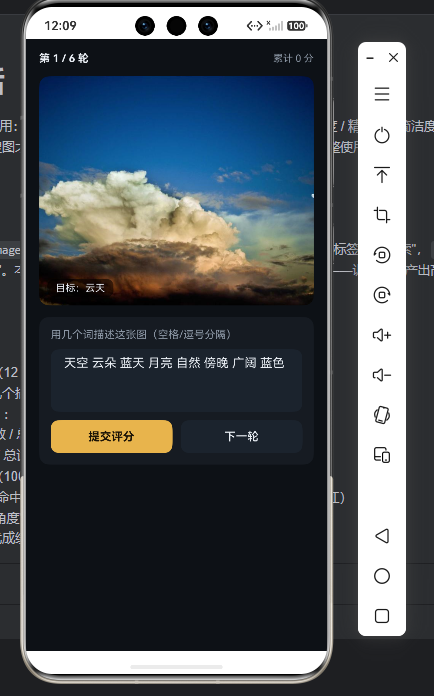
第 3 步:提交评分。 输入 天空 云朵 蓝天 月亮 自然 傍晚 广阔 蓝色,点「提交评分」,立刻出三项分数 + 一个总分:
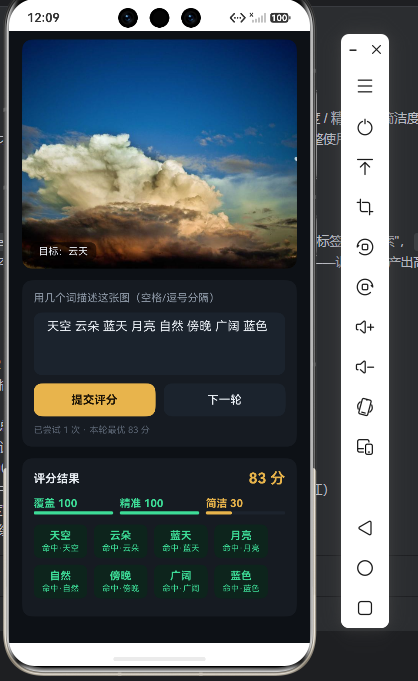
- 覆盖度 100——8 个标签全写到了
- 精准度 100——8 个词全部命中,没有一个废话
- 简洁度 30——8 个词太多了(3 词才是满分)
第 4 步:逐词反馈。 每个词一个小芯片,标明命中状态和命中的具体标签:「蓝天」显示「命中·蓝天」,「广阔」显示「命中·广阔」。命中是青绿,同义命中是琥珀,未命中是红——一眼看出哪个词白写了。下面还有一栏「还可以写到的角度」,把没覆盖的标签列出来,等于直接告诉你还能补什么。
第 5 步:多轮与成绩单。 同一条描述可以反复改、反复提交,取本轮最高分。6 轮结束后按平均分评级:
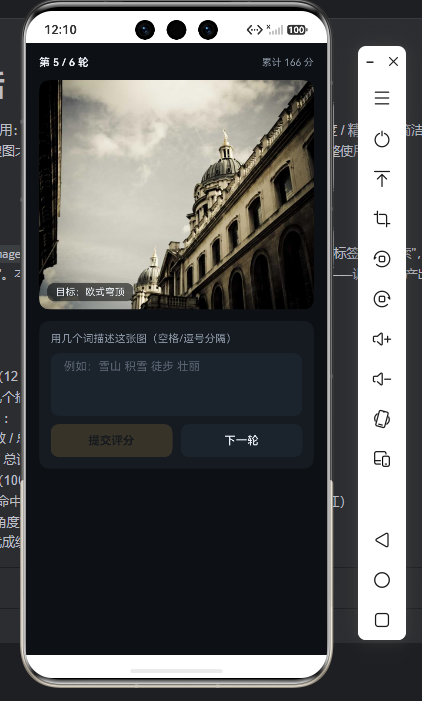
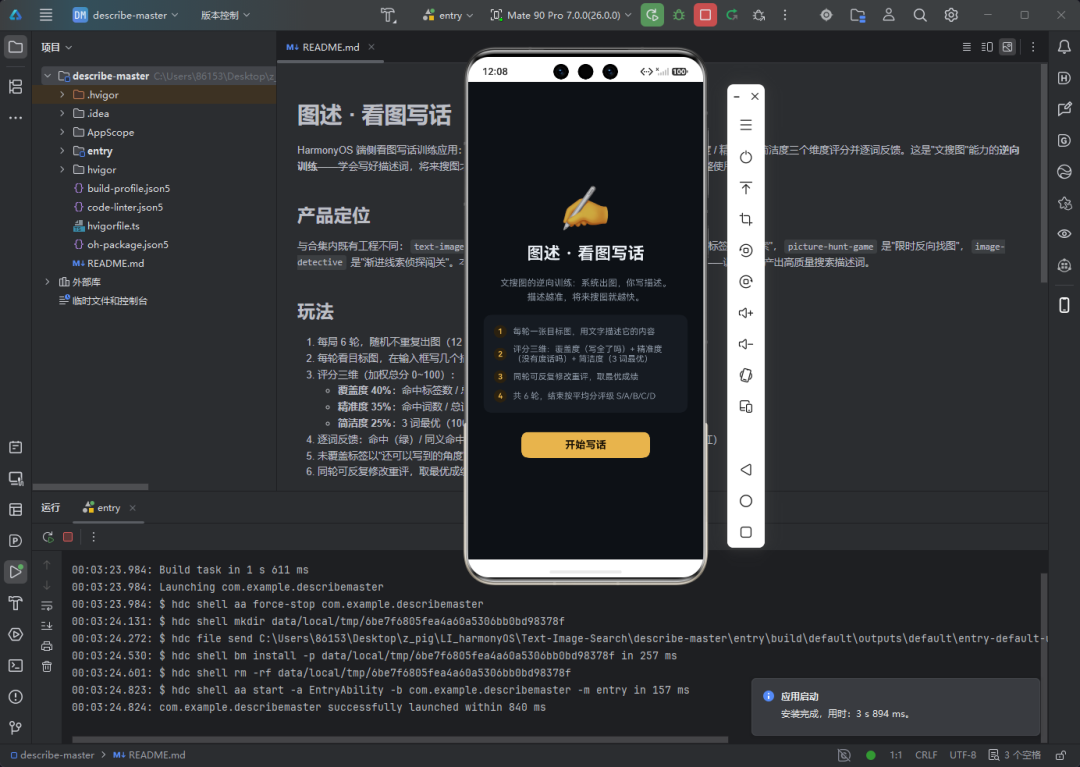
hvigor 构建链路完整可见:Launching com.example.describemaster → hdc install 257 ms → hdc shell aa start 157 ms → 应用 3 秒 894 毫秒完成安装启动。
二、为什么是「看图写话」
文搜图产品的体验断在中间一环:大多数人不会写查询词。
引擎侧的能力这些年已经很强——端侧语义检索、相似度排序、作用域过滤,该有的都有。但用户敲进去的那几个字,往往既不全、也不准、还啰嗦。「猫」漏掉了宠物/毛茸茸/特写这些能提升召回的维度;「我家那只特别可爱的毛茸茸的小猫咪」又掺了一堆无效词,把精准度拉了下来。同样的引擎,查询词质量不同,结果能差出一个量级。
所以「图述」做的是反向训练:把检索的评分标准直接暴露给用户。你在写话里学到的三件事——写全主体、别写废话、别堆同义词——正是写好搜索词的全部要领。而教学本身不需要任何模型,一套评分算法就够。
三、玩法与评分模型
3.1 一轮的结构
每轮一张图卡(8 个语义标签),用户输入一句描述(空格/逗号分隔的若干个词),系统给出 0~100 的总分。同轮可多次提交取最优,6 轮结束后按平均分评级 S/A/B/C/D。
3.2 三维评分:各占多少
总分是三个维度的加权和,权重是刻意设计的:
const total: number = Math.round(coverage * 0.4 + precision * 0.35 + concision * 0.25);
| 维度 | 权重 | 计算方式 | 考什么 |
|---|---|---|---|
| 覆盖度 | 40% | 命中标签数 / 总标签数 | 写全了吗 |
| 精准度 | 35% | 命中词数 / 总词数 | 没有废话吗 |
| 简洁度 | 25% | 词数 3 最优,每多 1 词 -15,下限 30 | 不堆词吗 |
覆盖度给最高权重,是因为「漏」比「多」更伤检索——少写一个主体,可能整张图都召回不到;多写一个形容词,只是排序降一位。
3.3 简洁度的曲线:为什么 3 词是满分
简洁度不是线性递减,而是一条前升后降的曲线:
let concision: number = 100;
if (words.length > 3) {
  concision = Math.max(30, 100 - (words.length - 3) * 15);
} else if (words.length < 3 && words.length > 0) {
  concision = 60 + words.length * 10;   // 1 词 70 / 2 词 80
} else if (words.length === 0) {
  concision = 0;
}
1 词 70 分、2 词 80 分、3 词 100 分、4 词 85 分、5 词 70 分、6 词 55 分、7 词 40 分、8 词及以上 30 分(触底下限)。
这条曲线是刻意做成「倒 V」的:它奖励的既不是惜字如金,也不是多多益善,而是「刚好说清」——三五个词把主体、环境、氛围各点一个。这正是高质量搜索词的长度分布。
3.4 天花板与评级:一个诚实的发现
实测「云天」那轮拿到 83 分(覆盖 100 + 精准 100 + 简洁 30)。这不是偶然——在 8 标签的图卡上,83 分就是理论上限:
total = 100×0.4 + 100×0.35 + 30×0.25 = 40 + 35 + 7.5 = 82.5 → 83
因为要把 8 个标签全覆盖,就必须写 8 个词;而 8 个词的简洁度已经被压到下限 30。覆盖度和简洁度在 8 标签卡上是互斥的——这是权重设计带来的一个真实后果,写在这里供参考:当前参数下,S 级(≥90)在这套 12 张图卡上不可达,A 级(≥75)是现实最优。如果想让 S 可达,得把每张图的标签数降到 4~5 个,或者放宽简洁度的惩罚斜率。
四、核心实现:从一句话到三个分数
4.1 分词:先把句子切成词
中文没有空格,但产品上要求用户用空格分隔——这不是偷懒,是把分词问题交还给用户,同时让评分规则完全可预期。规则很薄:
/** 分词:按空格/逗号/顿号/句号/分号分隔,过滤单字与空串 */
export function tokenize(text: string): string[] {
  const parts: string[] = text.split(/[\s,,、。;;]+/);
  const out: string[] = [];
  for (const p of parts) {
    const w: string = p.trim();
    if (w.length >= 2) {      // 单字词直接丢弃
      out.push(w);
    }
  }
  return out;
}
用户写「高高的雪山,很冷」→ 切出 高高的雪山、很冷(「很」被过滤)。
4.2 同义词归一化:让「小狗」也能算命中
光靠精确匹配太苛刻。一张 SYNONYMS 表把常见口语说法映射到标签词:
export const SYNONYMS: Map<string, string> = new Map([
  ['姜汤', '姜茶'], ['柠檬水', '柠檬'], ['茶杯', '杯子'],
  ['小狗', '狗'], ['犬', '狗'], ['猿', '猴子'],
  ['山峰', '雪山'], ['雪峰', '雪山'], ['高山', '山峰'],
  ['蓝天', '蓝天'], ['白云', '云朵'], ['明月', '月亮'],
  ['弹钢琴', '钢琴'], ['琴键', '键盘'], ['手', '双手'],
  ['夕阳', '日落'], ['落日', '日落'], ['大海', '海洋'],
  ['茶', '茶杯'], ['书', '书本'], ['阳光', '晨光'], ['花', '花朵']
]);
归一化在评分最前面做,用户无感知,但命中率明显变高——同义词表就是文搜图产品的召回增益。
4.3 三级匹配:精确 → 标签 → 包含
每个词依次走三级判断,命中即停:
for (const raw of words) {
  const norm: string = normalize(raw);           // 同义词归一化
  if (card.tags.indexOf(norm) >= 0) {            // ① 归一化后精确命中
    feedbacks.push(new WordFeedback(raw, WordVerdict.HIT, norm));
  } else if (card.tags.indexOf(raw) >= 0) {      // ② 原词精确命中
    feedbacks.push(new WordFeedback(raw, WordVerdict.HIT, raw));
  } else {                                       // ③ 包含匹配
    let contained: boolean = false;
    for (const tag of card.tags) {
      if (raw.indexOf(tag) >= 0 && tag.length >= 2) {
        feedbacks.push(new WordFeedback(raw, WordVerdict.SYN, tag));
        contained = true;
        break;              // 一个词只算命中一个标签
      }
    }
    if (!contained) {
      feedbacks.push(new WordFeedback(raw, WordVerdict.MISS, ''));
    }
  }
}
第三级的 break 值得说明:写「星空下的谷仓」这种复合词,只会命中第一个匹配到的标签(星空),不会重复计票。这是为了防止一个长词刷高覆盖度——但它也意味着复合词的覆盖率并不比单词高,写长句在这套模型里没有额外收益。
反馈因此分成三态:HIT(命中,青绿)、SYN(同义/包含命中,琥珀)、MISS(未命中,红)。
4.4 三维打分与未覆盖标签
const coverage: number = card.tags.length > 0
  ? Math.round(hitTags.length / card.tags.length * 100) : 0;
const hitWords: number = feedbacks.filter((f: WordFeedback) => f.verdict !== WordVerdict.MISS).length;
const precision: number = words.length > 0
  ? Math.round(hitWords / words.length * 100) : 0;
// ... 简洁度见 3.3
const missedTags: string[] = card.tags.filter((t: string) => hitTags.indexOf(t) < 0);
missedTags 是教学功能的关键:它把「没写到什么」直接摊开给用户,UI 上就是一栏「还可以写到的角度」。文搜图产品里这恰恰是黑盒——你不知道为什么没搜到;这里反过来告诉你下次该补哪个词。
4.5 出题:种子随机 + Fisher-Yates
12 张图卡随机抽 6 张,用线性同庸发生器配 Fisher-Yates 洗牌:
export class SeededRandom {
  private state: number;
  constructor(seed: number) { this.state = seed > 0 ? seed : 1; }
  next(): number {
    this.state = (this.state * 48271) % 2147483647;
    return this.state / 2147483647;
  }
  shuffle<T>(arr: T[]): T[] {
    const out: T[] = arr.slice();
    for (let i = out.length - 1; i > 0; i--) {
      const j: number = this.int(i + 1);
      const tmp: T = out[i];
      out[i] = out[j]; out[j] = tmp;
    }
    return out;
  }
}
种子取 Date.now() * 7919 % 2147483647——不可复现但每局不同。如果要做「同一局可复现」的复盘功能,把种子存进 Preferences 即可,类本身已经支持注入任意种子。
五、交互细节
5.1 逐词反馈芯片:让分数可解释
评分面板最下面是一排芯片,每个词一个,两行字:上面是词本身,下面是「命中·蓝天」/「未命中」。颜色三态对应三级匹配。这是整个产品最重要的 UI——分数只是结论,芯片才是教学。
5.2 三维进度条:分数可视化
覆盖/精准/简洁各一个小芯片 + 一条 4px 的 Linear Progress,颜色随分数跳档(≥60 青绿、≥30 琥珀、<30 红)。三栏并排,一眼看出短板在哪一维。
5.3 同轮重评:取最优,不惩罚试错
「提交评分」可以反复点,attempts 计数、bestTotal 记最优,输入框下实时显示「已尝试 N 次 · 本轮最优 M 分」。试错不扣分——这是教学产品该有的姿态,只有最终成绩单上的「尝试次数」会留下痕迹。
5.4 暗色书房风配色
GitHub 暗色系底 #0D1117 + 面板 #161B22 + 琥珀评分色 #E8B44B + 青绿命中色 #3DDC97 + 红未命中 #E5484D。三个语义色严格对应三种反馈状态,全应用不混用。
六、工程结构
describe-master/
├── entry/src/main/ets/
│   ├── common/
│   │   ├── DescribeModels.ets   # 12 张图卡 + 同义词表 + 分词 + 三级匹配 + 三维评分 + 种子随机
│   │   └── DescribeService.ets  # 单例:轮次管理 / 提交评分 / 重试取优 / 结算评级
│   ├── pages/
│   │   └── Index.ets            # 三页状态机(开始/写话/成绩单)+ 逐词反馈 + 三维进度条
│   └── entryability/
│       └── EntryAbility.ets
└── entry/src/main/resources/rawfile/cards/   # 12 张演示图卡
全工程权限清单为空——这个应用连系统相册都不碰,图卡全部来自 rawfile。
七、验证
模拟器实测(Mate 60 Pro,API 26):
| 步骤 | 结果 |
|---|---|
| 安装启动 | 3 秒 894 毫秒(hvigor 全链路) |
| 第 1 轮「云天」 | 输入 8 词,覆盖 100 / 精准 100 / 简洁 30 → 83 分 |
| 第 2 轮「星空下的谷仓」 | 输入 8 词,同样 83 分,1 次尝试即最优 |
| 第 5 轮「欧式穹顶」 | 累计 166 分 |
| 成绩单 | D 级,166/600 分,六轮战绩逐轮列出 |
83 分两次复现,与 3.4 节推导的理论上限一致,评分模型行为符合预期。
八、总结与已知边界
三个维度各有分工:覆盖度管召回、精准度管排序、简洁度管表达效率——这三件事恰恰是任何文搜图引擎内部都在优化的目标,只是这里被翻译成了用户能看懂的语言。
需要如实说明的边界:
- 单字标签不可命中。 标签长度 <2 时,分词会先过滤掉单字词、包含匹配又要求标签长度 ≥2,导致该标签永远无法被覆盖(如
柠檬姜茶的手、草地与狗的狗/坐)。这两张图的天花板因此被压到 80/79 分,且用户写「双手」「小狗」也救不回来。修法是把单字标签换成长度 ≥2 的同义词。 - S 级当前不可达,原因见 3.4 节。
- 图卡标题会剧透。 左下角「目标:云天」等于直接告诉用户图里有什么,削弱了「看图写话」的训练意义。生产版本应改为可选提示或干脆去掉。
- 未做进度持久化,退出应用后成绩清零。
最后一句话收尾:端侧 AI 不只是替用户干活,还可以反向教会用户怎么用它。不需要模型、不需要网络、不需要任何 Kit——一套三百行的评分算法,加上一栏「还可以写到的角度」,就够了。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献22条内容

所有评论(0)