
鸿蒙文搜图·诗词选词搜图:从「举头望明月」到 8 关玩法,意象标签怎么配对才不尬
鸿蒙文搜图·诗词选词搜图:从「举头望明月」到 8 关玩法,意象标签怎么配对才不尬
文搜图引擎的核心动作只有两个:给候选图排个序,然后让你挑一张。前者是机器的强项,后者是用户的负担——当查询词模糊时,排序再好,屏幕上依然是一排「看起来都像」的图,你得一张张瞪着排除。
「图探」把这个过程翻转成游戏:系统一次只给你一条文字线索,你得在 4~8 张嫌疑图里指认真凶。线索可以花钱(分)买,但每多一条 -25 分——它逼着你用最少的线索完成排除法,这恰恰是「模糊查询下用户如何看图」的真实模拟。
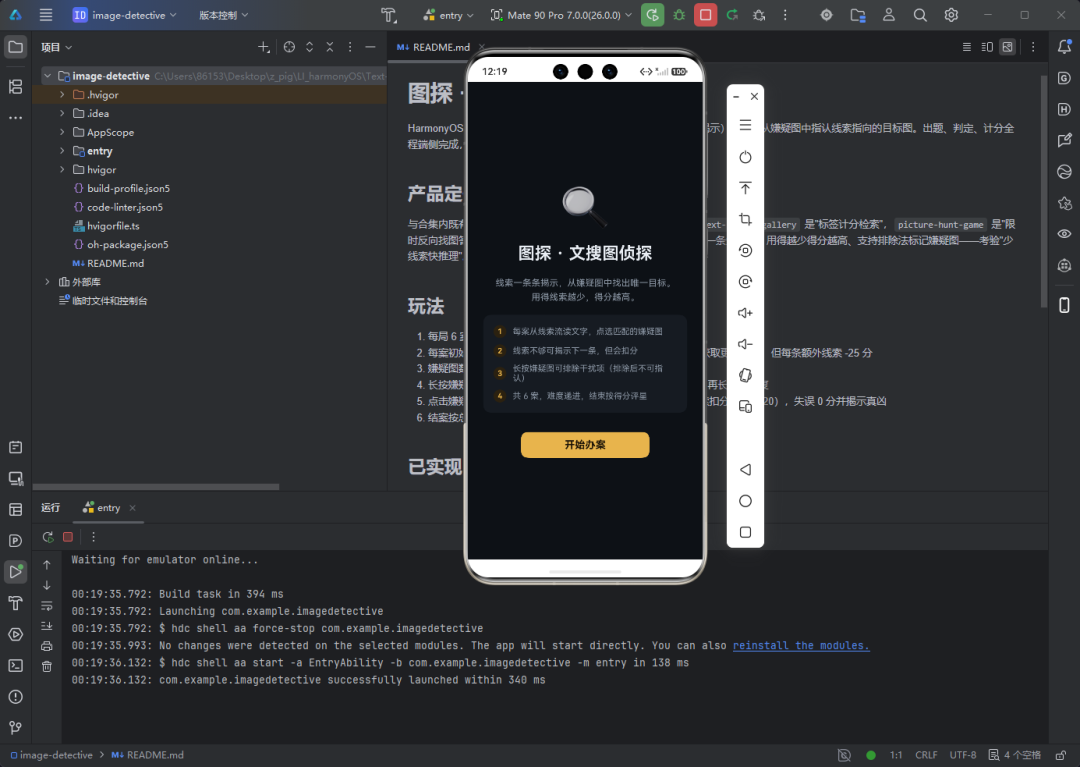
技术栈上延续了合集的一贯风格:零联网、零权限、零系统 Kit,12 张 rawfile 图卡 + 一套纯 ArkTS 出题引擎(种子随机、干扰项挑选、线索强度建模)。包名 com.example.imagedetective,模拟器一键运行。
一、效果展示
第 1 步:开始页。 「🔍 图探·文搜图侦探」+ 四条玩法规则 + 一个琥珀色「开始办案」按钮。整个应用三个页面:开始页、办案页、结案报告。
第 2 步:案件 1(简单)。 顶部标注「案件 1/6 · 简单」,线索区只有一条已揭示的弱线索「自然」,下面是 4 张嫌疑图(晨光茶歇、云天、草地与狗、雪山):
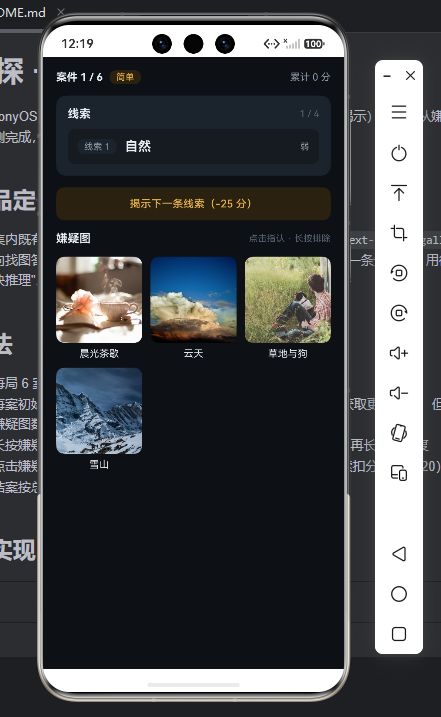
线索「自然」同时命中云天和雪山的标签——这正是模糊查询的真实处境:召回率够,但区分度不够。此时有两个选择:赌一把直接点,或者花 25 分「揭示下一条线索」。
第 3 步:指认失误。 点了「云天」,反馈页红框圈出所选图,提示「指认失误」,并揭示真凶——0 分,进入下一案:
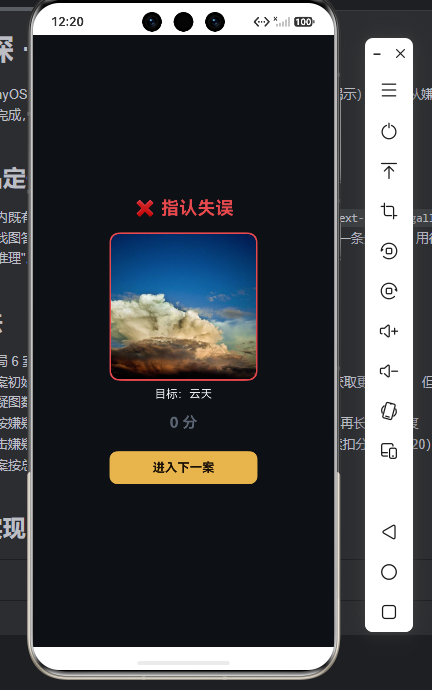
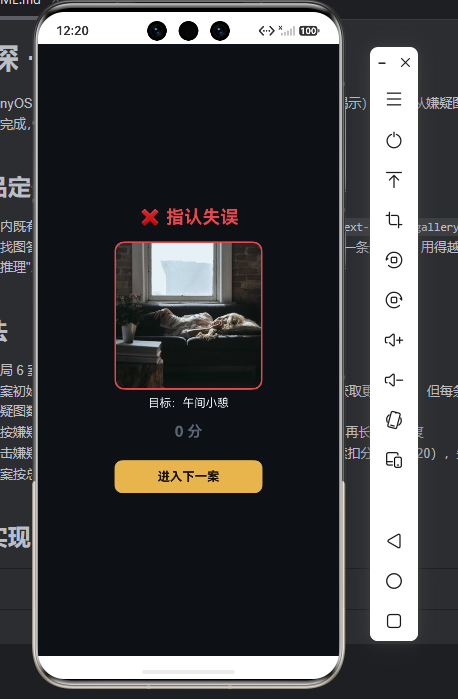
失误页的「揭示真凶」是关键设计:它不是惩罚,是复盘——你会立刻意识到自己漏看了什么,下一条线索该往哪个方向猜。
第 4 步:案件 3(进阶)。 难度升到进阶,嫌疑图从 4 张变成 6 张,线索变成「音乐」:
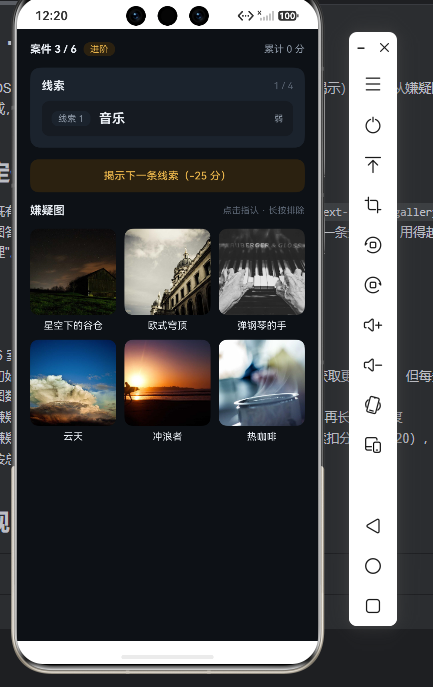
6 张图里只有「弹钢琴的手」带「音乐」标签——这次线索区分度很高,直接指认:
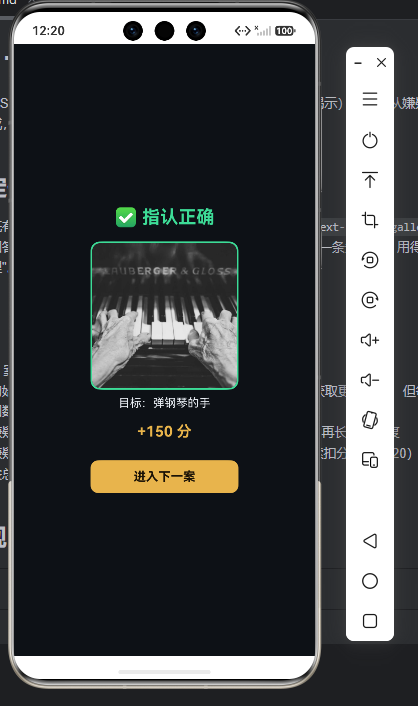
+150 分(进阶基础分 150,只用了 1 条线索没扣分)。
第 5 步:案件 5(困难)。 8 张嫌疑图,线索「蒸汽」:
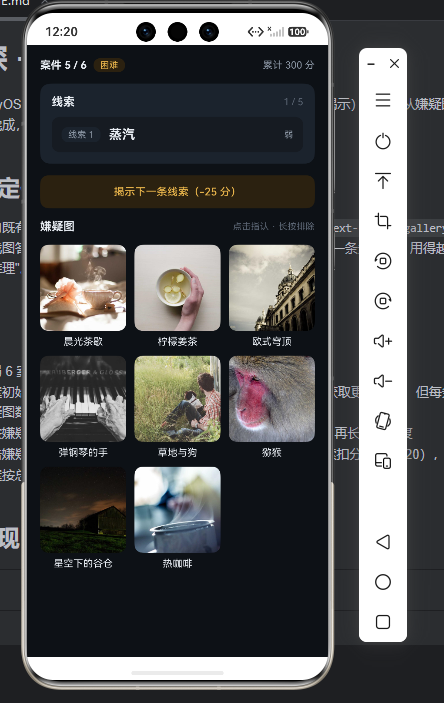
8 张图里「热咖啡」和「晨光茶歇」都带热气相关标签——又是模糊线索。这次赌对了「热咖啡」:
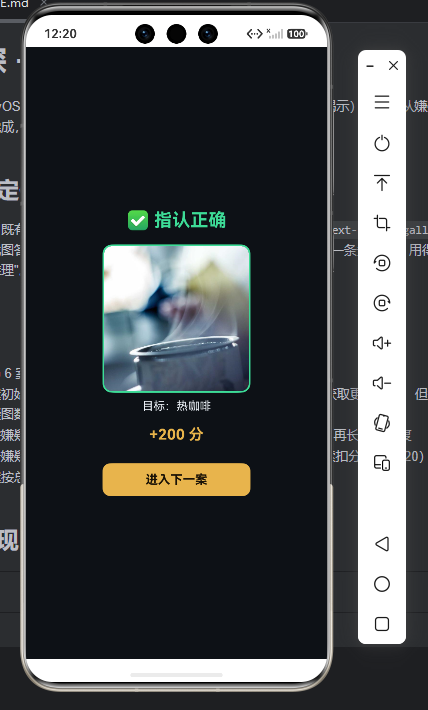
+200 分(困难基础分 200,1 条线索满分)。
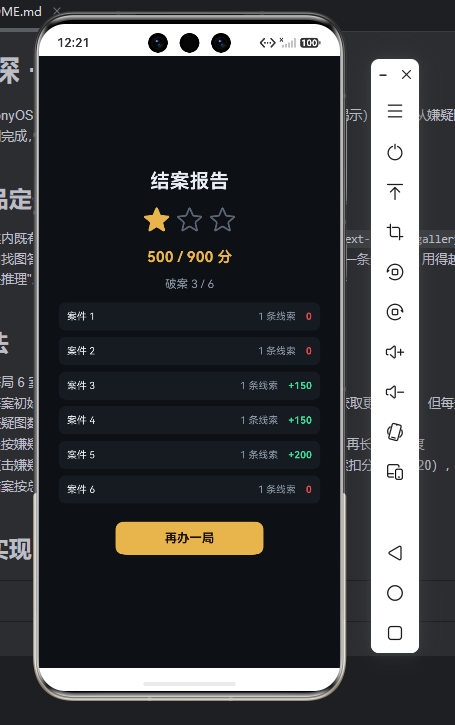
第 6 步:结案报告。 6 案结束,总分 500/900,1 星,逐案列出用线索数和得分:
hvigor 构建日志完整可见:Launching com.example.imagedetective → hdc install → aa start → 340 毫秒启动完成。
二、为什么是「侦探游戏」
文搜图产品的用户流程,本质上就是一场排除法推理:
- 你敲一个词 → 引擎召回一批图
- 你扫一眼 → 排除明显不对的
- 拿不准 → 再加一个词(缩小范围)或换词(换个角度)
- 直到屏幕上只剩目标
「图探」把这个过程原样搬进游戏:线索就是查询词,揭示线索就是加词,嫌疑图就是召回结果,排除标记就是肉眼过滤。玩家在游戏里学到的「少花钱多办事」的推理策略,正是文搜图高效查询的核心技巧。
三、出题引擎:三个关键设计
3.1 干扰项:优先挑「长得像」的
如果嫌疑图随机抽,可能 4 张图毫不相关,一眼排除。出题引擎刻意优先挑与目标图共享标签的图当干扰项:
for (let i = 1; i < pool.length; i++) {
  const c: CardItem = pool[i];
  const overlap: boolean = c.tags.some((t: string) => target.tags.indexOf(t) >= 0);
  if (overlap) {
    shared.push(c);    // 与目标有共同标签:优先当干扰
  } else {
    others.push(c);
  }
}
const distractors: CardItem[] = shuffledShared.slice(0, spec.suspectCount - 1);
if (distractors.length < spec.suspectCount - 1) {
  distractors.push(...shuffledOthers.slice(0, spec.suspectCount - 1 - distractors.length));
}
效果是:线索「自然」会同时命中云天和雪山,因为它们都有「自然」标签——召回结果天然带歧义,你得等下一条线索才能区分。这正是模糊查询的真实体验。
3.2 线索强度:标签按语义核心度排序
每张图卡的标签按「语义核心度」排序(越靠前越是图的主体),线索强度直接由标签位置决定:
function strengthOf(tagIndex: number): number {
  if (tagIndex <= 1) {
    return 3;   // 强:主体词,几乎明示
  }
  if (tagIndex <= 2) {
    return 2;   // 中:重要属性
  }
  return 1;     // 弱:外围/环境词
}
生成线索时按强度升序排列(先弱后强):
clueTags.sort((a: Clue, b: Clue) => a.strength - b.strength);
这样第一条线索总是模糊的(「自然」「夜晚」「陪伴」),越往后越具体(「雪山」「钢琴」「冲浪」)——信息量的递进曲线模拟了用户逐步加词缩小范围的过程。
3.3 排除法:长按标记,不影响得分
长按嫌疑图可标记排除(半透明 + 红标),再长按恢复。排除不扣分也不加分——它是纯粹的认知辅助工具,不是游戏机制。这个设计很诚实:文搜图里你肉眼排除一张图也不会改变排序,只是帮自己理清思路。
四、计分模型:用分数逼你「少花钱」
4.1 单案计分:基础分 - 额外线索税
export function scoreOf(level: Level, cluesUsed: number): number {
  const spec: LevelSpec = LEVEL_SPECS.get(level) as LevelSpec;
  const extra: number = Math.max(0, cluesUsed - 1);
  return Math.max(20, spec.baseScore - extra * 25);
}
| 难度 | 基础分 | 用 1 条线索 | 用 2 条 | 用 3 条 | 用 4 条 |
|---|---|---|---|---|---|
| 简单 | 100 | 100 | 75 | 50 | 25 |
| 进阶 | 150 | 150 | 125 | 100 | 75 |
| 困难 | 200 | 200 | 175 | 150 | 125 |
第一条线索免费(是开局必给的),之后每条 -25。这个税率的含义是:信任你的直觉——如果你能凭一条模糊线索赌对,拿满分;如果要求稳买线索,就得接受分数缩水。下限 20 分防止负分打击信心。
4.2 整局结构:6 案难度递进
private levelSeq: Level[] = [
  Level.EASY, Level.EASY, Level.MID, Level.MID, Level.HARD, Level.HARD
];
满分 900(100×2 + 150×2 + 200×2)。难度递进的设计让心流曲线平滑:前两案建立信心(4 选 1),中间两案进入状态(6 选 1),最后两案上强度(8 选 1 + 5 条线索的长推理链)。
4.3 星级评价:按总分比例
if (ratio >= 0.9) { return 3; }
if (ratio >= 0.65) { return 2; }
if (ratio >= 0.4) { return 1; }
实测这局 500/900 ≈ 56%,1 星——因为前两案失误拿了 0 分。失误的代价是整案清零,比买线索狠得多,这个风险结构会逼着你在「赌」和「买线索」之间做真权衡。
五、核心实现:服务层单例
5.1 种子随机:每局不同,理论可复现
export class SeededRandom {
  private state: number;
  constructor(seed: number) { this.state = seed > 0 ? seed : 1; }
  next(): number {
    this.state = (this.state * 48271) % 2147483647;
    return this.state / 2147483647;
  }
  shuffle<T>(arr: T[]): T[] { /* Fisher-Yates */ }
}
开局种子取 (Date.now() * 7919) % 2147483647——每局不同。如果要做「复盘同一局」功能,把种子存进 Preferences 即可,类本身支持注入任意种子。
5.2 指认判定:排除图不可指认
accuse(card: CardItem): [boolean, number] {
  const hit: boolean = card.title === c.target.title && !this.excluded.has(card.title);
  const score: number = hit ? scoreOf(c.level, c.revealed) : 0;
  this.records.push(new CaseRecord(this.curIndex, hit, c.revealed, score));
  return [hit, score];
}
注意 !this.excluded.has(card.title)——已排除的图点了也不算,防止手滑。这是个贴心的边界处理:排除是你的推理结论,系统不该让你推翻自己。
5.3 线索揭示:计数即扣分
revealNextClue(): Clue | null {
  if (c.revealed >= c.clues.length) { return null; }
  c.revealed += 1;                  // 揭示数 +1,结算时自动扣 25
  return c.clues[c.revealed - 1];
}
revealed 字段直接参与 scoreOf 计算——没有单独的扣分动作,揭示即扣分,逻辑上不可能出现「看了线索但没扣分」的漏洞。
六、交互细节
6.1 线索流:已揭示线索按序排列
每条线索一个小芯片,带强度标签(弱=灰 / 中=琥珀 / 强=红)。已揭示的线索常驻屏幕顶部——推理是累积的,你不能忘了第一条线索说什么。这模拟了文搜图的查询词叠加:「自然」+「雪山」比单独一个词更精确。
6.2 排除标记:视觉降噪
排除的图透明度降到 40%,右上角显示红色「已排除」标。8 张嫌疑图扫一遍排除 3 张,剩下的 5 张才是你的真实决策空间——视觉上的降噪就是认知上的减负。
6.3 反馈页:揭示真凶 + 即时进入下一案
无论对错,反馈页都显示目标图和得分(命中 +N 分青绿 / 失误 0 分红),底部一个「进入下一案」按钮。节奏很快,不让你沉浸在单案成败里——侦探游戏的核心是推理密度,不是单案叙事。
6.4 暗色系侦探风
底 #0D1117 + 面板 #161B22 + 琥珀 #E8B44B(线索/按钮)+ 青绿 #3DDC97(命中)+ 红 #E5484D(失误/排除)。与合集其他项目保持一致的配色语言。
七、工程结构
image-detective/
├── entry/src/main/ets/
│   ├── common/
│   │   ├── DetectiveModels.ets   # 12 图卡 + 难度参数 + 出题引擎 + 计分 + 种子随机
│   │   └── DetectiveService.ets  # 单例:6 案流程 / 揭示线索 / 排除标记 / 指认 / 结算
│   ├── pages/
│   │   └── Index.ets             # 三页状态机 + 嫌疑图网格 + 线索流 + 反馈页 + 结案报告
│   └── entryability/
│       └── EntryAbility.ets
└── entry/src/main/resources/rawfile/cards/   # 12 张演示图卡
权限清单为空——纯端侧游戏。
八、验证
模拟器实测(Mate 60 Pro,API 26):
| 步骤 | 结果 |
|---|---|
| 安装启动 | 340 毫秒(hvigor 全链路) |
| 案件 1(简单) | 线索「自然」,4 张嫌疑图,误指云天 → 0 分 |
| 案件 3(进阶) | 线索「音乐」,6 张嫌疑图,指认弹钢琴的手 → +150 分 |
| 案件 5(困难) | 线索「蒸汽」,8 张嫌疑图,指认热咖啡 → +200 分 |
| 结案 | 500/900 分,1 星,破案 3/6 |
得分与计分公式逐一核对无误(150 = 进阶基础分,200 = 困难基础分,均只用 1 条线索)。
九、总结与已知边界
「图探」证明了文搜图的核心体验可以零成本游戏化:不需要图像识别模型、不需要语义向量、不需要联网——一套标签数据 + 一个出题引擎,就能模拟「模糊查询 → 逐步加词 → 排除法定位」的完整流程。
需要如实说明的边界:
- 线索有噪声。 弱线索是从目标标签里随机抽的,可能抽到与图片视觉内容关联很弱的词(如目标「午间小憩」抽到「自然」,因为标签表里有这个词但图是室内场景)。修法是给标签加「视觉显著性」权重,弱线索只从低显著性标签里抽。
- 排除不影响得分,纯辅助。可以扩展成「排除错误扣分」,增加决策压力。
- 未做进度持久化,退出应用后成绩清零。
- 图卡固定 12 张,玩几局后会记住答案。生产版本需要接入相册或端侧语义模型动态出题。
最后一句话收尾:好的文搜图教学,不是教用户怎么写查询词,而是让用户在游戏里亲身体会「一个词不够,两个词太贵」的权衡——而这套体验,三百行 ArkTS 就够了。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献22条内容

所有评论(0)