
Qwen 4未发先“装机“:SGLang为昇腾910C手写QSA稀疏注意力路径,1.7倍速数字别当真
还没发布的Qwen 4,已经有人替它写好了昇腾910C的稀疏注意力内核——SGLang PR #41855 全解读
一个模型还没出生,它的"专用座位"已经焊好了。
2026年9月30日,开源推理框架SGLang的代码仓库里悄悄出现了一则拉取请求,编号41855。贡献者w1ida在标题里写得明白:为Qwen4-Exp的QSA(Query Sparsity Attention,查询稀疏注意力)预填充阶段,添加一条可选的CANN稀疏注意力路径。听起来只是常规的内核优化?真正耐人寻味的地方在于——Qwen 4这个模型家族,至今一个权重都没有放出来过。
阿里在9月22日云栖大会上公布的Qwen 4系列,包括Max、Flash、Plus和27B四个档位,只有名字和定位,没有模型卡、没有下载链接、没有API标识符,更没有发布日期。而这条拉取请求所服务的Qwen4Exp架构,目前唯一真正背着它跑起来的开放权重模型,是阿里8月24日扔到Hugging Face上的Qwen3.8-Flash-Next——一个1250亿总参数、激活仅60亿的MoE预览版,config.json里的model_type赫然写着qwen4_exp。
也就是说,一家厂商的推理服务栈,正在为一个尚未问世的产品家族提前铺路。硬件比发布会先到了。
这条拉取请求到底改了什么
整个PR刻意做得很小:五个文件,一次提交,相对主分支新增355行代码,只打了npu标签。作者开宗明义——目标是给Qwen4-Exp QSA的eager prefill提供一条原生CANN主注意力路径,底层调用torch_npu.npu_sparse_flash_attention,而索引器、Top-K选择、token预算和KV缓存内容,全部原封不动。
这里面藏着一个相当漂亮的数学技巧,值得单独说道。对于已经做过旋转处理的Q和K,这条路径把缓存打包成C = [K, V],同时把查询打包成Q' = [Q, 0]。矩阵一乘,Q' @ C.T的结果恰好等于Q @ K.T;而因为填充了零的查询部分不贡献任何信息,softmax之后再乘回C,得到的[ P @ K, P @ V ]堆叠结果中,把V那一半切出来就是注意力输出。用作者的话说,这是一种"注意力布局嵌入",既不是改动模型注意力本身,也不是低秩KV压缩。每个KV头在原生MLA布局下变成一个独立的batch,原始的D256缩放保持不变,辅助RoPE位置编码则直接置零。
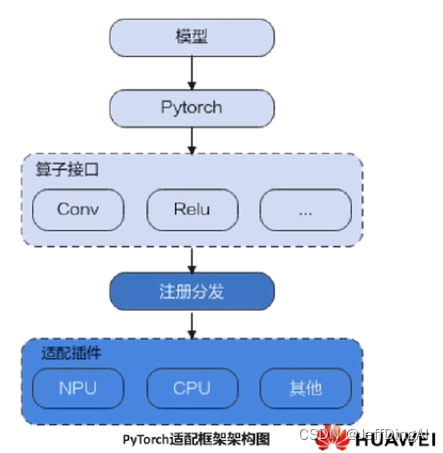
具体到工程细节,门槛卡得很死。想启用它,得手动设置环境变量SGLANG_NPU_QSA_NATIVE_PREFILL=1,默认是关闭的;而且只有普通的EXTEND前向模式会走这条路,解码、推测解码、混合前向以及图捕获全部维持现有路径,图捕获期间这个适配器会被完全绕过。硬件只认昇腾910C(Ascend910_93系列),数据类型只支持BF16,头维度固定256,作者在CANN 9.0加torch-npu 2.10的组合上做过测试。任何不支持的dtype或形状,都会静默回退到参考路径,不会报错更不会崩。
最能看出硬件"脾气"的是头形状的处理。这条路径只支持(16,2)、(24,2)、(12,1)、(6,1)和(3,1)这几组本地Q头、KV头搭配。问题在于CANN会直接拒绝query/KV比例为12的情况——它的tiler分块器只接受2的幂。于是适配器只能把头数做填充:12填到16,6填到8,3填到4,多算出来的输出再扔掉。这是整个PR里最诚实的一处痕迹:昇腾的硬件在设计时根本没考虑过这种稀疏注意力的头比例,适配器所做的,是替硬件消化这种不匹配,而不是反过来要求模型迁就芯片。
尺寸上也有边界:只打包被实际引用的物理缓存范围,上限262144个token。作者算过账,两个KV头的情况下,打包后的BF16 K/V张量最大约512 MiB。内部的-1填充会被检测出来并路由到回退路径,因为CANN要求连续有效的槽位;完全被掩码的行则保留现有的零输出约定。至于为什么仅限预填充——范围与布局检查需要把两个标量拷回主机端,临时副本加上原生工作区还会额外占显存,正是这种同步开销,决定了这条路只能用于eager模式的预填充阶段,图捕获时必须保持关闭。
九项测试全过,但那个1.713倍速别当真
先说好的一面:正确性证据具体且可复现,这比绝大多数内核PR的交代都扎实。在昇腾910C(Ascend910_9362)上,用CANN 9.0和torch-npu 2.10.0,九项测试40.772秒全部通过,而且不需要加载任何模型checkpoint。验证方式是拿非零随机BF16的Q/K/V,对照同输入在FP32 CPU参考实现下算出的结果,覆盖的用例包括宽度为1、63、64、65、2051的无序物理槽位、默认与显式缩放、完全掩码行、全零行、零选择宽度、非连续张量、压缩比为4的因果尾部、双请求共享前缀的物理映射、缓存内容复用,以及1和257个query行下的Flash-Next局部头形状。
重头戏是一次长上下文预填充:7810个query token对上65536长度的缓存,每个query选中2051个槽位,所有输出均为有限值,抽样八行与FP32参考对比,相对L2误差最高0.231%,低于测试门限要求的0.008。那次运行中NPU已分配显存峰值为1042.7 MiB,作者特意注明这是PyTorch分配器指标,不是板载HBM总量,更不是完整模型显存——这种限定说明,恰恰是负责任的做法。
然后就得泼冷水了。PR里附带的性能表写着:现有本地注意力路径每秒2270.79个新token,原生打包主注意力每秒3890.06,提升1.713倍,平均首token时间从3.109秒降到1.812秒。这个数字大概率会在各种转载里满天飞,但它不该被这样引用。作者自己交代得很清楚:这是历史原型测量数据,跑在2026年9月29日、一个经过适配的Whittle-Next-26B-A3B检查点上,并发1、六个请求、每个请求只出一个token,还从吞吐统计里剔除了36096个缓存前缀token。它既不是在PR分支上游代码上测的,原始serving产物也不在仓库里;后来那个每小时约5000 token的更好成绩,还包含了明确不归因于本次改动的原生indexer和block4工作。更麻烦的是,适配检查点的indexer权重是惰性加载的,预算与原模型不同——所以这组数字连indexer正确性都证明不了,更别说全预算下的生成质量。
顺带澄清一个命名陷阱:Whittle-Next是第三方Hugging Face账号发布的一个公开微调系列,基于Qwen3.8衍生,跟PR的目标模型Qwen4Exp不是一回事。搜到这个检查点的人,千万别把它当成1.713倍那组数字的基准配置。
作者自己还补了两刀:完整的服务集成、分布式张量并行、完整的Qwen3.8-Flash-Next模型,在这个分支上都还没验证过;贡献者明确表示保持草稿状态是刻意为之,甚至在PR正文里讨论这个适配器该归SGLang还是单独的sgl-kernel-npu仓库。CI也不干净——PR测试和AMD ROCm的运行记录里都有失败。前文说的正确性是算子级别的,PR里没有任何内容声称在完整服务栈上拿到了端到端的精度或吞吐结果。
QSA为什么难啃,看看配置表就懂了
Qwen的稀疏注意力不是普通注意力层换个稀疏mask那么简单。从Qwen3.8-Flash-Next的配置能看出来:48层按每4层一组的规律排布,每组里三个Gated DeltaNet块后面跟一个全注意力块,full_attention_interval为4,隐藏维度2560,注意力头维度256,24个query头对2个KV头,RoPE维度64。
真正让注意力变稀疏的是那个indexer,一个多查询结构:4个查询头共享1个键头,头维度128,压缩比4,每个query的预算为2048个选中的微块。模型卡说得很直白——QSA不是在单个token层面做选择,而是在微块(micro-block)粒度上运作,为的是压低长上下文延迟。而恰恰是这种微块粒度,加上复制式的选择器状态,没法干净地映射到任何一家厂商芯片上通用的分页注意力内核里。这次PR明智地把这些都排除在范围之外:稀疏块大小维持1,稀疏模式维持0,注意力模式维持2,所选token接口不变。所以它只是一个挂在现有选择机制底下的适配器,不是QSA的重写——这也是作者敢声称KV缓存内容不变的原因。
放到九月的全景里看,这不是孤例
单独看,某个加速器上的一个草稿PR不过是件新鲜事。但把时间线拉开,它是这个平台在服务对象还不存在之前就被公开拼装的第四、第五块木板。
vLLM那边,8月26日就挂出了"qwen4 fuse op"PR(#53909),加HyperConnection、QSA和PLE内核,至今开放未合并;9月29日又开了个草稿(#59279),为同一条QSA路径加解码上下文并行。SGLang这边更早,#38642做DFlash隐藏状态捕获,#39548做昇腾上Qwen4-Exp PLE的CPU卸载,#40235加基于文件的PLE表主机暂存,现在#41855补上昇腾注意力路径。更大块的使能工作还有两个:#37570把Qwen3.8-Flash-Next整体引入SGLang的NPU支持,带图重放、MTP和Triton内核,9月2日创建至今开着,横跨20个文件加了2590行;配套的sgl-kernel-npu #807则是一个贡献者在9月17日提交的4643行Triton内核。整个昇腾Qwen4Exp的叙事,基本就压在极少数几位贡献者身上——这种人员集中度,大概比任何路线图都更能说明,昇腾Qwen4Exp服务距离一条受支持的产品路径还有多远。
而且别把这当成"昇腾对决英伟达"的剧本。同样的注意力路径在NVIDIA一侧同样需要定制适配——vLLM里的QSA解码上下文并行、Hopper上的原生稀疏预填充内核,一个都不少。SGLang在8月28日登记的两个issue还记录了DGX Spark上Qwen4Exp解码的表现:QSA、PLE和Gated DeltaNet的内核耗时占据主导,NVFP4的KV缓存相比fp8_e4m3甚至让解码回退了约29%。这种架构的注意力层和嵌入层,在哪儿都是硬骨头,只是昇腾这边多了个"只认2的幂"的额外约束。
三件事,它都不意味着
先说清楚边界。第一,这不意味着Qwen 4发布了。云栖大会上那四个档位仍然只是路线图:没有模型卡、没有权重、没有API标识符、没有上下文窗口说明、没有许可证,也没有价格。一个针对内部架构名的框架适配器,是朝着"将来能服务好这个系列"迈出的一步,而不是朝着"这个系列存在"迈出的一步。
第二,这不意味着你今天就能跑起来。这个PR还是草稿,CI有失败项,没有合并日期。就算明天合入,这条路也需要昇腾910C、BF16、CANN 9.0配torch-npu 2.10、五种特定头形状之一,而且是可选加入的——部署方得主动打开开关。作者明确拒绝声称做过服务器级验证,而恰恰是服务器级的真实批处理表现,才能说明这条路到底站不站得住。
第三,这不意味着Qwen3.8-Flash-Next在任何已发布版本的SGLang或vLLM里受支持。两大开源运行时里的Qwen4Exp路径全是未合并的拉取请求。托管API那种开箱即用的便利,和你自己能跑的底层内核,中间隔着的正是这些PR想要填补的鸿沟。
如果你只是想测长上下文,不必等
关心这套架构的人,多数并不是想研究内核,而是想验证长上下文智能体提示的实际表现。那么更务实的选择是阿里已经正式供货的那一档:基于Qwen3.8-Flash-Next打造的生产线模型Qwen3.8-Flash,内置官方工具调用,支持一百万token上下文,支持文本、图像、视频输入,最大输出131072 token,已可通过OrcaRouter调用。按服务商标价,每百万输入token 0.15美元、输出0.47美元,缓存读取0.0184美元,中间零加价,供应商调价当天同步。过去七天实测画像:首token延迟中位数约4.4秒,输出速度约每秒106个token,错误率2.68%——这是高吞吐生产档位的气质,不是实验室预览版。
要交代的是,Qwen3.8-Flash-Next那个FP8原始预览检查点本身并未出现在该目录里;对外提供的是基于它构建的生产部署。而且前文所有昇腾、CANN、DCP相关的工作,在你今天能调用的任何东西里都不存在——它们还没合并。但对外这一档确实给了你一个低成本途径,判断你的工作负载是否属于这些内核要解决的问题:超长上下文、前缀密集的智能体提示。如果是,你在生产档上观察到的吞吐和缓存行为,也正是将来Qwen 4服务栈会竭力保护的那种行为。从架构层面讲,等权重落地时,切换只是一个路由问题,而不是一次重新集成——一个API覆盖两百多个模型的意义就在于此,还有故障回退兜底:把宝押在未经完整验证的路径上时,你总希望请求能退回稳定方案,而不是当场挂掉。
三个绕不开的问题,一次说清
看到qwen4_exp这个标识符,很多人会直接搜"Qwen 4"。必须提醒:这是内部架构名,你能在Qwen3.8-Flash-Next及其FP8同门的config.json里找到它,说明权重已发布、架构真实存在,而这个模型是Qwen 4系列预计构建方向的一次预览。"实验性架构"才是关键词,它不是Qwen 4本身,也不在任何标题带Qwen4Exp的引擎PR里暗示着发布。
有人问这是不是国产芯与NVIDIA的擂台赛。前面已经说了,不是。QSA的微块indexer加复制选择器状态,跟通用分页注意力内核的假设天然冲突,NVIDIA侧同样需要定制适配器和专用内核,DGX Spark上的实测数据摆在那儿。昇腾的独特贡献只是更苛刻的约束条件,适配器被迫用填充来掩盖罢了。
最后,这个PR会合并吗?以它呈现的状态看,大概率会,而且值得——适配器坦承自己只是适配器,正确性测试无需checkpoint即可复现,作者把集成问题摆上了桌面而不是假装万事俱备。真正值得盯的是后续:当NPU使能分支与这条注意力路径汇合之后,集成后的分支能不能跑出两者各自都没有过的端到端结果——完整模型、真实批处理,而不是只喂局部头形状的张量。到那天,在完工技术栈上实测出来的数字,会比那个1.713倍有分量得多。
在那之前,对这个PR最诚实的总结,恰恰是它自己始终恪守的那一句:算术上成立,开关默认关闭,CI是红的,而标题里那个模型,还并不存在。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)