
把小智的“大脑“搬到板子上:用端侧大模型替换云端 LLM 的完整改造
本篇速览
- 小智(xiaozhi-esp32)默认是「ESP32 设备 + 服务端(+ 云端大模型)」的三段式架构,设备只管采集播放,AI 全在另一台机器上跑。
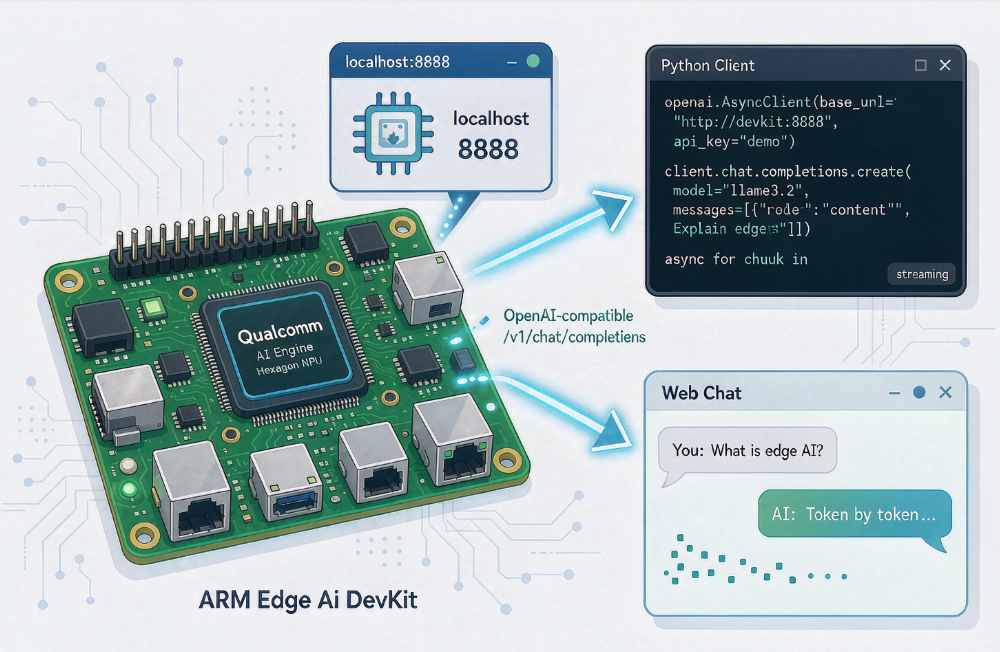
- 本次改造只动LLM 这一层:利用端侧大模型服务的 OpenAI 兼容接口,把小智的 LLM 后端从云端 API 改到本机,改动量只有一处配置。
- 改造顺序上,LLM 层是难度最低、见效最快的一层,适合作为整条改造主线的开篇;ASR/TTS 层留待后续。
- 必须承认的边界:端侧 0.5B 量级小模型的能力明显弱于云端大模型,本次改造换来的主要是部署形态、离线可用性、数据不出设备,不是模型能力。
一、为什么先动 LLM 这一层
1.1 小智的原架构:设备只是"嘴和耳朵"
先看清改造对象。小智是一套开源的 AI 语音对话方案,硬件层是 ESP32 系列(S3/C3/P4,现已扩展到其他平台)加麦克风、喇叭、显示屏;固件层负责语音唤醒、音频编解码与通信;真正的智能在服务端——xiaozhi-esp32-server 编排一条 VAD → ASR → LLM → TTS 的全流式链路。
也就是说,小智的 ESP32 端只负责"听进去、播出来",识别、理解、合成全在服务端完成。这是一个清晰的三段式:设备 + 服务器 +(通常还有)云。
1.2 这个架构的三个结构性约束
第一,必须有第二台机器:服务端的最低要求是 2 核 + 2~4GB 内存(本地 ASR 场景),若启用完整模块则需要 4 核 8GB 并配 MySQL、Redis。这意味着你没法只靠一块板子把它跑起来。
第二,链路依赖网络:音频要从设备传到服务端,结果要传回来;LLM 若走云端 API,还要看公网状况,断网即不可用。
第三,数据会离开设备:语音与对话内容经过外部的大模型服务,这对"语音不出本机"的场景是个硬约束。
这三点不是缺陷,而是原架构的设计取向——它追求的是"用便宜的设备 + 强的云端能力"。我们的改造目标则相反:把智能压回设备本地。
1.3 为什么从 LLM 层切入
整条链路有 VAD、ASR、LLM、TTS 四层,为什么第一篇只动 LLM?三个理由:
- 接口现成:端侧大模型服务(AidGenSE)提供的是 OpenAI 兼容接口,而小智服务端本身就支持"OpenAI 兼容"类型的 LLM provider。两者是同一套协议,改造本质是改一个
base_url,不需要动业务代码。 - 改动最小:不需要重新训练、不需要转模型格式、不需要碰音频链路。配置层面即可完成。
- 效果立即可见:改完立刻能对话、能对比延迟、能拔网线验证离线,故事完整。
反过来看 ASR 和 TTS 层:它们涉及采样率、流式接口、音色等一堆细节,改造成本高得多。所以正确的顺序是先易后难:用 LLM 层打通全链路、建立改造模板,再去啃硬骨头。
1.4 本次改造的边界声明
先把话说明白,避免误读:本次改造不提升模型能力。云端可用的大模型动辄几十 B 参数,端侧能跑的是 0.5B、1.5B 量级的小模型,对话质量与推理能力有肉眼可见的落差。本次改造带来的是另外三样东西:部署形态收敛为单板、断网可用、数据不出设备。如果你的产品核心竞争力是"回答得多聪明",那这次改造不是你要的答案;如果核心诉求是"离线、私密、不依赖服务器",那它正中靶心。
1.5 补一个背景:LLM 在这条链路里何时被调用
要改 LLM 层,得先知道它在整条流式链路里的位置与调用节奏。小智服务端是句级流式:端点检测判断你在说话 → 语音识别边听边出字 → 攒够一句(遇到标点等断句条件)就把这句送给 LLM → LLM 流式产出 token,再攒够一句就送给语音合成 → 合成出的音频帧推回设备。同时它支持打断:你在播放过程中开口,正在进行的生成与合成会被取消。
所以 LLM 不是"一轮对话调一次",而是按句子被多次调用。这个机制对本次改造有两个直接影响:
一是调用频率比直觉高,端侧算力有限时,句级切分策略(一句切多长、多久送一次)会显著影响负载。二是超时设置要重新匹配。原架构为云端接口设定的超时,放到本地小模型上可能偏紧,表现出来的现象就是"话还没说完就被判超时"。
理解"句级流式 + 可打断",你才知道改造后哪些参数是真正需要调的——不只是地址和模型名。
二、改造前的基线(这一步不能省)
改造类文章最容易犯的错,是上来就谈"提升了多少",却拿不出改之前的数据。所以动手前先建基线。
2.1 引用基线:端到端延迟分解
小智服务端有一份公开的延迟测试数据。以 Go 版服务端在「FunASR + Qwen2.5-72b-Instruct + CosyVoice」配置下的分解为例:
| 阶段 | 典型耗时 | 是否关键路径 |
|---|---|---|
| VAD 检测 | 200-400ms | 是 |
| ASR 处理 | 500-800ms | 是 |
| LLM 首 token | 300-600ms | 是 |
| LLM 成句 | 800-1500ms | 是 |
| TTS 首帧 | 200-400ms | 是 |
| 网络 + 解码 | 50-150ms | 是 |
| 端到端合计 | 1000-1300ms(区间 800-1800ms) | — |
数据说明:以上为引用数据,引自小智项目文档,配置如上,非本方案实测。使用这类数据时必须注明出处与配置,因为它高度依赖所选模型与部署环境——换成别的 LLM 或 TTS,分布会明显不同。
这份基线的用处在于:它告诉我们LLM 首 token 只是其中一段(300-600ms),而端到端是各段之和。所以改造 LLM 层,影响的是 LLM 这一段以及它引发的下游连锁反应,不能指望端到端延迟整体腰斩。
2.2 自己打一条本地基线
引用数据只能当参照,真正要对比的是你自己环境里的数字。在原架构(LLM 走云端 API)上,用同一组问题跑若干轮,记录每条的端到端耗时。最小做法:
# 在服务端的日志里抓每轮的阶段耗时(示例命令,日志字段以当前版本为准)
grep -E "asr|llm|tts" xiaozhi-server.log | tail -n 50

# 或者更直接:用固定问题集脚本化提问,记录时间戳
python3 bench_ask.py --questions questions.txt --repeat 10 --out baseline.csv
基线的关键是可重复:固定问题集、固定轮次、记录软硬件版本。没有基线的"优化"都是自说自话。
2.3 基线除了延迟,还应记录什么
延迟只是基线的一部分。完整的基线还应包含三项:
- 资源占用:服务端进程的内存与 CPU、板子温度。改造后如果内存占用暴涨,延迟再好看也不能上线。
- 稳定性:连续跑若干轮是否出错、内存有没有爬升趋势。
- 能力基线:用一组固定问题给回答质量打个分,哪怕是人工粗评。
第三项最容易被忽略,却最关键。改造后延迟可能变好,但能力可能变差——如果改造前没给能力打分,你就无法判断"这笔交易划不划算"。把三项都记下来,改造后的对照才是完整的,而不是只挑对自己有利的那个数字。
三、环境与版本准备
3.1 硬件与系统
本次改造在**犀牛派 X1(QCS8550)**上进行。选它的原因很直接:要在本地跑大模型,需要更高的 NPU 算力与更宽的内存水位,入门档的 A1 更适合跑轻量任务。具体板型规格以硬件文档为准。
3.2 组件与版本清单
改造涉及两套东西:小智服务端,以及本地的大模型服务。把版本清单列清楚,是后面排障的第一参考。
| 组件 | 作用 | 版本记录 |
|---|---|---|
| 板载系统 | 运行环境 | 记录系统镜像版本 |
| 端侧大模型 SDK | 提供模型推理 | 记录 SDK 版本 |
| 本地大模型服务 | 提供 OpenAI 兼容接口 | 记录服务版本 |
| 大模型权重 | 对话能力 | 记录模型名与量化精度 |
| 小智服务端 | 编排链路 | 记录服务端版本与分支 |
这张表要在改造前填完,并在每次升级后更新。多组件系统里,绝大多数"玄学问题"最终都是版本错配。
3.3 先把本地大模型服务跑起来
改造的前提,是本机已经有一个能对话的 OpenAI 兼容服务。先独立验证它,别急着接小智:
# 1) 起本地大模型服务(命令与参数以当前版本文档为准)
aidllm serve \
  --model /home/aidlux/models/qwen2.5-0.5b-instruct \
  --host 127.0.0.1 \
  --port 8888 \
  --context-length 2048

# 2) 另开一个终端,用 curl 冒烟测试
curl -s http://127.0.0.1:8888/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2.5-0.5b-instruct","messages":[{"role":"user","content":"用一句话介绍你自己"}]}'
能返回带 choices 的 JSON,说明服务本身没问题。这一步的意义在于把"服务的问题"和"小智的问题"分开:curl 通而小智不通,问题一定在小智那一侧的配置。
示例输出(示意,实际以真机为准):
{"id":"chatcmpl-local-001","object":"chat.completion","model":"qwen2.5-0.5b-instruct",
 "choices":[{"index":0,"message":{"role":"assistant","content":"我是一个运行在本地设备上的助手。"},
 "finish_reason":"stop"}]}
3.4 模型从哪来、选多大
本地大模型服务需要一个已适配端侧的权重。获取途径以平台提供的模型渠道为准(如模型广场一类),下载时确认三件事:适配的硬件平台、量化精度、配套的版本要求。三者任一不对,轻则加载失败,重则输出异常。
尺寸怎么选?端侧是一场体验与资源的直接博弈:
| 尺寸量级 | 特点 | 适用场景 |
|---|---|---|
| 0.5B | 最轻,加载快、首 token 延迟低 | 短问答、简单指令执行 |
| 1.5B | 能力与流畅度更平衡 | 需一定表达质量,但内存与上下文要克制 |
| 更大 | 对内存是考验,首 token 延迟明显上升 | 需精打细算上下文与并发,谨慎评估 |
本次改造先用 0.5B 量级把链路跑通、建立体感,再按需评估是否升尺寸。别一上来就追大——端侧"能跑"和"跑得舒服"之间的距离,比云端大得多。
下载后记得做完整性核对:文件大小、分片数量是否与说明一致,最好先跑一次最小对话确认能加载、能出 token,再投入正式联调。模型文件大、分片多,传输出错的概率不低,而带病的大模型排查起来成本极高。
四、核心改造步骤
4.1 定位小智的 LLM 配置
小智服务端的配置在 config.yaml(用户覆盖配置通常是 data/.config.yaml)。LLM 部分长这样——它声明了一组 provider,再用 selected_module 指定当前用哪个:
# 改造前:LLM 走云端 API
selected_module:
  LLM: ChatGLMLLM

LLM:
  ChatGLMLLM:
    type: openai
    model_name: glm-4-flash
    base_url: https://<云端服务地址>/v4      # 改造前指向云端
    api_key: <你的云端密钥>
注意 type: openai 这一行——它意味着服务端是用 OpenAI 兼容协议去调这个模型的。这正是我们能"零代码改造"的关键:只要本地服务也说这套协议,换 base_url 就够了。
4.2 新增一个本地 provider(核心 diff)
在配置里加一个指向本机的 provider:
# 改造后:新增本地 provider
LLM:
  LocalLLM:
    type: openai          # 协议类型不变
    model_name: qwen2.5-0.5b-instruct
    base_url: http://127.0.0.1:8888/v1   # 指向本机服务
    api_key: local        # 本地服务通常不校验密钥,给占位即可
4.3 切换 selected_module
selected_module:
  LLM: LocalLLM          # 由 ChatGLMLLM 改为 LocalLLM
整个功能性改动就是这两处。改完重启服务端即可。这就是"选对切入层"的价值——如果切 ASR 层,这里会是几十行代码和一堆音频参数的适配。
4.4 依赖顺序:先模型服务,后业务服务
这里有个容易被忽略的工程细节:小智服务端启动时会去连 LLM,如果本地模型服务还没起来,就会连不上。所以启动顺序必须被显式约束。用 systemd 管理时:
# 小智服务端的 unit 片段
[Unit]
After=aidgense.service
Wants=aidgense.service
After= 保证模型服务先起。别把顺序寄托在"手动先敲一条命令"上——量产后没人手动敲。
4.5 第一次跑通
重启服务端后,对着设备说话,观察三件事:服务端日志里 LLM 请求打到了本机地址、设备能正常返回语音、日志没有报错。第一次跑通建议用短问题("你好"级别),先确认链路通,再上复杂问题。
4.6 改前 / 改后配置完整对照
把改动摊开看更清楚。本次改造涉及的完整配置片段如下,其余配置一律不动:
# ============ 改前:LLM 走云端接口 ============
selected_module:
  LLM: ChatGLMLLM
LLM:
  ChatGLMLLM:
    type: openai
    model_name: glm-4-flash
    base_url: https://<云端服务地址>/v4      # 改造前指向云端
    api_key: <云端密钥>

# ============ 改后:LLM 走本机服务 ============
selected_module:
  LLM: LocalLLM
LLM:
  LocalLLM:
    type: openai
    model_name: qwen2.5-0.5b-instruct
    base_url: http://127.0.0.1:8888/v1
    api_key: local        # 本地服务通常不校验密钥
改动点只有三处:模块名、模型名、地址。协议类型与其余字段保持一致。这正是"协议兼容"带来的收益——业务代码零改动。
改动越小,回归范围越小,排障时也越容易定位。这也是把 LLM 层作为整条改造主线第一个目标的核心理由:用最小代价验证"端侧替代云端"这条路走得通,再逐步推进到更复杂的层。
4.7 第一次跑通之后:别急着下结论
第一次跑通时先别急着记录性能数据。端侧大模型的首次调用往往比后续慢——模型要加载权重、构建键值缓存结构,可能还有图编译。所以第一轮的耗时不能当作常态,要等跑过几轮、进入稳定状态再测。
另一个容易误判的点是缓存效应:连续问同一个问题,第二次可能明显更快,那是缓存带来的假象,不代表真实交互表现。测性能要用内容不同的问题集,避免被缓存美化了数字。
把"首跑慢"和"运行慢"分开看、把"缓存命中"和"真实推理"分开看,测出来的数字才有参考价值。这也正是前面强调"固定轮次取中位数"的原因——在端侧,单次测量几乎总是不可信的。
五、部署运行:从"能跑"到"常驻"
跑通一次不算完,要能开机自启、崩了自恢复。把两个服务都交给 systemd:
# /etc/systemd/system/aidgense.service
[Unit]
Description=Local LLM Service
After=network.target

[Service]
Type=simple
User=aidlux
ExecStart=/usr/bin/aidllm serve --model /home/aidlux/models/qwen2.5-0.5b-instruct --host 127.0.0.1 --port 8888
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
# /etc/systemd/system/xiaozhi.service
[Unit]
Description=Xiaozhi Server
After=aidgense.service          # 关键:等模型服务就绪
Wants=aidgense.service

[Service]
Type=simple
User=aidlux
WorkingDirectory=/home/aidlux/xiaozhi-server
ExecStart=/usr/bin/python3 app.py
Restart=on-failure
RestartSec=5

[Install]
WantedBy=multi-user.target
systemctl enable --now aidgense xiaozhi 后,重启一次机器验证:断电上电后两个服务是否按序自动起来、对话是否可用。能扛住重启,才算真正部署完成。
5.3 两个服务的日志分别看哪
部署完之后一定要知道去哪看日志。改造后系统里有两个服务,日志要分开看:
- 本地大模型服务的日志:看它是否正常加载模型、每次请求的耗时、有无报错。
- 小智服务端的日志:看整条链路——端点检测有没有触发、识别出了什么文本、LLM 请求打到哪个地址、语音合成有没有出音频。
判断问题归属的口诀是从后往前查:先在模型服务的日志里确认请求有没有进来、有没有正常返回;如果这一侧正常,再看小智服务端是怎么处理的。用 journalctl 看 systemd 托管的服务:
journalctl -u aidgense -f     # 本地大模型服务日志
journalctl -u xiaozhi  -f     # 小智服务端日志
很多"改造失败"其实是没看日志就瞎猜——把服务的问题当成配置的问题,或反过来。养成先翻日志再动手的习惯,能省下大量无效尝试。
5.4 资源隔离:别让大模型吃光整块板子
改造后,整块板子上同时跑着本地大模型服务和小智服务端,两者共享内存与算力。如果不加约束,大模型一旦因上下文过长或并发过多而吃满内存,会把小智服务端一起拖垮——表现很典型:模型服务还在,但对话链路已经死了。
用 systemd 的资源限制给两个服务各划一条线:
# 在两个 service 的 [Service] 段按需添加
MemoryMax=2G        # 内存上限,超限触发重启,而不是拖垮整机
CPUQuota=150%       # CPU 用量上限
给大模型服务设上限尤其重要:宁可它自己被限流重启,也不能让它把音频链路和系统进程饿死。资源隔离与崩溃自愈是互补的两件事——自愈管"它活着没",隔离管"它别太过分"。
具体限额要按板子的实际内存与两个服务的实测占用来定,先用宽松值跑起来观察,再逐步收紧。一步到位设死,容易把正常波动误杀。
六、问题与解决方案
改造不是改完就完事。以下是这次改造中真实会撞到的问题,每条按"现象 → 归因 → 解法 → 复验"组织。
6.1 连接被拒绝:服务没起或端口不对
现象:服务端日志出现连接错误,对话无响应。
归因:三种可能——本地模型服务没起来;端口不是 8888;base_url 写错(少了 /v1 后缀是最常见的低级错误)。
解法:先用 curl 独立验证服务(回到 3.3);确认端口 ss -tlnp | grep 8888;核对 base_url 是否以 /v1 结尾。
复验:curl 通了再重启小智服务端。
6.2 模型名不被接受
现象:服务端报模型不存在之类的错误。
归因:model_name 填的是云端模型的名字,本地服务不认识。本地服务只认识它加载的那个模型。
解法:把 model_name 改成与本地加载一致的名字(例如 qwen2.5-0.5b-instruct)。这个名字不是你随便起的,要和服务启动时加载的模型对应。
复验:重启后问一句短问题,确认返回正常。
6.3 上下文超长:小智的 prompt 比你想的长
现象:对话初期正常,聊几轮后报错或回答质量骤降。
归因:小智服务端会带上系统提示与历史消息,累积长度可能超出端侧模型设置的上下文长度(cl)。端侧内存有限,cl 不可能设得很大。
解法:调大服务启动时的上下文长度(在内存允许范围内),或在服务端侧限制历史消息条数。注意这是一道内存账:cl 越大,键值缓存越吃内存。
复验:连续对话 N 轮不报错,并观察内存占用。
6.4 响应变慢导致超时
现象:设备端迟迟不回话,或报超时。
归因:端侧小模型的生成速度慢于云端 API,而小智服务端/设备端通常有超时设置。原架构下 300-600ms 的首 token,在本地可能变成更长的等待。
解法:调大超时阈值;同时从根上压延迟——换更小的模型、缩短上下文、减少输出长度(在系统提示里要求"回答简洁")。
复验:连续提问若干轮,统计是否还有超时。
6.5 能力落差:小模型答非所问
现象:能对话,但复杂问题答得不好、指令遵循弱。
归因:这是模型规模决定的,不是配置问题。0.5B 量级模型与云端几十 B 模型的能力差距是客观存在的。
解法:承认它,并按小模型的能力重新设计交互——把任务拆小、在系统提示里明确要求简短回答、把复杂推理交给别的环节。这是产品层面的适配,不是改配置能解决的。
复验:用固定问题集评分,明确知道"哪些问题能答、哪些不能"。
6.6 流式字段差异
现象:流式输出断断续续,或某些参数不生效。
归因:本地服务的 OpenAI 兼容是"核心字段兼容",不保证所有可选参数都被支持。
解法:先只用最核心的字段(model、messages、stream),确认通了再加参数;遇到不生效的参数,去核对服务端支持范围。
复验:逐字段测试并记录支持情况(这正是本章 B1 篇要系统做的事)。
6.7 内存账:端侧大模型到底吃多少
改 LLM 层最容易撞的墙不是算力,是内存。端侧跑大模型的内存大致由三块构成:模型权重(随参数量与量化精度变化,INT4 < INT8 < FP16)、键值缓存(随上下文长度与层数增长)、运行时开销。三者相加还要留足余量,否则表现为加载失败,或者跑到一半崩掉。
可以按这个思路粗算(属推算,非实测):权重占用约等于"参数量 × 每个参数的字节数";键值缓存与上下文长度、层数、注意力头维度正相关。以板子的可用内存反推:0.5B 量级的量化模型通常能放下并留有余量,1.5B 量级就要开始精打细算上下文长度,更大尺寸则明显超出舒适区。
这笔账不必算到字节,但"先估算、再决定模型尺寸和上下文长度"的习惯,能让你避开"下了一个跑不起来的模型"这种返工。具体可用内存以板型规格与真机观察为准。
如果真的因为上下文设太大而崩溃,优先缩上下文长度,而不是急着换更大的板子——上下文长度是这堵墙上最灵活的那扇门。
6.8 改了却没生效:配置优先级
一个高频困惑:明明改了配置文件,重启后行为却没变。这通常不是改造失败,而是配置优先级在起作用。小智服务端的配置是有层级的——用户覆盖配置的优先级最高,仓库默认配置作为兜底。如果你改的是默认配置文件,而覆盖配置里也写了同一个键,那么实际生效的会是覆盖配置里的那份。
排查方法:确认自己改的是哪一份、两份里是否都出现了同一个键、以及服务端启动时实际加载的路径。一个实用技巧是改完立刻验证:临时把系统提示改成一个显眼的词,看模型是否照做,能快速判断"你改的那份到底生不生效"。
这条不只适用于小智——任何带多层配置的系统都有同类问题。把它当成改造类工作的通用排查项记下来,能省掉很多"明明改了却没变"的困惑。
6.9 并发:本地服务能同时处理几个请求
改造前,LLM 的并发压力由云端或独立服务端承担;改造后,所有并发都落在本机那一个服务上。端侧服务的并发能力是有限的——每个进行中的请求都要占用一份缓存内存,并发越高、上下文越长,内存压力越大。超出承受范围时,先是排队变慢,严重时直接报错。
对策有三条:一是限制同时接入的会话数量;二是控制每个请求的上下文长度;三是认清"长上下文"与"高并发"是一对需要权衡的资源,不能两头都要。
具体能扛多少并发要以真机实测为准:先用一个客户端跑通,再逐步加压,观察响应变化与内存曲线,找到属于你这台设备的拐点。这个数字对产品很重要——它直接决定"这板子能同时服务几个人"。
七、验证与对照
7.1 功能验证
用一组固定问题跑通,确认三类能力:基本问答能答、系统提示里的角色设定被遵守、多轮对话在上下文范围内记得前文。这组问题要固定成用例,以后每次改配置都重跑。
7.2 延迟对照
在同一台设备、同一组问题下,分别记录改造前后的端到端耗时。重点看 LLM 这一段的变化,以及它对下游 TTS 的连锁影响。
| 指标 | 改造前(云端 LLM) | 改造后(本地 LLM) | 测量条件 |
|---|---|---|---|
| LLM 首 token | 记录实测值 | 记录实测值 | 同一问题集、同一网络 |
| 端到端 | 记录实测值 | 记录实测值 | 同上 |
| 是否需外网 | 是 | 否 | 拔网线验证 |
表中"记录实测值"处必须填入你自己的真机数据;不许留空,也不许用别人的数据冒充实测。引自小智项目文档的 300-600ms 只能作为参照写在正文里,不能填进"实测"列。
7.3 断网验证(最有说服力的一项)
把外网断开(拔网线或断 Wi-Fi 上行),再对设备说话。改造前走云端 API 时,这一步会直接失败;改造后应当仍能正常对话。这一项验证直接对应"离线可用"这个改造目标,也比任何延迟数字都更能说明问题。
7.4 数据不出设备
用抓包或在网关侧观察,确认没有到外部大模型服务的请求。这一步验证"数据不出设备"的诉求是否真的成立——如果配置里还残留云端 TTS,那语音合成那一段仍然出网,结论就要打折。
7.5 一套可回归的验收用例集
改造完成别急着庆祝,把它固化成可重复执行的验收用例:
- 功能用例:一组固定问题(常识问答、指令遵循、多轮记忆各若干条),每次改配置后重跑,判定通过与否。
- 性能用例:固定问题集跑若干轮,记录每轮端到端耗时与 LLM 段耗时,取中位数。
- 稳定性用例:连续对话一段时间,观察内存是否爬升、有无报错。
- 离线用例:断开外网后重跑功能用例,确认仍然可用。
有了这套用例,以后换模型、调上下文、升级版本,都能立刻判断"变好还是变坏"。它的价值不在这一次验收,而在于让后续每一次改动都有据可依——这是把一次改造沉淀为长期能力的关键一步。
7.6 对照实验怎么做才可信
做前后对照时有几个容易让结论失真的坑:
一是样本太少——只问一句就下结论,波动会淹没真实差异,建议同一问题集重复若干轮取中位数。二是条件不一致——改造前后若网络环境、设备温度、后台负载不同,对比就失真,要尽量在相同条件下测。三是只测延迟不测质量——延迟变快但答得更差,这笔账要一起算。四是把引用数据当实测——引自项目文档的那组耗时只能当参照,不能填进你的实测列。
可信的对照 = 固定问题集 + 固定轮次 + 相同环境 + 三态标注。做到这四点,你的数字才经得起追问。
八、总结与复用
8.1 可复用的改造模板
把这次改造抽象成一套可复制的动作:
- 确认协议兼容性:目标层是否使用通用协议(本次是 OpenAI 兼容)。是,则改造退化为改配置。
- 独立验证被替换的组件:先用 curl/最小脚本确认新后端可用,再接入业务。
- 只改必要的字段:
base_url+model_name,其余保持不动。 - 显式约束启动依赖:用 systemd 的
After=保证顺序。 - 建基线 → 改 → 再测:三个动作缺一不可。
- 验证改造目标本身:离线就拔网线,隐私就抓包,别只测延迟。
这套模板对后续 ASR、TTS 层同样适用,只是第 1 步的"协议兼容性"未必那么理想,改造量会大得多。
8.2 适用边界(必须写清楚)
- 模型能力:端侧小模型明显弱于云端大模型,复杂推理、长文本理解、严格指令遵循都不如后者。
- 并发容量:本地服务只服务本机会话;云端/服务器模式可以一台带多台设备。这是"集中 vs 分布"的架构取舍,不是优劣之分。
- 延迟:省掉了网络往返,但本地算力有限,LLM 段是否更快取决于模型规模与硬件,需要实测判断,不能想当然。
- 适用场合:适合离线、私密、不便部署服务器的场景;不适合追求最强对话能力的场景。
8.3 下一步
LLM 这一层打通后,整条链路里剩下的 VAD、ASR、TTS 仍依赖服务端(或云端)。后续的方向是把它们逐个换到端侧组件——ASR 换端侧识别、TTS 换端侧合成,最终让"设备 + 服务器"收敛成真正的一块板子。届时还要处理更麻烦的问题:音频采样率与流式接口的差异、音色自然度、整机资源在多模型并发下的分配。这些留待后续篇章展开。
8.4 常见异常速查表
把改造中可能遇到的问题归成一张表,照表初判方向:
| 现象 | 可能的归属 | 对应小节 |
|---|---|---|
| 连接被拒绝 | 服务未起 / 端口错 / 地址缺 /v1 后缀 | 6.1 |
| 提示模型不存在 | 模型名与本地加载的不一致 | 6.2 |
| 聊几轮后报错 | 上下文超长 | 6.3、6.7 |
| 回答很慢或超时 | 模型偏大 / 超时设置偏紧 | 6.4 |
| 能答但答得差 | 模型规模所限的能力边界 | 6.5 |
| 流式断续、参数不生效 | 兼容字段范围 | 6.6 |
| 重启后不工作 | 启动依赖未显式约束 | 4.4、第五章 |
先对号入座定位方向,再翻对应小节深挖。这比从头到尾重读一遍要快得多,也是把排障从"凭感觉"变成"有依据"的常规做法。
8.5 这次改造换来什么、付出什么
把收益与代价摊在同一张表里,避免只谈一面:
| 维度 | 改造前(云端 LLM) | 改造后(本地 LLM) | 性质 |
|---|---|---|---|
| 部署形态 | 设备 + 服务端 + 云端 | 设备 + 本机服务 | 收敛 |
| 断网可用性 | 不可用 | 可用 | 收益 |
| 数据路径 | 对话内容出设备 | 不出设备 | 收益 |
| 网络链路 | 有公网往返 | 本机回环 | 收益 |
| 模型能力 | 云端大模型更强 | 端侧小模型较弱 | 代价 |
| 并发容量 | 一台服务端带多设备 | 服务本机会话 | 取舍 |
| 首 token 延迟 | 取决于云端 | 取决于本地算力 | 需实测 |
读这张表要抓住三点。第一,收益集中在部署形态、离线可用性、数据路径三项,不在模型能力——这一点必须说清楚,否则就是对读者的误导。第二,代价栏是真实存在的,不许省略;端侧小模型在复杂推理、长文本理解、严格指令遵循上都弱于云端大模型。第三,"首 token 延迟"这一栏不能想当然:省掉了网络往返,但本地算力有限,究竟更快还是更慢必须实测判定,引自项目文档的数字只能作为参照。
把收益与代价同时写出来,结论才站得住。只谈收益的改造文章,遇到懂行的读者一问就露怯——而诚实标注边界的文章,反而更能建立信任。
8.6 一份可勾选的改造清单
把本次改造落成清单,下次做同类替换可直接复用:
- 确认目标层使用通用协议(本次为 OpenAI 兼容)
- 新后端已独立验证可用(curl 或最小脚本)
- 只改必要字段,业务代码零改动
- 启动依赖已用 systemd 显式约束
- 改造前有基线(延迟 / 资源 / 能力,三项齐全)
- 改造后有对照,且实测列填的是真机数据
- 离线用例(拔网线)已通过
- 收益与代价对照表已写全,边界未省略
- 验收用例集已固化,可重复执行
清单的价值在于把"这次做成了"变成"下次也能做成"。改造类工作的经验,最终都要沉淀成这样的检查表才有复利——否则每次都是从头摸索一遍。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)