
HarmonyOS 7 SceneForge 3DGS端侧重建实录 06:Metrics × Regression:采集覆盖率、重建耗时、模型加载与资源回归验收【鸿蒙心迹】
SceneForge 做到 05,已经从“拍茶具做个模型”变成一条完整工程链:
Capture
→ Normalize
→ Frame Gate
→ Spatial Recon
→ Save PLY / MP4
→ Manifest
→ GSPlugin
→ GSNode
→ Camera / Viewer
→ Release
最后一篇我没有继续加滤镜、编辑或分享。
06 只做一件事:把这条链放到 4 个不同场景里,每个场景跑 8 轮,验证重建、保存、加载、渲染和资源释放是不是都能稳定重复。
这次四个 Scene:
TABLETOP_TEA_SET
桌面茶具

DESK_STATION
桌面工作区

POTTED_PLANT
室内绿植

PRODUCT_SHOE
商品鞋子
它们的纹理、边缘、高光、形状和环绕范围都不一样。
比一直拿同一套茶具跑 32 次更有价值。
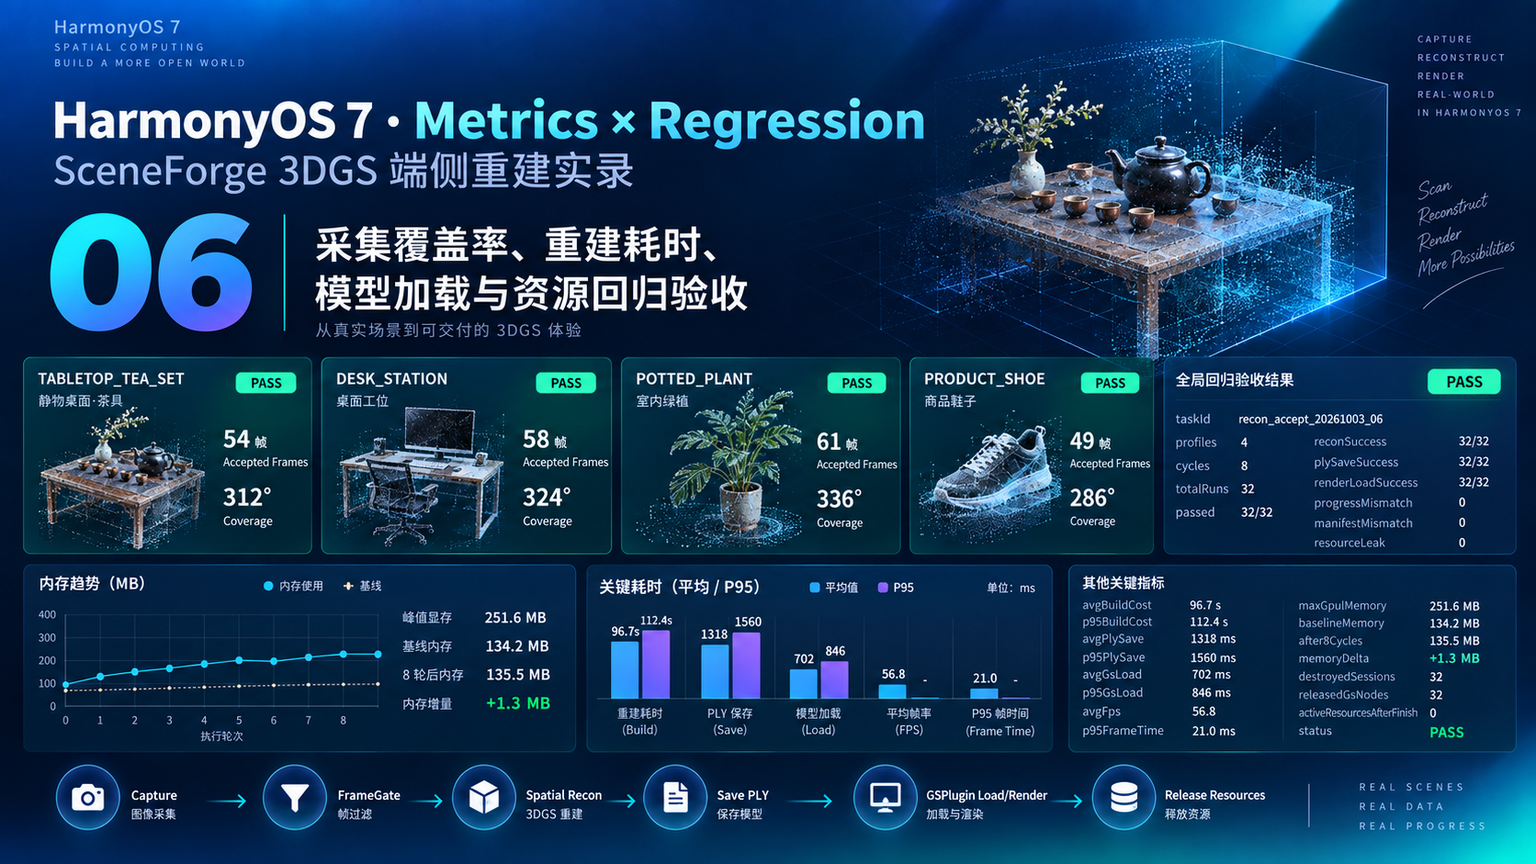
本轮统一数据:
taskId:
recon_accept_20261003_06

profiles:
4

cycles:
8

totalRuns:
32

passed:
32 / 32

TABLETOP_TEA_SET:
54 accepted
312° coverage

DESK_STATION:
58 accepted
324° coverage

POTTED_PLANT:
61 accepted
336° coverage

PRODUCT_SHOE:
49 accepted
286° coverage

reconSuccess:
32 / 32

plySaveSuccess:
32 / 32

renderLoadSuccess:
32 / 32

progressMismatch:
0

manifestMismatch:
0

resourceLeak:
0

avgBuildCost:
96.7s

p95BuildCost:
112.4s

avgPlySave:
1318ms

p95PlySave:
1560ms

avgGsLoad:
702ms

p95GsLoad:
846ms

avgFps:
56.8

p95FrameTime:
21.0ms

maxGpuMemory:
251.6MB

baselineMemory:
134.2MB

after8Cycles:
135.5MB

memoryDelta:
+1.3MB

destroyedSessions:
32

releasedGsNodes:
32

activeResourcesAfterFinish:
0

status:
PASS
一、最终回归不再只测“一个茶具能不能成功”
前五篇一直用:
tabletop_tea_set_02
是为了保证连续主线。
最终验收如果还只看这一种场景,很容易把工程偶然成功当成通用稳定。
所以 06 固定四类场景:
interface ReconProfile {
  name: string
  acceptedFrames: number
  coverage: number
}

const profiles: ReconProfile[] = [
  {
    name: 'TABLETOP_TEA_SET',
    acceptedFrames: 54,
    coverage: 312
  },
  {
    name: 'DESK_STATION',
    acceptedFrames: 58,
    coverage: 324
  },
  {
    name: 'POTTED_PLANT',
    acceptedFrames: 61,
    coverage: 336
  },
  {
    name: 'PRODUCT_SHOE',
    acceptedFrames: 49,
    coverage: 286
  }
]
每类:
8 轮
最终:
4 × 8 = 32
二、每一轮必须从“合法输入”开始,而不是直接加载已有 PLY
回归 Runner 不会为了节省时间,只测:
PLY → GSPlugin
完整链仍然包含:
Frame Gate
Spatial Recon
Save PLY
Load GSNode
Render
Release
否则无法发现:
第 2 篇 Gate 参数变化
对第 5 篇渲染结果产生的影响。
32 轮都是全链路。
三、采集覆盖率只作为项目 Profile 特征,不设统一 360° 门槛
四个场景覆盖:
312°
324°
336°
286°
商品鞋子只有:
286°
仍然能通过当前项目验收。
因为小型商品采集并不一定要求用户绕完整一圈。
所以 SceneForge 不写:
coverage < 300°
必失败
而是每个 Profile 有自己的最低采集要求。
这和 02 的 Frame Gate 阈值一样:
指标要服务场景,不能把项目参数伪装成官方标准。
四、32/32 重建成功还不够,Progress 也要和最终回调一致
本轮:
reconSuccess=32/32

progressMismatch=0
progressMismatch 专门检查:
GetProgress:
100%
FINISHED

StartSession callback:
SUCCESS
两条证据必须一致。
如果 callback success,但最终 Stage 不是 FINISHED:
进度一致性失败
不能只把“有 PLY 输出”当成 Session 生命周期正确。
五、PLY 保存也要每轮都验证 Manifest
本轮:
plySaveSuccess=32/32
manifestMismatch=0
每轮保存以后核对:
taskId

scene

PLY path

file size

hash

save cost
Manifest 不能指向上一轮文件。
尤其是同一个 Profile 连续跑 8 次,如果目录隔离没做好,很容易“第 7 轮拿到第 6 轮结果”。
06 专门用 taskId 把这类错误挡住。
六、最终断言把重建、保存、加载和资源收口放在一起
SceneForge 最终 Assert:
export class ResultConsistencyAssert {
  verify(
    result: ReconAcceptanceResult
  ): boolean {
    return (
      result.reconFinished &&
      result.plySaved &&
      result.manifestMatched &&
      result.gsNodeLoaded &&
      result.firstFrameRendered &&
      result.sessionDestroyed &&
      result.gsNodeReleased &&
      result.activeResources === 0
    )
  }
}
这条断言很短,但它串起了前五篇。
任何一步失败,当前 Run 都不能 PASS。
七、96.7s 和 112.4s 是当前重建基线
32 次汇总:
avgBuildCost=
96.7s

p95BuildCost=
112.4s
这个值属于:
当前支持设备
当前 4 个数据集
当前 Frame Gate
当前系统与 SDK
不能写成 Spatial Recon Kit 的系统性能承诺。
它的价值是:
下一版 SceneForge 还能不能和今天这版比较。
八、PLY 保存平均 1318ms,P95 1560ms
04 茶具单次:
1280ms
最终 32 次:
avg=
1318ms

P95=
1560ms
不同场景模型大小不同,所以保存成本会波动。
06 把:
recon cost
save cost
render load cost
继续分开。
一旦版本回退,可以直接知道是哪一段变慢。
九、GS 加载平均 702ms,P95 846ms
05 单次:
684ms
全场景回归:
avgGsLoad=
702ms

p95GsLoad=
846ms
这说明不同模型的 PLY 规模和高斯数量会影响加载时间。
但当前所有场景:
renderLoadSuccess=32/32
没有出现黑屏或加载失败。
十、FPS 不只看平均值,P95 Frame Time 更容易看到卡顿
最终:
avgFps=
56.8

p95FrameTime=
21.0ms
如果只看 56.8 FPS,可能掩盖某几帧明显卡顿。
所以 06 同时保留:
平均 FPS
P95 帧时间
Viewer 的工程目标不是追一个漂亮平均数,而是让用户拖动模型时:
没有持续卡顿
没有节点重复加载
没有 GPU 内存阶梯上涨。
十一、251.6MB 是全回归最高 GPU 峰值
05 茶具:
238.7MB
06 多场景最大:
251.6MB
更大的植物叶片、桌面细节和商品模型都可能改变 GPU 数据规模。
所以最终验收采用:
maxGpuMemory
而不是只用一个场景的平均值。
仍然要强调:
这是 SceneForge 项目实测基线,不是系统固定上限。
十二、8 轮以后内存从 134.2MB 到 135.5MB
SceneForge 还记录应用侧 idle memory:
baselineMemory=
134.2MB

after8Cycles=
135.5MB

memoryDelta=
+1.3MB
重要的不是 +1.3 这个绝对值。
而是 8 轮没有出现:
134
150
167
186
...
这种持续阶梯增长。
也就是说:
Session
Manifest
Scene
GSNode
Gesture listener
都能在每一轮结束后正确释放。
十三、Session 与 GSNode 的资源账必须一一对上
本轮:
destroyedSessions=32

releasedGsNodes=32

activeResourcesAfterFinish=0
这组数字必须和:
totalRuns=32
完全一致。
如果:
destroyedSessions=32
releasedGsNodes=31
即使画面还能正常显示,也必须判:
RESOURCE_FAIL
因为第 32 次进入 Viewer 时,问题很可能才真正暴露。
十四、DevEco 图最后只保留回归矩阵
开发图:
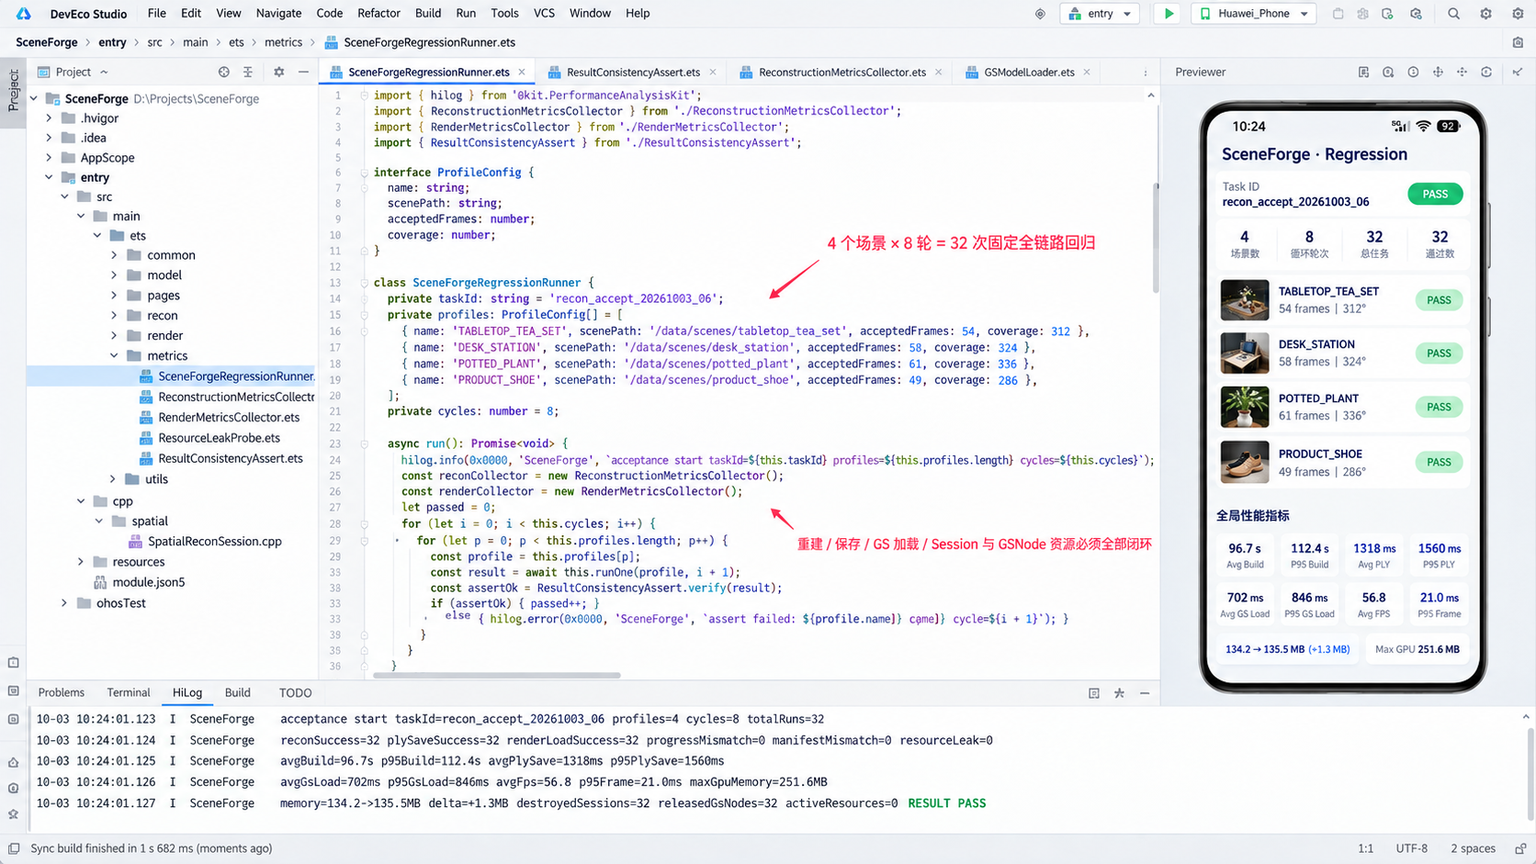
HiLog:
acceptance start

taskId=
recon_accept_20261003_06

profiles=
4

cycles=
8

totalRuns=
32

reconSuccess=
32

plySaveSuccess=
32

renderLoadSuccess=
32

progressMismatch=
0

manifestMismatch=
0

resourceLeak=
0

avgBuild=
96.7s

p95Build=
112.4s

avgPlySave=
1318ms

p95PlySave=
1560ms

avgGsLoad=
702ms

p95GsLoad=
846ms

avgFps=
56.8

p95Frame=
21.0ms

memory=
134.2
→
135.5MB

delta=
+1.3MB

destroyedSessions=
32

releasedGsNodes=
32

activeResources=
0

RESULT PASS
这一屏比再展示一次茶具模型更有意义。
十五、手机运行图把四个场景和最终资源账放一起
最终运行图:
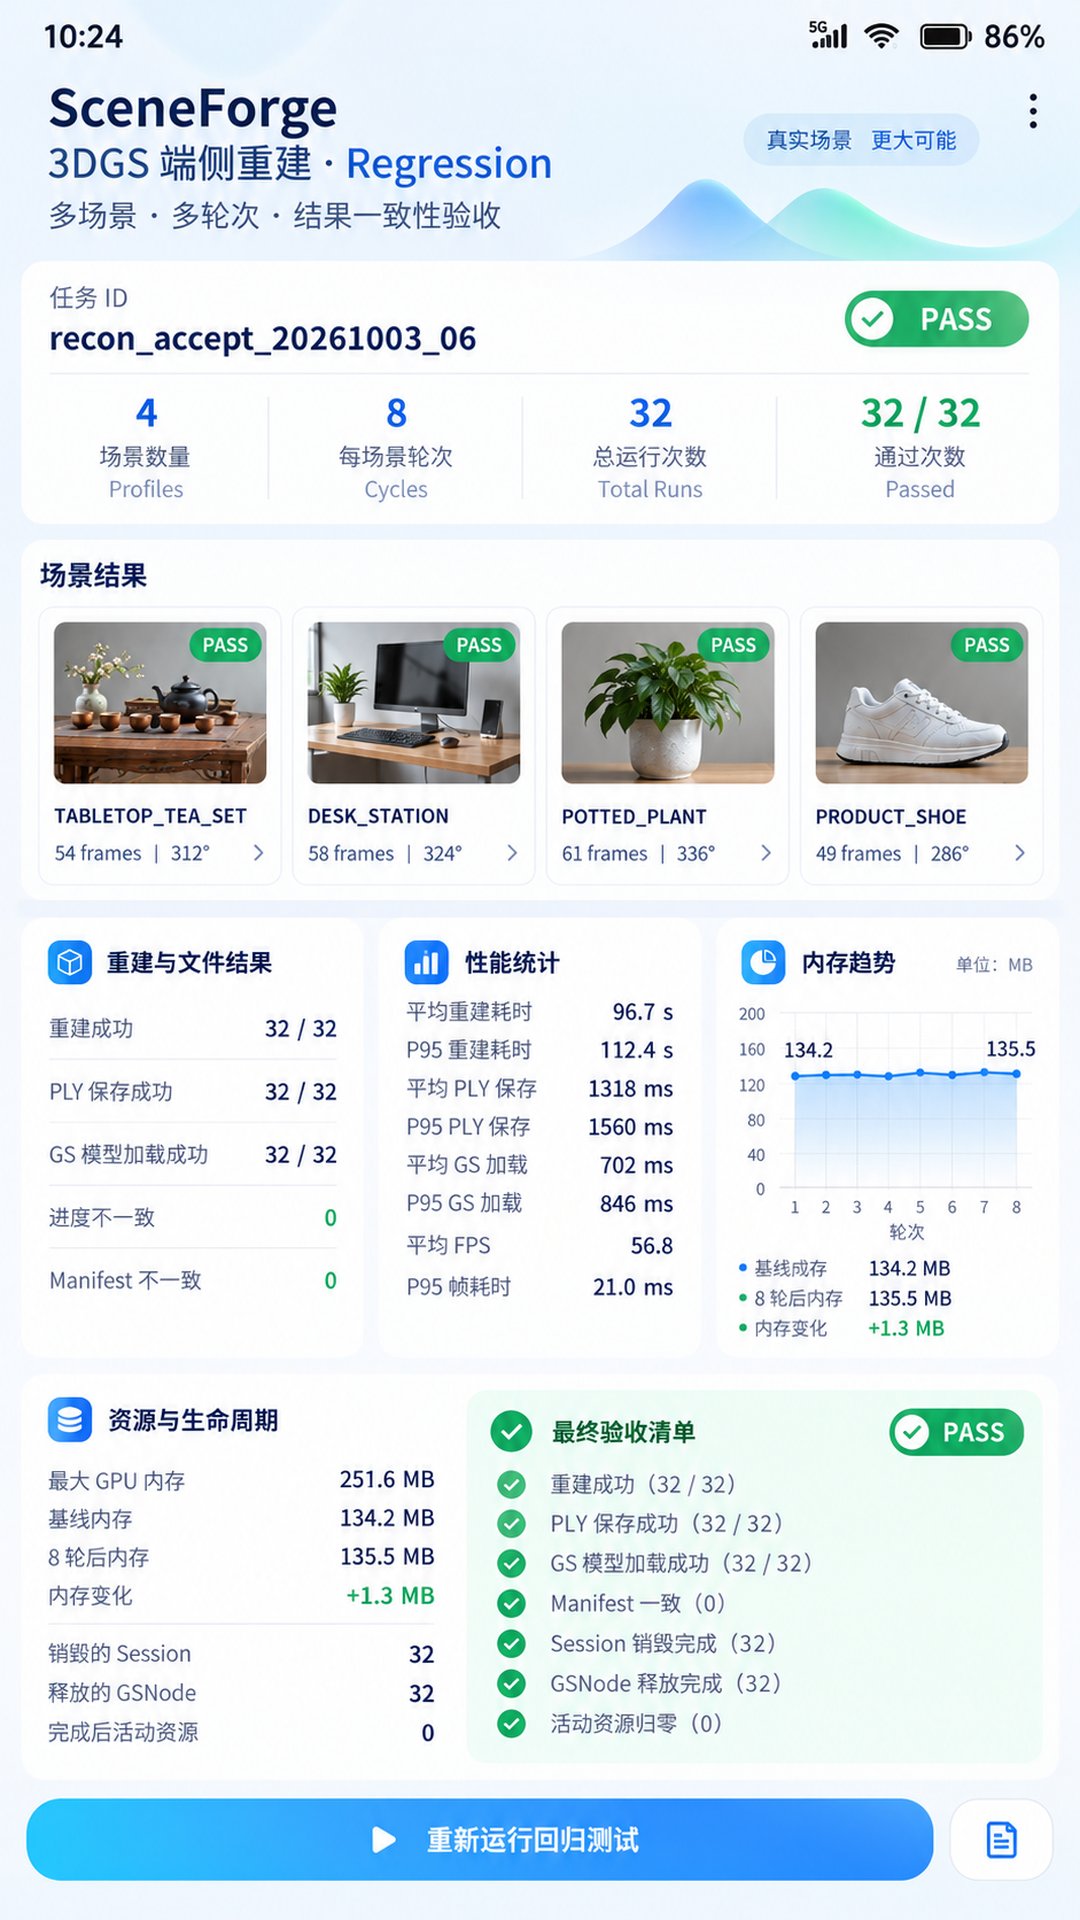
四个 Profile:
TABLETOP_TEA_SET
PASS

DESK_STATION
PASS

POTTED_PLANT
PASS

PRODUCT_SHOE
PASS
下面直接看到:
32 / 32 Recon

32 / 32 PLY Save

32 / 32 GS Load

0 Progress mismatch

0 Manifest mismatch

0 Resource leak

32 Session Destroy

32 GSNode Release

0 Active resources
最终:
PASS
十六、回归失败必须保存“哪一段失败”的第一现场
如果某一次失败,Runner 不只记录:
profile=DESK
FAIL
而是保存:
capture metrics

Frame Gate reasons

Session progress timeline

save result

Manifest

GS load cost

frame time

resource snapshot
这样可以区分:
采集问题

重建问题

保存问题

渲染问题

资源泄漏
不会所有故障都堆到“3DGS 不稳定”这个模糊结论里。
十七、自动化回归和真实视觉检查仍然要分开
即使:
32/32
全部功能通过,
3DGS 最终效果仍然需要人工查看:
细杆有没有缺失

高光有没有漂浮

植物叶片是否破碎

鞋带 / 边缘是否糊成一片

茶壶表面是否有明显浮点
所以 SceneForge 最终证据仍然是:
自动回归
+
视觉样本
不是一个数字替代全部质量判断。
十八、06 的 PASS 只属于当前测试矩阵
这一点必须保持克制。
PASS 代表:
当前 SceneForge 版本

当前支持设备

当前系统 / SDK

当前 4 个场景

每场景 8 轮
全部满足项目阈值。
它不代表:
任何大场景

任何户外环境

任何未来设备

任何采集轨迹

都一定稳定。
越接近空间计算这种复杂链路,测试边界越需要写清楚。
十九、SceneForge 六篇最终是一条完整的“从现实到可交互模型”链
回头看整个系列:
01
DataFrame 输入规范

02
Frame Gate 输入质量

03
Session 生命周期

04
PLY / MP4 资产保存

05
GSPlugin 实时渲染

06
多场景回归验收
用户看到的动作只是:
围着物体拍一圈
工程里真正经历的是:
相机数据
→ Native Session
→ 3DGS Result
→ Persistent Asset
→ ArkGraphics 3D Scene
→ Interactive Viewer
这就是这个系列最想留下的工程主线。
二十、SceneForge 到 06 正式结束
固定 X=6,到这里不再续写 07。
继续写新的茶具、鞋子、绿植,只会换输入,不会增加新的工程主矛盾。
下一轮应该切换到明显不同的技术方向和新 Demo,从新的 01 开始。
更适合的方向可以是:
折叠屏 / 平板 / PC 多形态适配

平行视界 / EasyGo

三方框架适配
避免继续重复 3DGS 主线。
二十一、四个 Profile 必须固定数据集版本,否则下一次 P95 没法比较
SceneForge 的回归配置不只保存:
scene name
frames
coverage
还保存:
datasetRevision
frameManifestHash
gatePolicyRevision
例如茶具本轮使用:
tabletop_tea_set_v3
如果下次采集换了光照、路径或帧数,却还拿新的 103 秒和旧的 96 秒比较,结论没有意义。
所以性能基线永远和数据集版本绑定。
真正的 Regression 不是“名字一样”,而是输入证据可复现。
二十二、Frame Gate 也要纳入回归,不能只看最终 Accepted 数量
本轮四个 Profile Accepted:
54
58
61
49
但 Runner 还保存:
duplicate
blur
lowBaseline
poseJump
四类拒绝分布。
如果下一个版本仍然 Accept 54 帧,但:
duplicate 从 6 变成 0
poseJump 从 3 变成 9
说明 Gate 行为已经变化。
所以 06 不只验收 Accepted Count,还会对 Reject Reason 分布设容忍区间。
文章里为了避免表格过重,只保留最终帧数与覆盖率。
二十三、重建阶段要检查 Stage 轨迹是否合法
正常轨迹通常类似:
INIT
→ BUILDING
→ FINISHED
如果中间触发热保护:
BUILDING
→ PAUSED
→ BUILDING
→ FINISHED
都可以接受。
但如果出现:
FINISHED
→ BUILDING
或者:
SAVING
→ BUILDING
就是状态机异常。
Runner 会保存每轮 Stage Timeline,再和允许的转换表比较。
这比只看最终 FINISHED 更能发现生命周期回归。
二十四、Save 回归不能只检查“文件存在”
PLY 文件存在并不代表保存完全正确。
每轮还检查:
fileSize > 0
Manifest size 一致
hash 一致
taskId 一致
save callback success
如果第 7 轮错误复用第 6 轮文件:
路径存在
但 Manifest hash 会不一致。
本轮:
manifestMismatch=0
正是用来抓这一类错误。
二十五、GS Load 回归要区分冷加载和页面 Reload
05 已经做过一次:
release
→ reload
06 每个 Profile 8 轮里会穿插:
冷加载
页面重新进入
模型 reload
不同路径都必须满足:
GSNode 最终只有 1 个
首帧能够出现
退出后资源归零
这样 renderLoadSuccess=32/32 才不是“32 次都从干净冷启动进来”的单一路径。
二十六、FPS 采样必须避开模型刚加载的首几帧
模型加载后的前几帧往往包含:
资源上传
Shader / Pipeline 准备
缓存建立
如果直接把它们和用户稳定交互阶段混在一起,平均 FPS 会被首帧成本扭曲。
所以 SceneForge 分开:
gsLoadCost
firstFrameCost
steadyFrameMetrics
avgFps=56.8 和 p95FrameTime=21.0ms 只统计稳定交互窗口。
这样 05 的:
firstFrame=71ms
不会被藏进 FPS。
二十七、GPU 峰值要和应用内存趋势同时看
只看 GPU:
251.6MB
无法判断 ArkTS / Native 引用是否泄漏。
只看应用内存:
+1.3MB
又可能看不到渲染资源没释放。
所以最终回归同时记录:
GPU peak
idle process memory
active GSNode
active Scene bindings
active Native Session
几条证据互相交叉。
空间渲染问题不能只用一个内存数字概括。
二十八、资源释放测试要在页面退出以后再采样
如果刚调用:
dispose()
马上读取一次内存,并不能证明资源真正完成回收。
06 统一等待一个稳定观察窗口,再采:
afterCycleMemory
activeResources
所有轮次都使用同一采样协议。
这样 134.2 → 135.5MB 才具有版本间比较意义。
二十九、32 个 Session Destroy 和 32 个 GSNode Release 必须来自两套独立计数器
如果用一个统一:
completedResources++
即使某次只 Destroy Session、没 Release GSNode,也可能被误记成“两个都完成”。
所以 Native Recon Manager 统计:
destroyedSessions
ArkTS Render Registry 统计:
releasedGsNodes
最终 Acceptance 汇总再比较:
32
32
两套 Owner 各自负责自己的资源闭环。
三十、PASS 还要包含“没有隐藏警告”
有些测试功能上成功,但日志里持续出现:
GetProgress failure
Manifest retry
FirstFrame timeout retry
Resource destroy warning
如果 Runner 只看最终成功次数,这些问题会被掩盖。
SceneForge 最终还统计:
warningCount
unexpectedErrorCount
当前验收中关键错误与资源警告都为 0,才给最终 PASS。
三十一、最终报告要保存每个 Profile 的代表性视觉样本
自动指标不能判断:
茶壶边缘有没有浮点
绿植叶片有没有破碎
鞋面纹理有没有拉花
桌面显示器边缘有没有缺口
因此每个 Profile 在第 1 轮与第 8 轮都会保存固定相机 Preset 的截图。
后续版本升级时,开发者可以:
同相机
同视角
同场景
直接对比。
这比随手截图更适合视觉回归。
三十二、SceneForge 最终可复用的不是一套茶具参数,而是一套分层指标
真正可以迁移到后续空间项目里的,是这些指标层:
Input
帧数 / Gate / 覆盖

Recon
Stage / Build Cost / Pause

Persist
PLY / Manifest / Save Cost

Render
Load / First Frame / FPS / GPU

Lifecycle
Destroy / Release / Active Resources
只要新的 3DGS 项目仍然走:
采集 → 重建 → 保存 → 渲染
就可以继续沿用这套 Acceptance 结构。
具体阈值再按场景重新定。
三十三、06 的基线要在系统或 SDK 升级后整体重跑
当前 spatialRender 和 GSPlugin 仍然在持续演进,2026 年 9 月的 API 变更就调整了 API model 标记并增加了插件相关静态 getter。只要出现:
HarmonyOS 版本升级
Spatial Recon Kit 升级
ArkGraphics 3D 升级
SceneForge Adapter 改动
就不能只挑一两个场景抽测,而要重新跑完整 4×8 矩阵。
性能数值、资源峰值和加载时延只有绑定具体系统与 SDK 版本才有意义。
三十四、最终验收文件还要能被下一轮自动化直接读取
Acceptance 结果最终会输出结构化 JSON,至少包含:
taskId
profiles
cycles
passCount
性能指标
资源指标
环境版本
这样 CI 或后续技术文章生成流程可以直接读取“上一版基线”,不需要从 HiLog 里重新解析数字。系列虽然结束,但基线会继续留在工程里,成为下一次系统升级时最有价值的对照证据。
补充一点,最终 PASS 之前还会把第 1 轮与第 8 轮的模型文件大小、Manifest hash、固定机位截图做成对照。如果同一 Profile 的结果在没有输入变化时出现明显漂移,会单独标记 RESULT_DRIFT,而不是继续依赖总成功次数掩盖问题。
参考资料
- HarmonyOS 空间计算能力
https://developer.huawei.com/consumer/cn/features/spatialization - Spatial Recon Kit / spatialRender API 变更
https://developer.huawei.com/consumer/en/doc/harmonyos-releases/js-apidiff-spatialreconkit-6101 - ArkGraphics 3D
https://developer.huawei.com/consumer/cn/sdk/arkgraphics-3d/ - ArkGraphics 3D 资源释放
https://developer.huawei.com/consumer/cn/doc/doccenter-references/api/js-apis-inner-scene-resources

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献159条内容

所有评论(0)