
HarmonyOS 7 PixelForge 图像超分工程实录 05:Stage × ImageSR:前后台切换、结果写盘与异常恢复【鸿蒙心迹】
前四篇把 PixelForge 的“正常路径”基本铺平了。
01 解决单图从文件到 PixelMap、超分、编码和释放;02 把这条链放进批量队列,压住并发带来的内存峰值;03 用 Region Decode、96px 输入重叠和 Feather Blend 把 4439×2959 大图拆成 4 块;04 又给结果增加了 sourceHash + scale + modelRevision 缓存,第二次命中只需要 17ms。
第五篇开始处理一个正常 Demo 很少主动碰,但真实应用一定会遇到的问题:超分还没完全写盘,应用切到后台,甚至进程重启,结果该怎么恢复。
我故意把故障点放在最尴尬的位置:
Decode 完成
→ Super Resolution 完成
→ 已经开始写临时结果
→ 应用进入后台
→ fault injection 模拟进程重启
→ 正式文件还没 commit
如果恢复设计不清楚,会出现三种结果:
重新跑一遍超分,白白浪费算力;

临时文件被当成正式结果,可能读到半成品;

页面恢复了,但任务状态还是上一轮的“处理中”。
所以 05 的核心不是“让超分永远在后台继续跑”。HarmonyOS 的后台任务本身是受系统规则约束的,普通 UIAbility 进入后台以后不能假设长耗时计算一定持续。PixelForge 采用更保守的策略:前后台切换只负责保存可恢复状态;进程如果还活着可以继续,但正确性绝不依赖它一定继续。
本轮统一数据:
taskId:
sr_20261003_05

recoveryId:
sr_recovery_20261003_05

source:
family_trip_2048x1365.jpg

input:
2048 × 1365

requestedScale:
3x

targetOutput:
6144 × 4095

outputFileSize:
7.8MB

stageBeforeBackground:
TEMP_WRITING

journalSeq:
17

backgroundDuration:
42s

processRestart:
true

restartGeneration:
2

tempFile:
sr_20261003_05.tmp.jpg

tempValidated:
true

restoreCost:
31ms

commitRenameCost:
9ms

rerunSr:
false

releasedPixelMaps:
2

orphanTempCleaned:
0

status:
RECOVERY_READY
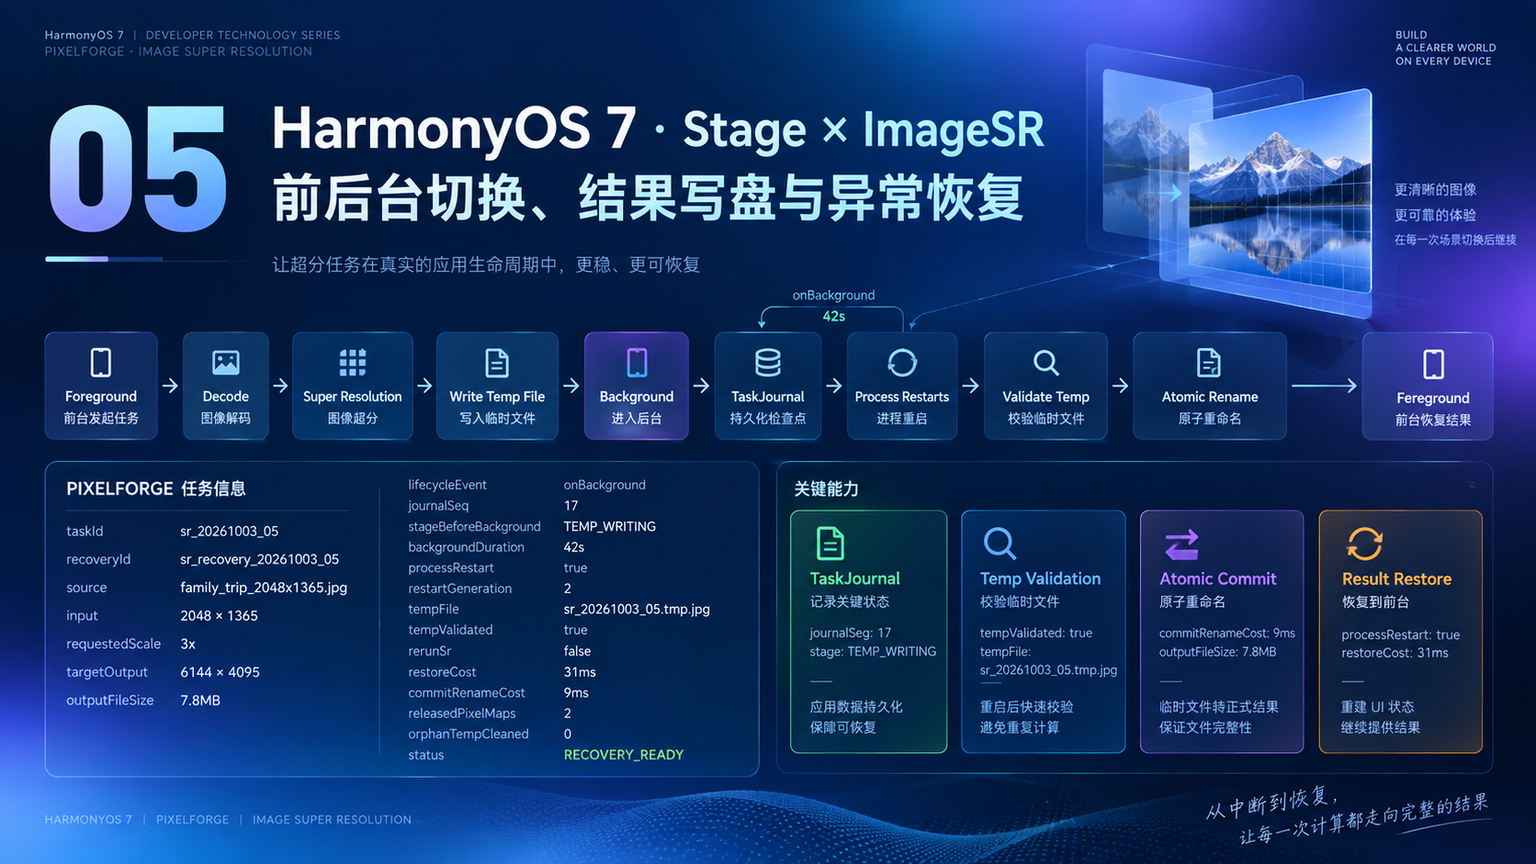
一、进入后台时,先保存“可恢复事实”,不要保存运行时对象
页面切后台时最容易犯的错误,是试图把当前对象直接“留着等回来”:
PixelMap
ImagePacker
Adapter 实例
Promise
页面 @State
这些都不适合作为恢复依据。
PixelForge 真正持久化的是 SrTaskJournal:
export interface SrTaskJournal {
  schemaVersion: number

  taskId: string
  recoveryId: string

  sourcePath: string
  sourceHash: string

  requestedScale: number
  targetWidth: number
  targetHeight: number

  stage:
    'DECODED' |
    'SR_DONE' |
    'TEMP_WRITING' |
    'TEMP_WRITTEN' |
    'COMMITTED'

  tempFile: string
  finalFile: string

  journalSeq: number
  updatedAt: number
}
这里没有 PixelMap。
恢复时只需要知道:
任务是谁;
处理到哪一步;
临时文件在哪里;
最终文件应该叫什么;
当前状态是不是已经可以直接提交。
这和 04 的缓存索引思路类似:持久化的是结果身份与阶段,不是大对象本身。
二、onBackground 的职责是落 Journal,不承诺任务永久后台运行
Stage 模型里,UIAbility 会经历前后台生命周期变化。PixelForge 在 onBackground() 里只做一件关键事:把当前 Journal 写入持久化存储。
import { preferences } from '@kit.ArkData'
import { common } from '@kit.AbilityKit'

export class SrTaskJournalRepository {
  private readonly name =
    'pixelforge_sr_task_journal'

  async save(
    context: common.UIAbilityContext,
    journal: SrTaskJournal
  ): Promise<void> {
    const store =
      await preferences.getPreferences(
        context,
        { name: this.name }
      )

    await store.put(
      journal.taskId,
      JSON.stringify(journal)
    )

    await store.flush()
  }
}
本轮进入后台时:
stage=TEMP_WRITING
journalSeq=17
日志先写 Journal,再让页面进入 Background。
这条顺序很重要。
如果先让页面销毁、再异步保存,很可能恢复证据还没落盘,进程就已经不在了。
三、为什么 TEMP_WRITING 不能直接当成“结果已经可用”
TEMP_WRITING 只代表:
编码链已经开始;
目标是临时文件;
正式文件还没有 commit。
它不代表:
文件完整;
JPEG 尾部已经写完;
结果尺寸可读;
可以直接交给页面。
所以重启后看到 TEMP_WRITING,恢复器不会直接 rename。
先走:
TempResultValidator
本轮 fault injection 模拟的是:虽然 Journal 最后一次落盘仍然是 TEMP_WRITING,但进程终止前底层编码实际上已经把临时文件写完整了。
因此恢复时要以文件证据重新判断,而不是盲信旧状态。
四、临时结果要做轻量完整性校验
恢复器至少检查:
临时文件存在;
文件大小大于 0;
图片头可解析;
宽高为 6144 × 4095;
编码格式符合预期。
export class TempResultValidator {
  async validate(
    tempPath: string,
    expectedWidth: number,
    expectedHeight: number
  ): Promise<boolean> {
    if (
      !this.fileOps.exists(tempPath)
    ) {
      return false
    }

    const info =
      await this.imageProbe.readInfo(
        tempPath
      )

    return (
      info.width ===
        expectedWidth &&
      info.height ===
        expectedHeight &&
      info.fileSize > 0
    )
  }
}
本轮:
tempValidated=true
因此不需要重新跑 3x 超分。
五、正式提交用“临时文件 → 最终文件”作为业务提交点
05 延续 04 的两阶段写入思想。
超分结果先进入:
sr_20261003_05.tmp.jpg
只有验证通过后,才提交为:
family_trip_2048x1365_sr.jpg
项目侧把同一沙箱目录里的 rename 当成最终 commit 点。
import { fileIo } from '@kit.CoreFileKit'

export class AtomicResultCommitter {
  async commit(
    tempPath: string,
    finalPath: string
  ): Promise<void> {
    await fileIo.rename(
      tempPath,
      finalPath
    )
  }
}
本轮:
commitRenameCost=9ms
注意这里说的是 PixelForge 的业务提交策略,不把它扩写成“所有文件系统场景下 rename 都具备完全相同的事务语义”。
六、恢复时先看 Journal,再看文件,不重新猜任务状态
进程重启后:
restartGeneration=2
恢复顺序固定:
读取 Journal
→ 读取 source / target
→ 检查 temp
→ 校验临时结果
→ 判断是否需要重新 SR
→ commit
→ 更新 Journal=COMMITTED
→ 页面恢复结果
Coordinator:
export class SrRecoveryCoordinator {
  async restore(
    taskId: string
  ): Promise<SrRecoveryResult> {
    const journal =
      await this.journalRepo
        .load(taskId)

    if (!journal) {
      return {
        restored: false,
        reason:
          'JOURNAL_NOT_FOUND'
      }
    }

    const tempValid =
      await this.validator
        .validate(
          journal.tempFile,
          journal.targetWidth,
          journal.targetHeight
        )

    if (tempValid) {
      await this.committer
        .commit(
          journal.tempFile,
          journal.finalFile
        )

      await this.journalRepo
        .markCommitted(
          journal.taskId
        )

      return {
        restored: true,
        rerunSr: false
      }
    }

    return {
      restored: false,
      rerunSr: true,
      reason:
        'TEMP_NOT_USABLE'
    }
  }
}
本轮最终:
rerunSr=false
这就是恢复价值最直接的体现。
七、如果临时文件只有一半,必须重新算,不能“尽量修”
如果校验失败:
tempValidated=false
PixelForge 不会尝试:
继续从 JPEG 半文件末尾追加;
猜测编码器状态;
把损坏文件交给 UI。
而是:
删除 temp;
Journal 回退到可重算阶段;
重新 Decode / SR / Encode。
因为图像超分这一步当前没有项目级“推理中间 checkpoint”。
恢复粒度应该和真实可恢复能力一致。
不能为了看起来高级,伪造一个模型内部断点续算。
八、前后台切换和“后台保活”要明确区分
HarmonyOS 文档中心对 Background Tasks Kit 的定位是:系统提供规范内、受约束的后台任务。
所以 PixelForge 05 不写:
onBackground 后
SR 保证继续 42 秒
本轮的 42 秒只是测试中的后台间隔。
如果进程仍然运行,异步操作可能继续;如果被系统回收,恢复器依赖 Journal 和临时文件继续。
正确性依赖持久化证据,不依赖后台一定活着。
这是整篇最重要的边界。
九、页面恢复只重建 UI Snapshot,不重建 PixelMap
onForeground() 以后,页面只拿:
finalFile path
width
height
file size
status
不会把刚刚恢复的 6144×4095 大图直接作为常驻 PixelMap 塞进 @State。
列表 / 结果页仍然按展示尺寸加载预览。
完整结果只在用户点击查看时解码。
这样恢复过程不会刚避开一次 OOM,又因为 UI 预览把大图重新顶进内存。
十、PixelMap 释放计数为什么仍然是 2
本轮只执行过一次真正的 SR:
input PixelMap
output PixelMap
结果写入临时文件以后:
releasedPixelMaps=2
恢复阶段没有重新解码大结果 PixelMap,也没有重新跑超分。
所以恢复本身几乎只操作:
Journal
文件元数据
rename
这也是 restoreCost=31ms 能保持很低的原因。
十一、orphanTempCleaned=0 是本轮正常结果
本轮临时文件:
sr_20261003_05.tmp.jpg
被成功校验并 rename。
所以:
orphanTempCleaned=0
如果任务失败、Journal 丢失或 temp 对不上 taskId,启动清理器会把孤儿临时文件移除。
05 把这条指标加进来,是为了以后长期运行不让:
*.tmp.jpg
越积越多。
十二、DevEco 图重点看恢复链,而不是再看一次超分效果
开发图:
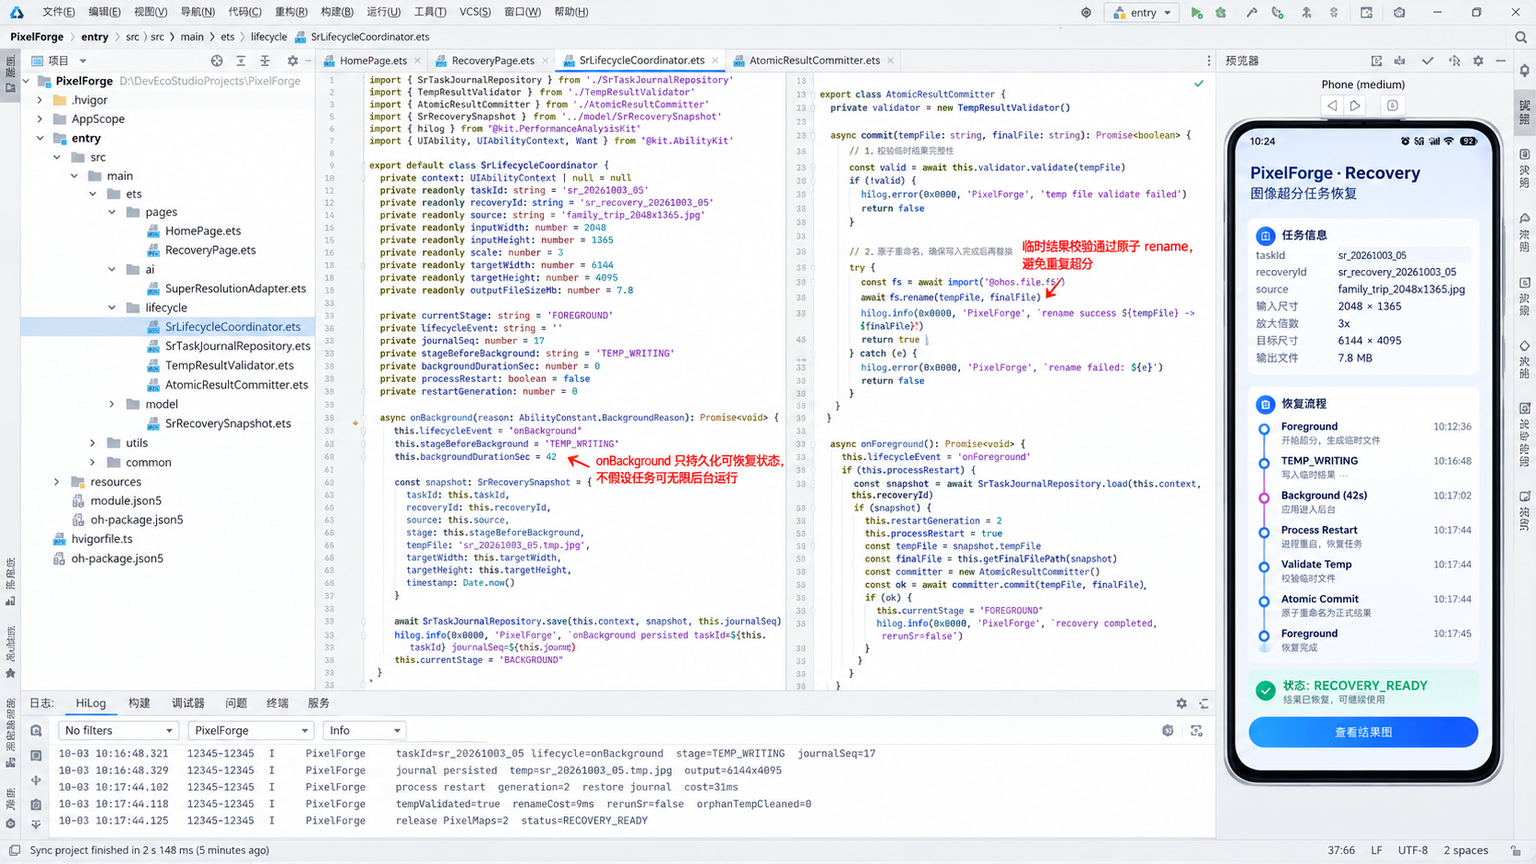
统一日志:
taskId=
sr_20261003_05

lifecycle=
onBackground

stage=
TEMP_WRITING

journalSeq=
17

temp=
sr_20261003_05.tmp.jpg

output=
6144x4095

process restart

generation=
2

restore journal

cost=
31ms

tempValidated=
true

renameCost=
9ms

rerunSr=
false

orphanTempCleaned=
0

releasedPixelMaps=
2

status=
RECOVERY_READY
这一屏证明的是:
任务可以从“运行时对象已经丢失”的状态恢复到一个确定结果。
十三、运行图把“前台 → 后台 → 重启 → 恢复”串成一条线
最终运行图:
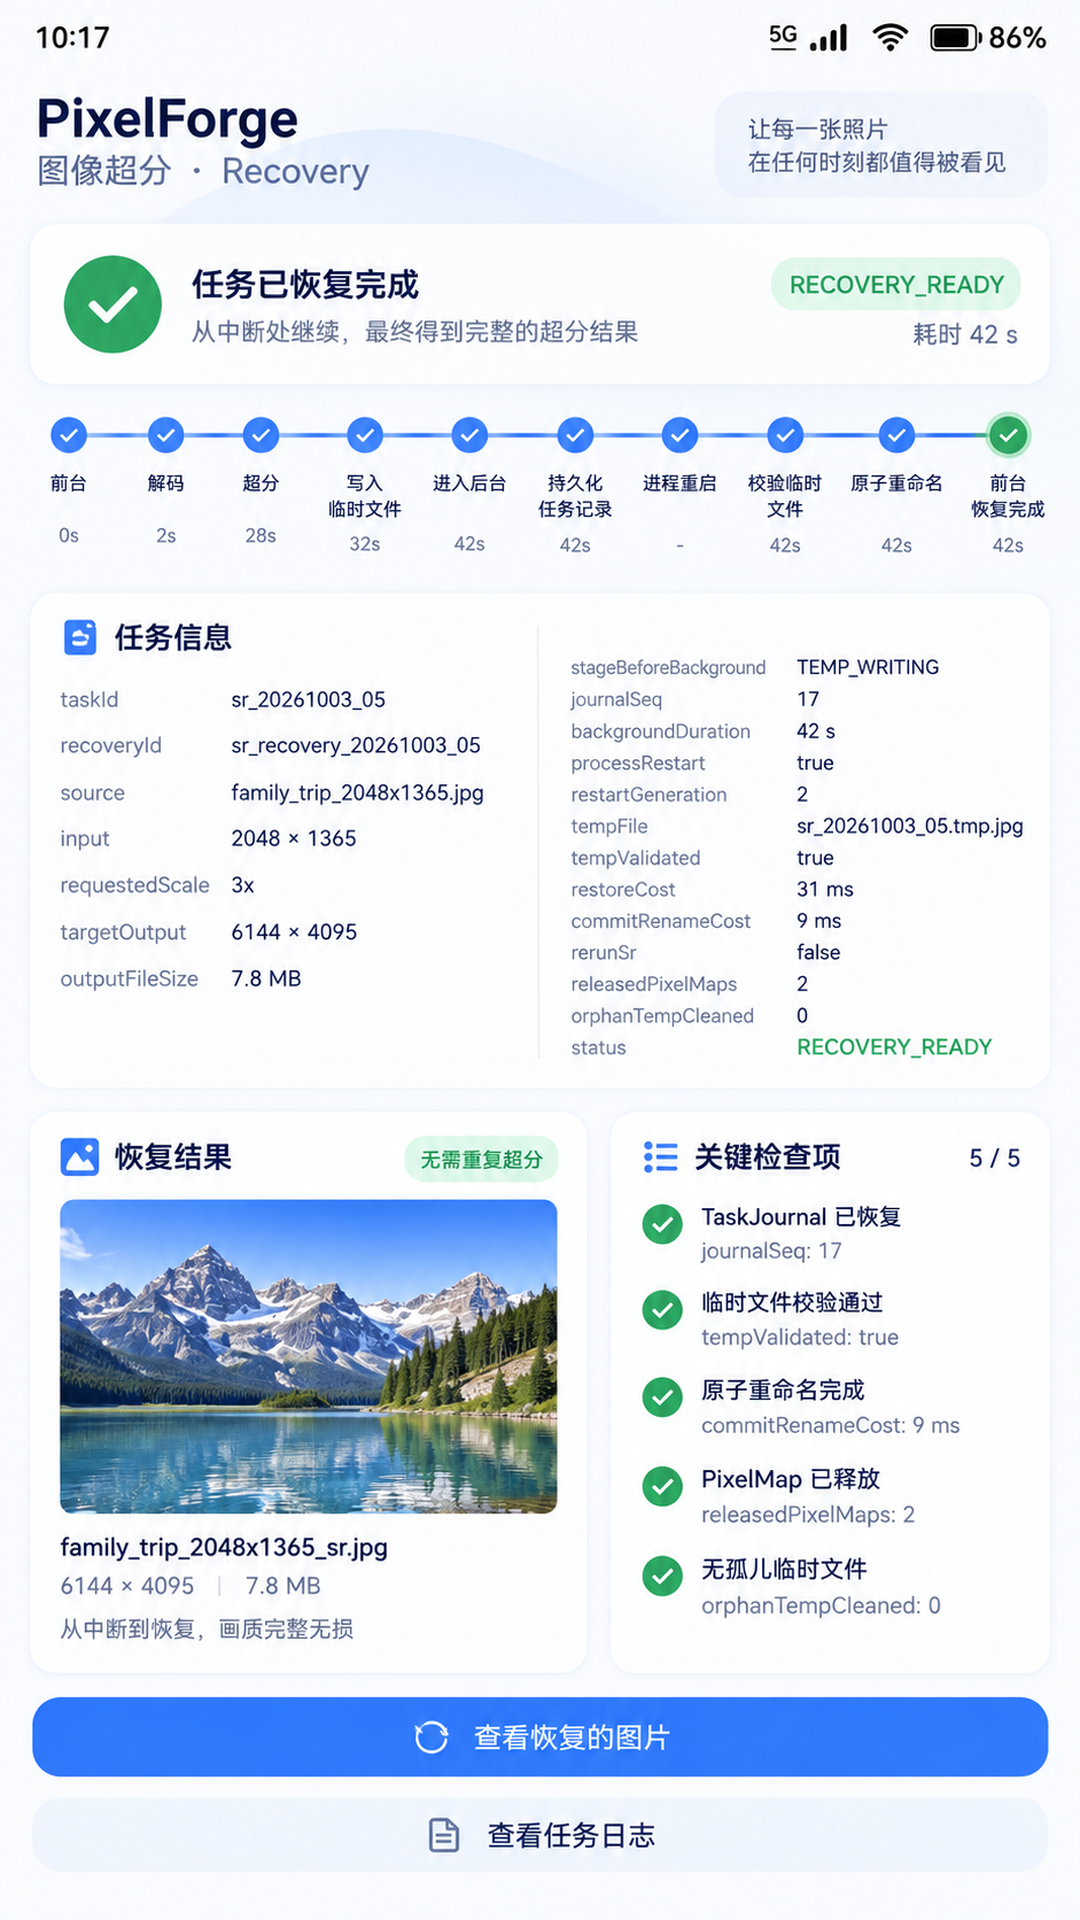
顶部时间线能看到:
Foreground
→ Decode
→ SR
→ 写临时文件
→ Background 42s
→ 持久化 Journal
→ Process Restart
→ Validate Temp
→ Atomic Commit
→ Foreground
任务信息:
2048×1365
→
6144×4095

7.8MB
最终:
RECOVERY_READY
它不是“后台一直算完”的演示,而是“中断以后仍然能得到正确结果”的演示。
十四、Journal 也要有 schemaVersion
05 当前:
schemaVersion=1
后面如果恢复信息增加:
modelRevision
cacheKey
tileManifest
encodeProfile
旧 Journal 需要迁移。
无法迁移时:
不要继续猜;
标记 JOURNAL_INCOMPATIBLE;
回到安全重算。
恢复系统最怕“半懂旧状态”。
宁可重新算一次,也不要把错误任务推进到 COMMITTED。
十五、临时文件和缓存文件不是一回事
04 的 Cache:
可以删;
删了只是下次重新算。
05 的 Temp Result:
是当前未完成事务的一部分;
恢复前不能随便清。
所以目录和生命周期要分开:
cache/
→ 可淘汰

recovery/
→ 活跃任务临时文件

files/
→ 最终结果
如果把三者混在同一个“缓存目录”,系统清理或业务清理都可能误删正在恢复的结果。
十六、恢复完成后要一次性收口 Journal
正式文件已经存在以后:
Journal.stage=COMMITTED
还需要保存:
finalFile
committedAt
restartGeneration
随后从“活动恢复队列”移除。
历史记录可以保留,但不再当作“待恢复任务”。
否则下一次应用启动又会重复执行 recovery。
十七、05 最后固定七组故障注入
第一组,正常前后台切换,进程不重启。
第二组,TEMP_WRITING 后模拟进程重启,temp 完整,直接 commit。
第三组,temp 缺失,回退重算。
第四组,temp 尺寸不匹配,删除并重算。
第五组,Journal 与 temp taskId 不一致,拒绝恢复。
第六组,rename 失败,正式结果不暴露给 UI。
第七组,再次冷启动,不重复处理已 COMMITTED 任务。
这七组都通过后:
RECOVERY_READY
才有工程意义。
十八、下一篇只做最终验收,不再加新功能
PixelForge 到现在已经有:
单图 SR
批量队列
大图分块
拼接缝治理
本地缓存
前后台恢复
两阶段写盘
06 不再增加功能。
最后一篇只做:
多尺寸
多格式
耗时
内存
缓存正确性
恢复正确性
资源释放
整套回归。
十九、Journal 写入也要防“旧状态覆盖新状态”
恢复记录本身也是异步 I/O。
如果生命周期变化很快,可能出现:
seq17:
TEMP_WRITING

seq18:
TEMP_WRITTEN
但 seq17 的 flush 比 seq18 更晚完成。
如果 Repository 只按“谁最后写完”覆盖,就可能把更旧的状态重新写回去。
所以 PixelForge 给 Journal 增加单调递增的:
journalSeq
写入前先读取当前序号:
export class JournalMonotonicGuard {
  canWrite(
    currentSeq: number,
    incomingSeq: number
  ): boolean {
    return (
      incomingSeq >
      currentSeq
    )
  }
}
本轮恢复读取到:
journalSeq=17
是因为 fault injection 刻意发生在下一次持久化之前。
真实链路里,只允许更大的 seq 覆盖旧值。
这能避免前后台快速切换时出现“状态回退”。
二十、恢复操作本身也必须幂等
应用恢复时可能同时出现:
onForeground
页面重新进入
启动时 recovery scan
三个入口。
如果它们都调用一次:
validate temp
rename
mark committed
第二次 rename 就会失败。
所以 SrRecoveryCoordinator 自己维护:
RESTORING
RESTORED
状态。
同一个 taskId 正在恢复时:
新的 restore 请求直接复用当前 Promise
已经恢复完成:
直接返回 finalFile
不会再次执行 commit。
“恢复链只执行一次”比调用方记住不要重复调更可靠。
二十一、最终文件存在时,要先确认它属于当前 taskId
假设:
family_trip_2048x1365_sr.jpg
已经存在。
恢复器不能简单判断:
final file exists
→ success
还要核对 sidecar:
taskId
sourceHash
scale
modelRevision
outputSize
只有上下文一致才算当前任务的结果。
如果 finalFile 来自上一张同名源图:
FINAL_CONTEXT_MISMATCH
当前任务仍然要重新生成或恢复自己的结果。
这和 04 缓存里“不能按文件名复用旧结果”是同一条原则。
二十二、后台回来以后页面应该先显示恢复态,再显示最终结果
如果页面一回来就先展示:
空白
然后 31ms 后突然跳成结果图,体验会显得不稳定。
PixelForge UI 状态改成:
RESTORING
→ RECOVERY_READY
RESTORING 阶段展示:
正在校验任务结果
但不会重新出现:
正在 AI 超分 0%
因为本轮实际并没有重新推理。
UI 文案必须和真实恢复阶段一致。
这也是 rerunSr=false 要直接暴露到诊断页的原因。
二十三、异常恢复还要覆盖“应用正常退出”的反向路径
并不是每一次临时文件都应该恢复。
如果用户主动:
取消任务
Journal 会写:
CANCELLED
然后:
删除 temp
释放 PixelMap
移出恢复队列
下一次冷启动不应该把用户取消的任务重新捞回来。
所以 Recovery Scanner 只扫描:
TEMP_WRITING
TEMP_WRITTEN
COMMIT_PENDING
不会扫描:
CANCELLED
FAILED_FINAL
COMMITTED
这能避免“恢复系统过于积极”。
二十四、临时文件清理要有宽限期
应用启动时看到陌生 .tmp.jpg,也不能立刻删除。
有可能另一个任务刚刚写完 Journal,但文件系统和索引更新时间存在短暂差异。
PixelForge 给孤儿临时文件设置:
grace period
只有:
没有活跃 Journal
并且
超过宽限时间
才清理。
本轮:
orphanTempCleaned=0
表示没有误删任何仍可恢复的结果。
二十五、05 的验收重点不是“后台 42 秒没出错”
如果只看这次测试,很容易得出:
切后台 42 秒
任务照样成功
这个结论不够严谨。
真正验收的是:
后台是否继续运行
不影响恢复正确性;

进程是否重启
不影响最终结果身份;

临时文件是否完整
决定是否需要重算;

页面重新进入
不会制造重复任务。
所以文章里保留 backgroundDuration=42s,只是说明测试时间线,不把它写成系统后台执行保证。
二十六、05 最后留给 06 的不是一个功能,而是一组可测指标
恢复链已经可以输出:
recoveryMismatch
rerunSr
restoreCost
orphanTempCleaned
activeRecoveryContext
releasedPixelMaps
06 不再凭肉眼看“恢复成功”。
它会把正常路径文件和恢复路径文件做一致性校验,并要求:
recoveryMismatch=0
activeResourcesAfterFinish=0
05 到这里才真正成为最终回归的一部分。
参考资料
- Core Vision Kit API 26 图像超分:
https://developer.huawei.com/consumer/en/doc/harmonyos-releases/js-apidiff-corevisionkit-7001 - Image Kit 图片解码与 PixelMap 释放:
https://developer.huawei.com/consumer/en/doc/harmonyos-guides-V14/image-decoding-V14 - HarmonyOS 文件系统:
https://developer.huawei.com/consumer/cn/doc/doccenter-atomic-service/develop-file-system - HarmonyOS 文档中心 / Background Tasks Kit:
https://developer.huawei.com/consumer/cn/doc/

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)