
HarmonyOS 7 AI Kit + RDB:文搜图结果的感知哈希族谱去重与可撤销合并【鸿蒙心迹】
文搜图能找到相关照片之后,结果页还有一个不那么显眼的问题:同一张素材经过裁剪、压缩和转发,会占掉大半屏。去重如果做得太狠,又会把真正不同的版本吞掉。
一、搜索没错,结果却不好用
这次的 Demo 叫 ClusterLens Lab。我给它准备了 1824 张展会素材,其中同一海报有原图、聊天软件压缩图、裁剪图和带水印图。查询“蓝色展台上的机器人”后,向量检索返回 120 条,相关性没有问题,但前 20 条里有 11 条几乎一样。
最初我们按文件摘要去重,结果只去掉了字节完全相同的副本;换成感知哈希以后,又把三张只是背景相似的不同展台照片合并了。UI 看起来干净了,业务上却更糟:用户找不到原本应该存在的素材,而且不知道它被谁“代表”了。
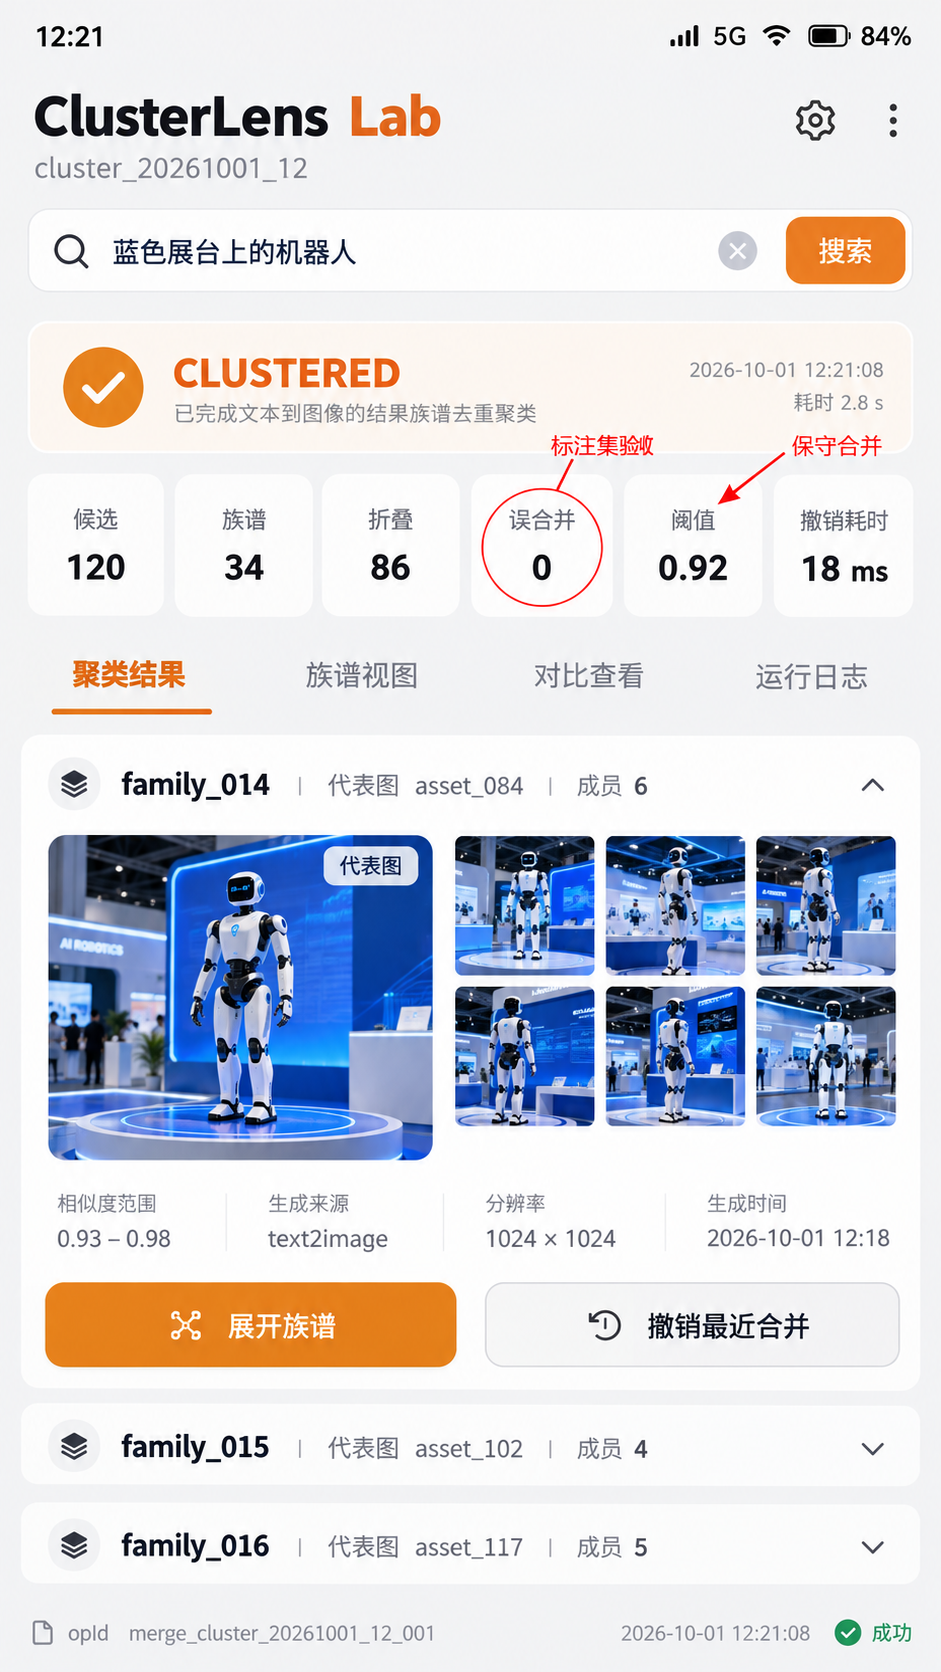
本轮会话固定为 cluster_20261001_12。最终处理数据是:原始候选 120 条,形成 34 个族谱,折叠重复项 86 条;误合并从 3 次降到 0,合并阈值为 0.92,撤销一次族谱合并耗时 18 ms,最终状态 CLUSTERED。
我没有把这件事写成一个 distinct(),而是拆成三个阶段:候选边生成、族谱归并、可撤销提交。向量相似度负责“语义相关”,感知哈希负责“视觉接近”,拍摄时间与尺寸比负责拒绝危险合并。三种信号各自有边界,任何一个都不适合单独拍板。
二、先生成候选边,不直接改结果列表
搜索服务已经按文本向量给出 120 条候选。去重阶段如果对任意两张图片做全量比较,需要 7140 次计算;数量再大一点,页面会明显卡住。我们先按 64 位感知哈希的前缀分桶,只在同桶和相邻桶中比较,再用汉明距离、宽高比和时间差生成“可能属于同一族”的边。
下面这段代码解决的是候选边的边界判断。它不会立刻删除任何图片,只产出可审计的 MergeEdge,后续归并可以拒绝或撤销。
export interface AssetFeature {
  id: string
  pHash: bigint
  width: number
  height: number
  capturedAt: number
  embeddingScore: number
}

export interface MergeEdge {
  leftId: string
  rightId: string
  confidence: number
  reason: string
}

export function buildEdge(a: AssetFeature, b: AssetFeature): MergeEdge | undefined {
  const distance = bitCount(a.pHash ^ b.pHash)
  const hashScore = 1 - distance / 64
  const ratioA = a.width / a.height
  const ratioB = b.width / b.height
  const ratioGap = Math.abs(ratioA - ratioB)
  const timeGap = Math.abs(a.capturedAt - b.capturedAt)

  if (hashScore < 0.92 || ratioGap > 0.08 || timeGap > 86_400_000) return undefined
  return {
    leftId: a.id,
    rightId: b.id,
    confidence: hashScore,
    reason: `phash=${hashScore.toFixed(3)},ratioGap=${ratioGap.toFixed(3)}`
  }
}
数据变化很明确:120 个候选仍然完整保留,只多了一组连接关系。0.92 不是通用真理,而是这批素材通过标注集验证后的门槛;如果换成证件照、连拍或设计稿版本库,需要重新标定。时间差设为一天,是因为展会素材的转发副本大多在当天产生,超过一天更可能是不同拍摄任务。
这里最容易写错的是只看哈希距离。裁剪会改变宽高比,纯色背景又可能让不同照片得到接近哈希,所以我们增加比例和时间两个否决条件。正式项目还可以加入文件来源、拍摄设备与 OCR 文本差异,但信号越多并不一定越稳,必须保留 reason 方便回放。
三、族谱不是数组分组,而是一组可解释关系
候选边生成后,我们用并查集把连通图片归为族谱。问题在于传递性:A 像 B,B 像 C,并不保证 A 像 C。如果直接合并连通分量,长链可能把边界完全不同的图片串成一族。
当前代码解决“传递合并失控”。每次准备把两个集合连接时,先找两个集合的代表图,再校验代表图之间的分数;不足 0.92 就拒绝这条边。代表图按分辨率、清晰度和原始来源优先级选择,不能简单用第一条。
export class FamilyBuilder {
  private parent = new Map<string, string>()
  private members = new Map<string, AssetFeature[]>()

  tryUnion(edge: MergeEdge): boolean {
    const leftRoot = this.find(edge.leftId)
    const rightRoot = this.find(edge.rightId)
    if (leftRoot === rightRoot) return false

    const leftCover = this.pickCover(this.members.get(leftRoot) ?? [])
    const rightCover = this.pickCover(this.members.get(rightRoot) ?? [])
    if (!leftCover || !rightCover || !buildEdge(leftCover, rightCover)) return false

    this.parent.set(rightRoot, leftRoot)
    this.members.set(leftRoot, [
      ...(this.members.get(leftRoot) ?? []),
      ...(this.members.get(rightRoot) ?? [])
    ])
    this.members.delete(rightRoot)
    return true
  }

  private pickCover(items: AssetFeature[]): AssetFeature | undefined {
    return [...items].sort((a, b) => b.width * b.height - a.width * a.height)[0]
  }
}
在这一步,120 条结果被投影为 34 个族谱,但任何素材都没有被删除。列表只显示每族代表图和“+N 个相似版本”,用户展开后仍能看到全部成员。代表图变化时,族谱 ID 不跟着变化,否则收藏状态和滚动位置会抖动;族谱使用独立的 familyId,封面只是属性。
FamilyBuilder 属于一次搜索会话,查询结束或页面销毁后应释放 Map。不能把它做成跨查询单例,否则下一次搜索可能继承上次的父节点。正式项目还需限制族谱最大成员数,超过上限时转入人工确认,避免极端连拍吞掉大量结果。
四、把归并写进 RDB,但保留撤销入口
界面确认无误后,我们才把族谱关系写入 RDB。早期方案直接更新素材表的 family_id,撤销时不知道旧值;现在额外保存操作日志,每次提交都有 opId、成员旧族谱、新族谱和阈值快照。
这段代码解决“批量写到一半”和“用户撤销”两个问题。关系更新与操作日志放在同一事务,任何一步失败都回滚,UI 只在事务成功后切换到 CLUSTERED。
export async function commitFamilies(store: relationalStore.RdbStore,
  sessionId: string, plans: FamilyPlan[]): Promise<string> {
  const opId = `merge_${sessionId}_${Date.now()}`
  await store.beginTransaction()
  try {
    for (const plan of plans) {
      for (const member of plan.members) {
        await store.update({ family_id: plan.familyId },
          new relationalStore.RdbPredicates('asset').equalTo('asset_id', member.id))
        await store.insert('family_journal', {
          op_id: opId, asset_id: member.id,
          old_family_id: member.oldFamilyId ?? '', new_family_id: plan.familyId,
          threshold: 0.92
        })
      }
    }
    await store.commit()
    return opId
  } catch (error) {
    await store.rollBack()
    throw error
  }
}
事务成功后,86 条重复项从主列表折叠,34 个代表项保留;日志里记录 opId=merge_cluster_20261001_12_001。撤销时按 opId 倒序读取旧族谱并恢复,再删除对应日志。重复点击提交会先检查同一会话是否存在已完成操作,避免同一批成员被写两次。
页面退出不会取消已开始的数据库提交,但会解除进度订阅;提交完成后仓库状态仍然一致。若应用在事务提交后、UI 刷新前退出,下次进入通过 opId 重建展示,不依赖内存中的列表。这个边界比“页面还在不在”更重要。
五、三次误合并是怎么消失的
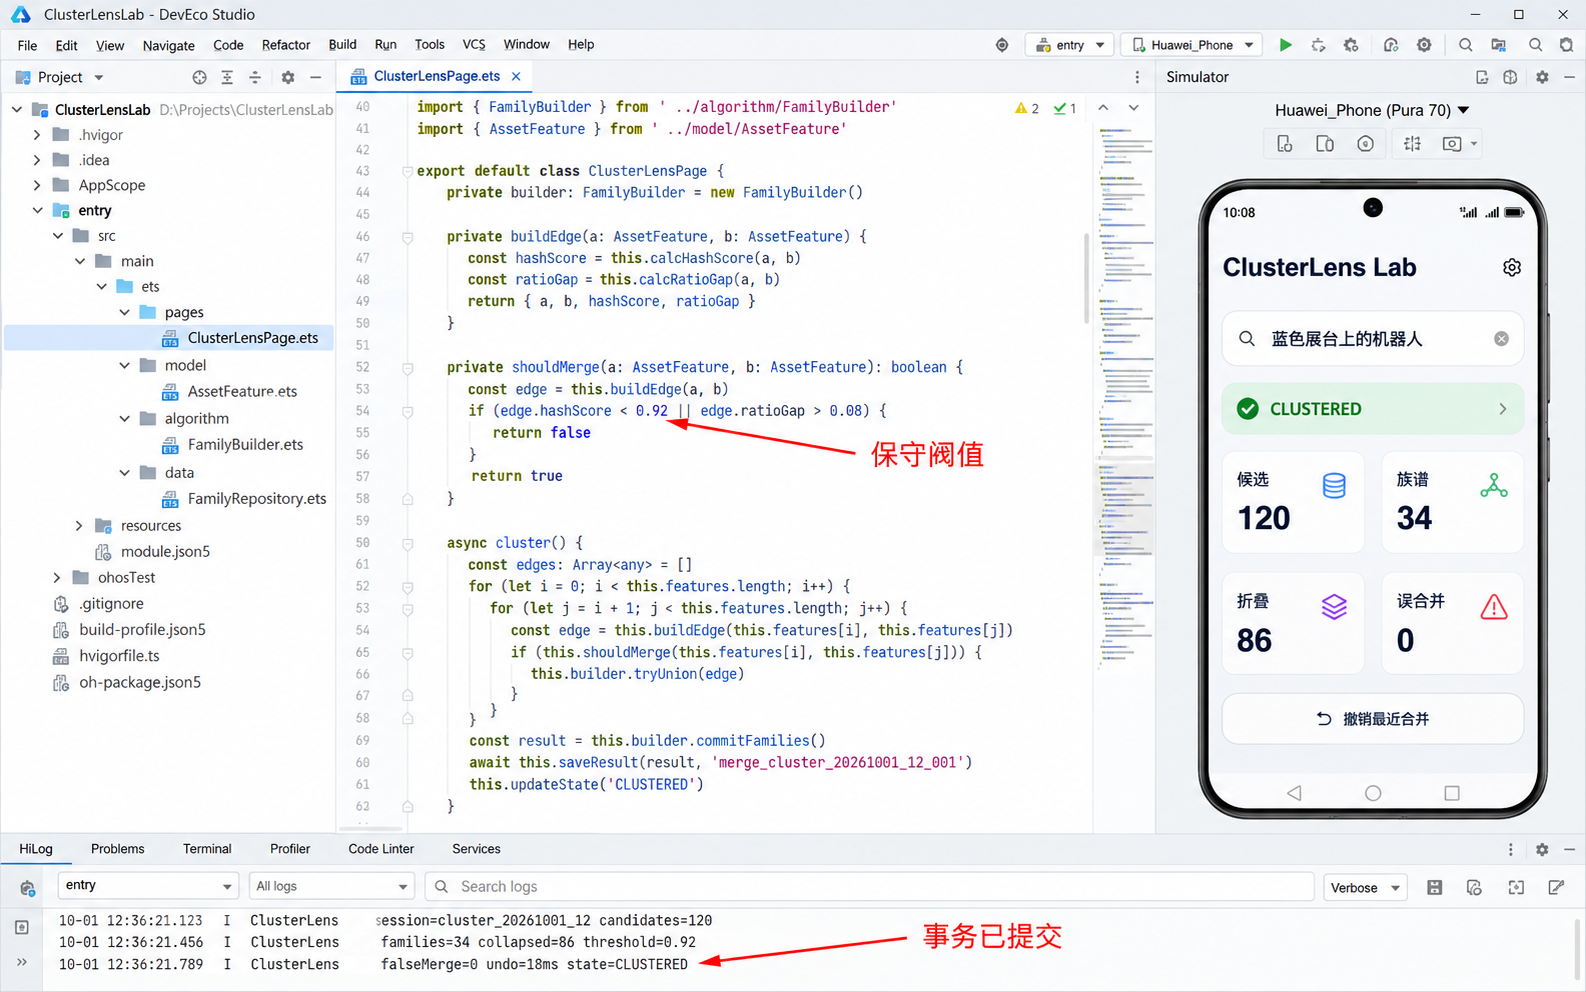
三次误合并都来自蓝色背景占比很高的展台图。它们的感知哈希分数分别达到 0.931、0.928 和 0.924,单看阈值都会通过;但宽高比差异超过 0.08,且拍摄时间相隔两天。加入否决条件后,三条候选边在生成阶段就被拒绝。
我们没有用“看起来对了”验收,而是准备 160 对人工标注样本:80 对应该合并,80 对不该合并。当前参数下,误合并为 0,漏合并 4 对;这四对都是大幅裁剪图。产品上宁可多显示几张,也不能把不同素材藏起来,所以保留这个偏保守的结果。
手机运行页显示族谱 34、折叠 86、阈值 0.92 和误合并 0;点击某个族谱能看到代表图与成员来源,点击“撤销最近合并”后,RDB 通过日志恢复,耗时 18 ms。撤销结束后又可以重新计算,而不是永久锁死。
六、性能、生命周期与产品边界
这条链路没有把所有计算塞进 UI 线程。感知哈希在素材导入时生成,搜索阶段只读取 64 位值;候选边与族谱构建放在任务线程,主线程按批次接收结果。每批最多更新 20 个族谱,避免 120 条数据同时触发界面重组。
1. 列表稳定比少几次计算更重要
第一版每发现一条合并边就刷新列表,120 条候选在两秒内重排了几十次。用户正要点击第二张图,目标突然被折叠到第一张下面,体验比重复结果更糟。现在任务线程先完成一轮族谱构建,再按稳定 familyId 提交批次;同一批次内封面和成员数一起变化,列表不会出现半合并状态。
为了保住滚动位置,UI 的 key 使用 familyId,不能使用封面素材 ID。代表图从压缩版换成原图时,列表项身份不变,只更新缩略图和分辨率。展开状态也按族谱 ID 保存,用户回到页面后仍能看到刚才打开的那一族。若使用数组下标做 key,合并后下标整体移动,ArkUI 会重建大量组件,既丢状态又增加解码开销。
我们记录了两组性能数据:逐边刷新时,结果区在 1.8 秒内触发 47 次结构更新;批次提交后只有 6 次。搜索首屏仍先展示未经折叠的高相关结果,族谱计算完成后再做一次温和收敛,不让用户为了等“完美去重”盯着空白页。
2. 族谱详情要把判断理由说清楚
算法给出 0.92 这样的数字,对普通用户没有意义。族谱详情页把理由翻译成三个可见信号:画面结构接近、尺寸比例一致、拍摄时间接近;若某条边被否决,也会显示“比例差异过大”或“拍摄时间跨日”。这不是暴露内部算法,而是让用户知道合并不是随机发生的。
代表图旁边显示原始来源、像素尺寸和文件大小,成员列表保留每张图自己的收藏、分享和删除操作。删除代表图时,族谱不会消失,而是重新选择下一张质量最高的素材;只有最后一个成员删除后才移除族谱。重新选封面属于族谱内部变化,不写入新的合并日志,也不影响撤销顺序。
用户手动拆分某个成员时,系统写入一条负向约束 never_merge(leftId,rightId)。下次相同查询或模型升级后重新计算,也要优先读取这条约束,避免刚拆开的图片又被合回去。负向约束同样有来源和时间,删除素材时需要清理悬空记录。
3. 阈值升级不能直接重写旧族谱
感知哈希算法或阈值变化后,旧族谱不能在应用启动时静默重算。用户可能已经收藏代表图、手动拆分成员,直接覆盖会破坏这些判断。我们把算法版本和阈值一起写入 family_journal,新版本先创建候选预览,只有用户确认或后台策略明确允许时才提交。
本 Demo 的算法版本为 phash-v2,阈值 0.92。若未来改为 0.94,系统会显示“预计拆分 5 个族谱、减少 13 个成员”,而不是马上变更。撤销时按操作日志恢复到旧版本关系,因此模型、阈值和人工修订都能区分。对跨设备同步,冲突解决也应以操作为单位,而不是比较最终 family_id 字符串。
RDB 结果集要在读取完成后关闭,搜索会话销毁时清理 FamilyBuilder,缩略图仍由图片缓存统一管理。撤销日志保留最近 20 次操作,超过后按提交时间清理;正式产品如果需要跨设备同步,日志还要加入设备 ID 与冲突规则,不能只复制 family_id。
最后要强调,族谱去重不是删除。它是结果页的一种折叠视图,用户仍能展开、选择原图、查看来源并撤销合并。AI Kit 提供语义相关候选,感知哈希补充视觉近似,RDB 负责让关系可恢复。三层职责分开后,搜索结果既不会被重复图淹没,也不会因为一次激进判断丢掉素材。
验收时我还保留了一条反向指标:被折叠成员仍能通过原始素材 ID 精确定位,抽查 86 条全部命中。这个指标能防止开发者只盯着“列表减少了多少”,却忘了验证用户是否还能找回每一张图。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 3
 0
- 0


 已为社区贡献110条内容

所有评论(0)