
中国电信 Xing4.0-29B-A4B 上线 AtomGit AI
近日,中电信人工智能科技有限公司开源新一代星辰大模型 Xing4.0-29B-A4B。该模型在 TeleChat 系列三代技术积累上升级,总参数 29B、激活参数 4B,原生支持256K 上下文(可扩展至 512K),基于国产算力与国产框架训练,面向复杂工程任务深度优化。
Xing4.0-29B-A4B 可在单张消费级显卡上本地运行,在编码、规划、工具调用等智能体核心能力上表现突出;从训练芯片到推理部署全栈国产,形成昇腾训练、国产框架适配、自研架构与开源生态的完整链路。
Xing4.0-29B-A4B 已全部开源,欢迎开发者在 AtomGit 获取与部署:
-
模型仓(AtomGit):https://atomgit.com/XingChen-AGI/Xing4.0-29B-A4B
-
代码仓(AtomGit):https://atomgit.com/XingChen-AGI/Xing4.0-29B-A4B-code
01|从“会回答”到“会做事”
过去大模型偏向“问答”角色,如今更强调“执行”——给定目标,自主拆解任务、调用工具、跑通链路、交付结果。Xing4.0 带来的正是这种转变:从通用大模型转向面向智能体场景的大模型。
技术路线上,模型采用mHC+MLA+MTP 架构,可高效处理长程 Agent 任务,支持多步骤规划、工具调用和复杂推理链路执行,保障长会话上下文下任务逻辑连贯、执行稳定。
02|性能表现
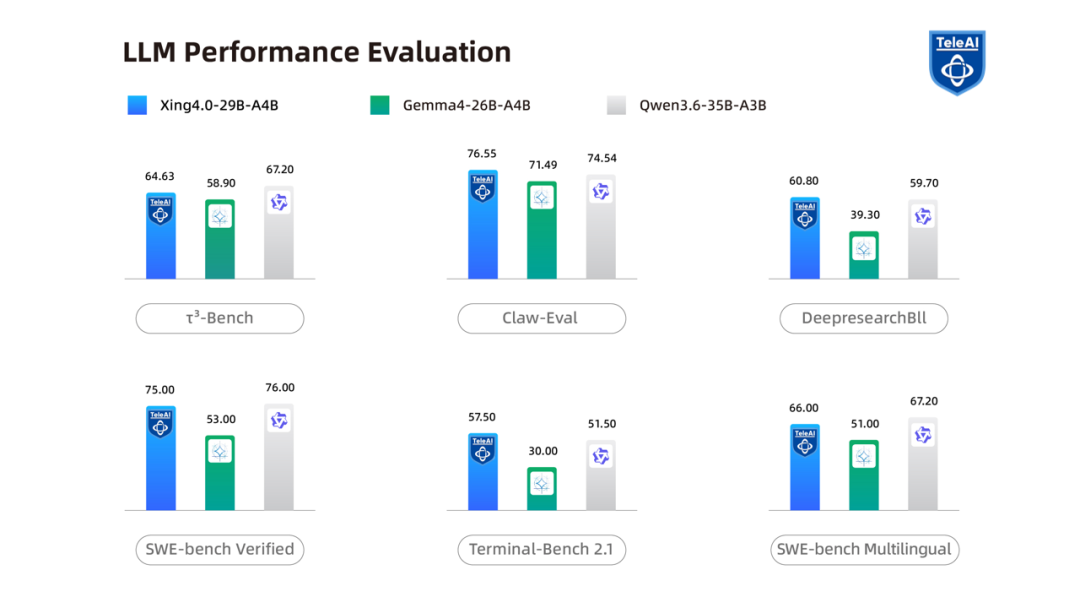
在较小参数规模下,Xing4.0-29B-A4B 在智能体场景的多项基准上表现突出:
编码 Agent:SWE-bench Verified 75.0、SWE-bench Multilingual 66.0、Terminal-Bench 2.1 57.5。其中 SWE-bench Verified 接近 Qwen3.6-35B-A3B(76.0),超过 Gemma4-26B-A4B(53.0)。
通用 Agent:Claw-Eval 76.55、DeepresearchBII 60.80、τ³-Bench 64.63,均超过同尺寸对比模型。
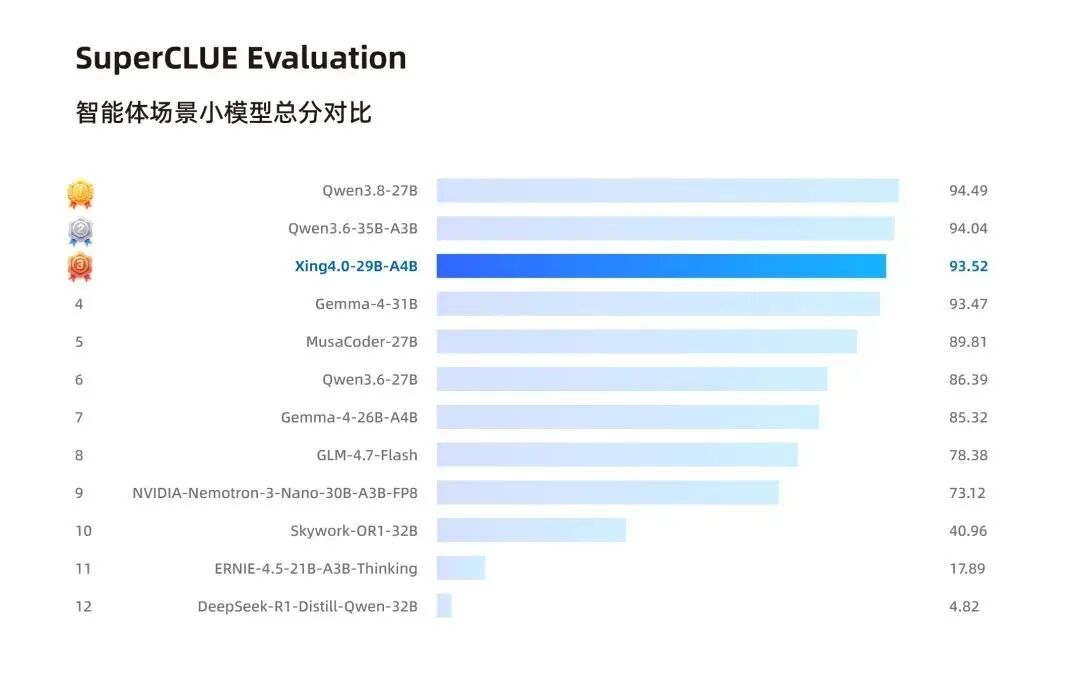
SuperCLUE 评测中,其智能体能力得分 93.52,位列第 3,与头部 Qwen 模型差距不足 1 分。综合来看,模型在任务规划、工具调用、代码处理和端到端执行等方面为智能体应用提供了较好的模型基础。
03|能力演示
两个应用场景示例:
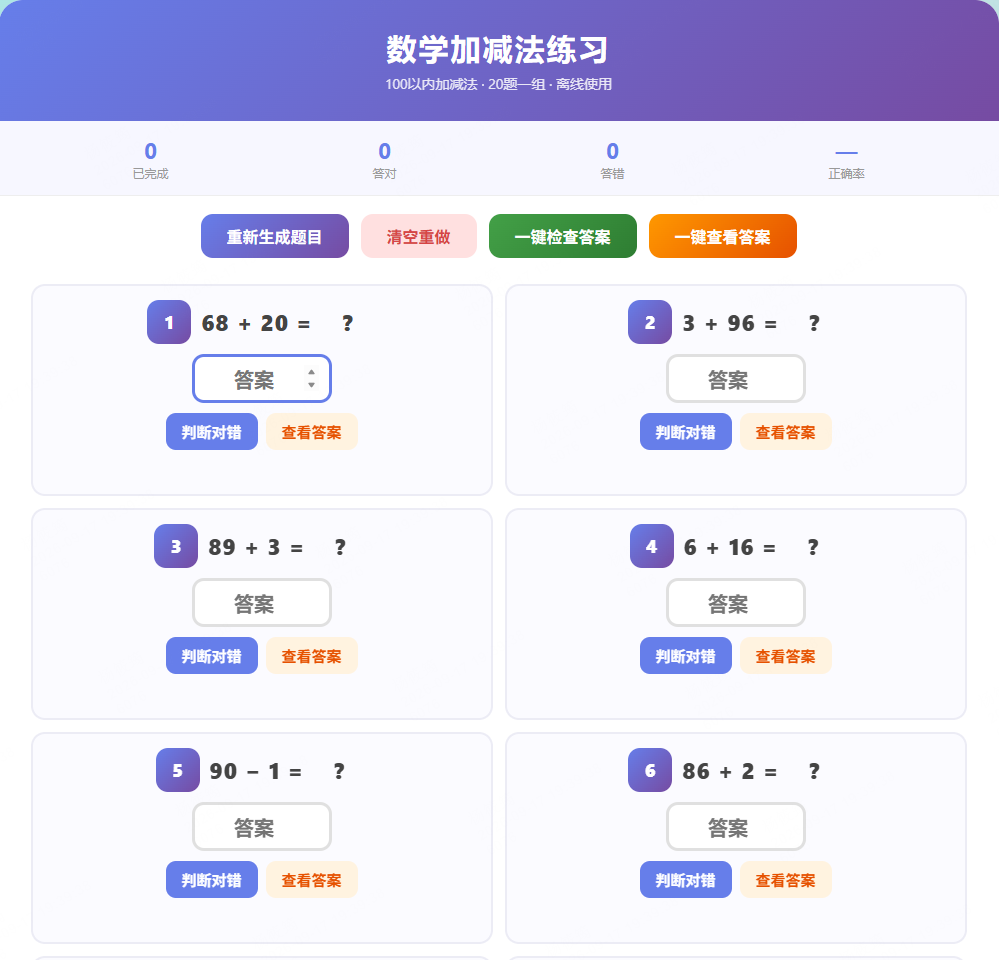
教学网页生成
给出一句需求,零代码生成可直接运行的互动教学页面。
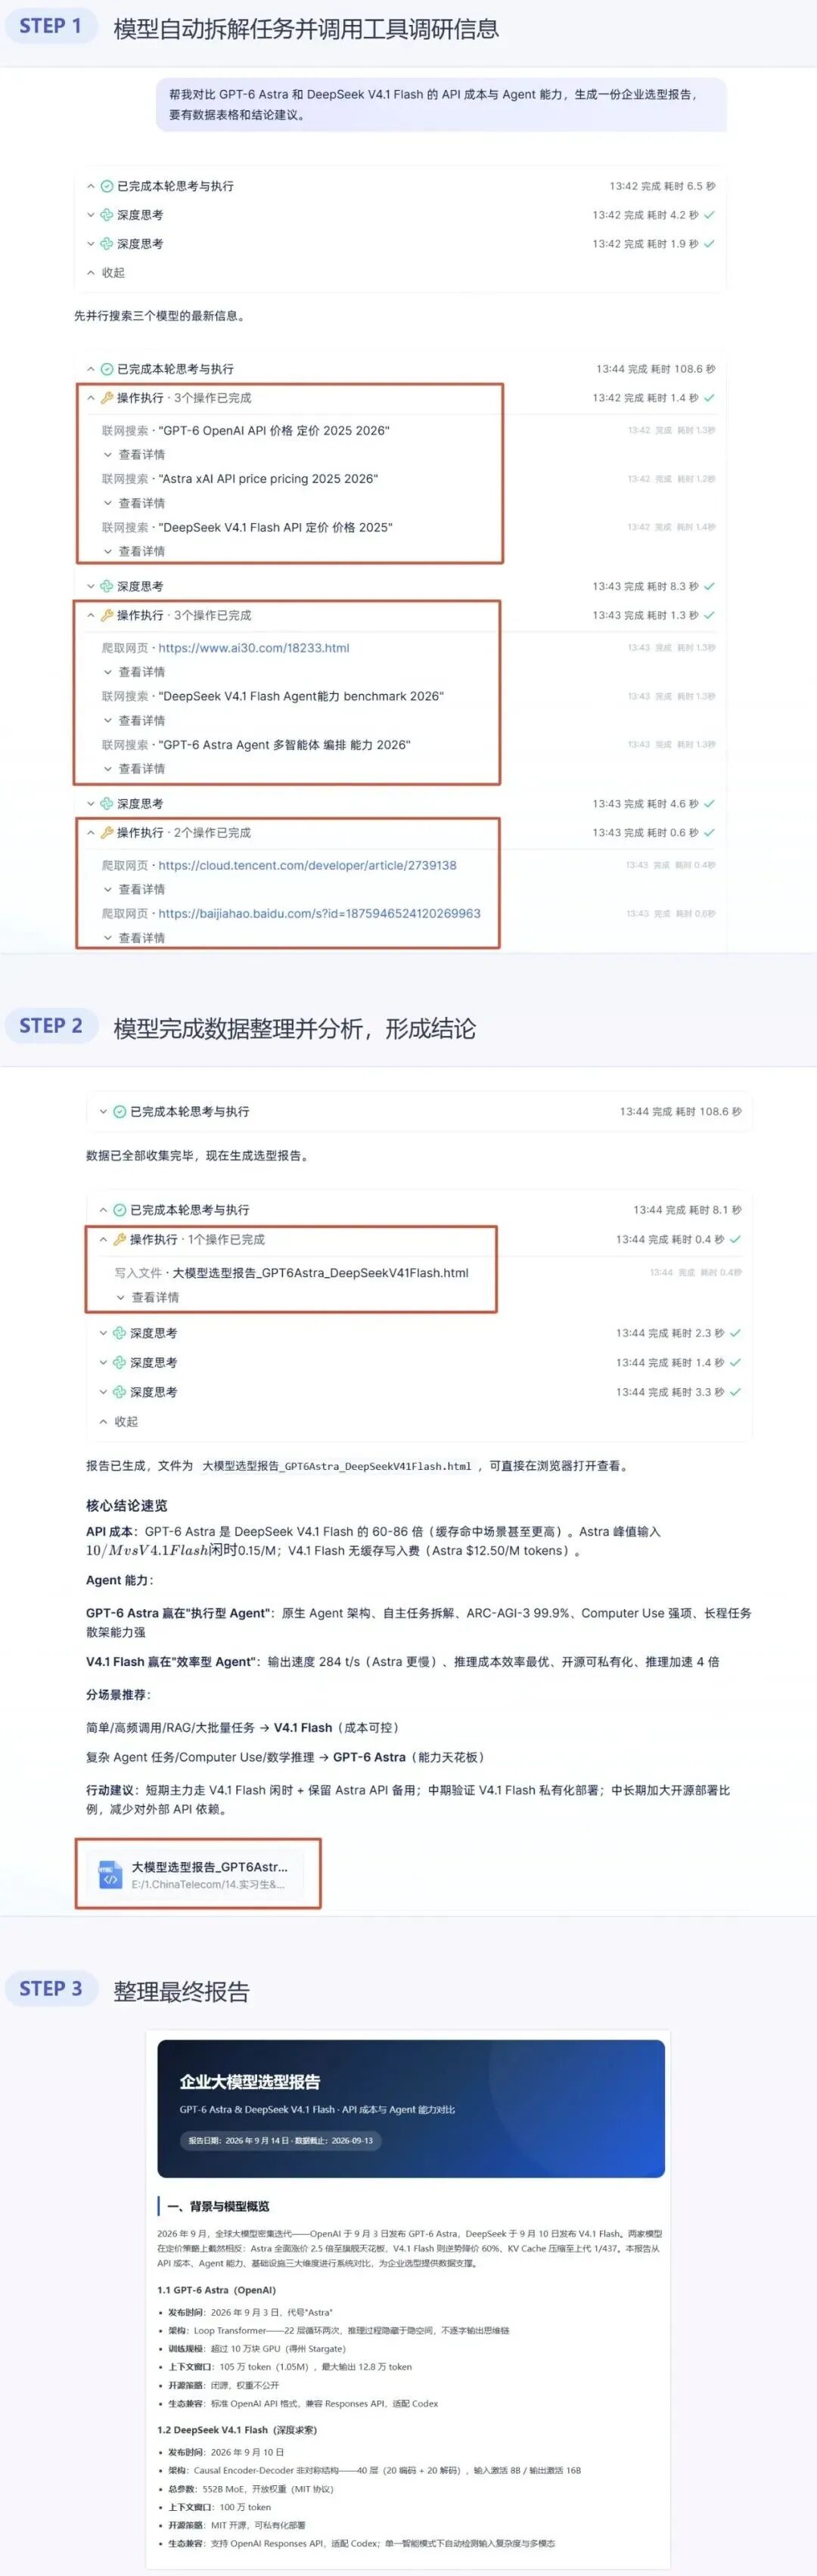
选型报告
对比两个主流大模型的 API 成本与 Agent 能力并输出带数据表格的选型报告,模型将复杂需求拆解为12 步闭环可执行链路,每步精准匹配对应工具。
03|部署与成本
算力门槛
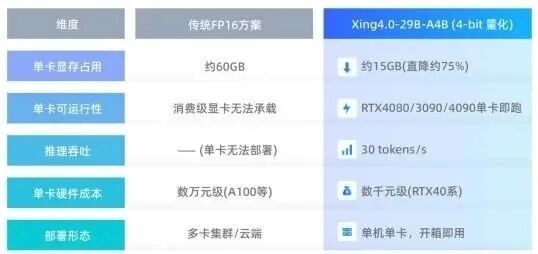
4-bit 量化后显存占用降至 15GB(较 FP16 省约 75%),RTX 3090、RTX 4090 等 24G 消费级显卡即可本地运行长上下文任务,适合个人开发者、小型工作室与中小企业,且数据全程本地、不出域。
生态兼容
支持 LLaMA-Factory、MindFormers 微调架构;适配 SGLang、vLLM、KTransformers 推理框架;对 OpenCode、Claude Code、OpenClaw、Hermes 等 Agent 框架做了定向适配。
05|国产算力与训练链路
面向长程上下文理解与复杂推理规划,Xing4.0-29B-A4B 从架构、训练 Infra、强化学习三个层面与国产芯片、国产框架深度适配:
架构
引入 MLA 压缩 KV 缓存,MTP 增强生成连贯性,mHC 改善深层网络训练稳定性,结合 Muon + QK-Clip 优化器;训练序列长度从4K 逐步扩展至 256K。
训练 Infra
基于昇腾 910C 集群协同优化,依托 MindSpore/MindFormers 完成特性适配与精度对齐,整网训练吞吐较开箱性能提升约 96%。
强化学习
依托昇腾生态完成 Slime 框架适配,面向 Agent、Coding、Reasoning 开展多专家强化学习训练,并通过MOPD 技术融合多专家能力。
基于智源 FlagOS 统一开源 AI 软件栈,模型已在昇腾、沐曦、摩尔线程、平头哥、海光等国产芯片完成跨芯适配与部署验证,提供 vLLM-plugin-FL、SGLang-plugin-FL 推理插件,支持异构算力一键部署。
据官方介绍,后续将推出更大参数规模的星辰大模型版本。AtomGit 将持续同步星辰系列模型权重,方便国内开发者获取与部署,欢迎大家持续关注。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献71条内容

所有评论(0)