
BECKETT开发手记:TFLite模型转MS模型记录
一次 TFLite → ONNX → MindSpore Lite 迁移中的张量边界
我们在开发过程中,因为需要用到端侧模型,在部署的时候就遇到这个问题。我们训出来的模型是TFlite格式,但是鸿蒙这块的Mindspore Lite Kit支持的是ms,并且不支持控制流,所以我们在模型转换的时候遇到了较大的问题。但是我们研究了很久,提出了上面的这个拆解流程与使用架构,把控制流剥离出模型。
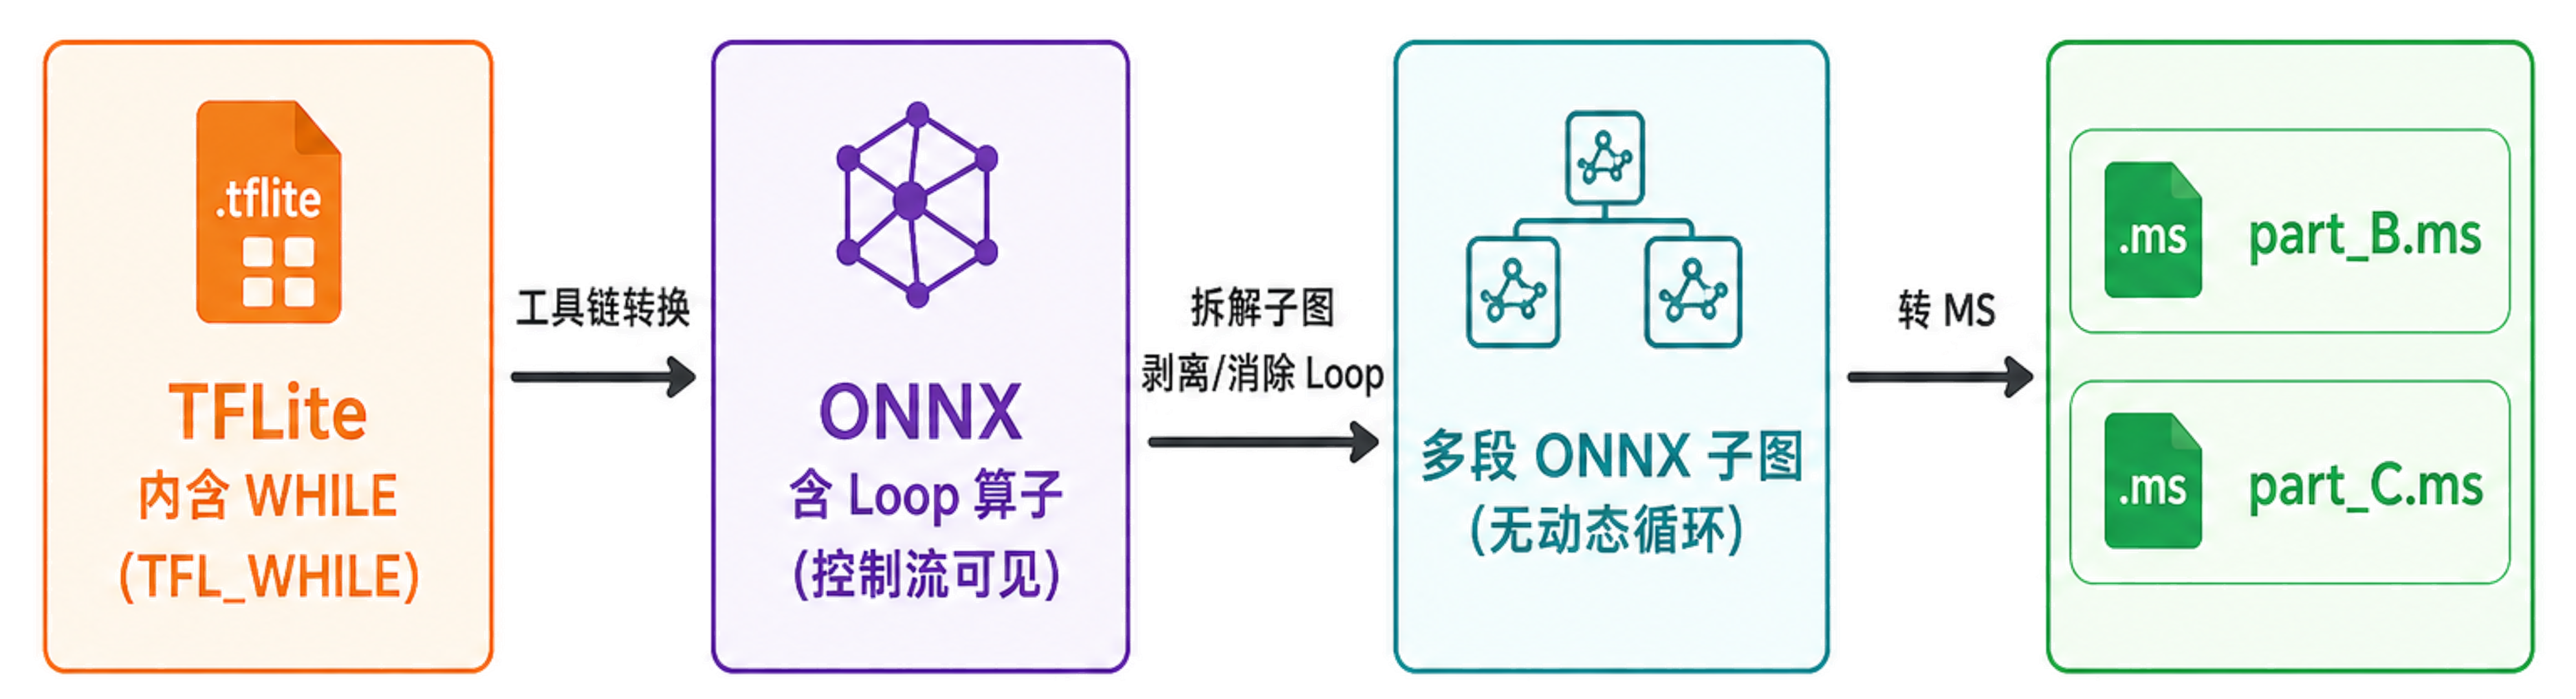
图中上面一条是我们在工程侧怎么把模型「变成能在端上跑的形态」。起点是 TFLite,里面带 WHILE、也就是 TFL_WHILE 这类控制流,如果硬怼到端推理框架里,循环往往不好原样落地。所以我们先用 工具链 把它转到 ONNX;在 ONNX 里,循环会以 Loop 算子 等形式 显式可见,方便我们做切分和验证。下一步是 拆解子图、剥离或消除 Loop,得到 多段不含动态循环的 ONNX 子图,再 分别转成 MindSpore Lite,又因为我们的控制流在模型图的中间,所以最后输出像 part_B.ms 和 part_C.ms 这样的多段模型,同时我们外置控制流代码,使用胶水代码重新粘合两个分离出来的模型,最终输出结果等价于tflite原模型
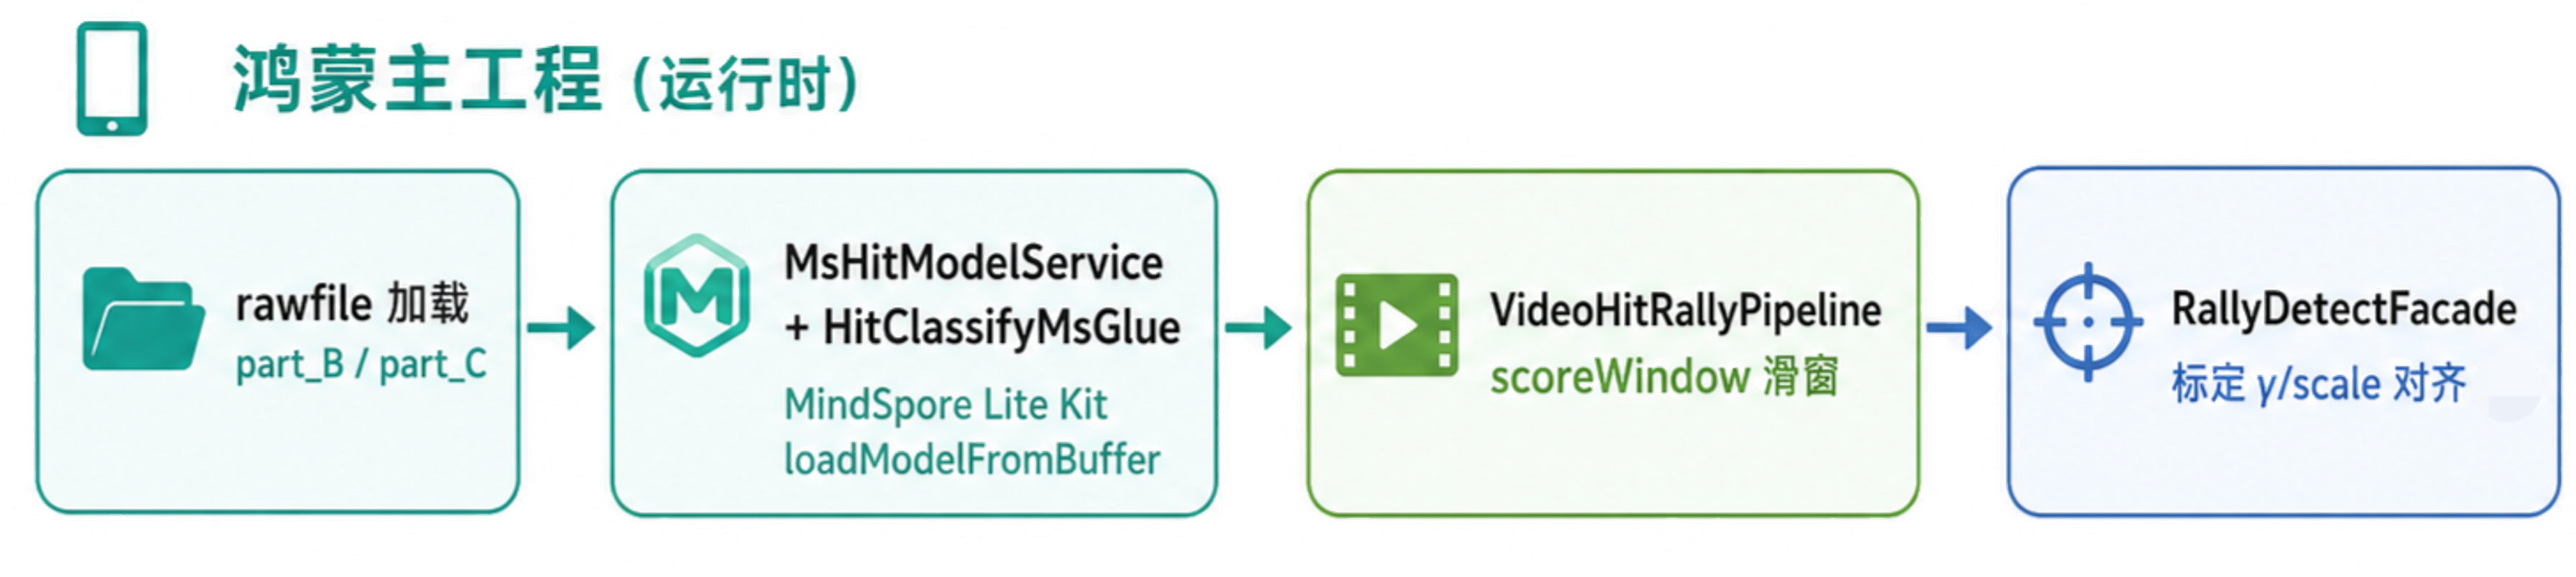
这一条是我们拆解后的模型在鸿蒙项目的部署:把 **part_B、part_C 放进 rawfile,运行时通过 MsHitModelService 包一层,用 MindSpore Lite Kit 的 loadModelFromBuffer 把模型加载进内存。业务侧是 VideoHitRallyPipeline,对音频做 scoreWindow 滑窗,每一窗送进模型得到原始输出,最后在 RallyDetectFacade 里做 概率后处理和标定,和 TFLite 语义对齐。这样 上图解决「图怎么切、循环去哪」,下图解决「包内怎么载、Pipeline 怎么接、结果怎么对齐」,最终就把 转换 和 落地 串起来了,也成功实现了不支持的控制流模型的转换部署使用。
做端侧模型迁移时,拿到目标格式文件只算走完一段路。模型能够加载,输入也没有报错,仍然可能把错误的数据送进推理。这个音频分类 Demo 让我把注意力从转换命令移到了模型之间、缓冲区之间的交接处。
先用同一份输入证明数值一致,再讨论业务效果。
先画清楚模型之间传的是什么
案例按固定长度窗口处理音频。每个窗口包含 15360 个 float32 采样点,先进入 B 段得到 1024 维特征,再交给 C 段输出一个分类概率。迁移过程涉及 TFLite、ONNX 和 MindSpore Lite;端侧 Demo 使用的是拆分后的两段模型。
拆图的好处是多了一个能观察的中间结果,代价则是原本由计算图维护的连接,变成了应用负责的接口。数据类型、batch 维度和元素数量,任何一项理解错了,都可能把问题带到后一段。
因此,我先记录接口约定,再组织模型加载和调用。转换工具支持某种格式,不代表任意图结构和算子都能原样落地;具体支持范围仍要结合转换器版本与目标模型核对。[1]
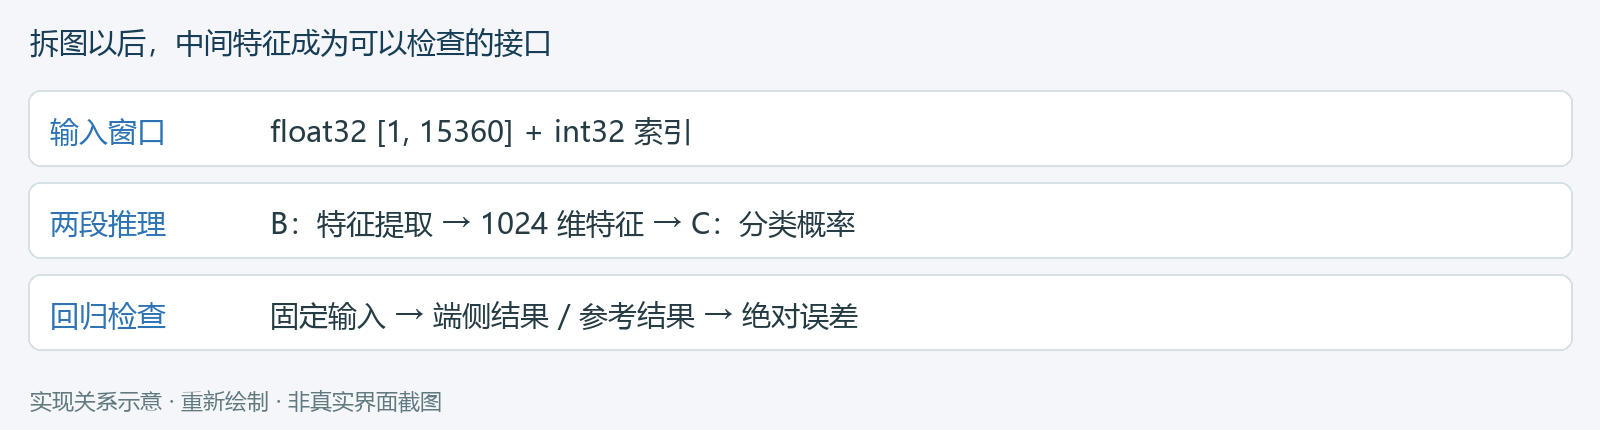
图 1 两段式模型的输入输出约定。尺寸来自案例,模型名称已泛化。
比 shape 更隐蔽的是 ArrayBuffer 视图
批量输入常常先读成一个大的 Float32Array,再用 subarray 切出窗口。这里最容易产生的误解是:窗口已经切好了,view.buffer 自然就是这个窗口。实际上 subarray 创建的是视图,底层缓冲区仍可能包含整批输入。
下面用一个不依赖模型的合成例子说明。完整数组有 12 个数,window 只取其中 4 个;window.length 是 4,但 window.buffer.byteLength 仍然是 48。把它直接交给只接受 ArrayBuffer 的接口,传入范围就与窗口语义不一致了。
const all = new Float32Array(12);
const window = all.subarray(4, 8);
console.log(window.length); // 4
console.log(window.buffer.byteLength); // 48
const begin = window.byteOffset;
const end = begin + window.byteLength;
const exact = window.buffer.slice(begin, end);
console.log(exact.byteLength); // 16
代码 1 可独立运行的 JavaScript 示例。数值为合成数据,不含模型或录音。
张量边界不仅包括 shape 和 dtype,还包括 byteOffset 与 byteLength。
把输入校验放在同一个地方
Demo 将加载、缓存输入张量、分段预测和结果汇总放在统一的推理封装里。页面负责提供窗口和展示结果,不在多个按钮回调中分别组装张量。这样修改模型版本时,接口约定也只需要在一个位置核对。
一次推理依次完成:检查窗口长度,写入音频与 int32 索引,执行 B 段,检查特征,再执行 C 段。两个模型都加载成功之后,封装才进入可用状态。加载失败、输入不合规和预测失败分别报告,定位会直接得多。
|
交接位置 |
本案例检查什么 |
|
音频 → B 段 |
float32;shape 为 [1, 15360];字节范围准确 |
|
辅助输入 → B 段 |
int32;固定索引值为 0 |
|
B 段 → C 段 |
1024 维 float32 特征;按 [1, 1024] 提供 |
|
C 段 → 页面 |
每个窗口对应一个概率,数量和顺序一致 |
用固定输入找差异,而不是先调分类阈值
已有 Demo 保存了五个窗口的二进制输入,以及对应的 ONNX 拆图参考输出。端侧读取同一份输入后,逐窗口比较概率,计算最大绝对误差和平均绝对误差。这比“看起来能识别几次”更适合判断迁移是否一致。
最大误差能暴露最差样本,平均误差帮助观察整体偏离。Demo 将 maxAbs < 1e-4 作为这组固定样本的判据;它属于这个案例的数值检查,不能直接解释为分类准确率,也不适合不加分析地套到其他模型。
若差异超标,我会依次检查输入读取、张量类型与形状、B 段特征、C 段输出。直接调整最终业务阈值,可能暂时让结果看起来顺眼,却把上游数据错误藏了起来。
// 数值检查定义:两组输出必须对应同一批输入。
maxAbs = max(abs(actual[i] - expected[i]));
meanAbs = sum(abs(actual[i] - expected[i])) / N;
// 判据由目标模型和参考样本确定。
代码 2 误差计算的数学伪代码,非新的测试结果。
迁移完成后,还要回答另一个问题
数值对齐回答的是“端侧与参考实现是否一致”。真实环境中的噪声、录音链路和事件去重,则影响“分类是否对业务有用”。这两件事需要分别验收,不能用五个固定窗口代替真实场景评估。
现有材料能够支撑两段推理和数值回归方法,但尚未形成包含转换、拆图、参考输出生成在内的一键工具链。文章不提供来源尚未明确可公开的模型权重或真实音频;示例代码仅用合成数组解释数据边界。本次也没有重新执行端侧模型测试。
我希望下一位接手迁移的开发者拿到的不只是模型文件,还能拿到输入输出约定、转换参数和参考结果。只有差异能够被逐步定位,迁移结果才容易维护。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)