
HarmonyOS 7 SpatialRecon:端侧重建阶段门控与断点续跑【鸿蒙心迹】
这篇文章想复盘一个很典型、也很容易被低估的问题:端侧重建任务不是“点一下开始,然后等它跑完”这么简单。
我这次做的是一个名为 ReconPocket 的 HarmonyOS 7 Demo。页面看起来并不复杂:采集、预检、重建、生成预览、导出结果。但真到工程里,问题会一个接一个冒出来:
- 采集阶段提交了多少批数据,页面和底层任务是不是同一个认知;
- 快照到底只是一个“预览点”,还是一个能恢复任务的有效检查点;
- 用户从后台回来时,恢复的是旧状态、旧进度,还是当前真实状态;
- 日志里已经开始
RECONSTRUCTING,界面却还停在PRECHECK,这种错位怎么避免。
这篇不想写成“Spatial Recon 接口怎么用”的说明书,而是想把一个更贴近实战的工程主线讲清楚:怎样把一个可演示的重建 Demo,收敛成一个可恢复、可校准、可解释的任务系统。
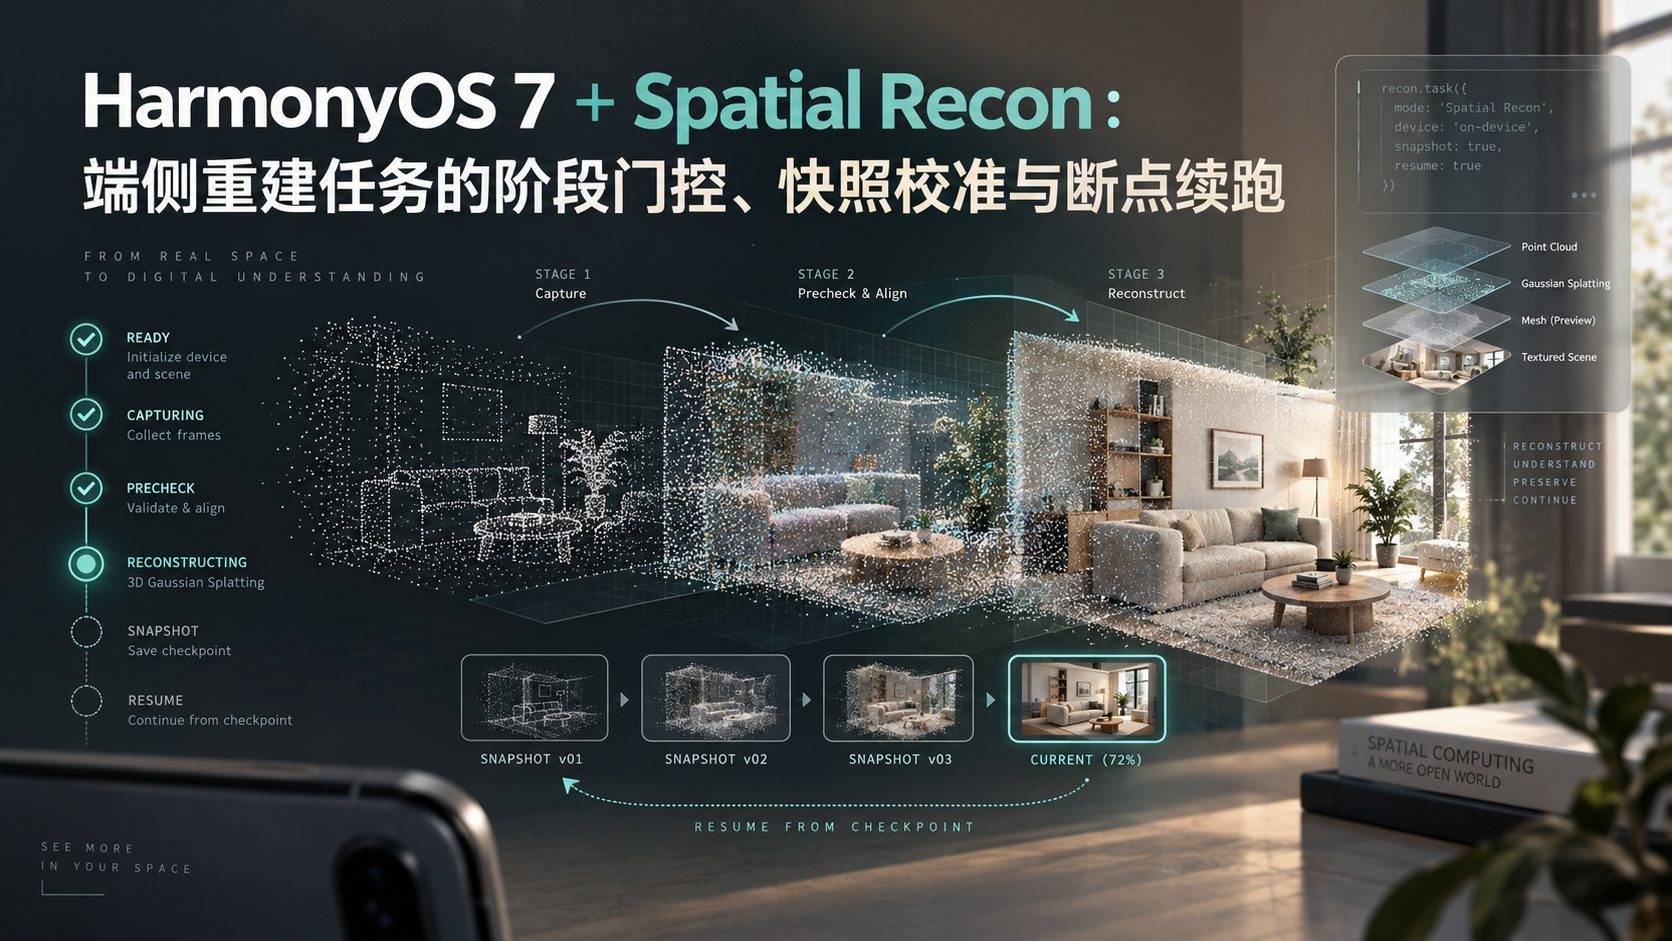
一、先别着急调重建接口,先把任务阶段定义清楚
我最开始也走过弯路。那时把采集、上传、重建、预览全都塞进一个 startTask() 里,流程能跑,但一旦遇到暂停、继续、后台切回前台、快照恢复,整条链路就变得很难控。原因很直接:代码在执行流程,页面在显示流程,但没有一个真正的任务状态机。
所以我先做的不是优化算法,而是把任务拆成可见的阶段:
READY:任务刚创建,设备与场景上下文已初始化;CAPTURING:持续接收采集帧;PRECHECK:对提交批次做基本校验与对齐;RECONSTRUCTING:进入重建主过程;PREVIEW_READY:预览网格已经可用;COMPLETED:当前重建批次完成;FAILED:失败并携带恢复策略。
下面这段代码解决的,就是“页面状态、服务状态、恢复状态要不要共享一个状态定义”的问题:
export enum TaskState {
  READY = 'READY',
  CAPTURING = 'CAPTURING',
  PRECHECK = 'PRECHECK',
  RECONSTRUCTING = 'RECONSTRUCTING',
  PREVIEW_READY = 'PREVIEW_READY',
  COMPLETED = 'COMPLETED',
  FAILED = 'FAILED'
}

private updateState(next: TaskState, reason: string) {
  if (this.taskState === next) {
    return
  }
  this.taskState = next
  hilog.info(0x0000, 'ReconPocket', `state -> ${next}, reason=${reason}`)
  this.taskStore.update(this.taskId, {
    status: next,
    updatedAt: Date.now(),
    reason
  })
}
为什么这段代码看起来普通,却值得先写?因为端侧重建的很多毛刺,并不是算法算错了,而是业务层对“当前处于哪个阶段”说不清。只有把状态变成一等公民,后面的提交门控、快照校准、断点续跑才有落脚点。
另外一个经验是:不要把状态切换写得过于“乐观”。比如调用重建接口前,不要直接把页面改成 RECONSTRUCTING,而应该在 PRECHECK 成功、任务句柄可用、检查点一致之后再切换。这样做的好处,是出问题时你能通过日志迅速定位到底卡在“请求发出前”,还是“重建开始后”。
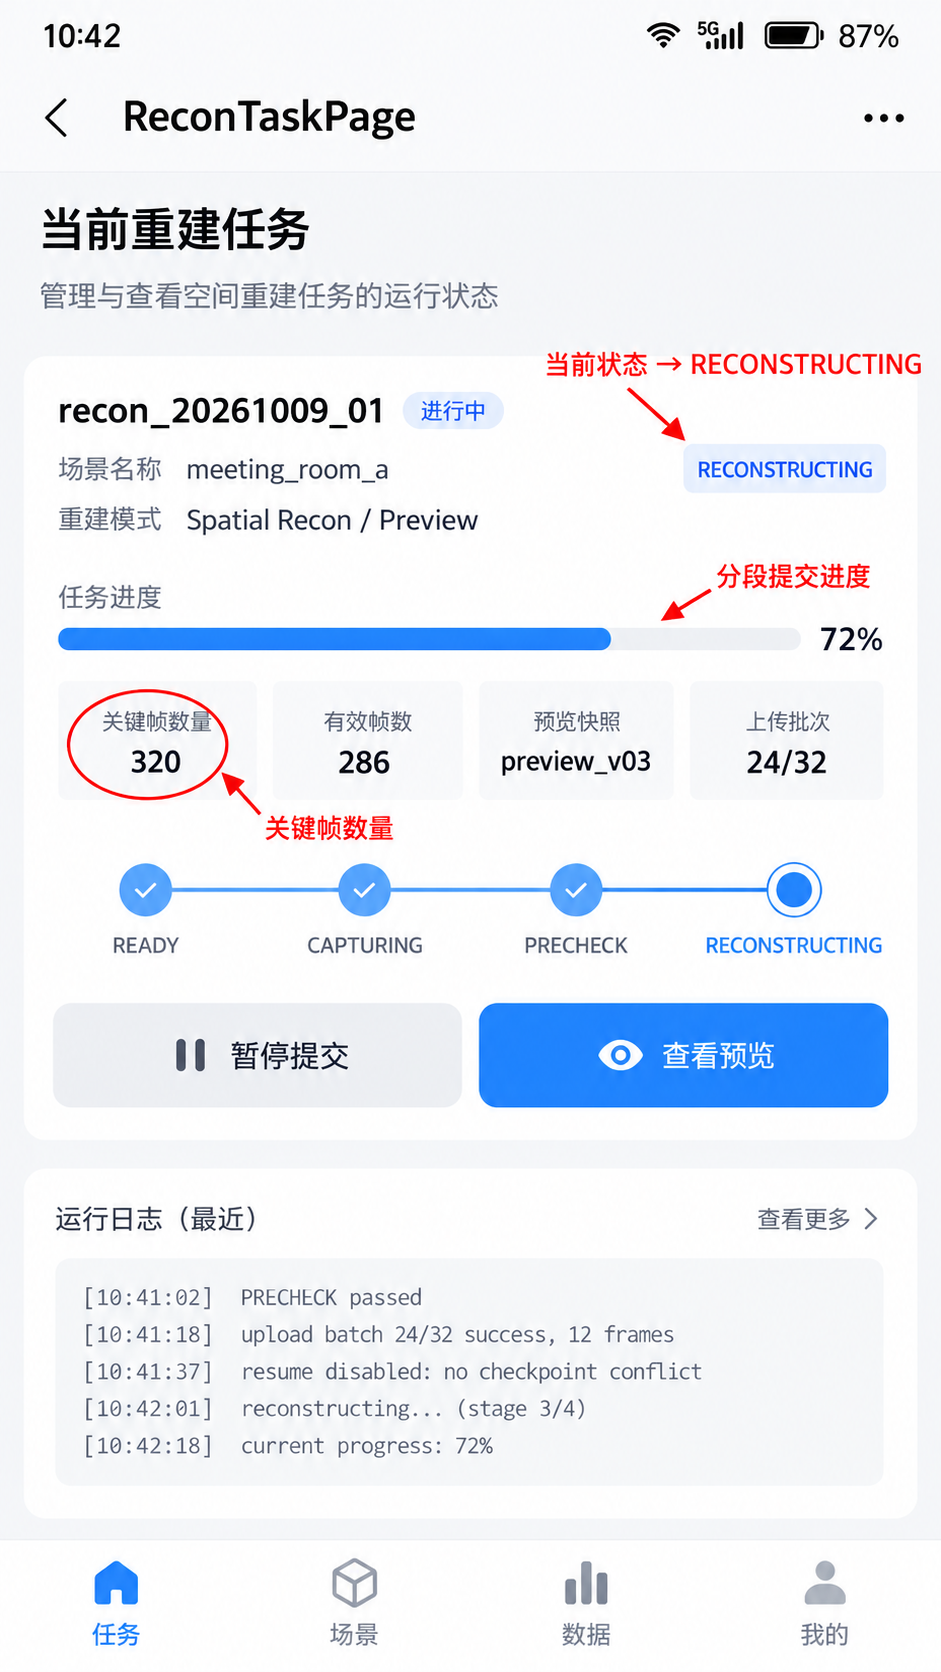
上图就是当前任务页。可以看到 taskId 是 recon_20261009_01,场景名是 meeting_room_a,当前阶段是 RECONSTRUCTING,进度 72%,关键帧 320,有效帧 286,预览快照 preview_v03,上传批次 24/32。这些字段不是为了好看,而是为了让工程人员在页面就能判断“现在跑到哪儿了”。
二、分段提交不是性能优化,它首先是稳定性设计
端侧重建最容易犯的一个错误,是把采集数据一股脑攒完再上传、再处理。这样在理想场景下很省事,但只要中途发生切后台、断网、页面销毁,整条链就会很脆。后来我改成了分段提交:采集到一批,就提交一批,同时刷新进度,并把批次结果和当前状态写进任务存储。
下面这段代码解决的是“上传批次如何进入可观察的任务进度”这个问题:
async commitCaptureBatch(batchIndex: number) {
  hilog.info(0x0000, 'ReconPocket', `commitCaptureBatch: ${batchIndex}`)
  try {
    const res = await this.uploadService.uploadBatch(this.taskId, batchIndex)
    this.lastUploadedBatch = batchIndex
    this.validFrames = res.validFrames
    this.refreshProgress(res.progress)
    hilog.info(
      0x0000,
      'ReconPocket',
      `upload batch ${batchIndex}/32 success, ${res.frames} frames`
    )
  } catch (err) {
    hilog.error(0x0000, 'ReconPocket', `upload batch failed: ${err}`)
    this.markBatchRetry(batchIndex)
  }
}
这里最关键的不是 uploadBatch(),而是成功与失败都要留下可恢复信息。成功时记录最后批次、有效帧数和进度;失败时不要只弹 toast,而要把这个批次标记为待重试。因为一旦用户切回页面,你需要知道自己是“从第 24 批继续”,还是“第 24 批其实没提交完”。
实际项目里,我会特别注意两个边界:
- 迟到批次:比如页面已经推进到新的阶段,旧的异步结果才返回,这时如果直接刷新页面,很容易造成进度回退;
- 无效帧突增:某一段采集质量不好时,有效帧数可能低于预期,此时页面应该显示真实值,而不是为了“好看”继续沿用上一个统计值。
验收这部分时,不要只盯着进度条,要同时看日志里是否出现了 upload batch 24/32 success、页面是否同步显示 24/32,以及关键帧与有效帧数字是否跟本轮结果一致。
三、快照不是缩略图,它是恢复协议的一部分
很多 Demo 会把快照理解成“方便给用户看一眼当前效果的图片”。这当然没错,但放到工程里还不够。对重建任务来说,快照既是预览依据,也是恢复依据。也就是说,当我看到 preview_v03 时,我希望它不仅告诉我“当前有个预览”,还意味着:如果任务中断,我可以从这份快照继续增量重建,而不是重新开始。
下面这段代码解决的,是“如何把快照从 UI 元素升级成任务协议的一部分”:
async flushPreviewSnapshot(snapshotId: string) {
  hilog.info(0x0000, 'ReconPocket', `flushPreviewSnapshot: ${snapshotId}`)
  try {
    await this.reconService.applySnapshot(this.taskId, snapshotId)
    this.snapshotId = snapshotId
    this.taskStore.update(this.taskId, {
      snapshotId,
      checkpoint: this.lastUploadedBatch,
      snapshotAligned: true
    })
    hilog.info(0x0000, 'ReconPocket', `snapshot ${snapshotId} applied`)
  } catch (err) {
    this.taskStore.update(this.taskId, { snapshotAligned: false })
    hilog.error(0x0000, 'ReconPocket', `snapshot apply failed: ${err}`)
  }
}
这里我会特别强调 snapshotAligned 这个标记。因为重建系统里最麻烦的不是“有没有快照”,而是页面上的快照、任务记录里的快照、底层实际恢复所依赖的快照,是否是同一个。如果这三者不一致,你就会看到很奇怪的现象:页面显示 preview_v03,但恢复后出来的是 preview_v02 的结果。
所以我在任务表里明确落了三类信息:
snapshotId:当前对外展示的快照;checkpoint:快照对应到哪一个上传批次;snapshotAligned:这份快照是否已经完成对齐并可用于恢复。
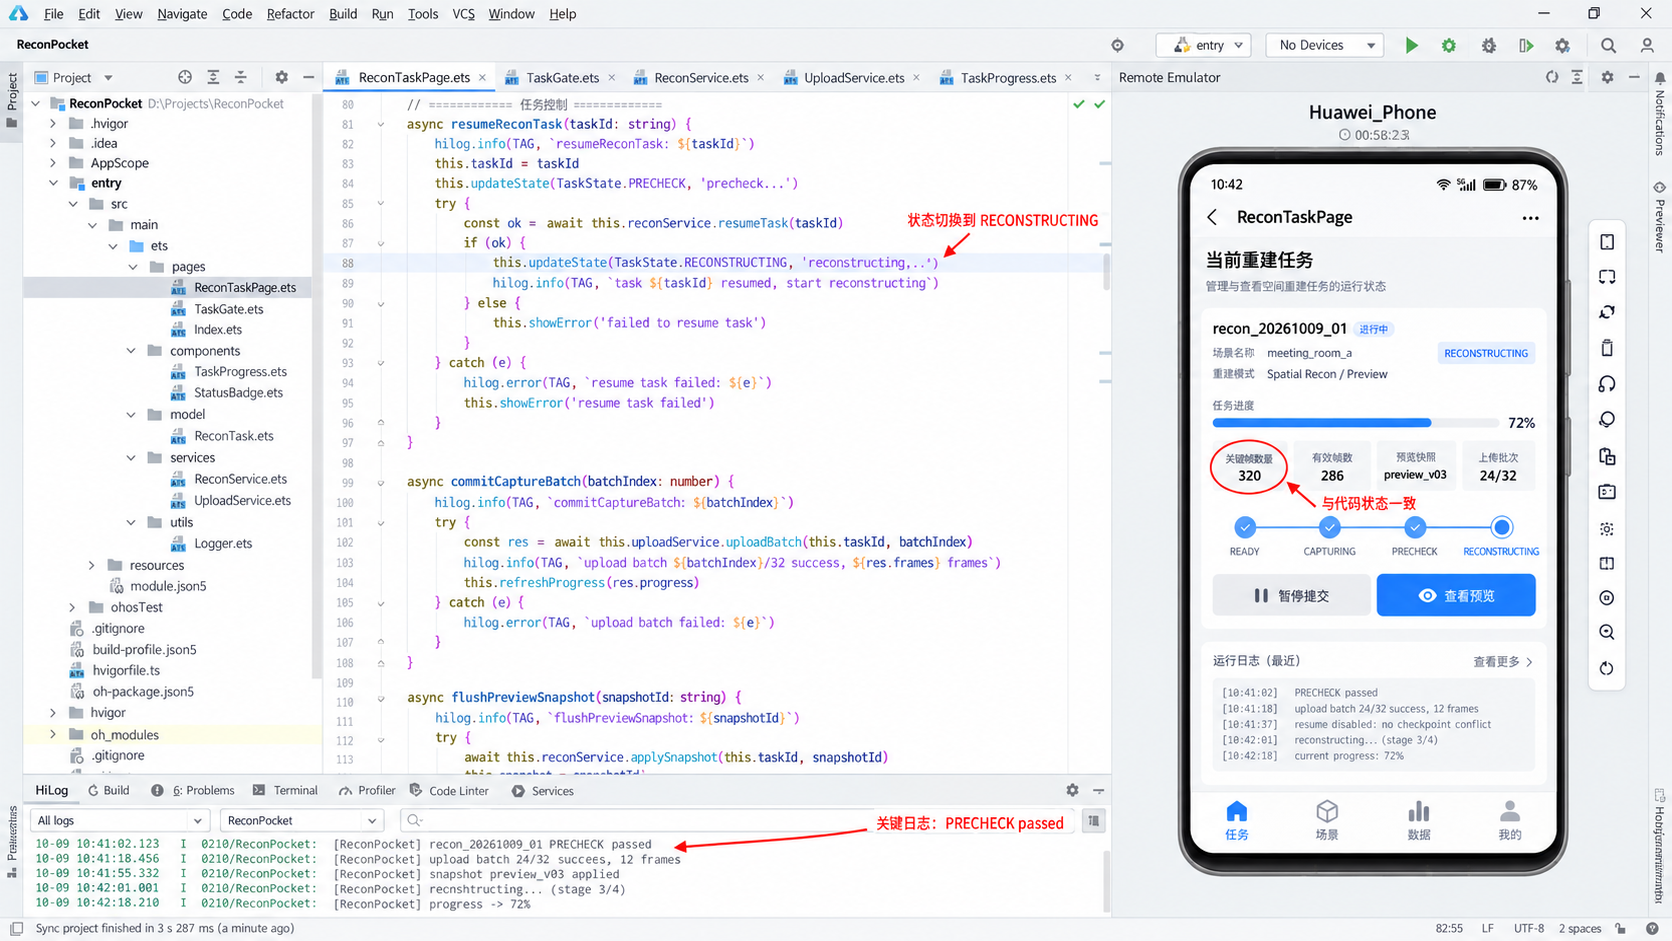
从这张 DevEco Studio 调试图里,可以看到三个信息是连起来的:
- 中间代码里
resumeReconTask()在通过预检后才切到RECONSTRUCTING; - 模拟器右侧的任务页面显示当前进度 72%,关键帧 320;
- 底部 HiLog 里同时出现了
PRECHECK passed、upload batch 24/32 success、snapshot preview_v03 applied和progress -> 72%。
这才是真正能支撑排障的“证据链”。
四、断点续跑的关键,不是恢复动作本身,而是恢复窗口
很多人一提断点续跑,第一反应是“把上次的任务 ID 和快照拿回来,再调一次恢复接口”。这只能算第一步。真正会让线上任务变得不稳定的,是恢复窗口控制不好。
比如页面从后台回来时,可能同时发生下面几件事:
- 旧请求的回调晚到;
- 新一轮预检开始;
- 恢复请求触发;
- UI 侧主动刷新任务详情。
如果没有门控,最典型的问题就是“旧结果覆盖新状态”。我在工程里做的处理是:恢复前先锁定当前 taskId 与 checkpoint,旧代次回调只要发现不一致就直接丢弃,不再回写 UI。
这类逻辑并不需要写得很“炫”,但一定要明确:页面状态只是订阅者,任务记录才是恢复判断的基准。 所以恢复时我一般会先走一遍:
- 检查本地任务是否存在;
- 检查
checkpoint是否仍然有效; - 检查
snapshotAligned是否为true; - 通过后再发起恢复请求;
- 恢复成功后刷新页面,而不是反过来。
这样做的好处,是即使发生异常,问题也会落在明确的位置:到底是快照不可用、检查点失效、还是页面只是没来得及刷新。
五、验收不要只看 100%,要看“系统实际结果”
我现在看端侧重建任务是否交付,不会只看最后是不是出现了一个 100% 的进度条。因为这只能说明“流程结束了”,不代表“结果可用”。真正值得看的,是以下三件事:
- 当前预览网格能不能被加载;
- 快照与预览是否来自同一轮任务;
- 任务是否还能从这个结果继续恢复。
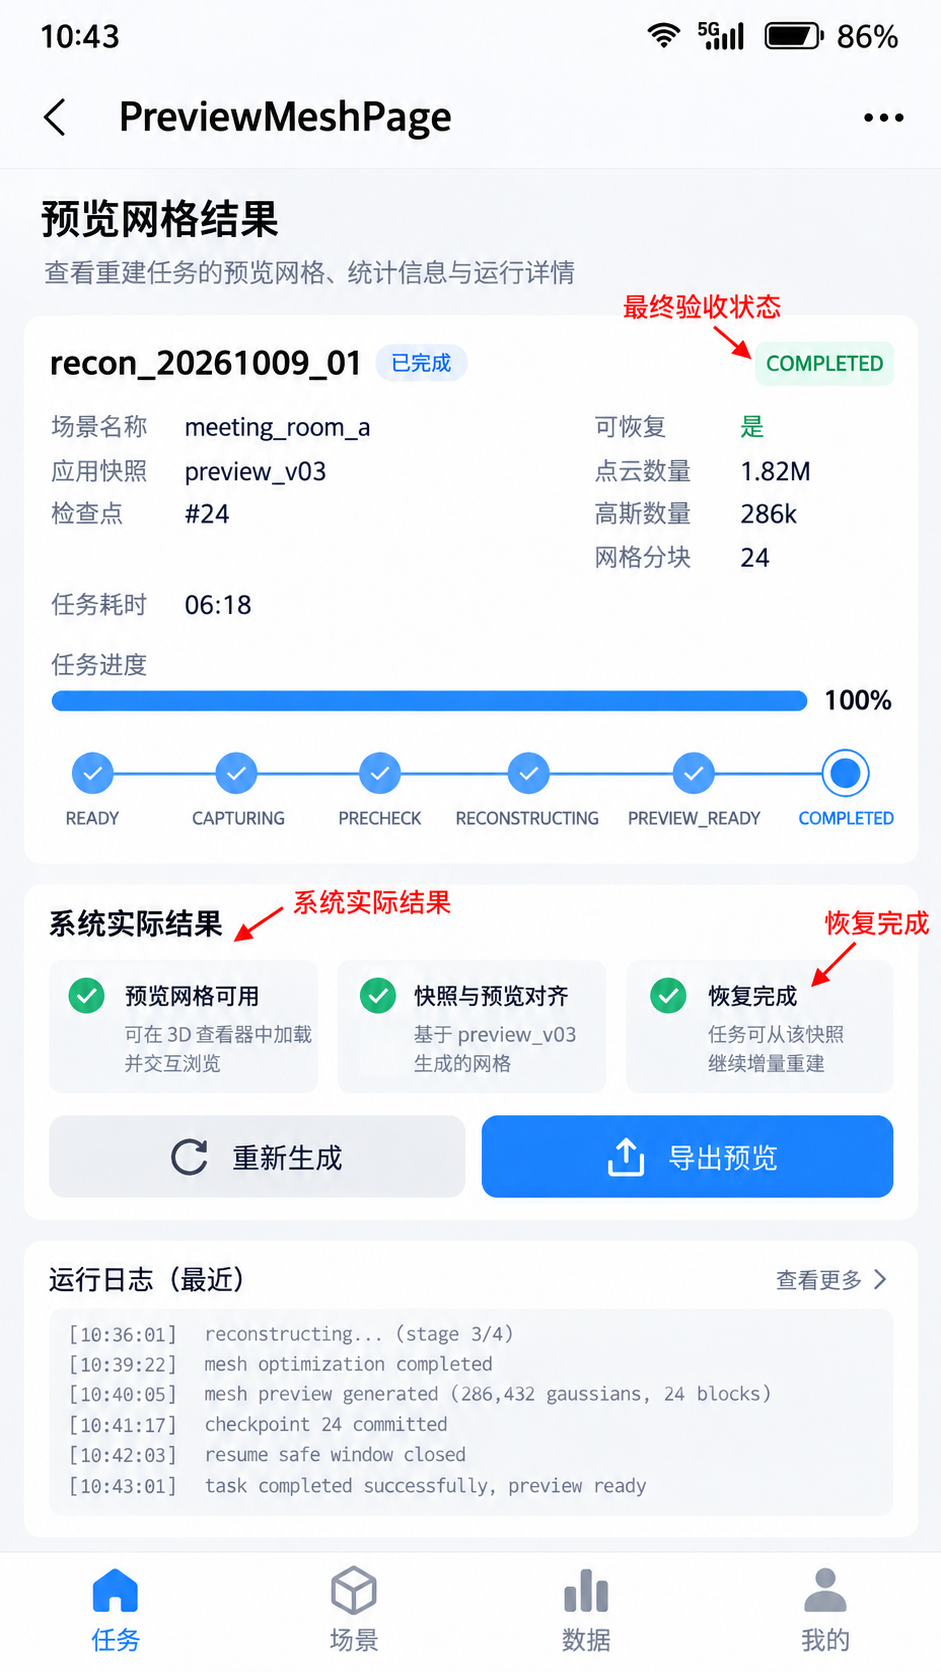
在结果页里,我把这些信息拆成了更直接的工程字段:
COMPLETED:当前任务已经结束;preview_v03:本次完成结果对应的快照;checkpoint #24:结果与第 24 批提交对齐;Point cloud 1.82M、Gaussians 286k、Mesh blocks 24:用于判断这份结果是否达到预期密度;Recoverable = 是:说明后续还能在此基础上继续增量重建。
再往下看运行日志:mesh preview generated、checkpoint 24 committed、resume safe window closed、task completed successfully。这些日志和页面字段一起,才构成完整的验收闭环。
六、这套做法真正解决了什么问题
回头看这次改造,我觉得最重要的收获不是“把 Demo 做复杂了”,而是把重建任务真正变成了一个可观察、可恢复、可解释的工程对象。
具体来说,它解决了三类常见问题:
1. 页面与任务状态经常错位
通过统一的 TaskState 和明确的阶段门控,UI 不再靠“猜”当前阶段,而是订阅同一套状态源。
2. 快照存在,但不能安全恢复
通过 snapshotId + checkpoint + snapshotAligned 的组合,快照不再只是展示信息,而变成恢复协议的一部分。
3. 断点续跑后结果不稳定
通过控制恢复窗口、丢弃旧代次迟到回调,以及在日志中保留关键证据链,恢复过程终于变得可追踪。
如果你也在做 HarmonyOS 7 上的空间重建、3DGS 预览或者类似的长任务系统,我会建议你先别急着追求“流程打通”。先问自己:一旦任务暂停、异常、恢复,我有没有足够的状态和证据把它接回来?
这往往比多跑快 5% 更重要。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献180条内容

所有评论(0)