
超节点三条路线:昇腾960与真武V900把算力推到机柜
这一轮超节点发布,值得看的不是单卡跑分,而是计算域的定义被改了。以前一台服务器是一台机器,现在一个机柜甚至跨机柜的一群卡被组织成一台逻辑机器。把公开数据摊开算一遍,你会发现瓶颈早就不是算力峰值。
一、超节点要解的,是数据跑得比算力慢
大模型推理现在有三个吃通信的特征:
- MoE 结构要求把不同 token 不断分派给不同专家,卡之间的通信频次成倍增长;
- 长上下文产生大量 KV Cache,持续占用显存与内存带宽;
- Agent 执行一个任务可能经历数百轮推理、工具调用、反馈与重规划,每轮都要等上一轮。
这三件事叠加起来,结果就是芯片算力再高也要排队等数据。超节点做的事情很直接:把原本分散在不同服务器里的芯片、显存和内存,通过更高带宽、更低时延的 Scale-up 网络组织进同一个计算域,让上层模型看到的是「一台内存巨大的计算机」,而不是一堆需要走网络通信的机器。
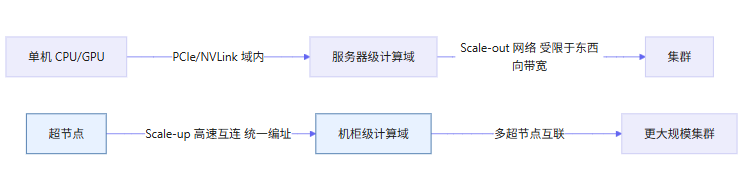
二、三条路线,差异不在算力在系统
同样是扩大高速协作区,三家的做法差别很大:
|
维度 |
华为昇腾 960 超节点 |
阿里磐久超节点 |
浪潮 SD200 Ultra |
|
单超节点规模 |
4096 卡 |
厂商未公布单节点卡数 |
128 颗 AI 芯片 |
|
互连取向 |
灵衢 UnifiedBus + NPO 光引擎(近铜远光) |
ICN 互联芯片,云与芯片联合设计 |
3D Hyper Mesh,节点内短距铜互连 |
|
内存组织 |
统一编址,可跨物理服务器访存 |
系统级协同 |
统一编址 + 对称内存,可访问远端显存 |
|
集群上限 |
厂商称多超节点经二层 CLOS 四平面组网可达 51.2 万卡 |
单集群最大 50 万卡 |
未公布 |
|
关键取舍 |
用光替代大量铜缆光模块,换功耗与可靠性 |
从云端模型负载向下定义基础设施 |
用开放系统把异构芯片组织成可交付平台 |
三家指向同一个目标,但谁来定义这套系统不一样:华为从芯片和互连协议往上构建全栈,阿里从云端的模型负载往下定义硬件,浪潮把不同芯片、内存、网络和软件组织成一套可交付的算力平台。英伟达的机柜级方案是同一方向的参照系。
三、算一笔账:4096 卡、8 EFLOPS 与 5500 个光引擎
厂商公布的数字里,最容易读错的是「总算力」。总量要除以卡数才有判断价值,而光引擎替代关系则直接决定机房侧的供电与布线设计。下面这段脚本把公开数据做一次换算,不做任何外推:
# ocs_scale.py —— 超节点算力与互连换算
NODES = {
    "昇腾960超节点": {
        "cards": 4096,
        "fp8_eflops": 8.0,
        "fp4_eflops": 16.0,
        "light_engines": 5500,          # 光引擎数量
        "replaced_800g_optics": 48000,  # 替代掉的 800G 光模块数量
        "power_saved_kw": 550,          # 功耗降低
        "max_cluster_cards": 512000,
    },
}

def card_level(node):
    return {
        "每卡等效 FP8(TFLOPS)": round(node["fp8_eflops"] * 1e6 / node["cards"] / 1e3, 1),
        "每卡等效 FP4(TFLOPS)": round(node["fp4_eflops"] * 1e6 / node["cards"] / 1e3, 1),
    }

def optics_efficiency(node):
    le, rep, kw = node["light_engines"], node["replaced_800g_optics"], node["power_saved_kw"]
    return {
        "光模块替代比(颗/个)": round(rep / le, 2),
        "每替代一颗 800G 光模块节电(W)": round(kw
实际运行输出:
单超节点卡数            : 4096
每卡等效 FP8            : 2.0 TFLOPS
每卡等效 FP4            : 3.9 TFLOPS
光模块替代比            : 8.73 颗 800G 光模块 / 1 个光引擎
每替代一颗光模块节电    : 11.5 W
集群最大卡数            : 512000
按 4096 卡折算的超节点数:
三个结论可以直接用:
- 替代比 8.73:5500 个光引擎顶掉了 4.8 万颗 800G 光模块。对机房来说这是布线与故障点的数量级变化——故障点少一个量级,可用度的账才算得过来,厂商给出的系统可用度是 99.8%;
- 每卡等效 FP8 约 2.0 TFLOPS:注意这是「总量 ÷ 卡数」的等效值,用来判断是不是同一量级,不是单卡实测指标。跨厂商拿这个数比高低是错的,因为精度口径、是峰值还是实测、卡数统计范围都可能不同;
- 按 4096 卡折算,51.2 万卡集群约等于 125 个超节点。这个数比「多少万卡」更有用,它决定了二层 CLOS 组网的平面数与拓扑设计。
四、多超节点怎么连起来:51.2 万卡是怎么拼的
刚才算出的 125 个超节点,不是简单堆在一起就算一个集群。厂商给出的组网方式是:多个超节点用灵衢网络或 RoCE 连接,采用二层 CLOS 四平面组网,再结合多轨道拓扑。
这三个词各对应一个工程约束:
- 二层 CLOS:超节点内部已经是 Scale-up 域,超节点之间是 Scale-out 层。用 CLOS 架构的目的是让任意两个超节点之间的跳数一致,避免近端带宽高、远端带宽低造成的负载不均;
- 四平面:把互联拆成四个独立平面,任一平面故障时其余平面承接流量。这是可用度账的一部分,也是 99.8% 这个数字的来源之一;
- 多轨道拓扑:解决的是超节点数量继续增加时的布线复杂度。轨道数上去,跨轨道的通信代价也跟着上去,所以规模不是线性扩展。
对使用方的实际含义:集群规模越大,能跑满的模型规模不一定同步增长,因为跨超节点的通信会让一部分算力等待。买卡之前先想清楚通信模型,比先想清楚卡数更有用。
五、什么情况下超节点跟你无关
说清楚边界,比只讲好处更有价值:
- 单机推理、并发不高:一张卡能装下的模型,超节点带来的是成本不是收益;
- 模型不大但请求很多:瓶颈在调度与批处理,先解决推理服务的吞吐,而不是扩计算域;
- 数据出不去:如果 KV Cache 与中间结果必须留在本地,跨机柜的统一编址用不上;
- 只看单卡跑分选型:超节点的价值在系统,单卡指标无法反映互连与功耗的实际差异。
一句话:当你的瓶颈是「卡等数据」,超节点才有意义;瓶颈是「数据等业务」,先看上面那层。
六、算力之上,还有一层要有人接
超节点解决的是「卡与卡之间」的问题。但企业把大模型用起来,卡之上还有一层绕不过去:推理服务要统一入口、KV Cache 要在节点间共享、模型路由要能按成本切换、请求要在消息与缓存之间有序流动。这几件事在国产化环境里更具体——算力要成体系可用,就不能只有芯片,还得有承接应用的基础软件层,把应用、缓存、消息、推理服务串成一条可运维的链路。
金蝶天燕 Apusic 在国产化基础软件里承担的就是这一层:Apusic 分布式计算与消息、缓存类产品要把上层应用与下层算力解耦,让换卡、扩节点、切模型不至于牵动业务代码。这一轮超节点把算力边界推到了机柜,随之而来的是中间件层要回答的新问题:跨节点的缓存一致性怎么保证、长任务的消息怎么不丢、模型切换怎么对业务无感。这些问题的答案不在芯片手册里,在部署架构里。
七、机房侧的账:550 千瓦与 99.8%
超节点的另一个变化在机房侧。采用正交架构与全液冷设计,配合光引擎替代光模块,厂商给出的数字是功耗降低超 550 千瓦、系统可用度达到 99.8%。
这两组数字对运维的含义不一样:
- 550 千瓦:这是单套系统的量级。机房供电与制冷是按机柜规划的,一套系统的功耗压下来,对应的配电容量、UPS 冗余、制冷能力都能重新算账。省电的价值不只在电费,在同样面积里还能放多少;
- 99.8%:这个可用度近似于年停机 17.5 小时。对训练任务,中断意味着要重新加载检查点;对推理服务,意味着容量冗余要按这个数留。可用度数字必须落到冗余设计上,否则就只是一句宣传语。
还有一个容易被忽略的连带项:光引擎替代光模块带来的是故障点数量下降,而故障点少一个量级,平均修复时间与备件管理都会跟着简化。这是少即是多在机房里的具体体现。
八、结论
超节点这一轮竞争,比的不是谁的卡多,而是谁先把「计算域」这件事定义清楚。华为用光引擎换功耗与可靠性,阿里用云端负载反过来定义硬件,浪潮用开放系统组织异构芯片。对使用方来说,判断标准只有一个:你的瓶颈在卡之间,还是在卡之上。
再补一句口径上的提醒:三家公布的算力数字,有的是峰值、有的是实测,精度口径(FP8、FP4、FP16)也未必一致,超节点的总算力更是整机系统的数,不是单卡能力。看到数字先问三个问题:什么精度、峰值还是实测、是整机还是单卡。 这三问答不清楚,比较就没有意义。
数据来源说明:本文算力、互连与功耗数据均来自三家厂商公开发布口径(华为全联接大会、阿里云栖大会及媒体转载),每卡等效值为本文换算结果,非厂商单卡实测指标;替代比与节电数据未经第三方复现,选型前应以厂商正式规格书为准。
你们的推理集群,现在卡在「卡等数据」还是「数据等业务」?

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)