
昇腾NPU显存管理避坑指南:从npu-smi输出精准识别空闲卡的底层逻辑与实战
昇腾NPU显存管理避坑指南:从npu-smi输出精准识别空闲卡的底层逻辑与实战
引言:大模型部署背后的算力焦虑
在人工智能飞速发展的今天,大语言模型(LLM)的参数规模不断攀升,从早期的几亿参数到如今动辄几百亿甚至上千亿参数。为了支撑这些庞然大物的推理和训练,企业对底层算力的需求呈现指数级增长。在这个过程中,华为昇腾(Ascend)系列NPU凭借其强大的算力和本土化生态优势,成为了众多企业构建AI基础设施的重要选择。
然而,当我们将视线从宏大的架构设计转向日常的工程落地时,会发现一个极为现实且普遍的问题:算力资源的精细化管理和排查。许多刚接触昇腾生态的开发者,在部署类似vLLM这样的高性能推理框架时,经常会遇到各种各样的问题。比如,满怀信心地输入了启动命令,结果用curl去测试接口时却遭遇了冷冰冰的“拒绝连接”;又或者,想要启动一个新的微调任务,却不知道当前机器上哪张卡是空闲的,盲目分配导致显存溢出(OOM)任务崩溃。
这些问题的根源,往往在于对底层硬件状态监控工具的熟悉程度不够。在英伟达(NVIDIA)生态中,开发者习惯于使用nvidia-smi;而在昇腾生态中,对应的利器则是npu-smi。虽然工具名称只有一词之差,但其输出信息的解读方式、指标含义却有着诸多独特之处,甚至暗藏着容易让人踩坑的陷阱。
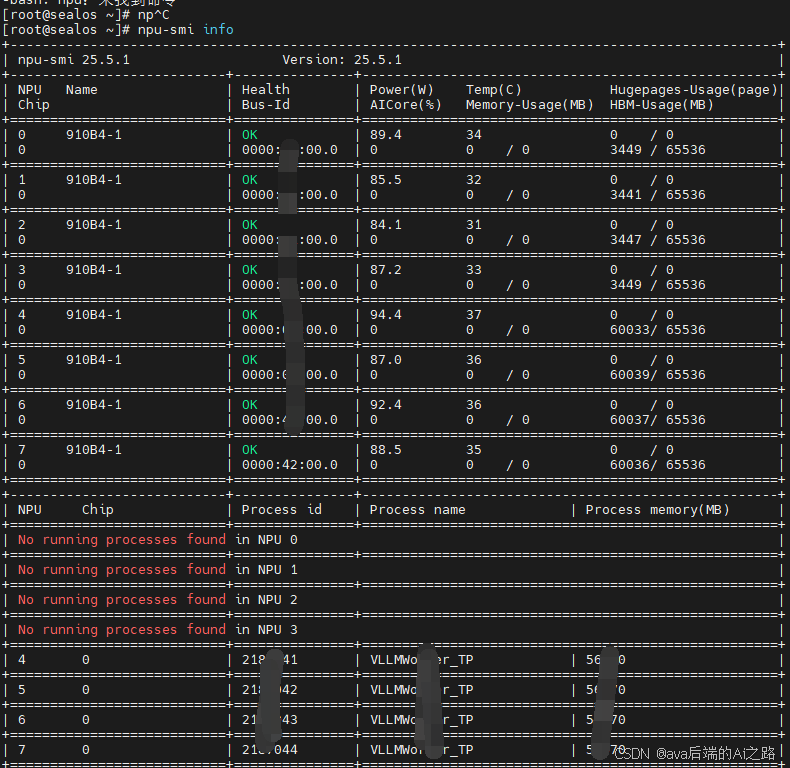
本文将以一次真实的排障经历为切入点,结合一张典型的npu-smi info输出截图,手把手教大家如何像资深系统工程师一样,精准解读昇腾NPU的各项指标,彻底搞懂如何准确无误地判断哪张卡是真正的空闲卡。全文将深入剖析显存占用、算力利用率、进程管理等核心概念,并提供切实可行的实战命令。本文篇幅较长,旨在为你提供一份详尽的昇腾运维避坑指南,建议收藏。
文章目录
第一章:场景复现——一次典型的vLLM部署排障
在深入解读工具之前,我们先来看看引发这次技术探讨的真实场景。假设你是一名AI平台工程师,负责在公司内部的昇腾服务器上部署一个基于Qwen 32B大模型的vLLM推理服务。
你敲下了一长串复杂的启动命令:
python3 /usr/local/python3.11.14/bin/vllm serve /data --trust-remote-code --port 6017 --served-model-name qwen32b --max-model-len 36864 --enable-auto-tool-choice --tool-call-parser hermes
这条命令包含了诸多关键参数:指定了模型路径/data,服务端口6017,模型名称qwen32b,以及上下文长度36864等。你满怀期待地等待模型加载完毕。
为了验证服务是否正常,你另开一个终端窗口,熟练地输入了测试命令:
curl -s --max-time 5 http://127.0.0.1:18019/v1/models
结果却令人沮丧,系统毫不留情地返回:
curl: (7) Failed to connect to 127.0.0.1 port 18019: 拒绝连接
“拒绝连接”通常意味着服务没有监听目标端口。但是,你敏锐地发现了一个细节:启动命令中指定的端口是6017,而测试命令中请求的是18019。这可能是复制粘贴时产生的笔误。然而,当你修正端口后,问题可能依然存在——服务启动极慢,或者底层根本没有足够的资源来加载模型。
为了排查底层硬件资源是否充足,你决定查看服务器的NPU状态。由于权限限制,你首先尝试以普通用户执行,结果遇到了“未找到命令”的报错,最终通过sudo -i切换到root用户后,终于敲下了那个至关重要的命令:
npu-smi info
系统返回了一张包含了丰富信息的表格。面对密密麻麻的数字和状态栏,如何判断到底哪张卡在干活,哪张卡在闲置,哪张卡已经被其他进程霸占?这不仅考验你对工具的理解,更关系到后续任务的生死存亡。
第二章:庖丁解牛——npu-smi info输出参数深度解析
要成为昇腾NPU的管理专家,首先必须像庖丁解牛一样,对npu-smi info的输出结构了如指掌。这个命令的输出通常分为上下两大部分:上半部分展示的是物理NPU芯片的整体健康与资源概况,下半部分展示的是进程级别的详细占用信息。
2.1 上半部分:物理卡状态全景图
在截图中,上半部分是一个规整的表格,包含了NPU、Name、Health、Power、Temp、AICore、Memory-Usage、Hugepages-Usage等列。让我们逐一拆解这些指标的深层含义。
NPU与Name(设备编号与型号)
第一列NPU展示了逻辑上的设备编号,从0到7,这表明服务器上插了8张加速卡。第二列Name显示了芯片的具体型号,图中显示为910B4-1。华为昇腾910B是目前国内主流的高性能AI训练/推理芯片,B4通常代表特定的规格或显存配置版本。了解型号有助于你在遇到性能瓶颈时,准确评估硬件的理论算力上限。
Health(健康状态)
这一列显示为OK,表示该NPU硬件处于健康状态,没有发生严重的硬件故障。如果出现Alarm或Error,则意味着硬件可能存在过热、掉卡或内存错误,此时需要立即联系运维人员进行硬件排查。硬件健康是所有软件运行的基础。
Bus-Id(总线标识)
图中显示的0000:C1:00.0等是PCIe总线地址。在多卡服务器中,这个标识非常重要,它决定了NPU与CPU以及其他外设之间的通信带宽。在进行多卡并行训练(如Tensor Parallelism)时,理解Bus-Id有助于评估卡间通信拓扑,优化并行策略。
Power(W)与Temp©(功耗与温度)
功耗和温度是反映NPU工作负载的重要物理指标。图中部分卡的温度在31到37摄氏度之间,功耗在84W到94W之间。虽然AICore显示为0%,但有一定的功耗和温度,这说明芯片处于通电待机状态。如果温度过高(如超过80度),NPU可能会触发降频保护,导致推理速度大幅下降。
AICore(%)(AI核心利用率)——最容易误导人的指标
这是本文要重点强调的第一个陷阱。在图中,所有卡的AICore利用率均为0%。很多初学者看到这个数字,第一反应就是“这张卡完全空闲,我可以随便用”。然而,这是一个极其危险的误解。
AICore代表的是AI计算核心的活跃度。0%仅仅意味着在当前这个极短的时间切片内,NPU没有在执行矩阵乘法等计算指令。但是,对于大模型推理框架(如vLLM)而言,显存中可能已经加载了数十GB的模型权重,服务处于常驻待命状态。此时AICore可能是0%,但显存早就被吃干抹净。这就像一辆停在路边的重型卡车,发动机没有转动(AICore为0%),但车厢里装满了货物(显存被占用),你无法再往里面塞任何东西。
Memory-Usage(MB)(显存占用)——最核心的硬通货
格式为已用 / 总量。图中每张卡的总显存为65536MB,即64GB。这是决定你能否启动新任务的最核心指标。大模型推理对显存的消耗极其惊人。以Qwen 32B模型为例,即使采用FP16精度,仅仅加载权重就需要约64GB显存(32B * 2 bytes),通常需要多卡并行才能装下。如果加上KV Cache和中间激活值,显存需求会更高。
观察图片可知,0到3号卡的显存占用在3449MB左右。这通常是系统基础驱动、固件以及未释放的缓存所占用的“底噪”。而4到7号卡的显存占用高达60037MB左右,几乎逼近64GB的上限,这说明这四张卡已经被严重占用。
Hugepages-Usage(page)(大页内存使用)
图中显示为0 / 0。大页内存是操作系统为了减少TLB(Translation Lookaside Buffer)未命中而采用的一种内存管理技术。在大模型推理中,合理配置大页内存可以显著提升显存与主存之间的数据传输效率。虽然目前很多框架会自动管理,但了解这一项有助于在极限性能调优时进行深度定制。
2.2 下半部分:进程级占用详情
如果说上半部分是宏观扫描,那么下半部分就是微观取证。表格列出了NPU、Chip、Process id、Process name和Process memory(MB)。
No running processes found(未找到运行进程)
在图中,0、1、2、3号NPU对应的这一栏赫然写着No running processes found。这是判断空闲卡最直接、最铁的证据。这意味着当前系统中没有任何用户态的进程(如Python脚本、推理服务)绑定在这几张卡上。
VLLMWorker_TP(vLLM工作进程)
在4、5、6、7号NPU上,我们看到了名为VLLMWorker_TP的进程。Process id分别是2187041到2187044。Process memory均显示占用56670MB。
这揭示了几个重要信息:
第一,这四张卡正在被一个vLLM服务使用。
第二,TP通常代表Tensor Parallelism(张量并行)。这意味一个大模型被切分成了四份,分别放置在4、5、6、7号卡上协同推理。这也是为什么每张卡的显存占用如此均匀(都在56GB左右)且巨大的原因。
第三,进程ID是连号的,说明它们是同一个父进程派生出来的工作进程。
第四,既然这四张卡上运行着vLLM,那么它们绝对不能被分配给其他任务。
第三章:核心误区辨析——打破“AICore为0即空闲”的思维定势
在明确了各项指标的含义后,我们需要集中精力攻克判断空闲卡时最大的认知陷阱:算力利用率(AICore)与显存占用(Memory-Usage)的分离现象。
在GPU/NPU的世界里,计算资源和存储资源是两个完全独立的管理维度。很多开发者习惯性地用CPU的思维来理解:任务没在跑(CPU利用率低),内存(显存)就会释放。但在AI加速卡上,这个逻辑并不成立。
为什么AICore为0%?
对于vLLM这类推理框架,其工作模式是“请求驱动”的。当没有外部HTTP请求到达时,模型不需要进行前向计算,因此AI核心处于休眠状态,利用率为0%。这就好比一家餐厅,没有客人点餐时,厨师(AI核心)就在休息。
为什么显存依然高居不下?
为了极致的响应速度,vLLM在启动时就会执行一个称为“显存预分配”的过程。它会一次性向NPU申请一大块连续的显存,将模型权重(Weights)常驻其中,并预先划分出KV Cache(键值缓存)的空间,以避免在推理过程中频繁申请和释放显存带来的开销。这就好比餐厅虽然没客人,但食材(模型权重)早就洗好切好摆满了整个冷库(显存)。即使厨师在休息,冷库也是满的,其他餐厅无法借用这个冷库。
因此,图中的4、5、6、7号卡,虽然AICore为0%,但它们是高度“忙碌”的——它们在待命,且资源已被锁死。任何试图向这四张卡提交新任务的行为,都会因为显存不足(Out of Memory, OOM)而立即失败。
AICore的真正应用场景
那么AICore指标没用吗?当然不是。AICore主要用于判断一张已经被占用的卡当前是否在“全力输出”。例如,当你发现4-7号卡正在进行高并发推理时,AICore可能会飙升到80%以上,此时如果你再加入新任务,即使显存勉强够用,算力也会被严重争抢,导致推理延迟(Latency)急剧增加,吞吐量(Throughput)大幅下降。因此,AICore是评估算力瓶颈的关键指标,但绝对不能作为判断卡是否空闲的唯一标准。
第四章:黄金法则——三步走精准锁定空闲卡的实战策略
基于以上的深度剖析,我们可以总结出一套判断昇腾NPU空闲状态的“三步走黄金法则”。这套法则优先级明确,逻辑严密,能够帮助你在任何复杂的集群环境中迅速做出正确决策。
第一步:查看进程列表(Process)——一票否决权
这是首要且最直接的判断标准。执行npu-smi info后,直接目光下移至底部的进程区域。
如果某张卡对应No running processes found,那么这张卡至少在用户态是没有任何任务在跑的。
如果显示了具体的Process id和Process name(如VLLMWorker_TP、python、pytorch等),无论其显存占用多少,无论其AICore是多少,这张卡都已经被占用。除非你明确知道该进程是僵尸进程或者可以安全终止,否则绝对不能将其视为空闲卡。
在给出的截图中,0、1、2、3号卡完美通过了这一关,下方明确显示无运行进程。
第二步:审查显存占用(Memory-Usage)——硬性资源门槛
通过了进程审查后,第二步是看显存。一张真正的空闲卡,其显存占用应该处于“基础底噪”水平。
在昇腾910B(64GB显存版本)上,这个基础底噪通常在3000MB到4000MB之间(如图中的3449MB)。这部分显存被驱动程序、底层通信库(如HCCL)以及系统守护进程所消耗,属于正常现象,你无法也不应该去释放它。
如果某张卡没有进程,但显存占用依然很高(例如占用了几万MB),这通常意味着存在显存泄漏,或者之前运行的进程异常退出后没有正确释放显存(僵尸显存)。在这种情况下,这张卡也不能被直接使用,通常需要通过npu-smi的相关工具或重启服务器来重置。
在截图中,0、1、2、3号卡的显存占用都在3.4GB左右,完全符合空闲卡的显存特征。而4、5、6、7号卡的显存占用高达约60GB,显然已被吃满。
第三步:参考算力利用率(AICore)——辅助验证
在满足了无进程、低显存两个条件后,最后再看AICore。此时,空闲卡的AICore应当趋近于0%。如果有非零的AICore占用,说明可能有隐蔽的内核线程在运行,或者系统正在进行后台巡检。但在绝大多数情况下,前两步就能决定一张卡的去留。AICore在这里更多是作为一个辅助确认,确保没有“幽灵任务”在偷跑算力。
实战判定结论
应用上述法则于本文的截图:
- NPU 0, 1, 2, 3:无进程,显存约3.4GB(基础占用),AICore为0%。结论:完全空闲,可安全分配新任务。
- NPU 4, 5, 6, 7:存在
VLLMWorker_TP进程,显存约60GB(接近满载),AICore为0%(待命状态)。结论:已被vLLM服务占用,严禁分配新任务。
第五章:从理论到实践——如何正确指定空闲卡启动任务
认清了哪些卡是空闲的之后,下一步就是如何在实际操作中正确地将任务绑定到这些空闲卡上。在昇腾生态中,控制可见设备的环境变量与NVIDIA生态既有相似之处,也有其特殊性。
5.1 使用 ASCEND_RT_VISIBLE_DEVICES 隔离设备
在基于PyTorch的昇腾开发中,最常用的环境变量是ASCEND_RT_VISIBLE_DEVICES。它的作用类似于NVIDIA的CUDA_VISIBLE_DEVICES,用于限制当前进程能够看到的NPU设备。
根据我们的排查结果,0、1、2、3号卡是空闲的。如果你希望启动一个新的推理服务或训练脚本,并且只使用这四张卡,你可以在启动命令前加上:
export ASCEND_RT_VISIBLE_DEVICES=0,1,2,3
或者在命令中直接内联:
ASCEND_RT_VISIBLE_DEVICES=0,1,2,3 python your_script.py
这样,你的程序内部在进行设备初始化时,只会看到逻辑上的0、1、2、3号卡,而物理上的4、5、6、7号卡对它是不可见的。这不仅避免了资源冲突,还能防止程序因尝试访问已被占用的卡而报错。
5.2 理解逻辑编号与物理编号的映射
值得注意的是,当你使用ASCEND_RT_VISIBLE_DEVICES=0,1,2,3后,在你的Python程序中,torch.npu.current_device()返回的可能是逻辑编号,而不是物理编号。例如,程序看到的device 0实际上对应的是物理上的NPU 0。这种映射关系在编写多卡并行代码时至关重要,错误的映射可能导致通信组初始化失败。
5.3 清理与回收被占用的显存
如果经过排查,你发现4、5、6、7号卡上的VLLMWorker_TP进程是你之前忘记关闭的,或者是意外中断留下的僵尸进程,你需要手动将其清理以释放显存。
首先,通过进程ID(如图中的2187041、2187042等)使用kill命令终止它们:
kill -9 2187041 2187042 2187043 2187044
执行后,不要立刻启动新任务。建议等待几秒钟,让驱动完成显存的回收,然后再次运行npu-smi info确认显存占用是否已回落到基础底噪(约3GB左右)。如果显存依然居高不下,可能需要使用更底层的重置命令(如npu-smi set -t reset -i <id>,需谨慎使用),或者在极端情况下重启服务器。
第六章:进阶运维——昇腾NPU常见疑难杂症与排查技巧
掌握了基本的空闲卡判断方法后,我们还需要了解一些进阶的运维知识,以应对更加复杂的生产环境。
6.1 为什么显存释放了,但 npu-smi 依然显示占用?
这是一个非常经典的问题。在很多情况下,你杀死了Python进程,但npu-smi依然显示该卡有大量显存被占用。这通常是因为:
- 僵尸进程残留:父进程被杀死了,但子进程(如DataLoader的worker进程)依然存活并持有显存。你需要使用
ps -ef | grep python仔细排查所有相关进程。 - HCCL通信组未销毁:在多卡通信中,如果程序异常崩溃,底层的HCCL通信库可能没有正常执行清理逻辑,导致显存被锁死。这种情况下,通常只能通过重启节点来解决。
- 显存碎片:长时间运行大量小任务后,显存中可能产生大量碎片,导致虽然总空闲显存足够,但无法分配出一块连续的大显存。
6.2 OOM(Out of Memory)报错的排查思路
当你在空闲卡上启动任务却遭遇OOM时,需要从以下几个维度排查:
- 模型大小与显存不匹配:例如试图在单张64GB的卡上以FP16精度加载一个70B参数的模型,这是物理上不可能的。
- Batch Size过大:KV Cache的大小与Batch Size和序列长度成正比。如果配置了过大的
max-model-len或并发数,显存需求会激增。 - 显存碎片与预分配策略:vLLM默认会预分配90%的显存(
gpu_memory_utilization=0.9)。如果设置过高,可能导致启动时直接OOM;设置过低,又可能影响吞吐量。在昇腾上,通常需要根据实际情况微调这个参数。
6.3 利用 npu-smi 监控多卡协同状态
在多机多卡训练中,卡间的通信带宽往往是瓶颈。npu-smi提供了查看拓扑结构的命令。你可以使用npu-smi info -t topo来查看各张卡之间的连接方式(如是否通过HCCS高速互联)。如果发现张量并行的卡跨了慢速的PCIe总线,就需要调整并行策略,将通信频繁的卡尽量放在同一个高速互联域内。
第七章:总结与展望
在AI基础设施规模不断扩大的今天,算力资源的高效利用是每一个AI工程师必须面对的课题。昇腾NPU作为国产算力的中坚力量,其生态正在快速完善。掌握npu-smi这一基础而强大的工具,不仅能够帮助我们快速排除故障,更是实现精细化资源调度的前提。
回顾本文的核心要点:
第一,npu-smi info是查看昇腾NPU状态的瑞士军刀,分为物理卡状态和进程详情两部分。
第二,判断空闲卡的金标准是“进程列表无记录 + 显存占用处于基础底噪”。
第三,切勿被AICore 0%的表象所迷惑,大模型推理框架的显存预分配机制会让空闲的算力核心与满载的显存同时存在。
第四,通过ASCEND_RT_VISIBLE_DEVICES环境变量可以精确控制任务的设备可见性,避免资源争抢。
技术的道路没有捷径,唯有深入底层,理解每一个指标背后的物理和逻辑含义,才能在遇到问题时游刃有余。希望这篇长文能够成为你在昇腾生态中探索的一份实用指南。在未来的文章中,我们将继续深入探讨vLLM在昇腾上的性能调优、多机多卡分布式训练的拓扑优化等高级话题。算力时代,让我们一起精进技术,驾驭未来。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)