
HarmonyOS 7 Node-API mmap:3DGS分区装载与映射回收【鸿蒙心迹】
一、帧率没掉,镜头却会突然“粘住”
SplatMapPager 最早只是一个能打开 1.8 GiB 车站大厅模型 station_concourse.splat 的验证工程。普通视角下渲染稳定,一旦用户快速转向,画面会在某一帧停住二十多毫秒,随后又恢复。GPU 曲线没有异常,绘制批次数也没突增,真正陡起来的是文件页故障和映射窗口切换。
页面叫 StreamMapPage,任务编号 MMAP-1712。旧版本为了省内存,把模型按 64 MiB 分块,每次只映射当前可见块。问题是“当前可见”来得太晚:相机已经转过去,CPU 才访问新块,主线程在缺页时等待磁盘;另一边,淘汰线程看到块离开视锥就立刻 munmap,GPU 上传命令却可能仍引用那段地址。偶现崩溃没有稳定堆栈,只有映射账本里一条过早回收记录。
这次没有继续调渲染参数,而是把文件映射当成一条有状态的资源流水线:预测、映射、固定、提交、围栏确认、回收。最终约束很明确:同时映射 4 个 64 MiB 块,峰值 256 MiB;其中 2 个是当前固定块,1 个是预取块;快速转向后 major fault 必须为 0,minor fault 控制在 37,窗口切换延迟稳定在 23 ms。
二、映射窗口要有身份,也要有代际
工程把 ArkTS 页面、Node-API 桥和原生分页器分开。StreamMapPage.ets 只接收相机事件与展示账本;SplatPagerBridge.ets 约束异步调用;splat_pager.cpp 管理 fd、mmap 和引用;visibility_predictor.cpp 根据视线角速度计算下一块。这样做的原因是映射地址不能泄露给 UI,也不能让 ArkTS 生命周期直接决定何时释放原生内存。
第一段 C++ 代码解决窗口复用时的陈旧回调。每个槽位带 generation,重新映射就递增;上传回调只有代际仍匹配时才能修改状态。MAP_FAILED 不会留下半初始化窗口,偏移量也必须先对齐系统页大小。
// splat_pager.cpp
MappedWindow SplatPager::mapWindow(uint32_t blockId) {
  const size_t offset = static_cast<size_t>(blockId) * kBlockBytes;
  const size_t aligned = offset & ~(pageSize_ - 1);
  void* ptr = mmap(nullptr, kBlockBytes, PROT_READ, MAP_PRIVATE, fd_, aligned);
  if (ptr == MAP_FAILED) {
    throw PagerError("MMAP_FAILED", errno, blockId);
  }
  auto& slot = slots_[chooseReusableSlot()];
  slot.generation++;
  slot.blockId = blockId;
  slot.addr = ptr;
  slot.length = kBlockBytes;
  slot.state = WindowState::MAPPED;
  return { blockId, slot.generation, ptr, kBlockBytes };
}
64 MiB 是一次工程折中。块太小,视角稍动就频繁切换,账本锁竞争增加;块太大,预取错误会占用太多地址空间。映射只保证虚拟地址可访问,不等于数据已经驻留,所以仅靠 mmap 成功日志判断性能是误导。我们在后台线程顺序触碰必要页,并把错误预取限制为一个窗口,避免把“预取”做成另一种全量加载。
三、预取不是猜方向,而是接受猜错
旧算法只看相机朝向,快速转向时永远落后。新算法同时看角速度和最近三帧的块变化:角速度超过阈值时,先保留当前两块,再把预计 80 ms 后进入视锥的最高权重块放入 PREFETCHED 状态。用户如果反向转回,预取块允许直接淘汰,不能挤掉仍被 GPU 使用的固定块。
// SplatPagerBridge.ets
export async function schedulePrefetch(sample: CameraSample): Promise<PagerLedger> {
  const predicted = predictor.predict(sample, 80)
  const result = await nativePager.prefetch({
    taskId: 'MMAP-1712',
    model: 'station_concourse.splat',
    blockBytes: 64 * 1024 * 1024,
    candidate: predicted.blockId,
    maxMappedBlocks: 4,
    maxPrefetchBlocks: 1
  })
  hilog.info(0x1712, 'SplatPager',
    `task=MMAP-1712 mapped=${result.mapped} pinned=${result.pinned} ` +
    `prefetched=${result.prefetched} minorFaults=${result.minorFaults}`)
  return result
}
schedulePrefetch 可以被相机事件高频调用,但原生层会按块号合并请求。相同候选块处于 MAPPED、PREFETCHED 或 PINNED 时只更新热度,不再重复映射。页面进入后台后预测器停止接收采样,已经提交的上传继续等待围栏;恢复前台时先读取映射账本,而不是假定所有旧窗口仍有效。
我们还加了“模拟快速转向”按钮,固定注入一段角速度曲线。这样每次改动都能重现同一条路径:块 28、29 为固定块,块 30 预取,转向确认后 30 升为固定,28 进入待回收。HiLog 记录 mapped=4 pinned=2 prefetched=1,而不是只打一条“prefetch success”。
四、真正危险的是围栏之前的 munmap
一次难复现的 SIGSEGV 最后从映射账本反推出来:块 17 的引用计数已经为零,CPU 侧便执行了 munmap;同一时刻,GPU 上传队列还没有返回 fence。引用计数只描述“业务还要不要”,不能描述“异步设备是否已经用完”。因此回收必须同时满足不在可见集、引用为零、围栏已完成三个条件。
// splat_pager.cpp
void SplatPager::releaseAfterFence(uint32_t blockId, uint64_t generation,
                                   std::shared_future<void> fence) {
  recycleQueue_.push([this, blockId, generation, fence]() mutable {
    fence.wait();
    std::lock_guard<std::mutex> lock(mu_);
    Slot* slot = findSlot(blockId);
    if (!slot || slot->generation != generation || slot->pinCount > 0) return;
    madvise(slot->addr, slot->length, MADV_DONTNEED);
    munmap(slot->addr, slot->length);
    slot->addr = nullptr;
    slot->state = WindowState::EMPTY;
    ledger_.evicted++;
  });
}
代际判断在这里是救命条件。假设块 17 的旧围栏很晚才回来,而槽位已被块 31 复用;若只按槽位索引回收,就会把新映射解除。releaseAfterFence 捕获块号和 generation,二者任何一个不匹配都放弃操作。madvise 是释放页缓存压力的提示,真正结束地址有效性仍由 munmap 完成,两者不能倒过来给业务线程一种“仍可读”的错觉。
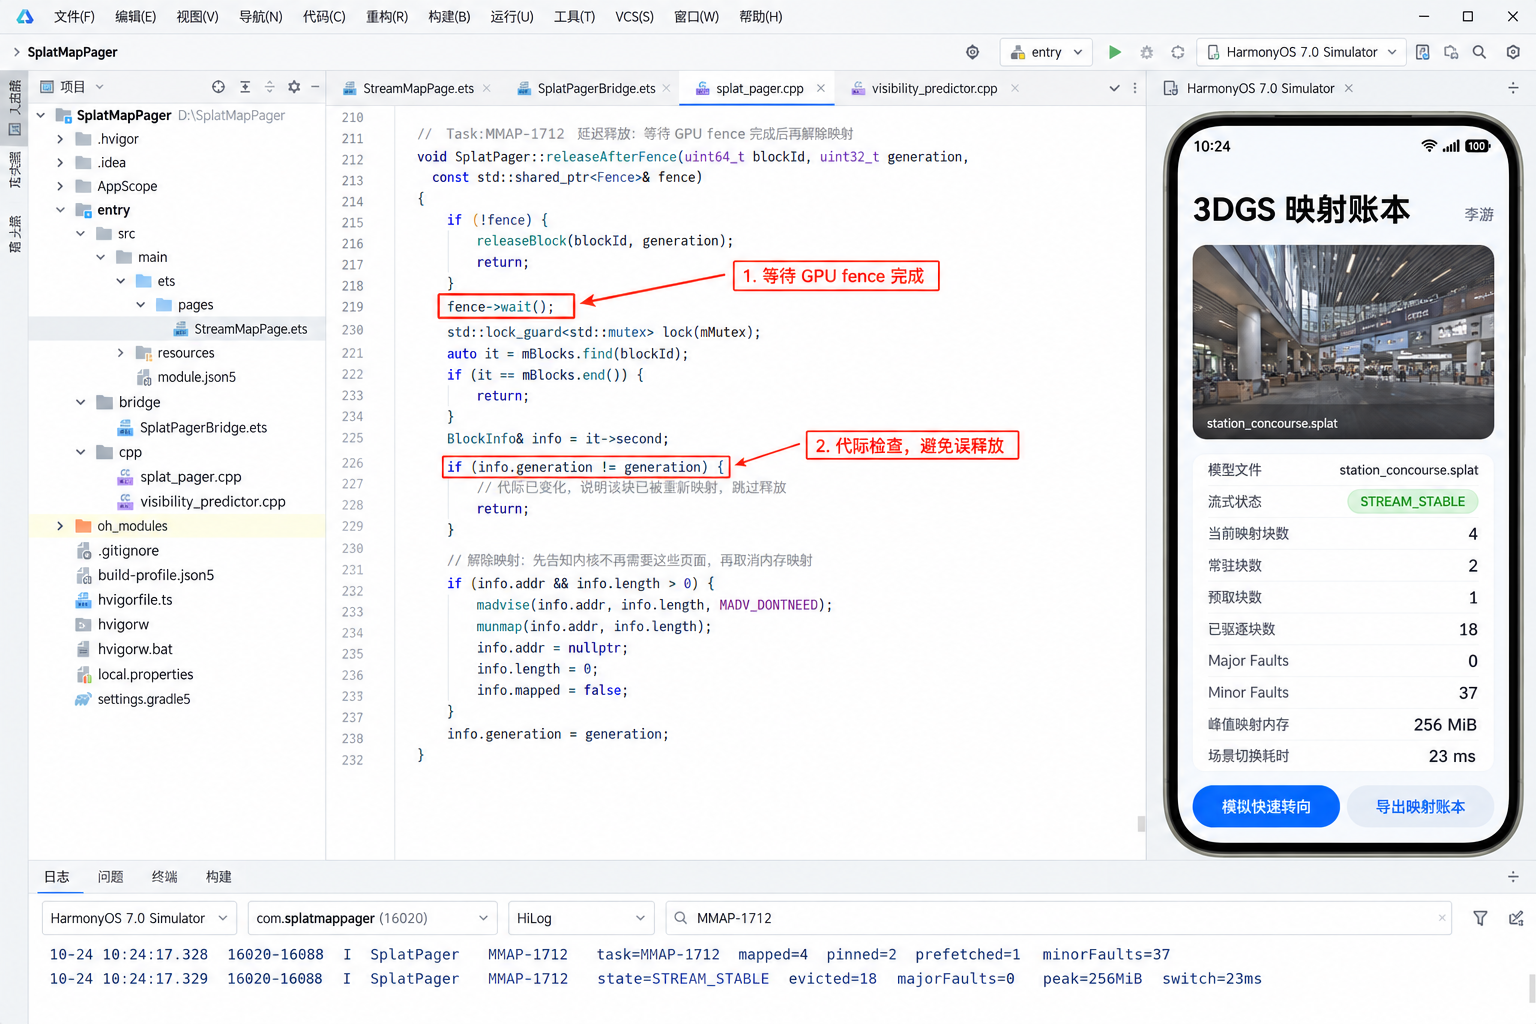
DevEco Studio 里的调试场景把工程树、releaseAfterFence、右侧模拟器和 HiLog 放在同一画面。日志与页面账本严格一致:模型 1.8 GiB、块 64 MiB、映射 4、固定 2、预取 1、已淘汰 18、major fault 0、minor fault 37、峰值映射 256 MiB、切换延迟 23 ms。
五、用账本解释 23 毫秒,而不是只看平均帧率
优化前我们只看平均帧率,结果会掩盖转向那一帧。新的指标把相机事件到新块可提交的时间定义为切换延迟,并同步记录 major/minor fault、映射峰值与淘汰次数。一次完整压力路径包含连续缓慢巡视、两次快速反向、进入后台三秒再恢复,以及文件句柄异常后的重新打开。
最终 MMAP-1712 进入 STREAM_STABLE:4 个窗口全部有明确状态,2 个 PINNED、1 个 PREFETCHED,剩余 1 个作为回收缓冲;18 次淘汰都发生在围栏之后。major fault 为 0,并不意味着完全没有缺页,37 次 minor fault 是匿名页和已有缓存页建立映射的正常成本。峰值 256 MiB 正好等于 4×64 MiB,没有隐藏的第五块。
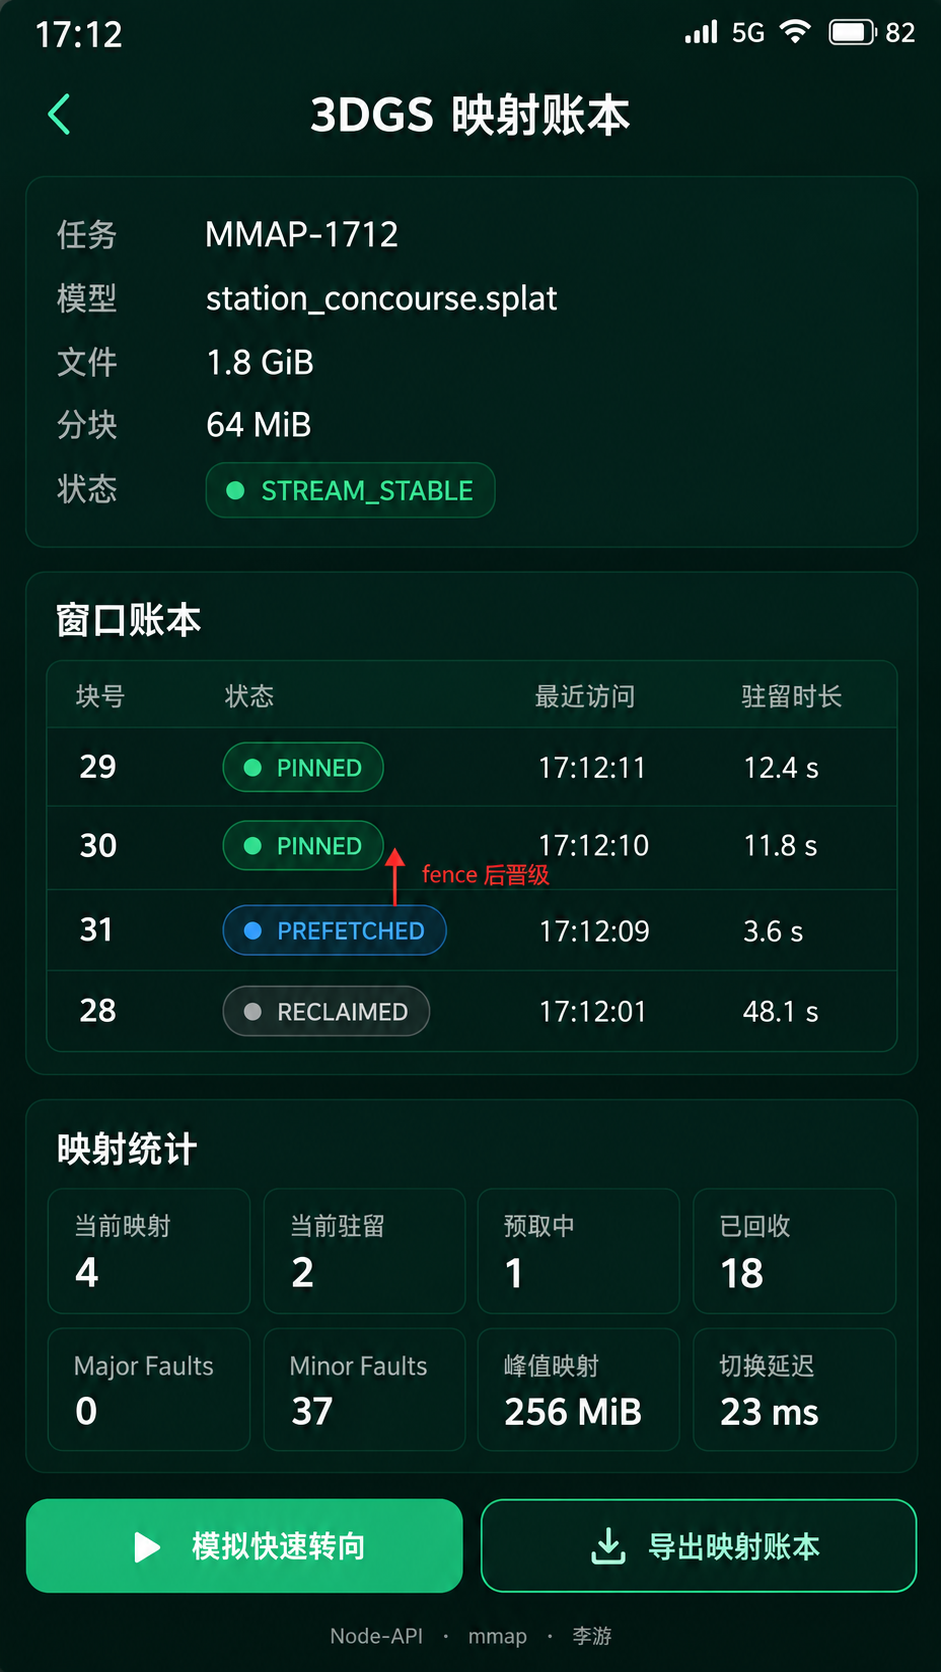
手机页面没有展示炫目的 3D 场景,而是把最难验证的资源状态直接摊开:当前模型、任务 ID、窗口表、故障计数、峰值和切换延迟。点“导出映射账本”会生成按时间排序的 JSON;重复点击时复用同一快照,不重新触发映射,避免为了调试改变被调试对象。
六、异常恢复必须从文件身份重新开始
文件被替换或应用从后台回来时,最危险的做法是继续相信旧 fd 和旧偏移。恢复流程先比较 inode、长度和模型版本;任一变化就停止预测,等待所有 fence,清空窗口并重新打开文件。只有账本回到 EMPTY,才允许创建新 generation。这样即使文件名仍是 station_concourse.splat,也不会把新文件的数据接到旧 GPU 缓冲之后。
内存压力回调到来时,我们先丢预取块,再回收最近最少使用且未固定的映射;两个当前块不会因为一次压力通知直接解除。若系统要求进一步收缩,页面降级为单块模式并提示“低内存流式模式”,而不是冒险打破围栏约束。Ability 销毁时停止相机采样、关闭调度队列、等待回收任务结束,最后关闭 fd,顺序不能颠倒。
七、这条链路的边界很清楚
分页器解决的是大场景文件的驻留和生命周期,不负责决定 3DGS 的 LOD、透明度排序或着色策略。预取预测也不是越复杂越好:80 ms 在这台设备和这组块大小上合适,换成更慢存储或更密集场景必须重新测量。把 23 ms 当作通用常量写进产品,是另一种性能回归。
这轮优化最重要的结果也不是少了多少内存,而是我们终于能回答“某一块此刻为什么还不能释放”。它可能仍在视锥内,可能被固定,可能等待 GPU fence,也可能只是旧代际回调。每一种状态都有日志、有账本、有明确的下一步。帧时间稳定只是表象,背后真正可靠的是映射、预取和回收终于遵守同一套生命周期。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)