
HarmonyOS 7 PixelForge 图像超分工程实录 03:ImageSR × Region Decode:大图分块、重叠边界与拼接缝治理【鸿蒙心迹】
前两篇把 PixelForge 的两个基础问题收稳了。
01 解决的是单图链:解码出 PixelMap、进入超分、拿到真实输出尺寸、编码、释放;02 把这条链放进批量队列,确认每张图都能在自己的 finally 里释放 input / output PixelMap,并把并发 3 的 287.9MB 峰值压到并发 1 的 118.6MB。
做到这里以后,第三篇才适合碰真正的大图。
这次我把输入换成:
city_panorama_4439x2959.jpg
4439 × 2959
4.8MB
如果仍然整图解码、整图超分、整图输出,3x 结果理论尺寸会达到:
13317 × 8877
仅最终 RGBA_8888 PixelMap 的像素数据就已经非常大。
更麻烦的是,AI 中间缓冲和编码阶段还会继续抬高峰值。
所以第三篇不再问“整图能不能跑”,而是问:
能不能只把当前分块解码成 PixelMap,做 3x 超分以后立即释放,再把结果按可控重叠区重新拼回去。
HarmonyOS 当前 Image Kit 的解码选项本身支持 region 概念,Native Image Kit 也明确提供图像区域描述结构;PixelMap 侧则支持裁剪、缩放、位图读写等能力。也就是说,“区域解码 + PixelMap 局部处理”本身是一个很合理的工程方向。
本轮统一数据:
taskId:
sr_20261002_03

source:
city_panorama_4439x2959.jpg

inputSize:
4439 × 2959

sourceFileSize:
4.8MB

tileCount:
4

horizontalCore:
2220 / 2219

verticalCore:
1480 / 1479

inputOverlap:
96px

outputOverlap:
288px

requestedScale:
3x

targetOutput:
13317 × 8877

actualOutput:
13317 × 8877

averageTileSrCost:
356ms

stitchCost:
126ms

fullFrameMemoryEstimate:
451.2MB

peakMemory:
168.9MB

seamDiffBeforeBlend:
12.8%

seamDiffAfterBlend:
1.9%

releasedPixelMaps:
8

status:
TILED_SR_READY
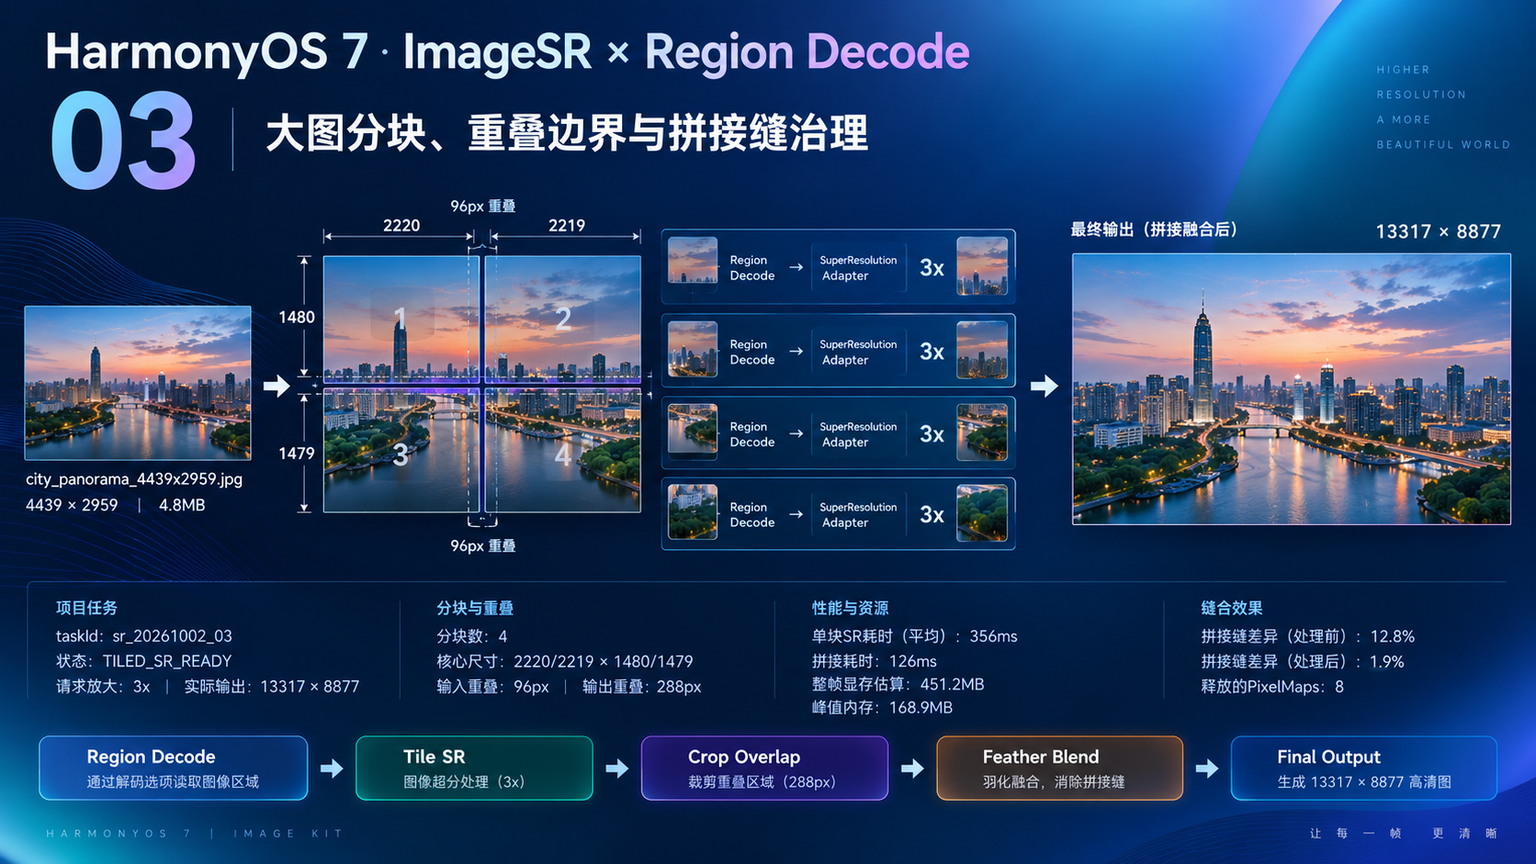
一、第三篇先把“整图超分”改成“区域计划”
如果继续沿用前两篇:
ImageSource
→ createPixelMap
→ SuperResolution
整张 4439×2959 原图会一次性进入 PixelMap。
3x 后输出宽高:
4439 × 3 = 13317
2959 × 3 = 8877
这时整帧内存估算已经到:
451.2MB
这不是最终系统占用,只是 PixelForge 当前按输入、输出和中间工作区做的工程估算。
真实值会随设备、模型实现、编码路径变化。
但它已经足够说明:
这张图不适合再把整帧 PixelMap 长时间留在内存里。
所以 03 新增:
tile/
├─ RegionDecodeService.ets
├─ TilePlanBuilder.ets
├─ TileStitcher.ets
└─ FeatherBlender.ets
页面不再关心 PixelMap,只订阅 TiledSrSnapshot。
二、4 块不是平均切,而是保留 96px 输入重叠
原图:
4439 × 2959
横向无法平均分成两个完全一样的整数宽度。
所以核心区域固定:
左:
2220

右:
2219

上:
1480

下:
1479
这四个 core 正好覆盖完整原图。
但真正解码区域不会只取 core。
靠近拼接边的位置额外多取:
96px
重叠。
Tile Plan:
export interface TileCore {
  x: number
  y: number
  width: number
  height: number
}

export interface TilePlan {
  core: TileCore
  decodeRegion: TileCore
  overlapPx: number
}

export class TilePlanBuilder {
  build():
    TilePlan[] {
    return [
      {
        core:
          { x: 0, y: 0, width: 2220, height: 1480 },
        decodeRegion:
          { x: 0, y: 0, width: 2316, height: 1576 },
        overlapPx: 96
      },
      {
        core:
          { x: 2220, y: 0, width: 2219, height: 1480 },
        decodeRegion:
          { x: 2124, y: 0, width: 2315, height: 1576 },
        overlapPx: 96
      },
      {
        core:
          { x: 0, y: 1480, width: 2220, height: 1479 },
        decodeRegion:
          { x: 0, y: 1384, width: 2316, height: 1575 },
        overlapPx: 96
      },
      {
        core:
          { x: 2220, y: 1480, width: 2219, height: 1479 },
        decodeRegion:
          { x: 2124, y: 1384, width: 2315, height: 1575 },
        overlapPx: 96
      }
    ]
  }
}
这一段代码解决的是“分块以后边缘上下文不够”的问题。
如果四块严格无重叠,超分模型在边缘看不到邻块内容,很容易形成明显接缝。
三、Region Decode 的价值不是“裁完再超分”,而是“不创建整图 PixelMap”
Image Kit 当前解码选项支持图像 region 描述;Native 接口也有 OhosImageRegion / Image_Region 这类区域结构。
PixelForge 的 RegionDecodeService 把具体 SDK 细节隔离在 Adapter 里,业务层只看到:
export interface DecodeRegion {
  x: number
  y: number
  width: number
  height: number
}

export interface RegionDecodeService {
  decodeRegion(
    sourcePath: string,
    region: DecodeRegion
  ): Promise<image.PixelMap>
}
这里最关键的不是接口长什么样,而是:
每次只得到当前 tile 的 PixelMap
不会为了截四块,先完整创建一次 4439×2959 PixelMap 再 crop。
这正是大图分块能真正降低峰值的前提。
四、每个 tile 仍然沿用 02 的单项生命周期
Tile 处理没有重新发明资源模型。
依然是:
decode region
→ tile PixelMap
→ SR
→ output tile PixelMap
→ crop overlap
→ 保存拼接块
→ release output
→ release input
代码:
export class TileRunner {
  async run(
    sourcePath: string,
    plan: TilePlan
  ): Promise<TileResult> {
    let input:
      image.PixelMap | null =
      null

    let output:
      image.PixelMap | null =
      null

    try {
      input =
        await this.regionDecoder
          .decodeRegion(
            sourcePath,
            plan.decodeRegion
          )

      const sr =
        await this.adapter
          .process(
            input,
            { scale: 3 }
          )

      output =
        sr.pixelMap

      return await this.cropper
        .cropToCore(
          output,
          plan,
          3
        )
    } finally {
      output?.release()
      input?.release()

      this.metrics
        .releasedPixelMaps += 2
    }
  }
}
4 个 tile:
4 input
4 output
所以最终:
releasedPixelMaps=8
五、为什么输出重叠变成 288px
输入重叠:
96px
请求:
3x
所以输出重叠区理论尺寸:
96 × 3 = 288px
这 288px 不是直接丢掉。
我们先保留它,用于:
比较两侧输出
做过渡融合
最后再根据 core 边界裁切到真实输出坐标。
这比“每块超分后直接按核心区域硬拼”更容易抑制接缝。
六、拼接缝 12.8% 是怎么来的
为了让“接缝好不好”不完全靠肉眼,我加了一个简单工程指标。
对相邻 tile 的重叠带:
取同一逻辑位置的 RGB 差值
求平均归一化差异
羽化前:
12.8%
这说明两个 tile 的独立超分结果在边缘有明显差异。
注意它不是 PSNR / SSIM,也不是官方质量指标。
只是 PixelForge 当前用于:
接缝回归
的工程量。
七、Feather Blend 只处理重叠带,不重新算整张图
第三段代码解决的是“怎么让 288px 重叠区平滑过渡”。
示意实现:
export function featherWeight(
  index: number,
  length: number
): number {
  if (length <= 1) {
    return 1
  }

  return index /
    (length - 1)
}

export function blendChannel(
  left: number,
  right: number,
  weight: number
): number {
  return Math.round(
    left * (1 - weight) +
    right * weight
  )
}
横向接缝:
左块权重 1 → 0
右块权重 0 → 1
纵向同理。
四块交叉中心区域则使用二维权重。
当前融合后:
seamDiffAfterBlend=
1.9%
相比 12.8% 明显下降。
八、1.9% 不是“完全无缝”的绝对证明
这点必须克制。
1.9% 只是当前测试图、当前重叠宽度、当前指标下的结果。
真实视觉还会受到:
建筑直线
文字
人脸
高频纹理
天空渐变
AI 伪影
影响。
所以 PixelForge 仍然保留:
接缝放大预览
人工检查。
工程指标和视觉确认两条都保留。
九、为什么没有把 overlap 开到 256px
overlap 越大:
边缘上下文越多
但代价也很明显:
重复 SR 区域更多
单 tile 更大
内存更高
总耗时更长
当前 96px 是 PixelForge 的项目参数,不是系统推荐值。
本轮先用:
96 → 288
形成可稳定回归的基线。
06 才会对比其他 overlap。
十、168.9MB 和整帧估算 451.2MB 的差别才是分块价值
本轮:
fullFrameMemoryEstimate:
451.2MB

actualPeak:
168.9MB
下降非常明显。
这两个数不能理解成系统承诺。
但在同一设备、同一测试输入、同一实现下,它们说明:
分块把大对象的同时存活数量压下来了。
和 02 的“并发 3 → 并发 1”是同一类工程思路。
不是让算法变轻,而是控制同时活着的资源。
十一、最终输出宽高必须回到完整 3x 几何
四块独立处理以后,最终输出不能因为:
奇数宽高
overlap
裁剪
多 1px 或少 1px。
原图:
4439 × 2959
最终必须:
13317 × 8877
所以 TileStitcher 的最终校验:
export function validateFinalSize(
  inputWidth: number,
  inputHeight: number,
  scale: number,
  outputWidth: number,
  outputHeight: number
): boolean {
  return (
    outputWidth ===
      inputWidth * scale &&
    outputHeight ===
      inputHeight * scale
  )
}
本轮:
actualOutput=
13317 × 8877
通过。
十二、拼接阶段不要同时保留 4 个巨大输出 PixelMap
这也是第三篇最容易重新把内存抬回去的地方。
如果:
4 tile SR 完成
→ 4 个 output PixelMap 全部放数组里
→ 最后一起拼
分块意义会被削弱。
PixelForge 当前策略:
tile SR
→ 裁出需要部分
→ 写入 stitch buffer / 文件块
→ release PixelMap
→ 下一 tile
TileResult 保存的是轻量坐标和缓存文件引用,不是大 PixelMap 本体。
这样才能把 peak 保持在 168.9MB 左右。
十三、拼接耗时 126ms 单独记录
当前:
averageTileSrCost=
356ms

stitchCost=
126ms
如果以后结果慢了,可以明确:
AI 推理变慢
还是:
拼接变慢
尤其当 tile 数量从 4 增加到 12 时,拼接成本会明显变化。
分块方案不能只看内存,不看总时延。
十四、DevEco 图要同时展示 core、overlap 和实际输出
开发图:
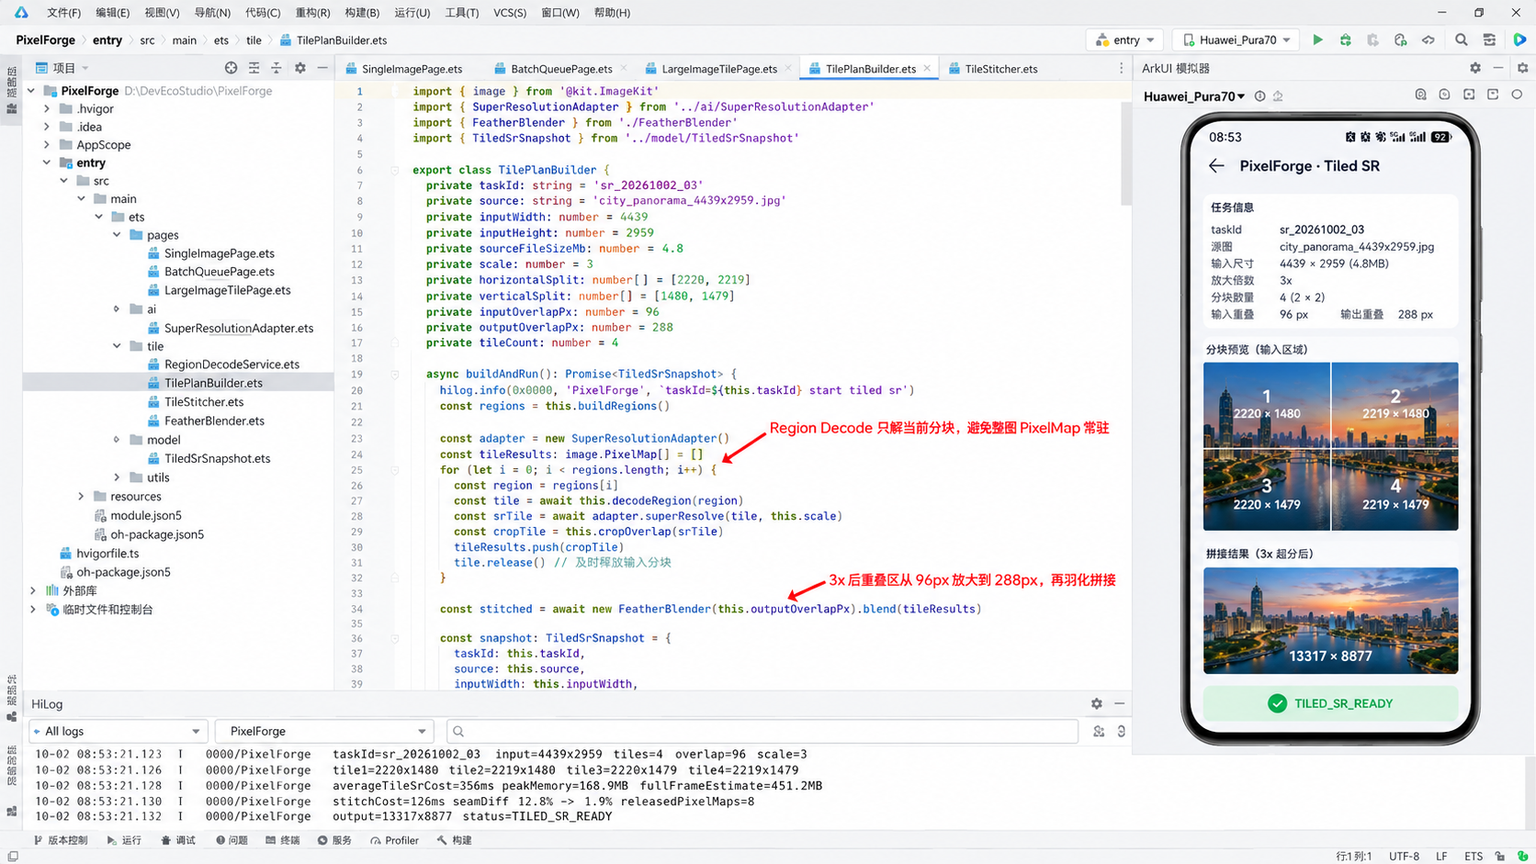
HiLog:
taskId=
sr_20261002_03

input=
4439x2959

tiles=
4

overlap=
96

scale=
3

tile1=
2220x1480

tile2=
2219x1480

tile3=
2220x1479

tile4=
2219x1479

averageTileSrCost=
356ms

peakMemory=
168.9MB

fullFrameEstimate=
451.2MB

stitchCost=
126ms

seamDiff:
12.8%
→
1.9%

releasedPixelMaps=
8

output=
13317x8877

status=
TILED_SR_READY
这比“分成 4 块”有用得多。
十五、运行图让接缝治理变成可视结果
最终运行图:
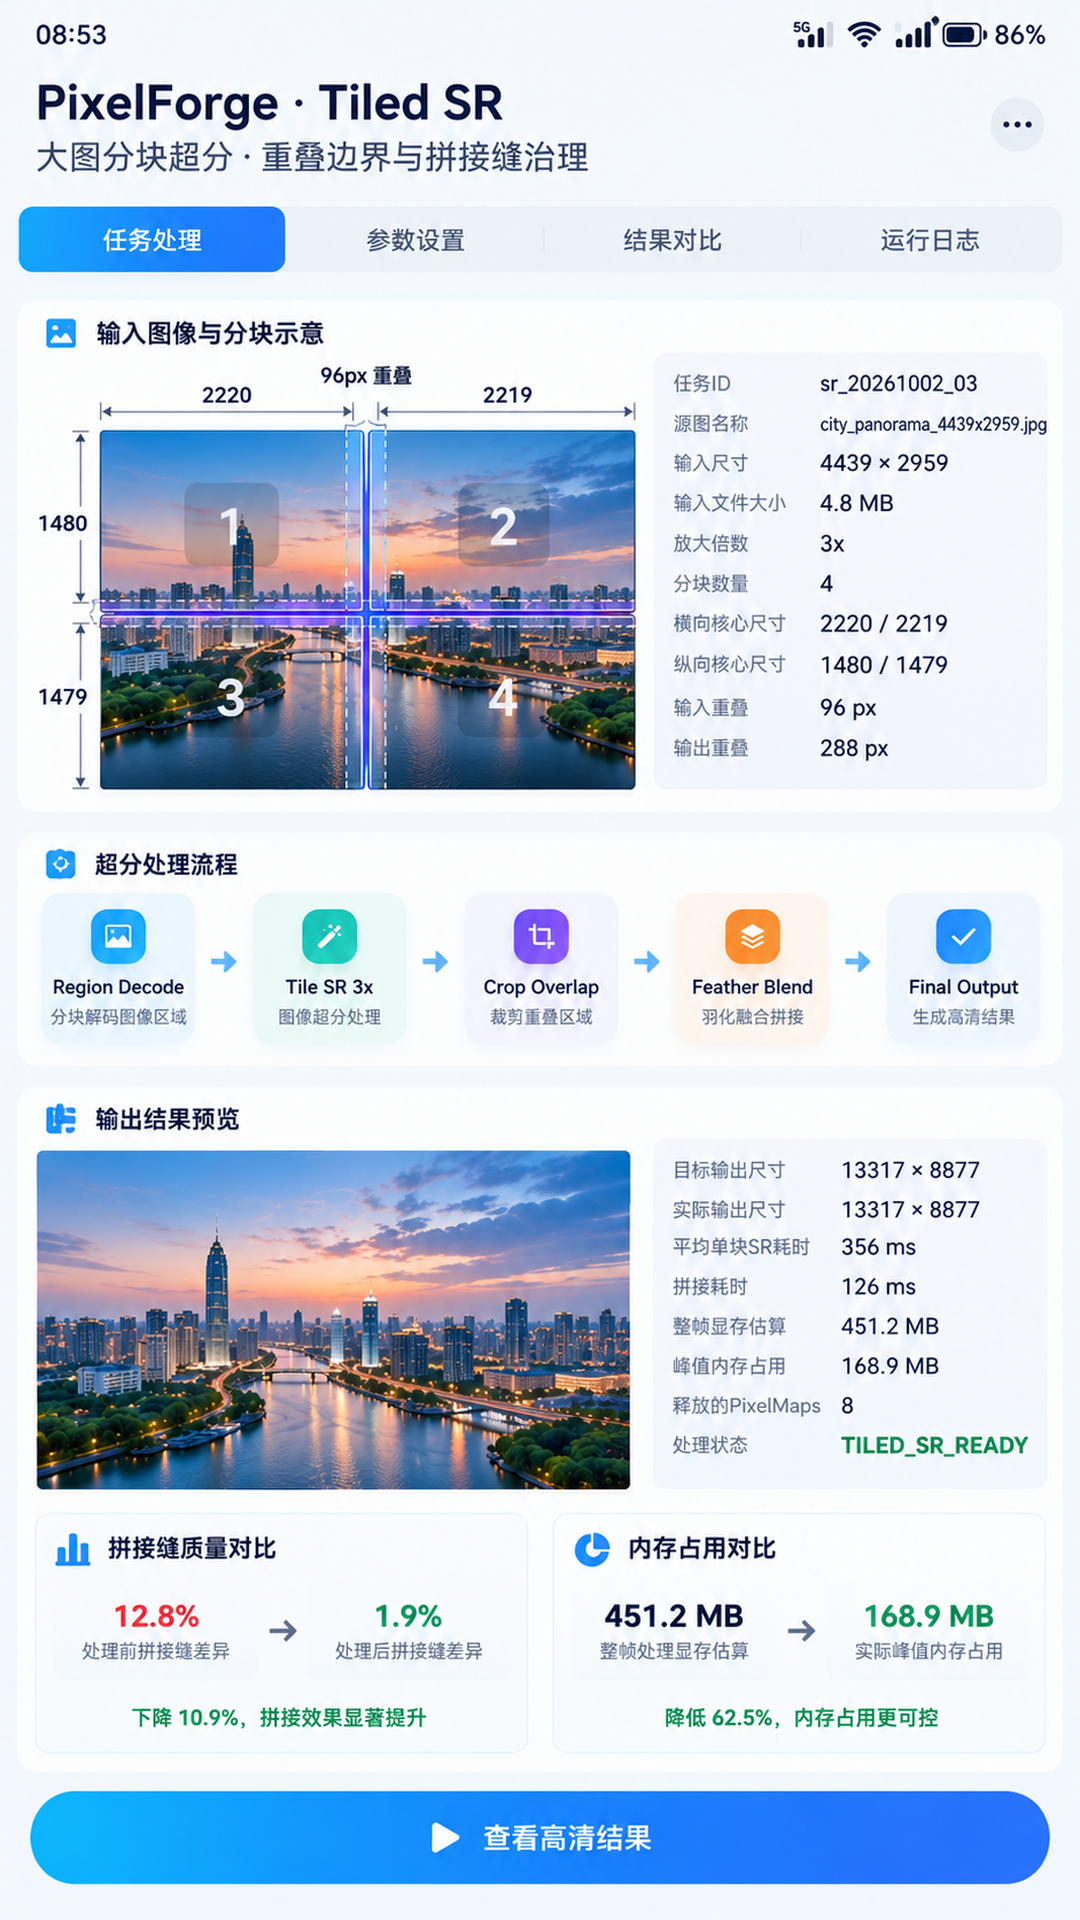
能直接看到:
4 个 core

96px 输入重叠

288px 输出重叠

3x 结果

13317 × 8877
以及:
12.8%
→
1.9%
真正表达的是:
分块以后,结果不是机械拼图,而是有明确重叠策略和接缝治理。
十六、如果 tile 中间失败,不能重跑整图
4 块里任何一块失败,PixelForge 记录:
tileId
decode region
SR state
cache path
重试只重新执行失败 tile。
已经完成的 tile 不重复跑。
这会直接成为 04 缓存设计的基础:
完整图可缓存
分块结果也可缓存
十七、Region Decode 本身也需要边界 clamp
靠近原图边缘时:
core + overlap
可能超出源图。
所以 Tile Plan Builder 必须做:
x >= 0
y >= 0
right <= sourceWidth
bottom <= sourceHeight
本轮四个 decodeRegion 都经过 clamp。
右侧 tile 实际宽度:
2315
而不是强行写成和左边一样的 2316。
这就是奇数尺寸必须认真算的地方。
十八、TILED_SR_READY 的验收条件
最终状态至少代表:
4 个 tile 全部完成

每 tile input/output PixelMap 都释放

最终宽高正确

输入 overlap=96px

输出 overlap=288px

拼接耗时可观察

接缝差异从 12.8% 降到 1.9%

实际峰值明显低于整帧估算

失败 tile 可单独重试
这些全部成立以后,第三篇才算真正完成。
十九、下一篇:算力省下来以后,别每次都重新算
03 的大图已经能跑稳。
接下来最浪费的事情反而变成:
同一张图
同一倍率
同一模型版本
每次打开都重新超分
04 会给 PixelForge 加本地结果缓存。
但缓存不能只用文件名。
同名文件被重新编辑,或者模型版本升级以后,旧结果必须自动失效。
下一篇会围绕:
sourceHash
scale
modelRevision
cacheKey
MISS / HIT / INVALIDATE
继续推进。
二十、分块方案还要保存 Tile Manifest,不能只靠内存数组
第三篇跑通以后,我又补了一层很实际的东西:TileManifest。
原因是大图处理时间明显比单图长,中途如果应用发生异常,只靠内存里的 tiles[] 很难知道已经完成到哪里。
Manifest 至少记录:
taskId
sourceHash
scale
tileCount

每个 tile 的 core
decodeRegion
resultPath
status
srCost
当前 4 个 tile 都是:
DONE
如果第 3 块失败,下一次重试只需要重新跑:
tile_03
而不是重新超分 1、2、4。
这和 04 的缓存设计也能直接衔接:tile 结果本身可以成为可复用的中间产物。
二十一、拼接缓冲区也不能无限大
即使不保留 4 个输出 PixelMap,最终生成 13317×8877 大图时仍然需要一个结果容器。
如果一次性创建完整 RGBA 拼接缓冲:
13317 × 8877 × 4
依然很重。
所以 PixelForge 当前把 Stitcher 设计成“条带写入”:
上半区
→ 处理 / 写入

下半区
→ 处理 / 写入
或直接面向目标文件做分区写入。
这篇手机图里为了方便理解,展示的是完整结果预览;真实实现不会为了“拼接方便”再次把所有中间结果同时堆回内存。
分块优化如果只优化 AI 阶段、不优化 stitch 阶段,很容易把省下来的内存又在最后一步用掉。
二十二、羽化只处理亮度差还不够,后面还要关注结构连续性
当前 1.9% 指标主要反映像素差异。
但城市全景里更敏感的是:
桥梁直线
楼体边缘
栏杆
文字
窗格
如果两块 SR 在边缘生成的结构稍有偏移,即使平均 RGB 差值不大,人眼仍然能看出断线。
所以 PixelForge 给后续质量回归预留:
edge continuity
line continuity
local sharpness
这些指标不会在 03 一次全部做完。
当前先把“接缝明显偏色 / 偏亮”解决,再把结构问题留到 06 的多图回归。
二十三、Tile 顺序也会影响峰值和首屏反馈
4 块可以:
1 → 2 → 3 → 4
顺序执行。
也可以优先处理当前用户正在查看的区域。
如果用户放大浏览图像左上角,PixelForge 可以优先:
tile_01
先生成局部高清结果,再后台完成其余 tile。
第三篇还没有做这种调度,但 Tile Manifest 已经有独立 tile 状态,因此后面不需要修改核心数据结构。
这也是分块设计除了“降内存”以外的另一个价值:处理单位更小以后,调度策略会更灵活。
二十四、分块失败时必须把临时文件和 PixelMap 两边都清理
某个 tile 在 SR 成功后、写入临时结果时失败,可能留下:
tile_02.tmp
如果下一轮直接读取这个文件,很容易把半成品当完成结果。
所以 tile 的最终状态只在:
临时文件完整写入
→ rename final
→ Manifest 标记 DONE
以后成立。
失败路径:
PixelMap release
临时文件删除
Manifest = FAILED
大图任务的可靠性最终仍然回到“资源和状态一起收口”,而不是只看 AI 调用有没有返回。
二十五、为什么 03 不追求把 4 块并行处理
02 已经证明并发 3 会把内存推到 287.9MB。
03 每块又比 02 的最大输入更大。
所以当前仍然坚持:
tile concurrency=1
先得到:
168.9MB
稳定峰值。
后面如果高内存设备要做 tile concurrency=2,必须在 06 的设备基线里单独验证。
我更愿意先牺牲一点总耗时,也不愿意让“大图支持”变成一条不可预测的 OOM 风险。
二十六、第三篇最终留下的是一套可以重试、可以观测的大图协议
到这里,大图处理已经从“切四张图拼一下”变成:
Tile Plan
→ Region Decode
→ Tile SR
→ Overlap Crop
→ Feather Blend
→ Manifest
→ Final Size Check
→ Resource Cleanup
每个步骤都有明确输入、状态和证据。
以后输入从 4439×2959 换成更大尺寸,只需要重新规划 tile 数量和 overlap,不需要把整个 PixelForge 的任务生命周期重做一遍。
二十七、最终还要把 TilePlan 写进结果元数据
最终输出文件不能只保存一张大图。
PixelForge 会同时写一份轻量 sidecar:
sourceSize
scale
tileCount
overlap
tilePlanRevision
seamDiff
generatedAt
以后用户反馈“这张大图中间有一道缝”,开发者可以直接知道它来自哪一版分块策略,而不是只拿到一张已经拼好的 JPEG 猜原因。
这种结果元数据在算法持续迭代时很有价值:图片是结果,TilePlan 则是结果能够被复现的证据。
参考资料
- Core Vision Kit API 26 图像超分 API 变更:
https://developer.huawei.com/consumer/en/doc/harmonyos-releases/js-apidiff-corevisionkit-7001 - Image Kit 区域解码选项:
https://developer.huawei.com/consumer/cn/doc/harmonyos-references-v5/_ohos_image_decoding_ops-V5 - Image Kit PixelMap 图像变换:
https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/image-transformation

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)