
HarmonyOS 7 PixelForge 图像超分工程实录 02:Image Kit × Image Super-Resolution:批量队列、PixelMap 生命周期与内存峰值【鸿蒙心迹】
01 把单图链路跑稳以后,我直接把相册里的 6 张图一次选进 PixelForge。
第一版写得很“自然”:
for each image
→ Promise
→ 同时 decode
→ 同时 super resolution
→ 同时 encode
功能确实跑起来了。
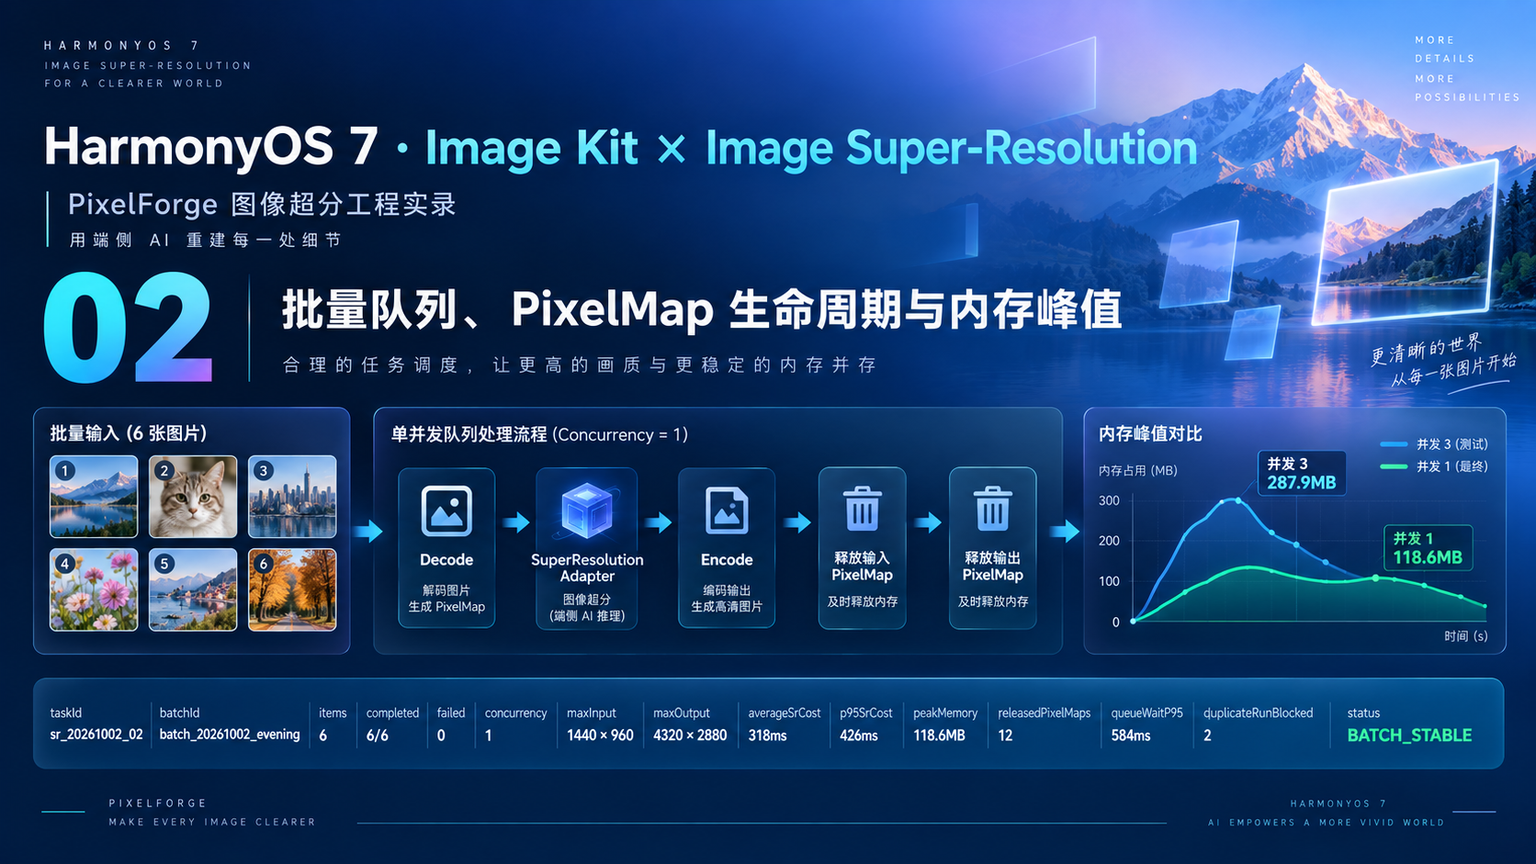
真正的问题出现在第 3 张输出 PixelMap 创建以后:内存峰值快速抬到 287.9MB,界面开始明显变慢,几次压力测试里还出现了任务完成后 PixelMap 没及时回收的情况。
这和 Image Kit 当前官方“常见崩溃报错问题”里提醒的风险其实是同一类:不要对同一个 ImageSource 并发执行多个异步操作,异步编码结束之前也不能提前释放 PixelMap;一旦生命周期和并发叠在一起,资源竞态和峰值内存很容易同时出现。
所以 02 不再追求“同时跑得更多”,而是把批量任务变成一条可控队列。
本轮统一数据:
taskId:
sr_20261002_02

batchId:
batch_20261002_evening

items:
6

completed:
6 / 6

failed:
0

finalConcurrency:
1

stressConcurrency:
3

stressPeakMemory:
287.9MB

maxInput:
1440 × 960

maxOutput:
4320 × 2880

averageSrCost:
318ms

p95SrCost:
426ms

peakMemory:
118.6MB

releasedPixelMaps:
12

queueWaitP95:
584ms

duplicateRunBlocked:
2

status:
BATCH_STABLE
一、批量任务先把“并发越多越快”的直觉拿掉
图像超分不是普通字符串处理。
每张图片至少会经历:
ImageSource
PixelMap input
AI intermediate buffers
PixelMap output
ImagePacker
输入图最大:
1440 × 960
3x 输出:
4320 × 2880
光输出 RGBA PixelMap 理论像素数据就接近:
4320 × 2880 × 4
≈ 47.5MB
并发 3 时,光三份输出 PixelMap 就已经超过 140MB。
再加中间资源,287.9MB 并不奇怪。
所以第二篇第一个改动不是换更复杂的并发框架,而是先限制:
finalConcurrency=1
二、每一张图必须有完整的“创建 → 使用 → 释放”闭环
第一篇已经有 finally。
批量以后,这个 finally 不能放在整个 Batch 最后。
否则:
第 1 张处理完
input/output 还留着

第 2 张处理完
继续留着

...
第 6 张结束
一起释放
峰值仍然很高。
正确方式是:
每张图完成
立即释放自己的 PixelMap
第一段代码就是批量单项 Runner:
import { image } from '@kit.ImageKit'

export class BatchItemRunner {
  async run(
    item:
      BatchImageItem
  ): Promise<BatchItemResult> {
    let input:
      image.PixelMap |
      null = null

    let output:
      image.PixelMap |
      null = null

    const startedAt =
      Date.now()

    try {
      input =
        await this.decoder
          .decode(item.path)

      const srResult =
        await this.adapter
          .process(
            input,
            { scale: 3 }
          )

      output =
        srResult.pixelMap

      await this.encoder
        .save(
          output,
          item.outputPath
        )

      return {
        id:
          item.id,
        success:
          true,
        costMs:
          Date.now() -
          startedAt
      }
    } catch (error) {
      return {
        id:
          item.id,
        success:
          false,
        costMs:
          Date.now() -
          startedAt
      }
    } finally {
      output?.release()
      input?.release()

      this.metrics
        .recordPixelMapRelease(2)
    }
  }
}
本轮 6 张图:
input 6
output 6
最终:
releasedPixelMaps=12
三、ImageSource 也不能在一个实例里被并发复用
Image Kit 当前官方文档专门列出:
不要对同一个 ImageSource 实例并发执行多个异步操作;如果确实要并发处理,应创建独立 ImageSource 实例。
PixelForge 批量队列进一步规定:
一个 BatchItem
对应一个 ImageSource

ImageSource 不跨 item 共享
这比做一个“全局 decoder cache”更安全。
每张图的 decode() 内部自己:
createImageSource
createPixelMap
release ImageSource
完成后不把 ImageSource 挂在成员变量里。
四、Queue 本身只管理状态,不持有 PixelMap
第二段代码解决一个很隐蔽的问题:队列不要为了方便,把 PixelMap 放进 item 里。
BatchItem 只保留轻量数据:
export interface BatchImageItem {
  id: string

  path: string
  outputPath: string

  requestedScale: number
}

export class SrBatchQueue {
  private items:
    BatchImageItem[] = []

  private running:
    boolean = false

  private concurrency:
    number = 1

  async start(): Promise<void> {
    if (this.running) {
      this.metrics
        .duplicateRunBlocked++

      return
    }

    this.running = true

    try {
      for (
        const item
        of this.items
      ) {
        await this.runner
          .run(item)
      }
    } finally {
      this.running = false
    }
  }
}
队列里没有:
inputPixelMap
outputPixelMap
ImageSource
ImagePacker
它只关心:
路径
状态
结果
资源全部在 item runner 内部出生和销毁。
五、为什么最终没有用 Promise.all
Promise.all 当然可以写得很短:
await Promise.all(
  items.map(run)
)
但这一篇的目标不是“代码短”,而是控制资源。
官方 Image Kit 文档已经明确提醒多异步图像操作的资源生命周期风险。
所以当前 6 张图选择串行:
concurrency=1
这并不意味着以后永远不能并行。
等 06 有真实内存和设备矩阵后,可以考虑:
高内存设备 concurrency=2

普通设备 concurrency=1
但不能在没有基线前先把并发开满。
六、压力测试为什么还保留并发 3 的 287.9MB
我没有把失败实验删掉。
压力测试数据:
concurrency=3

peakMemory=
287.9MB
最终策略:
concurrency=1

peakMemory=
118.6MB
两组数据同时保留,才能解释:
为什么队列要收窄。
否则别人看到 concurrency=1 很容易觉得只是“实现保守”。
工程取舍最好有证据。
七、118.6MB 仍然比单图 54.6MB 高,为什么
单图 01:
54.6MB
批量单并发 02:
118.6MB
不是矛盾。
批量页面还持有:
6 张缩略图
任务列表
结果信息
输出路径缓存
队列 Metrics
编码临时资源
并且最大输入已经从:
960×640
变成:
1440×960
所以批量峰值更高很正常。
我们真正关心的是:
随着处理张数增加
峰值是否不断阶梯上涨
本轮没有。
八、重复点“开始批处理”也必须幂等
用户在批量处理中连续点两次开始按钮,第一版会创建两条队列。
结果是同一批 6 张图重复执行。
所以 start() 先检查:
running
本轮专门快速点击三次。
第一次正常开始。
后两次:
duplicateRunBlocked=2
不会新建第二个 Batch。
这和之前其他长任务项目一样:重复触发必须被挡在创建资源之前。
九、队列等待时间也要记录
串行能降内存,但代价是后面的图片要等。
本轮:
queueWaitP95=
584ms
这个值是 6 张图当前测试集的等待基线。
如果以后扩到 50 张图,等待时间会明显增长。
这时需要考虑:
分页执行
分组批次
优先级
可取消
并发 2 的设备策略
而不是盲目把 concurrency 从 1 改回 6。
十、第三段代码给队列加取消边界
用户在第 4 张时点击取消,不能把正在编码的 PixelMap 直接 release。
因为官方文档已经提醒:
packToFile
还没 await 完
不能提前 release
所以取消只影响:
下一项是否继续
export class SrBatchQueue {
  private cancelRequested:
    boolean = false

  requestCancel(): void {
    this.cancelRequested =
      true
  }

  async runAll(
    items:
      BatchImageItem[]
  ): Promise<void> {
    this.cancelRequested =
      false

    for (
      const item
      of items
    ) {
      if (
        this.cancelRequested
      ) {
        break
      }

      await this.runner
        .run(item)
    }
  }
}
当前项继续完整走完:
decode
sr
encode
finally release
再停止队列。
这样取消不会制造资源竞态。
十一、平均 318ms 和 P95 426ms 怎么理解
6 张图的单图超分耗时不同。
本轮:
averageSrCost=
318ms

p95SrCost=
426ms
平均值说明总体速度。
P95 更能看出:
尺寸更大
内容更复杂
设备瞬时负载
造成的慢项。
最终验收不会只看平均值。
06 会把:
avg
P95
max
都纳入。
十二、任务失败时不能中断整个 Batch
这一篇当前:
failed=0
但 Runner 已经按单项隔离。
某一张失败:
FAILED
记录错误。
队列继续下一张。
除非错误属于:
能力不可用
设备资源异常
全局 Adapter 失效
才终止 Batch。
这比 Promise.all 任一 reject 后整组抛错更适合用户批量处理场景。
十三、DevEco 图里重点看“每张 finally 释放”和压力测试对比
开发图:
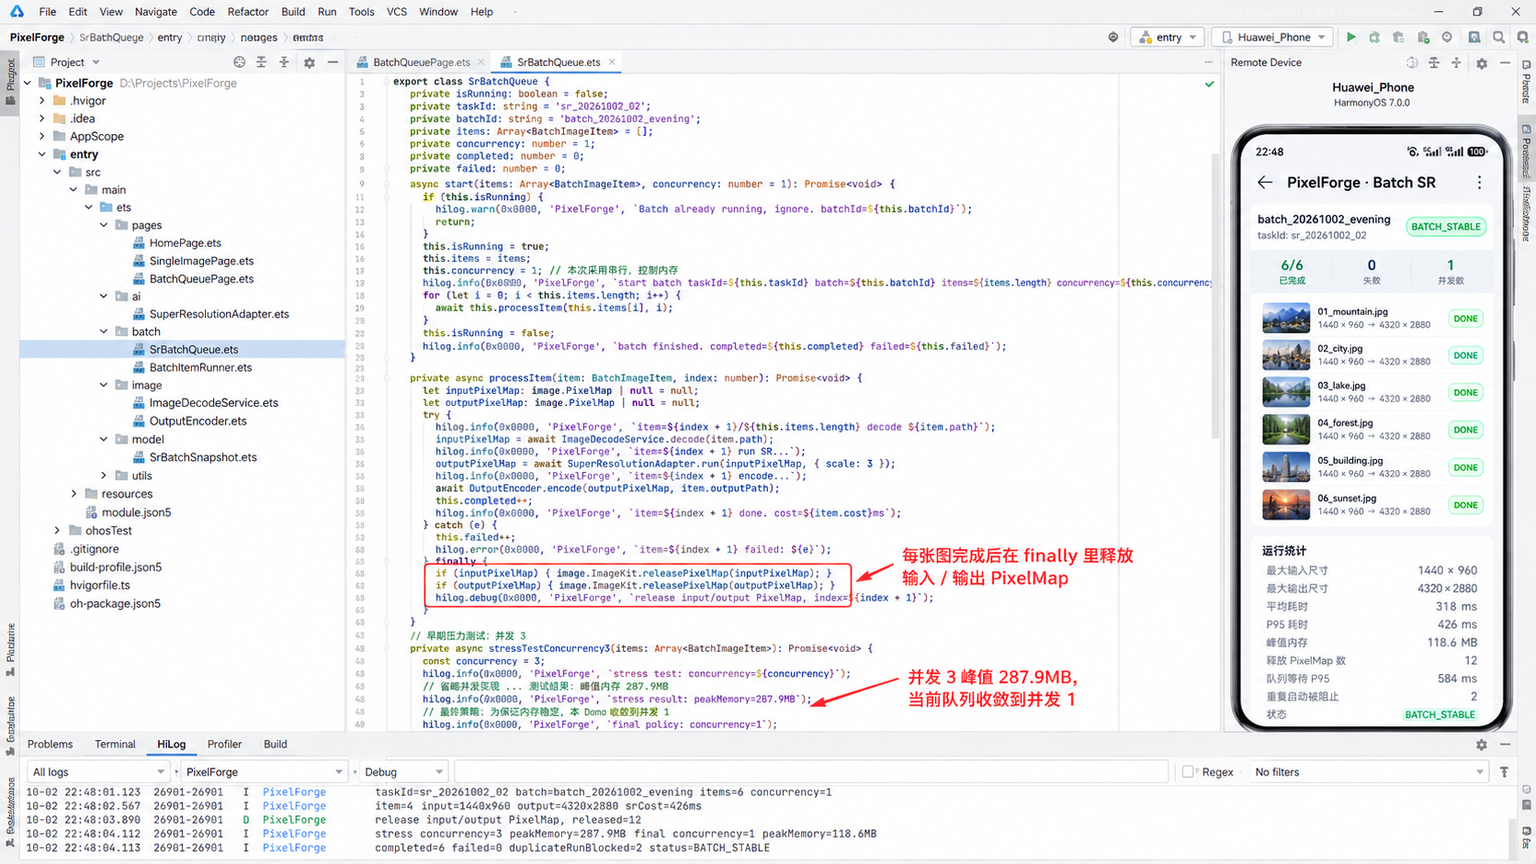
统一日志:
taskId=
sr_20261002_02

batch=
batch_20261002_evening

items=
6

concurrency=
1

item 4:
1440x960
→
4320x2880

srCost=
426ms

release input/output PixelMap

released=
12

stress concurrency=
3

stress peakMemory=
287.9MB

final concurrency=
1

peakMemory=
118.6MB

completed=
6

failed=
0

duplicateRunBlocked=
2

status=
BATCH_STABLE
一条日志就能解释整个工程取舍。
十四、运行图让批量结果和资源指标同时可见
最终运行图:
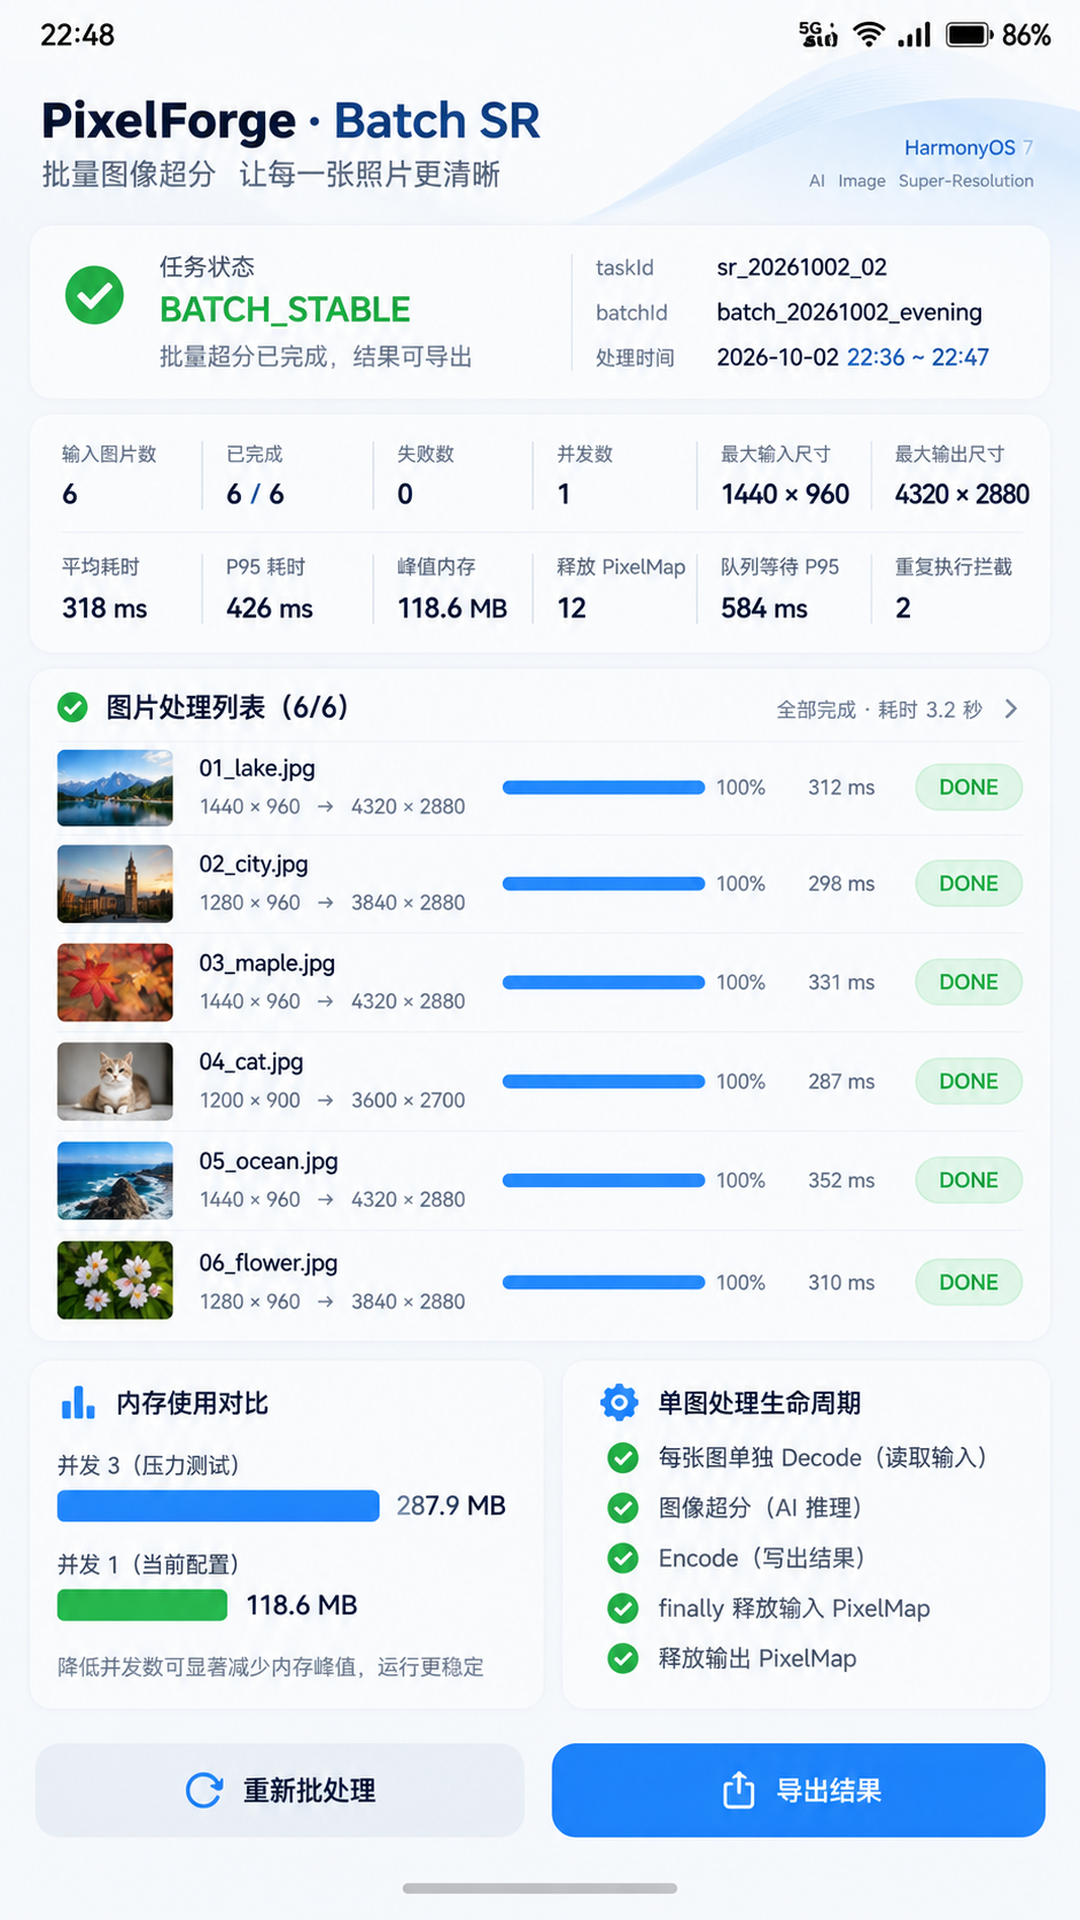
顶部:
6 / 6
failed 0
concurrency 1
列表里每张图:
输入尺寸
输出尺寸
单图耗时
DONE
底部对比:
并发 3
287.9MB

并发 1
118.6MB
再加:
released PixelMap=12
最终:
BATCH_STABLE
这张图证明的不是“6 张都处理完”。
而是:
6 张都处理完以后,资源生命周期和内存仍然可解释。
十五、为什么这篇没有把 TaskPool 当主角
ArkTS 当前确实提供 TaskPool 和 Worker 两类并发能力。
但这一篇真正的瓶颈不是:
主线程 CPU 算不过来
而是:
图像资源同时存活太多
如果只为了“用了 TaskPool”把 AI 调用和 PixelMap 随意丢到多个并发任务里,反而可能把资源问题放大。
所以当前先用业务队列控制并发。
后面如果需要把:
摘要计算
文件扫描
结果统计
放进 TaskPool,可以单独做。
系统 AI 能力调用仍然通过 Adapter 保持边界清楚。
十六、Image Kit 官方崩溃指南为什么和这一篇高度相关
当前官方文档给出的两个典型错误,和 PixelForge 批量场景几乎一一对应:
异步编码未完成
PixelMap 提前 release

多个异步操作
共享同一个 ImageSource
解决建议也是:
await 异步操作完成
再释放资源

不要并发访问同一个 ImageSource
所以这一篇很多“看起来保守”的写法,其实是在主动避开官方已经明确列出的资源竞态。
十七、批量结果不能把 PixelMap 留在页面里做缓存
处理完成以后,页面列表需要缩略图。
最容易偷懒的写法是:
output PixelMap
直接存进 @State 数组
这样 6 张 3x 结果会一直留在内存。
PixelForge 当前做:
超分完成
→ 编码到文件
→ 生成轻量缩略图
→ 页面只保存结果 URI
→ release output PixelMap
UI 看到的是文件结果,不是 AI 输出的大 PixelMap 本体。
这是本轮能把峰值压下来的关键之一。
十八、下一篇会把“单张最大 1440×960”升级到真正的大图
02 最终最大输入:
1440×960
还不算真正的大图。
第三篇会把输入提升到:
4439×2959
这类尺寸继续整图超分,输出和内存都会明显上升。
下一步真正的问题会变成:
怎么分块
块之间怎么留 overlap
最后怎么拼回去
怎么避免接缝
这就是 03 的主线。
十九、BATCH_STABLE 的验收条件
最终至少满足:
6/6 完成

失败数 0

重复启动被拦截

每张 input/output PixelMap 都释放

活动 ImageSource 不共享

编码结束后再 release

最终并发为 1

峰值从 287.9MB 降到 118.6MB

批量结束后内存不持续阶梯上涨
这些全部成立以后,BATCH_STABLE 才不是一句状态文案,而是一份真正可解释的工程结果。
二十、批量内存治理还要先做一份“理论预算”
真正决定并发数以前,PixelForge 会先估算一个最粗的像素内存预算。
例如最大输入:
1440 × 960 × 4
≈ 5.3MB
3x 输出:
4320 × 2880 × 4
≈ 47.5MB
只看输入输出,一张图就已经超过 52MB。
如果并发 3:
52MB × 3
≈ 156MB
这还没包含:
AI 中间缓冲
编码缓存
UI 缩略图
ArkTS 对象
系统图像框架开销
所以实测 287.9MB 并不意外。
理论预算不能替代实测,但它能在“还没跑”之前告诉开发者:
这个并发数可能从一开始就不合理。
二十一、缩略图必须是缩略图,不能偷偷复用 3x 输出
Batch 页面看起来只展示六张小图。
如果每个列表项背后仍然绑着:
4320 × 2880 PixelMap
UI 再小也没有意义。
当前结果页策略:
超分大图
→ 编码到文件
→ release 大 PixelMap
→ 单独生成 320px 左右预览
→ 列表只保存 preview URI
大图在用户真正点击查看时再解码。
这种“按展示尺寸加载”的思路和超分本身并不冲突。
恰恰相反,越是能生成高清结果,越需要避免列表页面把高清资源全部同时留在内存里。
二十二、队列重试必须针对单项,不能整批重跑
如果第 5 张失败,用户点击重试以后,不能把已经完成的前 4 张和第 6 张全部重新执行。
每个 BatchItem 都有自己的终态:
WAITING
RUNNING
DONE
FAILED
CANCELLED
重试只把:
FAILED
→ WAITING
重新入队。
完成项保留结果 URI。
这不仅省算力,也能避免重复覆盖已经确认过的输出文件。
批量系统真正稳定以后,用户应该能把它理解成“六个独立任务组成一个 Batch”,而不是“一次大 Promise”。
二十三、错误分类决定队列该继续还是停止
PixelForge 把错误粗分成三类:
ITEM_ERROR
单张文件损坏
→ 记录失败,继续下一张

CAPABILITY_ERROR
设备不支持 / Adapter 全局异常
→ 停止整个 Batch

RESOURCE_ERROR
内存压力 / 资源创建失败
→ 停止并提示降低并发或输入规格
如果所有异常都简单:
catch
→ continue
可能会在能力已经失效时继续重复失败六次。
反过来,如果任何一张 JPEG 损坏都直接终止整个 Batch,又太脆弱。
错误分类是批量任务从 Demo 走向工具必须补上的一层。
二十四、并发 1 不代表 UI 被“锁死”
批量是串行的,但 UI 不应该卡住。
页面状态只订阅:
BatchSnapshot
每张图状态变化后刷新:
1/6
2/6
...
6/6
单项真正的耗时处理仍然是异步链。
只要不在 ArkUI build 里做同步大计算,concurrency=1 和“主线程被阻塞”不是同一个概念。
这个区别很重要。
很多时候团队看到串行就本能想改成并发,但这里串行只是业务资源策略。
二十五、BatchSnapshot 也要限制更新频率
6 张图问题不大,未来 100 张时:
decode 进度
AI 进度
encode 进度
资源指标
如果每一个小状态都触发页面重绘,UI 自己会成为新的开销。
当前 Snapshot 只在关键节点更新:
ITEM_START
SR_DONE
ITEM_DONE
ITEM_FAILED
BATCH_DONE
高频内部日志仍然写 HiLog,但不全部映射到 @State。
这是批量场景另一个经常被忽略的“资源治理”:不仅是内存,还有 UI 更新成本。
二十六、队列结束后要做一次活动资源对账
releasedPixelMaps=12 只是计数。
最终还会检查:
activeImageSource=0
activeInputPixelMap=0
activeOutputPixelMap=0
activePacker=0
queueRunning=false
如果 releaseCount 是 12,但 activeOutputPixelMap 仍然 1,说明计数本身有漏洞。
所以 06 最终验收会采用:
释放计数
+
活动资源快照
两个口径交叉验证。
二十七、118.6MB 是当前设备基线,不是下一台设备的目标值
不同设备:
屏幕
系统版本
AI 能力实现
图像框架
后台进程
都会影响峰值。
因此这篇不把:
118.6MB
写成“合理标准”。
它只是说明:
同一个 PixelForge 测试集
同一台设备
同一版本
并发 1
相对并发 3 的 287.9MB 明显更稳定。
工程结论是“控制并发有效”,不是“所有设备都应该低于 120MB”。
二十八、BATCH_STABLE 之后,才有资格挑战 4439×2959
批量任务现在已经具备:
单项隔离
安全 release
重复启动保护
取消边界
失败分类
资源对账
所以下一篇即使遇到超大 PixelMap,也不会再把“资源泄漏”和“大图本身太重”混在一起。
03 会把问题收窄到真正的大图算法工程:
切成多块
每块带 overlap
分块超分
裁掉重叠边
重新拼接
检查接缝
这是 PixelForge 从“任务调度”进入“图像几何处理”的下一步。
参考资料
- HarmonyOS 7(API 26) 图像超分开发者实践合集:
https://developer.huawei.com/consumer/cn/forum/topic/0204224159448225375 - Image Kit 常见崩溃报错问题:
https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/image-common-mistakes - ArkTS 并发能力概览:
https://developer.huawei.com/consumer/cn/arkts

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)