
HarmonyOS 7 + Hvigor-Node.js:HAP 产物中的调试资源与大文件回归门禁【鸿蒙心迹】
应用包突然变大,开发阶段常见的解释是“最近资源多了一点”。等到发布前再手工翻目录,往往只能看到源码侧文件,却无法回答最终 HAP 里到底装进了什么。尤其是 rawfile:它允许保留原始文件形态,适合模型、媒体和配置,也最容易把采样包、调试日志与临时数据原样带进产物。
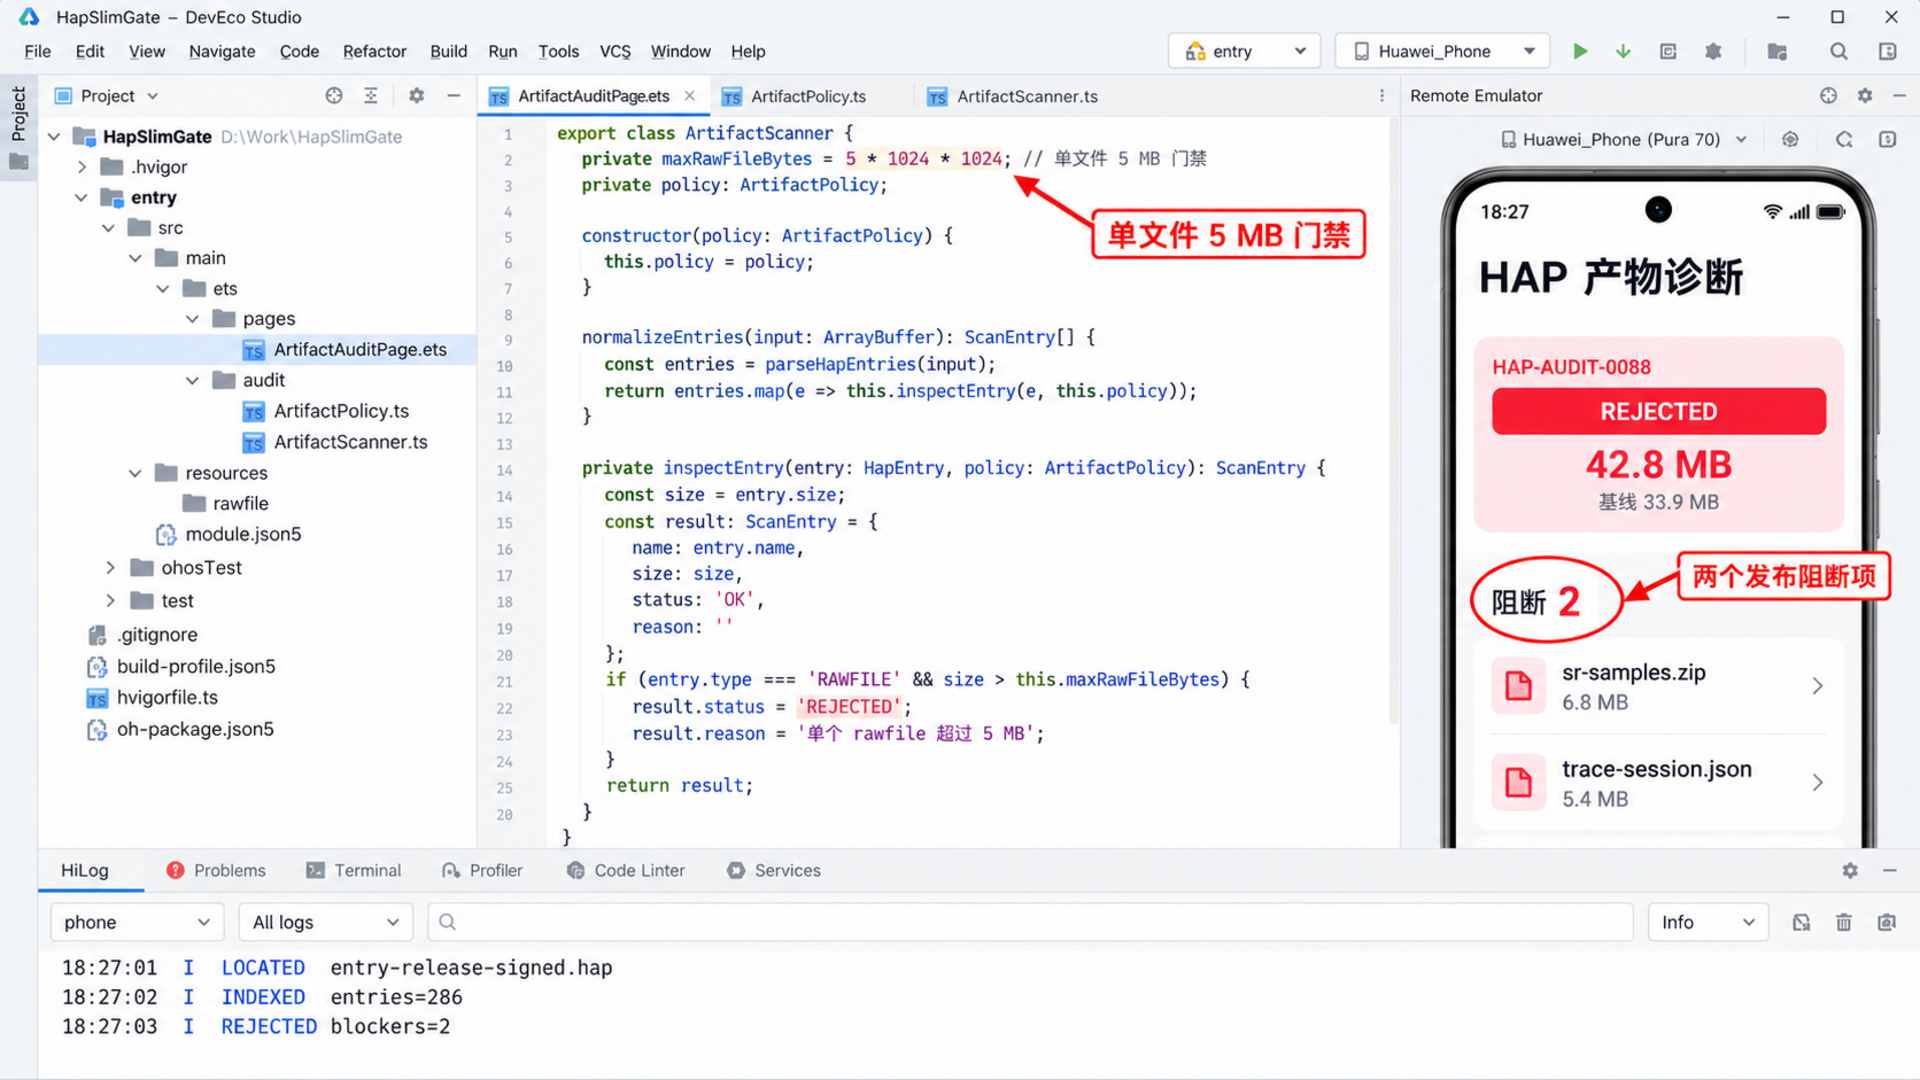
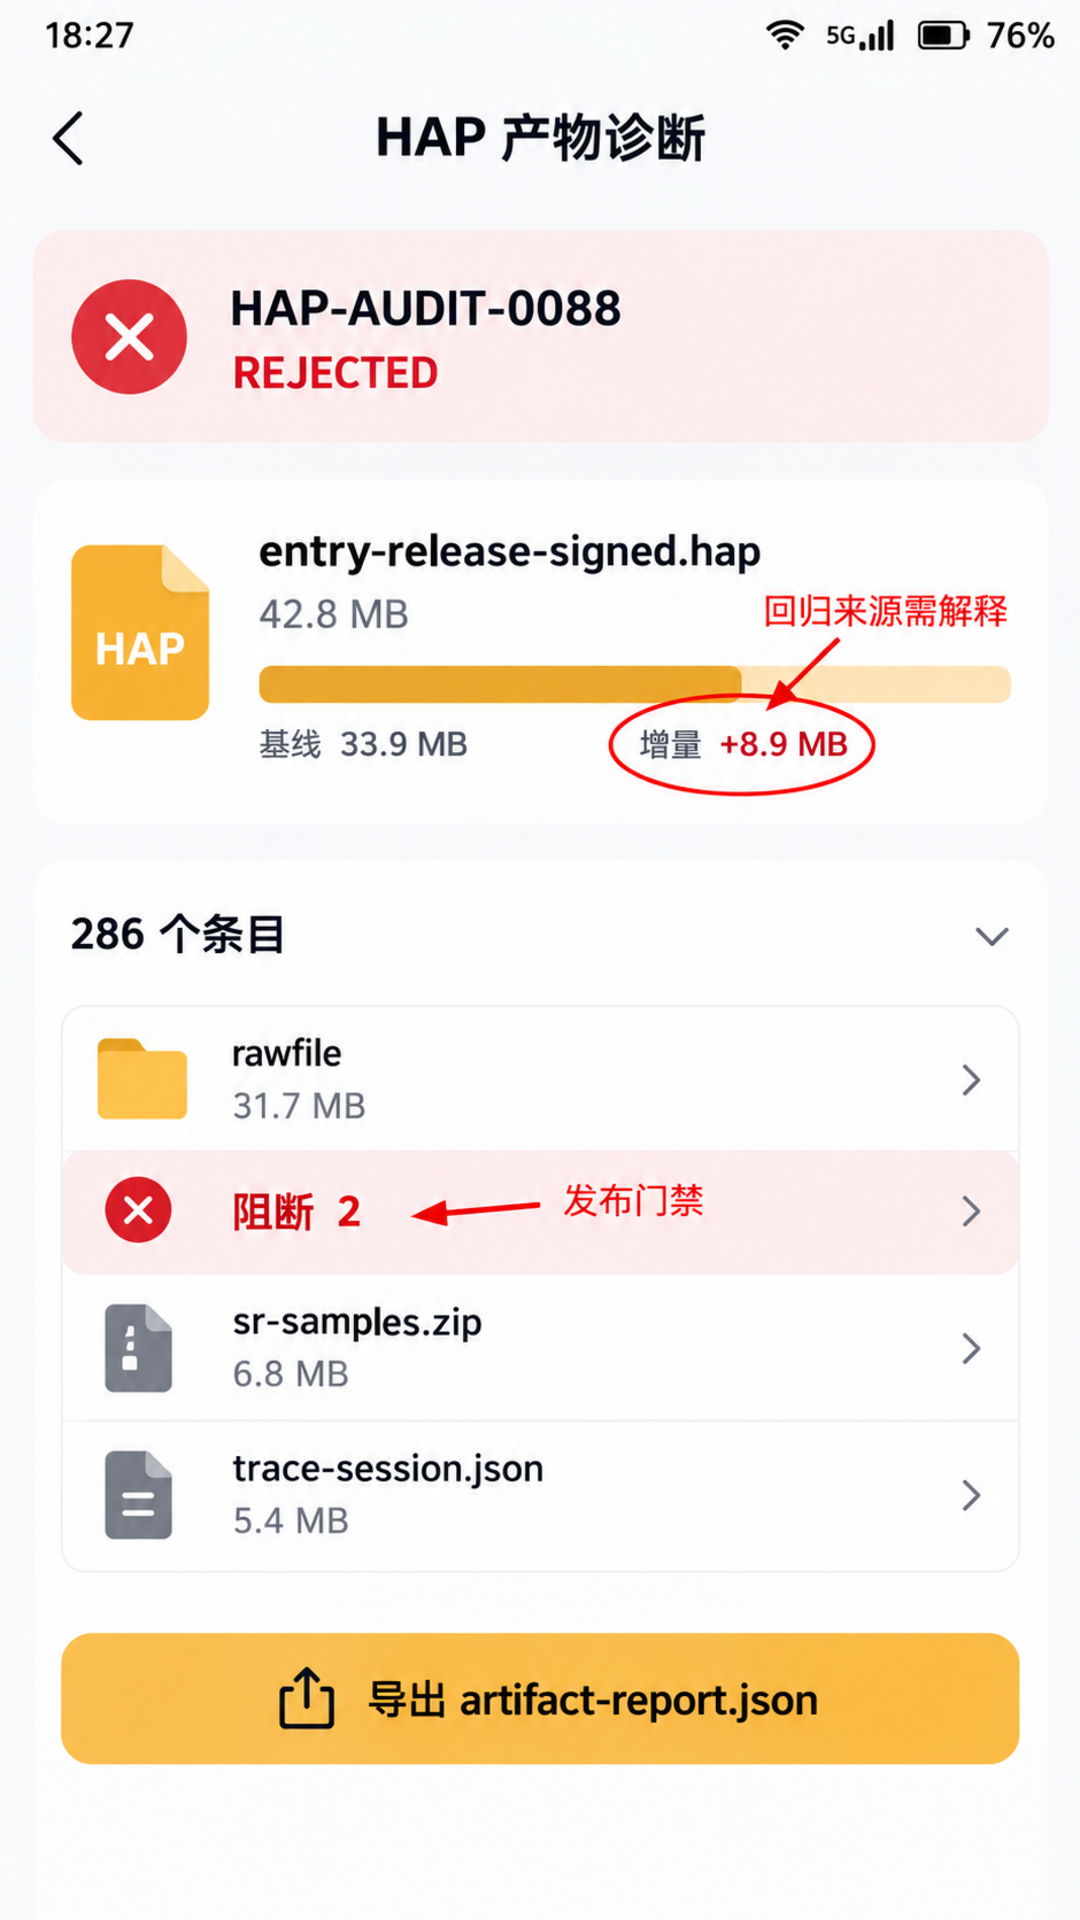
本文设计一个 HapSlimGate 检查器,从产物而不是源码反推问题。配套页面是 ArtifactAuditPage,任务 ID 为 HAP-AUDIT-0088。演示 HAP 名称固定为 entry-release-signed.hap,大小 42.8 MB,基线 33.9 MB,回归增量 8.9 MB;归档中有 286 个条目,rawfile 合计 31.7 MB。门禁识别 2 个阻断项,最终状态是 REJECTED。这些数值用于说明规则,并非真实应用市场审核结果。
一、先看发布产物,不要只看工程目录
源码目录干净,不代表产物干净。构建过程会汇入模块资源、三方库、生成代码和经过处理的配置;反过来,某些被误放到 resources/rawfile 的文件不会经过资源编译,而是按原始形态打进 HAP。华为官方资源分类文档明确说明,rawfile 文件不会进入 resources.index,引用时按路径和文件名访问。
这意味着 rawfile 很适合存放无法编译成普通资源的内容,但也意味着压缩包、采样数据、临时数据库等文件不会因为“没有代码引用”就自动消失。检查器必须落在构建完成之后,读取真实 HAP 条目。如果只扫描 entry/src/main/resources/rawfile,多模块合并、构建变体和生成任务都可能造成盲区。
官方应用包术语文档把 HAP 定义为安装和运行的基本单元,内容由代码、资源、三方库和配置组成;发布上架时则由所有 HAP、HSP 和 pack.info 组成 App Pack。本文选择先对单个 HAP 做诊断,是为了把问题收敛到模块产物。多 HAP 应用还需要在 App Pack 层面汇总,不能把一个 entry HAP 的结论外推成整个应用结论。
二、检查器从一份预算契约开始
“包太大”不是可执行规则。HapSlimGate 使用三层预算:HAP 总大小不超过 45 MB;单个 rawfile 默认不超过 5 MB;允许的大文件必须出现在精确白名单里,并同时匹配路径、大小上限和 SHA-256。这样模型文件可以被明确接受,调试压缩包却不能靠改后缀混过去。
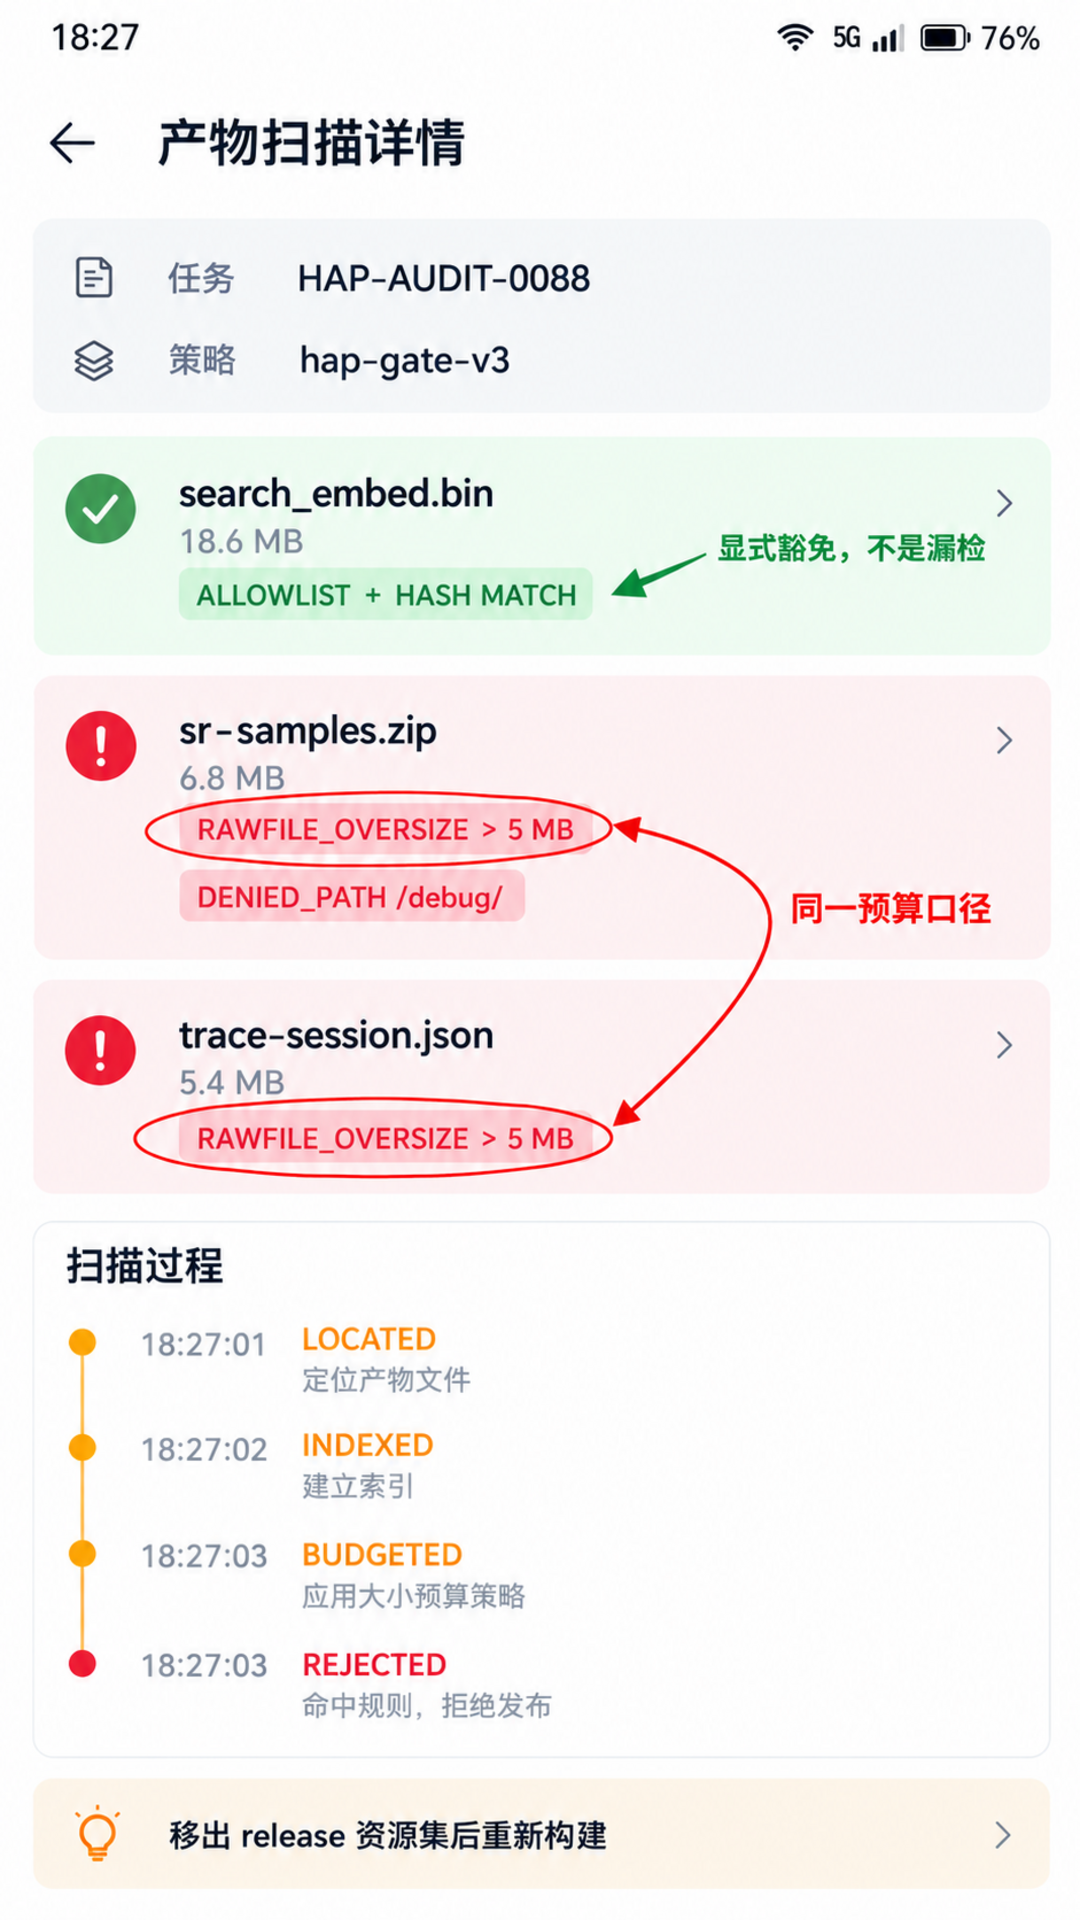
本次演示里,resources/rawfile/models/search_embed.bin 为 18.6 MB,因为在白名单中且摘要匹配,所以状态为 ALLOWED_LARGE_ASSET。resources/rawfile/debug/sr-samples.zip 为 6.8 MB,resources/rawfile/demo/trace-session.json 为 5.4 MB,两者均超过单文件阈值且不在白名单,于是成为两个阻断项。另一个 0.9 MB 的 device-log.txt 虽未超大小线,但命中调试路径规则,被记为警告。
这段代码解决什么问题:把预算、允许的大文件和禁止路径写成可评审的契约,避免规则散落在脚本条件里。
export interface ArtifactPolicy {
  maxHapBytes: number
  maxRawFileBytes: number
  deniedPathPatterns: RegExp[]
  allowLargeFiles: Record<string, { maxBytes: number, sha256: string }>
}

export const releasePolicy: ArtifactPolicy = {
  maxHapBytes: 45 * 1024 * 1024,
  maxRawFileBytes: 5 * 1024 * 1024,
  deniedPathPatterns: [/\/debug\//i, /device-log/i, /trace-session/i],
  allowLargeFiles: {
    'resources/rawfile/models/search_embed.bin': {
      maxBytes: 20 * 1024 * 1024,
      sha256: '6b44d7f0c8a1f5e2'
    }
  }
}
示例摘要做了截断,仅用于界面展示;真实白名单必须保存完整摘要。白名单也不能只按扩展名匹配,否则任何 .bin 都可能获得豁免。实际项目中应把策略版本单独记录,本次为 hap-gate-v3,这样一次放行能追溯到当时使用的阈值。
三、把归档列表转换成稳定清单
HAP 是归档产物,但脚本不应假定内部所有目录都永远固定。比较稳妥的做法是把归档工具输出先转换成自己的 ArtifactEntry,只保留路径、未压缩大小、压缩后大小和摘要。解析器负责兼容工具输出,规则引擎只消费稳定结构。
CI 环境可以通过受控的解包或列表命令取得条目。命令参数必须使用数组传递,不要把 HAP 文件名拼进 shell 字符串,以免路径中的空格或特殊字符造成命令注入。扫描前还要拒绝 ../ 与绝对路径,防止恶意归档在解压时越界。本文示例只展示清单处理,不把某个系统命令当成 HarmonyOS SDK API。
这段代码解决什么问题:校验归档路径并生成按大小排序的条目清单,为后续预算计算提供稳定输入。
export interface ArtifactEntry {
  path: string
  size: number
  compressedSize: number
}

export function normalizeEntries(input: ArtifactEntry[]): ArtifactEntry[] {
  return input.map(item => {
    const path = item.path.replaceAll('\\', '/')
    if (path.startsWith('/') || path.split('/').includes('..')) {
      throw new Error(`UNSAFE_ARCHIVE_PATH:${path}`)
    }
    if (!Number.isSafeInteger(item.size) || item.size < 0) {
      throw new Error(`INVALID_ENTRY_SIZE:${path}`)
    }
    return { ...item, path }
  }).sort((a, b) => b.size - a.size || a.path.localeCompare(b.path))
}
这里用未压缩大小做单文件预算,因为运行时读取和解压后的占用与它更相关;HAP 总大小则直接读取产物文件大小。两者不能混用。另一个易错点是把目录条目算进文件数,或者遇到重复路径时静默覆盖。检查器应将重复路径视为归档异常,并终止生成报告。
四、从“大小排行”升级到“阻断理由”
很多包体脚本只输出 Top 20 文件。这对观察有帮助,却不能形成门禁,因为排行榜没有说明哪个文件被允许、哪个文件必须处理。HapSlimGate 对每个条目依次执行四个判断:是否命中禁止路径;是否超过单文件阈值;是否存在白名单;白名单摘要与大小是否仍匹配。
顺序很重要。若一个文件同时位于 debug 目录又超过阈值,报告应保留两个原因,而不是在第一次命中后提前返回。这样修复者知道仅压缩到 5 MB 以下仍不够,发布产物中本来就不应保留该调试路径。
这段代码解决什么问题:为每个条目生成结构化问题,并区分阻断、警告和显式允许的大文件。
export interface Finding {
  path: string
  severity: 'BLOCKER' | 'WARNING' | 'INFO'
  code: 'DENIED_PATH' | 'RAWFILE_OVERSIZE' | 'ALLOWED_LARGE_ASSET'
  size: number
}

export function inspectEntry(
  entry: ArtifactEntry, policy: ArtifactPolicy
): Finding[] {
  const findings: Finding[] = []
  const allowed = policy.allowLargeFiles[entry.path]
  if (allowed && entry.size <= allowed.maxBytes) {
    findings.push({ path: entry.path, severity: 'INFO',
      code: 'ALLOWED_LARGE_ASSET', size: entry.size })
  } else if (entry.path.startsWith('resources/rawfile/') &&
             entry.size > policy.maxRawFileBytes) {
    findings.push({ path: entry.path, severity: 'BLOCKER',
      code: 'RAWFILE_OVERSIZE', size: entry.size })
  }
  if (policy.deniedPathPatterns.some(pattern => pattern.test(entry.path))) {
    findings.push({ path: entry.path,
      severity: entry.size > policy.maxRawFileBytes ? 'BLOCKER' : 'WARNING',
      code: 'DENIED_PATH', size: entry.size })
  }
  return findings
}
真实实现还要在判断 allowed 前计算完整 SHA-256;示例为了让代码聚焦,没有把文件流读取混在规则函数里。文件摘要应使用流式读取,避免一次把 18.6 MB 模型加载到 Node.js 堆中。扫描器结束时必须关闭归档句柄和文件流,异常路径也要在 finally 中释放。
五、增量不是百分比,而是来源
本次 HAP 为 42.8 MB,虽然没有越过 45 MB 总预算,仍然被拒绝。原因是总量阈值只能防止最后一刻爆线,不能解释 8.9 MB 从哪里来。检查器把当前清单与基线清单按路径比较,得到新增、删除和大小变化三类记录,再按增量排序。
sr-samples.zip 新增 6.8 MB,trace-session.json 新增 5.4 MB,同时其他资源压缩后减少约 3.3 MB,所以 HAP 净增量是 8.9 MB。若只看总包大小,会误以为仍有 2.2 MB 余量;按来源看,则能发现两个不该发布的调试产物。门禁因此使用“阻断项优先,总预算兜底”的策略。
汇总阶段给出单一、可复现的最终状态,保证页面和 CI 使用同一结论。报告数字应来自扫描器计算,页面不要再次做浮点换算。生产代码使用整数 Byte 保存,在格式化层统一显示一位小数。本例的演示报告写入任务 HAP-AUDIT-0088、产物 entry-release-signed.hap、42.8 MB 总量、33.9 MB 基线、286 个条目、31.7 MB rawfile 与两个阻断项。只要阻断数组非空,状态就是 REJECTED。
状态转换是 LOCATED → INDEXED → BUDGETED → REJECTED,每个阶段都有时间和输入摘要,避免同名 HAP 被后一次构建覆盖后仍显示旧结果。若总量超预算但不存在单文件问题,也仍然拒绝,只是错误码改为 HAP_BUDGET_EXCEEDED,便于区分修复方向。
六、把产物诊断放到开发者能看懂的位置
ArtifactAuditPage 不模拟应用市场后台,而是一张工程内诊断页。顶部展示任务 HAP-AUDIT-0088、产物名和策略 hap-gate-v3;中间显示 42.8 MB、基线 33.9 MB、增量 +8.9 MB;底部列出两个阻断文件及处理建议。时间固定为 18:27,与 HiLog 和配图一致。
这段代码解决什么问题:将构建报告映射为 ArkUI 状态卡,避免开发者在长日志里寻找最终结论。
@Entry
@Component
struct ArtifactAuditPage {
  @State status: string = 'REJECTED'

  build() {
    Scroll() {
      Column({ space: 12 }) {
        Text('HAP 产物诊断').fontSize(28).fontWeight(FontWeight.Bold)
        Text('HAP-AUDIT-0088 · 18:27').fontColor('#667085')
        Text(this.status).fontColor('#B42318').fontWeight(FontWeight.Bold)
        Text('entry-release-signed.hap · 42.8 MB')
        Text('基线 33.9 MB · 增量 +8.9 MB')
        Text('286 个条目 · rawfile 31.7 MB')
        Divider()
        Text('阻断 1  sr-samples.zip  6.8 MB')
        Text('阻断 2  trace-session.json  5.4 MB')
        Text('建议:移出 release 资源集后重新构建')
        Button('导出 artifact-report.json')
      }.padding(24).width('100%')
    }.width('100%').height('100%')
  }
}
页面只读取已完成报告。如果构建任务正在重跑,旧报告保留但加上 STALE 标记,不能一边扫描一边逐项刷新最终数字。否则用户会看到“阻断 0”短暂出现,并误以为当前产物已经通过。
七、失败时保留产物身份
诊断最怕“报告是新的,HAP 是旧的”。因此任务创建时先计算 HAP 摘要,报告中同时保存文件名、字节数、修改时间和摘要。页面打开报告后再次核对当前文件;任一字段不一致就显示 ARTIFACT_CHANGED,要求重新扫描。
详情页展示 LOCATED 18:27:01、INDEXED 18:27:02、BUDGETED 18:27:03、REJECTED 18:27:03。阻断项后附规则:RAWFILE_OVERSIZE > 5 MB 与 DENIED_PATH /debug/。18.6 MB 模型显示绿色 ALLOWLIST + HASH MATCH,说明它不是被大小规则漏掉,而是经过明确批准。
如果归档无法读取,状态应是 SCAN_FAILED,而不是 REJECTED。前者说明检查没有完成,后者说明检查完成且产物违反策略。二者都会阻断发布,但修复动作不同。工具异常时应保留上一次成功报告,另写失败事件,不能用半份清单覆盖基线。
八、接入 Hvigor 与流水线时的取舍
检查任务应挂在 release 产物生成之后,并将报告目录排除在应用资源之外,避免“检查报告又被打进 HAP”。本地开发可以提供一个显式任务,CI 则在签名和上传之前强制执行。脚本退出码只表达通过或失败,详细原因写进 artifact-report.json,便于 DevEco、流水线和归档服务复用。
不要把所有大文件都设成硬错误。模型、离线词典、地图切片可能就是产品能力的一部分,正确做法是用精确白名单和摘要固定它们;也不要只在发布分支运行,最好在资源变更的合并请求里就生成增量报告。越晚发现包体回归,修复成本越高。
还要区分“应用市场规则”和“团队预算”。本文的 45 MB、5 MB 都是 Demo 策略,不是华为应用市场的通用限制,也不能据此声称某个包一定能通过审核。真正提审前仍应核对当前官方政策、签名、版本和素材要求。这个检查器解决的是工程可见性,不替代平台审核。
九、结语
在把门禁推广到更多模块前,还有几组边界值得单独验收。
1. 压缩率不能替代运行成本
有些文本或采样数据在 HAP 中压缩率很高,看起来只增加少量包体,解压后却可能占用大量存储和内存。报告因此同时保存压缩大小与原始大小,并给出压缩比。压缩比异常高的文件不一定有问题,但应进入观察列表,防止把几十兆日志压成几百 KB 后绕过包体判断。
相反,已经压缩的图片、视频和模型通常压缩率不高。对它们反复压缩不仅收益有限,还会增加构建时间。门禁不应该自动重新编码业务资源,因为这可能改变画质、模型精度或运行时读取方式。它只提供证据,资源处理由对应模块负责人决定。
运行成本还包括首次启动时的复制。某些业务会把 rawfile 从 HAP 复制到沙箱,再解压或建立索引。此时磁盘峰值接近“HAP 内一份 + 沙箱一份 + 临时文件一份”。包体诊断可以为这类文件增加 copyOnFirstRun 元数据,提示产品评估首启时间和空间,而不是只关心下载大小。
2. 白名单需要过期机制
大文件一旦进入白名单,很容易永久存在。hap-gate-v3 要求每条豁免记录负责人、原因、最大字节数、完整摘要和复核日期。文件内容改变后摘要不匹配,立即失去豁免;到期后即使摘要相同,也降为阻断,要求重新确认。
路径移动同样需要重新评审。models/search_embed.bin 被允许,不代表复制到 debug/search_embed.bin 仍然合理。路径本身表达资源用途,也是规则的一部分。对于经常更新的模型,可把摘要更新放在模型发布流水线中,但仍要生成评审差异,不能允许通配哈希。
团队还应定期查看白名单总量。如果十个文件各自合理,合计后仍可能让应用变得难以下载和升级。单文件豁免不绕过 HAP 总预算,App Pack 层还要再做一次总量汇总,这是两级规则的关系。
3. 多模块报告不能简单相加
一个 App Pack 可能包含多个 HAP 与 HSP。模块报告适合定位责任,但 App Pack 级别的实际大小不能机械相加源码目录。共享包、签名信息与最终打包结构都应以真实产物为准。正确方式是先分别扫描每个模块归档,再扫描最终 App Pack,建立“App Pack 条目 → 模块产物”的映射。
如果同一资源在多个 HAP 中重复出现,模块级报告都可能显示“单包未超线”,汇总页却应标出重复成本。重复判断不能只按文件名,要比较完整摘要和资源语义;同名不同内容是冲突线索,同内容不同路径是去重候选。是否迁入 HSP 则属于架构决策,门禁只提供重复证据。
动态特性或按需模块也不能被忽略。它们也许不在首装路径,却仍然影响下载与存储。报告应标明模块类型和交付阶段,给出首装体积与完整体积两套口径,避免把其中一个口径宣传成全部事实。
4. 修复后要比较同一个产物阶段
开发者删除调试文件后,应该重新执行完整 release 构建,再用新 HAP 与同一基线比较。不能拿未签名 debug 包与已签名 release 包比较,因为构建配置和内容本就不同。报告的身份字段至少包含变体、模块、签名阶段、提交号和构建任务 ID。
本例期望修复是从 release 资源集中移除 sr-samples.zip 与 trace-session.json,不是在归档生成后用脚本删除。后处理会让源码、构建日志和最终产物不一致,也可能破坏签名。正确修复位置应尽量靠近文件被加入资源集的源头。
修复验证还要检查业务回归。如果采样包被误当成运行时依赖,删除后应用可能在某个入口才报错。门禁可以生成资源引用候选,但无法证明业务不再需要它;至少要运行相关页面、离线场景和首次启动流程。ACCEPTED 只表示通过当前包体策略,不代表功能测试已经完成。
5. 报告面向不同角色给不同密度
CI 摘要只需要状态、阻断数、增量和报告链接;开发页面显示 Top 变化与修复建议;归档附件保存完整条目和摘要。三者都来自同一份 JSON,不应各自重新扫描。这样能够保证图片、页面、日志和流水线数字一致,也减少“本地显示两个阻断,CI 却只报一个”的分叉。
报告排序也要稳定:先按严重级别,再按增量大小,最后按路径。稳定排序让同一结果在不同机器上保持可比较。时间使用带时区的 ISO 值保存,界面再格式化为 18:27;本文配图中的分钟值只是界面展示,原始报告仍应保留完整时间。
最后,诊断截图只能作为解释材料,不能冒充实际审核证据。本文所有界面都是与固定 Demo 数据对应的演示配图;真正项目需要保存 HAP 摘要、构建日志和流水线附件,才能形成可复核链路。
6. 把规则变更当成一次工程变更
预算从 45 MB 调到 50 MB,看起来只改了一个数字,实际上会改变后续所有构建的判定口径。策略调整应带评审说明、影响范围与生效日期,并在报告中同时保存策略版本和策略文件摘要。这样回看旧报告时,能够解释当时为何通过,而不是用今天的阈值重新解释过去。
规则新增也需要回放历史样本。比如增加 /debug/ 禁止路径后,可以对最近若干个发布产物做只读扫描,观察误报数量,再决定是硬阻断还是先告警。若一开始就全量阻断,团队可能为了赶发布加入宽泛白名单,反而削弱门禁。比较稳妥的推进是“可见化、告警、阻断”三阶段,但每个阶段都要设明确截止点。
检查器自身也要纳入测试。准备一个包含允许模型、超限调试包、路径穿越条目、重复路径和损坏归档的样本集合;每次修改解析器或策略引擎都跑回归。样本只需保留小型替身文件和声明大小,不必存放真实大模型。目标是验证分类和状态转换,而不是消耗仓库存储。
当检查耗时增加时,优先缓存“产物摘要 → 清单报告”,而不是跳过扫描。摘要相同的 HAP 可以复用报告,摘要不同就必须重扫。缓存命中也要核对检查器版本与策略摘要,旧规则生成的绿色报告不能被新规则直接复用。
最后要为门禁设置负责人。没有负责人时,白名单到期、规则误报和工具升级都会被临时绕过。负责人并不负责所有资源优化,而是维护规则可信度、确认报告结构和推动异常归属到具体模块。只有工具和流程都有人维护,包体门禁才不会退化成发布前的一次性脚本。
HAP-AUDIT-0088 最有价值的结论不是“42.8 MB 还没超过 45 MB”,而是“产物净增 8.9 MB,其中两个不应发布的 rawfile 已经进入 HAP”。当检查器能够把产物身份、预算版本、条目清单、差异来源和阻断理由串起来,包体问题就从发布前的人工翻找,变成构建阶段的可执行证据。
落地时可以从三步开始:扫描真实 HAP;给 rawfile 建立精确白名单;保存基线并对增量归因。随后再接入 Hvigor、CI 和 ArkUI 诊断页。这样即使总包暂时没有越线,调试资源和异常大文件也不会悄悄混进发布候选产物。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 4
 0
- 0


 已为社区贡献10条内容

所有评论(0)