
HarmonyOS 7 + Hvigor-HSP:多 HAP 重复 HAR 的包体审计与迁移门禁【鸿蒙心迹】
多模块工程的包体增长,常常不是某一张图片突然变大,而是同一份静态共享包被多个 HAP 各自带了一遍。源码目录看起来只有一个 common-ui,依赖树也只有一条声明;到了最终 .app,它可能已经变成两份甚至更多份字节。开发阶段只看工程目录,很难看见这类“构建后重复”。
本文围绕一个可复现的演示工程 PackLens 展开。候选包为 LedgerSuite.app,任务编号 PACK-HSP-0079。审计页 DuplicationAuditPage 在 14:18 展示一次示例扫描:迁移前压缩包 46.8 MB,common-ui.har 在 entry 与 report 两个 HAP 中各出现一次,合计 10.8 MB;迁成应用内 HSP 并重新核对后,包体为 40.9 MB,减少 5.9 MB,重复项从 3 个收敛到 0 个。
这里的数字是文章 Demo 的固定样例,不冒充真实商用项目的实测结论。真正值得复用的,是“先对最终产物取证,再决定是否迁移”的判断顺序。
一、源码只有一份,发布包为什么会多出两份
HAR 是静态共享包。它适合编译期复用,也可以携带代码、资源和 C++ 库。但静态复用的代价是:当多个 HAP 或 HSP 同时引用同一个 HAR 时,相关内容可能进入多个消费方的产物。HSP 是动态共享包,运行时复用;在同一应用的多个模块需要共享一份代码和资源时,它能避免多包间的重复拷贝。
这并不意味着“看到 HAR 就改成 HSP”。迁移会改变模块边界、资源访问方式、页面声明、Worker 文件加载和依赖关系。小型纯工具 HAR 只有几十 KB,改造收益可能抵不过维护成本;带大量媒体资源、字体或原生库的公共 HAR,同时被多个 HAP 引用,才是更值得审计的对象。
PackLens 把问题拆成三层事实。
第一层是工程事实:哪个模块声明了哪个依赖。第二层是产物事实:最终 APP 内的每个 HAP 到底携带了什么。第三层是迁移事实:换成 HSP 后,功能、资源、依赖方向与包体是否同时成立。
只看 oh-package.json5 只能回答第一层。只看总包大小只能发现“变大了”,却回答不了是哪一份内容造成的。审计器必须落到解包清单:模块名、条目路径、摘要、压缩大小和归属包缺一不可。
演示中,官方拆包工具负责把 LedgerSuite.app 解析成目录与包描述;一个很薄的适配步骤再生成 pack-inventory.json。文章里的 Node.js 脚本不自行猜测 APP 二进制格式,它只消费这份稳定清单。这一点很重要:工具链格式变化时,只替换适配器,不让业务规则跟着解包细节一起漂移。
二、先做只读审计,不急着改模块类型
一次安全的包体治理,第一步应该是只读扫描。扫描不能只按文件名分组,因为不同版本的库可能同名;也不能只按摘要分组,因为一张通用图标与一个完整 HAR 的治理价值不同。PackLens 同时使用 logicalName + sha256 形成重复键,再按模块归属聚合。
任务 PACK-HSP-0079 的阈值设为 1 MB:同一内容至少被两个模块携带,且重复浪费量超过 1 MB,才进入阻断列表。阈值是团队策略,不是 HarmonyOS 的系统限制。
这段代码解决什么问题:从最终产物清单中识别跨 HAP 的重复静态包,并输出可用于构建门禁的确定性结果。
// tools/pack-audit.ts
import fs from 'node:fs';

interface Item {
  owner: string;        // entry.hap / report.hap
  logicalName: string;  // common-ui.har
  sha256: string;
  compressedSize: number;
}

interface Finding {
  key: string;
  owners: string[];
  copies: number;
  wastedBytes: number;
}

const inventory = JSON.parse(
  fs.readFileSync('build/audit/pack-inventory.json', 'utf8')
) as { app: string; items: Item[] };

const groups = new Map<string, Item[]>();
for (const item of inventory.items) {
  const key = `${item.logicalName}:${item.sha256}`;
  const bucket = groups.get(key) ?? [];
  bucket.push(item);
  groups.set(key, bucket);
}

const findings: Finding[] = [];
for (const [key, items] of groups) {
  const owners = [...new Set(items.map(item => item.owner))].sort();
  if (owners.length < 2) continue;
  const unit = Math.min(...items.map(item => item.compressedSize));
  const wastedBytes = unit * (owners.length - 1);
  if (wastedBytes < 1024 * 1024) continue;
  findings.push({ key, owners, copies: owners.length, wastedBytes });
}

findings.sort((a, b) => b.wastedBytes - a.wastedBytes);
fs.writeFileSync('build/audit/duplicate-report.json',
  JSON.stringify({ taskId: 'PACK-HSP-0079', findings }, null, 2));

console.info(`[PACK-HSP-0079] duplicate=${findings.length}`);
process.exitCode = findings.length === 0 ? 0 : 2;
为什么用最小压缩大小估算浪费,而不是把每份大小简单相加?因为同一逻辑条目在不同容器中的压缩结果可能有少量差异。取最小值乘以多余副本数比较保守,不会因为容器元数据差异夸大收益。
脚本执行后,状态从 SCANNING 进入 DUPLICATE_FOUND。演示清单给出 3 个发现,其中 common-ui.har 的两个副本各为 5.4 MB;另外两项是 HAR 内的字体和插图资源。它们与主条目有包含关系,所以报告会标记“父子重复”,总收益不能把三项直接相加。实际项目如果忽略这一点,很容易把节省量算两遍。
容易出错的地方还有摘要时机。应对解包后的实际条目计算摘要,而不是对源码目录计算;发布构建可能执行资源裁剪、压缩或产物合并,源码相同不等于最终字节相同。门禁也应读取 release 候选包,而不是 debug 包。
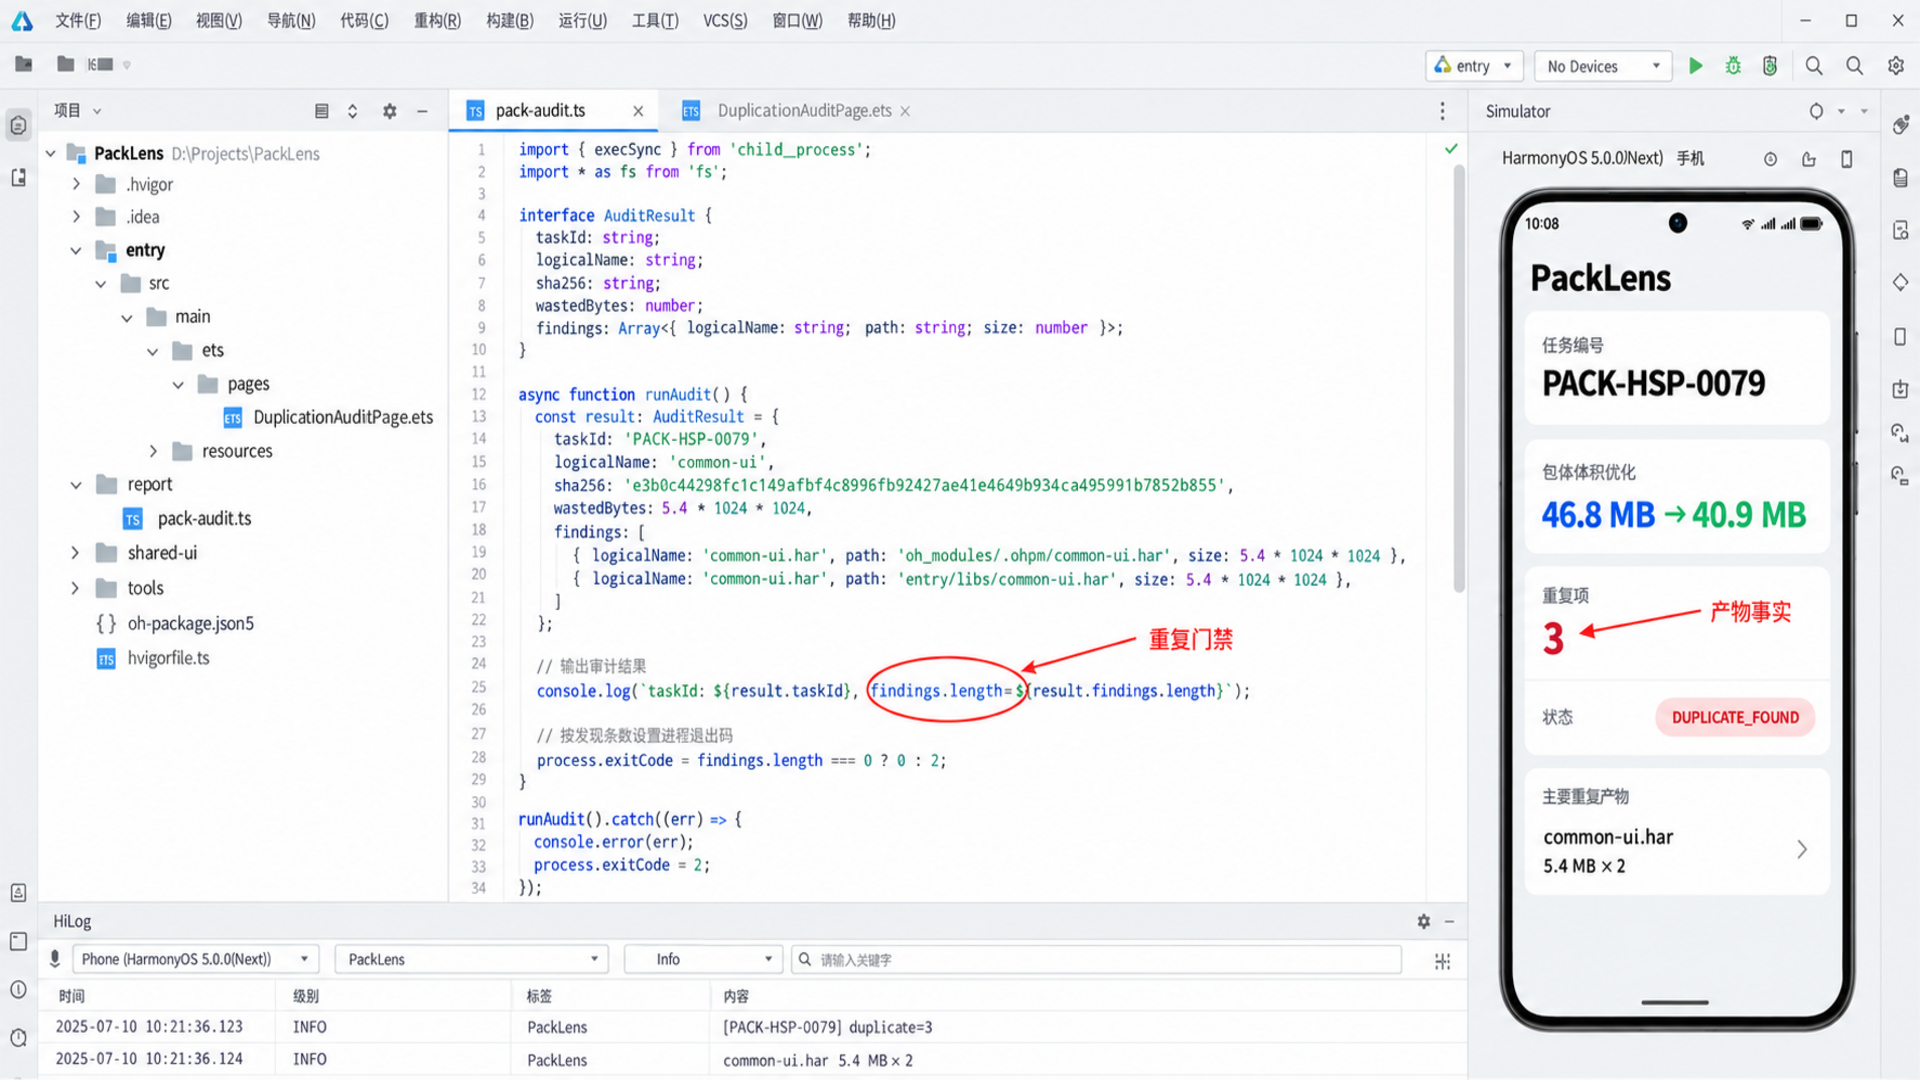
下图是演示版 DevEco Studio 工作区:左侧为 PackLens 目录,中间是重复项聚合逻辑,右侧模拟器显示 PACK-HSP-0079,底部 HiLog 对应 duplicate=3 与 common-ui.har 5.4 MB × 2。它是与正文一致的演示配图,不作为真实 IDE 测试凭证。
三、迁移判断要同时过四道门
发现重复之后,不能直接批量把 type: "har" 改成 shared。我更愿意先问四个问题。
第一,这份库是不是只在同一应用内共享。HSP 适合应用内运行时复用;如果库还要发布到 OHPM 供其他应用编译期使用,往往需要保留对外 HAR 接口,内部再建立 HSP 实现层,而不是简单二选一。
第二,消费方是否真的有两个或更多安装模块。如果只有一个 HAP,HSP 很可能没有消除副本的空间,还会增加边界复杂度。
第三,库里是否包含页面、资源、Worker 或原生库。不同内容的迁移约束不同,尤其不能假设 HAR 与 HSP 的资源上下文完全等价。
第四,依赖图是否会形成环。共享模块可以依赖其他 HAR/HSP,但设计上要让业务模块依赖共享层,而不是共享层回头依赖业务 HAP。
PackLens 的结论是:common-ui 只服务 LedgerSuite,entry 与 report 都使用同一套图表主题和字体,公共层不依赖业务模块,适合迁成应用内 shared-ui.hsp。对外发布的 analytics-contract.har 保持不动,只把大体积实现和资源迁入 HSP。
这段配置解决什么问题:把原来的静态共享模块声明为应用内 HSP,并明确随应用安装及页面清单。
// shared-ui/src/main/module.json5
{
  "module": {
    "name": "shared_ui",
    "type": "shared",
    "deliveryWithInstall": true,
    "pages": "$profile:main_pages",
    "deviceTypes": ["phone", "tablet", "2in1"]
  }
}
type: "shared" 是模块身份变化的核心,deliveryWithInstall 表示随应用安装,pages 指向 HSP 自己的页面声明。配置不能孤立复制:工程还要调整构建配置与依赖声明,并逐项检查资源、Worker 和原生库的用法。
状态在这里进入 MIGRATION_READY,但还没有到 VERIFIED。因为配置能编译,只证明语法和基本依赖成立,不证明多模块都加载了正确资源,也不证明包体真的减少。
另一个易错点是资源归属。迁移前,消费方可能通过自身上下文读取随 HAR 一起编入的资源;迁移后,资源属于 HSP。对于跨模块资源,应该使用明确的模块上下文或 HSP 对外封装的资源访问函数,避免业务模块知道 HSP 内部路径。
四、把模块边界做窄,而不是把整个工程搬过去
HSP 改造最容易走向两个极端。一个是只换后缀,调用方仍到处拼资源路径;另一个是把几十个页面、状态和工具一起搬进共享模块,最终形成新的“大泥球”。
PackLens 只暴露稳定接口:主题令牌、格式化器和两类可复用组件。业务页面仍留在 entry/report,HSP 不读取业务数据库,也不持有业务路由栈。
这段代码解决什么问题:用窄接口隔离 HSP 的资源与实现细节,让两个 HAP 只依赖稳定能力。
// shared-ui/src/main/ets/api/ChartTheme.ets
export interface ChartPalette {
  positive: ResourceColor;
  negative: ResourceColor;
  grid: ResourceColor;
}

export function ledgerPalette(): ChartPalette {
  return {
    positive: $r('app.color.chart_positive'),
    negative: $r('app.color.chart_negative'),
    grid: $r('app.color.chart_grid')
  };
}

// entry/src/main/ets/pages/DashboardPage.ets
import { ledgerPalette } from 'shared_ui';

@Entry
@Component
struct DashboardPage {
  private palette: ChartPalette = ledgerPalette();

  build() {
    Column() {
      Text('LedgerSuite')
      Text('共享主题已加载')
        .fontColor(this.palette.positive)
    }
  }
}
这样写的目的不是追求“接口越少越高级”,而是把迁移风险限制在可测试的边界内。调用方只知道 ledgerPalette(),不知道字体文件和色值存放位置。后续 HSP 内部调整资源目录,不需要同步修改两个 HAP。
资源类型也要谨慎。示例使用 ResourceColor,如果团队希望跨模块传递已经解析的字符串色值,需要在接口层统一转换,不能一部分页面拿 Resource,另一部分页面拿字符串。实际项目还应补充两个消费模块的渲染快照或组件测试。
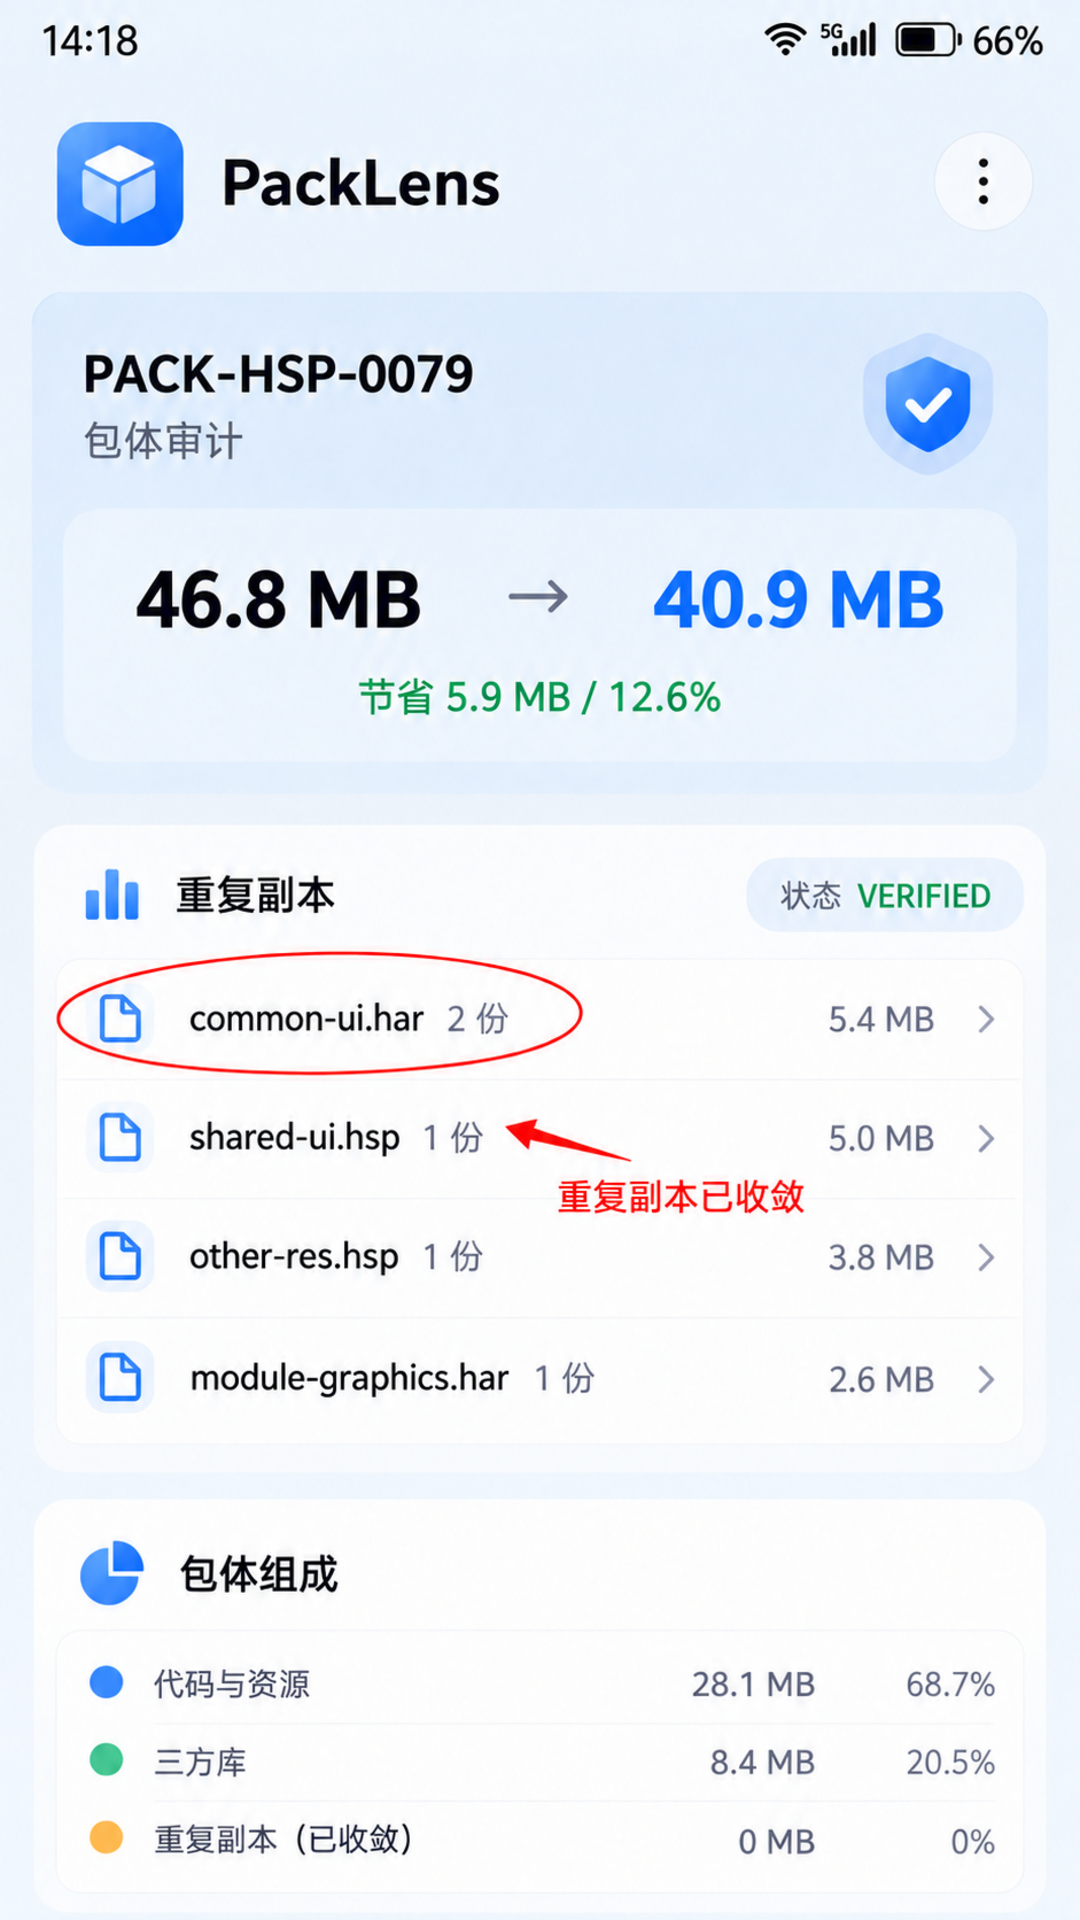
手机运行页把迁移前后的事实放在同一屏:任务 PACK-HSP-0079,包体 46.8 MB → 40.9 MB,节省 5.9 MB / 12.6%,common-ui.har 从 2 份变成 shared-ui.hsp 1 份。红色箭头只标出重复副本和最终节省量。
五、验证不是“能安装”,而是产物、功能与边界三项同时成立
重新构建后,PackLens 再跑同一条只读扫描。这里必须复用原始任务规则,不能因为迁移后目录变化就临时修改识别逻辑。否则报告显示 0 个重复项,可能只是扫描器没找到新路径。
演示的验证清单分三组。
产物组确认 LedgerSuite.app 为 40.9 MB,entry 与 report 内不再出现 common-ui.har,顶层存在一份 shared-ui.hsp,摘要与候选构建记录一致。
功能组分别启动 entry 仪表盘、report 导出页,检查公共字体、图表主题、组件交互与资源加载。因为本文没有连接真实设备,页面显示的是“样例验证流程”,不是宣称已经在某型号上跑通。
边界组检查 HSP 没有反向依赖业务模块,没有循环依赖,没有让业务 HAP 直接拼 HSP 私有资源路径;对外 HAR 仍能独立发布。
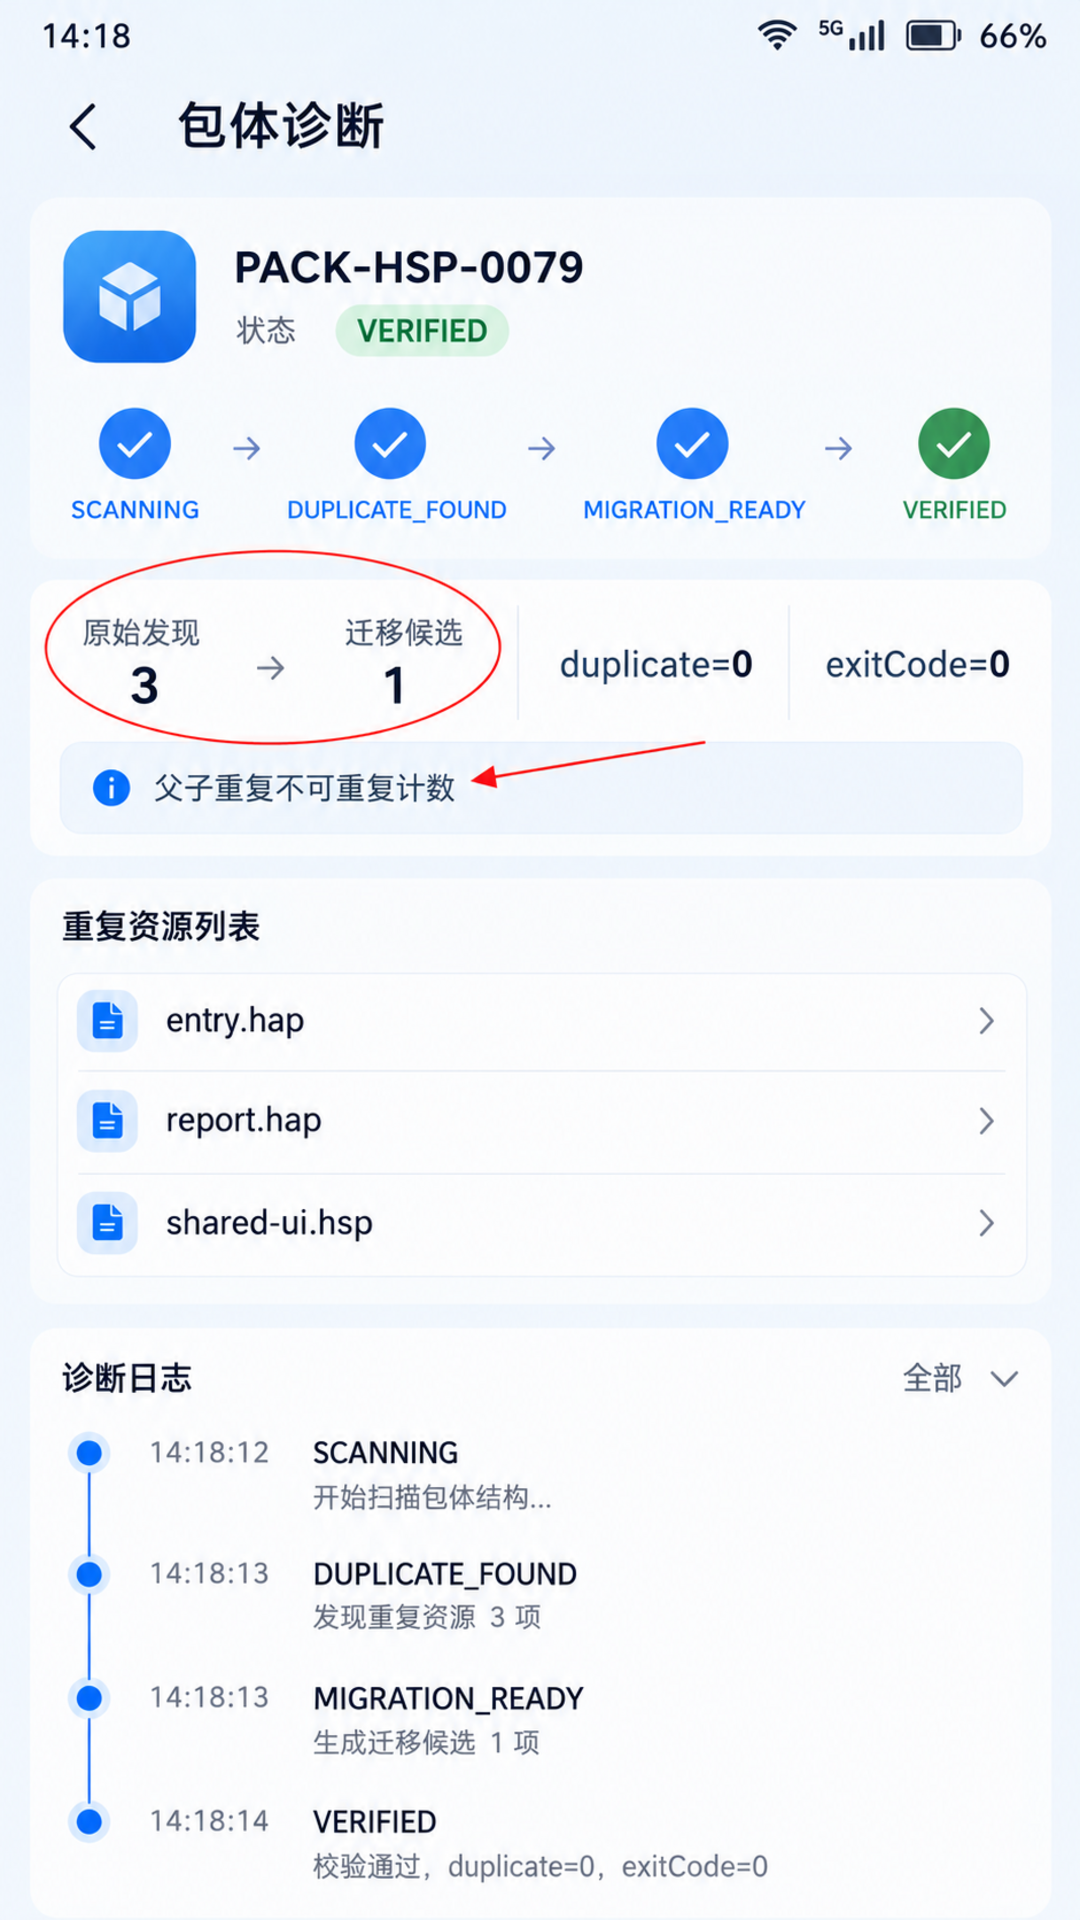
诊断页的状态为 SCANNING → DUPLICATE_FOUND → MIGRATION_READY → VERIFIED。这是一条单向状态机:一旦某个候选包验证失败,就生成新的构建编号重新开始,不允许把旧报告手工改成 VERIFIED。
这段代码解决什么问题:在 ArkUI 诊断页上把审计事实和验证状态分开呈现,避免“发现已修复”与“产物已验证”混为一谈。
interface PackAuditView {
  taskId: string;
  state: 'SCANNING' | 'DUPLICATE_FOUND' | 'MIGRATION_READY' | 'VERIFIED';
  beforeMb: number;
  afterMb: number;
  duplicateCount: number;
  modules: string[];
}

@Entry
@Component
struct DuplicationAuditPage {
  @State report: PackAuditView = {
    taskId: 'PACK-HSP-0079', state: 'VERIFIED',
    beforeMb: 46.8, afterMb: 40.9,
    duplicateCount: 0,
    modules: ['entry.hap', 'report.hap', 'shared-ui.hsp']
  };

  build() {
    Column({ space: 12 }) {
      Text(this.report.taskId).fontSize(14)
      Text(`${this.report.beforeMb} MB → ${this.report.afterMb} MB`)
        .fontSize(28).fontWeight(FontWeight.Bold)
      Text(`状态 ${this.report.state}`)
      Text(`重复项 ${this.report.duplicateCount}`)
      ForEach(this.report.modules, (name: string) => Text(name))
    }.padding(24).alignItems(HorizontalAlign.Start)
  }
}
页面状态只负责展示,不应该成为审计真相源。生产项目要从构建产物生成不可变报告,再由页面读取;如果让 UI 自己计算结果,测试页面与 CI 门禁很容易产生两套规则。
下图的详情页展示父子重复折叠后的诊断:原始发现 3 条,归并为 1 个迁移候选;迁移后 duplicate=0、exitCode=0。红圈标的是“父子项不可重复计数”,这是包体审计最容易产生虚假收益的地方。
六、把节省量写进基线,但不要把 HSP 当万能答案
门禁应该比较基线,而不是写死一个永远不变的总包上限。PackLens 保存 release-baseline.json:构建编号、APP 大小、各模块大小、重复候选和摘要。新版本允许因业务增长而变大,但如果某个已消除的 HAR 又同时进入两个 HAP,CI 立即以退出码 2 阻断。
同时要保留例外机制。某些模块需要独立交付,或运行约束决定必须保留静态副本,团队可以在策略文件中记录 logicalName、原因、负责人和到期日期。只有“永久忽略”没有到期复核,会让门禁逐渐失去意义。
这套方案也有明确边界。
它不承诺迁移后的节省量等于 HAR 文件大小。容器压缩、资源去重、对齐和元数据都会影响最终结果,必须以重新构建的 APP 为准。
它不建议把只有一个消费方的 HAR 迁成 HSP。没有重复副本,就没有这项收益。
它不替代功能测试。包体变小而资源加载失败,仍然是不合格发布物。
它也不把当前工具链字段当成永久格式。官方拆包工具与 DevEco Studio 会演进,适配器需要跟随版本校验;业务规则只依赖内部清单结构,才能减少变更面积。
回到 PACK-HSP-0079,最终可接受的结论不是“HSP 比 HAR 好”,而是:在两个 HAP 共享 5.4 MB 静态内容的前提下,迁成一份应用内 HSP 后,样例候选包从 46.8 MB 降到 40.9 MB,重复项 3→0,功能与依赖边界均进入 VERIFIED。换一个工程、一个依赖图,这个判断可能完全不同。
七、让审计进入发布链路,而不是停在一次优化
如果包体扫描只在专项治理时运行一次,几个月后同样的问题通常还会回来。新 feature 模块为了赶进度,再次直接依赖旧 HAR;某个资源包从 HSP 拷回 HAP 解决临时路径问题;发布包变大了,大家只会看到总数,却不知道重复是从哪个提交开始出现的。
因此 PackLens 把审计拆成“每次构建的轻检查”和“发布候选的完整检查”。轻检查只比较依赖图与已知高风险模块,速度优先;完整检查则对 release APP 解包、计算摘要、生成归属矩阵,并和上一个通过验证的基线比较。只有完整检查可以更新基线。
基线不是一行 maxSize=41MB。它至少包含 APP 总压缩大小、每个 HAP/HSP 的压缩大小、重复键、依赖者列表、工具链版本、构建编号和策略版本。总包增加 500 KB 可能是合理功能增长;一个已经消失的 5.4 MB 摘要重新出现在两个 HAP,却应立即阻断。只有结构化基线才能区分这两种情况。
报告还要保留“证据链”。每条发现指向源清单位置、所属模块、摘要与压缩大小;每个例外指向策略条目;最终 VERIFIED 指向候选包摘要。这样审核者不需要相信一句“已经优化”,而是可以从结果追到输入。构建缓存命中时也要校验候选包摘要,不能把上一轮报告贴到新产物上。
在持续集成中,退出码应保持简单:0 表示没有阻断项,2 表示存在确定性重复,3 表示清单不完整或适配器不认识当前格式。第三种情况不能当作“没发现问题”。扫描失败与扫描通过是完全不同的状态,最危险的实现就是捕获所有异常后返回空 findings。
团队还需要规定谁能批准例外。包体负责人可以接受短期重复,但例外必须写清业务原因、影响大小、负责人和到期日期。到期后再次出现时,门禁自动恢复。把审批留在结构化文件中,也比聊天记录里一句“先这样”更容易审计。
1. 功能回归要覆盖两个消费方
共享模块迁移后,只验证 entry 页面是不够的。最常见的遗漏是 entry 使用正常,report 中某个延迟加载页面才暴露资源上下文错误。PackLens 为每个消费方保存一张能力清单:加载公共字体、读取三种主题色、创建共享组件、触发一次交互、释放页面资源。
测试重点不是像素级截图是否完全一致,而是资源是否来自预期模块、异常是否可定位。日志里应带消费模块名和共享模块版本,例如 consumer=report shared=shared_ui revision=7。如果日志只写“resource not found”,多模块环境下很难判断是路径、上下文还是构建裁剪。
原生库也需要单独检查。HAR 中携带 .so 时,迁移可能改变加载位置和打包归属;不能因为 ArkTS 页面打开成功,就认为 Native 路径也成立。应在目标设备架构上至少执行一次真实调用,并核对 ABI 产物。本文 Demo 没有原生库,所以报告明确标记 nativeCheck=NOT_APPLICABLE,而不是伪造一个通过结果。
2. 包体收益要看净值
迁移并非没有新增成本。HSP 自身有描述与容器开销,接口层可能引入少量适配代码,某些资源为了兼容旧路径还会短期保留。收益计算应使用“迁移前完整 APP”减去“迁移后完整 APP”,而不是用删除的 HAR 大小当结论。
演示中,两个 5.4 MB 副本理论上可以少一份,但最终下降 5.9 MB,原因包括资源重排与压缩差异。这个结果比单份 HAR 略大,并不违反逻辑;同样,真实工程也可能只减少 4.7 MB。只要输入包、构建配置与测量口径一致,净值才有比较意义。
还要防止“通过删功能变小”的假优化。迁移前后应比较页面清单、公共资源集合和关键能力测试。如果某个 report 页面没有进入最终包,总大小当然会下降,却不是共享治理的收益。PackLens 把功能清单摘要与包体报告绑定,功能集合变化时要求重新审核基线。
3. 何时应该撤销迁移
HSP 迁移不是不可逆决定。如果共享模块只有一个消费方,或两个模块已合并;如果 Worker、资源或初始化约束让运行复杂度显著上升;如果公共层开始反向依赖大量业务接口,团队应重新评估是否保留 HSP。
撤销也要按同一流程做:先记录动机,恢复静态模块,重新构建候选 APP,再比较包体与功能。不能因为“以前是 HAR”就跳过验证。模块形态只是实现手段,最终目标仍是可维护的边界和可解释的发布产物。
这也是这次治理最值得留下的经验:包体优化不从“换模块类型”开始,而从“最终产物里到底有什么”开始;不以编译成功结束,而以重新解包、功能回归和依赖边界同时成立结束。只有这样,5.9 MB 才是一项可以复核的工程结果,而不是一张漂亮但不可追溯的对比图。
当后续模块继续增加时,同一套证据链仍可重复执行,而不必依赖某位开发者记得曾经处理过哪个包。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 4
 0
- 0


 已为社区贡献6条内容

所有评论(0)