
HarmonyOS 7 + EasyGo-ArkUI:平行视界双窗草稿的乐观锁与冲突合并【鸿蒙心迹】
平行视界把列表与详情同时铺开之后,一个原来不明显的问题会立刻暴露:两个窗口可能同时持有同一份业务对象。左窗从列表快速编辑标题,右窗在详情页修改正文和标签;如果两边都执行“读取—修改—覆盖写入”,最后到达的保存会悄悄抹掉先到的内容。
这不是导航问题,也不是双栏比例问题,而是并发写入问题。单窗口里,用户通常按顺序操作,覆盖写不容易出事;双窗让两个编辑上下文同时可见,保存顺序与用户看到的界面顺序不再一致。
本文用演示工程 TwinDraft 说明一种克制的处理方式。页面名是 DraftConflictPage,任务编号 DRAFT-MERGE-0080,演示时间 14:21,草稿 ID 为 note-1042。样例数据从 revision 31 开始,先发生一次直接提交,再触发一次三方合并:标题与标签自动合并,正文第 2 段因为双方都修改而进入人工确认,最终 revision 变为 33,丢失更新为 0。
所有时间、计数与结果都是固定 Demo 数据,用来解释状态变化,不是对真实线上系统的运行宣称。
一、双窗真正放大的,是“保存”这个动作的含义
假设左窗在 revision 31 读取草稿,改标题为“周报-第40周”,同时改正文第 2 段。右窗也在 revision 31 读取草稿,新增标签“性能”,并把正文第 2 段改成另一种表达。
左窗在 14:21:08.314 提交成功,仓库进入 revision 32。右窗在 14:21:08.507 才提交。如果右窗直接把自己手里的完整对象覆盖进去,左窗刚保存的标题会消失;如果系统只比较更新时间,仍然只能决定“谁赢”,不能保留互不冲突的改动。
因此保存请求不能只带最终值,还要带三个事实:草稿 ID、编辑开始时的 base revision、当前窗口修改过的字段。仓库需要回答的也不只是成功或失败,而应区分 DIRECT_COMMIT、AUTO_MERGED、NEEDS_REVIEW 与 STALE_REJECTED。
TwinDraft 的状态机是:
CLEAN → EDITING → SAVING → CONFLICT → MERGED → CLEAN。
其中 CONFLICT 不是异常页,而是正常业务分支。它意味着系统已经确认两个修改基于同一旧版本,并且至少有一个字段无法安全自动合并。
我不建议用 AppStorage 直接承担业务真相源。AppStorage 适合应用范围内的 UI 状态共享,但草稿提交需要持久化、一致性和可审计历史。Demo 中仓库用内存实现便于展示,真实项目应把 compare-and-set 放在数据库或服务端事务里;窗口只保存自己的编辑快照与待提交补丁。
二、先记录修改路径,再谈合并策略
最简单的冲突检测是比较整条记录 revision。它能阻止覆盖,却会把所有并发编辑都变成冲突。左窗只改标题、右窗只改标签,本来可以自动合并,如果一律弹窗,用户很快就会对“冲突”失去耐心。
TwinDraft 把可编辑字段拆成 title、body、tags 三条路径。保存补丁只包含真正改过的字段。三方合并时同时观察 base、current、incoming:
- current 等于 base,说明别人没改这个字段,incoming 可以提交;
- incoming 等于 base,说明当前窗口没改这个字段,保留 current;
- current 与 incoming 相等,说明双方得到同一结果,也可以接受;
- 三者都不同,才形成字段级冲突。
这段代码解决什么问题:用 base/current/incoming 三方比较识别真正冲突的字段,保留互不重叠的双窗修改。
type DraftField = 'title' | 'body' | 'tags';

interface DraftData {
  title: string;
  body: string;
  tags: string[];
}

interface MergeResult {
  merged: DraftData;
  conflicts: DraftField[];
}

function same(a: string | string[], b: string | string[]): boolean {
  return JSON.stringify(a) === JSON.stringify(b);
}

function threeWayMerge(base: DraftData,
  current: DraftData, incoming: DraftData): MergeResult {
  const fields: DraftField[] = ['title', 'body', 'tags'];
  const merged: DraftData = { ...current, tags: [...current.tags] };
  const conflicts: DraftField[] = [];

  for (const field of fields) {
    const b = base[field];
    const c = current[field];
    const i = incoming[field];
    if (same(c, b)) {
      (merged[field] as string | string[]) = i;
    } else if (same(i, b) || same(i, c)) {
      continue;
    } else {
      conflicts.push(field);
    }
  }
  return { merged, conflicts };
}
为什么不直接用对象展开运算符合并?因为展开只表达“后者覆盖前者”,没有 base 语义。三方比较才能判断一个差异来自当前窗口,还是来自另一个已经提交的窗口。
代码里用 JSON 序列化比较标签数组,只适合顺序稳定、元素简单的演示。真实项目要先定义标签是否有序、是否允许重复,再做规范化比较。正文也不能永远按整个字符串处理;长文编辑器可以升级为段落 ID 或操作日志,但复杂度会显著增加。本文刻意把边界停在字段级合并。
三、revision 不是页面计数器,而是提交权凭证
两个窗口都能看到 revision 31,不代表它们都能把 31 改成 32。仓库必须原子地检查 expected revision,并只允许一个请求完成提交。否则“先查询再更新”之间仍然存在竞态。
演示仓库暴露 commit():请求携带 base snapshot、incoming 数据和 expectedRevision。若仓库仍是同一 revision,直接写入;若已前进,执行三方合并。没有字段冲突时自动生成下一 revision;有冲突时返回候选结果和冲突路径,仓库保持不变。
这段代码解决什么问题:把 revision 校验与写入放在同一提交边界,阻止迟到窗口覆盖已经成立的新版本。
interface VersionedDraft {
  id: string;
  revision: number;
  data: DraftData;
}

interface CommitRequest {
  base: VersionedDraft;
  incoming: DraftData;
}

type CommitResult =
  | { kind: 'DIRECT_COMMIT' | 'AUTO_MERGED'; value: VersionedDraft }
  | { kind: 'NEEDS_REVIEW'; current: VersionedDraft;
      candidate: DraftData; conflicts: DraftField[] };

class DemoDraftRepository {
  private current: VersionedDraft;

  constructor(seed: VersionedDraft) { this.current = seed; }

  commit(request: CommitRequest): CommitResult {
    if (request.base.revision === this.current.revision) {
      this.current = {
        id: this.current.id,
        revision: this.current.revision + 1,
        data: request.incoming
      };
      return { kind: 'DIRECT_COMMIT', value: this.current };
    }

    const merge = threeWayMerge(
      request.base.data, this.current.data, request.incoming);
    if (merge.conflicts.length > 0) {
      return { kind: 'NEEDS_REVIEW', current: this.current,
        candidate: merge.merged, conflicts: merge.conflicts };
    }

    this.current = { id: this.current.id,
      revision: this.current.revision + 1, data: merge.merged };
    return { kind: 'AUTO_MERGED', value: this.current };
  }
}
这段实现是单进程演示,不是生产数据库事务。真实项目中,如果数据落在关系型数据库,revision 条件必须进入同一条更新语句或事务;如果提交到服务端,服务端才是最终仲裁者。把 if 写在页面里,再调用普通 update,仍然会出现检查后被别人抢先写入的问题。
状态变化也要明确。右窗发起保存时进入 SAVING;发现仓库已经从 31 到 32 后,不直接回到 EDITING,而是进入 CONFLICT,并冻结当前 base snapshot。用户处理冲突期间,如果仓库又到了 33,旧冲突结果必须作废并重新读取,不能把基于 32 的选择覆盖到 33。
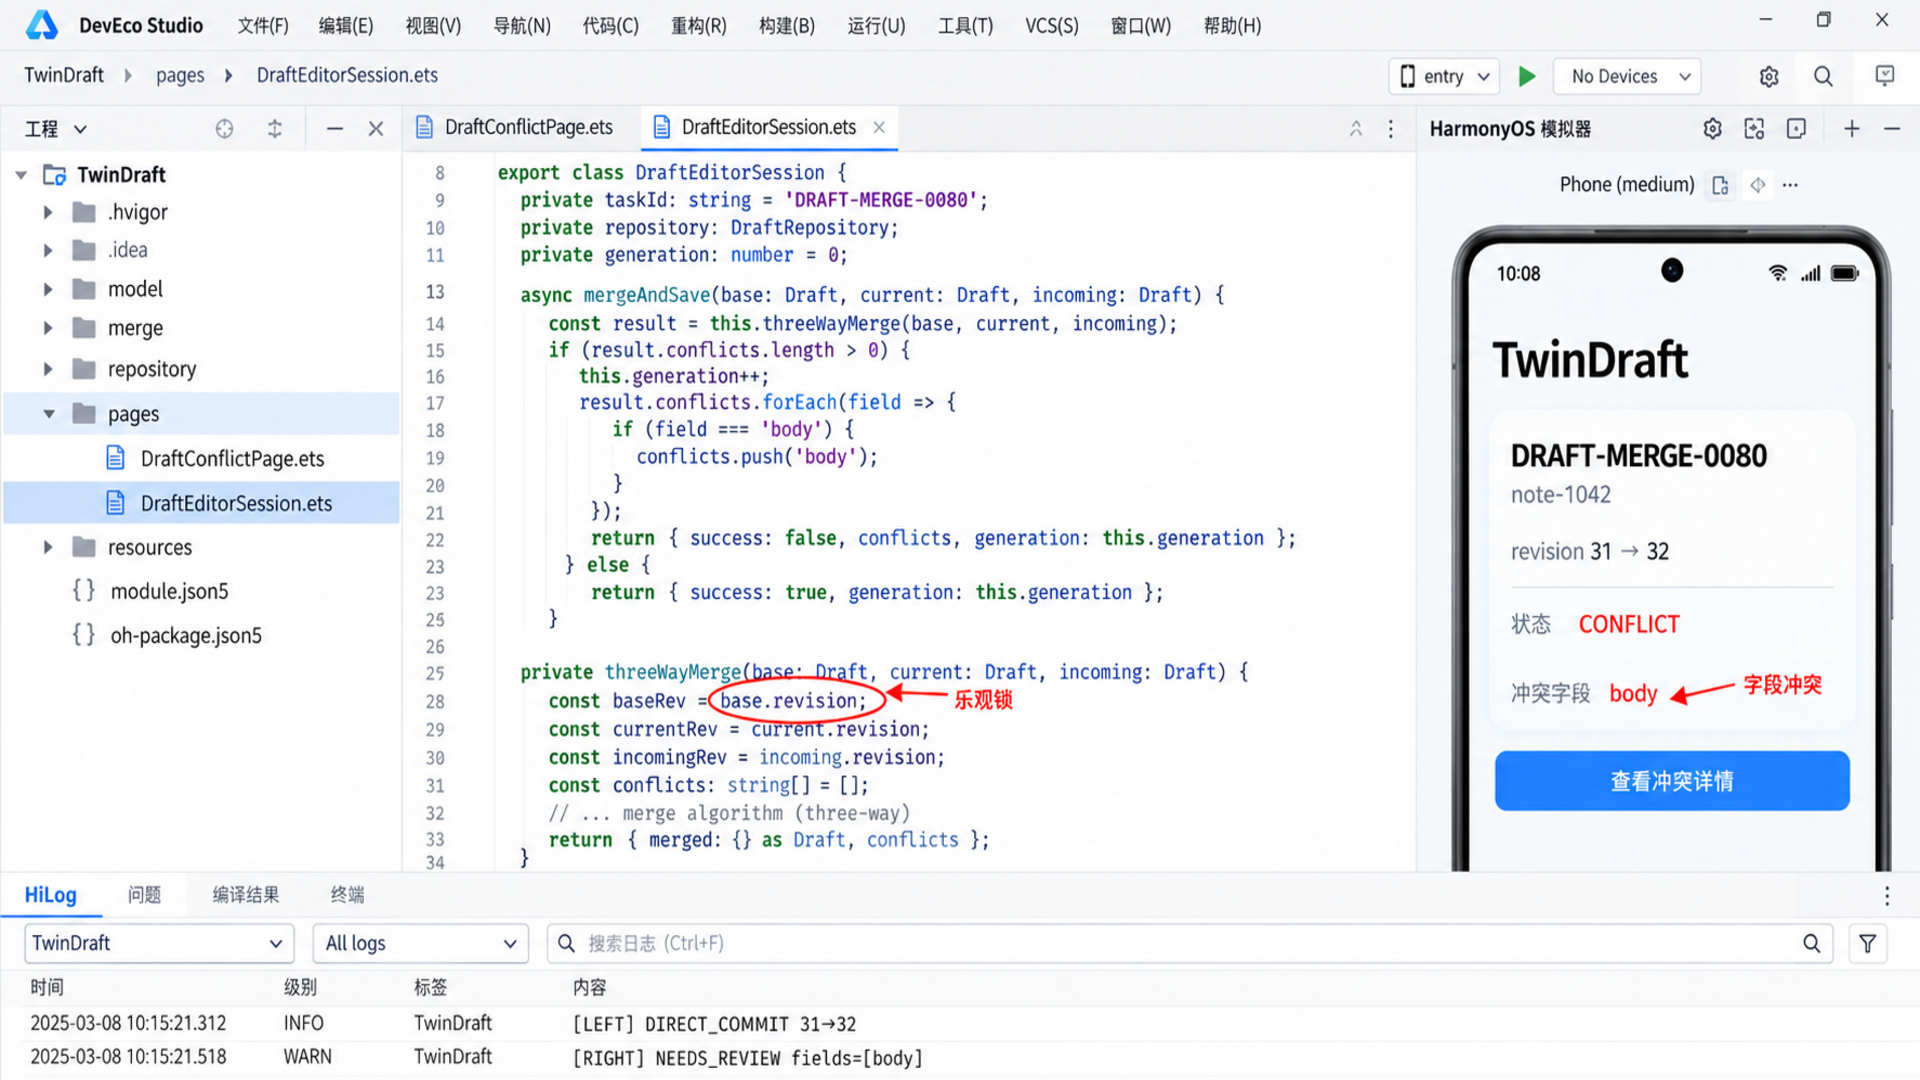
下图是对应的演示开发视图。左侧工程目录包含 merge、repository 和页面层;中间显示 threeWayMerge() 与 revision 判断;右侧模拟器显示 note-1042 / revision 31→32;底部 HiLog 是 DIRECT_COMMIT 后紧接 NEEDS_REVIEW fields=[body]。模拟器固定在右侧,红圈只标 revision 与冲突字段。
四、平行视界页面要共享事实,不共享未提交输入
平行视界下,左窗与右窗可以共享“当前已提交 revision”和“是否存在冲突”这类事实,但不应该把两个编辑器的未提交文本绑到同一个双向状态。否则右窗每敲一个字,左窗的输入模型也变化,用户还没保存就已经互相覆盖。
TwinDraft 为每个窗建立独立 DraftEditorSession,包含 windowId、base snapshot、working copy、dirty fields 和 generation。应用级只发布最新已提交记录的只读投影。窗口收到新 revision 后:如果没有未提交修改,直接刷新;如果 dirty fields 为空集合以外,则显示“远端已更新”,由用户决定刷新或继续提交进入合并。
这个设计也解释了为什么不能简单在 onPageShow 里重新加载并覆盖本地。平行视界的两个页面可能同时可见,生命周期回调不等于用户放弃编辑。页面出现、窗口获焦、业务草稿提交是三种不同事件,不应互相代替。
这段代码解决什么问题:让每个窗口拥有独立编辑会话,并用 generation 拒绝迟到保存结果更新已经切换的草稿。
class DraftEditorSession {
  readonly windowId: 'LEFT' | 'RIGHT';
  base: VersionedDraft;
  working: DraftData;
  dirty = new Set<DraftField>();
  generation: number = 1;

  constructor(windowId: 'LEFT' | 'RIGHT', draft: VersionedDraft) {
    this.windowId = windowId;
    this.base = draft;
    this.working = { ...draft.data, tags: [...draft.data.tags] };
  }

  edit(field: DraftField, value: string | string[]): void {
    (this.working[field] as string | string[]) = value;
    this.dirty.add(field);
  }

  beginSave(): { generation: number; request: CommitRequest } {
    return {
      generation: this.generation,
      request: { base: this.base, incoming: this.working }
    };
  }

  switchDraft(next: VersionedDraft): void {
    this.generation += 1;
    this.base = next;
    this.working = { ...next.data, tags: [...next.data.tags] };
    this.dirty.clear();
  }
}
generation 解决的是另一个竞态:右窗保存 note-1042 后立刻切到 note-1043,旧请求晚到。如果只看请求成功,页面可能把 1042 的 revision 显示到 1043 上。回调必须携带发起时的 generation,只有与当前会话一致才有 UI 提交权。
windowId 不应该参与业务主键。它只用于日志与交互归因;草稿身份仍然是 note-1042。如果把左窗草稿和右窗草稿存成两个业务对象,表面上没有冲突,实际上只是把一致性问题推迟到汇总阶段。
五、冲突页要告诉用户哪里不同,而不是只说保存失败
演示运行页在 14:21 展示两个窗的并发状态。左窗先提交:标题“周报-第40周”和正文修改进入 revision 32。右窗随后提交标签“鸿蒙、性能”和另一版正文,系统保留可自动合并的标签,同时把 body 标成唯一冲突字段。
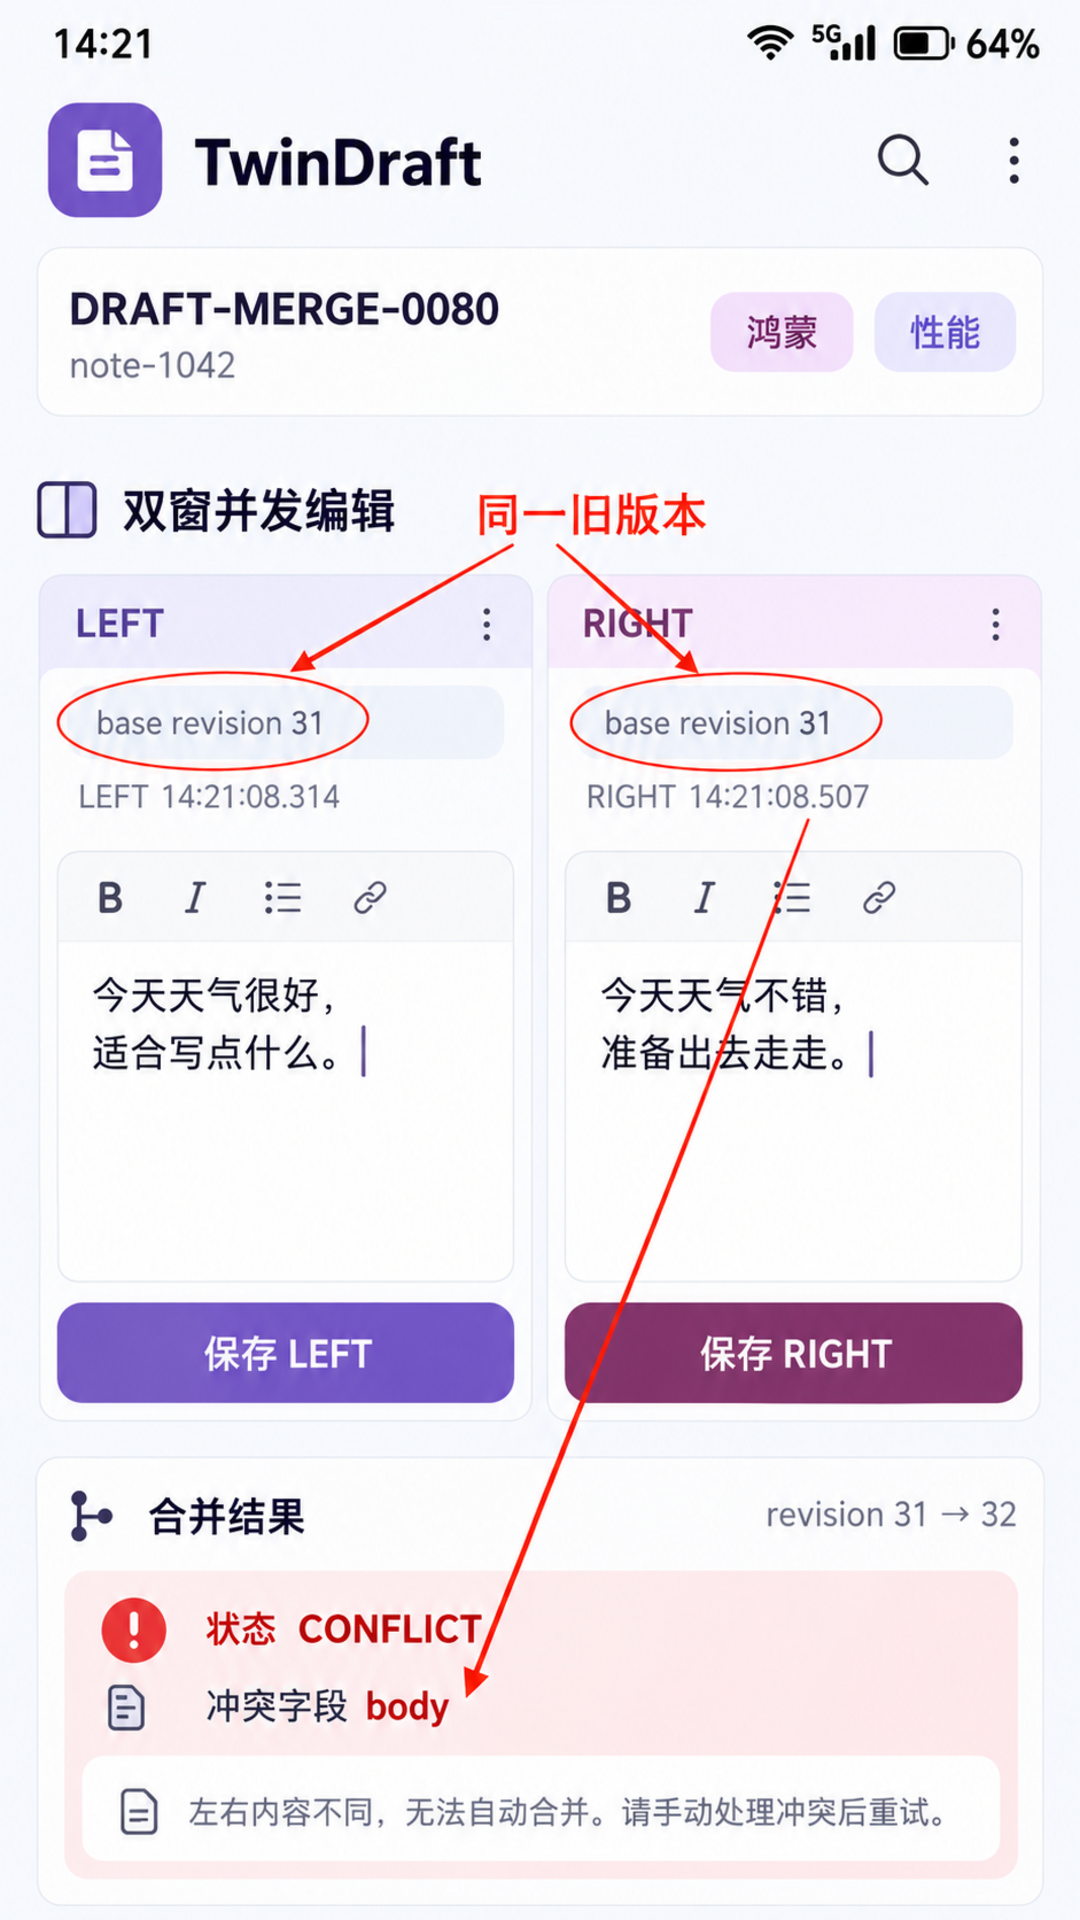
冲突界面不需要展示整份 JSON。它只显示三个版本的正文第 2 段:base、current、incoming,并提供“保留左窗”“采用右窗”“稍后处理”。标题和标签已经自动合并,不再让用户重复选择。
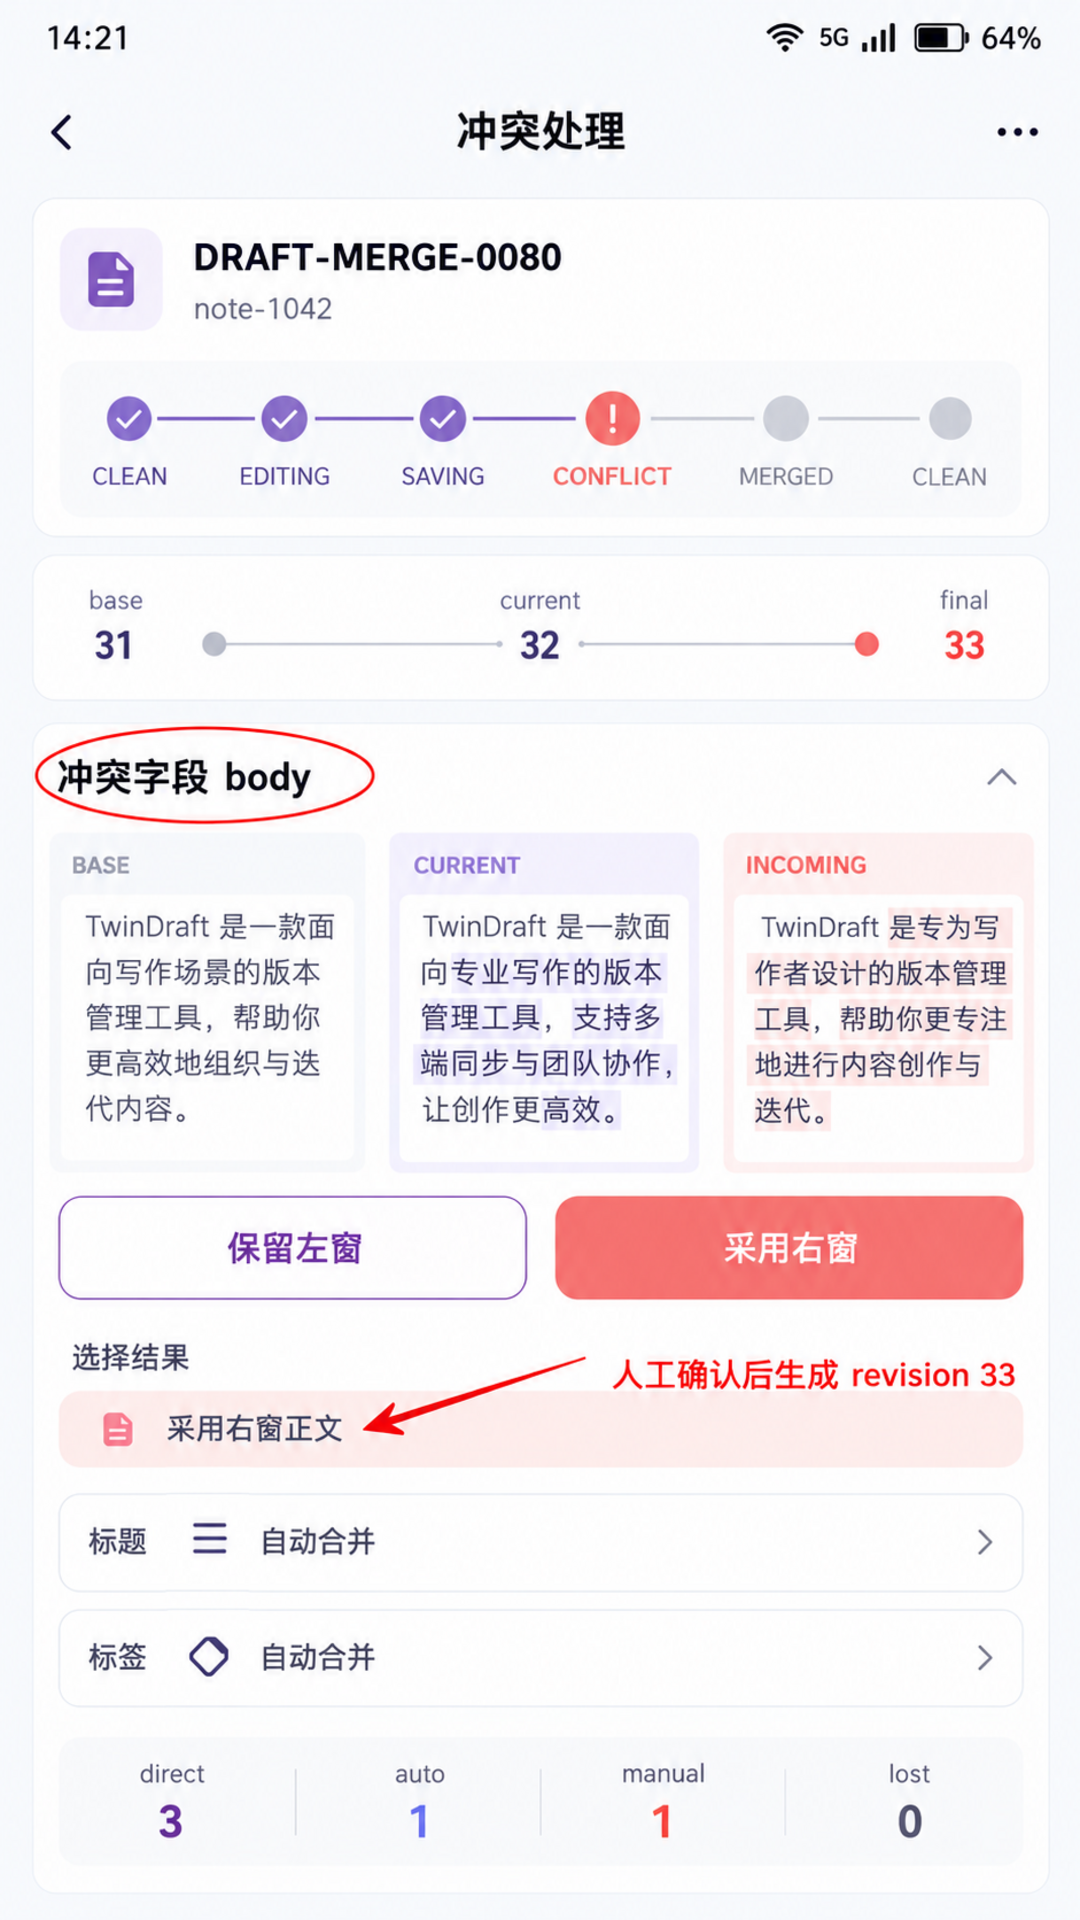
示例选择“采用右窗正文”后,系统基于当前 revision 32 生成新的提交,请求成功才进入 revision 33。注意,这不是把原来的失败请求重放;它是一个带新 base 的新命令。如果在选择期间 current 又变化,仍要重新检测。
诊断页记录 5 次保存尝试:3 次直接提交、1 次自动合并、1 次人工合并,lostUpdates=0。这些指标能帮助团队判断冲突策略是否过于粗糙。如果人工冲突比例持续很高,应该细化字段或段落粒度;如果自动合并很多但随后撤销也很多,说明“技术上可合并”未必符合业务语义。
这段代码解决什么问题:把提交结果映射为可观察的 ArkUI 状态,并确保迟到结果不能改写已切换的会话。
@Entry
@Component
struct DraftConflictPage {
  @State taskId: string = 'DRAFT-MERGE-0080';
  @State phase: string = 'CONFLICT';
  @State revisionText: string = '31 → 32';
  @State conflictField: string = 'body';
  @State progress: number = 80;

  private applyResult(result: CommitResult,
    expectedGeneration: number, currentGeneration: number): void {
    if (expectedGeneration !== currentGeneration) return;
    if (result.kind === 'NEEDS_REVIEW') {
      this.phase = 'CONFLICT';
      this.conflictField = result.conflicts.join(',');
      this.progress = 80;
      return;
    }
    this.phase = 'CLEAN';
    this.revisionText = `${result.value.revision - 1} → ${result.value.revision}`;
    this.progress = 100;
  }

  build() {
    Column({ space: 14 }) {
      Text('TwinDraft').fontSize(28).fontWeight(FontWeight.Bold)
      Text(this.taskId)
      Text(`状态 ${this.phase}`)
      Text(`revision ${this.revisionText}`)
      Text(`冲突字段 ${this.conflictField}`)
      Progress({ value: this.progress, total: 100 })
    }.padding(24).alignItems(HorizontalAlign.Start)
  }
}
这里的 applyResult() 只演示 UI 提交权。它没有把仓库塞进组件,也没有声称 @State 能提供持久化。实际项目要把会话协调器放在页面外,并在页面销毁时解除订阅;否则双窗多次打开后,旧页面仍可能收到 revision 广播。
详情图把状态变化展开为:CLEAN → EDITING → SAVING → CONFLICT → MERGED → CLEAN,并列出 base 31、current 32、final 33。红圈落在 body,红箭头指向“采用右窗正文”;标题与标签旁标注“自动合并”,让技术解释集中在真正的冲突上。
六、几种看似省事、实际会丢数据的实现
第一种是 last-write-wins。它实现简单,却把保存到达顺序当成业务正确性。网络抖动、磁盘调度或页面切换都能改变到达顺序,用户无法预测谁覆盖谁。
第二种是只用时间戳。两个设备或进程的时钟不一定一致,毫秒时间也不能证明提交基于哪个版本。revision 是逻辑顺序,时间只适合日志。
第三种是所有字段冲突都自动拼接。标签可以做集合合并,正文却不能简单把两个字符串相加;金额、状态、审批结论更不适合。合并策略必须按字段定义,而不是由通用工具臆测。
第四种是把 UI 状态库当数据库。AppStorage、LocalStorage 能帮助组件同步展示,但它们不替代原子持久化。双窗看到同一对象,不等于两个写入已经获得串行语义。
第五种是保存失败后直接刷新。刷新确实消除了冲突提示,也一起消除了用户未提交内容。正确做法是保留 working copy,展示差异,并允许复制或选择。
第六种是冲突确认时沿用旧 base。人工选择可能持续数十秒,期间仓库还会变化;确认操作必须以最新 current 为 base 重新提交。
七、边界:乐观锁适合低冲突,不适合所有协作编辑
字段级三方合并适合“同一草稿偶尔被两个窗修改”的场景。它实现成本可控,冲突时也能给出清楚解释。但如果产品目标是多人实时协作、逐字同步和离线编辑,仅靠 revision 会频繁冲突,需要进一步评估 OT、CRDT 或服务端操作日志。
对于不可合并字段,例如支付状态、审批结果和库存扣减,应该直接使用更严格的业务命令与幂等键,不要套用文本合并。
对于大正文,可以给段落稳定 ID,把冲突粒度从整篇降到段落;但段落移动、拆分与合并仍需要额外规则。粒度越细,自动合并率越高,调试成本也越高。
TwinDraft 的验收标准因此很朴素:同一 base 的两个窗口同时提交时,不发生静默覆盖;互不重叠字段可自动合并;重叠字段进入可解释确认;窗口切换后旧回调不能污染新草稿;每次成功提交 revision 单调递增。
在固定演示中,note-1042 走完 revision 31→32→33,保存尝试 5 次,direct 3、auto merge 1、manual merge 1,最终 lostUpdates=0。真正项目应把这些指标接入测试与日志,并明确区分“示例通过”和“设备实测通过”。
平行视界只是让并发更容易被用户看见。问题的根仍然是:业务对象是否有版本,保存是否携带 base,仓库是否原子检查,冲突是否能解释。把这四件事补齐之后,双窗才不只是把两个页面摆在一起,而是让两个编辑上下文安全地共享同一份事实。
八、用事件序列验证,而不是靠快速点几下
并发问题最大的调试陷阱,是人工操作通常太慢。开发者左边改完、点击保存,再去右边修改,两个请求已经自然串行,看起来永远不会冲突。真正的测试应固定事件序列,把两个窗口的读取、编辑、提交和回调顺序写成可重放步骤。
TwinDraft 的核心向量从 revision 31 开始。步骤一,LEFT 与 RIGHT 同时读取 note-1042@31。步骤二,LEFT 修改 title 与 body,RIGHT 修改 tags 与 body。步骤三,LEFT 提交并生成 32。步骤四,RIGHT 仍携带 base 31 提交。预期结果不是失败异常,而是 NEEDS_REVIEW,冲突集合严格等于 [body],title 保留 LEFT 值,tags 接纳 RIGHT 值。步骤五,用户选择 RIGHT 正文,以 32 为新 base 提交,得到 33。
这个向量同时验证四件事:revision 比较有效、非冲突字段没有丢、冲突字段没有被擅自决定、人工选择使用了新 base。只断言最终 revision=33 不够,因为一个错误的 last-write-wins 实现也可能得到 33,却已经丢掉标题。
第二组向量专门测试迟到回调。RIGHT 在 generation 7 发起保存,随后切换到 note-1043,generation 变成 8。旧请求返回成功,但 UI 必须保持 1043,不更新 revision 文本,也不弹出 1042 的成功提示。仓库中的 1042 可以正常提交,UI 提交权与业务提交权要分开判断。
第三组向量测试冲突确认期间再次变化。RIGHT 收到基于 current 32 的冲突页,尚未选择时,LEFT 又把记录提交到 33。RIGHT 点击“采用右窗正文”时不能直接写出 34,而应先发现 current 已变化,重新构造三方比较。若 33 没改 body,可以继续;若 33 也改了 body,需要展示新的差异。
第四组向量测试标签语义。如果标签定义为无序集合,[鸿蒙, 性能] 与 [性能, 鸿蒙] 应视为相同;如果 UI 支持用户排序,则顺序本身也是业务数据,不能擅自排序。合并器必须使用领域规则,不能把所有数组都用同一个 JSON 字符串比较。
1. 日志要能回答“谁基于谁提交”
普通成功日志只写 save success,对并发分析几乎没有帮助。每条提交至少记录 taskId、draftId、windowId、baseRevision、observedRevision、resultKind、conflictFields、generation 和耗时。敏感正文不应进入日志,字段路径和摘要已经足够定位顺序。
对于本例,一条可读时间线应是:LEFT base=31 observed=31 direct→32;RIGHT base=31 observed=32 review [body];RIGHT resolution base=32 direct→33。看到这三行,开发者就能判断冲突来自正常并发,而不是重复点击或请求重试。
还要区分请求 ID 与草稿 ID。请求 ID 用于去重一次保存命令,草稿 ID 用于定位业务对象,revision 用于表达版本顺序,generation 用于限制 UI 回调。四者职责不同,不能拿一个万能 id 混用。否则日志虽然字段很少,排查时却无法回答任何一个关键问题。
2. 离线与重试要保留原始 base
离线队列恢复时,不能把 baseRevision 改成当前最新值再重试。那相当于告诉仓库“这些改动是基于最新内容产生的”,会绕过冲突检测。正确做法是保留用户编辑时的 base snapshot;恢复联网后,先拉 current,再做三方比较。
请求超时也不能直接认为提交失败。服务端可能已经写入,只是响应丢失。提交命令需要稳定 requestId 或幂等键,客户端重试后先查询该命令是否已经生效。幂等解决“同一个命令执行两次”,revision 解决“旧版本覆盖新版本”,两者不能互相替代。
如果仓库在本地关系数据库,应用异常退出后也要能恢复待处理冲突。只把冲突对象放在页面 @State 中,进程被回收后用户的选择上下文就丢了。可以持久化 base revision、dirty fields 和 working copy,但应控制保存频率,并明确清理时机。
3. 生命周期收口必须成对
两个窗口订阅同一份 revision 广播时,注册和解除必须成对。页面重新创建、平行视界形态变化或窗口关闭,都可能留下旧监听器。一个提交触发三次回调,会造成重复提示、重复刷新,甚至让旧 generation 的页面重新出现。
协调器应持有稳定的回调引用,在页面可交互阶段注册,在销毁或不再需要时解除;不能 on() 时使用匿名函数,off() 时再创建另一个匿名函数。日志可以记录 listener count,演示期也应把重复订阅当作错误,而不是无害告警。
编辑会话自身也要释放大对象。正文编辑器可能持有图片、附件或撤销栈,切换草稿时不能只改 ID。先提升 generation,取消不再需要的异步任务,再释放旧 working copy,最后载入新 base,顺序比“全部清空再说”更安全。
4. 结果指标不能只看冲突率
低冲突率不一定说明设计好,也可能是系统在静默覆盖。至少要同时观察 direct、auto merge、manual merge、stale rejected、lost update 和用户取消次数。lostUpdates 不能靠运行日志自报为 0,需要通过测试向量比较最终字段集合。
人工合并率过高,可能意味着字段粒度太粗;自动合并后撤销率高,可能意味着规则不符合用户预期;stale rejected 突增,可能意味着页面切换后旧请求没有及时取消。指标要和事件序列一起看,不能把“自动合并越多”当作单一目标。
本批演示固定显示 direct=3、auto=1、manual=1、lost=0。它让正文、代码、日志和图片共享同一份数据字典,也明确保持“示例演示”标签。真正项目上线前,还需要在支持平行视界的目标设备和不同窗口组合上验证焦点、页面生命周期与数据库事务,这部分不能由一张模拟器配图替代。
最终,乐观锁的价值不是制造一个更复杂的保存按钮,而是把原先不可见的覆盖风险变成可判断的状态:版本相同就直接提交,字段独立就自动合并,字段重叠就请用户决定,会话过期就拒绝 UI 回写。每一步都能解释,才适合进入双窗界面。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)