
HarmonyOS 7 Spatial Recon Kit + Camera Kit:3DGS 采集帧背压与温控降级的质量预算调度【鸿蒙心迹】
这次不是模型算不出来,而是相机给得太快。采集两分钟后,预览依然顺滑,重建队列却已经积了十几帧;等手机发热,系统开始限频,前面的积压反而把后面的有效视角拖成了“过期数据”。
我把问题拆成了一个小工程:ReconBudget Lab。本次任务编号是 recon_20261001_21,相机输入 30 fps,重建端的稳定吞吐只有 18 fps。如果每帧都保留,延迟会持续上涨;如果随机丢帧,帧率降下来了,视角覆盖却可能断层。
16:06 的最终运行状态固定为 DEGRADED:设备热状态 WARM,当前质量档 BALANCED,接收 30 fps、入队 18 fps,队列深度 4 / 6,累计丢弃 96 帧,已融合 642 帧,高斯点数 142 万。这组数据不追求“全部吃掉”,而是让管线在可预期的时延内继续收敛。
一、相机帧率不等于重建吞吐
Spatial Recon 管线需要连续的图像、位姿与时间戳,但“连续”不等于一帧不落。端侧 3DGS 还要做特征提取、可见性判断、高斯参数更新与阶段性缓存,某个阶段一旦慢下来,上游相机仍会按固定节奏产生数据。
最初的实现是在帧回调中直接调用 session.submit(frame)。前 20 秒看不出问题,队列也只偶尔到 2。当融合阶段的单帧耗时从 32 ms 上涨到 55 ms,队列开始单向增长。此时再使用“处理完一帧再取下一帧”,只是把堆积从 native 层换到 ArkTS 层。
我更关心三个量:队列深度、队首帧年龄和新帧的视角价值。队列深度回答“挤了多少”,队首帧年龄回答“旧到什么程度”,视角价值则决定“新帧值不值得换掉旧帧”。
二、入队之前先做采样,不在队尾做无限等待
当前需要解决的不是“如何把数组 push 进去”,而是超出预算时保留哪帧。我使用一个最多 6 帧的有界队列,在队列未满时正常接受;队列已满时,比较新帧与最后入队帧的位移、旋转以及清晰度。只有视角足够新,才替换队尾;否则当场丢弃。
下面这段代码解决的是“队列满了以后,不要随机丢掉有价值视角”的问题。
export class FrameAdmission {
  private queue: ReconFrame[] = []
  private readonly capacity: number = 6
  private lastAccepted?: ReconFrame

  offer(frame: ReconFrame, budget: CaptureBudget): AdmissionResult {
    const interval = 1000 / budget.targetFps
    if (this.lastAccepted && frame.timestampMs - this.lastAccepted.timestampMs < interval) {
      return { accepted: false, reason: 'FPS_BUDGET' }
    }

    const novelty = poseDistance(frame.pose, this.lastAccepted?.pose)
    if (this.queue.length >= this.capacity) {
      if (novelty < budget.minPoseDelta) {
        return { accepted: false, reason: 'LOW_NOVELTY' }
      }
      this.queue[this.queue.length - 1]?.release()
      this.queue.pop()
    }

    this.queue.push(frame)
    this.lastAccepted = frame
    return { accepted: true, reason: 'ADMITTED' }
  }
}
这里有两个容易忽略的资源问题。第一,被拒绝的帧不能只从数组里移除,底层图像缓冲必须按封装约定释放;第二,被替换的队尾帧也要释放,否则 UI 上的队列长度是 6,实际图像内存却会一直涨。当前 Demo 的 ReconFrame.release() 是一次性的,重复调用只记录警告,正式工程应让帧所有权在“相机—队列—重建会话”之间只转移一次。
这个策略也没有拿固定的 18 fps 当真理。targetFps 是质量预算的输入,热状态、单帧耗时与队首年龄都可以让它上下浮动。
三、温控降级要改“预算”,不要突然停掉会话
发热后直接暂停相机是最容易写的方案,但用户会立刻丢掉扫描节奏,已经稳定的位姿追踪也要重新建立。我把热状态映射成三档预算:QUALITY 保留 24 fps,BALANCED 保留 18 fps,SURVIVAL 保留 12 fps,并同时调整特征尺寸与阶段性优化频率。
下面这段代码解决的是“热状态短时间抖动,档位在 18 和 12 fps 之间来回跳”的问题。
export class BudgetGovernor {
  private profile: BudgetProfile = BudgetProfile.QUALITY
  private pending?: BudgetProfile
  private pendingSince: number = 0

  update(thermal: ThermalLevel, queueDepth: number, now: number): CaptureBudget {
    const next = thermal >= ThermalLevel.HOT || queueDepth >= 6
      ? BudgetProfile.SURVIVAL
      : thermal >= ThermalLevel.WARM || queueDepth >= 4
        ? BudgetProfile.BALANCED
        : BudgetProfile.QUALITY

    if (next !== this.profile) {
      if (this.pending !== next) {
        this.pending = next
        this.pendingSince = now
      } else if (now - this.pendingSince >= 1500) {
        this.profile = next
        this.pending = undefined
      }
    }
    return budgetOf(this.profile)
  }
}
1.5 秒的稳定窗口是当前 Demo 的工程选择,不是系统固定值。它让档位只在趋势确认后切换,也让日志能解释 QUALITY -> BALANCED 是由 WARM + queue=4 引起,而不是偶发的一次耗时峰值。
升档和降档不应对称。降档要快,以避免队列继续积压;恢复到 QUALITY 要多观察几个窗口,否则温度刚降就把负载又拉满。正式项目还应把电量、充电状态和用户选择的质量模式纳入策略,不能只看一个热等级。
四、消费端只拉取一帧,页面只订阅摘要
第二个性能陷阱是让 UI 直接订阅每帧的完整调试对象。一帧内包含位姿矩阵、清晰度、特征数量和内部时间点,30 fps 刷新到页面,反而会让调试面板成为新的卡顿源。
下面这段代码解决的是“重建消费和 UI 刷新互相干扰”的问题。消费循环一次只从队首取一帧,转移给 native 会话后立即更新计数;页面每 250 ms 读取一份不可变快照。
export class ReconCoordinator {
  private running: boolean = false
  private accepted: number = 0
  private dropped: number = 0

  async drain(): Promise<void> {
    if (this.running) return
    this.running = true
    try {
      while (!this.queue.isEmpty() && this.lifecycle === 'FOREGROUND') {
        const frame = this.queue.shift()
        if (!frame) break
        try {
          await this.nativeSession.submit(frame)
          ++this.accepted
        } finally {
          frame.release()
        }
      }
    } finally {
      this.running = false
    }
  }

  snapshot(): ReconSnapshot {
    return Object.freeze({
      taskId: 'recon_20261001_21',
      state: this.governor.profile === BudgetProfile.QUALITY ? 'RUNNING' : 'DEGRADED',
      acceptedFps: this.metrics.acceptedFps,
      queueDepth: this.queue.size,
      dropped: this.dropped
    })
  }
}
running 防止相机回调连续触发多个消费循环。页面退到后台时,循环不再拉取新帧,队列中尚未消费的图像统一释放;重新回到前台后,由新的相机时间戳重建采集基线,不使用后台前的旧帧。
当前 Demo 为了看清背压,把丢帧原因分成 FPS_BUDGET、LOW_NOVELTY和 QUEUE_REPLACE。正式产品日志不需要记录每一帧,可以每秒聚合一次,否则日志 I/O 会改变原本想测量的管线耗时。
1. 从四行日志反推管线卡在哪里
第一版日志只打印“已处理帧数”,数字一直增长,看起来很正常。直到我把采集、入队、融合和释放四个计数拆开,才发现“处理进度在走”不等于“新数据没有堆积”。采集每秒增加 30,融合只增加 18,中间的 12 如果没有受控去向,就是未来的内存和延迟。
现在每秒只输出一份 PipelineTick:相机产生多少帧、入队多少帧、主动丢弃多少帧、重建完成多少帧,再加上队首年龄和当前预算档。如果采集与入队的差值稳定,队列也没有增长,说明丢帧是有意图的采样;如果入队和融合的差值持续增大,才说明消费端跟不上。
调试期间还出现过一个反直觉现象:队列已经回到 1,手机仍然很热。检查后发现,重建会话在队列空闲时触发了更频繁的局部优化,所以只看队列深度会错把高计算负载判成“已恢复”。我因此把滑动窗口内的单帧融合耗时和优化耗时也纳入升档条件,只有两者同时回落,才从 BALANCED 回到 QUALITY。
2. 异常不能让队列失去所有权
native 会话拒绝某一帧时,最容易出现的是“谁来释放”不明确。如果 submit() 失败后底层已经回收图像,ArkTS 的 finally 再释放一次,就可能变成重复回收;如果双方都认为对方会处理,又会变成泄漏。ReconBudget Lab 把规则定死:submit() 只借用数据,帧所有权一直在协调器,无论成功还是失败都由同一个 finally 收口。
连续失败三帧后,状态从 DEGRADED 进入 PAUSED_ERROR,停止新帧源并释放队列,不再用“继续丢帧”掩盖真实异常。用户重试时会创建新的采集代号,旧回调即使晚到,也只会释放自己携带的帧,不会改写新会话的队列和指标。
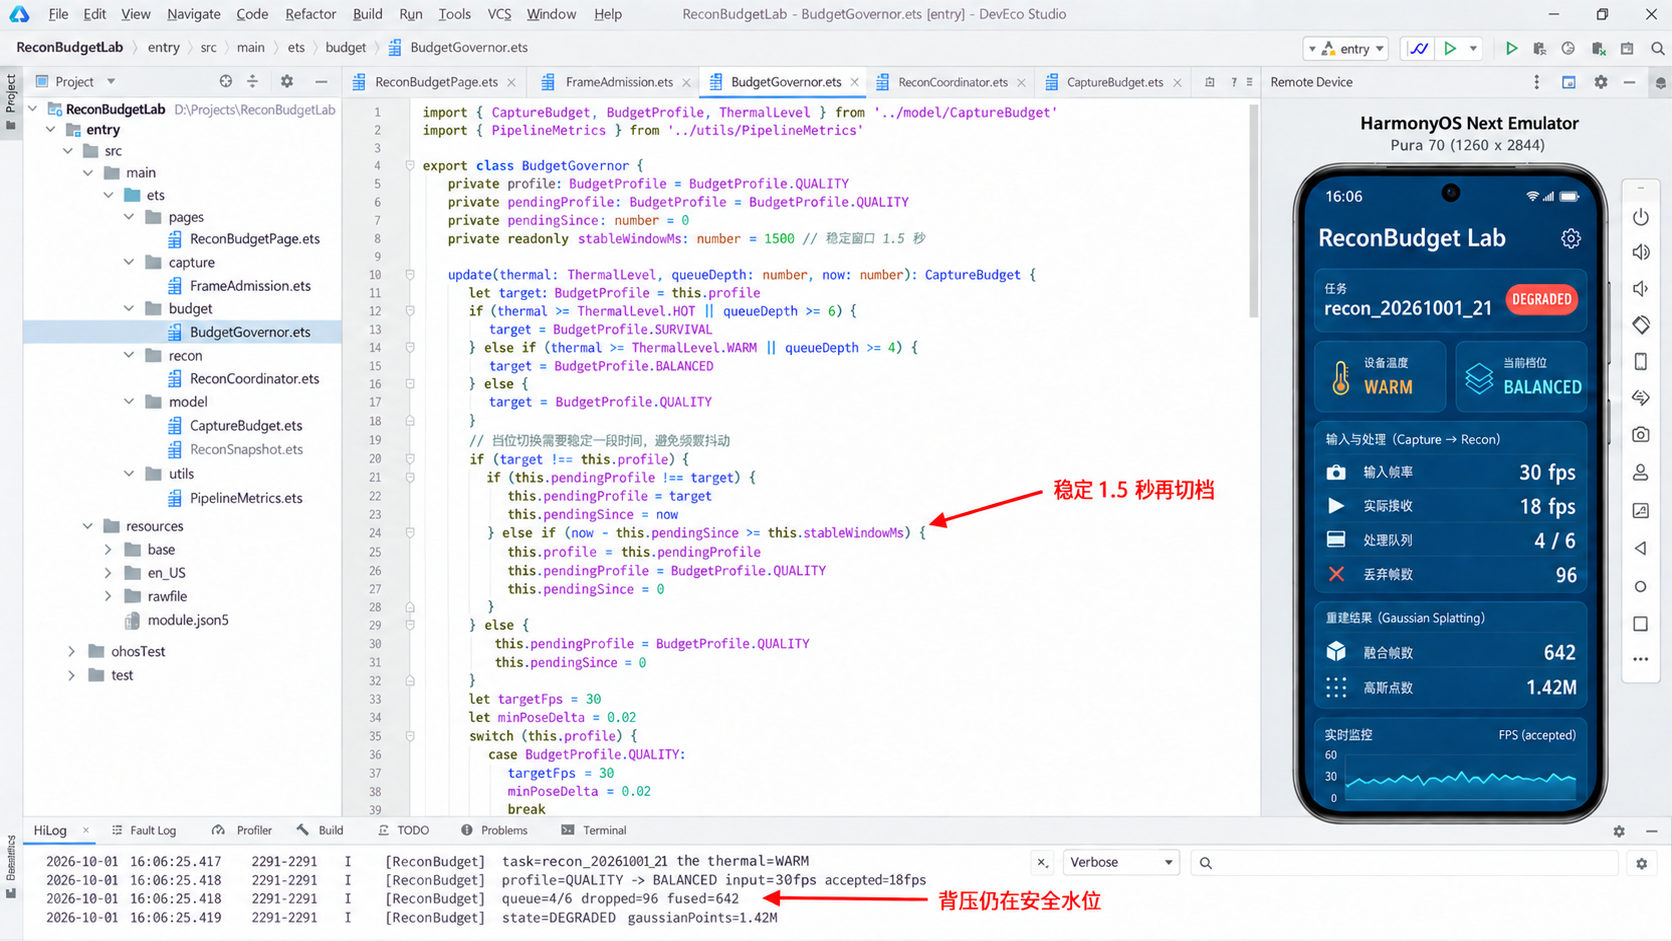
DevEco Studio 图中,左侧是 capture / budget / recon / model 四层,中间停在 BudgetGovernor.ets,右侧模拟器展示 recon_20261001_21。底部 HiLog 的关键数据是 30 -> 18 fps、queue=4/6、dropped=96 与 QUALITY -> BALANCED,这几个数放在一起,才能判断是主动降级,而不是相机无故掉帧。
五、看到 DEGRADED,不代表这轮重建失败
运行页没有把降档包装成一个红色错误。DEGRADED 的意思是当前会话仍在处理,但已主动收紧质量预算。页面展示输入帧率、接收帧率、队列、丢帧、融合数和高斯点数,用户可以继续扫描,也可以暂停等待设备降温。
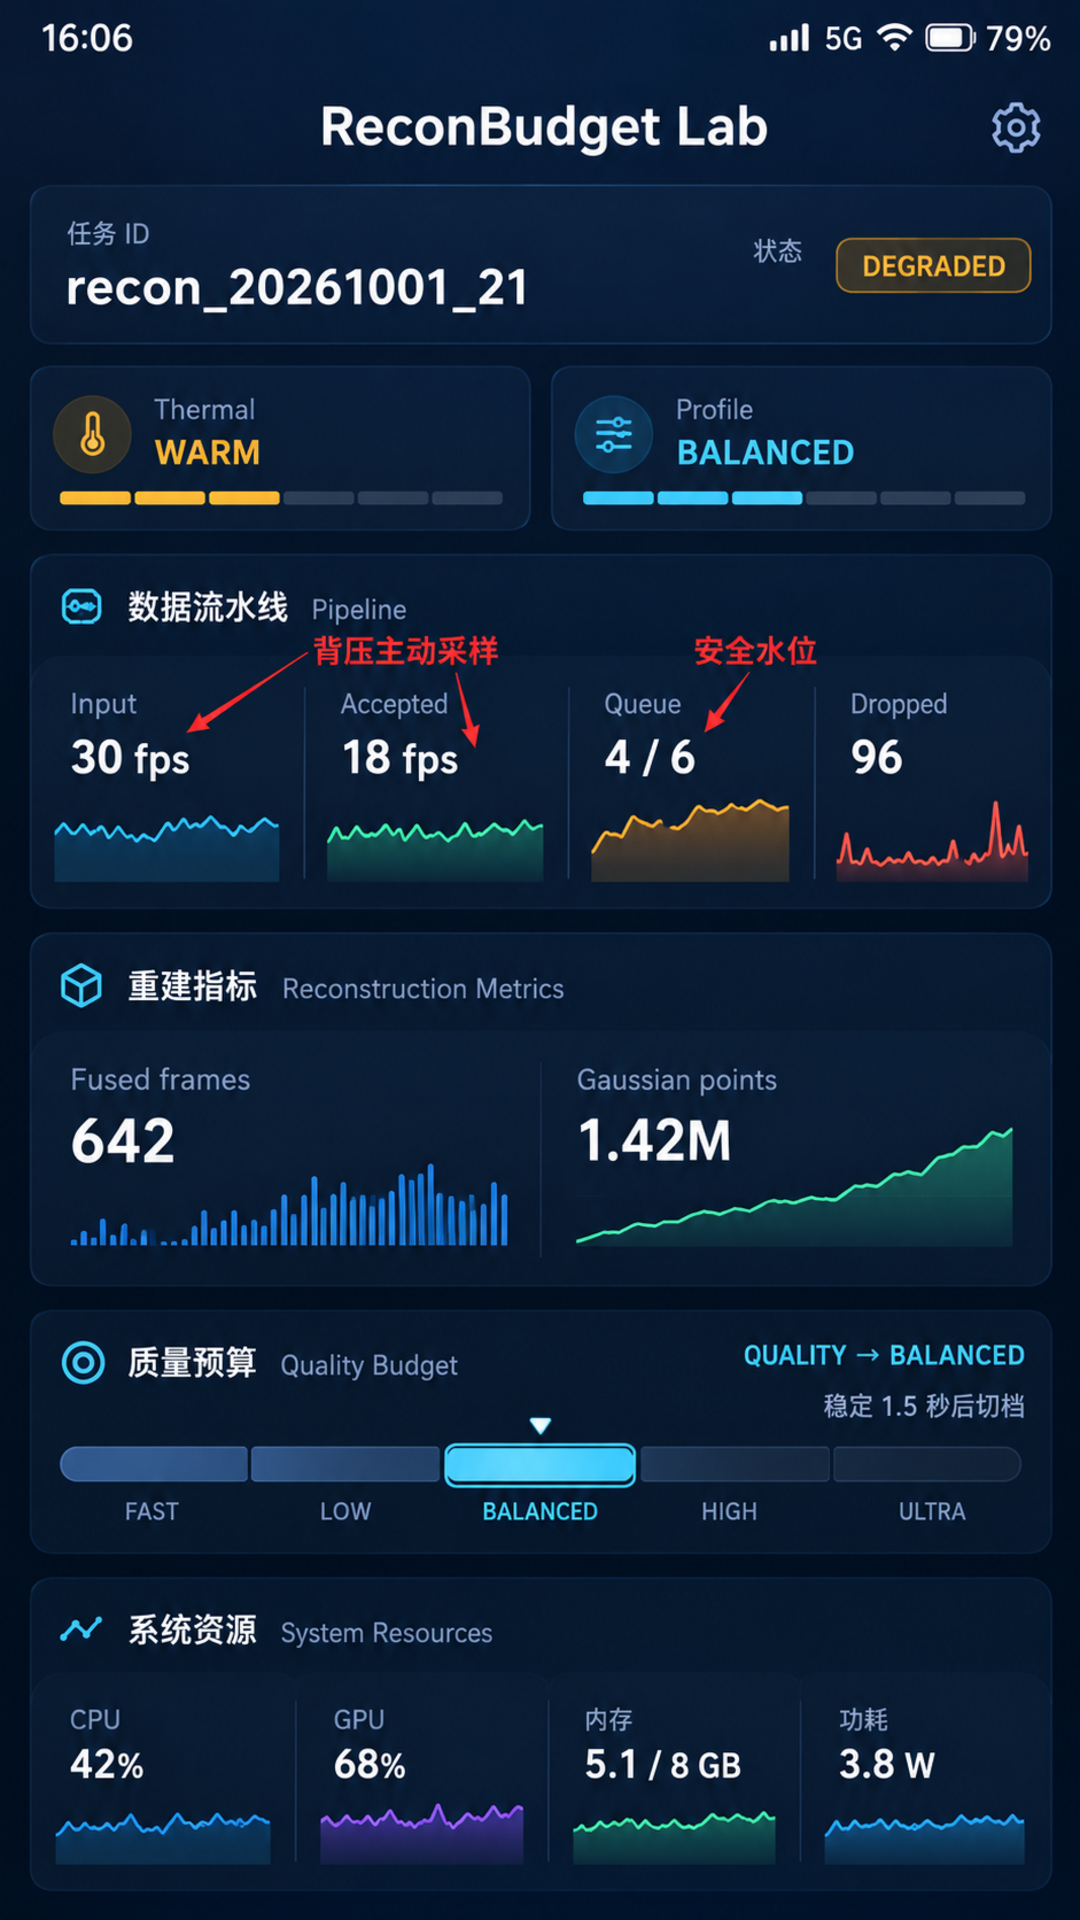
16:06 的手机页保持了同一组运行数据:WARM / BALANCED / DEGRADED,30 fps 输入,18 fps 入队,队列 4 / 6,丢弃 96 帧,融合 642 帧,高斯点数 142 万。红色细箭头只标了两个判断:帧率差是背压结果,4 / 6 是当前仍可恢复的安全水位。
验收时我不只看最终模型,而是做三组对照。第一组固定 30 fps 且不丢帧,队首年龄超过 1.8 秒;第二组随机丢帧,时延下来了,但家具边缘出现空洞;第三组使用视角价值与热预算,队首年龄稳定在 260 ms 内,且扫描路径上的新视角没有明显缺口。
六、还有几个边界不能被 Demo 掩盖
第一,丢帧策略不能只看时间。用户转身很快时,低帧率下仍应保留姿态差足够大的帧;用户原地停留时,即使时间间隔到了,低新颖度帧也不一定需要进管线。
第二,热降级是设备级现象。后台还有导航、录屏或其他 AI 任务时,同一套机型上的稳定吞吐也会变。预算不要写成机型表的硬编码。
第三,切到后台要先停止帧源,再清空队列,最后挂起重建会话。顺序反了,相机回调可能在清理过程又塞进新帧。这类竞态很难在短时 Demo 里出现,长时间扫描却很常见。
第四,质量不能只用高斯点数衡量。点多可能是重复观测堆出来的,还要观察视角覆盖、表面空洞、边缘稳定性和最终包体。当前的 142 万是一个运行证据,不是通用合格线。
第五,不同阶段的帧价值不一样。会话刚开始时,管线需要快速建立粗略结构,视角覆盖比局部细节更重要;进入稳定阶段以后,清晰度和重投影误差才应获得更高权重。如果从头到尾只用一个 minPoseDelta,可能前期收得太紧、后期又放得太宽。我在实际产品里会让采样阈值跟随管线阶段,而不是跟随一个全局常量。
第六,调试数据应该能回放。只看手机现场的实时数字,很难比较两套预算策略。ReconBudget Lab 会保留每秒的聚合快照,包括帧率差、队首年龄、温控档位、丢帧原因分布和阶段耗时。同一段扫描路径分别使用“不丢帧”、“随机丢帧”和“质量预算”运行,再把快照与最终模型一起比较。这能防止我们因为某次设备恰好比较凉,就误判新策略更好。
第七,采集提示也是调度的一部分。当队列连续升到 5,页面不会只在右上角改一个档位,而是提示用户放慢移动,尤其不要在短时间内大幅转身。这不是把性能问题甩给用户,而是让采集节奏与当前设备预算匹配。提示只在背压持续数秒后出现,队列回到 3 以下就自动收起,避免短时波动反复打断扫描。
七、让管线稳定,比让每帧都进去更重要
这次修正后,我对“丢帧”的看法变了。它不一定是管线失败的证据;在有界队列、视角采样和资源释放都可解释时,主动丢掉低价值帧,反而是保住重建时效性的必要手段。
recon_20261001_21 最终没有回到 QUALITY,而是在 BALANCED 档完成本轮采集。它看起来不如全程 30 fps 漂亮,但队列没有失控,重建结果没有被两秒前的旧视角拖着跑,手机页上的每个数也都能对应一次真实的调度决策。
这也是我给后续模型调参留下的底线:先保证输入是新鲜、有界、可释放的,再谈特征数量和训练轮数。否则上层再精细的质量参数,也只是在替失控的采集管线补洞。工程上真正可持续的优化,往往从承认设备预算有上限开始。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 5
 0
- 0


 已为社区贡献10条内容

所有评论(0)