
HarmonyOS 7 DevEco CLI + Node.js:module.json5 权限声明与隐私清单的构建前对账脚本【鸿蒙心迹】
这篇来自一次很典型的“代码没报错、构建也成功,但提审前越看越心虚”的场景:module.json5 里权限改过几轮,隐私政策也改过几轮,最后到底是不是一一对应,靠人工翻两份文件很难放心。
一、我想解决的不是审核规则,而是提交前没人敢保证“这两份东西一致”
应用上架前最容易让人疲劳的检查,往往不是一个复杂 API,而是配置之间的对账。
这次 Demo 叫 ReviewGuard。我给它设定的目标很窄:构建前读取 entry/src/main/module.json5 中的 requestPermissions,再读取团队自己维护的一份 tools/privacy-manifest.json,比较两边权限集合。如果代码声明了权限,但内部隐私清单里没有对应条目,就标记为 undeclared;如果隐私清单里还留着项目已经不用的权限,就标记为 orphan。
先强调一个边界:privacy-manifest.json 是我为了工程自检设计的内部文件,不是华为应用市场要求上传的标准文件,也不能替代隐私政策、SDK 隐私声明或审核材料。这个工具只做“研发仓库内的一致性检查”。
官方上架说明里反复强调,涉及第三方 SDK 时,需要在隐私政策中明示其处理个人信息的目的、方式和范围;部分 SDK 的合规指南还会要求在用户同意后再初始化。我的想法不是把法规变成脚本,而是把最机械、最容易漏掉的配置差异提前拦在构建之前。
本次 Demo 固定数据如下:
- Build ID:
review_guard_20261001_03 - App Version:
2.3.0(20300) Request Permissions = 6Privacy Items = 6Undeclared = 0Orphan = 0- 最终状态:
PASS - 检查时间:
2026-10-01 02:59:42
二、先把“隐私清单”做成工程里能被机器读懂的结构
以前我见过一种维护方式:权限和用途全写在项目 Wiki 或 Word 表格里。人看很方便,脚本没法稳定读取,结果就是每次还是要人工核对。
ReviewGuard 里我新建了一个内部文件:
{
  "version": "2.3.0(20300)",
  "permissions": [
    {
      "name": "ohos.permission.CAMERA",
      "purpose": "用于拍摄用户主动创建的内容"
    },
    {
      "name": "ohos.permission.MICROPHONE",
      "purpose": "用于用户主动发起的语音录入"
    }
  ]
}
这段不是为了把所有隐私说明塞进 JSON,而是解决一个更简单的问题:让每一条系统权限都能在代码仓库里找到对应的业务用途。
真实项目里,我会给每个条目继续补 featureOwner、policySection、enabled 等字段,但不会把法务文本原样复制进来。内部清单的角色应该是索引,不是最终隐私政策。
另一个取舍是权限名称必须使用 module.json5 里同样的原始值。不要自己再造别名,例如不要一边叫 CAMERA,另一边叫 cameraPermission。对账脚本越“聪明”,后面越容易因为映射规则隐藏真正的差异。
三、Node.js 脚本只做集合差,不替你判断“这个权限该不该申请”
核心脚本放在 tools/review-guard.mjs。它做三件事:读取 module.json5;读取内部清单;比较两个集合。
这段代码解决的是自动发现“声明了但没记录”和“记录了但没声明”的配置漂移:
import fs from 'node:fs'
import path from 'node:path'
import JSON5 from 'json5'

const rootDir = process.cwd()
const modulePath = path.join(rootDir, 'entry', 'src', 'main', 'module.json5')
const privacyPath = path.join(rootDir, 'tools', 'privacy-manifest.json')

const moduleJson = JSON5.parse(fs.readFileSync(modulePath, 'utf-8'))
const privacyManifest = JSON.parse(fs.readFileSync(privacyPath, 'utf-8'))

const requested = new Set(
  (moduleJson.module.requestPermissions ?? []).map((item) => item.name)
)
const declared = new Set(
  (privacyManifest.permissions ?? []).map((item) => item.name)
)

const undeclared = [...requested].filter((name) => !declared.has(name))
const orphan = [...declared].filter((name) => !requested.has(name))

const result = {
  buildId: 'review_guard_20261001_03',
  appVersion: '2.3.0(20300)',
  requestPermissions: requested.size,
  privacyItems: declared.size,
  undeclared,
  orphan,
  status: undeclared.length === 0 && orphan.length === 0 ? 'PASS' : 'FAIL'
}

console.log('[ReviewGuard]', JSON.stringify(result, null, 2))
process.exit(result.status === 'PASS' ? 0 : 1)
这里我用 JSON5 解析 module.json5,而不是直接 JSON.parse,因为工程配置本身允许 JSON5 语法。正式落地时,把 json5 放进开发依赖并锁版本,避免不同开发机解析行为不一致。
脚本故意不判断“申请 CAMERA 合不合理”。那是业务和合规问题,不能靠集合运算给结论。它只回答:代码已经声明的东西,内部是否有记录;内部记录的东西,代码是否还在用。
这个边界很重要。自动化最危险的地方不是检查少,而是看起来检查很多,最后团队误以为 PASS 等于“审核一定通过”。ReviewGuard 的 PASS 只能解释为本地对账规则通过。
四、失败就让构建链停下来,比发群消息更有用
脚本能打印结果还不够。如果它只是一个“想起来才运行”的工具,过两周大家还是会忘。
我给项目加了一个很朴素的预构建脚本:
#!/usr/bin/env bash
set -e

node tools/review-guard.mjs
./hvigorw assembleHap
这段代码解决的是把自检结果变成构建前置条件。review-guard.mjs 返回非零退出码时,后面的构建不会继续。
如果团队使用 DevEco CLI 或 CI,这个入口可以继续包在统一命令里;如果本地习惯从 IDE 点运行,也可以把它作为发布分支的流水线检查,而不是强行阻塞所有日常 Debug。我的经验是:开发阶段太严格会让大家绕过工具,真正需要强约束的是“准备发包”和“合并到发布分支”两个时点。
这里还有一个容易踩的坑:脚本不能直接修改 module.json5 或隐私清单来“自动修复”。权限涉及真实业务能力,发现差异后应该让开发者判断哪边错了。自动补齐只会把问题从“漏写”变成“错误地写上了”。
五、为了让检查结果可视化,我加了一个只在 Demo 里存在的 Review Guard 页面
命令行已经足够完成工作,但这次文章需要把状态过程讲清楚,所以我额外做了一个调试页。构建脚本会把检查结果写入一个结果 JSON,Demo 页读取后展示。
这段 ArkTS 代码解决的是把构建期结果转成开发阶段可查看的页面状态:
interface ReviewResult {
  buildId: string
  appVersion: string
  requestPermissions: number
  privacyItems: number
  undeclared: string[]
  orphan: string[]
  status: string
}

@Entry
@Component
struct Index {
  @State result: ReviewResult = {
    buildId: 'review_guard_20261001_03',
    appVersion: '2.3.0(20300)',
    requestPermissions: 6,
    privacyItems: 6,
    undeclared: [],
    orphan: [],
    status: 'PASS'
  }

  build() {
    Column({ space: 12 }) {
      Text('Review Guard').fontSize(28).fontWeight(FontWeight.Bold)
      Text(`Build ID  ${this.result.buildId}`)
      Text(`App Version  ${this.result.appVersion}`)
      Text(`Request Permissions  ${this.result.requestPermissions}`)
      Text(`Privacy Items  ${this.result.privacyItems}`)
      Text(`Undeclared  ${this.result.undeclared.length}`)
      Text(`Orphan  ${this.result.orphan.length}`)
      Text(`Status  ${this.result.status}`)
    }
    .padding(24)
  }
}
这个页面不是发布功能,也不应该把隐私清单完整暴露给用户。它只是文章 Demo 和内部调试视图。正式项目中,更合理的做法是把脚本结果交给 CI、制品报告或构建日志,避免为了展示自检状态往正式包里增加无关页面。
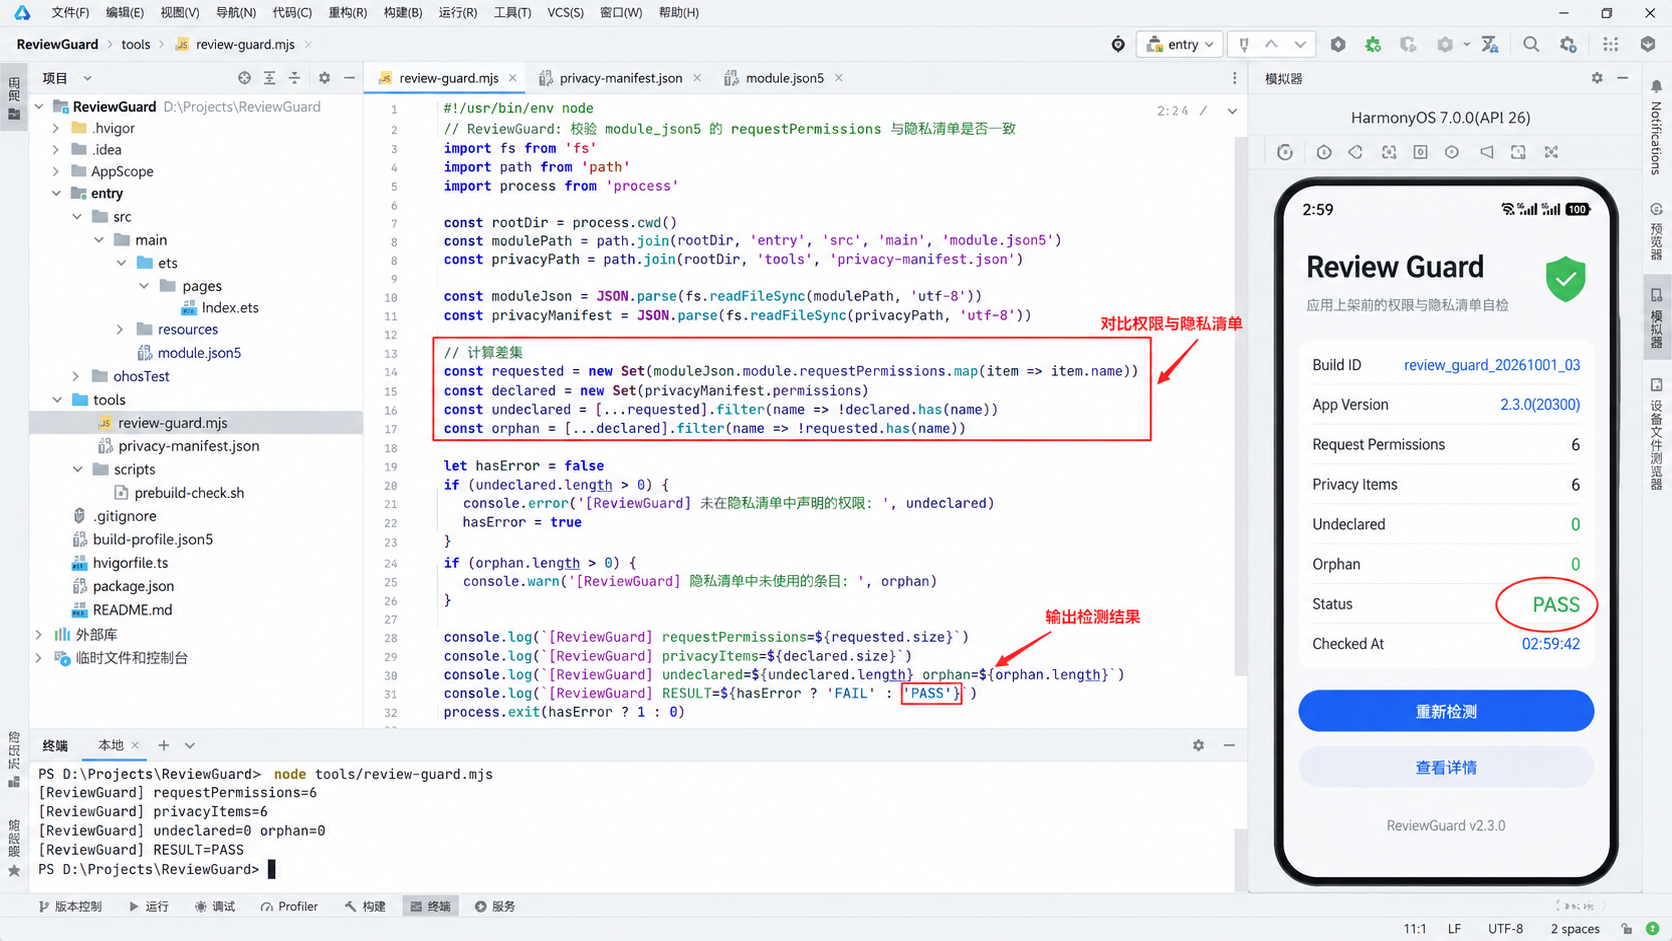
从 DevEco Studio 里可以直接看到脚本输出:
[ReviewGuard] requestPermissions=6
[ReviewGuard] privacyItems=6
[ReviewGuard] undeclared=0 orphan=0
[ReviewGuard] RESULT=PASS
这一版我特意让数字和手机页完全一致。以前做技术截图时最容易忽略的就是日志写 5,页面写 6,读者一眼就会怀疑是不是拼出来的。这种工具型文章,数据一致比 UI 漂亮更重要。
六、我用两个故障注入确认脚本不是“永远 PASS”
一个检查工具如果只展示成功结果,没有任何价值。我做了两次故障注入。
第一次,我在 module.json5 临时加了一条权限,但没有往内部清单增加对应记录。脚本立刻得到:
undeclared=1
orphan=0
RESULT=FAIL
第二次反过来:从 module.json5 删除一条已经不用的权限,但故意保留内部清单条目。结果变成:
undeclared=0
orphan=1
RESULT=FAIL
这两种失败含义不同。undeclared 更值得优先关注,因为意味着代码申请权限但内部说明还没跟上;orphan 则通常说明功能下线后文档没有清理。我的脚本都让构建失败,是为了让发布分支保持干净;如果团队觉得 orphan 不需要阻断,也可以把它降级成 warning。
异常处理上还有两个实际问题。第一,配置文件不存在时要直接失败,而不是把集合当空数组继续;第二,JSON5 解析失败时要保留原始文件路径和行号信息,方便快速定位。脚本越靠近发布链路,错误信息越不能只写一个 parse failed。
七、最终结果不是“审核通过”,而是“这次配置没有漂移”
最终这次 review_guard_20261001_03 的结果是:权限 6 条、内部清单 6 条、缺失 0、孤儿项 0、状态 PASS。
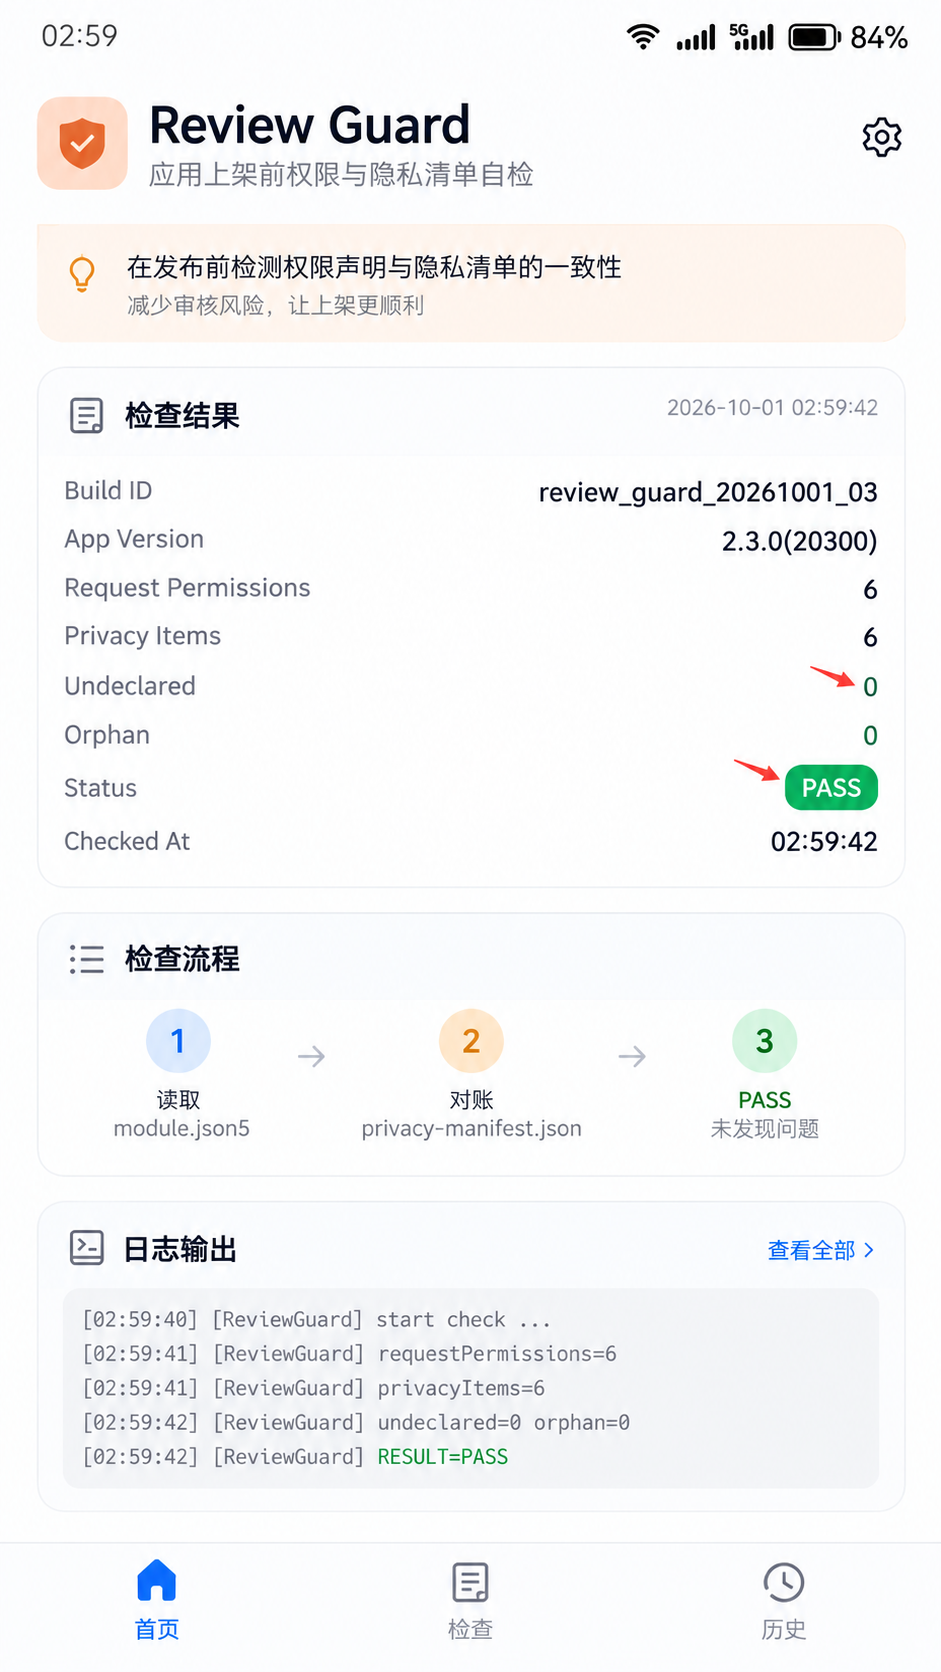
手机截图里我保留了检查时间 02:59:42,和 DevEco 里的运行结果对应。页面最有价值的不是绿色 PASS,而是下面四个数字。只要 requestPermissions、privacyItems、undeclared、orphan 能稳定记录,每次发布前就能很快判断配置是不是发生了非预期变化。
但我要再强调一次:这个 PASS 不是应用市场的审核结论。官方上架说明要求开发者了解审核指南、补充应用信息并提交上架;涉及第三方 SDK 时,隐私政策还需要按实际情况逐一明示相关信息。ReviewGuard 只是研发侧“早一点发现配置差异”的工具。
我更愿意把它看成一个很小的防呆脚本:不替法务做判断,不替产品决定是否申请权限,也不替审核平台给结论。它只保证我们自己仓库里两份本来应该同步维护的配置,在发包前没有悄悄走散。
八、后面还能继续扩,但别一口气做成“大而全合规平台”
下一步如果继续扩展,我会优先做三件小事。
第一,把 privacy-manifest.json 里的条目和具体功能模块绑定,让删除功能时能提示“这个权限对应哪个模块”;第二,把第三方 SDK 名称、用途和政策章节位置做成索引,但仍然只做一致性检查;第三,在 CI 里保存每次发布版本的对账结果,方便回看某个版本到底声明了什么。
我不会直接把网络请求、敏感 API 扫描、隐私政策文本 NLP 校验全部塞进同一个脚本。工具一旦开始假装自己能判断所有合规问题,误报和漏报都会迅速增加。对这类发布前工具,我更看重规则少但可解释:为什么失败、哪条不一致、应该去哪个文件改,一眼就能看明白。
这也是我这次写 ReviewGuard 的出发点。很多上架问题不一定需要一个复杂平台解决,有时候先让工程里最容易漂移的两份配置自动对上账,就已经能省掉不少提审前的反复确认。
九、脚本放进发布链以后,最需要防的是“规则自己悄悄失效”
工具跑通之后,我没有立刻继续加更多规则,而是反过来检查这个脚本自己会不会失效。发布前检查最尴尬的情况不是报错,而是大家以为它在工作,实际上某次目录调整之后它已经没有读到真正的配置文件。
所以我给 ReviewGuard 又加了三个约束。第一,module.json5、内部清单和结果文件都必须打印绝对路径,文件不存在就直接退出;第二,读取到的 requestPermissions 数量为 0 时不能默认为正常,而是根据项目基线决定是否需要 warning;第三,脚本版本要跟随仓库提交,不能依赖某个开发者电脑上的全局脚本。这样 CI 和本地看到的规则才是一致的。
我还给结果对象加了 schemaVersion。现在只有两个集合,看起来完全没必要,但只要以后加入第三方 SDK 索引、功能负责人、隐私政策章节号,结果结构就会变化。没有版本号,历史构建报告很快就无法比较。工具脚本这种东西,最容易在“很小”时忽略自己的兼容性。
另一个实际问题是例外项。某些权限可能只在特定 flavor、测试模块或可选能力里出现,如果粗暴要求两边永远完全相等,团队很快就会开始用假数据把脚本哄绿。我更倾向于显式增加 scope 或 enabledWhen 字段,让例外有名字、有原因、有负责人,而不是给脚本加一个 --ignore-all 开关。规则可以允许差异,但差异必须可解释。
最后我把失败结果分成“阻断”和“提醒”两档:undeclared 默认阻断,因为代码已经申请但内部索引没有记录;orphan 在开发分支可以提醒,在发布分支再阻断。这样既不至于让日常开发被频繁打断,又能保证真正出包之前仓库是干净的。
这几个改动没有增加什么华丽功能,却让工具从“一次性的文章 Demo”更接近能在团队里长期运行的小基础设施。对发布前检查来说,规则稳定、结果可解释、失败能定位,通常比扫描项越多越重要。
十、资料核对
华为开发者公开文档中,上架申请页面明确提示开发者在提交前了解审核规则;涉及第三方 SDK 时,需要根据实际情况在隐私政策中明示 SDK 处理个人信息的相关信息。不同 SDK 的合规指南还会给出各自的隐私、权限和初始化要求。本文脚本是工程自检示例,不替代官方审核指南或法律合规评估。
- HarmonyOS 文档中心:https://developer.huawei.com/consumer/cn/doc/
- 上架申请示例:https://developer.huawei.com/consumer/cn/doc/HMScore-Guides/harmonyos-release-application-0000001181600758
- SDK 合规使用指南示例:https://developer.huawei.com/consumer/cn/doc/hmscore-guides/harmony-sdk-guide-0000001657109996

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)