
HarmonyOS 7 + Hvigor-Localization Kit:多语言资源占位符签名与回退链路预检【鸿蒙心迹】
作者:李游
多语言资源最棘手的错误,往往不是“翻译得不够好”,而是构建能通过、页面也能打开,直到某个带参数的文案在特定语言下才暴露类型错位。%d 被译成 %s、复数分支缺少 other、关键文案依赖默认资源回退,这些问题靠逐页肉眼检查很难稳定发现。
本文把检查器收敛为一个可重复执行的构建前门禁。示例工程叫 LocaleGuard,页面为 LocaleAuditPage,任务 ID 为 L10N-0049。资源集合包含 base、zh_CN、en_GB、ar 四个目录和 126 个 key。首轮扫描得到 6 个问题:缺失 key 2 个、占位符签名不一致 2 个、复数缺少 other 1 个、发布文案硬编码 1 个;修复后结果为 0。所有统计用于展示检查逻辑,不是某个真实项目的审核结果。
一、先定义“签名”,再谈字符串相等
资源文件里的两条文案可以完全不同,却仍然拥有相同的参数契约。例如基础资源 已完成%d%%,剩余%s 和英文 Completed %d%%, %s left,文本不同,但占位符顺序都是 %d,%s。检查器真正要比较的是这个有序签名,而不是翻译文本。
示例里故意放入错误版本:Completed %s%%, %s left。它看起来像正常英文,运行时却把第一个整数参数当成字符串。若业务层仍按基础资源传入数字,轻则格式异常,重则让某些分支在运行期失败。
1. 为什么不能只数占位符数量
错误版本与正确版本都有两个占位符,只比较数量会放过问题。类型和顺序同样重要。对带位置索引或精度修饰的格式,规则还要先归一化,再比较语义签名。检查器的第一版应支持项目实际使用的格式集合,不要一上来写一个“匹配所有 printf 语法”的巨大正则。
这段代码解决什么问题:从资源文本中提取有序占位符签名,让 %d,%s 与 %s,%s 的差异可被稳定识别。
export type PlaceholderToken = '%d' | '%s' | '%f';

export function placeholderSignature(text: string): PlaceholderToken[] {
  const escapedPercent = '__PERCENT_LITERAL__';
  const normalized = text.replace(/%%/g, escapedPercent);
  const matches = normalized.match(/%(?:\d+\$)?[dsf]/g) ?? [];
  return matches.map((item) => {
    const type = item[item.length - 1];
    return (`%${type}`) as PlaceholderToken;
  });
}

export function sameSignature(base: string, translated: string): boolean {
  const left = placeholderSignature(base);
  const right = placeholderSignature(translated);
  return left.length === right.length &&
    left.every((token, index) => token === right[index]);
}
先把 %% 替换掉,是为了避免把百分号字面量误当成参数。位置索引被归一化,只保留最终类型;如果项目允许翻译调整参数顺序,就不能丢掉位置索引,而应解析后按索引比较。规则必须与调用方式一致,不存在一套适合所有工程的万能签名。
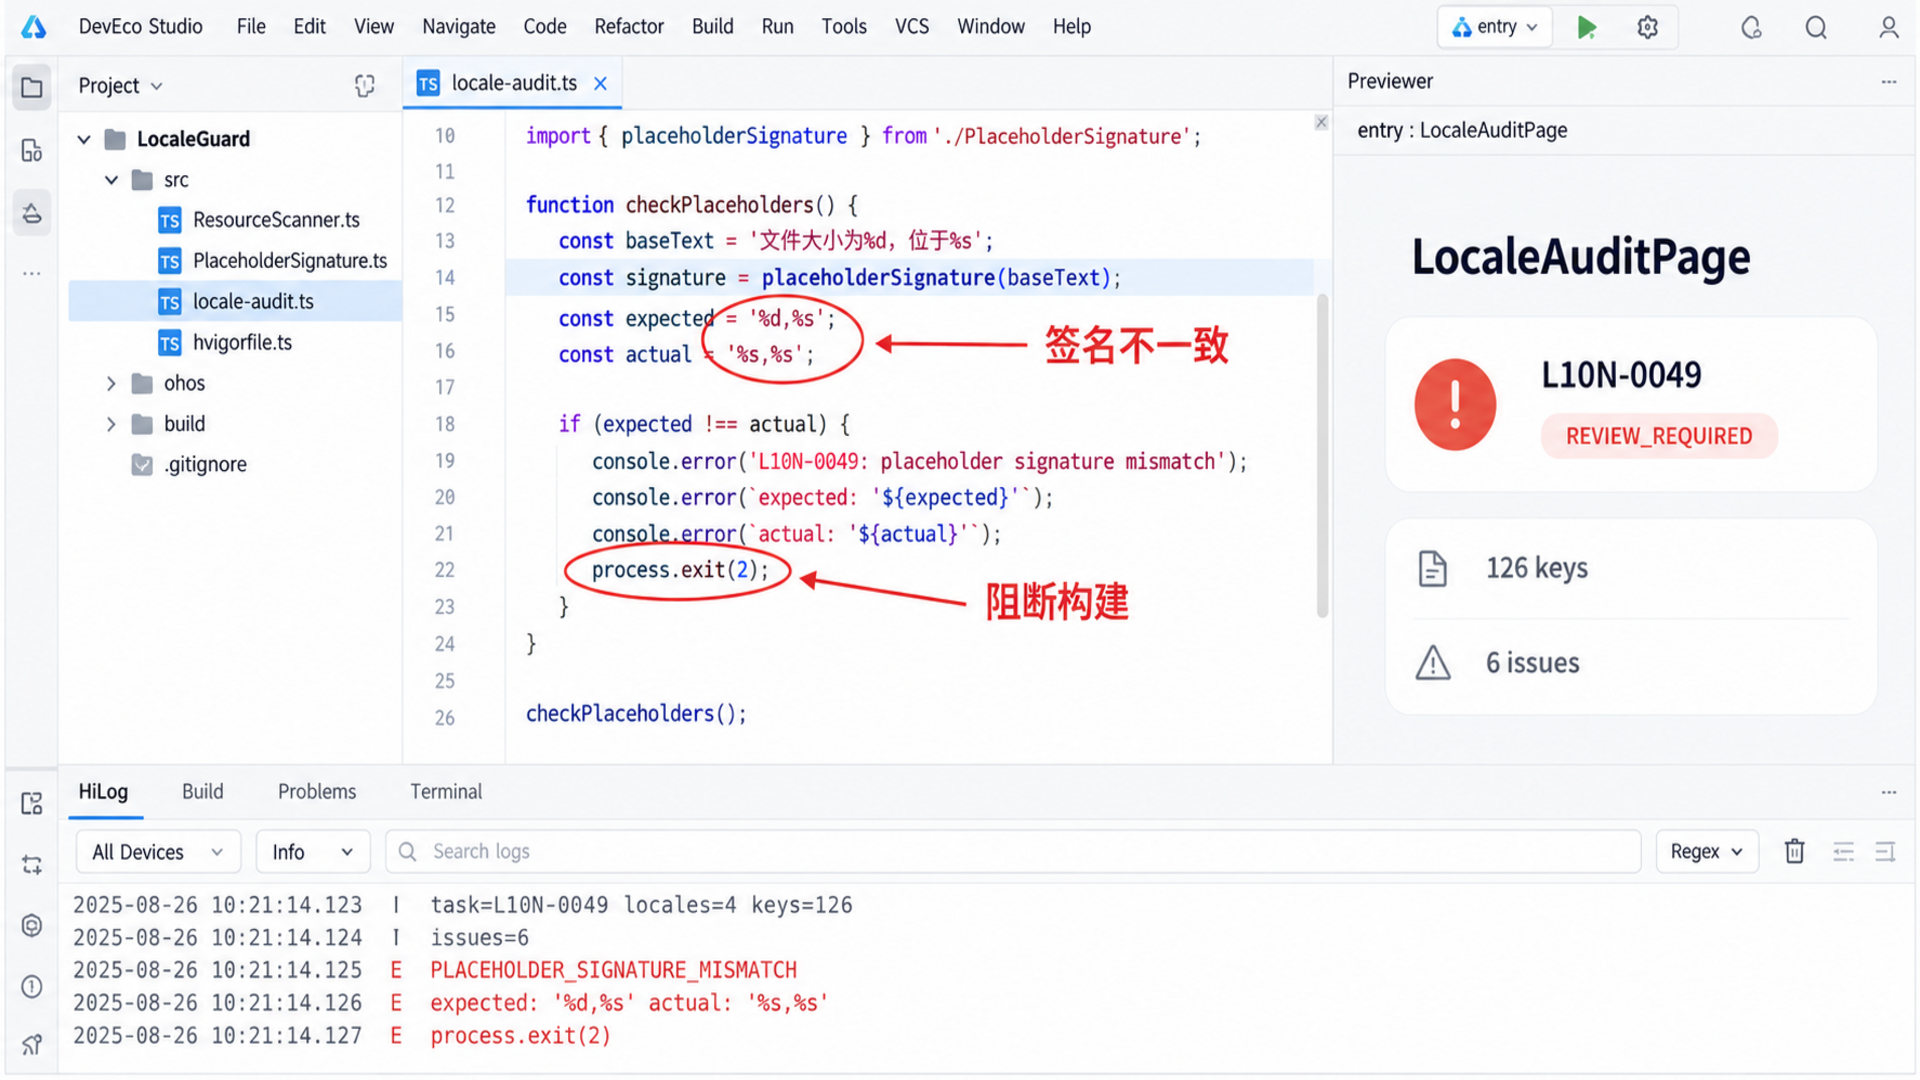
状态在这里还没有进入 UI。函数只输出确定结果,扫描器再负责把差异变成 PLACEHOLDER_SIGNATURE_MISMATCH。拆开后,规则可以用小样本单测,页面只消费报告,不参与判断。
二、默认资源回退是运行能力,不是发布质量标准
HarmonyOS 资源系统会根据设备语言和限定词选择匹配资源;没有匹配项时,可以回到默认资源。这个能力保证应用不至于因为某个翻译缺失而完全无文案,但它不意味着项目应允许所有 key 随意回退。
LocaleGuard 把规则分成两层:平台层确认资源结构合法、默认资源存在;项目层对支付、权限、隐私、导出等高风险文案要求每个目标语言显式提供。这样不会把团队策略误写成系统规则,也不会把系统回退误当成翻译完成。
1. 四个目录采用同一份索引
扫描器先读取 base 形成基准 key 集合,再逐个读取 zh_CN、en_GB、ar。每条记录带上目录、key、规则、期望值和实际值。报告使用稳定排序:先 locale,再 key,再规则。否则同一批问题每次输出顺序不同,很难在代码评审里看清新增与消失。
这段代码解决什么问题:把四个资源目录解析为统一索引,并明确区分缺失、回退与高风险阻断。
export interface LocaleIndex {
  locale: string;
  strings: Map<string, string>;
  plurals: Map<string, Set<string>>;
}

export interface AuditIssue {
  locale: string;
  key: string;
  rule: 'MISSING_KEY' | 'HIGH_RISK_FALLBACK' | 'PLACEHOLDER_SIGNATURE_MISMATCH';
  expected?: string;
  actual?: string;
}

const highRiskKeys = new Set([
  'privacy_collect_location',
  'export_delete_source',
  'payment_confirm_amount'
]);

export function compareLocale(base: LocaleIndex, target: LocaleIndex): AuditIssue[] {
  const issues: AuditIssue[] = [];
  for (const [key, baseText] of base.strings) {
    const targetText = target.strings.get(key);
    if (targetText === undefined) {
      issues.push({
        locale: target.locale,
        key,
        rule: highRiskKeys.has(key) ? 'HIGH_RISK_FALLBACK' : 'MISSING_KEY'
      });
      continue;
    }
    if (!sameSignature(baseText, targetText)) {
      issues.push({
        locale: target.locale,
        key,
        rule: 'PLACEHOLDER_SIGNATURE_MISMATCH',
        expected: placeholderSignature(baseText).join(','),
        actual: placeholderSignature(targetText).join(',')
      });
    }
  }
  return issues;
}
为什么缺失 key 还要分普通与高风险?因为两者运行时都可能走回退,但发布决策不同。普通缺失可以在开发分支先记录,关键文案则应阻断。实际项目要把高风险清单放进版本控制,并要求业务负责人评审;不要让扫描脚本作者独自决定所有业务优先级。
易错点是把 zh_CN 当作默认资源。默认目录与某个语言限定目录职责不同,应以官方资源目录规则为准。另一个易错点是只扫描一份 JSON:字符串、复数、媒体资源可能位于不同文件,解析器要按项目实际结构扩展。
三、复数 other 与硬编码要分别处理
复数规则不是把数字拼进字符串那么简单。不同语言的分类并不相同,项目若使用复数资源,至少要确认目标集合拥有兜底分支。LocaleGuard 把缺少 other 作为项目发布门禁,因为它能显著减少未覆盖数量落到错误文本的风险;这是一条工程策略,不应被描述为应用市场对所有项目的一刀切拒审条件。
硬编码检查也要克制。扫描所有中文或英文字符会产生大量误报,包括日志、测试数据和无障碍标识。示例只扫描发布构建中可到达的页面目录,排除测试与调试文件,并允许对确有理由的文本加带责任人的白名单。
这段代码解决什么问题:把复数兜底、硬编码与占位符差异合并成一份稳定报告,并保持规则来源可解释。
export interface AuditSummary {
  taskId: 'L10N-0049';
  locales: number;
  keys: number;
  issues: AuditIssue[];
}

export function auditAll(base: LocaleIndex, targets: LocaleIndex[]): AuditSummary {
  const issues: AuditIssue[] = [];
  for (const target of targets) {
    issues.push(...compareLocale(base, target));
    for (const [key, quantities] of target.plurals) {
      if (!quantities.has('other')) {
        issues.push({ locale: target.locale, key, rule: 'MISSING_KEY', actual: 'plural:other' });
      }
    }
  }
  return {
    taskId: 'L10N-0049',
    locales: 4,
    keys: base.strings.size,
    issues: issues.sort((a, b) =>
      `${a.locale}/${a.key}/${a.rule}`.localeCompare(`${b.locale}/${b.key}/${b.rule}`)
    )
  };
}
这里为了聚焦主线,把硬编码扫描结果也转换为同一种 AuditIssue 后再汇总,生产代码应给它独立规则名和源文件位置。keys 取基础索引大小,示例固定为 126;locales 包括 base 在内共 4 个。若资源解析失败,不能返回“0 问题”,而应让任务进入 FAILED。扫描失败与扫描通过是完全不同的状态。
图中的工程目录、代码、模拟器与日志使用同一组数据:L10N-0049、4 locales、126 keys、6 issues。画面是演示配图,不冒充真实 DevEco Studio 执行证据。
四、把检查器放在 Hvigor 之前,而不是藏在某个人电脑里
一个只能手动运行的脚本,很快会变成“发布前记得点一下”。更可靠的做法是让它成为构建入口的一部分:先执行 TypeScript 检查器并输出 JSON 报告,退出码非零时不启动 Hvigor;通过后再执行 hvigorw assembleHap。这种外部门禁不依赖未核实的 Hvigor 插件接口,同时仍然把检查放进标准构建链路。
在本地可以封装为 npm script,在 CI 中则直接执行两个命令。关键不是命令放在哪里,而是保证所有发布构建走同一入口,不能让“快捷构建”绕过资源审计。
这段代码解决什么问题:用明确退出码把 LocaleGuard 与 Hvigor 构建串联,避免报告有问题时仍继续产出发布包。
import { writeFileSync } from 'node:fs';
import { spawnSync } from 'node:child_process';

const summary = auditAll(baseIndex, localeIndexes);
writeFileSync('build/reports/locale-audit.json', JSON.stringify(summary, null, 2));

if (summary.issues.length > 0) {
  console.error(`[LocaleGuard] task=L10N-0049 issues=${summary.issues.length}`);
  process.exit(2);
}

const result = spawnSync('./hvigorw', ['assembleHap'], { stdio: 'inherit' });
process.exit(result.status ?? 1);
状态变化很清楚:开始时是 SCANNING;发现 6 个问题进入 REVIEW_REQUIRED;修改资源后标记 FIXED 并重新扫描;只有第二次 issues.length === 0 才进入 PASS 并启动 Hvigor。不要在 FIXED 状态直接放行,因为“改过了”不等于“规则已经重新验证”。
生产环境还要处理 Windows 命令名、工作目录和超时,并保留 JSON 报告作为构建产物。脚本本身异常时使用不同退出码,便于 CI 区分“资源问题”和“工具故障”。如果团队后来把规则集做成 Hvigor 插件,应先依据当前版本官方扩展文档验证接口,而不是复制未经确认的示例。
五、报告页面只展示能支持决策的数据
LocaleAuditPage 不试图成为翻译平台。它只回答本次构建能否继续:任务 ID、资源目录数、基准 key 数、问题总数和状态链。首轮页面为 REVIEW_REQUIRED,修复后显示 6 → 0 与 PASS。
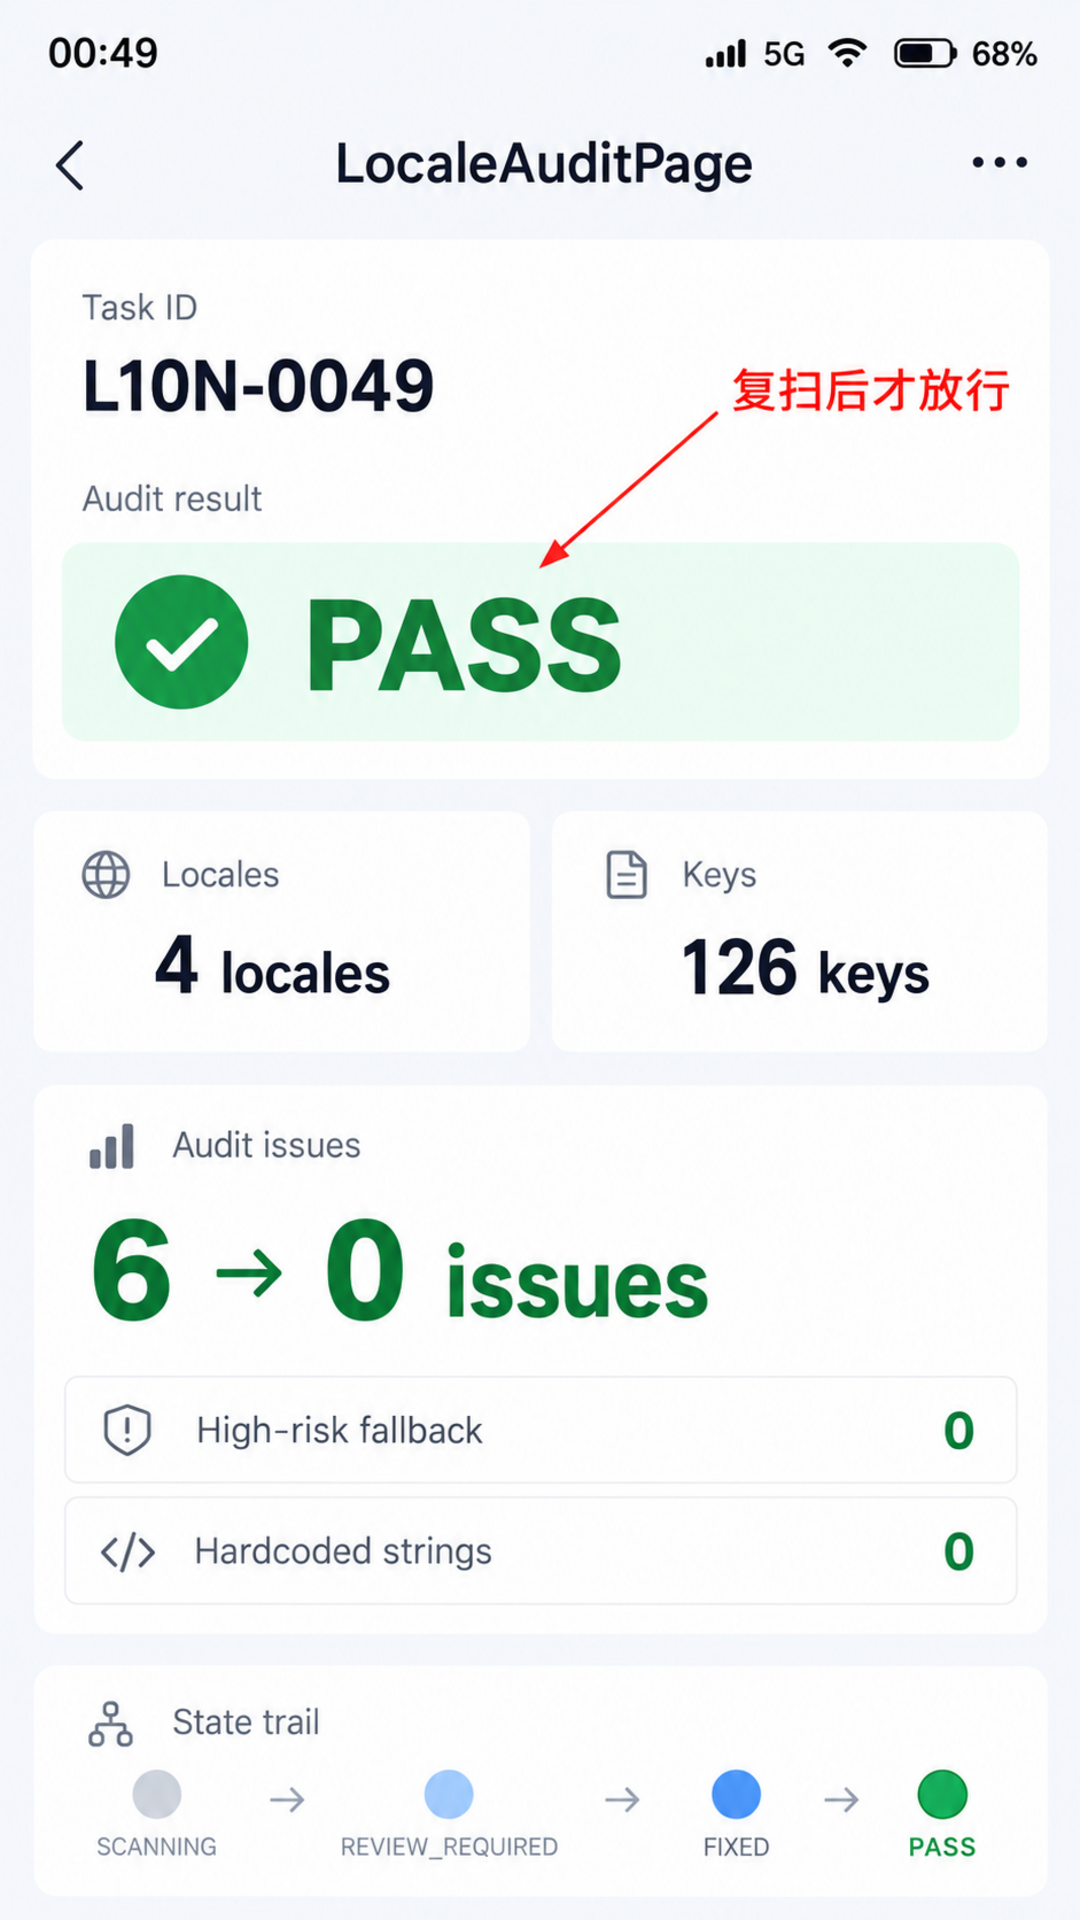
运行页显示时间 00:49、四个 locale、126 个 key、回退阻断 0、硬编码 0。这里的“回退 0”指项目高风险回退规则没有命中,并不代表系统资源解析永远不会回退。把指标命名写清,能避免一个绿色数字掩盖真实含义。
详情页保留修复轨迹:缺失 key 2、占位符不一致 2、复数 other 1、硬编码 1,总计 6。重点样本 export_progress 同时展示期望 %d,%s、发现 %s,%s 与修复后 %d,%s,这样评审者不用打开资源文件也能理解阻断原因。
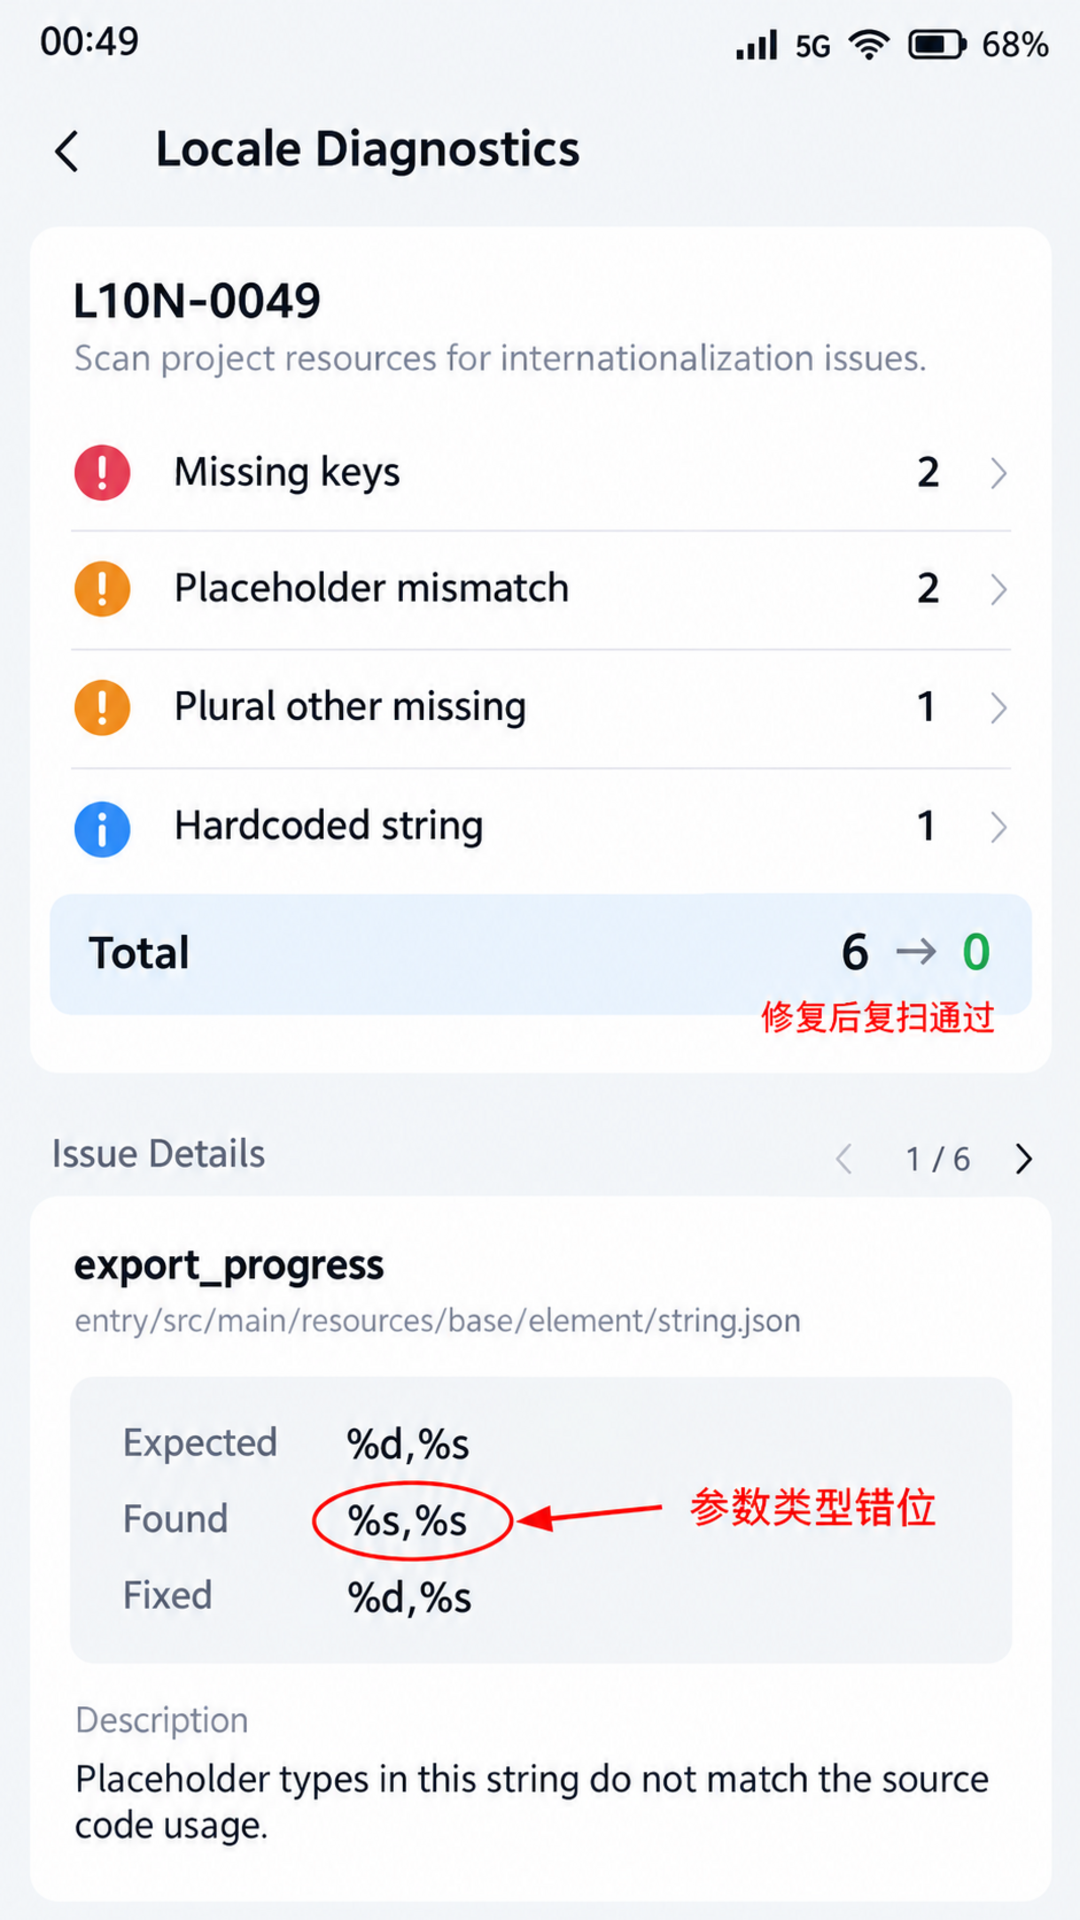
红色标注只圈出签名错位和 6 → 0,不为每个字段都加箭头。诊断图承担的是规则解释:它告诉开发者哪种差异会失败,而不是仅仅展示一个漂亮的 PASS 页面。
六、资源扫描的边界比正则表达式更重要
占位符规则很容易继续膨胀:位置索引、浮点精度、富文本标签、双向文本、资源引用、复数类别都可能加入。正确的扩展顺序是先收集工程实际格式,再为每种格式增加测试样例。一个看似完美却没有样本约束的正则,往往会在下一种语言上制造更多误报。
还要区分三类结论:
- 平台事实:资源限定目录与默认资源存在匹配、回退关系,字符串资源支持格式参数。
- 项目策略:高风险 key 不允许依赖回退,复数必须包含
other,发布页面不得出现未豁免硬编码。 - 示例结果:
L10N-0049从 6 个问题修复为 0,126 个 key 全部通过。
第一类由官方文档约束,第二类由团队质量门槛决定,第三类只是本文 Demo 数据。把它们混写,会让读者误以为项目策略是系统硬性政策,或误以为示例数字来自真实审核。
扫描报告还应保持可追溯:记录规则版本、资源提交号与目标语言集合,但不要收集翻译人员身份或把业务文案上传到无关服务。报告用于定位资源契约,不应变成新的数据外泄入口。若构建使用缓存,缓存键必须包含规则版本和资源摘要,否则旧的 PASS 可能错误复用到新的资源提交。
本文核对的官方一手资料包括 HarmonyOS 资源分类与访问、多语言资源、Localization Kit 与 Hvigor 工具说明:
- https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/resource-categories-and-access
- https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/i18n-l10n
- https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/localization-kit
- https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/hvigor
具体目录名、资源 JSON 结构和构建命令应以项目使用的 HarmonyOS SDK、DevEco Studio 与 Hvigor 版本为准。若官方文档的页面路径调整,应从开发者文档中心检索同名章节,不要依赖第三方转载来决定发布规则。
七、从“能显示”提升到“契约一致”
多语言资源的质量门槛不该停在“页面上有字”。真正稳定的本地化链路要保证 key 可达、参数契约一致、复数分支可兜底、关键文案不依赖意外回退,并且每次发布都执行同一套检查。
LocaleGuard 的价值不在 6 个问题本身,而在于把隐性的语言差异变成可比较、可阻断、可复查的构建数据。SCANNING → REVIEW_REQUIRED → FIXED → PASS 不是为了多做一个页面,而是迫使状态从“已经修改”走到“已经重新验证”。当 export_progress 的签名重新回到 %d,%s,构建才继续;这条边界比发布前临时扫一眼资源文件可靠得多。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献75条内容

所有评论(0)