
HarmonyOS 7 TaskPool + Node-API + zstd:Native 批量压缩任务的主线程隔离、进度回传与资源收口【鸿蒙心迹】
这篇从一个很实际的性能问题开始:我把 zstd Native 压缩库接进 HarmonyOS 以后,功能第一次就跑通了,但直接从页面线程同步压缩几十 MB 数据时,按钮反馈、列表滚动和进度动画都会一起变差。问题不在 zstd,而在“重活放错了线程”。
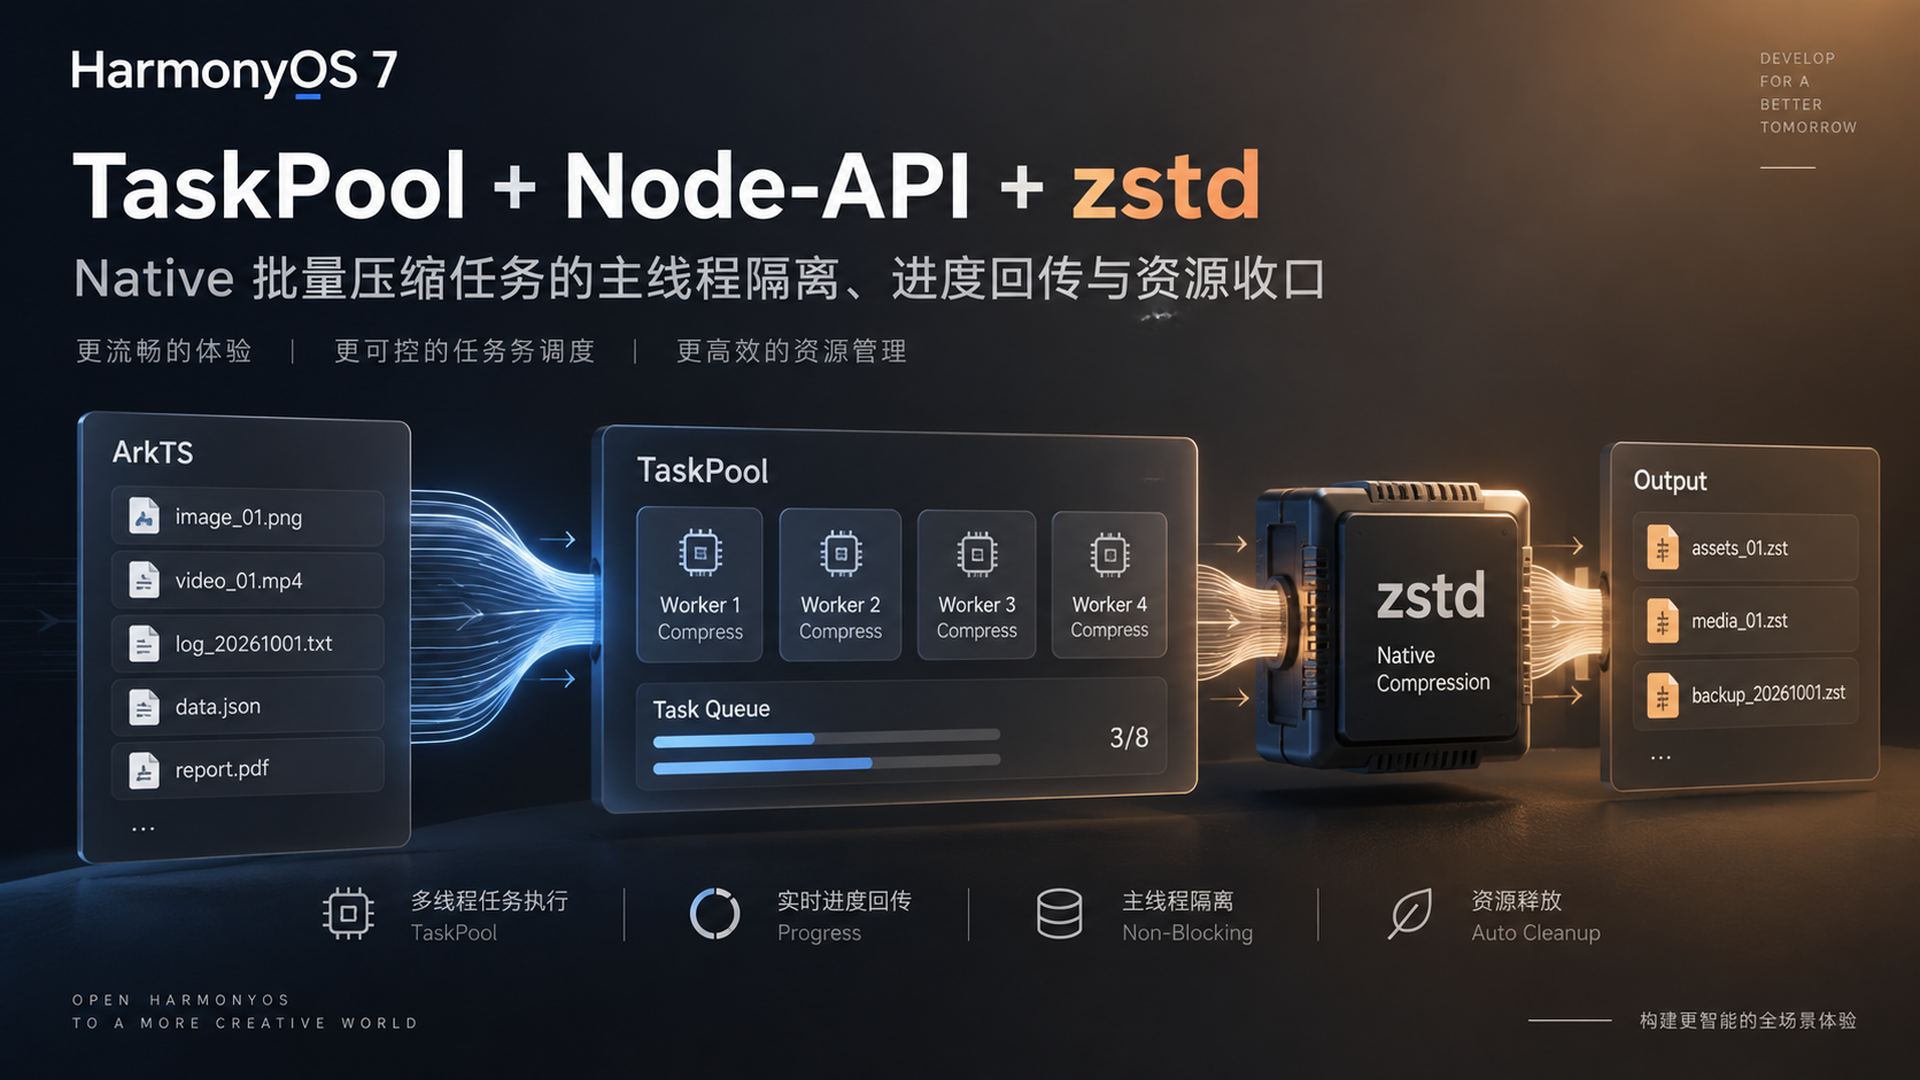
这次 Demo 叫 NativeZipBench。
固定运行数据如下:
- Task ID:
zip_20261001_04 - Files:
12 / 12 - Input:
64.0 MB - Output:
18.7 MB - Ratio:
29.2% - Level:
zstd level 6 - Elapsed:
1260 ms - UI FPS:
59 - Active Tasks:
0 - State:
COMPLETED
先说明一下,1260ms 和 29.2% 都只是本文这一次 Demo 数据,不代表所有设备和所有文件类型都能得到相同结果。
我真正想复盘的是 Native 三方库接入以后,怎么把 CPU 密集型同步调用从 UI 主线程移出去。
HarmonyOS 当前 Node-API 用来连接 ArkTS/JS 与 C/C++ 模块;官方并发指南也明确把图片编解码、压缩 / 解压、模型运算等归到典型耗时任务,TaskPool 用池化任务降低主线程负载。
一、第一次接完 zstd,功能正确但线程不对
zstd 本身是 Native 库。
我用 OHOS NDK 编译出适配目标架构的库,再通过 C++ Node-API 层暴露一个同步 compress() 方法给 ArkTS。
最初页面里直接调用:
const output =
  nativezip.compress(inputBuffer, 6);
逻辑完全正确。
但 64MB 数据压缩时,这个调用在哪个 ArkTS 线程发生,CPU 工作就跟着在哪个线程跑。
如果它直接发生在 UI 主线程,Native 代码并不会因为“它是 C++”就自动变成后台任务。
这个误区很常见。
Native 不等于异步。
所以我后面把问题拆成两层:
- Node-API 只解决跨语言调用;
- TaskPool 负责把这次同步 CPU 任务放到并发线程。
二、Node-API 桥只做参数转换,不承担任务调度
先看 Native 这一层。
当前代码解决的问题,是把 ArkTS 的 ArrayBuffer 转成 zstd 输入,再把压缩结果返回。
static napi_value Compress(
    napi_env env,
    napi_callback_info info)
{
    size_t argc = 2;
    napi_value args[2] = { nullptr, nullptr };
    napi_get_cb_info(
        env, info, &argc, args, nullptr, nullptr);

    void* inputData = nullptr;
    size_t inputSize = 0;
    napi_get_arraybuffer_info(
        env, args[0], &inputData, &inputSize);

    int32_t level = 6;
    napi_get_value_int32(env, args[1], &level);

    size_t bound = ZSTD_compressBound(inputSize);
    std::vector<uint8_t> compressed(bound);

    size_t resultSize = ZSTD_compress(
        compressed.data(),
        bound,
        inputData,
        inputSize,
        level);

    if (ZSTD_isError(resultSize)) {
        napi_throw_error(
            env, nullptr, ZSTD_getErrorName(resultSize));
        return nullptr;
    }

    void* out = nullptr;
    napi_value arrayBuffer;
    napi_create_arraybuffer(
        env, resultSize, &out, &arrayBuffer);

    memcpy(out, compressed.data(), resultSize);
    return arrayBuffer;
}
这段代码没有开线程。
它就是一个同步 Native 方法。
这反而让我更容易确认职责:Node-API 层只负责安全拿参数、调用 zstd、创建返回值、处理错误。
线程策略留在 ArkTS 并发层。
正式工程里还会补参数类型校验、空指针、超大输入限制和错误码映射,本文没有把所有防御代码都铺开。
三、真正的隔离发生在 @Concurrent 任务里
这段代码解决的是:不要从 UI 线程直接调用 nativezip.compress()。
import { taskpool } from '@kit.ArkTS';
import nativezip from 'libnativezip.so';

@Concurrent
export function compressOne(
  input: ArrayBuffer,
  level: number
): ArrayBuffer {
  return nativezip.compress(input, level);
}
它看起来只比原来多了一个 @Concurrent。
但真正执行时,我会创建 taskpool.Task,然后通过 taskpool.execute(task) 调度。
private async runNativeTask(
  input: ArrayBuffer,
  level: number
): Promise<ArrayBuffer> {
  const task = new taskpool.Task(
    compressOne,
    input,
    level
  );

  return await taskpool.execute(task) as ArrayBuffer;
}
官方当前 TaskPool 使用方式也是 new taskpool.Task(...) 配合 taskpool.execute(task)。
需要特别注意的是,TaskPool 子线程不应该直接操作 UI,也不适合把页面对象、组件实例这种上下文带进去。
我传入的是可序列化 / 可跨线程处理的数据,返回结果以后再回宿主线程更新页面。
四、批量 12 个文件,不等于一次性起 12 个无上限任务
我最开始做批量压缩时,想到的第一版是:
Promise.all(files.map(file => compress(file)))
对于 12 个几十 MB 级别的输入,这种“全扔出去”并不一定合理。
TaskPool 本身会调度线程,但应用仍然应该根据实际性能数据控制并发度。官方 2026 年更新的 TaskPool 使用规范也明确建议根据业务场景和性能数据控制并发度。
这次 Demo 我把应用层并发上限固定为 4。
private maxParallel: number = 4;
private active: number = 0;

private async drainQueue(): Promise<void> {
  while (
    this.active < this.maxParallel &&
    this.waiting.length > 0
  ) {
    const job = this.waiting.shift()!;
    this.active += 1;

    this.executeJob(job)
      .finally(() => {
        this.active -= 1;
        this.drainQueue();
      });
  }
}
这不是 HarmonyOS 强制值。
4 只是 NativeZipBench 当前这组数据下的实验配置。
正式项目应该通过设备、输入规模、内存峰值和 CPU 负载决定,而不是看到“多核”就把并发开得越大越好。
五、进度回传必须跟 Task 生命周期对得上
用户压缩 12 个文件,如果 1.2 秒里页面一直没有变化,体验仍然会像“卡住了”。
所以我需要 25%、50%、75%、100% 四个阶段的进度。
TaskPool 提供 Task.sendData() 和 onReceiveData() 进行任务与宿主线程通信。
我在同步任务循环里回传当前完成数:
@Concurrent
export function compressBatch(
  inputs: ArrayBuffer[],
  level: number
): number[] {
  const sizes: number[] = [];

  for (let i = 0; i < inputs.length; i++) {
    const result =
      nativezip.compress(inputs[i], level);

    sizes.push(result.byteLength);

    taskpool.Task.sendData({
      done: i + 1,
      total: inputs.length
    });
  }

  return sizes;
}
宿主线程接收:
const task = new taskpool.Task(
  compressBatch,
  buffers,
  6
);

task.onReceiveData((data: object) => {
  const progress = data as {
    done: number,
    total: number
  };

  this.progress =
    progress.done / progress.total;
});

const sizes =
  await taskpool.execute(task) as number[];
这里我特意保持 sendData() 在同步 Task 执行阶段调用。
官方最新使用规范提醒过一个很重要的边界:不要在 Task 已可能结束之后的异步回调里继续调用依赖 Task 生命周期的 sendData();这类长时、异步监听场景需要换用更合适的通信和任务模型。
当前压缩任务是短时同步 CPU 工作,因此这套方式更直接。
六、资源收口不只是在 ArkTS 里把 active 归零
Native 三方库接进来以后,我会特别检查资源的创建和释放是不是成对出现。
如果使用 zstd 的 Context API,那么创建和释放应该在同一次任务边界内完成。
例如:
ZSTD_CCtx* cctx = ZSTD_createCCtx();
if (cctx == nullptr) {
    // error
}

size_t result = ZSTD_compressCCtx(
    cctx,
    output,
    outputCapacity,
    input,
    inputSize,
    level);

ZSTD_freeCCtx(cctx);
cctx = nullptr;
如果中间任何异常路径提前 return,也要保证 context 被释放。
正式 C++ 代码我更倾向用 RAII 封装,而不是每个分支手写 free。
ArkTS 这边同样要收口:
- Task 完成后
active -= 1 - 失败任务从运行集合移除
- 页面不再需要大块 ArrayBuffer 时释放引用
- 不把整批输入和输出长期同时挂在页面状态上
这也是我这次把“Active Tasks = 0”放到最终截图里的原因。
它比一个绿色“完成”更能说明调度层已经收口。
七、DevEco 里我主要看三类日志,不只看耗时
这次跑完以后,HiLog 固定为:
Task[zip_20261001_04] start, total: 12 files
progress: 25% (3/12)
progress: 50% (6/12)
progress: 75% (9/12)
progress: 100% (12/12)
completed, input: 64.0 MB
output: 18.7 MB
cost: 1260 ms
Active tasks: 0
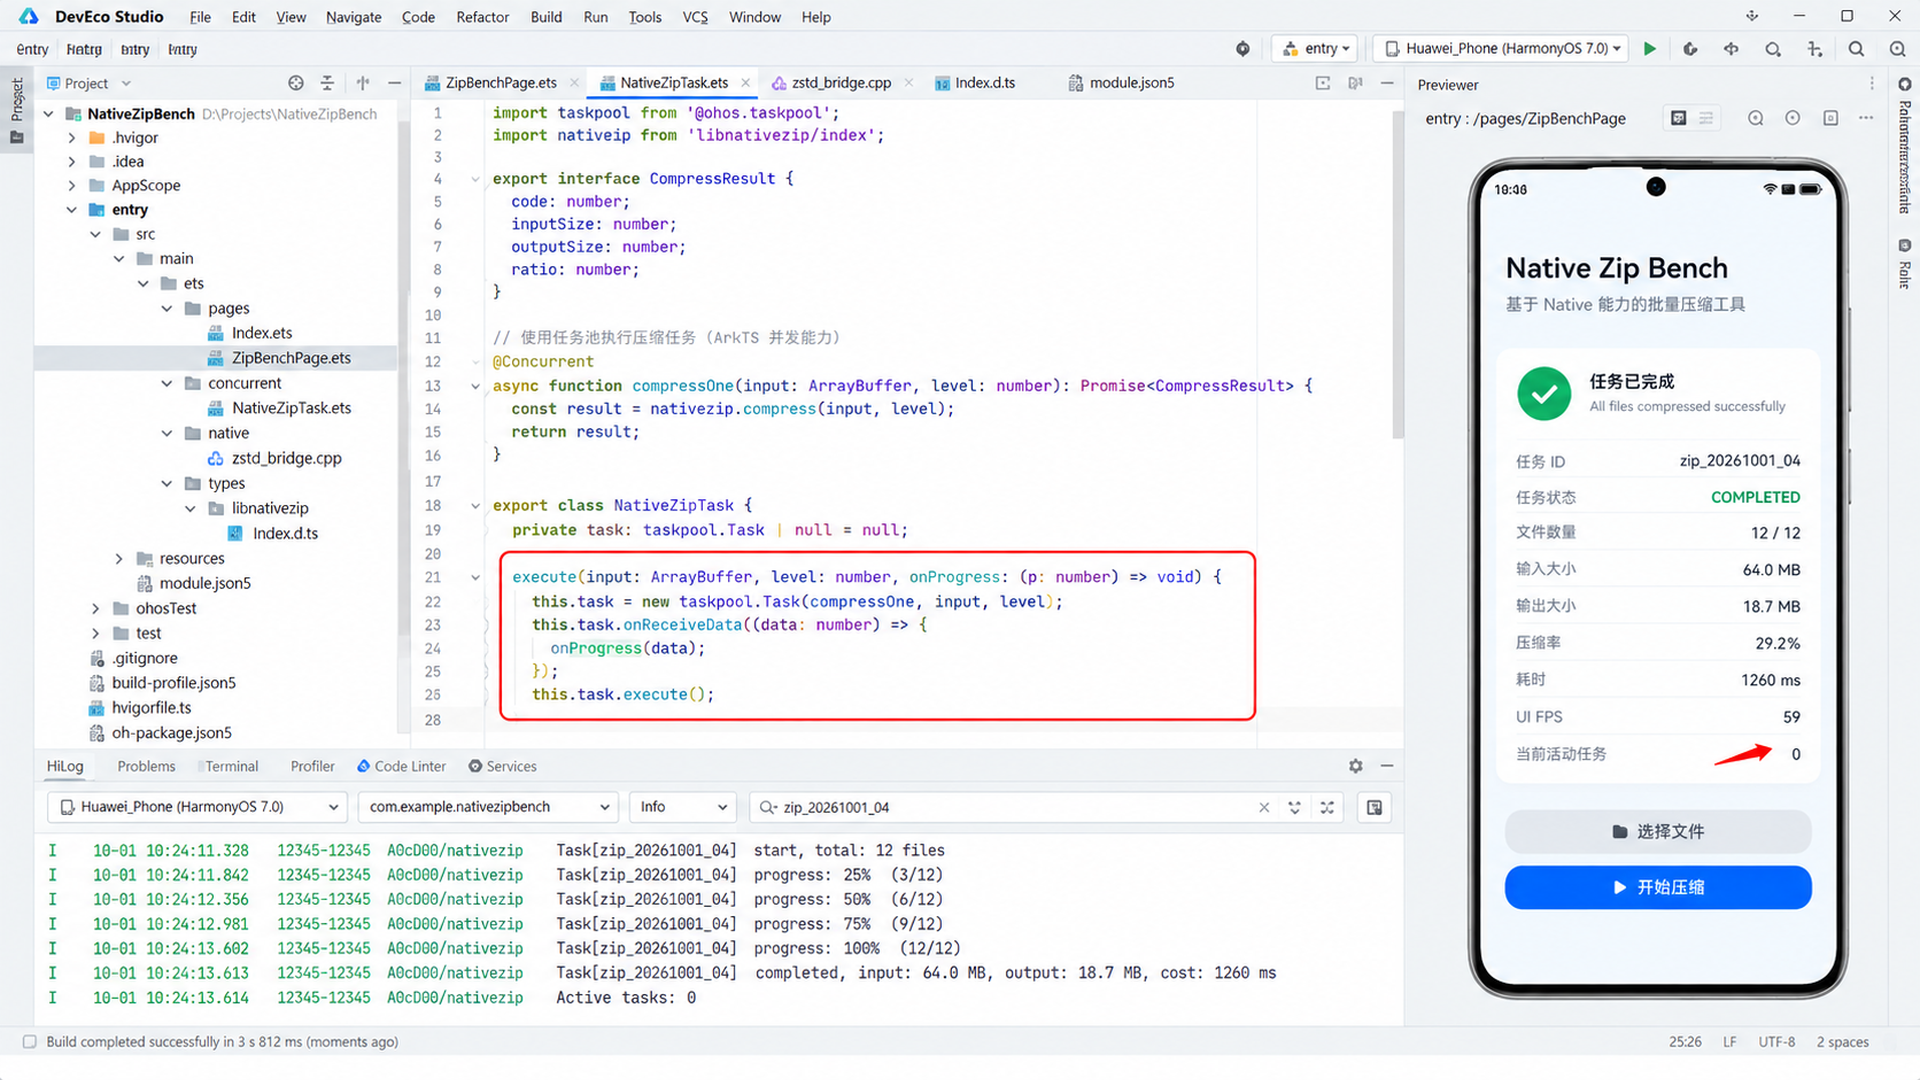
我更关注的是三类信息:
第一,进度是不是按实际完成数变化,而不是定时器模拟。
第二,最终 Active Tasks 是否回到 0。
第三,异常时有没有文件永远停在 RUNNING。
1260ms 反而只是其中一个观测值。
如果下一台设备变成 1800ms,只要 UI 仍然流畅、任务状态正确、资源能收口,这套架构就仍然成立。
八、59 FPS 不能证明“性能优化完成”,只能说明这次主线程没被明显拖住
最终手机运行图里,我保留了 UI FPS 59。
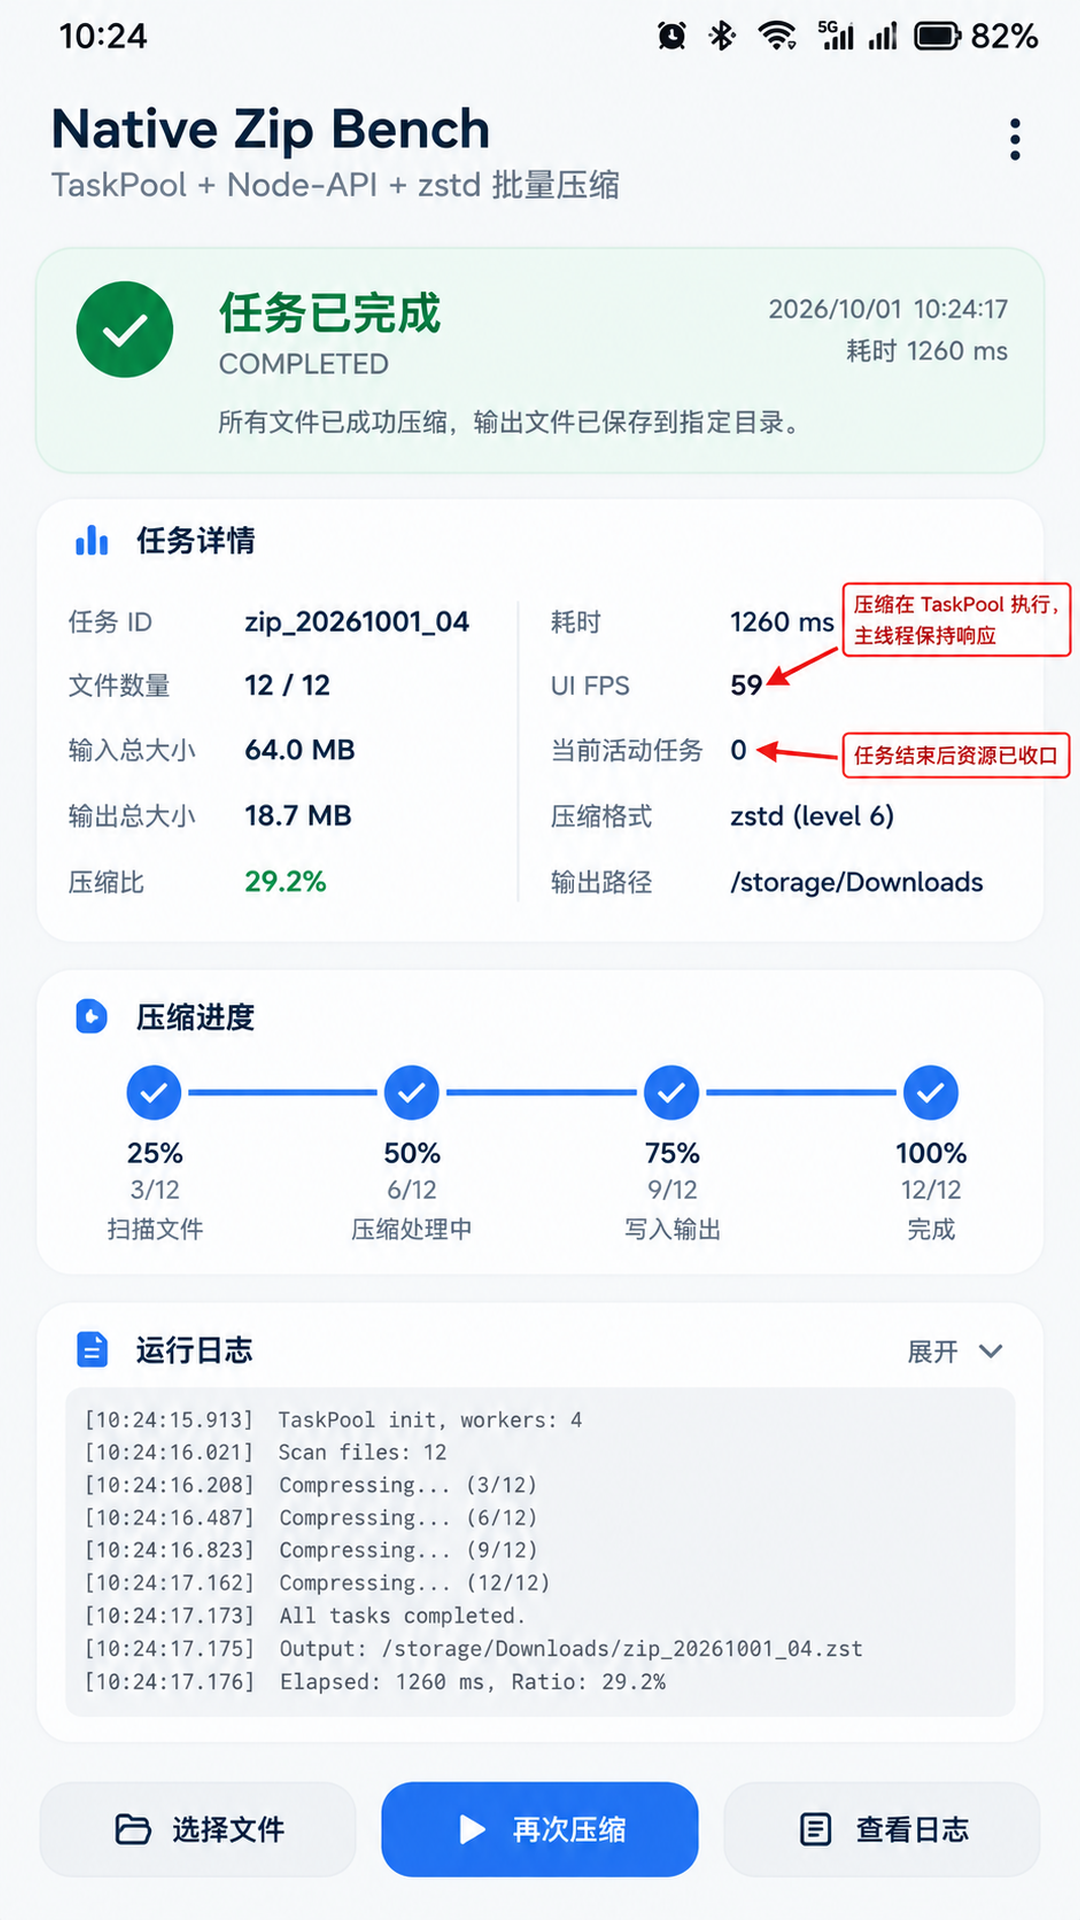
但我不会把它写成“TaskPool 优化后稳定 59FPS”。
因为这只是这一次运行、这台环境、这组 12 个文件的观测结果。
真正能从结构上确认的是:
压缩函数已经不在 UI 主线程同步执行。
页面仍然可以正常刷新任务进度。
最终状态为:
Task ID: zip_20261001_04
State: COMPLETED
Files: 12 / 12
Input: 64.0 MB
Output: 18.7 MB
Ratio: 29.2%
Elapsed: 1260 ms
Active Tasks: 0
这个结果更适合作为工程验收信息。
九、这次让我重新区分了三个“异步”
做 Native 混合开发时,很容易把三个东西混在一起。
第一个是 ArkTS Promise。
它只是调用形式异步,不代表 CPU 重活一定离开了主线程。
第二个是 Node-API。
它解决跨语言边界,也不自动替你决定工作线程。
第三个才是 TaskPool / Worker 这类并发机制。
它们负责把适合的任务放进并发执行环境。
把这三个概念拆开以后,问题就清楚很多:
Native 库负责算,Node-API 负责桥,TaskPool 负责调度,ArkUI 负责显示。
这也是 NativeZipBench 最后留下来的结构。
十、正式项目里我还会继续补两件事
第一是取消。
用户批量压缩过程中离开页面,如果业务允许取消,需要把 Task 标识保存下来并按当前 TaskPool API 管理,而不是只在 UI 上把进度条隐藏。
第二是 I/O 分层。
本文主要讨论 CPU 压缩阶段。真正的大文件项目里,文件读取、输出写盘同样可能成为耗时点,不能为了把 zstd 放进 TaskPool,就又在主线程同步读完 2GB 文件。
最终应该把:
读取 → 压缩 → 写入 → 状态更新
都按真实耗时拆开测量。
但至少这一次,最明显的结构问题已经解决了:Native 同步函数不再因为调用方便,就直接压在 UI 线程上。
参考资料
- HarmonyOS TaskPool 使用规范
https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/task-pool-usage-guidelines - TaskPool 任务与宿主线程通信
https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-V13/taskpool-communicates-with-mainthread-V13 - Node-API 跨语言调用
https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425 - HarmonyOS 三方 Native 库适配说明
https://developer.huawei.com/consumer/cn/doc/games-guides/games-2dx-adapt-third-library-0000002290527381

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献75条内容

所有评论(0)