
HarmonyOS 7 Spatial Recon Kit + Preferences:重建会话中断恢复与脏任务回收【鸿蒙心迹】
端侧重建最麻烦的并不是把任务跑起来,而是跑到一半接电话、锁屏或被系统回收以后,应用还能不能解释清楚:刚才采到哪里、哪些文件有效、旧任务是否已经释放,以及用户下一步应该继续还是重来。
我最近给一个室内陈列采集 Demo 加“继续上次任务”时,第一次实现看起来很顺:页面把进度写进 Preferences,重新进入后再把进度读出来,进度条也能回到 64%。真正运行才发现,这种恢复只是把 UI 演明白了。底层重建句柄已经失效,帧目录里还混着未写完的文件,再点击继续,页面会同时收到旧回调和新回调。
这类问题很容易被误判成 Spatial Recon Kit 的调用失败。实际拆开看,它是三层状态没有对齐:原生流水线有自己的生命周期,磁盘上的采集素材有自己的完整性,ArkUI 页面又有一套可观察状态。只保存一个 progress,恰好绕开了最重要的部分。
本文使用的 Demo 叫 ScanResume Lab。固定任务为 recon_20261001_09,目标采集 600 帧;应用进入后台时已经确认 384 帧,恢复页面显示 64%。最终输出文件为 livingroom_20261001_09.splat。这里不假设原生句柄可以跨进程复用,而是把恢复定义为:核验检查点、清理脏任务、重新创建流水线,再从可复用输入继续。
一、恢复的不是句柄,而是一份可验证的事实
重建任务运行时通常会同时存在四类信息:任务标识、采集素材、流水线实例和页面状态。前两类可以落盘,原生实例与回调对象只能活在当前进程里,页面状态则随组件销毁而结束。
我最初把 nativeHandle 转成字符串写入本地,后来很快删掉了。句柄值只是当前进程里的索引,重新启动以后,即使数字相同,也不代表它仍指向原来的资源。正式项目里把这种值当恢复依据,轻则调用返回无效参数,重则让清理逻辑释放错误对象。
因此,检查点只记录可以复核的数据:任务 ID、素材目录、已确认帧数、最后一帧摘要、配置版本和更新时间。状态机也不直接从 CHECKPOINTED 跳到 RUNNING,中间必须经过 RESTORING 与 REBUILDING。
下面这段定义解决的是“页面进度和真实任务混成一个字段”的问题。持久化结构不保存任何 native 对象,只保存重新构建流水线所需的最小事实。
export enum ReconState {
  IDLE = 'IDLE',
  CAPTURING = 'CAPTURING',
  CHECKPOINTED = 'CHECKPOINTED',
  RESTORING = 'RESTORING',
  REBUILDING = 'REBUILDING',
  COMPLETED = 'COMPLETED',
  FAILED = 'FAILED'
}

export interface ReconCheckpoint {
  schemaVersion: 2
  taskId: string
  frameDir: string
  confirmedFrames: number
  targetFrames: number
  lastFrameSha256: string
  state: ReconState
  updatedAt: number
}
confirmedFrames 不是“相机回调过多少次”,而是素材写入成功、文件长度满足要求并进入索引的数量。当前 Demo 在第 384 帧完成确认后才生成检查点,所以恢复时显示 384 / 600 和 64%。如果第 385 帧只写了一半,它不会被计入,启动核验时还会被清理。
schemaVersion 也很重要。重建参数、目录组织或摘要算法调整以后,旧检查点未必还能使用。正式产品不应该为了“尽量恢复”而硬读未知版本;更稳妥的做法是保留原始素材,提示用户重新建立索引。
二、检查点写入要晚于素材确认
第一次出现脏任务,是因为我在图像写入前更新了帧数。锁屏恰好发生在文件流尚未关闭的时候,Preferences 里写着 384,目录里第 384 张却是零字节。恢复页相信了数字,原生侧读取到损坏输入后才报错,故障位置离真正原因已经很远。
当前实现把顺序改成:写入临时文件、关闭流、校验、原子改名、更新索引,最后才刷新检查点。Preferences 负责保存小体积元数据,不承担大文件存储。
这段代码解决的是“检查点领先于素材”的问题。每次不是都强制落盘,而是每 24 帧或进入后台时写一次,减少高频序列化带来的抖动。
import { preferences } from '@kit.ArkData'
import type { common } from '@kit.AbilityKit'

const STORE_NAME = 'scan_resume_store'
const KEY_ACTIVE = 'active_checkpoint'

export class CheckpointStore {
  constructor(private context: common.UIAbilityContext) {}

  async save(checkpoint: ReconCheckpoint): Promise<void> {
    const store = await preferences.getPreferences(this.context, STORE_NAME)
    await store.put(KEY_ACTIVE, JSON.stringify(checkpoint))
    await store.flush()
  }

  async load(): Promise<ReconCheckpoint | undefined> {
    const store = await preferences.getPreferences(this.context, STORE_NAME)
    const raw = await store.get(KEY_ACTIVE, '') as string
    if (!raw) return undefined
    const value = JSON.parse(raw) as ReconCheckpoint
    return value.schemaVersion === 2 ? value : undefined
  }

  async clear(): Promise<void> {
    const store = await preferences.getPreferences(this.context, STORE_NAME)
    await store.delete(KEY_ACTIVE)
    await store.flush()
  }
}
flush() 放在关键节点显式执行,因为这里需要的是可恢复性,不只是内存中的最新值。另一方面,也不能每来一帧就 flush()。当前 Demo 目标 600 帧,如果每帧都同步检查点,会把采集链路和持久化链路绑在一起。正式项目还应该把异常分类:存储空间不足、JSON 损坏、目录不可访问分别处理,不能统一显示“恢复失败”。
检查点保存完成后,页面状态从 CAPTURING 进入 CHECKPOINTED,HiLog 固定输出:
[ScanResume] task=recon_20261001_09 CAPTURING -> CHECKPOINTED
[ScanResume] confirmed=384 target=600 progress=64%
[ScanResume] checkpoint flushed at 2026-10-01 14:36:18
三、先处理脏目录,再重建流水线
恢复按钮不能一上来就创建新任务。它要先确认三件事:任务目录仍存在;索引中的 384 个文件都可读;目录尾部是否有未登记的临时文件。只有检查通过,才把状态切到 REBUILDING。
这里还有一个容易忽略的边界:原进程如果没有真正死亡,而只是页面被重建,旧回调可能仍在队列里。新控制器启动后,旧回调晚到几百毫秒,就会把 64% 改回 3%,或者把新任务误标为失败。
下面的控制器用 generation 解决回调串线。每次创建或恢复都会递增代次;回调携带创建时的代次,不一致就丢弃。它同时在恢复前调用 cancelAndDispose(),把仍存活的旧流水线收口。
export class ReconSessionController {
  private generation: number = 0
  private state: ReconState = ReconState.IDLE

  async restore(cp: ReconCheckpoint): Promise<void> {
    const current = ++this.generation
    this.state = ReconState.RESTORING

    await nativeRecon.cancelAndDispose()
    const validFrames = await FrameIndex.verify(cp.frameDir, cp.confirmedFrames)
    await FrameIndex.removeUncommittedTail(cp.frameDir)
    if (validFrames !== cp.confirmedFrames) {
      this.state = ReconState.FAILED
      throw new Error(`FRAME_INDEX_MISMATCH:${validFrames}/${cp.confirmedFrames}`)
    }

    this.state = ReconState.REBUILDING
    await nativeRecon.createPipeline({
      taskId: cp.taskId,
      inputDir: cp.frameDir,
      expectedFrames: cp.targetFrames
    }, (event: ReconEvent) => {
      if (current !== this.generation) return
      this.consume(event)
    })
    await nativeRecon.feedExistingFrames(cp.confirmedFrames)
    await nativeRecon.startCaptureFrom(cp.confirmedFrames + 1)
  }

  async dispose(): Promise<void> {
    ++this.generation
    await nativeRecon.cancelAndDispose()
  }
}
这段代码里的 nativeRecon 是 ArkTS 对 Native Bridge 的工程封装,方法名属于 Demo,不是把系统 C API 原样搬进页面。真正的 Spatial Recon Kit 流水线仍在 C/C++ 层创建、喂入数据和释放;ArkTS 负责会话编排、检查点与 UI 状态。这样写的好处是页面不接触裸指针,恢复策略也可以独立测试。
feedExistingFrames() 不等于从 64% 的优化迭代现场继续。它是重新构建输入上下文并复用已确认素材。底层能力若不承诺跨进程保存训练态,就不能在文章里把它包装成“无损断点续训”。当前 Demo 恢复的是采集会话与输入集合,计算阶段可能需要重新执行,这个边界必须向用户说明。
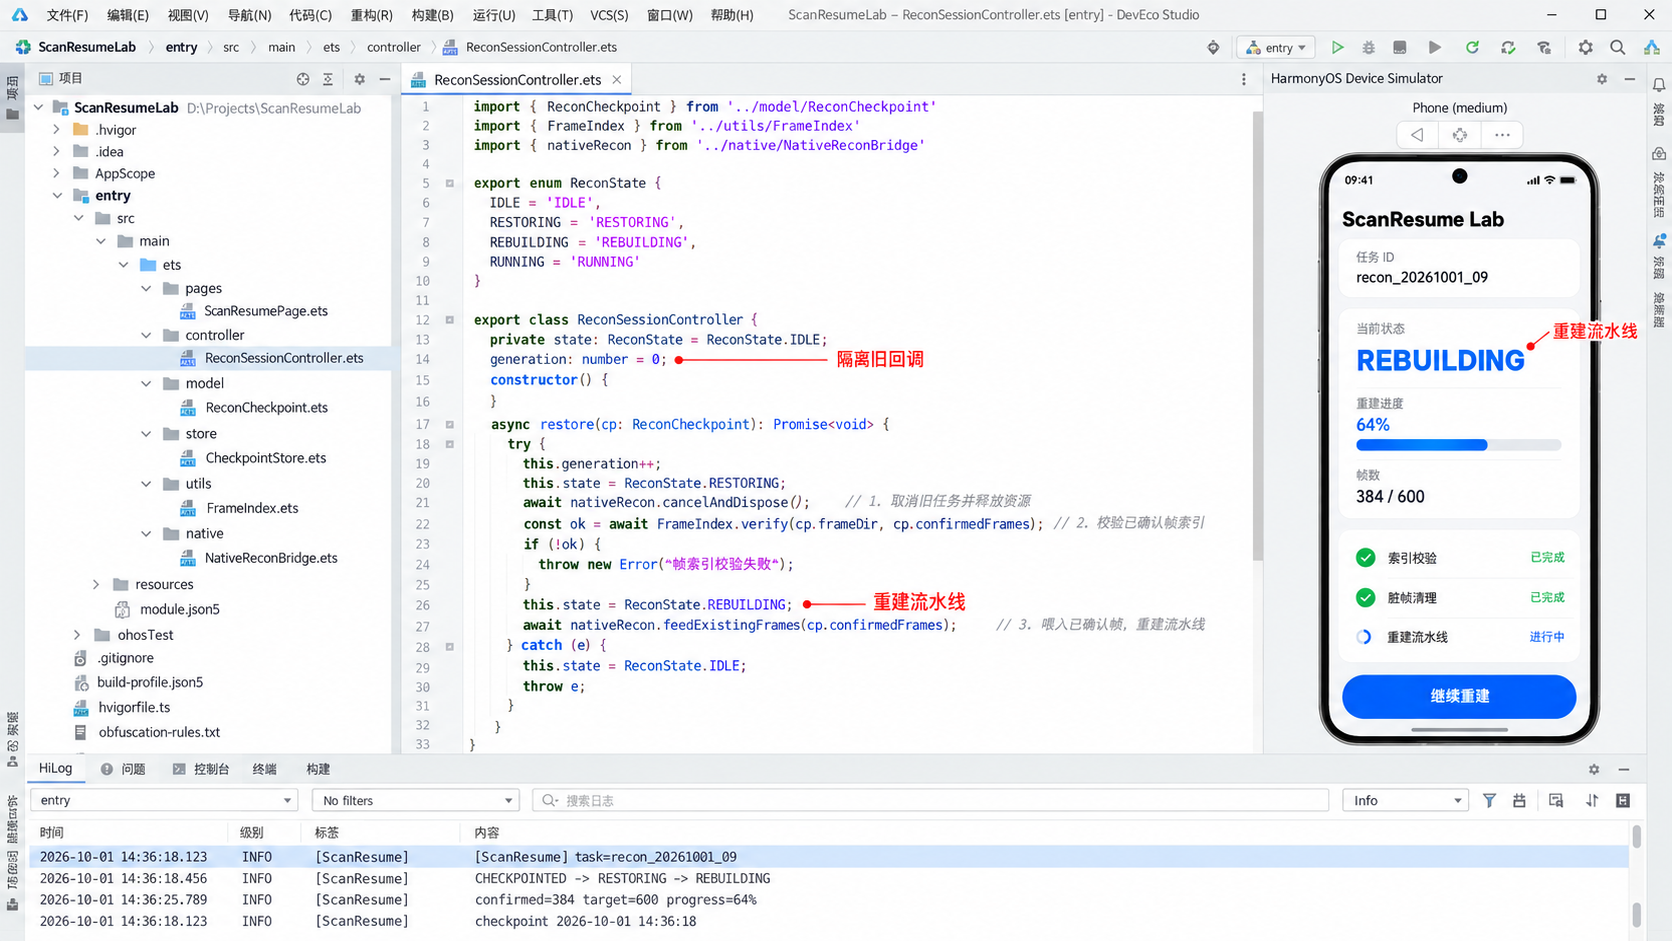
图中的工程目录将 CheckpointStore、FrameIndex 和 ReconSessionController 分开。右侧模拟器显示任务 recon_20261001_09 正在 REBUILDING,底部日志则对应 384 帧校验、脏尾清理和新流水线创建。这样排查时能快速判断失败发生在存储、索引还是 native 管线。
四、前后台切换只发信号,不在生命周期里做重活
另一版代码把目录扫描和流水线释放全部放进 UIAbility.onBackground()。实际用下来不稳:生命周期回调应尽快结束,复杂 I/O 会让切后台变慢;如果释放过程与相机回调并发,还可能出现检查点尚未完成、句柄已经销毁的次序问题。
我最后只在 Ability 层发出“需要收口”的信号,具体工作由控制器串行处理。页面可见性恢复时同样只刷新状态,不自动弹窗、不自动启动相机。
这段代码解决的是生命周期回调承担过多业务的问题。
export default class EntryAbility extends UIAbility {
  onBackground(): void {
    this.context.eventHub.emit('recon:lifecycle', 'BACKGROUND')
  }

  onForeground(): void {
    this.context.eventHub.emit('recon:lifecycle', 'FOREGROUND')
  }

  onDestroy(): void {
    this.context.eventHub.emit('recon:lifecycle', 'DESTROY')
  }
}

// Controller 内部使用串行队列消费:
// BACKGROUND -> commitFrameTail -> saveCheckpoint -> pauseOrDispose
// FOREGROUND -> loadCheckpoint -> verify -> exposeResumeAction
// DESTROY -> invalidateGeneration -> cancelAndDispose
页面返回前台后只展示“发现可恢复任务”,由用户点击“继续重建”。这是一个产品取舍:相机、算力和磁盘读写都属于用户能感知的行为,不应该因为一次前后台切换就静默恢复。重复进入前台时,控制器还会检查是否已有恢复 Promise,避免两次点击或两次生命周期事件创建两条流水线。
五、64% 只是入口,恢复过程要让人看懂
最终页面没有只放一个进度条,而是显示三层信息:检查点是 384/600 帧;当前正在 REBUILDING;恢复动作已经完成“索引校验”和“脏帧清理”,正在“重建原生流水线”。用户可以区分“素材还在”和“计算已继续”,开发者也能从截图复核状态。
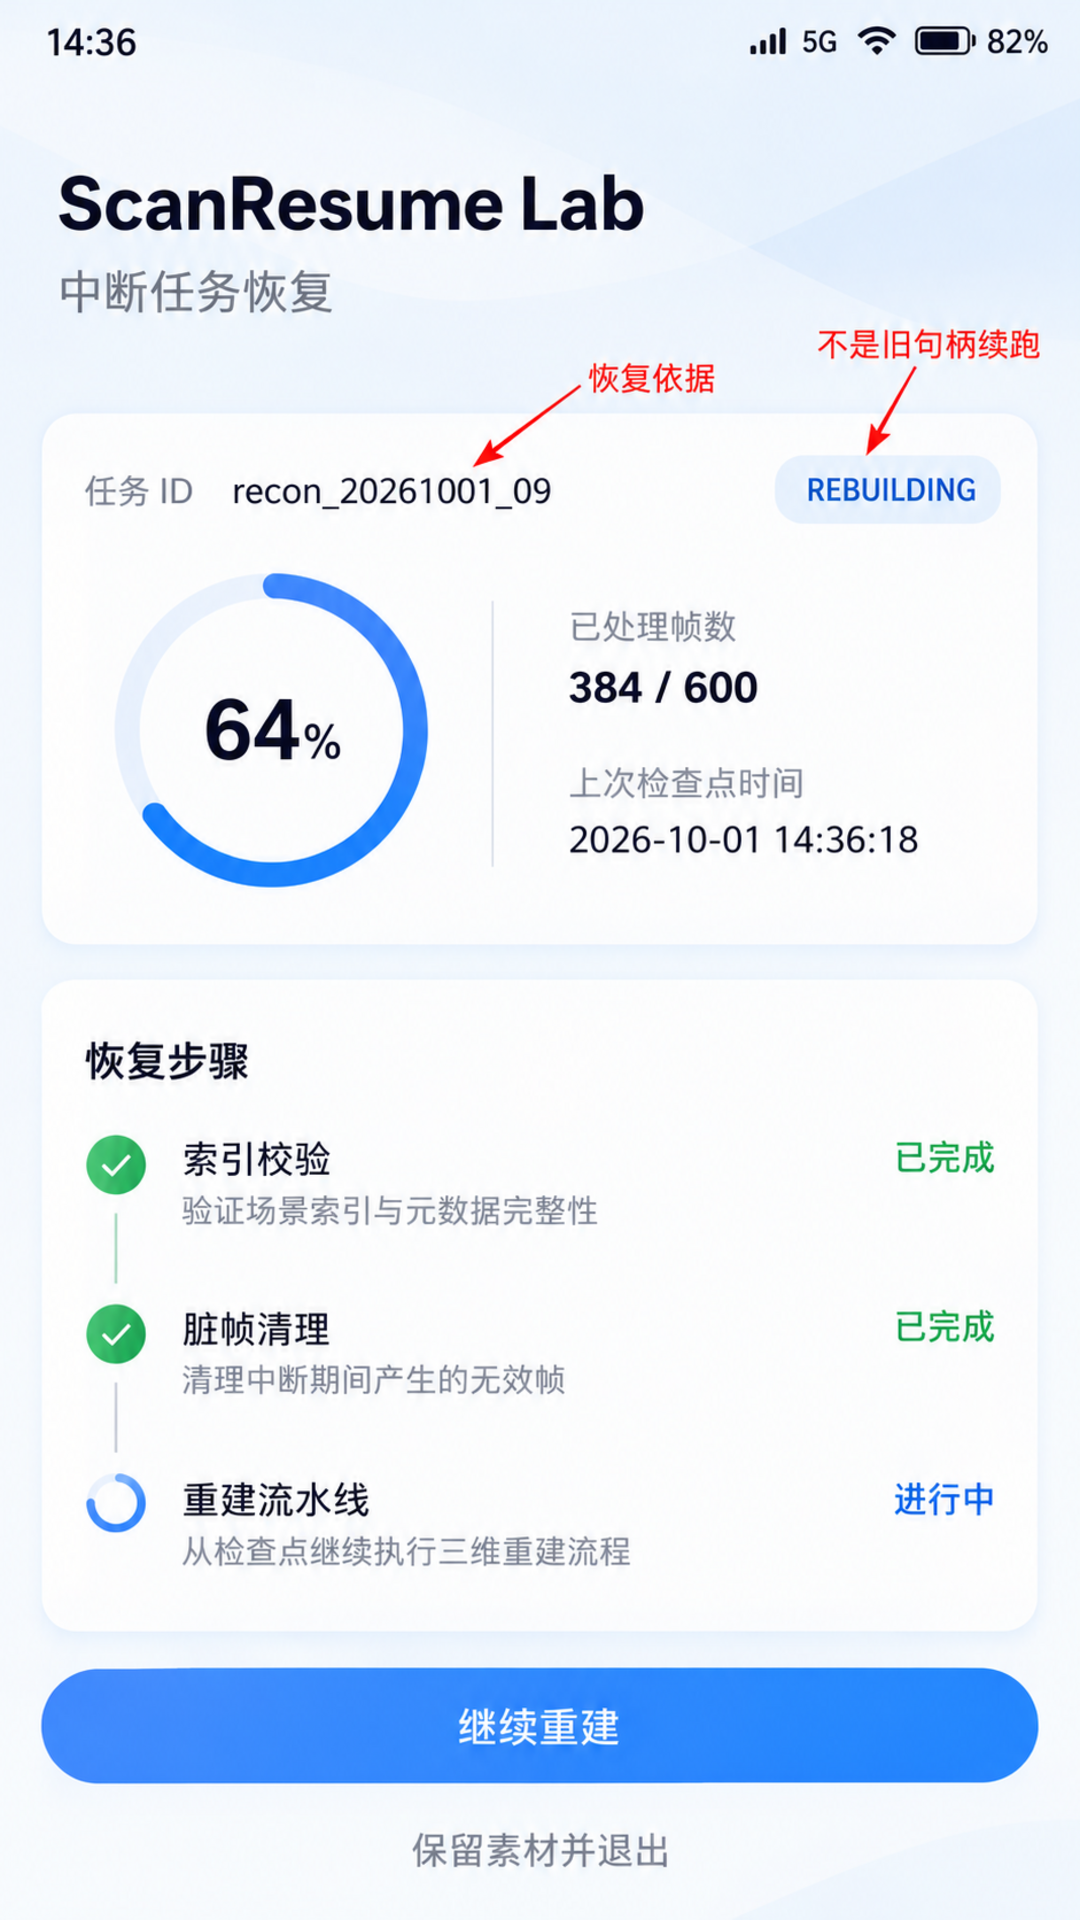
恢复成功后的状态顺序是:
CHECKPOINTED -> RESTORING -> REBUILDING -> CAPTURING -> COMPLETED
最终确认 600 帧,导出 livingroom_20261001_09.splat。如果核验只找到 383 个有效文件,页面不会把进度偷偷改成 63% 然后继续,而是进入 FAILED,显示 FRAME_INDEX_MISMATCH:383/384,保留素材并提供“重建索引”和“新建任务”两个操作。
这个判断看起来保守,却能避免最难查的半恢复状态。对重建类任务来说,进度条好看不重要,输入集合能否解释才重要。
六、正式项目还要补齐的四个边界
第一,存储空间。开始任务前要估算剩余空间,恢复前也要重新检查。用户拍到 64% 时空间不足,不能继续写临时文件,更不能覆盖最后一个有效检查点。
第二,配置兼容。模型版本、相机内参策略、图像方向处理方式发生变化后,应提升 schemaVersion 或单独记录 pipelineConfigHash。配置不一致时保留原素材,禁止直接混入新帧。
第三,热状态与冷状态要区分。页面销毁但进程仍在属于热恢复,可以复用仍被控制器持有的实例;进程重启属于冷恢复,必须重建管线。两条路径最终都要走同一套状态机,不能各写一套 UI。
第四,资源释放必须可重复。cancelAndDispose() 要做到幂等:没有任务时调用不报错,任务取消后再次调用不释放其他实例。回调、纹理、文件描述符和 native 内存都要在同一个所有权模型里收口。
七、这次改动真正解决了什么
最后回看,这次工作并没有创造一个神奇的“断点续训 API”,而是把原来含糊的“继续任务”拆成了一条可验收的工程链路:素材先确认,检查点后写入;恢复先核验,流水线后重建;旧回调靠代次隔离;前后台只传递事件;失败时保留证据,不伪造进度。
实际用下来,最明显的变化不是恢复速度,而是每一种失败都能落到具体阶段。看到 RESTORING 就查目录和索引,看到 REBUILDING 就查 Native Bridge,看到 CAPTURING 卡住再查相机输入。状态拆清楚以后,3DGS 端侧重建才从一次性 Demo 变成能承受真实手机生命周期的工程能力。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献75条内容

所有评论(0)