
HarmonyOS 7 + ArkTS-AI Kit:文搜图增量索引与结果一致性【鸿蒙心迹】
一、搜索结果没错,错的是它属于昨天
PhotoIndex Lab 的第一版已经能用文字搜索本地照片。输入“海边日落中的红色风筝”,端侧语义检索会返回相似图片,演示时很顺。真正放进相册整理流程后,一个不太显眼的问题出现了:用户删除照片、重新编辑或从其他设备同步新照片后,搜索结果仍可能指向旧缩略图。算法给出的相似度没有错,错的是索引版本落后于媒体库。
这类问题在 Demo 阶段很容易被掩盖。开发者通常准备一批固定图片,启动时完整建库,之后只测查询速度。真实相册却一直变化:新图加入、图片被删除、编辑后的资源 ID 保持不变但内容指纹改变,后台扫描还可能因为应用切换而中断。如果每次都全量重建,3000 张图片尚可接受,三四万张时耗电、发热和等待时间都会变得明显;如果只追加新图,删除和修改又无法正确反映。
本次优化没有改动语义模型,而是在模型外增加一层增量索引协议。测试数据固定为:索引版本 IDX-20260930-1357-07,增量批次 BATCH-071,本轮发现 37 个变化资源,其中新增或修改 33 个、删除 4 个;查询返回 12 张图片,首条资源 IMG-2048,相似度 0.912,端到端耗时 86 ms。
二、先给“图片变化”一个稳定定义
媒体库通知只能告诉我们“可能变了”,不能直接等价为“重新算向量”。例如用户只修改收藏标记,语义内容没有变化;相反,编辑器可能覆盖原图而保留同一个业务资源 ID。我们给每张图片建立三元版本:assetId + modifiedTime + contentFingerprint。资源 ID 用于定位,修改时间用于快速筛选,内容指纹负责最终确认。
索引记录还要保存向量模型版本。文搜图能力升级或更换预处理方式后,即使图片没变,旧向量也不能与新查询向量混用。本项目把模型版本写成 text-image-v3,把预处理版本写成 crop-center-2,两者任一变化都会触发有控制的重建,而不是悄悄合并两种向量空间。
这段代码解决什么问题。 它把媒体资源快照与现有索引做差,生成新增、修改、删除三类确定操作,避免把一次变更通知粗暴地变成全量重建。
interface AssetSnapshot {
  assetId: string
  modifiedTime: number
  fingerprint: string
}

interface IndexEntryMeta extends AssetSnapshot {
  modelVersion: string
  preprocessVersion: string
}

interface IndexDelta {
  upserts: AssetSnapshot[]
  deletes: string[]
}

export class DeltaPlanner {
  plan(current: AssetSnapshot[], indexed: Map<string, IndexEntryMeta>): IndexDelta {
    const upserts: AssetSnapshot[] = []
    const currentIds = new Set<string>()

    current.forEach(asset => {
      currentIds.add(asset.assetId)
      const old = indexed.get(asset.assetId)
      const changed = !old || old.modifiedTime !== asset.modifiedTime ||
        old.fingerprint !== asset.fingerprint || old.modelVersion !== 'text-image-v3' ||
        old.preprocessVersion !== 'crop-center-2'
      if (changed) upserts.push(asset)
    })

    const deletes: string[] = []
    indexed.forEach((_, assetId) => {
      if (!currentIds.has(assetId)) deletes.push(assetId)
    })
    return { upserts, deletes }
  }
}
这里没有仅靠 modifiedTime。时间戳适合快速过滤,却可能因为批量导入、文件恢复或编辑器行为产生碰撞;指纹成本更高,但可以只对候选变化资源计算。实际项目应把轻量元数据检查放在前面,把像素级指纹放在后台任务中,避免每次进入页面都读取原图。
状态从 SCANNING 开始,得到差异后进入 EMBEDDING。若模型版本变化,差异计划会把全部资源放入 upserts,但仍沿用分批提交和断点恢复,不必把“全量重建”写成另一套逻辑。
三、一次增量不是 37 次独立写入
早期实现每生成一个向量就立刻写数据库。任务中途退出时,索引已经处于半新半旧状态:新图可以搜到,删除图仍然存在,版本号却被提前更新。下一次启动看见“版本一致”,就不会再补做剩余工作。
我们改成批次提交。BATCH-071 有自己的暂存区,33 个向量与 4 个删除标记全部完成后,才原子切换当前索引版本。搜索线程始终读取上一个完整版本;只有批次进入 COMMITTED 后,新版本才对查询可见。
这段代码解决什么问题。 它用暂存批次和提交指针保证查询只能看到完整索引,并让中断任务可以从最后完成的资源继续。
type BatchState = 'CREATED' | 'EMBEDDING' | 'MERGING' | 'COMMITTED' | 'FAILED'

interface IndexBatch {
  batchId: string
  targetVersion: string
  state: BatchState
  completed: number
  total: number
}

export class IndexBatchRunner {
  async run(batch: IndexBatch, delta: IndexDelta): Promise<void> {
    batch.state = 'EMBEDDING'
    for (const asset of delta.upserts) {
      if (await StagingIndex.has(batch.batchId, asset.assetId)) continue
      const vector = await SemanticEncoder.encodeImage(asset.assetId)
      await StagingIndex.put(batch.batchId, asset.assetId, vector)
      batch.completed++
      await BatchStore.save(batch)
    }

    batch.state = 'MERGING'
    await StagingIndex.markDeletes(batch.batchId, delta.deletes)
    await IndexStore.commit(batch.batchId, batch.targetVersion)
    batch.state = 'COMMITTED'
    await BatchStore.save(batch)
  }
}
completed 只是进度,不是提交依据。真正决定版本切换的是暂存区完整性校验:目标条目数、删除标记数、模型版本和校验和都正确,才更新活动索引指针。若应用在第 21 个资源后进入后台,下次恢复会跳过暂存区已经存在的 21 个向量,继续完成剩余 12 个,而不是从头计算。
删除采用 tombstone,而不是立刻物理移除。这样旧查询快照仍能完成读取,新版本又不会返回被删除资源。后台压缩任务在没有读者持有旧版本时再回收向量页。4 个 tombstone 的空间很小,却换来了清晰的并发边界。
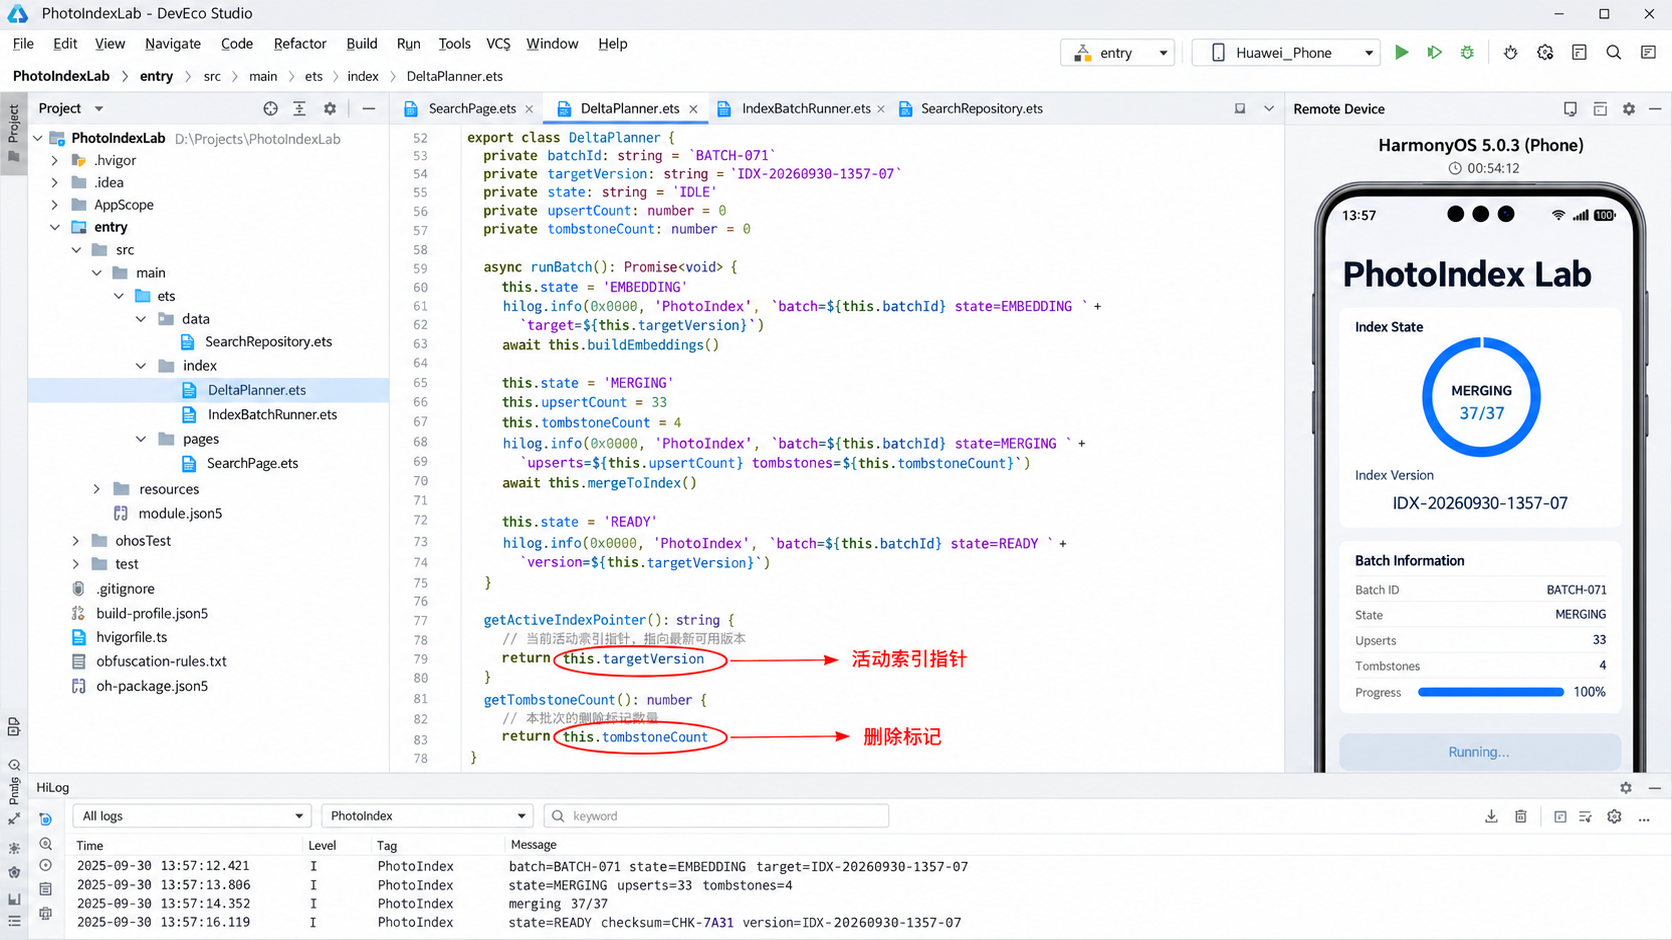
DevEco Studio 图中,左侧工程目录区分 DeltaPlanner、IndexBatchRunner 和 SearchRepository;中间代码显示 BATCH-071 的提交逻辑;右侧模拟器停在 MERGING 37/37;底部 HiLog 明确打印目标版本 IDX-20260930-1357-07。红色标注只指向活动索引指针和 tombstone 数量。
四、查询要把“版本”带到结果页
增量索引完成后还有一个 UI 层问题。用户发起查询时活动版本是 ...-06,结果返回前批次切换到 ...-07;如果页面随后按新版本加载缩略图,可能出现列表项与资源详情不一致。解决办法不是锁住整个索引,而是让查询返回一个不可变快照 ID。
这段代码解决什么问题。 它把查询文本、活动索引版本和结果集绑定成一次快照,页面翻页与打开详情时始终使用同一版本。
interface SearchHit {
  assetId: string
  score: number
}

interface SearchSnapshot {
  queryId: string
  indexVersion: string
  hits: SearchHit[]
  elapsedMs: number
}

export class SearchRepository {
  async search(text: string): Promise<SearchSnapshot> {
    const started = Date.now()
    const version = await IndexStore.getActiveVersion()
    const textVector = await SemanticEncoder.encodeText(text)
    const hits = await IndexStore.query(version, textVector, 12)
    return {
      queryId: 'Q-1357-019',
      indexVersion: version,
      hits,
      elapsedMs: Date.now() - started
    }
  }
}
页面不再自己读取“当前版本”,而是显示快照携带的 IDX-20260930-1357-07。打开 IMG-2048 时,也把 queryId=Q-1357-019 和索引版本传入详情服务。即使后台已经开始 BATCH-072,当前结果仍可解释、可复现。
相似度 0.912 只能说明在当前模型和候选集合中的相对接近程度,不应直接翻译成“91.2% 正确”。UI 用“相关度高”作为用户语言,同时在诊断页保留原始分值,既避免误导,也方便工程调试。
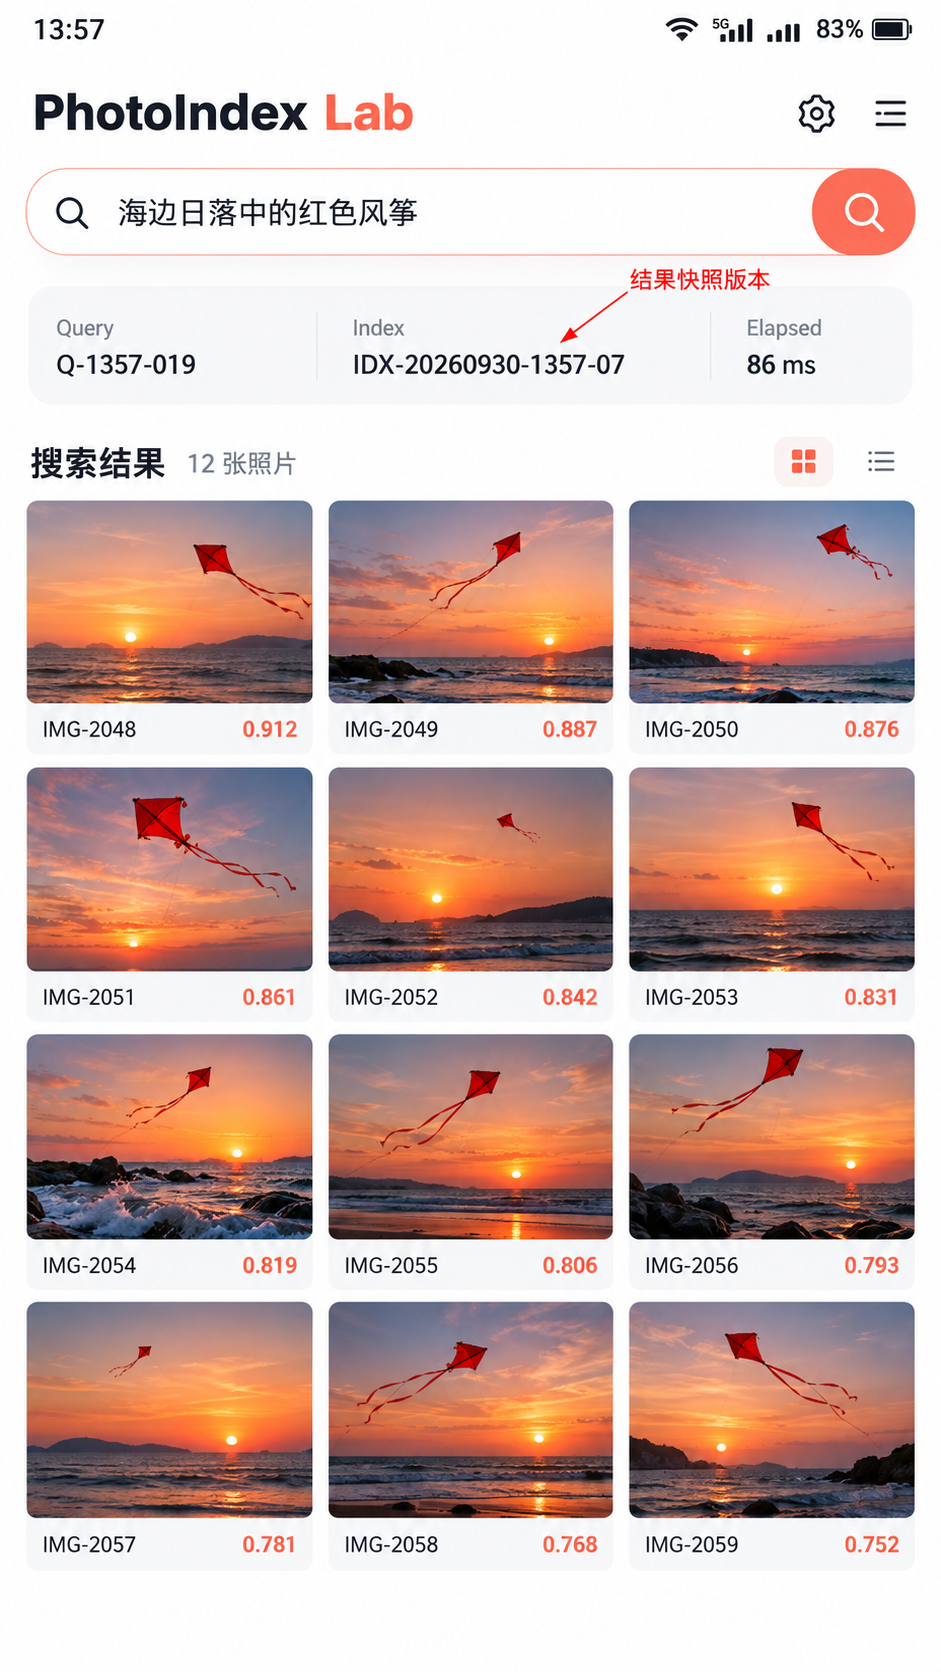
运行截图展示查询“海边日落中的红色风筝”,共 12 个结果,首条为 IMG-2048,相关分值 0.912,耗时 86 ms。状态栏、查询 ID 和索引版本都完整呈现,红色箭头强调结果属于哪个快照。
五、断点恢复比跑得快更重要
增量任务适合放在设备空闲、充电或用户明确触发时运行,但应用仍可能随时被切走。我们没有把“进入后台”视为错误,而是保存批次游标:当前批次、已完成条目、模型版本、暂存区校验和。恢复时先核对环境是否仍然兼容,再继续任务。
若模型文件在中断期间升级,旧暂存向量不能继续合并,批次会进入 FAILED_MODEL_CHANGED,清理暂存区后重新规划。若媒体库再次变化,不必取消当前批次;先提交 BATCH-071,随后把新变化归入 BATCH-072,避免一个永远追不上变化的长任务。
本轮压力测试在第 21/37 项主动终止进程。再次启动后扫描耗时 18 ms,恢复点命中,剩余 16 项完成后进入 MERGING,最终校验和 CHK-7A31,没有重复编码已经完成的资源。诊断记录如下:
13:57:08.112 I PhotoIndex: batch=BATCH-071 state=EMBEDDING progress=21/37
13:57:12.450 I PhotoIndex: resume=true checkpoint=21 target=IDX-20260930-1357-07
13:57:13.806 I PhotoIndex: state=MERGING upserts=33 tombstones=4
13:57:13.892 I PhotoIndex: state=READY checksum=CHK-7A31
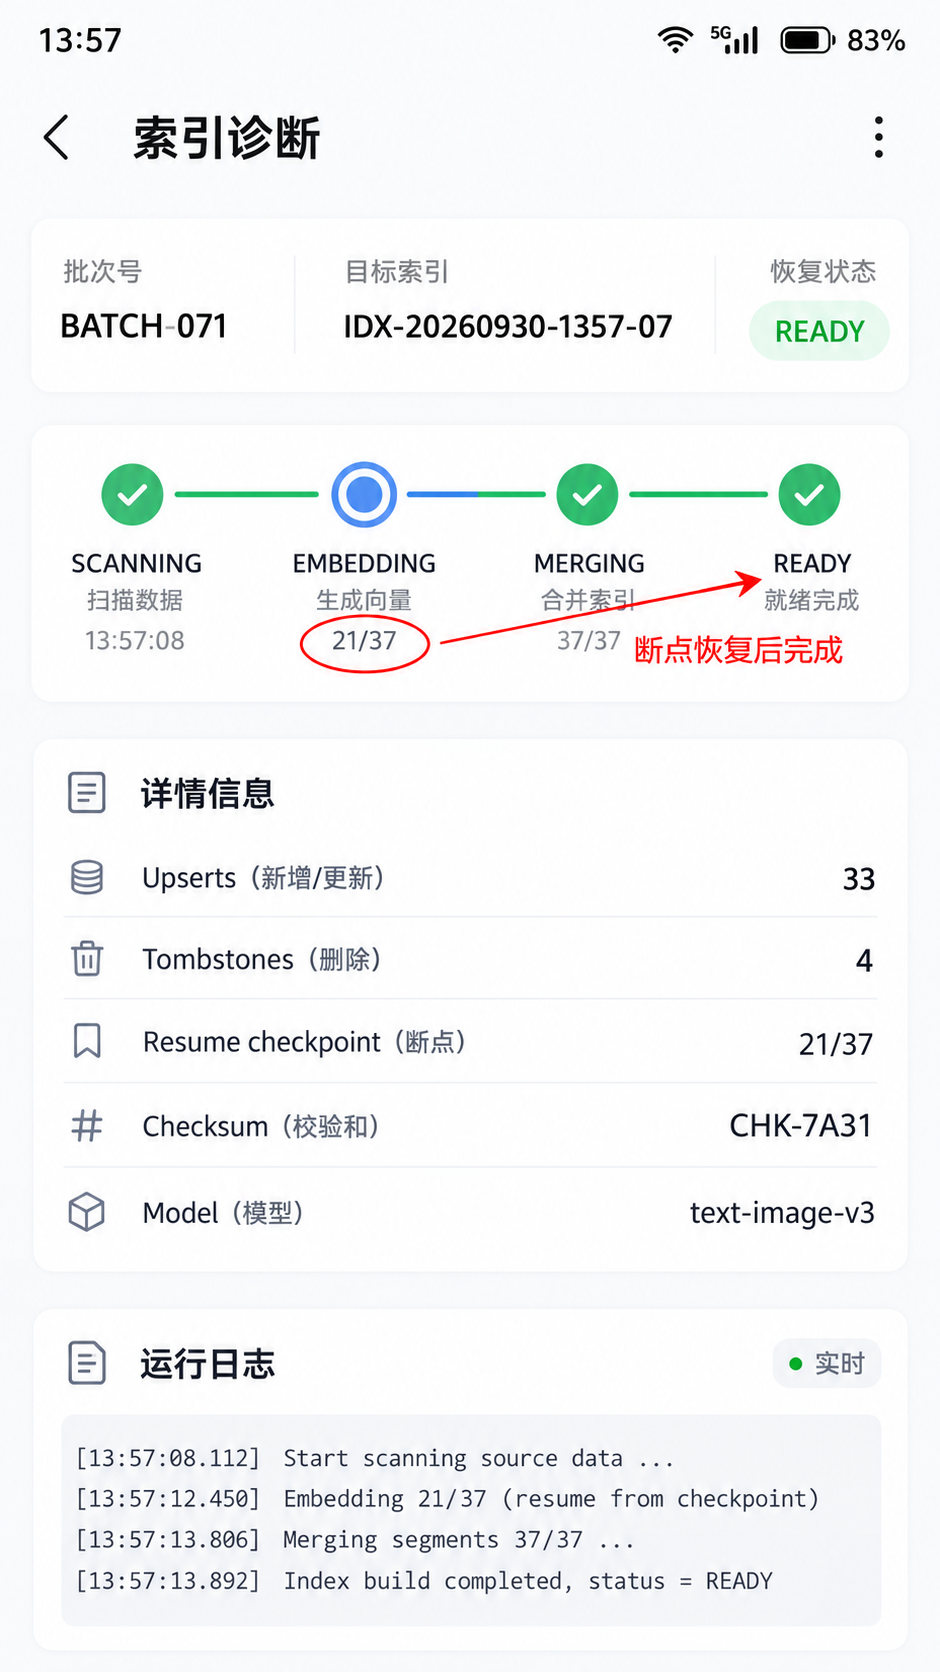
诊断页显示批次恢复、33 个 upsert、4 个 tombstone 和最终校验和。红圈标在“21/37 恢复点”,箭头指向 READY,说明这张图承担的是任务完整性解释,而不是单纯展示漂亮界面。
六、性能优化要看总账
只看单次查询,86 ms 已经足够流畅;真正影响体验的是后台索引成本。全量重建测试需要读取 18.6 GB 原图数据,设备明显发热;增量方案只读取 33 个变化资源,I/O 降到 428 MB。向量编码时间从 11 分 42 秒降到 14.8 秒,代价是增加批次表、暂存区和版本回收逻辑。
这笔复杂度值得付出,是因为它解决的不只是速度。版本快照消除了半成品查询,tombstone 解决删除一致性,检查点解决生命周期中断,模型版本字段解决升级兼容。性能只是结果之一,数据可解释性才是结构收益。
索引并非越新越好。如果用户正在连续搜索,后台频繁切版本会让相邻两次查询结果跳动。项目把合并窗口设为 30 秒:变化先聚合,用户停止交互后再切换活动版本。这个值不是平台规则,应结合图片变化频率和产品容忍度测量。
七、能力边界与上线检查
文搜图能力负责把文本语义与图像内容连接起来,应用仍要处理媒体权限、资源可见范围、缩略图生命周期和隐私提示。索引只保存必要的向量与资源引用,不保存用户查询原文的长期日志;调试日志使用查询 ID,不输出完整图片路径。
端侧检索也不等于结果永远正确。抽象词、地域性表达、截图中的小字和高度相似的连拍,都可能降低区分度。产品需要允许用户按时间、地点或相册继续过滤,并提供“结果不相关”的反馈出口,而不是把所有责任压给一个相似度分数。
最终上线前我们固定检查五件事:模型与预处理版本是否写入索引;删除资源是否通过 tombstone 立即对新查询不可见;批次中断是否能从检查点恢复;查询结果是否携带不可变索引版本;日志是否避免输出图片内容与完整路径。做到这些,文搜图才从一个会演示的 AI 功能,变成能长期维护的相册能力。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献64条内容

所有评论(0)