
HarmonyOS 7 Node-API + Rust FFI:三方 Rust 库 C ABI 封装与 Native 崩溃边界【鸿蒙心迹】
把一个 Rust 库编译进 HarmonyOS 工程并不难,真正麻烦的是“出错以后会发生什么”:参数错误应该回到 ArkTS,Rust panic 不能穿过 FFI,真正的 Native 越界更不是 try/catch 能兜住。这次我用一个感知哈希库,把边界一层层拆开。
一、我不是为了“用 Rust”而用 Rust
这次 Demo 叫 RustHashLab,做的是相册重复图片诊断。
测试批次固定为:
RUST-20260930-019
扫描图片:24 张
重复分组:3 组
Native 调用:24 次
Rust 错误:1 次
业务本身并不复杂:读取图片,交给 Rust 三方库计算感知哈希,再按汉明距离做相似分组。
真正让我重新改架构的,是第 13 张测试图 IMG_2026_0912.jpg。
这张图故意做成损坏文件。最早版本里,ArkTS 直接通过 Node-API 调 C++,C++ 再调 Rust。Rust 库内部对图片解码结果做了一个 unwrap(),结果不是正常返回错误,而是直接 panic。
在纯 Rust 程序里,panic 还能沿 Rust 调用栈处理;跨到 C ABI 以后,事情就不一样了。panic 不能被当成一种正常跨语言异常机制。 如果让它跨过 FFI 边界,轻则进程中止,重则进入未定义行为风险。
于是我把这次接入目标改成了三层:
ArkTS
↓ Node-API
C++ Bridge
↓ C ABI
Rust Wrapper
↓
第三方 Rust Library
三层分别处理三类问题:
- ArkTS 参数不合法:Node-API 直接抛 JS/ArkTS 异常;
- Rust 可预期错误或 panic:在 Rust C ABI 边界内收口成状态码;
- 真正的 Native 越界、非法指针、SIGSEGV:不能假装能被 ArkTS try/catch 捕获,只能依赖更严格的内存管理和崩溃诊断。
HarmonyOS 的 Node-API 本来就是 ArkTS/JS 与 C/C++ 交互的稳定桥梁。我的做法不是让 ArkTS 直接理解 Rust,而是让 Rust 先表现成一个普通 C 库,再由 Node-API 暴露给 ArkTS。
二、Rust 对外只暴露 C ABI,不把第三方类型带出去
第三方库内部可能有 Result<T, E>、枚举、泛型、trait 对象,这些都不适合直接穿过语言边界。
我最后只暴露一个非常窄的 C 接口:
typedef enum {
  RUST_OK = 0,
  RUST_INVALID_IMAGE = 1,
  RUST_IO_ERROR = 2,
  RUST_PANIC = 3
} RustStatus;

RustStatus rh_hash_file(const char* path, uint64_t* hash_out);
这段代码解决什么问题:把复杂的 Rust 返回值压缩成稳定的 C ABI,让上层只处理状态码和基础类型。
Rust 侧的关键实现如下:
use std::ffi::CStr;
use std::os::raw::c_char;
use std::panic::{catch_unwind, AssertUnwindSafe};

#[repr(C)]
pub enum RustStatus {
    Ok = 0,
    InvalidImage = 1,
    IoError = 2,
    Panic = 3,
}

#[no_mangle]
pub extern "C" fn rh_hash_file(
    path: *const c_char,
    hash_out: *mut u64,
) -> RustStatus {
    if path.is_null() || hash_out.is_null() {
        return RustStatus::IoError;
    }

    let result = catch_unwind(AssertUnwindSafe(|| {
        let c_path = unsafe { CStr::from_ptr(path) };
        let path_str = c_path.to_str().map_err(|_| RustStatus::IoError)?;

        let hash = compute_hash(path_str)
            .map_err(|_| RustStatus::InvalidImage)?;

        unsafe {
            *hash_out = hash;
        }
        Ok::<(), RustStatus>(())
    }));

    match result {
        Ok(Ok(())) => RustStatus::Ok,
        Ok(Err(status)) => status,
        Err(_) => RustStatus::Panic,
    }
}
catch_unwind() 在这里不是“万能崩溃捕获器”。
它只能把 Rust 的 unwind 型 panic 收口在 Rust 内部。真正的段错误、非法内存访问、进程 abort,不会因此变成 RustStatus::Panic。这一点必须说清楚,否则很容易给团队一种“Native 代码已经安全了”的错觉。
我也不会把 catch_unwind() 包在整个应用所有 Rust 逻辑外面。它应该只存在于明确的 FFI 出口,作用是阻止 Rust panic 穿出 C ABI。
三、Node-API 只做类型转换和异常映射,不承载业务算法
C++ 这一层我刻意写得很薄。
这段代码解决什么问题:检查 ArkTS 参数,调用 Rust C ABI,并把 Rust 状态码转换成 ArkTS 可处理的异常。
#include "napi/native_api.h"
#include "rust_bridge.h"
#include <string>

static napi_value HashFile(napi_env env, napi_callback_info info)
{
    size_t argc = 1;
    napi_value argv[1] = { nullptr };
    napi_get_cb_info(env, info, &argc, argv, nullptr, nullptr);

    if (argc != 1) {
        napi_throw_error(env, nullptr, "hashFile requires one file path");
        return nullptr;
    }

    bool isString = false;
    napi_is_string(env, argv[0], &isString);
    if (!isString) {
        napi_throw_error(env, nullptr, "file path must be string");
        return nullptr;
    }

    size_t len = 0;
    napi_get_value_string_utf8(env, argv[0], nullptr, 0, &len);

    std::string path(len + 1, '\0');
    napi_get_value_string_utf8(
        env, argv[0], path.data(), path.size(), &len
    );
    path.resize(len);

    uint64_t hash = 0;
    RustStatus status = rh_hash_file(path.c_str(), &hash);

    if (status != RUST_OK) {
        std::string message =
            "rust hash failed, code=" + std::to_string(status);
        napi_throw_error(env, nullptr, message.c_str());
        return nullptr;
    }

    napi_value result = nullptr;
    napi_create_bigint_uint64(env, hash, &result);
    return result;
}
Node-API 这一层最容易变坏的写法,是顺手把图片分组、缓存、线程池都塞进 C++。
这样一旦出问题,就很难回答“是 ArkTS 状态错了、C++ 桥接错了,还是 Rust 库错了”。
我只让 Bridge 做三件事:校验、转换、映射。
真正的图片去重策略仍然留在 ArkTS 服务层;哈希算法留在 Rust;跨语言桥只负责把两边接起来。
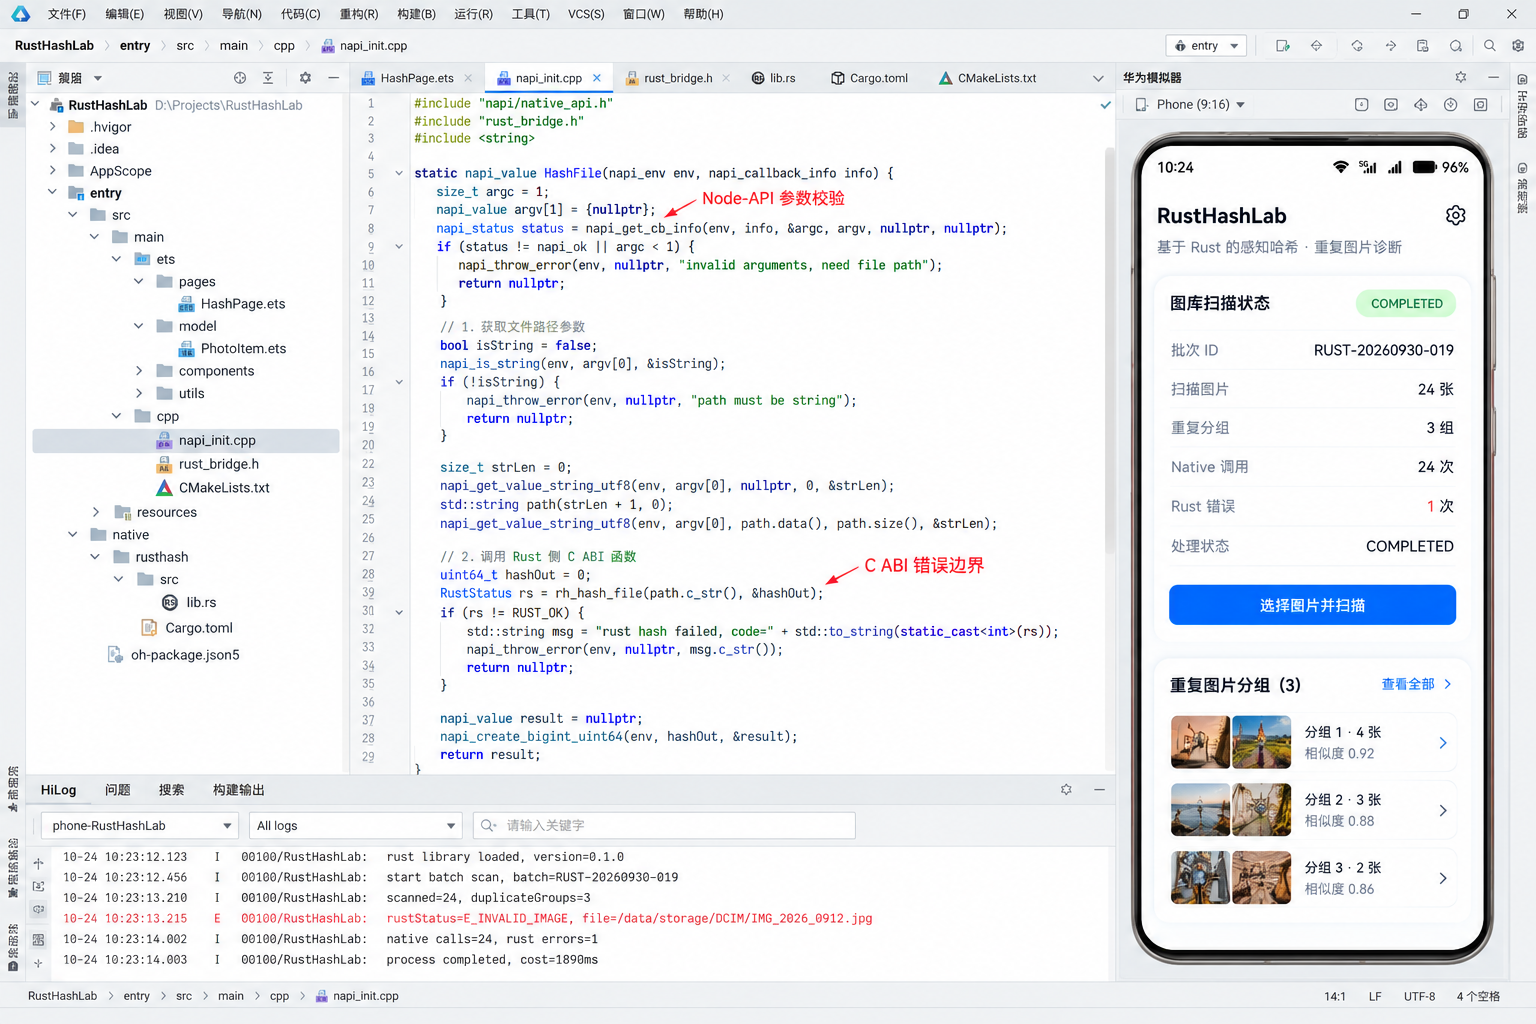
图二里调试现场保持了同一批数据:RUST-20260930-019、24 次 Native 调用、1 次 Rust 错误。底部 HiLog 能看到损坏文件最终变成 RUST_INVALID_IMAGE,而不是把进程直接打掉。
四、ArkTS 看到的是普通异常,不需要知道 panic 是什么
Bridge 稳定以后,ArkTS 侧反而最简单。
这段代码解决什么问题:单张 Native 处理失败时,只标记当前文件,不让整个批次中断。
import rustHash from 'librusthash.so'
import { hilog } from '@kit.PerformanceAnalysisKit'

interface HashResult {
  path: string
  hash?: bigint
  error?: string
}

async function scanImages(paths: string[]): Promise<HashResult[]> {
  const results: HashResult[] = []

  for (const path of paths) {
    try {
      const hash = rustHash.hashFile(path)
      results.push({ path, hash })
    } catch (error) {
      hilog.error(
        0x0000,
        'RustHashLab',
        `hash failed: ${path}, ${JSON.stringify(error)}`
      )
      results.push({
        path,
        error: 'RUST_INVALID_IMAGE'
      })
    }
  }

  return results
}
我没有因为一张损坏图失败就让 24 张批次一起失败。
这也是三方 Native 库接入以后很重要的一层业务判断:底层错误应该怎样影响上层任务?
RustHashLab 里,图片损坏属于单项失败,继续扫描后面的图;如果是库加载失败、ABI 不兼容、初始化失败,那才应该让整批任务停止。
把错误严重性分层以后,页面状态就不会只剩一个“失败”。
五、真正的 Native 崩溃,ArkTS try/catch 救不了
这是这次最想强调的边界。
如果 C++ 传了悬空指针,或者 Rust unsafe 代码访问非法内存,进程级崩溃不是:
try {
  nativeCall()
} catch (e) {
}
就能兜住的。
ArkTS 异常只适合处理 Node-API 主动抛回来的异常。真正的 Native crash 需要从源头降低发生概率:
- C ABI 参数尽量只用 POD / 基础类型;
- 不跨边界传 Rust 生命周期引用;
- 不把 Rust 分配的内存交给 C++ 随意 free;
- 明确“谁分配谁释放”;
- 所有裸指针在进入 Rust 前先检查;
unsafe控制在最小范围;- Native 代码开启日志和符号信息,出问题用崩溃栈定位。
如果确实需要返回字符串或缓冲区,我会设计成:
Rust 分配
→ 返回 pointer + length
→ C++ 读取
→ 调 Rust 提供的 free 函数
而不是 Rust malloc 一块,C++ 想当然用另一套释放接口处理。
六、CMake 和 Cargo 的真正边界是“产物”,不是互相接管构建
这次三方库不是把整个 HarmonyOS 工程改成 Cargo 项目。
我的做法是先让 Rust crate 产出稳定的静态库或动态库,再让 HarmonyOS Native 工程通过 CMake 链接。
目录大概是:
RustHashLab/
├── entry/src/main/ets/
├── entry/src/main/cpp/
│   ├── napi_init.cpp
│   ├── rust_bridge.h
│   └── CMakeLists.txt
└── native/rusthash/
    ├── src/lib.rs
    └── Cargo.toml
CMake 只关心目标库文件和头文件,Cargo 只关心 Rust crate 怎么编译。
这种边界比“让一个脚本把所有事情都做了”更容易排错。Rust 编译失败先在 Cargo 层解决,Node-API 链接失败再查 CMake,ArkTS 调用失败最后看模块导出。
七、我专门留了一张坏图,而不是把异常案例删掉
最终运行结果是:
扫描图片:24
重复分组:3
Native 调用:24
Rust 错误:1
状态:COMPLETED
损坏文件:
IMG_2026_0912.jpg
RUST_INVALID_IMAGE
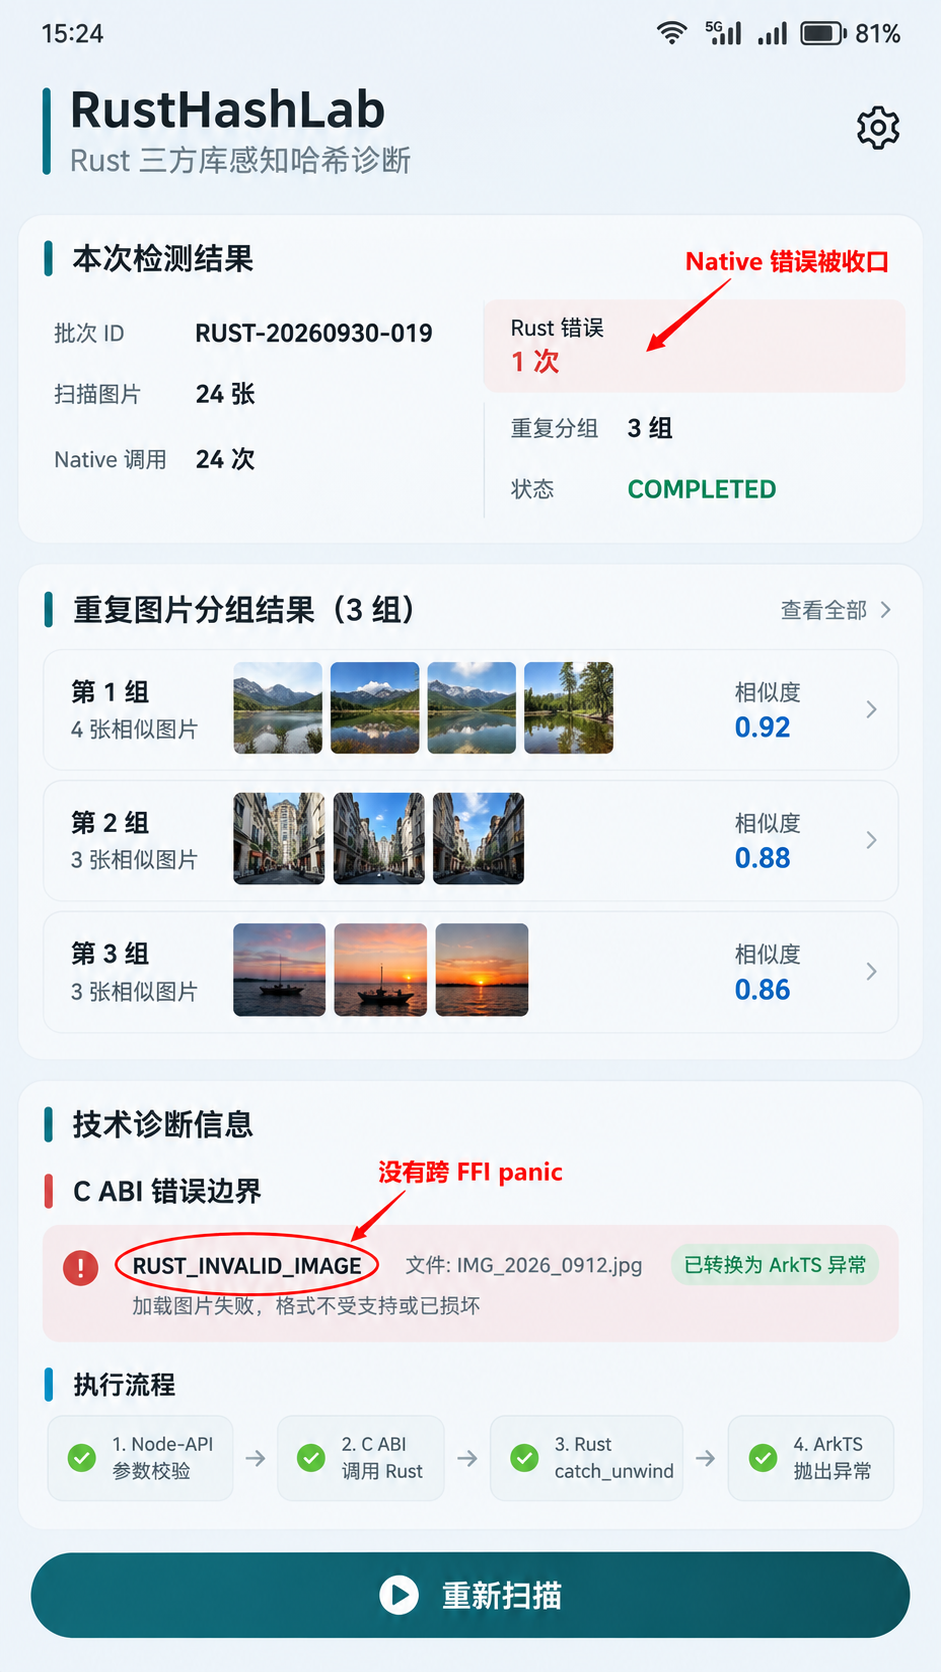
图三里把这条错误专门圈出来了。
执行流程是:
Node-API 参数校验
→ C ABI 调 Rust
→ Rust catch_unwind
→ 状态码返回
→ ArkTS 抛出并记录当前文件异常
最重要的是“没有跨 FFI panic”。
这张图不是要证明“Rust 永远不会崩”,而是证明可预期的第三方库错误已经被收口到了明确边界内。
八、Rust 库能编译过,不代表 ABI 就已经稳定
这次把第三方库接进来以后,我专门做了一轮“升级 Rust 依赖”的测试。
最容易踩的坑,是 Node-API 这一层虽然没改,Rust crate 升级以后内部类型、错误枚举甚至哈希算法参数都发生了变化。如果 C++ Bridge 直接 include Rust 侧自动生成的大量结构体,很容易被下层变化牵着走。
所以我后来把 rust_bridge.h 控制得非常小。
对外只暴露:
uint32_t rh_abi_version();
RustStatus rh_hash_file(const char* path, uint64_t* hash_out);
启动时先检查 ABI 版本。
这段代码解决什么问题:应用加载 Native 模块时先确认 Rust 库 ABI 版本,避免“能链接但语义已经不一致”。
constexpr uint32_t EXPECTED_ABI = 3;

static bool CheckRustAbi()
{
    uint32_t actual = rh_abi_version();
    if (actual != EXPECTED_ABI) {
        OH_LOG_ERROR(
            LOG_APP,
            "rust abi mismatch, expected=%{public}u actual=%{public}u",
            EXPECTED_ABI,
            actual
        );
        return false;
    }
    return true;
}
我不建议用 Rust crate 的版本号直接代替 ABI 版本。
0.6.2 → 0.6.3 可能完全不影响 C 接口,也可能因为自己的 Wrapper 改动导致 ABI 不兼容。ABI 版本应该由桥接层自己维护,只在跨语言契约变化时升级。
这样做以后,升级三方库就多了一道显式保护。至少不会出现 Rust 内部已经把某个状态码重新排序,C++ 仍然按旧枚举解释的情况。
九、字符串和缓冲区是 FFI 最容易把“谁负责释放”写乱的地方
感知哈希这次只返回 uint64_t,所以内存所有权非常简单。
但我还是提前验证了一个返回诊断字符串的场景。比如 Rust 侧希望把详细错误原因返回给 C++,如果直接返回 String 指针,然后 C++ 用 free() 释放,就可能把两个不同分配器混在一起。
我的规则是:
哪一侧分配,哪一侧提供释放函数。
如果 Rust 返回缓冲区,就同时提供:
RustBuffer rh_last_error();
void rh_free_buffer(RustBuffer buffer);
C++ 读取后调用 rh_free_buffer(),绝不自己猜释放方式。
同理,C++ 传给 Rust 的 const char* 默认只在当前调用期间有效,Rust 不能把这个地址偷偷保存到全局变量里,等下一次再用。
这种问题在 Demo 里未必立刻出现,但一旦碰到批量任务和异步线程,悬空指针往往比普通业务 Bug 难排得多。
十、CPU 密集型 Rust 逻辑不要长期堵住 ArkTS 主线程
24 张测试图片规模不大,但感知哈希本身属于 CPU 和解码混合型工作。
如果 Node-API 暴露的是同步函数,ArkTS 在 UI 主线程连续调用 500 张图片时,页面一样会卡住。底层换成 Rust 并不会自动变成“异步”。
这次 Demo 为了把错误边界讲清楚,截图里用同步 hashFile() 更直观;正式工程我会把批量任务放到 Worker / TaskPool 或 Native 工作线程,主线程只接收结果。
但这里又会产生一个新边界:不能从任意 Native 子线程直接操作 ArkTS UI 对象。
更稳定的做法是:
后台线程调用 Rust
↓
生成纯数据结果
↓
安全切回 ArkTS / 主线程
↓
更新页面
如果用 Node-API 异步任务,也要遵守 env、callback、生命周期对应规则,不要把主线程创建的 napi_value 随意保存到 Native 后台线程长期使用。
我现在判断一个三方 Rust 库能不能接,不只看算法跑得快不快,还会先问它是否能被拆成“输入纯数据 → 输出纯数据”。越接近纯函数,跨线程和跨语言都越容易管理。
十一、Native 日志要能够定位到“哪一次跨语言调用”
RustHashLab 给每一批扫描都有:
batchId = RUST-20260930-019
但只靠 batchId 还不够。
真正排 Native 问题时,我会给每次调用再分配一个 callSeq:
batch=RUST-20260930-019
call=13
file=IMG_2026_0912.jpg
ArkTS、C++ 和 Rust 三层都打印同一个序号。
这样一条错误链可以连起来:
ArkTS: call=13 start
C++: call=13 path validated
Rust: call=13 decode failed
C++: call=13 status=RUST_INVALID_IMAGE
ArkTS: call=13 marked failed
这比三层各打一套“开始 / 失败”要实用得多。
正式线上日志当然不应该直接打印用户完整相册路径。我一般只保留脱敏文件 ID、扩展名、尺寸、调用序号和状态码。能定位工程问题就够了,没必要把用户内容写进日志。
十二、我还专门测试了“错误很多但进程不崩”的情况
只放一张坏图还不够。
我又构造了一批测试数据:
正常图 20 张
损坏图 2 张
空文件 1 张
不存在路径 1 条
目标不是看错误提示好不好看,而是确认错误连续发生时,C ABI 层不会泄漏资源,Rust Wrapper 不会残留脏状态,下一张正常图片还能继续得到正确哈希。
这类测试很适合发现全局缓存和静态变量问题。
比如某个三方库第一次 decode 失败以后,把内部 decoder 留在错误状态;下一次正常调用仍然失败。单测只跑一张图时完全看不出来,批量混合测试才会暴露。
所以我最后把 Native 接入验收拆成:
正常输入
可预期错误
连续错误
错误后恢复正常
长批次资源稳定
ABI 版本不匹配
真正的稳定不是“没报错”,而是错误发生以后,后面的合法调用仍然可以继续。
十三、性能优化放在错误边界之后做,顺序不要反
Rust 接入很容易让人一开始就盯性能:
单张哈希 8 ms
还是 5 ms
能不能并发 8 个
我这次反过来做。
先把 C ABI、错误码、资源归属、panic 收口全部稳定,再测性能。
原因很简单:并发会放大所有原本不清楚的边界。
一个全局缓存如果线程不安全,单线程永远没问题;一个错误字符串如果放在静态缓冲区,多线程一跑就会互相覆盖;一个第三方 crate 如果内部依赖线程局部状态,盲目并发可能直接让结果变得不可解释。
RustHashLab 当前 24 张测试只记录一次批次耗时,用来做版本对比,不把它包装成任何固定性能结论。
真正产品里我会测:
单张 P50 / P90
不同尺寸图片耗时
1 / 2 / 4 并发
峰值内存
失败后资源回落
连续 1000 张稳定性
性能数据只对自己的设备、图片集和版本有效。
这也是我这次接 Rust 库以后一个很明确的顺序:
先让错误能回来,再让任务能跑久,最后再让它跑快。
十四、接三方 Rust 库以后,我会固定做这几项检查
第一,先看库有没有 unsafe、全局状态、线程模型和 panic 假设,不要只看 crates.io 上能不能编译。
第二,先设计 C ABI,再写 Node-API。ABI 稳定以后,上层和下层才能各自迭代。
第三,Rust panic 在 Rust 边界里转成状态码,绝不把 panic 当跨语言异常。
第四,Node-API 负责把状态码映射成 ArkTS 异常,但不要假装能捕获段错误。
第五,批量任务要区分“单项失败”和“系统性失败”。一张坏图不应该让全部图片停止,Native 模块无法加载则应该立即终止。
HarmonyOS 的 Node-API 已经给 ArkTS 和 C/C++ 提供了稳定交互机制,而 Rust 三方库通常最适合通过 C ABI 接进来。真正决定这个方案能不能长期维护的,不是“Rust 性能快不快”,而是出了问题以后,错误会停在哪一层。
这次 RustHashLab 最后留下来的结论很简单:
跨语言调用不是把函数调通,而是把错误边界也一起设计出来。
参考资料
- HarmonyOS Node-API 跨语言调用
https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425 - 使用 Node-API 实现 ArkTS/JS 与 C/C++ 交互
https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/use-napi-about-object - ArkTS
https://developer.huawei.com/consumer/en/arkts/

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)