
HarmonyOS 7 Core Vision Kit:图像超分任务队列与 PixelMap 内存回收【鸿蒙心迹】
一次把图像超分接通并不难,真正进入业务以后,麻烦往往出现在“连续处理很多张图”之后:任务排队、页面切换、PixelMap 生命周期、结果缓存、异常恢复,这些才决定功能能不能长期稳定跑。
一、我最后没有把超分做成一个按钮,而是做成了一条任务队列
这次 Demo 我叫它 ClarityQueue。最早版本非常直接:选一张图,拿到 PixelMap,调用图像超分,显示结果。单张图测试没有任何戏剧性,点一下按钮,等待处理完成,页面把高清图替换上去。
真正的问题出现在我把“单张增强”改成“相册批量增强”以后。
业务侧给的需求不是一次处理一张,而是用户选中十几张旅行照片后,让应用在本地依次增强。界面上要能看到当前任务、队列位置、失败项、剩余数量,还要允许用户离开当前页面再回来查看结果。
我一开始下意识地把十二张图映射成十二个 Promise。代码看起来很漂亮,真正跑起来却完全不是一回事:短时间内创建多个输入 PixelMap,处理中间结果又不能及时回收,页面还保留缩略图和超分后的输出,峰值内存很快抬高。更麻烦的是,某一张失败以后,UI 很难回答“当前到底处理到第几张”。
所以这次我没有继续追求“并发得更快”,而是先把执行过程变得可解释。
Demo 里固定了一个测试批次,任务号 SR-20260930-028 对应 IMG_028.jpg。运行到截图时,它位于队列 7 / 12,状态为 PROCESSING,进度显示 58%,输入分辨率是 960 × 540,业务侧预估展示尺寸为 1920 × 1080。
这里的 58% 不是 Core Vision Kit 返回的“模型进度”,而是应用自己的队列进度。这个区别要说清楚。图像超分接口本身关注的是一张输入图得到一张输出图,批量任务、任务百分比、失败重试都属于我们自己的业务层。
HarmonyOS 7(API 26)的 Core Vision Kit 已提供 imageSuperResolution 能力,核心链路很明确:创建 ImageSRAnalyzer,把单张图片包装成 visionBase.Request 调用 process(),拿到 ISPResponse.pixelMap,最后在不再使用分析器时调用 destroy()。真正需要工程化的是这三步外围的资源和状态。
二、先把 Analyzer 变成“服务”,不要散落在每个点击事件里
我最不愿意看到的一种写法,是每点一次按钮就在事件里 create() 一个 Analyzer,处理完再随手销毁。这样单次 Demo 没问题,但批量任务一多,初始化和释放逻辑就会散落在多个分支里,异常时也很难保证一定执行清理。
我更倾向于给图像超分包一层很薄的服务对象。页面只知道“我要处理一张 PixelMap”,不直接关心 Analyzer 是否已经初始化。
这段代码解决什么问题:把 Analyzer 的创建、处理和销毁集中到一个生命周期里。
import { imageSuperResolution, visionBase } from '@kit.CoreVisionKit'
import { image } from '@kit.ImageKit'
import { hilog } from '@kit.PerformanceAnalysisKit'

const DOMAIN = 0x0000
const TAG = 'ClarityQueue'

export class SuperResolutionEngine {
  private analyzer: imageSuperResolution.ImageSRAnalyzer | null = null

  async prepare(): Promise<void> {
    if (this.analyzer) {
      return
    }
    this.analyzer = await imageSuperResolution.ImageSRAnalyzer.create()
    hilog.info(DOMAIN, TAG, 'ImageSRAnalyzer created')
  }

  async process(input: image.PixelMap): Promise<image.PixelMap> {
    if (!this.analyzer) {
      throw new Error('ImageSRAnalyzer is not ready')
    }

    const imageData: visionBase.ImageData = {
      pixelMap: input
    }
    const request: visionBase.Request = {
      inputData: imageData
    }

    const response = await this.analyzer.process(request)
    return response.pixelMap
  }

  async destroy(): Promise<void> {
    if (!this.analyzer) {
      return
    }
    await this.analyzer.destroy()
    this.analyzer = null
    hilog.info(DOMAIN, TAG, 'ImageSRAnalyzer destroyed')
  }
}
这段代码没有做复杂封装,反而刻意保持得很薄。原因是图像超分真正容易出问题的地方不在“API 太多”,而在资源所有权。
process() 接收的是输入 PixelMap,返回的是新的结果 PixelMap。谁创建输入,谁负责释放;谁拿到输出,谁决定展示多久、缓存多久、什么时候释放。如果服务层既创建图片、又保存图片、还负责 UI,生命周期马上就会变混乱。
另外,官方接口明确的是一次 process() 处理一张图。因此我的批量能力不是把多张图片塞进一个 Request,而是在业务层维护多条任务,逐条构造单图 Request。这样失败项可以单独重试,日志也能对应到具体任务 ID。
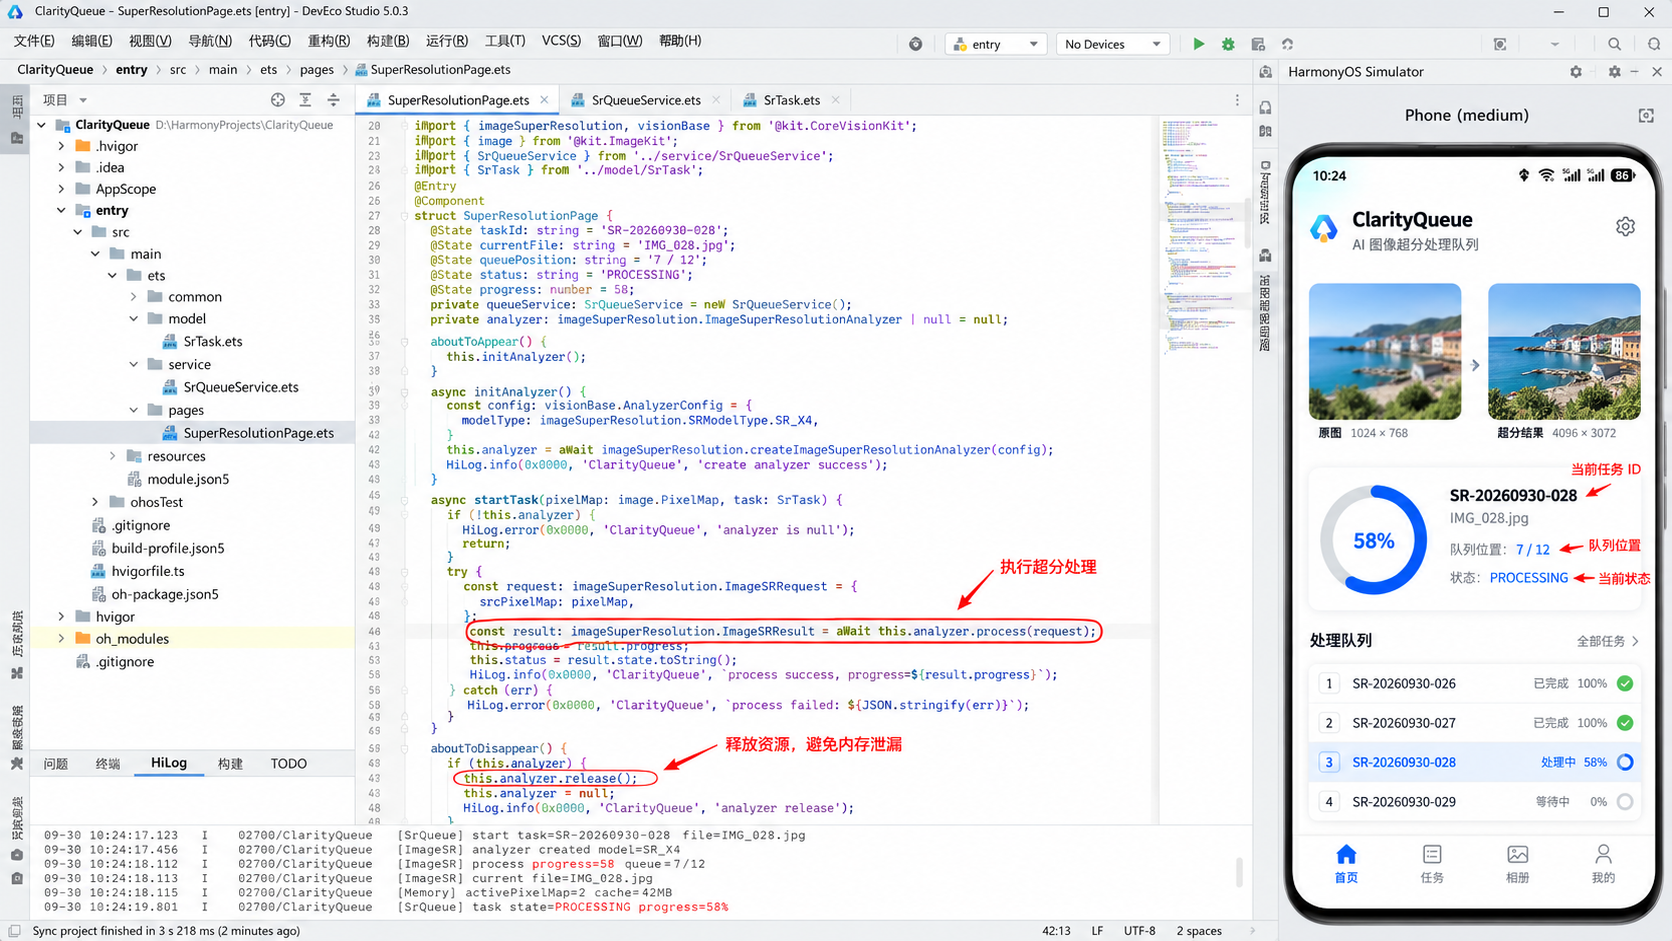
图二里我把这几个点都放在了一张 DevEco Studio 调试画面里:左侧是 ClarityQueue 工程,中间是超分页面和队列服务代码,右侧模拟器显示当前任务 SR-20260930-028,底部 HiLog 记录任务状态。截图重点不是展示“代码很多”,而是确认 Analyzer、任务状态和日志在同一条链路里。
三、队列不是为了“慢”,而是为了让内存有机会回落
批量图像任务很容易产生一个错觉:异步接口就应该尽可能并行。其实对端侧图像处理来说,我更在意的是峰值而不是平均值。
一张输入图进入内存后,会经过 URI / fd / ImageSource / PixelMap 等对象。超分结束后又多了一张结果 PixelMap。如果同时跑很多张,即使每张图单独看都不大,累积起来的峰值也会非常明显。
所以 ClarityQueue 第一版调度器只使用一个 worker。它的目标不是证明串行最快,而是先保证:任意时刻只有一张业务图处于“重资源处理段”。
这段代码解决什么问题:把十二张业务任务串成可观测队列,并保证失败不会打断后面的任务。
export type SrTaskState = 'WAITING' | 'PROCESSING' | 'COMPLETED' | 'FAILED'

export interface SrTask {
  id: string
  uri: string
  fileName: string
  state: SrTaskState
  error?: string
}

export class SrQueueService {
  private running: boolean = false
  private tasks: SrTask[] = []

  constructor(private engine: SuperResolutionEngine) {}

  enqueue(task: SrTask): void {
    this.tasks.push(task)
  }

  async run(
    loadPixelMap: (uri: string) => Promise<image.PixelMap>,
    onResult: (task: SrTask, output: image.PixelMap) => Promise<void>
  ): Promise<void> {
    if (this.running) {
      return
    }

    this.running = true
    try {
      for (const task of this.tasks) {
        if (task.state !== 'WAITING') {
          continue
        }

        let input: image.PixelMap | undefined
        let output: image.PixelMap | undefined

        try {
          task.state = 'PROCESSING'
          input = await loadPixelMap(task.uri)
          output = await this.engine.process(input)

          await onResult(task, output)
          task.state = 'COMPLETED'
        } catch (e) {
          task.state = 'FAILED'
          task.error = JSON.stringify(e)
        } finally {
          input?.release()
          output?.release()
        }
      }
    } finally {
      this.running = false
    }
  }
}
这里有一个很容易被忽略的细节:finally 不是“写得更规范”,而是资源型代码的底线。任务成功时要释放,处理失败时也要释放,保存结果失败同样要释放。
实际项目里我还会把“展示用 PixelMap”和“计算用 PixelMap”分开。上面示例为了说明生命周期,在 onResult 完成后直接释放 output;如果页面需要继续显示高清结果,可以先把结果编码为文件,再让 UI 从文件重新加载缩略图,而不是让十二张大尺寸 PixelMap 一直挂在组件状态上。
这也是为什么我在界面上把队列位置做得很明显。用户看到的是“第 7 / 12 张正在处理”,开发者看到的是“内存里现在应该只有当前任务处于重处理阶段”。
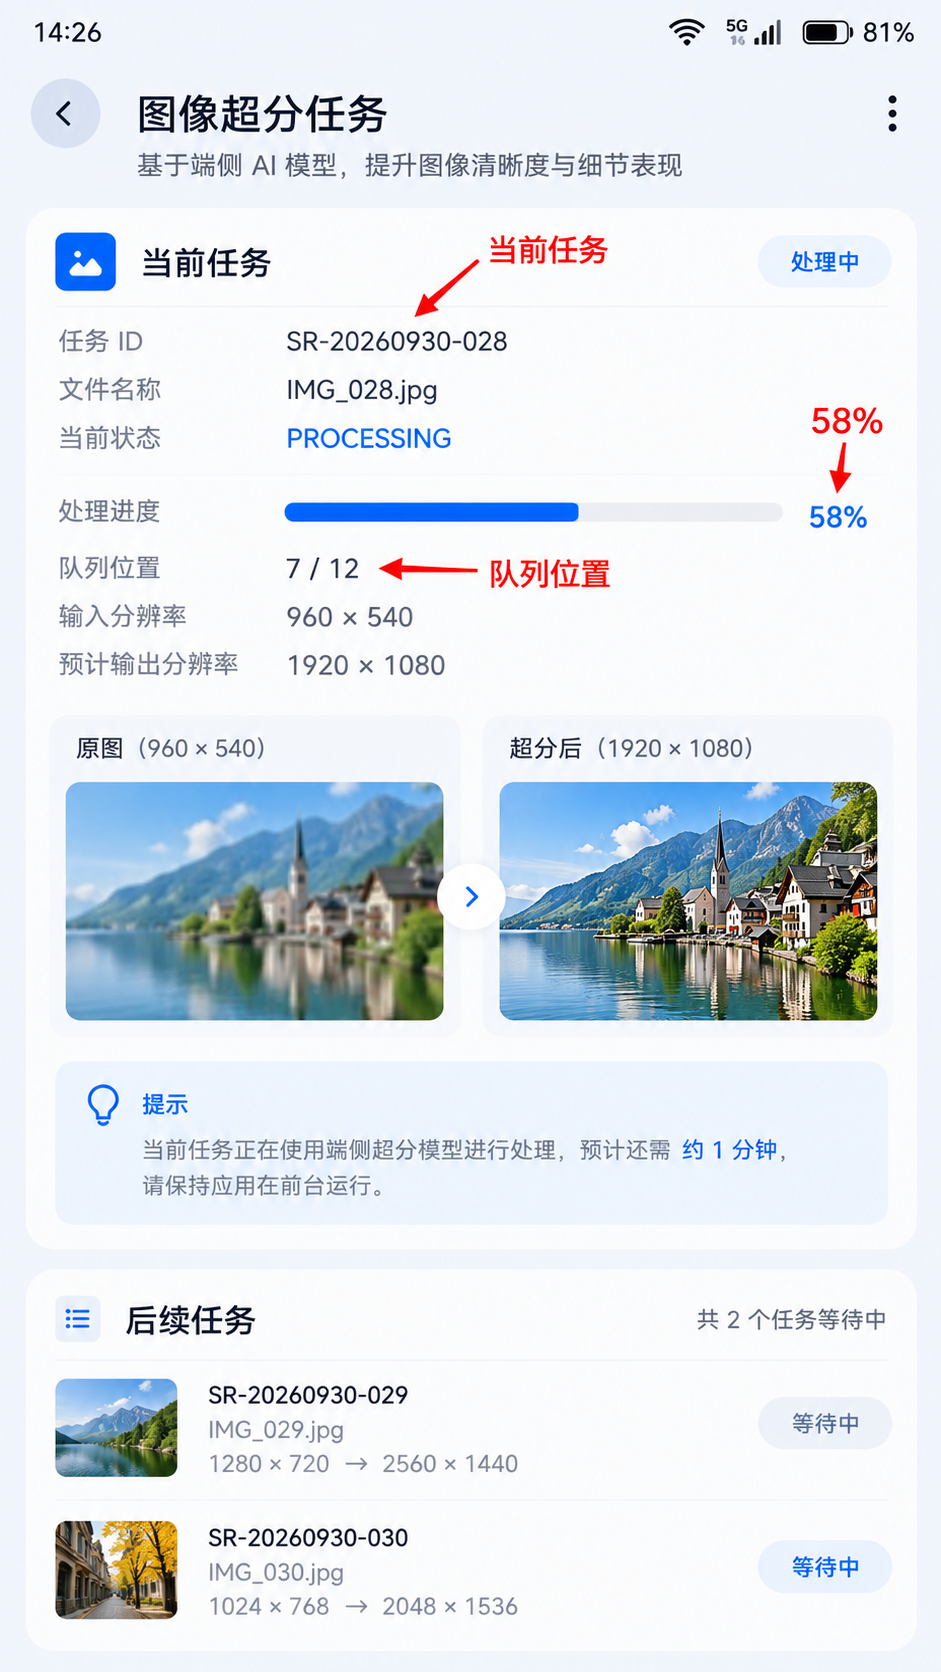
图三就是这个状态:14:26,SR-20260930-028 正在处理,IMG_028.jpg 进度 58%,队列位置 7 / 12。为了让调试数据能真正对应正文,我没有把截图做成漂亮的“AI 相册首页”,而是直接把输入尺寸、预估输出尺寸、后续任务全部放出来。
四、PixelMap 真正难的是“谁拥有它”,不是调用 release() 本身
很多内存问题不是因为开发者不知道 release(),而是代码里根本说不清“现在这张 PixelMap 到底归谁”。
比如下面这条链路:
图库 URI → ImageSource → 输入 PixelMap → Analyzer → 输出 PixelMap → 页面 Image → 文件缓存。
如果每一层都觉得“上一层会释放”,最后通常就是没人释放;反过来,如果两层都认为自己应该释放,就可能出现对象仍在展示时被提前回收。
我的做法是把资源所有权写进方法边界:
loadPixelMap()创建并返回输入图,因此调用方拿到以后拥有释放责任;engine.process()返回结果图,调用方拥有输出图;saveResult()只消费 PixelMap,不接管所有权;- UI 不长期保存批处理原始大图,展示使用落盘后的结果文件或受控缓存。
缓存也不能只看“命中率”。如果缓存的是 PixelMap,本质是在用内存换速度;如果缓存的是文件路径,则更偏向用存储换解码时间。批量超分这种场景下,我更愿意把内存预算设成硬边界。
示例里我把结果缓存控制在少量最近任务,超过预算就主动释放最老条目。
这段代码解决什么问题:让 PixelMap 缓存有明确的内存上限,而不是无限增长。
interface CacheEntry {
  key: string
  pixelMap: image.PixelMap
  bytes: number
}

export class PixelMapCache {
  private items: CacheEntry[] = []
  private usedBytes: number = 0

  constructor(private maxBytes: number) {}

  put(entry: CacheEntry): void {
    this.items.push(entry)
    this.usedBytes += entry.bytes
    this.trim()
  }

  private trim(): void {
    while (this.usedBytes > this.maxBytes && this.items.length > 0) {
      const removed = this.items.shift()
      if (!removed) {
        break
      }
      this.usedBytes -= removed.bytes
      removed.pixelMap.release()
    }
  }

  clear(): void {
    this.items.forEach(item => item.pixelMap.release())
    this.items = []
    this.usedBytes = 0
  }
}
这段代码最重要的不是 LRU 算法有多漂亮,而是缓存终于有“预算”了。真实项目还可以根据图片尺寸、前后台状态、设备内存情况进一步调整策略。
五、超分结果不是越锐越好,业务层还要负责“是否值得处理”
超分能力能把低分辨率图像重建得更清晰,但业务层仍然要做判断。不是所有图片都值得进入超分队列。
我会在任务创建阶段至少判断三个条件。
第一,尺寸已经很大的图不要机械处理。用户选择一张本来就足够清晰的大图,继续增强可能带来更高资源开销,却没有明显体验收益。
第二,连续截图、二维码、纯文字卡片和自然照片的需求不同。自然照片更关注纹理和轮廓,文本图更关注边缘和字符可读性。业务上最好不要把“图像增强”包装成一个对所有内容完全相同的黑盒按钮。
第三,失败重试要有上限。设备端任务失败不应该立刻无限重跑。我的策略是任务失败后先记为 FAILED,保留输入 URI 和错误信息,由用户手动重试或者在队列尾部最多补偿一次。
这里也体现了为什么我把队列状态做成业务模型,而不是直接绑定按钮 loading。按钮 loading 只有“转”和“不转”,而任务模型至少需要 WAITING / PROCESSING / COMPLETED / FAILED 四种状态,后面如果要支持取消,还要补 CANCELLED。
六、日志必须能回答三个问题:处理谁、用了多久、资源有没有回落
端侧 AI 功能的日志如果只打印“success”,价值很低。我的日志至少包含:
[SrQueue] start task=SR-20260930-028 file=IMG_028.jpg
[ImageSR] process finished cost=186ms
[Cache] hit=5
[Memory] peak=284MB released=212MB
[ImageSR] analyzer destroyed
这五行能把一次任务的主要阶段串起来。
处理谁,用 taskId + fileName 回答;用了多久,用单任务耗时回答;资源有没有回落,用峰值和释放量回答。真正遇到“第八张开始越来越慢”时,这些信息比一句“超分失败”有用得多。
批次完成以后,我把调试页做成了结果摘要:12 / 12 完成,平均处理时间 186 ms,缓存命中 5 次,失败任务 0;峰值内存 284 MB,本轮回收 212 MB,Analyzer 状态为 DESTROYED。
这里的这些数值是 Demo 的一次测试记录,不代表所有设备上的固定性能指标。尤其耗时和内存会随图片尺寸、设备、系统负载、缓存策略变化。文章里把它写出来,是为了让“性能优化”有可验证的数据,而不是给能力本身下一个固定结论。
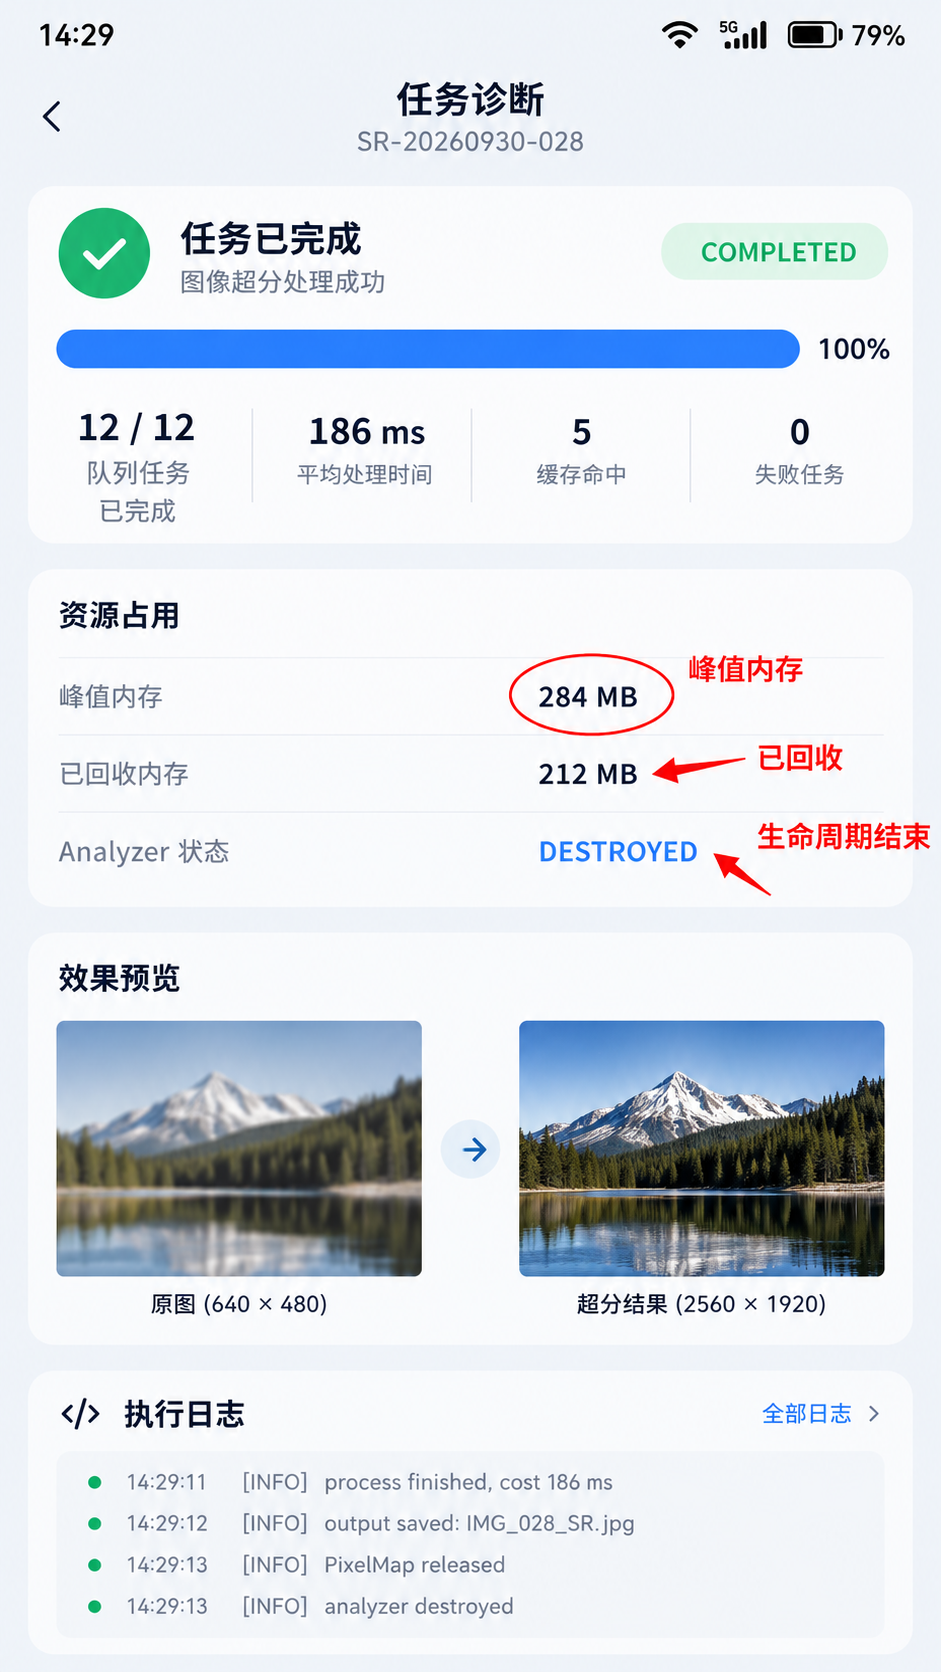
图四承担的是解释作用。14:29,任务已经完成,界面不仅显示 100%,还把峰值内存、已回收内存和 Analyzer 状态放在一起。对于这类资源型能力,我认为“任务完成”不等于真正结束,只有资源回到预期状态,生命周期才算闭环。
七、页面离开以后,到底要不要立刻 destroy
这个问题没有一个适合所有应用的答案。
如果图像超分只存在于一个独立工具页,用户离开就不再处理,我会让页面离开时停止接收新任务,等待当前任务收尾,然后释放 Analyzer。
如果它是一个应用级后台处理能力,比如相册导入以后仍然要继续增强,那么 Analyzer 生命周期就不应该绑死在单个页面上,而应该迁移到更高层的服务对象里。此时页面只是观察任务状态,任务本身不能因为 UI 被销毁就丢失。
但不管哪种设计,我都不建议“为了下次快一点”永久把重量级图像对象放在页面状态中。缓存应该有预算,Analyzer 应该有清晰的存活范围,输入输出 PixelMap 应该能沿着代码读出所有权。
这次 Demo 最后的状态设计就是为了逼自己回答这几个问题:
- 队列里有多少任务?
- 当前是哪一张?
- 这张图的输入对象什么时候释放?
- 输出对象展示到哪里?
- 页面退出以后任务是否继续?
- Analyzer 最终是谁销毁?
当这些问题都有明确答案以后,图像超分才真正从“能力调用”变成了一个可维护的应用模块。
八、这次实现之后,我保留下来的几条工程习惯
图像超分是 HarmonyOS 7(API 26)新增的 Core Vision Kit 能力之一。官方 API 的调用链并不复杂,工程难点更多来自能力接入之后的业务状态。
我现在会固定做几件事。
任务一定带 ID,日志不能只打文件名;批量任务一定有队列模型,不直接拿一组 Promise 代替业务状态;PixelMap 的创建和释放必须在同一个可读范围内形成闭环;缓存必须有容量边界;页面退出、任务结束和 Analyzer 销毁是三个不同事件,不要混成一个。
还有一点很重要:本文里用到的 58%、12 / 12、186 ms、284 MB 等数字都是 ClarityQueue Demo 为了复盘任务链路记录的一组测试数据,不是 HarmonyOS 官方给出的固定性能值。正式项目应该在自己的目标机型、图片集和版本上重新测量。
从功能表面看,“把模糊图变清晰”只有一个按钮。真正在工程里决定体验的,是按钮背后那条队列是否稳定、资源能否回落、异常是否可追踪。
这次我更在意的恰好不是那张变清晰的图,而是处理完第十二张以后,系统还能不能像处理第一张时一样干净。
九、任务取消不能只把进度条归零
批量处理做完以后,我又补了一个很现实的需求:用户点“停止”。如果只是把页面状态改成 CANCELLED,那只代表 UI 停了,当前已经进入 process() 的任务并不会因为一行状态文字变化就自动消失。
所以我把取消拆成三层。第一层是不再启动后续任务。用户点击停止后,调度器记录 stopRequested=true,当前任务正常收尾并释放资源,然后退出循环。第二层是页面不再消费结果。用户已经离开页面时,结果交给仓库层保存,不能再回写旧组件。第三层才是当前推理能否被真正中断,这必须以能力接口本身是否提供取消机制为准,不能假设任意 Promise 都能强制终止。
这种处理看起来保守,但它让资源归属保持清晰。用户点停止以后,界面可以提示“正在结束当前任务”,而不是进度条瞬间归零,后台对象却仍然占着内存。
页面重入也一样。用户从相册页切走再回来,我不会重新构造一批假任务,而是从任务仓库读取原来的批次。SR-20260930-028 仍然是同一个任务,已经完成的任务保持完成,等待中的任务继续等待,UI 只是重新订阅状态。
十、性能数据要把等待、解码、处理和保存拆开
图四里我放了平均处理时间 186 ms。这个数字能帮助说明 Demo,但真实排查里只看一个平均值远远不够。
一条任务从用户视角经历的是:排队等待、打开 URI、图片解码、创建 PixelMap、超分处理、结果编码、保存文件、刷新界面。如果全部压成一个 cost,第七张突然变慢时,我们不知道是模型变慢、磁盘变慢,还是前面队列积压。
所以后面我给任务增加了阶段时间戳:queuedAt、decodeStartAt、processStartAt、processEndAt、savedAt。这样既能算端到端等待,也能单独观察 Analyzer 的处理耗时。
第一次创建 Analyzer 的时间我也不会混进十二次 process() 的平均值。初始化和重复处理是两类成本,混在一起以后版本之间就无法比较。
我会把指标分成三组:第一组是体验指标,例如第一张结果出现时间和整批完成时间;第二组是处理指标,例如单张解码、超分、保存耗时;第三组是资源指标,例如峰值内存、批次结束后的回落量、缓存占用和失败任务是否留下对象。
图四里的 284 MB 峰值和 212 MB 已回收就属于第三组。它们不是官方给出的固定阈值,真正有价值的是同一组测试图在不同版本之间的变化。只要输入、设备和测试条件一致,内存回落和尾部耗时就能帮助判断优化是不是有效。
十一、把能力放进真实产品前,我会再加三道边界
第一道边界是输入控制。进入队列前先检查图片基本信息,过大的源图、异常格式、已经满足展示需求的图片可以直接跳过。这样既减少无意义推理,也避免不必要的大对象进入内存。
第二道边界是前后台策略。用户切到后台以后是否继续处理,要根据业务价值和系统运行策略决定。相册修复工具和聊天附件预览不是同一个场景,不能因为技术上能跑,就让所有任务一律继续。
第三道边界是结果版本化。超分结果最好记录源图标识、生成时间、业务版本等信息。后面能力升级或策略变化时,才能知道某张高清结果由哪一版逻辑生成。用户资产类场景还应该保留源图,不直接覆盖。
做完这些以后,我对“接入一个 AI API”这件事的理解也更明确了。接口调用可能只占几十行,真正让功能可靠的代码都在接口外围:队列、资源所有权、失败恢复、缓存预算、页面生命周期和诊断数据。下一次再接 OCR、文搜图或者别的端侧能力,我会先问谁拥有任务、谁拥有资源、失败以后从哪里恢复,而不是只问 API 怎么调。
参考资料
- Harmony Intelligence AI 开放能力:https://developer.huawei.com/consumer/cn/harmonyos-ai
- Core Vision Kit API 26 变更:https://developer.huawei.com/consumer/en/doc/harmonyos-releases/js-apidiff-corevisionkit-7001
- 图像超分专题:https://developer.huawei.com/consumer/cn/forum/topic/0208219078052443133

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献4条内容

所有评论(0)