
HarmonyOS 7 精准碰一碰 SlideDrop 实战 04:投递状态 + 冲突恢复解决连续碰一碰异常场景【鸿蒙心迹】
前三篇我一直在做一件事:先把 SlideDrop 的主链路搭起来,再把触碰坐标、槽位映射、素材类型和插入规则一点点补完整。到第四篇,我关注的重点明显变了。现在我更关心的,不再是“能不能把素材投进去”,而是“连续碰一碰会不会乱、目标位置已有内容时怎么收、用户取消或超时以后页面怎么反馈、失败后到底有没有恢复能力”。
如果前三篇解决的是“精准落位”,那第四篇解决的就是“异常情况下还能不能稳住”。这也是 Demo 从“看起来能跑”走向“有工程味道”的分水岭。
一、第四篇为什么一定要讲状态、冲突和恢复
我做这套 SlideDrop 五连载时,一开始心里其实有个担心:如果一直沿着“投进去就算成功”的思路写,前两篇、第三篇还会有新鲜感,到了第四篇很容易开始飘。读者会看到很多效果图,但会逐渐怀疑一件事:这东西是不是只适合做演示,不适合认真讨论工程实现。
而真正决定一个跨设备协作 Demo 成色的,往往不是那一瞬间的“成功动效”,而是下面这些更难受的问题:
- 用户点了发送以后,系统当前到底处于哪个阶段;
- 目标设备已经识别了,但用户迟迟没有碰一下,会不会一直挂着;
- 对方页面的目标槽位已经有内容了,系统怎么决定是替换、取消还是稍后重试;
- 连续两次甚至三次碰一碰时,前一个会话没结束,后一个任务是不是会把状态冲掉;
- 当用户离开页面、切到后台、或者目标端一度失联时,当前任务能不能留下可诊断的痕迹。
这些问题有个共同点:它们都不是“主链路 happy path”的问题,但它们决定了读者会不会把这套 Demo 当成一个真正能继续往下迭代的工程项目。
所以第四篇我给自己定下来的目标很明确:
- 用一套清晰的状态定义,把投递过程说清楚;
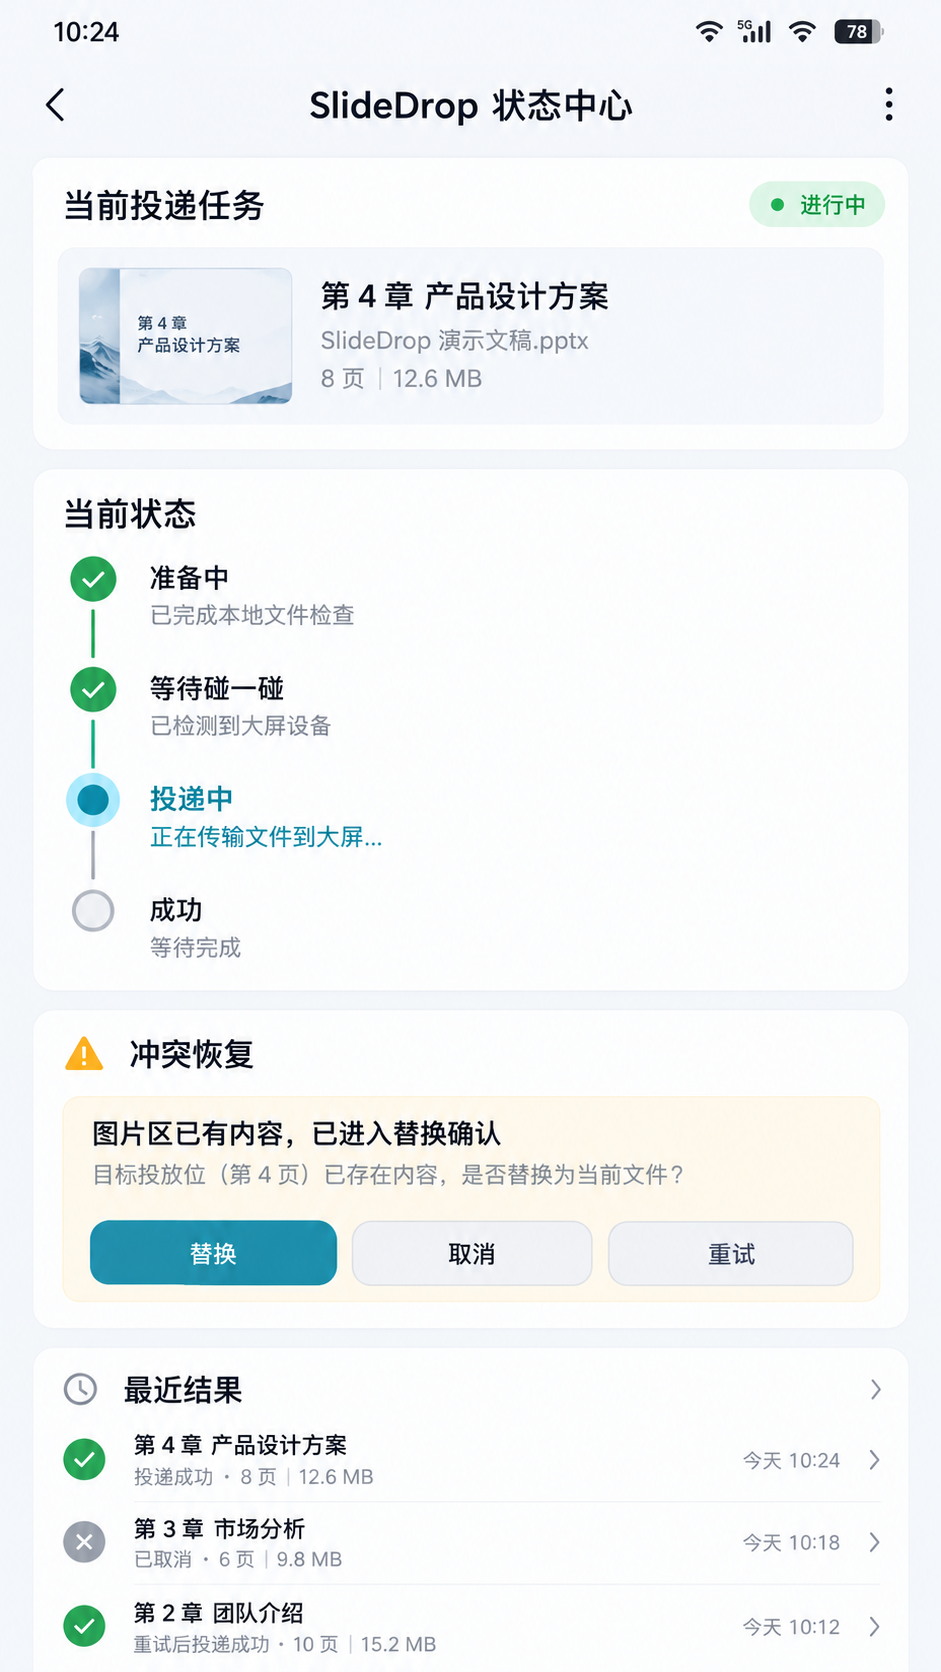
- 用状态中心页面,把这些状态对用户讲清楚;
- 用冲突恢复模块,把“目标位置已有内容”这类边界情况收起来;
- 用重试队列,让失败不只是“结束”,而是“还有下一步”;
- 让代码、日志、页面和配图,说的是同一件事。
二、第四篇我真正要补的是“一条完整的状态链”
如果把前三篇看成“建主桥”,那第四篇更像是在给桥两边加护栏、加路标、加应急车道。它不一定最炫,但它会让这套 Demo 突然稳很多。
我最后把第四篇的主线收成一句话:
不是加一个新页面,而是补齐一条完整的状态链。
这条链条至少要覆盖这些阶段:
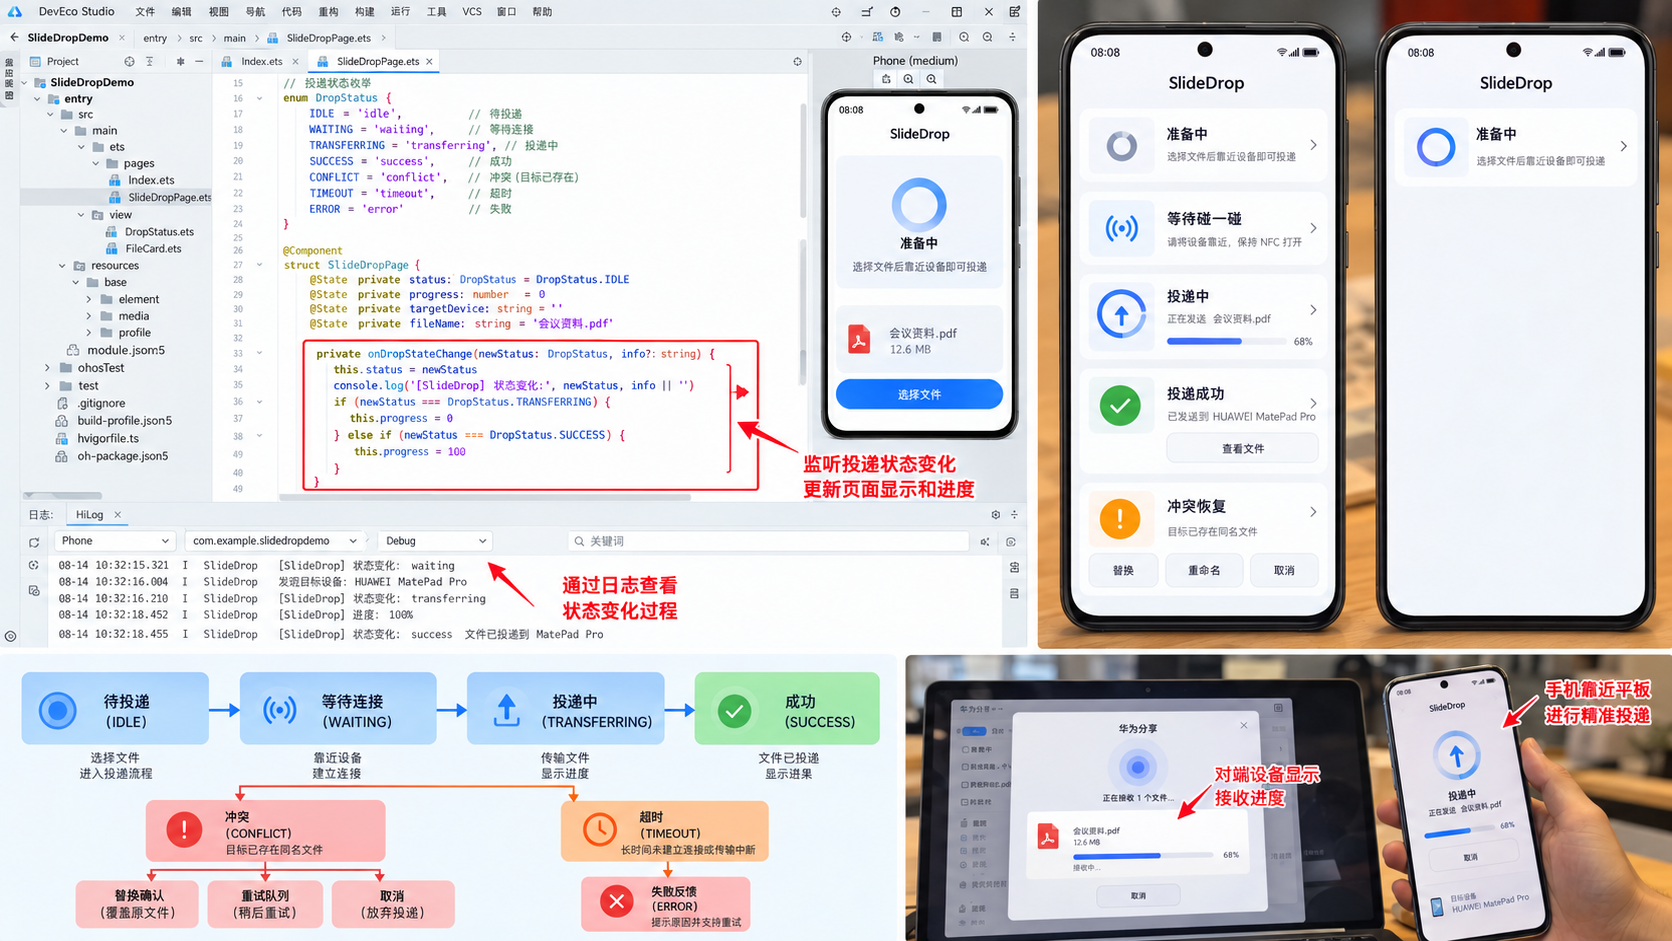
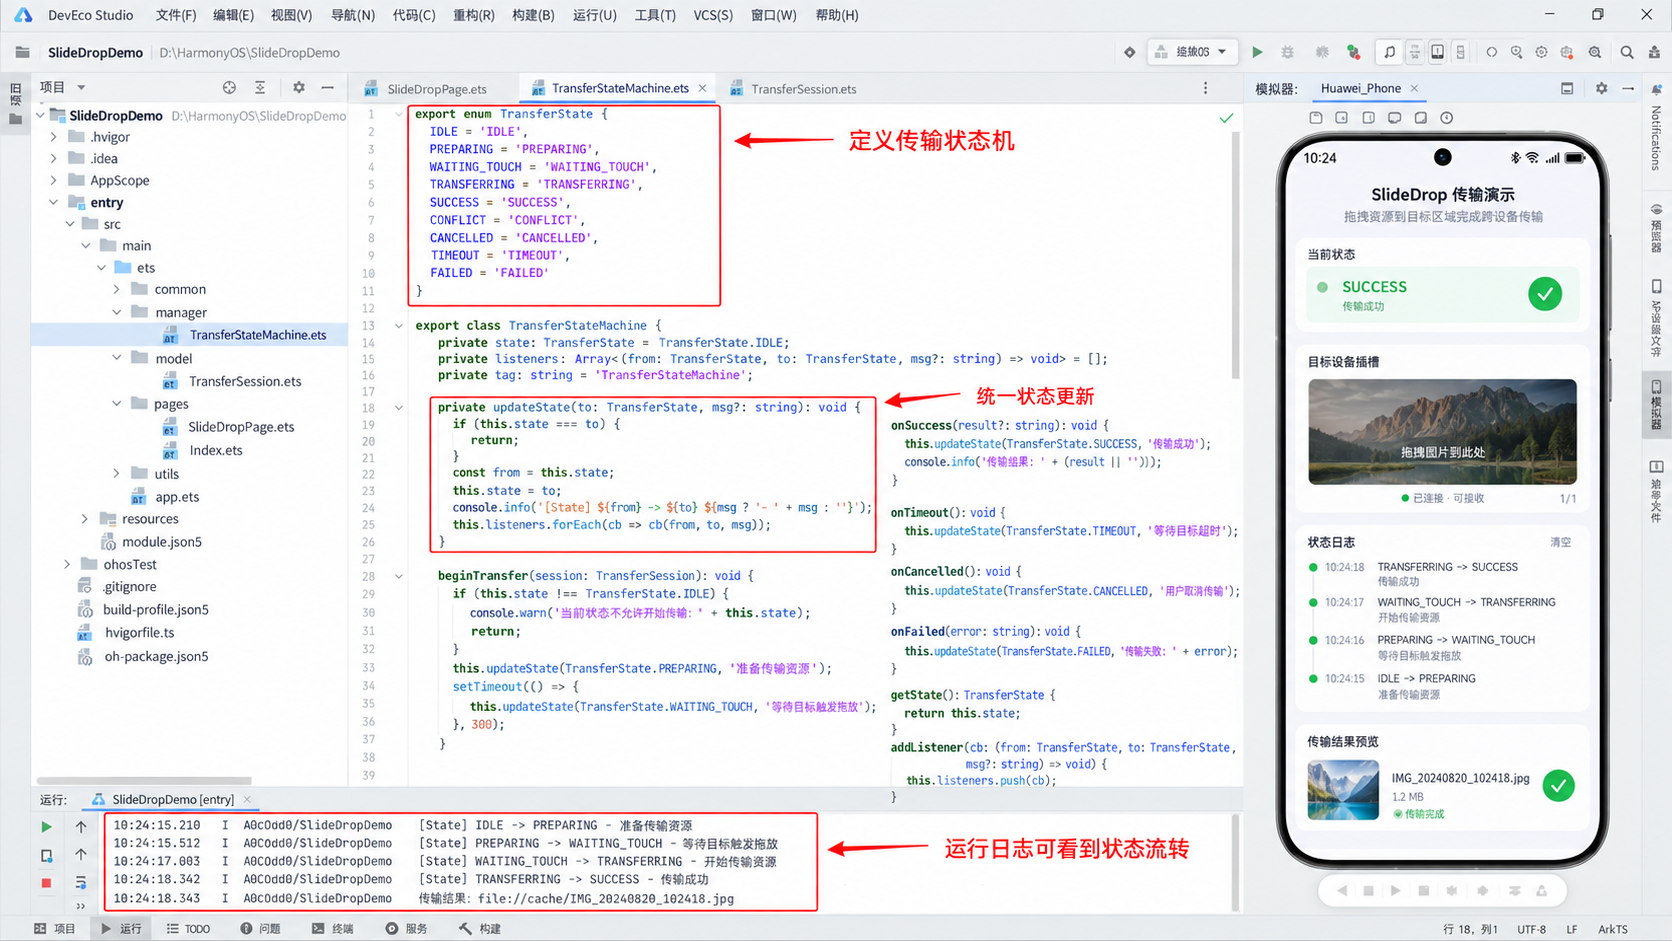
IDLE:空闲,尚未发起投递;PREPARING:准备中,校验文件、创建会话、装配上下文;WAITING_TOUCH:等待碰一碰,说明目标设备已就绪,但还未真正开始传输;TRANSFERRING:投递中,正在发送文件或等待目标落位;SUCCESS:成功,目标端已经完成接收与放置;CONFLICT:冲突,目标槽位已有内容、存在同名资源或当前会话被阻塞;CANCELLED:取消,用户主动终止;TIMEOUT:超时,等待碰一碰或传输过程超过设定时限;FAILED:失败,最终没有恢复成功。
这些状态看起来不少,但它们并不是“为了专业而专业”。相反,它们是为了避免后面每一层代码都在各自发明一套状态词。页面说“准备中”,日志写“ready”,会话管理器又写“pending”,读者一看就会乱。工程真正麻烦的地方,从来不是你状态少,而是你状态词不统一。
所以第四篇一上来,我没有先做 UI,也没有先画流程图,而是先把状态语言统一下来。后面的状态中心、冲突恢复、重试队列、日志打印,全都围绕这个前提往下走。
三、目录结构必须再往前走一步,不然后面一定写乱
第四篇之前,SlideDrop 的项目结构已经开始成形,但还偏 Demo。也就是说,它可以说明问题,但还不够适合接纳越来越多的异常逻辑。尤其是当我要开始处理冲突恢复、会话取消、重试队列时,如果还继续把逻辑堆在页面层,后面几乎一定会难以维护。
所以这篇我先整理了一次目录:
SlideDropDemo
├─ entry
│  ├─ src/main/ets
│  │  ├─ pages
│  │  │  ├─ Index.ets
│  │  │  ├─ SlideDropPage.ets
│  │  │  └─ StatusCenterPage.ets
│  │  ├─ components
│  │  │  ├─ ReplaceDialog.ets
│  │  │  ├─ TransferProgressCard.ets
│  │  │  ├─ RecentResultCard.ets
│  │  │  └─ StateStepList.ets
│  │  ├─ manager
│  │  │  ├─ TransferStateMachine.ets
│  │  │  ├─ ConflictRecoveryManager.ets
│  │  │  ├─ RetryQueue.ets
│  │  │  └─ TransferSessionManager.ets
│  │  ├─ model
│  │  │  ├─ TransferMission.ets
│  │  │  ├─ TransferState.ets
│  │  │  ├─ SlotType.ets
│  │  │  └─ RecentResult.ets
│  │  ├─ store
│  │  │  └─ TransferStore.ets
│  │  ├─ common
│  │  │  ├─ Logger.ets
│  │  │  └─ TimeFormatter.ets
│  │  └─ utils
│  │     ├─ FileValidator.ets
│  │     └─ DelayTask.ets
│  └─ resources
└─ module.json5
我为什么特别愿意在文章里把目录写出来?因为它其实代表了我对第四篇边界的判断:
TransferStateMachine只管状态流转;ConflictRecoveryManager只管冲突分支怎么走;RetryQueue只管待重试任务;TransferStore只管给页面喂数据;- 页面层只负责表达,不去吞掉所有业务逻辑。
到这里,SlideDrop 就不再只是“一个页面把所有事做完”的 Demo 了,而开始像一个能讲工程结构的项目。
四、先把状态机立住:因为 UI、日志、恢复逻辑都要依附在它上面
很多人写 Demo 喜欢先做页面,这很正常,因为页面有即时反馈。但我自己写第四篇的时候非常明确:状态机必须先出来。
原因很简单。没有状态机的时候,页面层和日志层往往会各自长出一套规则:
- 页面可能用
isLoading、hasConflict、progress来判断; - 日志可能打印
start、retry、done; - 会话管理器又可能内部有一套
pending / active / closed。
这些词一多,很快就会出现“代码能跑,但解释不清”的情况。文章一旦要讲清楚过程,就会非常吃力。
所以第四篇我直接用 enum + 状态机 的方式,把语言收紧。
文件位置: entry/src/main/ets/manager/TransferStateMachine.ets
用途: 统一管理投递状态流转,驱动 UI 更新、日志输出和异常入口。
export enum TransferState {
  IDLE = 'IDLE',
  PREPARING = 'PREPARING',
  WAITING_TOUCH = 'WAITING_TOUCH',
  TRANSFERRING = 'TRANSFERRING',
  SUCCESS = 'SUCCESS',
  CONFLICT = 'CONFLICT',
  CANCELLED = 'CANCELLED',
  TIMEOUT = 'TIMEOUT',
  FAILED = 'FAILED'
}

export class TransferStateMachine {
  private state: TransferState = TransferState.IDLE
  private listeners: Array<(from: TransferState, to: TransferState, msg?: string) => void> = []
  private timeoutTask: number | null = null
  private sessionId: string = ''

  beginTransfer(sessionId: string, fileName: string, slot: string): void {
    this.sessionId = sessionId
    this.updateState(TransferState.PREPARING, `file=${fileName}, slot=${slot}`)
    setTimeout(() => {
      this.updateState(TransferState.WAITING_TOUCH, '等待目标设备靠近')
      this.startTimeoutTimer()
    }, 280)
  }

  onTouchConfirmed(deviceName: string): void {
    this.updateState(TransferState.TRANSFERRING, `target=${deviceName}`)
  }

  onConflict(slot: string): void {
    this.clearTimeoutTimer()
    this.updateState(TransferState.CONFLICT, `slot=${slot}`)
  }

  onSuccess(resultPath: string): void {
    this.clearTimeoutTimer()
    this.updateState(TransferState.SUCCESS, `result=${resultPath}`)
  }

  onCancelled(reason: string): void {
    this.clearTimeoutTimer()
    this.updateState(TransferState.CANCELLED, reason)
  }

  onTimeout(): void {
    this.updateState(TransferState.TIMEOUT, 'touch-or-transfer-timeout')
  }

  onFailed(message: string): void {
    this.clearTimeoutTimer()
    this.updateState(TransferState.FAILED, message)
  }

  subscribe(listener: (from: TransferState, to: TransferState, msg?: string) => void) {
    this.listeners.push(listener)
  }

  private updateState(to: TransferState, msg?: string): void {
    const from = this.state
    this.state = to
    Logger.info(`[State] ${from} -> ${to}${msg ? ' | ' + msg : ''}`)
    this.listeners.forEach(listener => listener(from, to, msg))
  }

  private startTimeoutTimer() {
    this.timeoutTask = setTimeout(() => this.onTimeout(), 12000) as unknown as number
  }

  private clearTimeoutTimer() {
    if (this.timeoutTask) {
      clearTimeout(this.timeoutTask)
      this.timeoutTask = null
    }
  }
}
这段代码真正解决的问题,不只是“状态能跑起来”,而是它给整个项目建立了一条骨架:
- 页面知道自己应该展示什么;
- 日志知道自己应该怎么记录;
- 冲突恢复知道自己从哪个状态进入;
- 重试队列知道自己应该把任务送回哪个阶段。
第四篇的很多东西,看起来像在写页面,实际上底层全是靠这个状态机在撑着。
五、页面层要变轻:第四篇新增状态中心,但它只负责“表达”
状态机出来以后,页面层就该瘦身了。不然你很容易陷入一种老问题:为了做一个状态页,又在页面里堆回一堆业务判断。
所以我这篇的原则很简单:页面只负责表达,不直接包办业务。
状态中心页主要做四件事:
- 展示当前投递任务;
- 展示当前状态步骤;
- 在发生冲突时给出替换 / 取消 / 重试入口;
- 展示最近一次或最近几次结果。
这些信息都不应该在页面层临时拼出来,而是来自 TransferStore 和状态机订阅结果。
文件位置: entry/src/main/ets/pages/StatusCenterPage.ets
用途: 监听状态变更,把投递状态、冲突恢复和最近结果展示给用户。
@Entry
@Component
struct StatusCenterPage {
  @State private currentState: TransferState = TransferState.IDLE
  @State private progressValue: number = 0
  @State private taskTitle: string = '第 4 章 产品设计方案'
  @State private fileName: string = 'SlideDrop 演示文稿.pptx'
  private store: TransferStore = AppStorage.get<TransferStore>('transferStore')!
  private machine: TransferStateMachine = AppStorage.get<TransferStateMachine>('stateMachine')!

  aboutToAppear() {
    this.machine.subscribe((from, to, msg) => {
      this.currentState = to
      this.store.appendStateLog({ from, to, msg, time: Date.now() })

      if (to === TransferState.PREPARING) {
        this.progressValue = 12
      } else if (to === TransferState.WAITING_TOUCH) {
        this.progressValue = 24
      } else if (to === TransferState.TRANSFERRING) {
        this.progressValue = 68
      } else if (to === TransferState.SUCCESS) {
        this.progressValue = 100
        this.store.pushRecentResult({
          title: this.taskTitle,
          state: 'success',
          fileName: this.fileName,
          timeText: '今天 10:24',
          extraText: '耗时 12.3 秒'
        })
      } else if (to === TransferState.CANCELLED) {
        this.store.pushRecentResult({
          title: '第 3 章 市场分析',
          state: 'cancelled',
          fileName: '分析补充稿.pptx',
          timeText: '今天 10:18',
          extraText: '用户已取消'
        })
      }
    })
  }
}
这个结构看着不复杂,但我觉得它很重要,因为从这一刻开始,页面终于不再是“什么都能做,什么都写一点”的状态,而是明确变成了“拿结果去表达”。
六、真正难的不是弹一个替换框,而是把冲突之后的每一步收清楚
到第四篇,最像真实工程的一层,我觉得不是状态机,而是冲突恢复。
因为“目标位置已经有内容”这件事,表面上只是一个弹窗,实际上它后面会连出很多分支:
- 用户确认替换,系统是不是要先备份旧内容;
- 用户取消,当前会话是不是立刻结束;
- 用户暂时不处理,这个任务能不能进入重试队列;
- 设备恢复以后,之前的任务要不要自动恢复;
- 同一个槽位连续收到两个新任务时,后来的任务是不是需要排队。
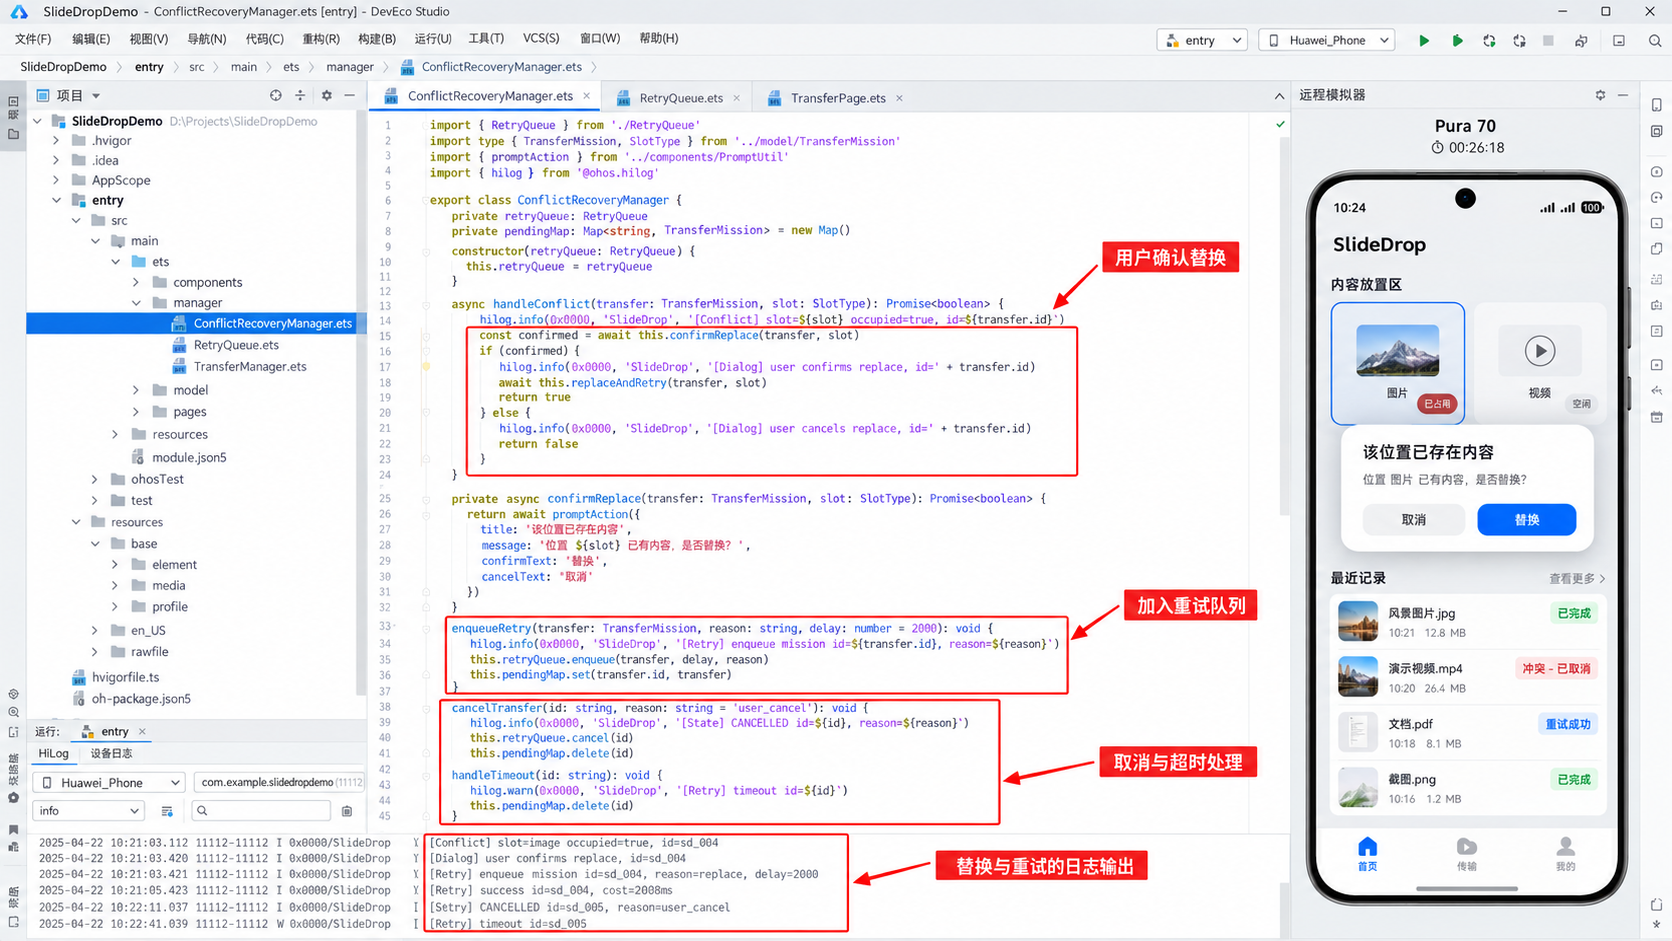
如果这些逻辑全写在页面里,那页面一定会变得很重,而且代码会越来越难读。所以我把它们统一收进 ConflictRecoveryManager。
文件位置: entry/src/main/ets/manager/ConflictRecoveryManager.ets
用途: 处理冲突时的替换确认、取消结束、加入重试队列和超时恢复。
export class ConflictRecoveryManager {
  constructor(private retryQueue: RetryQueue) {}

  async handleConflict(transfer: TransferMission, slot: SlotType): Promise<boolean> {
    Logger.info(`[Conflict] slot=${slot} occupied=true, id=${transfer.id}`)

    const confirmed = await this.confirmReplace(transfer, slot)
    if (confirmed) {
      Logger.info(`[Dialog] user confirms replace, id=${transfer.id}`)
      await this.backupOldResource(slot)
      await this.replaceCurrentContent(transfer, slot)
      this.enqueueRetry(transfer, 'replace-confirmed', 600)
      return true
    }

    Logger.info(`[Dialog] user cancels replace, id=${transfer.id}`)
    this.cancelTransfer(transfer.id, 'user_cancel')
    return false
  }

  enqueueRetry(transfer: TransferMission, reason: string, delay: number = 2000): void {
    Logger.info(`[Retry] enqueue mission id=${transfer.id}, reason=${reason}`)
    this.retryQueue.enqueue(transfer, delay, reason)
  }

  cancelTransfer(id: string, reason: string): void {
    Logger.info(`[State] CANCELLED id=${id}, reason=${reason}`)
    this.retryQueue.cancel(id)
  }

  handleTimeout(id: string): void {
    Logger.warn(`[Retry] timeout id=${id}`)
    this.retryQueue.remove(id)
  }

  private async confirmReplace(transfer: TransferMission, slot: SlotType): Promise<boolean> {
    return await promptAction.showDialog({
      title: '该位置已存在内容',
      message: `位置 ${slot} 已有内容,是否替换为 ${transfer.fileName}?`,
      confirmText: '替换',
      cancelText: '取消'
    })
  }

  private async backupOldResource(slot: SlotType): Promise<void> {
    Logger.info(`[Backup] backup old resource in slot=${slot}`)
  }

  private async replaceCurrentContent(transfer: TransferMission, slot: SlotType): Promise<void> {
    Logger.info(`[Replace] apply new resource ${transfer.fileName} -> slot=${slot}`)
  }
}
这段代码写完以后,我最大的感受不是“冲突问题解决了”,而是:冲突终于从一个 UI 提示,变成了一个完整过程。
它有前因、有分支、有结论,最重要的是——它可追踪。你在日志里能看到它,在页面上能看到它,在配图里也能展示它。这种“可追踪感”,我觉得就是第四篇最值钱的地方。
七、重试队列不是炫技,而是让失败拥有第二次机会
我见过很多 Demo,一遇到失败就结束。它们通常会给一个很轻的提示:网络异常、设备不可用、请稍后重试。看起来没毛病,但如果这个 Demo 是跨设备协作场景,这种处理就太薄了。
因为这类失败很多时候不是“根本不成立”,而只是“当前条件不满足”。比如:
- 对端刚好切页面;
- 槽位还没释放;
- 用户碰完又挪开了设备;
- 目标端一度被中断,但很快就恢复;
- 用户连续发起两次任务,后一个其实完全可以稍后继续。
这些情况都不适合“一刀切直接失败”。所以第四篇里我专门加了 RetryQueue。这套队列我没有往复杂设计走,而是有意保持小而清楚:
- 收下待重试任务;
- 记录失败原因;
- 记录已重试次数;
- 在合适的时机重新发起;
- 超过上限后再真正判定结束。
文件位置: entry/src/main/ets/manager/RetryQueue.ets
用途: 保存待重试任务,并在恢复时重新执行。
interface RetryMission {
  transfer: TransferMission
  delay: number
  reason: string
  retryCount: number
  createdAt: number
}

export class RetryQueue {
  private queue: RetryMission[] = []
  private maxRetryCount: number = 3

  enqueue(transfer: TransferMission, delay: number, reason: string) {
    this.queue.push({
      transfer,
      delay,
      reason,
      retryCount: 0,
      createdAt: Date.now()
    })
  }

  async flush(handler: (mission: RetryMission) => Promise<boolean>) {
    for (const mission of this.queue) {
      mission.retryCount += 1
      await DelayTask.sleep(mission.delay)
      const success = await handler(mission)
      if (success) {
        Logger.info(`[Retry] success id=${mission.transfer.id}, cost=${mission.retryCount}`)
        this.remove(mission.transfer.id)
      } else if (mission.retryCount >= this.maxRetryCount) {
        Logger.warn(`[Retry] give up id=${mission.transfer.id}`)
        this.remove(mission.transfer.id)
      }
    }
  }

  cancel(id: string) {
    this.queue = this.queue.filter(item => item.transfer.id !== id)
  }

  remove(id: string) {
    this.queue = this.queue.filter(item => item.transfer.id !== id)
  }

  getPendingList(): RetryMission[] {
    return [...this.queue]
  }
}
你会发现,这里并没有什么“高并发调度算法”,但它已经足够说明第四篇想表达的核心:
失败以后,SlideDrop 不再只是“退出”,而是开始学会“恢复”。
八、状态中心页面不是装饰,它其实承担了“把内部过程翻译成人话”的责任
写到这里,第四篇其实已经有了完整的底层逻辑:状态机、冲突恢复、重试队列、日志出口。但如果这些都只留在代码里,读者和用户依然会觉得它“黑盒”。
所以我才坚持把“状态中心”单独做出来。它不是为了凑一个页面数量,而是为了做一件很实际的事:
把工程内部过程翻译成人能理解的界面。
这件事说起来很轻,实际上很难。因为你不能把所有底层术语原样扔给用户。比如:
WAITING_TOUCH在界面上就应该写成“等待碰一碰”;CONFLICT不能只显示“冲突”,而是要告诉用户“该位置已有内容”;RETRY ENQUEUED这种内部词不该直接出现,而应该翻译成“已加入重试队列”;CANCELLED也要区分到底是“用户取消”,还是“目标设备超时导致终止”。
这一步其实很像技术写作本身:把工程里的专业状态,翻译成外界能理解的语言。SlideDrop 第四篇,我觉得最有意思的地方就在这里——代码和文章做的是同一件事。
九、类型二这张综合讲解图,第四篇我最想强调的是“异常也有秩序”
前面几篇你已经让我固定了两种视觉语言:一个是简约封面,一个是类型二综合讲解图。我现在越来越认同这个组合,因为它很适合技术文章。
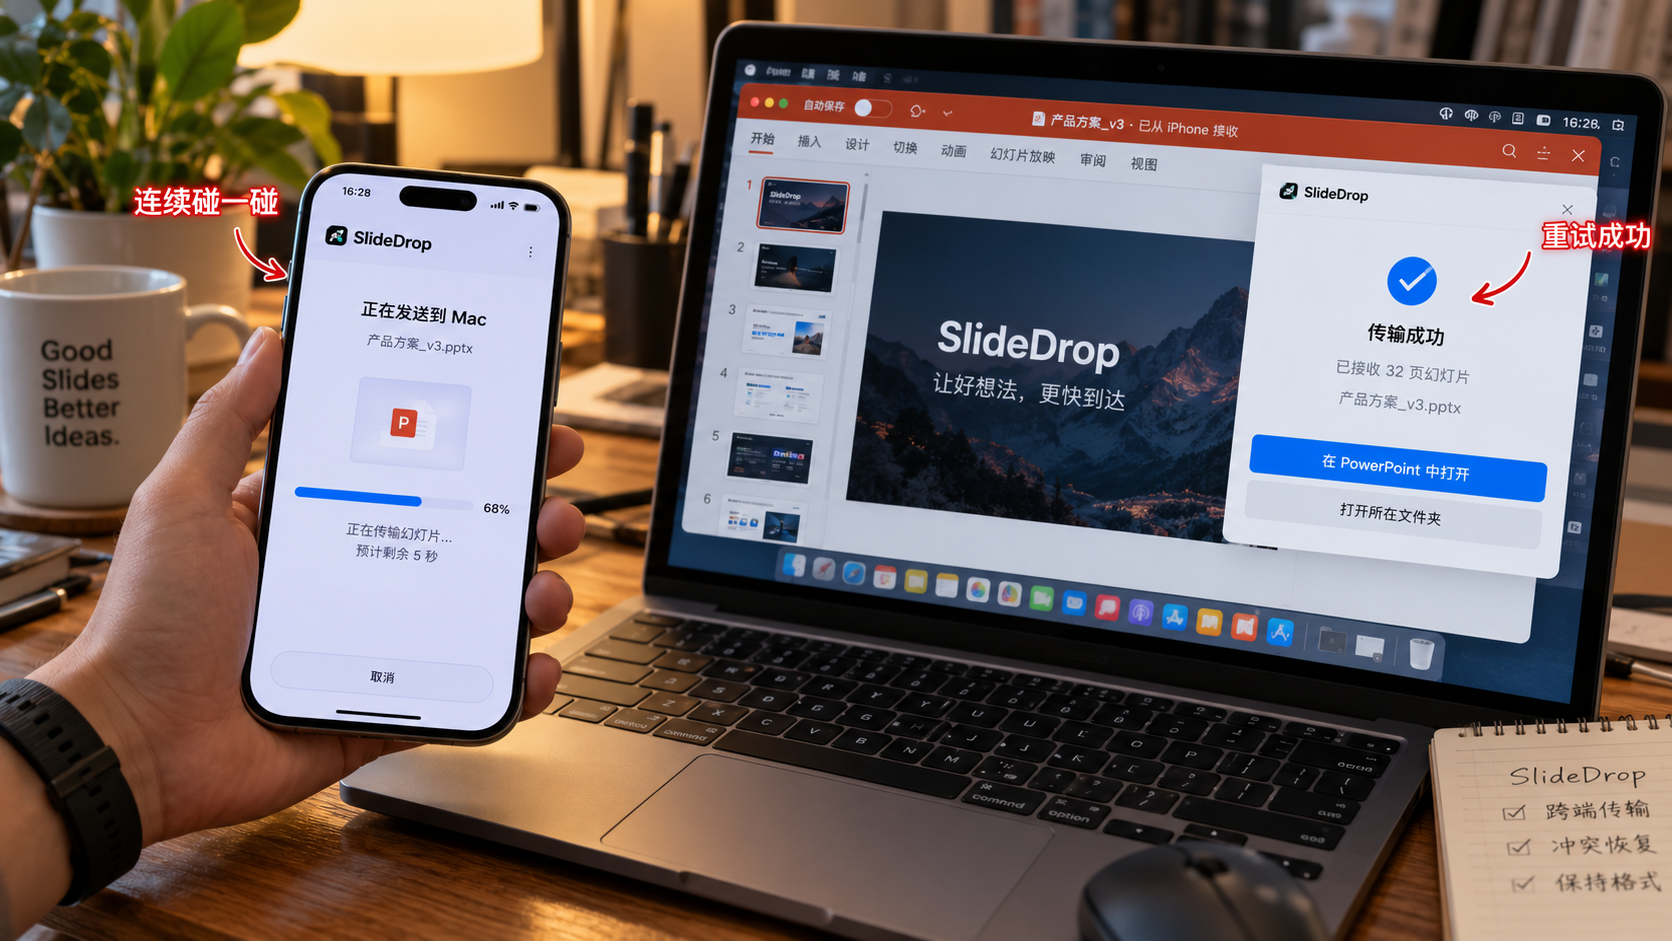
尤其是第四篇,类型二这张图的价值比前面更大。因为第四篇讲的不是单点能力,而是一段比较复杂的链路。单独一张 DevEco 截图说明不了全貌,单独一张手机图也不够,所以我特别希望类型二图里同时出现这几类信息:
- DevEco 里的状态机或恢复代码;
- 手机端的状态中心界面;
- 中间的状态流转图;
- 下方或侧边的实机碰一碰效果。
当这些元素放在一起的时候,读者会非常直观地感受到:
- 这篇文章不是只在讲 UI;
- 也不是只在讲某个 API;
- 它讲的是一条完整的工程链路,以及这条链路在异常场景下如何继续成立。
所以第四篇的类型二图,我最看重的不是视觉炫技,而是它能不能把“异常也有秩序”这件事讲清楚。
十、第四篇我怎么验收:看的是“失败以后还能不能回来”
前三篇的验收更偏功能证明,而第四篇的验收明显更偏工程稳定性。我这次基本按下面几条来验收。
1)正常状态链是否完整
我会先走一条正常投递链路,确保至少能覆盖:
PREPARINGWAITING_TOUCHTRANSFERRINGSUCCESS
而且不仅状态要走到,页面上的步骤、日志里的打印,也要跟着同步变化。
2)冲突检测是否准确
我会故意找一个已有内容的目标槽位再次发起投递,看系统能不能稳定触发冲突状态,而不是直接覆盖过去,也不是静默失败。
3)替换确认是否闭环
冲突出现以后,用户确认替换时,日志里应该能看到冲突、确认、替换、重试、成功这一整串过程;用户取消时,则应该能明确落在 CANCELLED,而不是停在一个不清不楚的中间态。
4)重试是否真的有效
我会人工制造一次短暂中断,比如延迟目标端响应,再看任务是否被加入重试队列,恢复以后是否能继续往前推进,而不是每次都要重新从头来一遍。
5)连续碰一碰是否会互相污染
这是第四篇非常关键的一点。我会连续发起多次投递,观察:
- 新任务是否覆盖旧任务状态;
- 已结束任务是否会污染最近结果区;
- 重试中的任务是否会和新任务抢页面状态。
如果这些地方不稳,第四篇就还不算完成。
6)用户能不能看懂
虽然这套 Demo 本质上还是一个演示项目,但第四篇之后,我已经开始用“用户能不能一眼看明白”来做验收了。用户至少要知道:
- 现在是不是还在投递;
- 为什么发生冲突;
- 应该替换、取消,还是再试一次;
- 最近一次结果到底是什么。
如果这些都能说清楚,我就认为第四篇是真的把异常路径纳进来了。
十一、这篇写完以后,我对第五篇反而更有底了
有意思的是,第四篇虽然写的是“异常”和“恢复”,但它写完以后,我反而觉得第五篇会轻松很多。
原因很简单。之前你会一直担心:
- 会话会不会收不住;
- 页面会不会越来越重;
- 日志会不会越来越散;
- 一旦出错,Demo 会不会没法继续演示。
而第四篇其实已经把这些问题拆得差不多了。它做的不是最后一步工程收口,但它把工程收口最难啃的前提铺好了。到第五篇时,我就能更从容地去做下面这些事:
- 生命周期和页面间状态同步;
- 资源释放与清理;
- 图片、文件和会话缓存收尾;
- 可复用 Demo 目录模板;
- 最终演示验收与文章收官。
换句话说,第四篇的作用不是“给第四篇自己加分”,而是把整个五连载往最终成型的方向推了一大步。
十二、本文小记
如果让我用一句话总结第四篇,我会说:
第四篇最重要的价值,不是多了一个状态中心页面,而是 SlideDrop 第一次认真面对“失败以后怎么办”。
前三篇解决的是:怎么把东西精准投进去。第四篇开始解决的是:
- 投递过程怎么被定义;
- 冲突出现以后怎么恢复;
- 用户取消、等待超时、重试成功这些状态怎么被表达;
- 代码、日志、页面和配图怎么形成一个统一的叙事。
这一步没有第三篇那种“规则命中了”的爽感,但它更像真实工程。因为真正的项目,从来不只是看成功路径,而是看你在异常路径上还能不能站得住。
也正因为如此,我觉得第四篇可能会是这个五连载里最“有工程味”的一篇。它没有试图炫很多新能力,它只是认真把一件很关键的事做好了:让 Demo 在异常场景下也能讲清楚自己。
十三、这篇里我刻意保留的几个“工程味”细节
为了让第四篇不只是停留在概念层,我在实现和写作上都刻意保留了几个细节。它们看起来不大,但我觉得很能代表这篇文章的气质。
1)状态词尽量稳定,不频繁换说法
文章里写 等待碰一碰,代码里就让它落到 WAITING_TOUCH;文章里写 投递中,页面里就保持同样语义。这样做的好处,是读者在看配图、看代码、看解释时不会不断做“翻译工作”。技术文章最怕的就是同一件事换了三种名字,读起来会很累。
2)日志一定保留“前后状态”而不是只打结果
我这篇特别在意日志是否能看出“从哪到哪”。比如 IDLE -> PREPARING、WAITING_TOUCH -> TRANSFERRING、CONFLICT -> SUCCESS。因为只看单点结果,后面很难定位问题;看状态流转,才更接近真实排查思路。这也是为什么配图里我总想把日志区保留下来。
3)冲突恢复不直接做成大红色危险按钮
很多教程图一碰到冲突就喜欢做得很吓人,但实际产品里并不是每次冲突都意味着严重错误。它更像是一个需要用户确认的分支。所以我在这篇里更偏向“克制表达”:提醒用户当前槽位已有内容,同时给出替换、取消、重试三个明确动作。这样更像一个能落地的交互,而不是单纯追求视觉戏剧性。
4)实机图里保留了轻微办公环境感
这一点其实是为了让文章更像“真实开发记录”。如果所有图都过于干净,反而像概念设计稿。我保留了桌面、电脑、手机同框,少量红色标注只用来解释关键点,而不是每张图都满屏箭头。这样一来,文章整体会更像开发过程复盘,而不是宣传海报。
5)代码不追求写满,而是尽量只放能解释问题的那一段
第四篇里状态机、冲突恢复、重试队列这三段代码就是这个思路。它们不一定覆盖项目全部实现,但都刚好能解释“为什么要这样拆”“异常是怎么被收住的”“页面为什么能跟着变”。我越来越觉得,技术文章里的代码不一定越多越好,关键是要让每一段都承担清晰职责。
十四、写在最后:第四篇不是炫功能,而是在替第五篇铺路
如果前三篇让我更有“做出东西”的成就感,那第四篇给我的感觉更像“把东西做稳”。它不一定最热闹,但它会让整个 SlideDrop 系列一下子站住。
因为从这一篇开始,我终于可以比较有底气地说:这不是一个只能顺着演示路径跑一遍的 Demo 了。它开始有状态、有恢复、有日志、有重试,也开始有一点真实工程面对异常时的克制和秩序感。
而第五篇能不能把整个系列顺利收口,其实很大程度上就取决于第四篇有没有把这些地基打稳。现在我反而挺期待第五篇的,因为状态、冲突、恢复这些最容易发散的部分,已经在这一篇里被规整得差不多了。剩下的,就是把这套 Demo 真的收成一个可以复用、可以展示、也可以写进完整项目复盘的作品。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献7条内容

所有评论(0)