
HarmonyOS 7 Image Kit + VideoProcessingEngine:图像超分任务队列、缓存复用与质量档位治理【鸿蒙心迹】
这篇不把图像超分写成“调用一个接口就结束”的能力介绍。我更关心的是它真正进到业务以后,连续预览、快速切图、重复处理、质量档位和结果缓存怎么一起工作。Demo 项目叫 ClearShelf,用一组低清老照片模拟相册修复工作流。
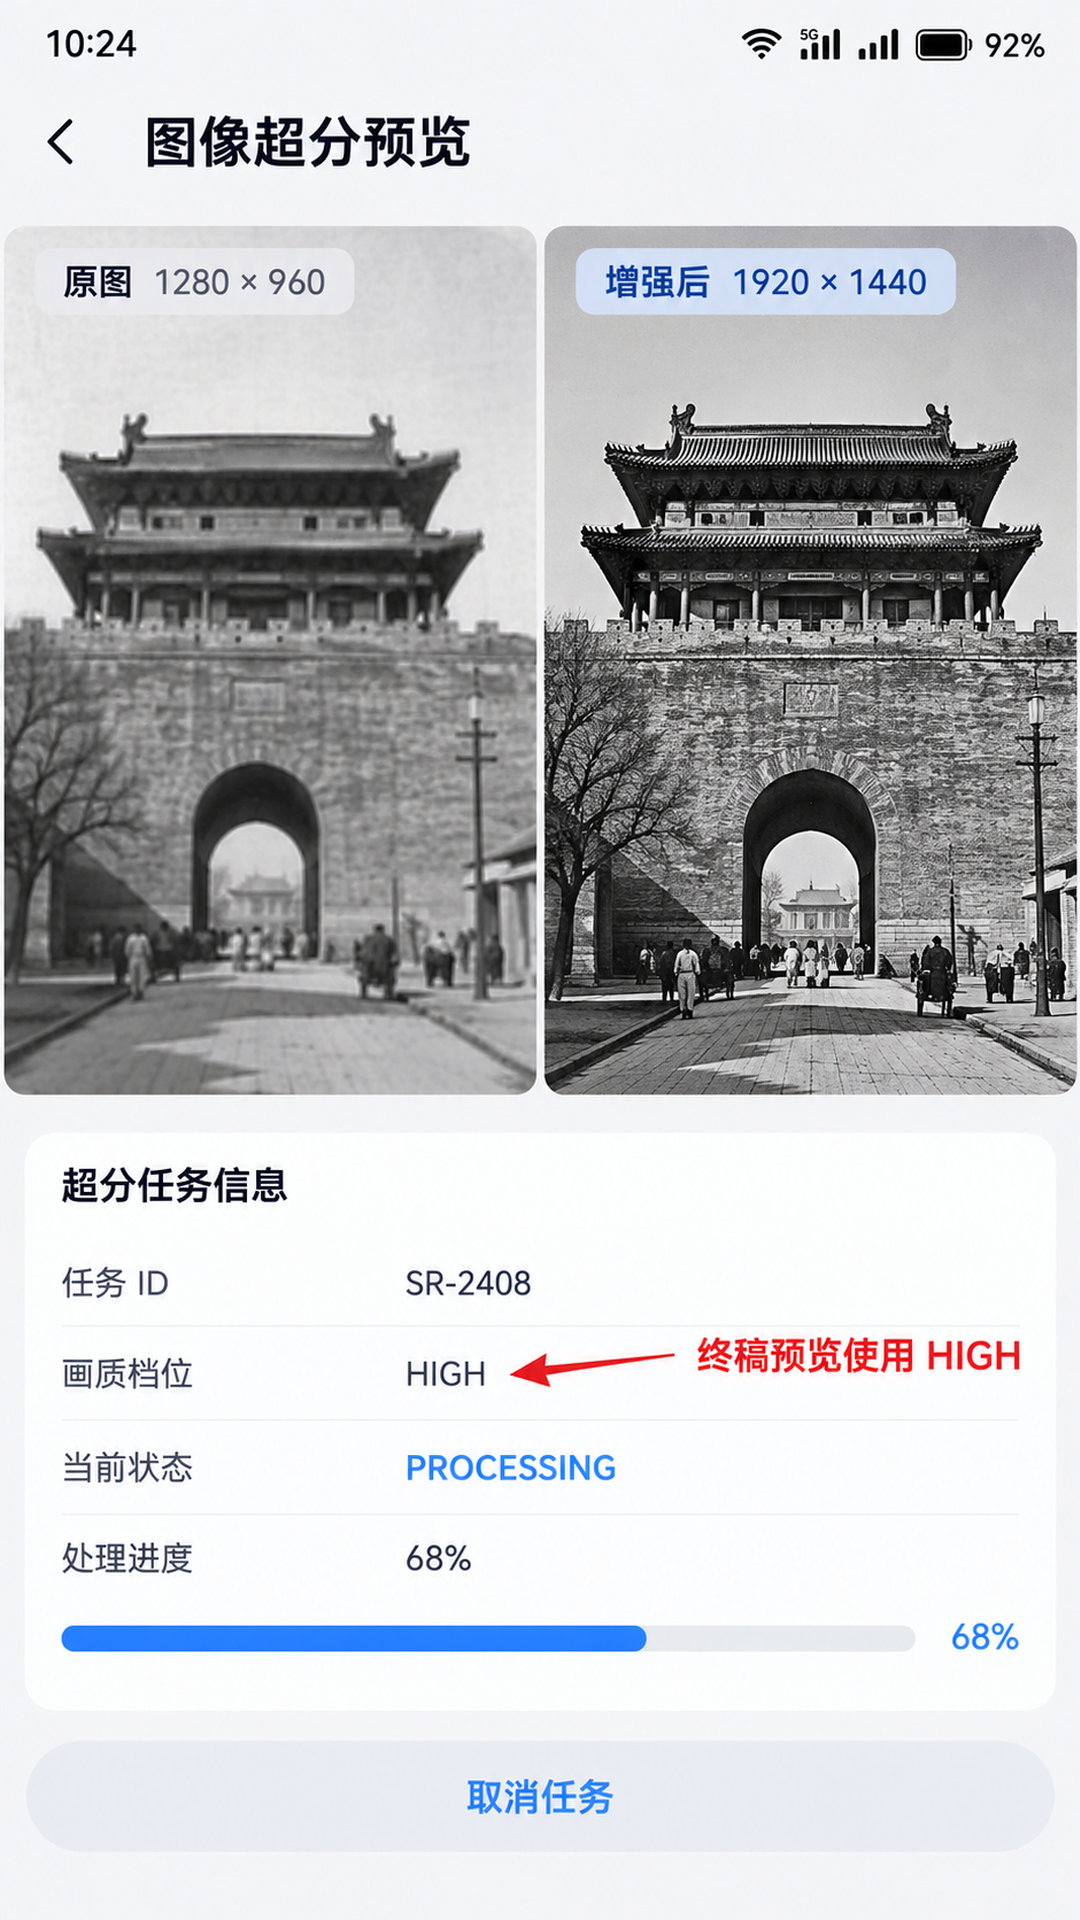
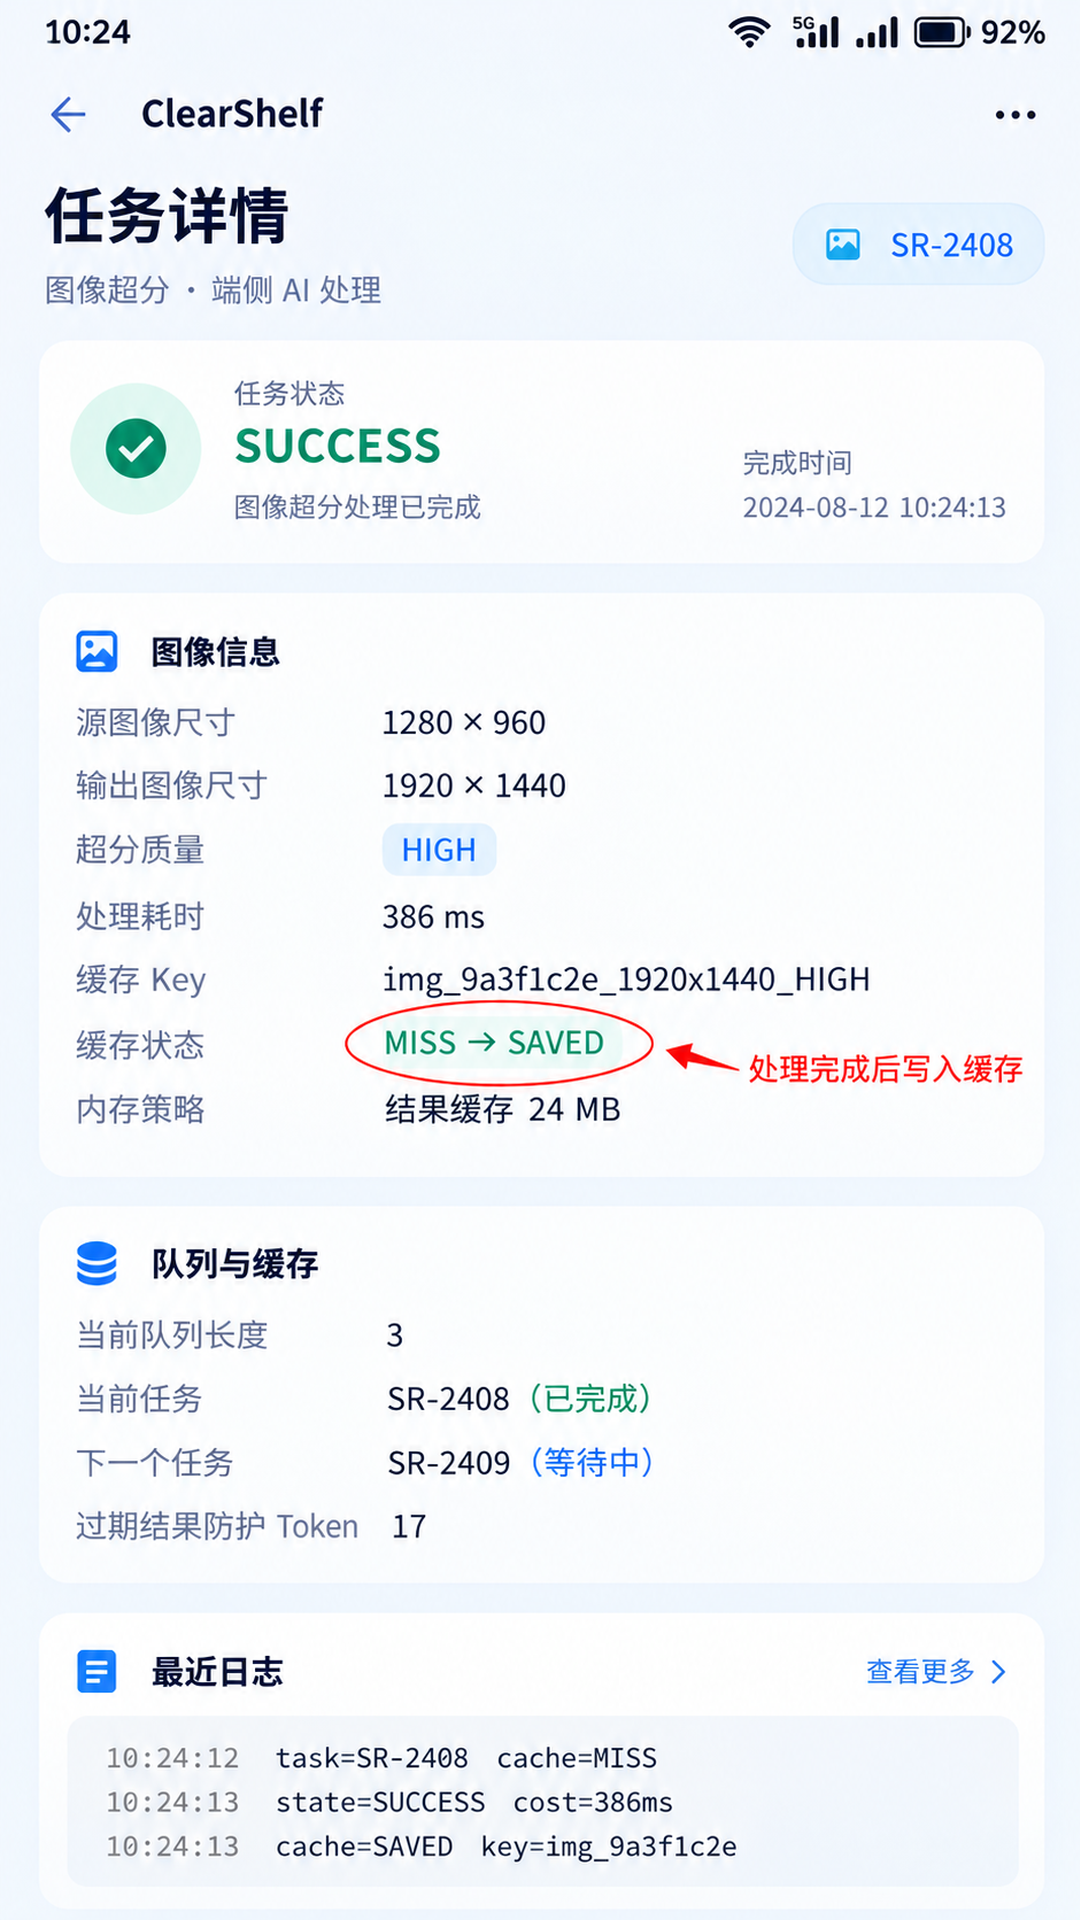
我在 ClearShelf 里设定了一条很具体的验证链路:原图 1280 × 960,最终预览输出 1920 × 1440,任务 ID 为 SR-2408,终稿使用 HIGH 档。第一次处理时缓存为 MISS,处理完成后写入缓存,结果页记录耗时 386 ms。这些数字并不是为了做跑分,而是为了让后面的队列、缓存和 UI 状态都能围绕同一条任务线展开。
官方当前的 ArkTS 图像处理能力由 Image Kit 中的 videoProcessingEngine 提供。官方文档说明,该模块可对图片做细节增强和缩放,支持 NONE / LOW / MEDIUM / HIGH 四个质量档位;其中 HIGH 更偏向需要明显细节增强的场景,但性能开销也更高。它同时对输入格式、DMA PixelMap 以及分辨率范围有约束,所以工程上真正麻烦的地方,往往不是“会不会调 API”,而是“什么时候调、调哪一档、结果还要不要继续用”。
一、先看结果,再反推这条链路为什么没有写成一个按钮
ClearShelf 的页面看上去很简单:左边是原图,右边是增强后的结果,下面显示任务状态。真正开始连续操作后,问题很快就出现了。
我连续做了三次动作:先打开 A 图,再切到 B 图,随后又返回 A 图。如果每次页面变化都直接执行超分,短时间内就会出现三个异步处理请求。更麻烦的是,用户最后停留在 A 图,但 B 图的处理结果可能更晚返回。一旦页面只认“最后一个完成的 Promise”,B 图就可能把 A 图覆盖掉。
这类问题和网络搜索很像:并不是请求失败,而是旧请求成功得太晚。
所以我把页面状态拆成四个值:
IDLE:还没有进入处理流程;QUEUED:任务已经排队,但尚未占用处理器;PROCESSING:当前任务正在调用超分接口;SUCCESS / FAILED:结果已确定。
图 03 记录的是 SR-2408 正在执行时的状态。界面上进度显示 68%,这个进度不是底层算法真实回调,而是业务层的阶段进度:完成输入检查、缓存检查、处理器调用、结果写入分别占不同权重。这样做的好处是,UI 不会伪装成“算法精确进度”,但用户仍能知道流程走到了哪里。
这里有一个很重要的边界:enhanceDetail() 本身是一个异步处理调用,业务层可以取消“等待和展示旧结果”,但不应该把这种逻辑包装成“底层任务已经被硬取消”。ClearShelf 的取消策略是让旧任务结果失效,而不是承诺能中止已经进入底层的计算。
二、真正先落地的不是 HIGH,而是输入合法性
第一次接这个能力时,我最容易犯的错,是直接把“质量档位”当成核心参数。后来发现,真正应该排在最前面的其实是输入约束。
官方文档当前要求用于这条 ArkTS 图像细节增强链路的图片满足对应格式与内存要求;例如支持 RGBA、BGRA、NV12、NV21,处理的 PixelMap 需要符合 DMA 内存要求。不同档位还有各自的输入输出分辨率范围,HIGH 的范围比 LOW、MEDIUM 更严格。
这意味着业务层不能只保存一个 PixelMap,还要保存它的来源信息和计划输出尺寸。ClearShelf 里我把任务模型写成下面这样。
这段代码解决什么问题:在进入超分接口前,把任务身份、输入尺寸、输出尺寸和质量档位固定下来,避免 UI 临时拼参数。
import { videoProcessingEngine } from '@kit.ImageKit';

export type EnhanceState = 'IDLE' | 'QUEUED' | 'PROCESSING' | 'SUCCESS' | 'FAILED';

export interface EnhanceTask {
  taskId: string;
  sourceKey: string;
  sourceWidth: number;
  sourceHeight: number;
  targetWidth: number;
  targetHeight: number;
  quality: videoProcessingEngine.QualityLevel;
  state: EnhanceState;
  token: number;
}

export const currentTask: EnhanceTask = {
  taskId: 'SR-2408',
  sourceKey: 'img_9a3f1c2e',
  sourceWidth: 1280,
  sourceHeight: 960,
  targetWidth: 1920,
  targetHeight: 1440,
  quality: videoProcessingEngine.QualityLevel.HIGH,
  state: 'QUEUED',
  token: 17
};
为什么要把 sourceKey 和 token 一起放进来?因为它们解决的是两类完全不同的问题。sourceKey 用来判断“同一份输入是否已经处理过”,token 用来判断“当前返回的结果还是不是页面想要的结果”。一个服务缓存,一个服务时序。
项目里还应该把分辨率检查做成独立函数,而不是等到底层抛错后才提示用户。尤其 HIGH 档更适合最终预览,不适合列表快速滚动时对每一张图都立即执行。列表缩略图、详情页预览、导出结果,应该是三套不同策略。
三、初始化一次,处理器复用,但不要把生命周期做成全局野变量
在页面 Demo 里最省事的写法,是进入页面就初始化环境,离开页面就释放。真正项目里如果多个页面会连续使用图像处理能力,频繁初始化和释放会让调用层变得很碎。
我的处理方式是做一个 SuperResolutionQueue 服务。它负责环境初始化、处理器创建、串行任务执行和页面 token 校验,页面只提交任务,不直接操纵引擎。
这段代码解决什么问题:把 Image Kit 环境和 ImageProcessor 从页面生命周期中抽出来,避免每次点击都重复创建。
import { image, videoProcessingEngine } from '@kit.ImageKit';

export class SuperResolutionQueue {
  private processor?: videoProcessingEngine.ImageProcessor;
  private ready: boolean = false;

  async initialize(): Promise<void> {
    if (this.ready) {
      return;
    }
    await videoProcessingEngine.initializeEnvironment();
    this.processor = videoProcessingEngine.create() as videoProcessingEngine.ImageProcessor;
    this.ready = true;
    console.info('[SR] environment ready');
  }

  async enhance(
    source: image.PixelMap,
    width: number,
    height: number,
    level: videoProcessingEngine.QualityLevel
  ): Promise<image.PixelMap> {
    if (!this.processor) {
      throw new Error('ImageProcessor is not initialized');
    }
    return await this.processor.enhanceDetail(source, width, height, level);
  }

  release(): void {
    if (!this.ready) {
      return;
    }
    videoProcessingEngine.deinitializeEnvironment();
    this.processor = undefined;
    this.ready = false;
  }
}
这里我故意没有把处理器做成随手可访问的全局对象。图像处理对象一旦被任何页面随意调用,队列策略就形同虚设。更稳妥的做法是:只有服务内部可以拿到处理器,外部只能提交任务。
另外,资源释放也不要简单绑定到某一个页面的 aboutToDisappear()。如果 A 页面跳到 B 页面,而 B 页面还要继续使用同一个处理器,A 一消失就释放环境,反而会制造新的状态问题。实际项目应该根据应用级使用范围、页面栈和业务生命周期确定释放时机。
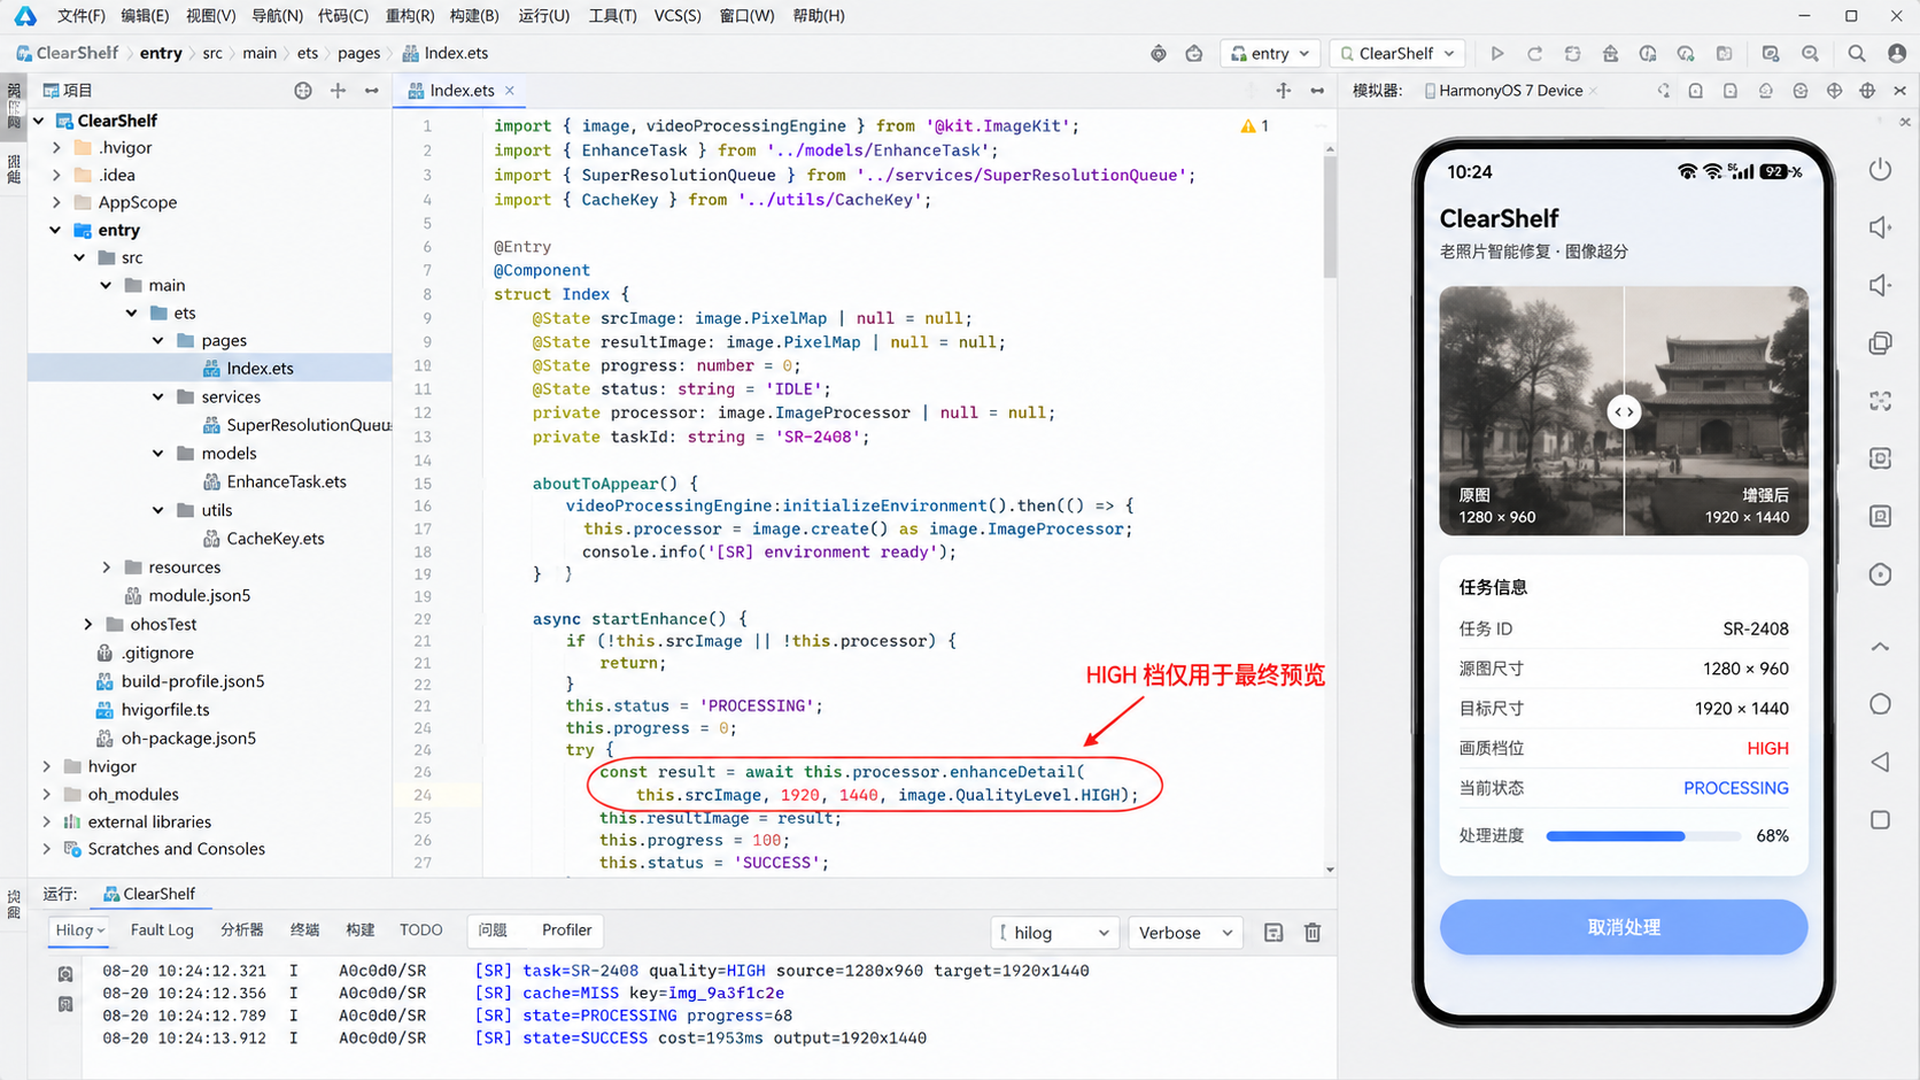
图 02 是我把这套逻辑放进 DevEco Studio 后的调试状态。右侧模拟器对应 SR-2408,日志里也用同一个任务号过滤,因此不会出现“页面看 A、日志查 B”的情况。
四、质量档位不是“越高越好”,而是不同页面承担不同成本
图像超分最容易被写成一个“画质开关”:LOW 不够清楚就上 MEDIUM,MEDIUM 不够就上 HIGH。这个判断在工程里太粗了。
我现在更愿意按用户正在做什么来选档位。
列表页里,用户一秒钟可能滑过很多张图。此时真正重要的是首屏稳定和滚动流畅,缩略图只需要“看得清”,没有必要为每一张图争取极致纹理。LOW 或 MEDIUM 更合理,而且还可以加可见区域判断,只处理当前真正需要展示的资源。
进入单图详情页后,用户会停留更久,可以允许更高处理成本。这个阶段我通常先展示原图或已有缓存,再根据图片尺寸与设备状态决定是否触发增强。
到了“查看终稿”或“导出前确认”这类明确动作,HIGH 才真正有价值。ClearShelf 的 SR-2408 就属于这种路径,所以图里明确标了“终稿预览使用 HIGH”。
这里还有一个工程取舍:不要把 HIGH 当成修复任何图片的万能按钮。原始图像如果已经严重失真、主体过小、信息本身缺失,超分只能在算法能力范围内增强细节,不应该在产品文案里承诺“恢复真实细节”。开发页面可以展示对比,但对用户的描述最好保持克制。
五、缓存键必须把质量档位和目标尺寸算进去
做完第一版后,我碰到过一个很典型的问题:A 图处理过一次 HIGH,随后切换到 MEDIUM,界面却直接命中了旧结果。原因是我一开始的缓存键只有 sourceKey。
这其实等于告诉缓存:“同一张输入图,不管你要 960p、1440p,还是 LOW、HIGH,我都当成同一种结果。”
后来缓存键改成四部分:输入内容标识、目标宽、目标高、质量档位。
这段代码解决什么问题:确保不同输出尺寸与不同质量档不会互相污染缓存。
import { videoProcessingEngine } from '@kit.ImageKit';

export function buildCacheKey(
  sourceKey: string,
  width: number,
  height: number,
  level: videoProcessingEngine.QualityLevel
): string {
  return `${sourceKey}_${width}x${height}_${level}`;
}

const key = buildCacheKey(
  'img_9a3f1c2e',
  1920,
  1440,
  videoProcessingEngine.QualityLevel.HIGH
);

console.info(`[SR] cacheKey=${key}`);
这只是第一层。实际项目还要考虑算法版本、源图编辑版本、裁剪区域是否改变。如果用户先裁剪后超分,裁剪结果发生变化,旧缓存自然也不应该继续命中。
ClearShelf 当前只做本地 Demo,所以用 img_9a3f1c2e_1920x1440_HIGH 作为可读 key。第一次处理记录 MISS,完成后变成 SAVED;下次同样条件再进入时才允许 HIT。图 04 中看到的 MISS → SAVED 就是这次完整执行留下的证据。
六、快速切图时,旧结果要“作废”,不是和新结果抢最后一次 setState
有了缓存,还没解决时序问题。
假设用户在 A 图点击增强,token 是 16;还没结束时又切到 B 图,token 变成 17。A 的处理先开始却后返回,如果页面只看 Promise 完成顺序,它仍可能覆盖 B。
我用了一个很朴素的 token 方案:每次提交新的页面意图时递增 token,结果回来以后先比较 token,再决定是否更新 UI。
这段代码解决什么问题:防止过期异步结果覆盖当前页面。它不是取消底层算法,而是取消旧结果的展示资格。
private activeToken: number = 0;

async requestPreview(source: image.PixelMap): Promise<void> {
  const token = ++this.activeToken;
  this.status = 'PROCESSING';

  const result = await this.queue.enhance(
    source,
    1920,
    1440,
    videoProcessingEngine.QualityLevel.HIGH
  );

  if (token !== this.activeToken) {
    console.info(`[SR] stale result ignored, token=${token}`);
    return;
  }

  this.resultImage = result;
  this.status = 'SUCCESS';
}
这个方法不复杂,却比“给按钮加个 loading”有效得多。loading 只能避免用户重复点击同一个按钮,拦不住页面切换、图片替换、参数变化这些新的业务意图。
如果产品允许并行处理多个任务,就不能只用一个全局 token,而要按图片或业务槽位维护 token。比如相册批处理是“任务 A、B、C 都要完成”,单图预览才是“只认最新一次”。不要把两种业务混成一套取消规则。
七、我最后保留的日志,不是为了看热闹,而是为了复盘状态
这一版我只保留几类日志:任务创建、缓存命中、开始处理、结果完成、旧结果丢弃和异常。每一条都带 taskId。
例如 SR-2408 的正常路径可以是:
[SR] task=SR-2408 quality=HIGH source=1280x960 target=1920x1440
[SR] cache=MISS key=img_9a3f1c2e_1920x1440_HIGH
[SR] state=PROCESSING token=17
[SR] state=SUCCESS cost=386ms output=1920x1440
[SR] cache=SAVED key=img_9a3f1c2e_1920x1440_HIGH
日志真正有用的场景,是用户反馈“切回来怎么又处理了一次”时,我能判断到底是 cache key 变化、缓存被释放、还是输入图已经不是同一个版本。没有这些关联字段,单看一句 enhance success 几乎得不到任何工程信息。
性能观察也一样。一次 386 ms 不能代表所有设备,更不能拿来宣称某个统一性能结论。它只是这次 Demo 的一次记录。真正上线要按设备、输入尺寸、质量档位、前后台状态做分组观察,并且看 P50/P90 一类分布,而不是只截图最快的一次。
八、把超分接进真实产品后,我会额外加的三条边界
第一条是内存上限。原图和增强结果都可能占用较大内存,列表页不能无限保留 PixelMap。缓存策略最好区分“结果索引”和“结果对象”,前者可以长期存在,后者要受内存预算约束。
第二条是前后台切换。如果处理期间应用进入后台,回来后页面已经换了业务上下文,仍然要通过 token 或页面任务标识确认结果是否继续可见。不要看到 Promise 成功就无条件 setState。
第三条是能力失败后的降级。输入不满足要求、资源紧张、处理异常,都应该有明确退路。最基本的做法是继续展示原图,保留“再次尝试”入口,而不是让整张图片区域变成错误占位。
这三条并不属于图像超分算法本身,却决定了这项能力能不能稳定进入真实产品。
九、真正做一次连续操作压测,才能看见队列设计值不值得
单张图片处理成功只能证明接口接通了,不能证明交互稳定。为了验证队列逻辑,我后来固定了一套非常“笨”的手工压测:准备 6 张不同尺寸但都符合输入要求的图片,按固定节奏连续切换详情页,并反复在 LOW、MEDIUM、HIGH 三档之间切换。测试过程中不追求极限速度,只观察四件事:是否出现旧图覆盖新图、是否重复处理已经有缓存的结果、页面退出后是否继续把结果写回旧页面、内存是否随着反复进入详情页持续上涨。
第一轮测试就暴露了两个问题。一个是我虽然加了 token,但缓存写入发生在 token 校验之前。于是旧任务虽然没有更新 UI,却仍然可能把结果写进一个已经失效的缓存槽位。第二个问题是页面为了展示“最近处理结果”,长期持有了多个 PixelMap,连续测试十几次以后,内存增长比算法耗时更值得警惕。
修正以后我把流程重新排成:底层处理完成 → 校验任务身份 → 生成稳定缓存键 → 写缓存 → 更新 UI。只有业务确实需要保留的结果才进入内存缓存,其余只保存轻量元数据或持久化后的文件路径。
我还把连续切图的验收标准写得很明确:
场景 A:A → B → A,最后页面必须展示 A
场景 B:同一 A + 同一尺寸 + 同一档位,再次进入应命中缓存
场景 C:A-HIGH 切换 A-MEDIUM,不允许复用 HIGH 的结果
场景 D:任务返回时页面已离开,不允许回写已销毁页面状态
场景 E:处理失败后仍可看到原图,并可以重新发起任务
这种检查没有什么“高深算法”,但特别适合端侧 AI 能力。因为用户真正感知到的不是模型名称,而是切图时会不会闪错图、返回时会不会卡住、反复处理会不会发热、失败时还能不能继续操作。
1. 列表页和详情页的处理策略必须分开
一开始我还想做一个统一的“自动增强”开关,后来删掉了。列表页的目标是快速浏览,详情页的目标是看细节,两者对处理成本的容忍度完全不同。统一开关看起来简单,实际会让最重的质量策略扩散到所有页面。
现在 ClearShelf 的规则更明确:列表页默认不做 HIGH;进入详情页后先检查缓存;用户放大图片或者进入“终稿预览”时才进入 HIGH 路径。这个设计也让埋点更容易解释——如果 HIGH 的调用次数异常升高,就能快速判断是不是某个页面错误地触发了终稿策略。
2. 不要用一台开发机上的一次耗时替代设备分层
端侧处理特别容易被开发者自己的设备误导。高性能设备上 386 ms 看起来很舒服,换到不同硬件、不同温度、不同后台负载,体验可能完全不同。因此我更愿意在日志里保留输入尺寸、输出尺寸、质量档位和耗时,然后在真实测试设备上形成分组数据。
如果后续接入性能采集,我会至少区分:首次处理 / 缓存命中、LOW / MEDIUM / HIGH、输入尺寸区间、前台连续处理次数。这样才能判断“慢”到底是算法本身、输入过大,还是业务重复调用造成的。
十、还有几个很容易被 Demo 隐藏掉的细节
第一个细节是结果展示尺寸不等于算法输出尺寸。页面可能只显示 900 px 宽,但为了后续放大和导出,算法输出仍然可能是 1920 px。渲染尺寸和处理尺寸不要混用,否则 UI 一改布局,就可能意外改变算法成本。
第二个细节是原图发生编辑后要主动失效缓存。旋转、裁剪、滤镜、重新下载,都可能让 sourceKey 对应的内容发生变化。如果 sourceKey 只是文件名,很容易继续拿到旧结果。更稳妥的做法是把内容摘要、编辑版本号或资源更新时间纳入缓存身份。
第三个细节是不要在异常分支忘记释放页面 loading 状态。图像处理调用失败时,如果只打印错误而没有把 PROCESSING 切回 FAILED,用户看到的就是一个永远转圈的按钮。技术上错误已经捕获,产品上却像死机。
第四个细节是异步接口不要被同步封装重新堵回主线程。官方同时提供同步和异步调用方式,业务页面更适合优先使用异步路径,把重处理放在不会阻塞交互的链路里。同步接口更适合明确受控、不会影响 UI 响应的场景,不能因为代码少两行就默认选同步。
第五个细节是资源释放要有归属。如果处理服务是应用级单例,就由服务统一维护引用和释放;如果只是某个独立页面临时使用,就让页面完整负责初始化到销毁。最怕的是初始化在 A,释放在 B,最后任何人都说不清当前环境是不是可用。
十一、这次改造真正解决的,是“图像超分怎么成为一条可管理的业务链路”
做完 ClearShelf 后,我对这类端侧 AI 能力的理解比刚开始更谨慎了。
接口只负责把一张图处理成另一张图;产品却要面对用户连续操作、页面变化、资源占用、缓存一致性、异步结果竞争和失败恢复。工程层真正需要设计的是这些“接口之外”的部分。
对于图像超分,我现在会把链路固定成:输入检查 → 任务建模 → 缓存查询 → 档位选择 → 串行或受控并发 → 结果 token 校验 → 缓存写入 → UI 展示 → 资源回收。
这样做以后,HIGH 不再只是一个枚举值,SR-2408 也不只是一条日志。每个状态都能对应到 UI,每个 UI 又能回到日志和代码。出现问题时,开发者知道该查任务、查缓存还是查输入,而不是反复怀疑“是不是算法没生效”。
参考资料

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)