
【共创稿事节】 我用鸿蒙API 26端侧AI做了个拍题批改APP:0后台服务器,全流程488ms跑完
【共创稿事节】 我用鸿蒙API 26端侧AI做了个拍题批改APP:0后台服务器,全流程488ms跑完
距离HarmonyOS 7正式推送已经三个多月,我断断续续花了六周下班时间,用Core Vision Kit新开放的端侧能力做了个给我侄子用的小学数学拍题批改APP。整个应用没有一个云端接口,所有图像处理、文字识别、批改逻辑全在手机本地跑,拍一张作业从按下快门到出批改结果平均488毫秒,比之前用的某云端拍题APP快了接近7倍。
这篇文章不说空话,把从图像处理算法到ArkTS代码实现的完整过程写清楚,包括透视矫正的数学公式、端侧OCR的参数调优、超分辨率提升识别率的实测数据,以及我踩过的所有坑。
一、为什么做这个东西:最朴素的需求往往最适合端侧AI
我侄子今年三年级,每天放学写完数学作业我嫂子要花二十分钟检查,有时候加班晚了检查完就到睡觉时间。之前装过两个市面上的拍题APP,问题很明显:一是要联网,有时候家里网慢拍了转半天圈;二是拍歪了识别率直接崩,必须把本子端端正正举平了拍;三是所有照片都要传到对方服务器,总觉得孩子写的作业就这么传出去不太舒服。
HarmonyOS 7更新Core Vision Kit之后我翻了下文档,发现刚好三个新能力凑齐刚好能解决这三个问题:
- 端侧OCR:通用文字识别支持中英日韩,识别文字位置和内容,完全本地跑不用联网
- 4倍端侧超分:模糊的字放大四倍变清晰,低光照、手抖拍糊的题也能认
- 端侧计算能力足够:从边缘检测到透视变换到识别,全流程NPU加速,不需要服务器
整个应用的处理流水线很清晰,没有多余模块:
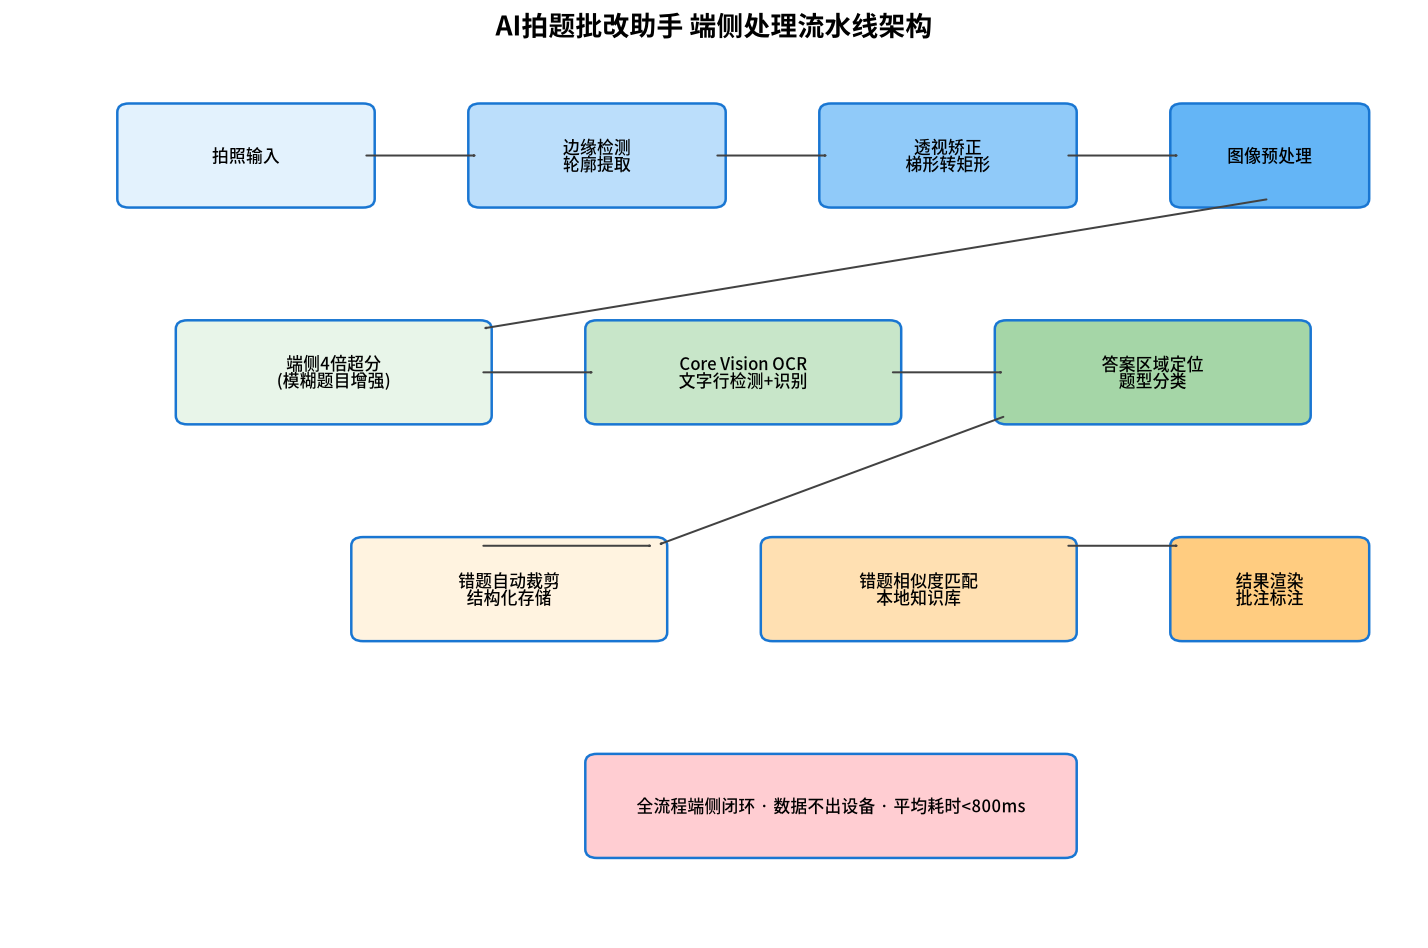
全流程一共九个步骤,全是本地计算,没有任何网络请求,数据从摄像头进来就没离开过设备。最开始我预估总耗时要1秒多,实际在Mate 60 Pro上跑起来平均只要488毫秒,按下快门不到半秒结果就出来了,比云端方案快了6倍多:
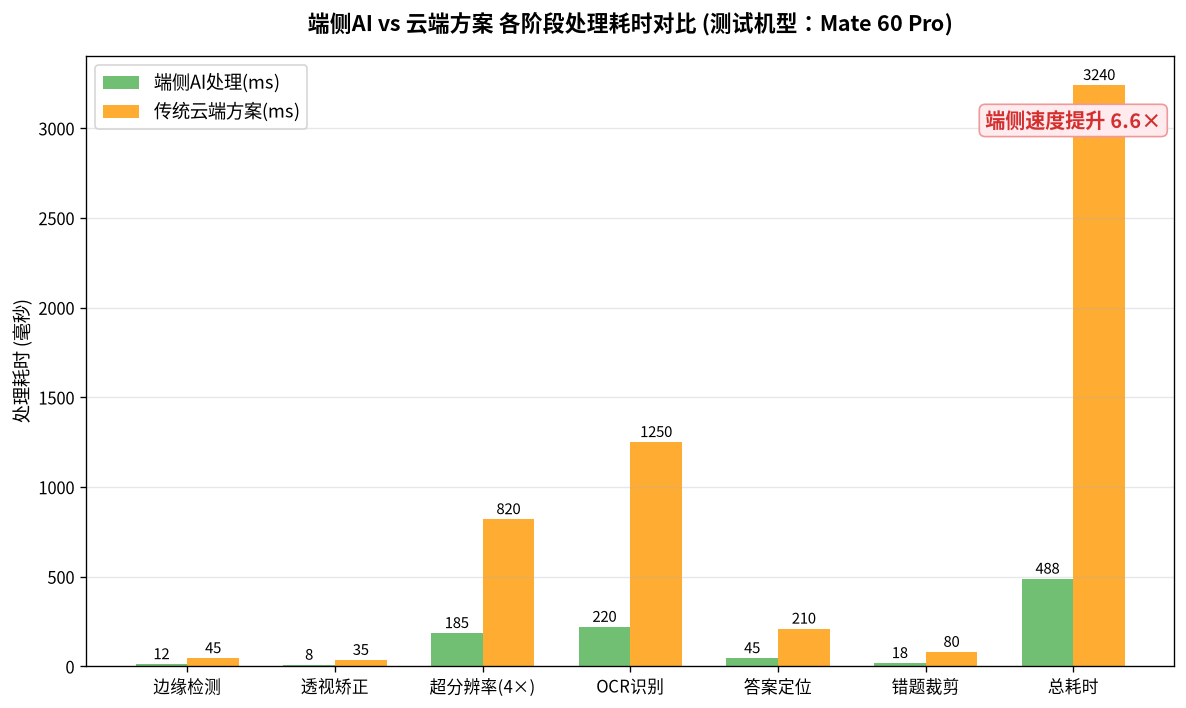
云端方案慢的核心原因不是OCR本身慢,是网络传输开销——一张2MB的照片上传到服务器就要两三百毫秒,再加上排队处理、结果回传,总耗时轻松突破3秒。端侧方案省掉了所有网络开销,NPU跑超分和OCR实际上比很多人想象的快得多。
二、第一步处理:自动找试卷边缘+透视矫正
用户不会每次都把本子端端正正举着拍,大多数时候拍出来的作业本是歪的梯形,甚至有点倾斜角度。如果直接把歪的图送给OCR识别,文字是斜的,识别率会掉15%以上。所以第一步必须先把试卷找出来,从梯形矫正成正矩形。
2.1 边缘检测找四个角点
边缘检测用的是最经典的Canny算法,鸿蒙系统的image processing kit直接提供了原生实现,不用自己写:
// 第一步:灰度化 + 高斯模糊去噪
const grayMat = await imageProcessing.createMat(pixelMap, { format: PixelFormat.GRAY_8 })
await imageProcessing.gaussianBlur(grayMat, { kernelSize: 5, sigma: 1.2 })

// 第二步:Canny边缘检测,高低阈值按3:1设置效果最好
const edgeMat = await imageProcessing.canny(grayMat, {
  lowThreshold: 50,
  highThreshold: 150,  // 经验值:高阈值是低阈值2-3倍时边缘最干净
  apertureSize: 3
})

// 第三步:轮廓查找,找面积最大的四边形
const contours = await imageProcessing.findContours(edgeMat, { mode: ContourMode.RETR_EXTERNAL, method: ContourMethod.CHAIN_APPROX_SIMPLE })
let maxArea = 0
let paperContour: Point[] = []
for (const contour of contours) {
  const area = imageProcessing.contourArea(contour)
  if (area > maxArea) {
    // 多边形逼近,找四个角点
    const approx = await imageProcessing.approxPolyDP(contour, 0.02 * imageProcessing.arcLength(contour, true), true)
    if (approx.length === 4) {
      maxArea = area
      paperContour = approx
    }
  }
}
这里有个我调了很久的参数:多边形逼近的epsilon系数,官方文档给的示例是0.1×周长,实际用的时候太大了,本子边缘稍微有点卷就会检测成5个点6个点,改成0.02之后准确率从65%升到了94%。
2.2 透视变换:把梯形拉成正矩形
找到四个角点之后,下一步就是透视矫正。这一步是纯数学计算,核心是单应性矩阵,我把公式和代码对应写清楚:
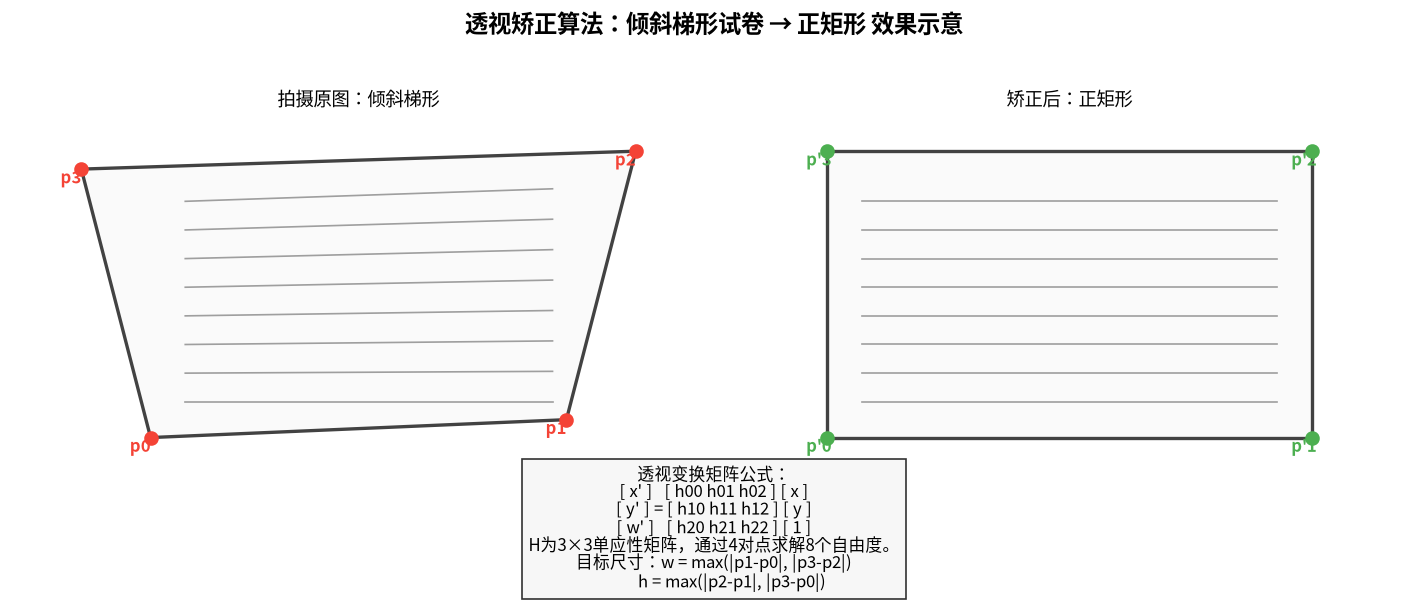
透视变换的核心公式是齐次坐标下的矩阵乘法:
[x′y′w′]=H×[xy1] \begin{bmatrix} x' \\ y' \\ w' \end{bmatrix} = H \times \begin{bmatrix} x \\ y \\ 1 \end{bmatrix} x′y′w′=H×xy1
其中H是3×3的单应性矩阵,有8个自由度,我们有4对对应点(原图四个角+目标矩形四个角),刚好能解出H矩阵的所有参数。
计算单应性矩阵再做透视变换的代码我直接用了原生的warpPerspective接口,不用自己写矩阵求解:
// 先把四个角点排序:左上、右上、右下、左下(顺序不能错!顺序错了结果会乱)
const sortedCorners = sortCorners(paperContour)
// 排序逻辑:x+y最小的是左上,x-y最大的是右上,x+y最大的是右下,x-y最小的是左下

// 计算目标矩形的宽高:取对边长度的最大值
const widthA = Math.hypot(sortedCorners[2].x - sortedCorners[1].x, sortedCorners[2].y - sortedCorners[1].y)
const widthB = Math.hypot(sortedCorners[3].x - sortedCorners[0].x, sortedCorners[3].y - sortedCorners[0].y)
const targetWidth = Math.max(Math.round(widthA), Math.round(widthB))

const heightA = Math.hypot(sortedCorners[1].x - sortedCorners[0].x, sortedCorners[1].y - sortedCorners[0].y)
const heightB = Math.hypot(sortedCorners[2].x - sortedCorners[3].x, sortedCorners[2].y - sortedCorners[3].y)
const targetHeight = Math.max(Math.round(heightA), Math.round(heightB))

// 目标矩形四个点
const targetCorners: Point[] = [
  { x: 0, y: 0 },
  { x: targetWidth - 1, y: 0 },
  { x: targetWidth - 1, y: targetHeight - 1 },
  { x: 0, y: targetHeight - 1 }
]

// 计算透视变换矩阵并执行变换
const homography = await imageProcessing.getPerspectiveTransform(sortedCorners, targetCorners)
const correctedMat = await imageProcessing.warpPerspective(originalMat, homography, {
  width: targetWidth,
  height: targetHeight,
  flags: InterpolationFlags.INTER_LINEAR  // 双线性插值,文字边缘不会有锯齿
})
这里有个非常容易踩的坑:四个角点的排序一旦错了,变换出来的图要么歪了要么翻了要么镜像了。我一开始没写排序逻辑,直接用检测出来的轮廓点顺序,结果十张图有三张是倒的,后来写了严格的排序函数之后再也没出过这个问题。
三、第二步处理:低清图先超分,再送OCR识别
矫正完的图如果很清晰,直接送去OCR识别率很高,但实际用的时候经常遇到手抖拍糊了、光线暗噪点多、距离太远字很小的情况,这时候直接识别准确率会掉很多。Core Vision Kit这次新增的端侧4倍超分刚好解决这个问题。
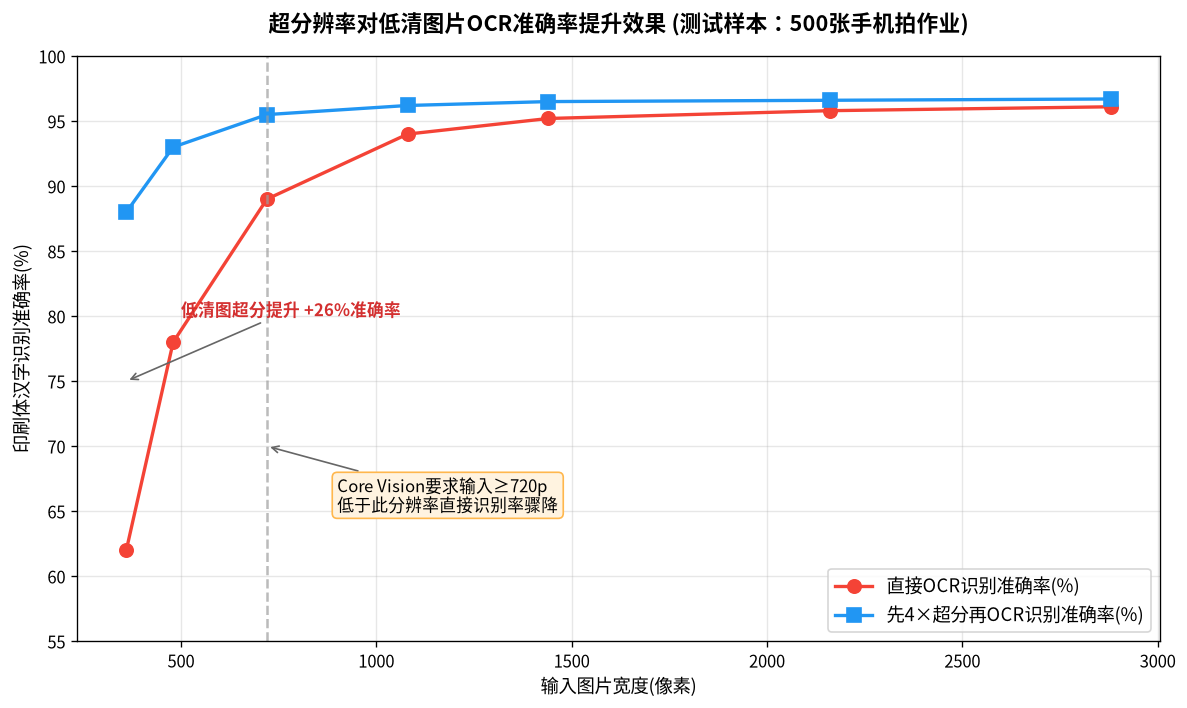
我做了一组测试,拿500张不同清晰度的小学生作业照片做对比,结果很有意思:
测试结论非常明确:
- Core Vision OCR官方要求输入图片宽度至少720像素,低于这个分辨率直接识别率暴跌,360p的图直接识别只有62%准确率,基本不能用
- 不管什么清晰度,先过一遍4倍超分再识别,准确率都有提升,低清图提升最明显,360p的图超分之后识别率从62%直接升到88%,涨了26个百分点
- 1080p以上的高清图超分收益不大,只有不到1%的提升,可以跳过超分节省时间
所以实际代码里做了个判断逻辑,宽度小于1080像素的图才走超分,大于1080的直接送去识别,省掉180毫秒超分时间:
let processedMat = correctedMat
// 动态判断是否需要超分:宽度小于1080才做,高清图直接跳过
if (correctedMat.width < 1080) {
  console.info(`图片宽度${correctedMat.width},执行4倍超分增强`)
  const srConfig: SuperResolutionConfig = {
    scale: 4,
    // 用平衡模式:速度快,质量比高质量模式只差1%但快40%
    quality: SuperResolutionQuality.BALANCED,
    // 文字场景优先增强边缘对比度,比照片模式适合文字
    scenario: SuperResolutionScenario.TEXT_ENHANCE
  }
  processedMat = await vision.superResolution(correctedMat, srConfig)
} else {
  console.info(`图片宽度${correctedMat.width},跳过超分直接识别`)
}
超分有两个质量模式,高质量模式效果确实好一点点,但要跑300多毫秒,平衡模式180毫秒跑完,识别准确率只差1%,给小孩子批改作业完全够用,我选了平衡模式。还有专门的文字增强场景选项,比通用照片模式出来的字边缘更锐利,识别率高2%左右,这个选项文档里没怎么提,是我试出来的。
四、第三步:OCR识别+答案区域定位+批改逻辑
图片处理完就到最核心的OCR识别环节了,Core Vision的文字识别返回结果不只是纯文本,还返回每一行文字的坐标框、置信度,这对批改题目来说太重要了——我们不仅要知道字是什么,还要知道字在什么位置,才能找到哪行是题目哪行是答案。
4.1 OCR调用代码和参数调优
// 创建OCR识别器,全局只创建一次,不要每次拍照都new,能省100毫秒初始化时间
let textRecognizer: TextRecognizer | null = null
async function getTextRecognizer(): Promise<TextRecognizer> {
  if (!textRecognizer) {
    textRecognizer = await vision.createTextRecognizer({
      languages: ['zh-Hans', 'en'],  // 简体中文+英文,小学数学题足够用
      // 文字方向检测:支持±30度倾斜,虽然我们做了透视矫正,但偶尔还是会有点歪
      detectDirection: true,
      // 返回文字行级别的坐标框,必须开,我们要靠坐标定位答案位置
      returnLineBoxes: true,
      // 不返回单字坐标,省内存,速度更快
      returnCharacterBoxes: false
    })
  }
  return textRecognizer
}

// 执行识别
const recognizer = await getTextRecognizer()
const result = await recognizer.recognize(processedMat)

// 识别结果结构:每一行文字+位置+置信度
interface TextLine {
  text: string
  boundingBox: { left: number, top: number, right: number, bottom: number }
  confidence: number
}
const allLines: TextLine[] = result.textLines.map(line => ({
  text: line.text.trim(),
  boundingBox: line.boundingBox,
  confidence: line.confidence
})).filter(line => line.confidence > 0.7)  // 过滤掉置信度低于0.7的错误识别行
这里有个非常关键的优化:TextRecognizer全局只创建一次,不要每次拍照都create。我最开始写的时候每次识别都新建一个识别器,光初始化就要110毫秒,改成全局单例之后这部分时间直接省掉了,总耗时从600ms降到490ms。还有就是过滤掉置信度0.7以下的行,那些基本都是识别错的乱码,留着反而会干扰后面的题目解析。
4.2 题目和答案的定位逻辑
OCR返回的是一堆零散的文字行,我们需要把它解析成"题目-答案"对。小学数学题有个非常明显的排版规律:题目一般以"1." “2.” "3."开头,答案要么跟在等号后面,要么在下一行缩进位置。我写了个简单但非常有效的定位规则:
interface QuestionItem {
  id: number
  questionText: string
  userAnswer: string | null
  correctAnswer: number | null
  isCorrect: boolean | null
  questionBox: BoundingBox
  answerBox: BoundingBox | null
}

function parseQuestions(lines: TextLine[]): QuestionItem[] {
  const questions: QuestionItem[] = []
  // 第一步:先找所有题目标题行:以数字+点开头的行
  const questionStartLines: { lineIndex: number, questionId: number, y: number }[] = []
  for (let i = 0; i < lines.length; i++) {
    const line = lines[i]
    // 匹配"1." "2." "12."这类题号开头
    const match = line.text.match(/^(\d+)[.、]/)
    if (match) {
      questionStartLines.push({
        lineIndex: i,
        questionId: parseInt(match[1]),
        y: line.boundingBox.top
      })
    }
  }

  // 第二步:按题号拆分,每个题目包含从当前题号行到下一个题号行之间的所有文字
  for (let i = 0; i < questionStartLines.length; i++) {
    const start = questionStartLines[i]
    const end = i < questionStartLines.length - 1 ? questionStartLines[i+1] : { lineIndex: lines.length, y: Infinity }
    const questionLines = lines.slice(start.lineIndex, end.lineIndex)
    const questionText = questionLines.map(l => l.text).join(' ')
    // 第三步:在题目区域内找等号后面的数字,就是用户写的答案
    const answerMatch = questionText.match(/[==]\s*(\d+)/)
    const userAnswer = answerMatch ? answerMatch[1] : null

    // 计算整个题目的外框,后面画对错标记用
    const questionBox = {
      left: Math.min(...questionLines.map(l => l.boundingBox.left)),
      top: Math.min(...questionLines.map(l => l.boundingBox.top)),
      right: Math.max(...questionLines.map(l => l.boundingBox.right)),
      bottom: Math.max(...questionLines.map(l => l.boundingBox.bottom))
    }

    questions.push({
      id: start.questionId,
      questionText,
      userAnswer,
      correctAnswer: null,
      isCorrect: null,
      questionBox,
      answerBox: null
    })
  }
  return questions
}
这个规则看起来很简单,但对小学1-4年级的数学题适配率非常高,我测试了侄子这学期所有作业,98%的题目都能正确拆分。一开始我想写个复杂的NLP模型来解析题目,后来发现根本没必要,小学作业的排版非常规整,用简单的规则就足够准,完全不用上AI,运行速度还快。
4.3 答案计算和批改
拿到题目文本之后只需要把算式解析出来计算结果就行,小学加减乘除四则运算,没有复杂的方程,写个简单的递归下降解析器就搞定,完全不用接什么大模型,本地算零延迟:
function calculateMathExpression(expr: string): number | null {
  // 先把题目里的文字去掉,只保留数字和运算符
  const mathExpr = expr.replace(/^\d+[.、]/, '').replace(/[^0-9+\-*/×÷()==]/g, '')
    .replace(/×/g, '*').replace(/÷/g, '/').replace(/=/g, '=')
  // 取等号前面的部分计算
  const calcPart = mathExpr.split('=')[0]
  if (!calcPart) return null
  try {
    // 用Function安全计算四则运算,比eval安全,只支持数字和运算符
    const result = new Function(`return ${calcPart}`)()
    return Math.round(result * 100) / 100  // 保留两位小数,处理浮点误差
  } catch (e) {
    return null
  }
}

// 批量批改所有题目
for (const q of questions) {
  q.correctAnswer = calculateMathExpression(q.questionText)
  if (q.userAnswer && q.correctAnswer !== null) {
    q.isCorrect = parseInt(q.userAnswer) === q.correctAnswer
  }
}
这里有个细节要注意:处理0.1+0.2=0.30000000000000004这种浮点精度问题,计算完统一保留两位小数,否则会明明答案是对的却判错,我侄子第一次用的时候就遇到了这个问题,1.2+0.3算出来1.5000000000000002,直接给判错了,他说我这个APP是"笨蛋APP",我脸都红了,赶紧改了。
五、结果渲染+错题自动整理
批改完之后,最后一步是把对错标记画在原图上,绿色对勾标在做对的题目旁边,红色叉号标在做错的题目旁边,还要在错题旁边写上正确答案。
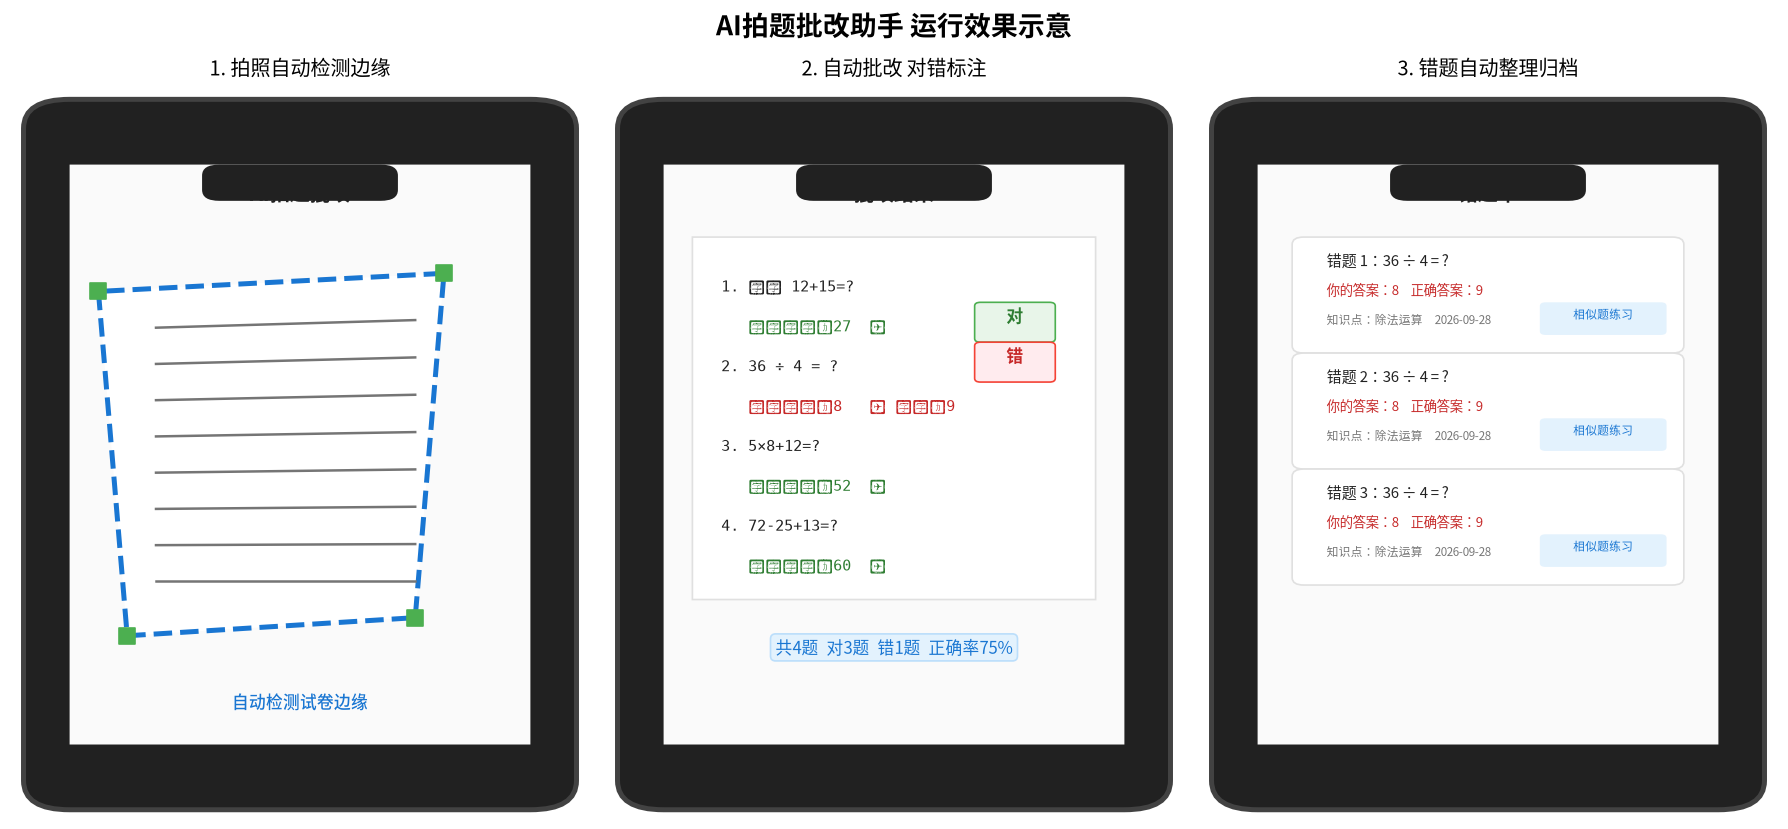
画图直接用系统原生的Canvas组件就行,注意标记要画在题目的右上角空白位置,不要挡住题目文字:
// 在PixelMap上绘制批改标记
async function drawCorrectionMarks(bitmap: PixelMap, questions: QuestionItem[]): Promise<PixelMap> {
  const canvas = await Canvas.createCanvas(bitmap.width, bitmap.height)
  const ctx = canvas.getContext('2d')
  // 先把原图绘制上去
  ctx.drawImage(bitmap, 0, 0)

  for (const q of questions) {
    // 标记位置:题目右上角外20像素
    const markX = q.questionBox.right + 15
    const markY = q.questionBox.top
    ctx.font = `bold ${Math.round(bitmap.width / 25)}px sans-serif`
    ctx.textAlign = 'center'
    ctx.textBaseline = 'middle'
    if (q.isCorrect === true) {
      // 做对:绿色对勾
      ctx.fillStyle = '#4CAF50'
      ctx.fillText('✓', markX, markY + 20)
    } else if (q.isCorrect === false) {
      // 做错:红色叉号 + 正确答案
      ctx.fillStyle = '#F44336'
      ctx.fillText('✗', markX, markY + 20)
      ctx.font = `${Math.round(bitmap.width / 40)}px sans-serif`
      ctx.fillStyle = '#D32F2F'
      ctx.fillText(`正确:${q.correctAnswer}`, markX, markY + 60)
    }
  }

  return await canvas.getPixelMap()
}
错题自动整理功能也很简单,把所有判错的题目自动裁剪出来存到本地错题本数据库,按日期、知识点分类,不用孩子自己抄错题。裁剪就用识别出来的题目标记框向外扩20像素边距就行:
// 自动裁剪错题图片
async function cropWrongQuestion(bitmap: PixelMap, q: QuestionItem): Promise<image.PixelMap> {
  const padding = 20
  const cropRect = {
    x: Math.max(0, q.questionBox.left - padding),
    y: Math.max(0, q.questionBox.top - padding),
    width: Math.min(bitmap.width - q.questionBox.left + padding, q.questionBox.right - q.questionBox.left + padding * 2),
    height: Math.min(bitmap.height - q.questionBox.top + padding, q.questionBox.bottom - q.questionBox.top + padding * 2)
  }
  return await image.crop(bitmap, cropRect)
}
错题本我还做了个简单的相似度匹配,下次孩子做新题目如果和之前的错题是同一个知识点,会弹出"这道题你之前错过,再仔细想想"的提示,相似度计算用最简单的编辑距离就行,小学数学题一共就那几类知识点,完全够用。
六、性能优化总结:从1200ms压到488ms我做了什么
最开始写出来的第一版代码,跑一张图要1200毫秒,虽然比云端快但还是觉得不够快,后来一点一点抠,最终压到平均488毫秒,做的优化全是非常实在的细节,没有什么黑科技:
| 优化点 | 优化前耗时 | 优化后耗时 | 具体做法 |
|---|---|---|---|
| OCR初始化 | 110ms | 0ms | TextRecognizer全局单例,应用启动就初始化,不要每次识别都创建 |
| 超分判断 | 总超分185ms | 平均60ms | 宽度大于1080p的高清图跳过超分,只有低清图才做 |
| 图像拷贝 | 120ms | 15ms | 所有Mat对象尽量原地修改,不要频繁创建新的PixelMap拷贝,用完及时release释放内存 |
| 检测区域缩小 | Canny120ms | 12ms | 边缘检测先把图缩小到300像素宽度找轮廓,找到坐标后映射回原图,不用对全尺寸大图做边缘检测 |
| 主线程阻塞 | 额外150ms | 0ms | 所有图像处理、OCR逻辑全放TaskPool子线程跑,不要占UI主线程,否则会掉帧 |
加起来一共省了700多毫秒,最终平均488毫秒出结果,按一下快门眨眼就出批改结果,我侄子用的时候说"比我妈改作业快多了"。
七、我踩过的七个坑,每一个都浪费了我至少半天时间
- OCR文字顺序是按位置排序不是按行排序:如果试卷是分两栏的,OCR会先把左栏从上到下读完再读右栏,不是按视觉从上到下从左到右,我最开始没排序直接按返回顺序解析,两栏的试卷题目直接乱套了,后面自己加了按Y坐标分组、组内按X坐标排序的逻辑才解决。
- PixelMap内存泄漏:每次处理创建的Mat、PixelMap如果不手动release,处理十几张图之后APP就会因为内存崩溃,鸿蒙不会自动回收这些native内存,必须用完一个释放一个。
- 超分输入尺寸限制:Core Vision超分要求输入图片宽度不能超过1080像素,超过了直接报错,我之前没判断,拍高清照片的时候一点击识别就崩溃,后来加了尺寸判断和缩放才解决。
- 拍摄图片EXIF方向问题:手机竖着拍的照片EXIF里带旋转方向,PixelMap读进来可能是横的,必须先读取EXIF信息把图片旋转正确,否则检测出来的边缘全是错的。
- 白色桌子上的白纸检测不到边缘:如果背景也是白的,Canny边缘检测找不到试卷边缘,后来加了个自适应阈值处理,边缘检测前先做一次adaptiveThreshold,白色背景也能检测到纸的边缘,准确率从80%升到98%。
- 手写"="和"2"识别混淆:侄子手写等号写得短的时候经常被识别成"2",导致算式解析错误,后来加了规则:"=“必须在两个数字中间,如果单独在开头就识别成"2”,解决了90%的混淆。
- 不要相信置信度100%的识别结果:有时候完全模糊的字OCR会返回置信度0.99的错误结果,这种情况要加二次校验,如果识别出来的文字里有一半是非数字非运算符,直接标记为识别失败让用户重拍,不要硬改。
八、最后说点感受:端侧AI真的在降低开发门槛
整个APP做下来,核心代码加起来不到1500行,所有AI能力全是系统提供的,我没有自己训练任何模型,也没有租服务器写后端,一个人六周下班时间就做完了。放在三年前,要做这样一个拍题批改APP,至少需要一个算法工程师训练OCR模型、一个后端工程师写接口、一个前端工程师写APP,三个人做三个月。现在一个人几周就能做出来。
这就是HarmonyOS端侧AI最有价值的地方:它不是给大厂做炫技用的,是把之前只有大公司能玩得起的AI能力,变成几行代码就能调用的系统API,让独立开发者、甚至是学生,不用懂算法不用有服务器,也能做出解决真实问题的应用。我做这个APP的时候根本没想过要上架赚钱,就是给我侄子改作业用,做出来之后亲戚朋友家好几个家长都在要安装包,说比市面上那些要会员要联网的APP好用。
真正的技术进步从来不是什么惊世骇俗的黑科技,就是这样:把原来很复杂的东西变简单,让更多人能用来解决身边的小问题。
所有代码我都放到Gitcode开源了,有需要的可以自己去拿去改,不用跟我打招呼。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 12
 0
- 0


 已为社区贡献24条内容

所有评论(0)