
HarmonyOS 7 + OCR Kit + Vision Kit 技术干货:票据文档识别、文本框定位与结构化提取闭环【鸿蒙心迹】
这篇不想只讲“识别一张图片里的文字”。真正落到工程里,OCR 更像一条链:图片从哪里来,文本块怎么定位,倾斜内容怎么纠正,识别结果怎么结构化,最后又怎么让业务真正可用。
一、很多 OCR Demo 能跑,但离业务闭环还差很远
第一次接 OCR 能力时,最容易满足于一个简单结果:
- 选择图片;
- 调一下识别接口;
- 把整段文字吐出来;
- 页面上能看到结果。
如果只是学习接口,这样当然够了。
但只要你把需求往真实业务里放一步,问题马上就多起来了:
- 识别的到底是票据、发票、证件还是文档?
- 原图里哪些是正文,哪些是干扰信息?
- 文本块坐标有没有拿到?
- 倾斜、旋转、小字号文本是否可用?
- 最终业务要的是“一整段文字”,还是“金额、时间、编号、商户名”这类结构化字段?
- 识别失败时,用户是重新拍照,还是手动修正?
我后来越来越觉得,OCR 真正有价值的地方,不是“把字认出来”,而是把原始图片转成业务可消费的数据结果。
所以这次我没有把重点放在单纯的“识别文本”,而是拆成了四段:
- 图片输入:相册、拍照或已有文档;
- 文本块定位:先知道识别到了哪些区域;
- 结果结构化:把原始识别结果转成业务字段;
- 结果验证与导出:让用户能看清、复制、导出和复核。
二、页面设计先别花,先让链路跑顺
我做这种能力型页面时,一般不会一上来就做得很复杂。
因为 OCR 这种需求的难点,不在于卡片圆角或者配色,而在于链路是不是完整。所以首页我会先只保留最必要的几个区域:
- 原始图片预览;
- 识别入口;
- 识别状态;
- 结构化结果展示;
- 导出或复制操作。
先让链路闭合,后面再谈体验优化。
真正跑起来以后,页面最好能同时回答两个问题:
- 系统识别到了什么?
- 系统是从哪里识别出来的?
这也是为什么我后面特意保留了“原图识别区域”和“结构化字段结果”两个视角。因为很多 OCR 页面只展示最终文本,却不告诉用户这些内容是从哪块图上取出来的,一旦结果不对,用户根本不知道该怎么判断。
三、第一步不是显示结果,而是把 OCR 服务初始化稳定
很多人把 OCR 逻辑全塞进按钮点击里,我不太建议这样写。
因为 OCR 服务初始化、模型状态检查、权限和异常处理,最好在页面进入时就先准备好。这样到了真正识别那一刻,链路才不会太仓促。
我这次的处理方式,是在页面出现时先初始化 OCR 服务:
import { OcrService } from '../service/OcrService'
import { promptAction } from '@kit.ArkUI'

aboutToAppear() {
  OcrService.getInstance().init().then(() => {
    console.info('OCR 服务初始化完成')
  }).catch((err: Error) => {
    console.error('OCR 服务初始化失败: ' + err.message)
    promptAction.showToast({ message: 'OCR服务初始化失败' })
  })
}
这段代码不复杂,但它有两个好处:
- 识别之前,先把能力准备好;
- 初始化失败时,问题暴露得足够早。
这种处理特别重要。因为 OCR 这类能力一旦失败,读者看到的通常只是“没结果”,但真正的问题可能出在模型没加载、服务没准备好、资源初始化异常等更前面的阶段。
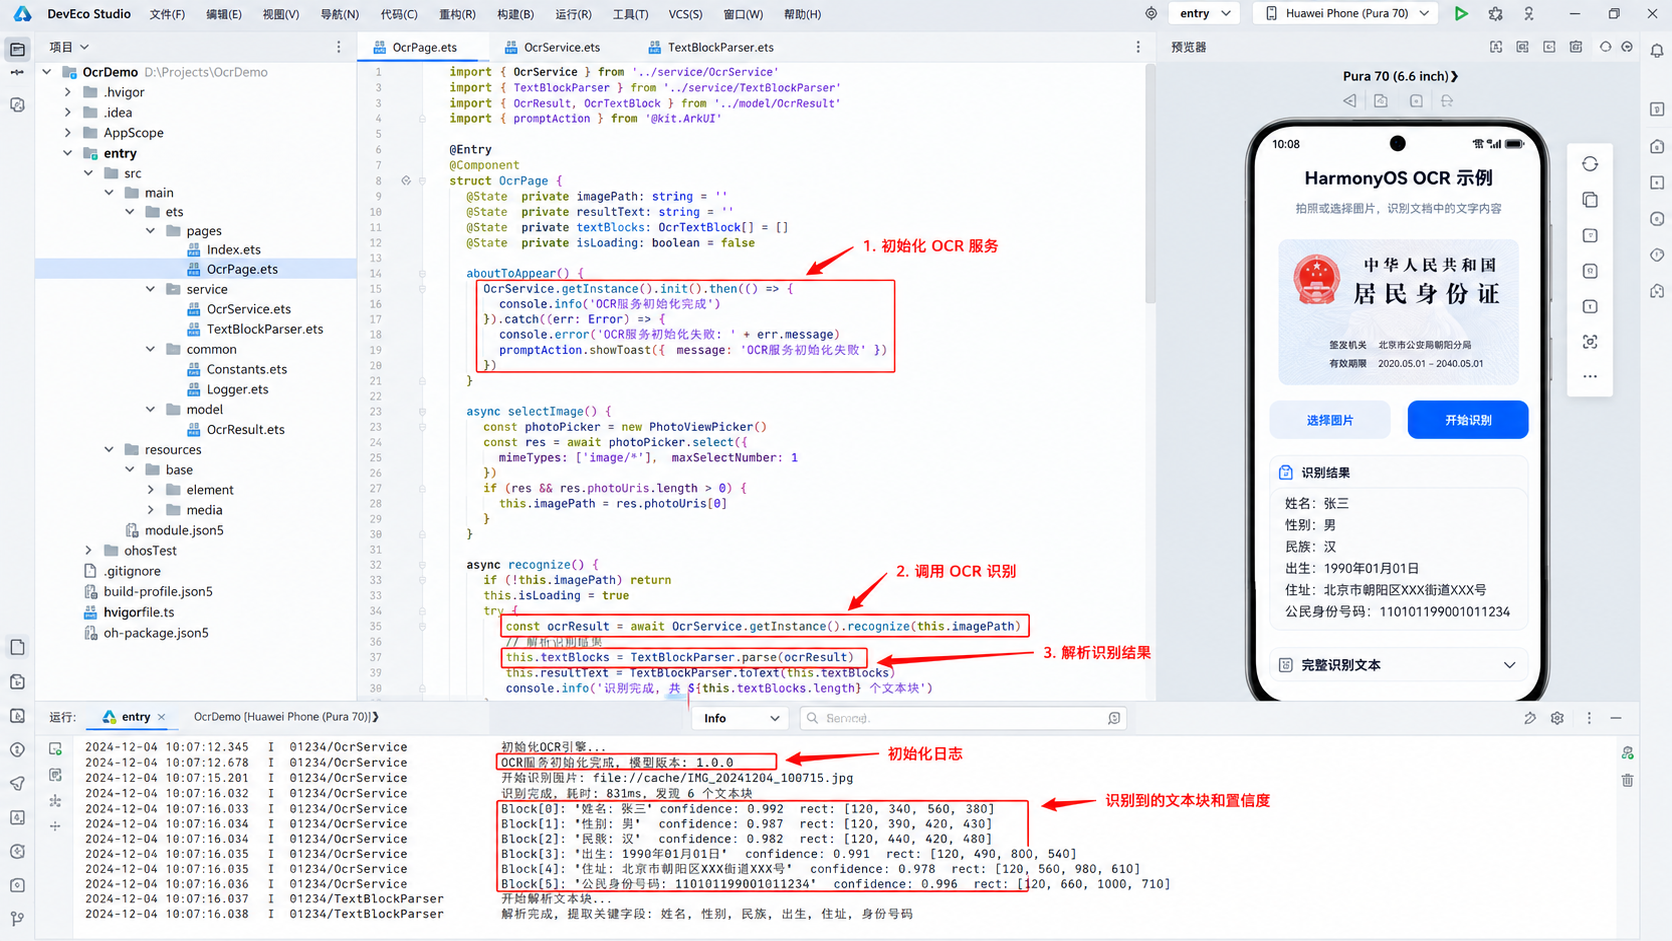
这张 DevEco 图里,我保留了几处红色标注,目的很明确:
- 初始化 OCR 服务;
- 发起识别调用;
- 解析识别结果;
- 查看日志中的文本块与置信度。
这种标法非常适合技术文章,因为它不是单纯展示界面,而是在帮读者快速建立“代码 → 模拟器 → 日志”之间的对应关系。
四、真正的核心不是文本字符串,而是文本块
OCR 如果只返回一整段文字,当然也有价值,但工程价值有限。
因为只要业务稍微复杂一点,你就会发现真正要用的是:
- 文本内容;
- 文本块位置;
- 文本置信度;
- 文本之间的结构关系。
所以我在识别完成后,没有直接把结果拼成一整段字符串,而是先保留文本块数组:
async recognize() {
  if (!this.imagePath) {
    promptAction.showToast({ message: '请先选择图片' })
    return
  }
  this.isLoading = true
  try {
    const ocrResult = await OcrService.getInstance().recognize(this.imagePath)
    this.textBlocks = TextBlockParser.parse(ocrResult)
    this.resultText = TextBlockParser.toText(this.textBlocks)
    console.info(`识别完成,共 ${this.textBlocks.length} 个文本块`)
  } finally {
    this.isLoading = false
  }
}
这一步很关键。
因为一旦你有了 textBlocks,后面的很多事情才有抓手:
- 在图片上画识别框;
- 判断哪些字段更像金额、日期、编号;
- 对低置信度文本做单独标记;
- 支持点击某块文本进行修正。
也就是说,OCR 的中间态决定了这个能力后面能不能继续长。
五、结构化提取,才是业务真正想要的结果
对于票据、发票、身份证这类场景,业务方通常不想要“一大段文本”,而是直接要字段。
比如一张消费票据,常见目标字段至少包括:
- 商户名称;
- 日期时间;
- 金额;
- 票据编号;
- 支付方式;
- 交易流水号。
所以我后来加了一层简单的结构化解析,把识别结果按规则映射成字段。
export class TextBlockParser {
  static extractReceiptFields(blocks: OcrTextBlock[]): ReceiptFields {
    return {
      merchantName: this.findByPattern(blocks, /咖啡|公司|商户/),
      dateTime: this.findByPattern(blocks, /\d{4}-\d{2}-\d{2}/),
      amount: this.findByPattern(blocks, /¥?\d+\.\d{2}/),
      ticketNo: this.findByPattern(blocks, /\d{12,}/),
      payMethod: this.findByPattern(blocks, /微信支付|支付宝|银行卡/)
    }
  }
}
这段代码当然还不是完美的通用方案,但已经足够说明一个关键思路:
OCR 的价值,不在“全部识别出来”,而在“把有用的部分提炼出来”。
真正的业务页面,也更适合先展示关键字段,再允许用户查看完整原始文本。
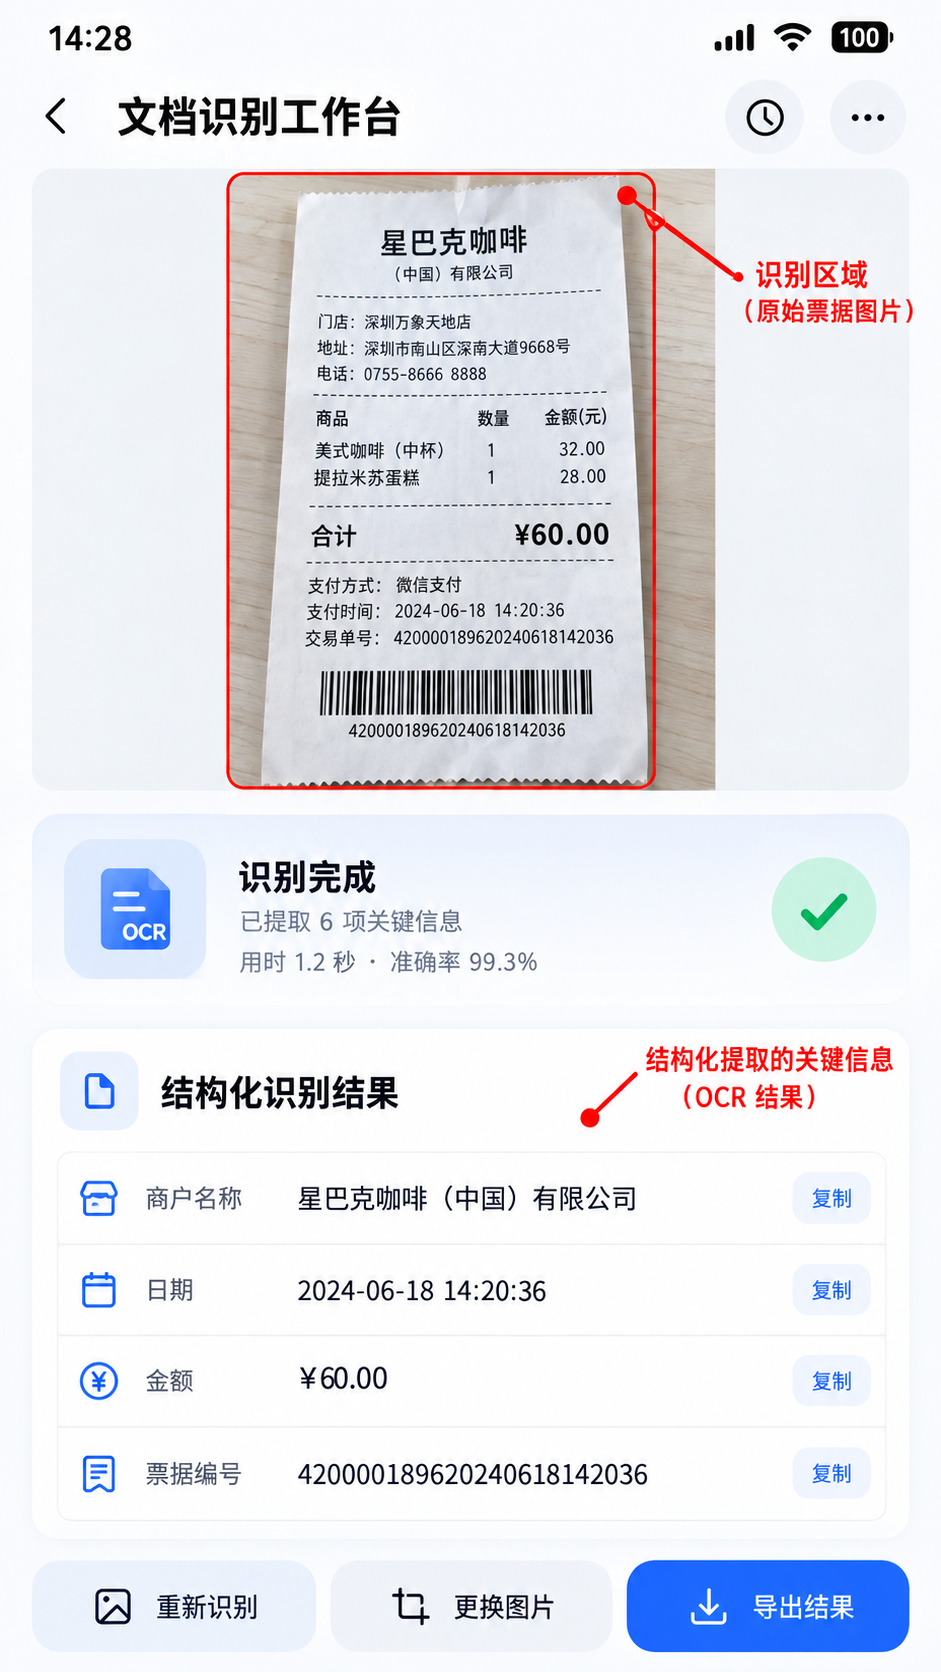
这张运行图就是这个思路的直接呈现。
我特意用红色箭头和圆角框去标了两个重点:
- 上面是原始票据图片的识别区域;
- 下面是结构化提取出来的关键信息。
这样读者一眼就能看明白:OCR 不只是“认了字”,而是把图片和字段真正连起来了。
六、文本框定位是验证质量最直接的方法
很多 OCR 页面有一个常见问题:结果看着像对了,但你没法确认它是怎么对的。
这时候最有用的功能,不是再多放几个按钮,而是把文本框定位详情做出来。
为什么?
因为只要你把文本块、位置和置信度可视化,很多问题立刻就清楚了:
- 到底识别了多少块内容;
- 哪些块识别得更稳定;
- 倾斜、旋转的文字有没有被纠正;
- 金额、编号这种关键字段是不是取对了位置。

这张图里我刻意保留了几类解释性标注:
- 文本块定位:告诉你识别框在哪;
- 倾斜 / 旋转文本矫正:说明系统不是只能处理正向文本;
- 文本内容准确识别:结合置信度,让结果有可信度判断。
从文章表达上看,这种图也特别适合放正文里。因为它不是单纯“好看”,而是在替你完成技术解释。
七、日志和异常处理,决定这个能力能不能维护
真实项目里,OCR 不是一次成功就结束。
你会遇到很多边缘情况:
- 图片模糊;
- 光照反差太大;
- 文本区域过小;
- 用户选了不适合识别的图片;
- 票据样式和规则不一致;
- 某些文本块置信度太低。
所以除了结果页面,我还会特别强调日志和降级策略:
- 初始化日志;
- 识别耗时;
- 文本块数量;
- 平均置信度;
- 关键字段是否提取成功;
- 失败时允许用户重新识别或更换图片。
如果这些信息都没有,后面你几乎没法判断问题究竟在服务层、解析层,还是原图本身。
八、我做完以后最认可的一个判断
这次做下来,我最大的感受是:OCR 最难的,从来不是 API 调用,而是结果组织。
很多文章停留在“识别一张图上的文字”,这当然是第一步,但技术干货如果只写到这里,其实偏浅。
真正更值得讲的,是下面这条链:
- 图片输入;
- 文本块识别;
- 结构化提取;
- 结果展示;
- 置信度验证;
- 异常回退。
这条链做顺了,后面无论是:
- 发票识别;
- 名片识别;
- 身份证识别;
- 快递面单识别;
- 表格与表单解析;
都能继续往上长。
九、本文小记
如果让我用一句话总结这篇文章,我会写成:
OCR 不是“识别文字”这么简单,它是一条把原始图像转换成结构化业务结果的工程链。
对我来说,这次最值得保留的不是某个接口名字,而是这几个工程判断:
- 先初始化服务,再发起识别;
- 识别结果优先保留文本块,而不是直接拼字符串;
- 真正的业务价值来自结构化字段;
- 文本框定位和置信度,是质量判断的重要依据;
- 日志和重试机制,决定这条链能不能维护。
如果你接下来也要做 HarmonyOS 的 OCR 场景,我会建议你别只停在“把字认出来”,而是尽量把原图、定位、结果、置信度和业务字段一起串起来。做到这一步,文章会更有技术深度,项目也会更有真实价值。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)