
HarmonyOS 7 + Camera Kit + Scan Kit 项目复盘:仓储扫码盘点的连续识别、重复码去重与批次入库闭环【鸿蒙心迹】
这次项目不是做一个“扫到二维码弹结果”的演示,而是把仓储盘点里真正麻烦的几个环节走了一遍:相机预览要稳定、条码要连续识别、同一个箱子不能一秒扫三次、识别结果要匹配商品主数据,最后还得生成一个可校验、可提交的盘点批次。
一、真正的仓库现场,扫码和 Demo 完全不是一回事
这个项目最开始来自一个非常具体的问题:仓库盘点时,工作人员拿着手机沿货架移动,希望连续扫描商品条码,不想每扫一个都停下来点一次“确认”。
听起来就是一个连续扫码功能。
第一版做出来以后,在办公室桌面上跑得很好。把几个纸盒放在桌上,摄像头对准条码,识别速度也够快。
到了真实一点的测试环境,问题一下全出来了:
- 手机移动时画面抖动,一个条码连续命中好几次;
- 两个相邻箱子的条码同时进入画面,结果会来回跳;
- 光线变暗以后,识别明显变慢;
- 扫到数据库里不存在的条码,流程不知道该继续还是停;
- 同一个商品分布在两个库位,不能简单按条码全局去重;
- 扫了 100 多件以后,用户还要知道哪些已经入批次、哪些需要人工确认。
所以这个项目最后已经不是“调用一次扫码能力”,而是一个完整的识别结果治理问题。
我最后把链路拆成六步:
- Camera 预览;
- Scan 连续识别;
- 重复码过滤;
- 商品主数据匹配;
- 批次内合并;
- 提交前校验与入库。
二、第一步不是识别,而是先让 Camera 预览稳定
连续扫码和拍照不一样。
拍照可以让用户停下来对准、按快门,识别失败再重拍。连续盘点则要求用户边走边扫,Camera 预览必须一直稳定工作。
所以第一版我先把相机职责收得很窄:
- Camera Kit 只负责预览和帧来源;
- Scan 适配层只关心识别结果;
- 页面不直接处理帧级细节;
- 批次逻辑放到单独的
InventoryService。
这样做最大的好处是,相机、识别、业务批次三层不会绑死。
我们最后的目录大致是这种结构:
pages/
  ScanPage.ets
service/
  CameraService.ets
  ScanService.ets
  InventoryService.ets
model/
  ScanResult.ets
  InventoryItem.ets
utils/
  DuplicateFilter.ets
看起来只是多拆了几个文件,但项目后面能不断加逻辑而没有失控,基本就靠这个分层。
三、连续识别最大的坑:一个条码会在 1 秒内出现很多次
真正开始连续识别以后,第一个问题就是重复。
手机对着一箱商品不动,识别引擎可能连续回调同一个条码。如果每次回调都记一次库存,一箱 24 瓶水可能几秒钟就变成 120 瓶。
所以我们加了一个非常简单、但非常关键的时间窗口过滤。
class DuplicateFilter {
  private latest = new Map<string, number>()
  private windowMs: number = 2000

  accept(barcode: string): boolean {
    const now = Date.now()
    const last = this.latest.get(barcode) ?? 0

    if (now - last < this.windowMs) {
      return false
    }

    this.latest.set(barcode, now)
    return true
  }
}
这段代码第一眼看起来很普通,但项目真正跑起来以后,我们又补了两个边界。
1. 去重不能跨库位无限生效
同一个 SKU 可能在 A 区和 C 区都有货。如果只按条码全局去重,用户走到另一个库位重新扫描,系统可能错误地把它忽略。
所以最终的 key 不是单纯 barcode,而是:
warehouseId + locationId + barcode
2. 重复识别不一定要“丢掉”
有些商品是整箱盘点。同一个条码再次命中时,业务希望增加数量,而不是忽略。
所以后来我们把去重策略做成可配置:
IGNORE:时间窗口内忽略;MERGE_COUNT:时间窗口内合并数量;KEEP:保留每次识别。
这一步做完,扫码能力才真正从“识别工具”变成了“业务组件”。
四、扫描结果不能直接进列表,中间必须有商品匹配层
第二个大坑是未知条码。
如果扫码结果一回来,就直接往盘点列表里塞,会遇到很多脏数据:
- 条码不存在;
- 商品已经下架;
- 条码绑定了多个包装规格;
- 当前库位不允许放这个商品。
所以识别结果回来后,我没有直接改页面,而是先经过 InventoryService:
async onBarcodeRecognized(barcode: string) {
  if (!this.duplicateFilter.accept(barcode)) {
    this.logger.info(`duplicate ignored: ${barcode}`)
    return
  }

  const sku = await this.productRepository.findByBarcode(barcode)

  if (!sku) {
    this.pendingConfirm.push({
      barcode,
      reason: 'SKU_NOT_FOUND'
    })
    return
  }

  this.mergeIntoCurrentBatch(sku)
}
这个中间层非常重要。
它让扫码结果分成两条路径:
- 正常商品直接进入批次;
- 异常结果进入人工确认区。
用户不需要因为一条异常条码停掉整个连续扫描流程。
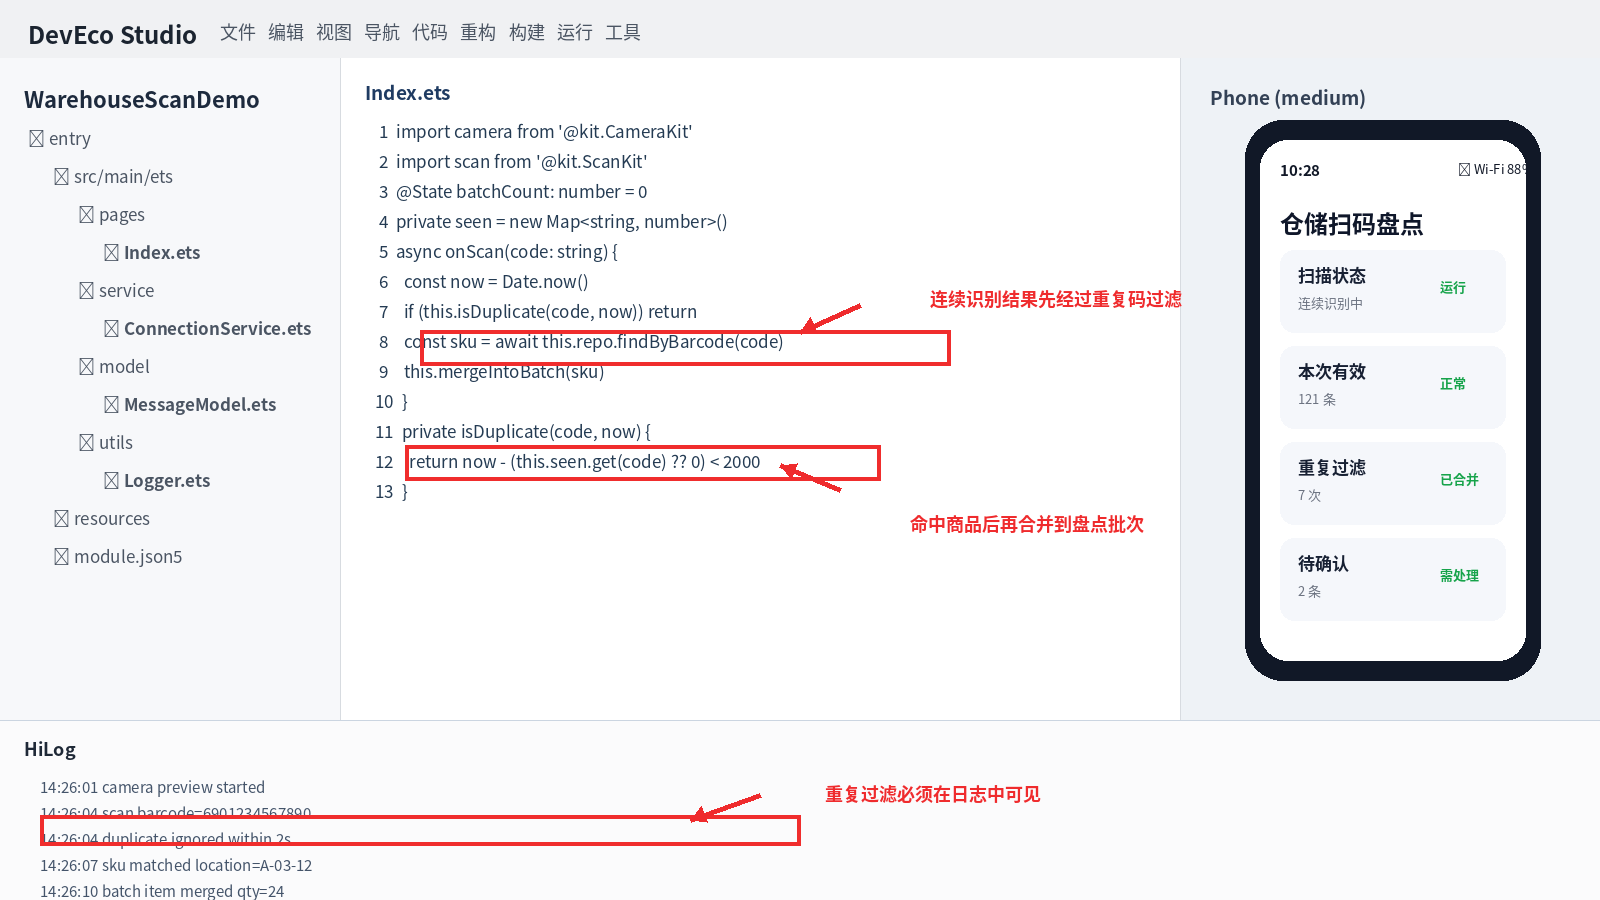
上面这张 DevEco 图里,我把“重复过滤”和“批次合并”两个关键位置标了出来。底部日志也会明确记录 duplicate ignored,这样测试人员看到数量不增加时,不会误以为识别能力失效。
五、页面上必须把“识别次数”和“有效数量”分开
第一版 UI 只显示了一个“已扫描 128 件”。
结果测试同事问我:这 128 到底是识别回调次数,还是最终有效商品数?
这个问题一下提醒了我。
做连续识别时,页面必须把至少三个数字分开:
- 识别次数:相机/识别层一共命中多少次;
- 有效数量:过滤和主数据匹配后进入批次多少条;
- 重复次数:被去重策略拦掉多少次。
这三个数字对最终盘点结果非常重要。
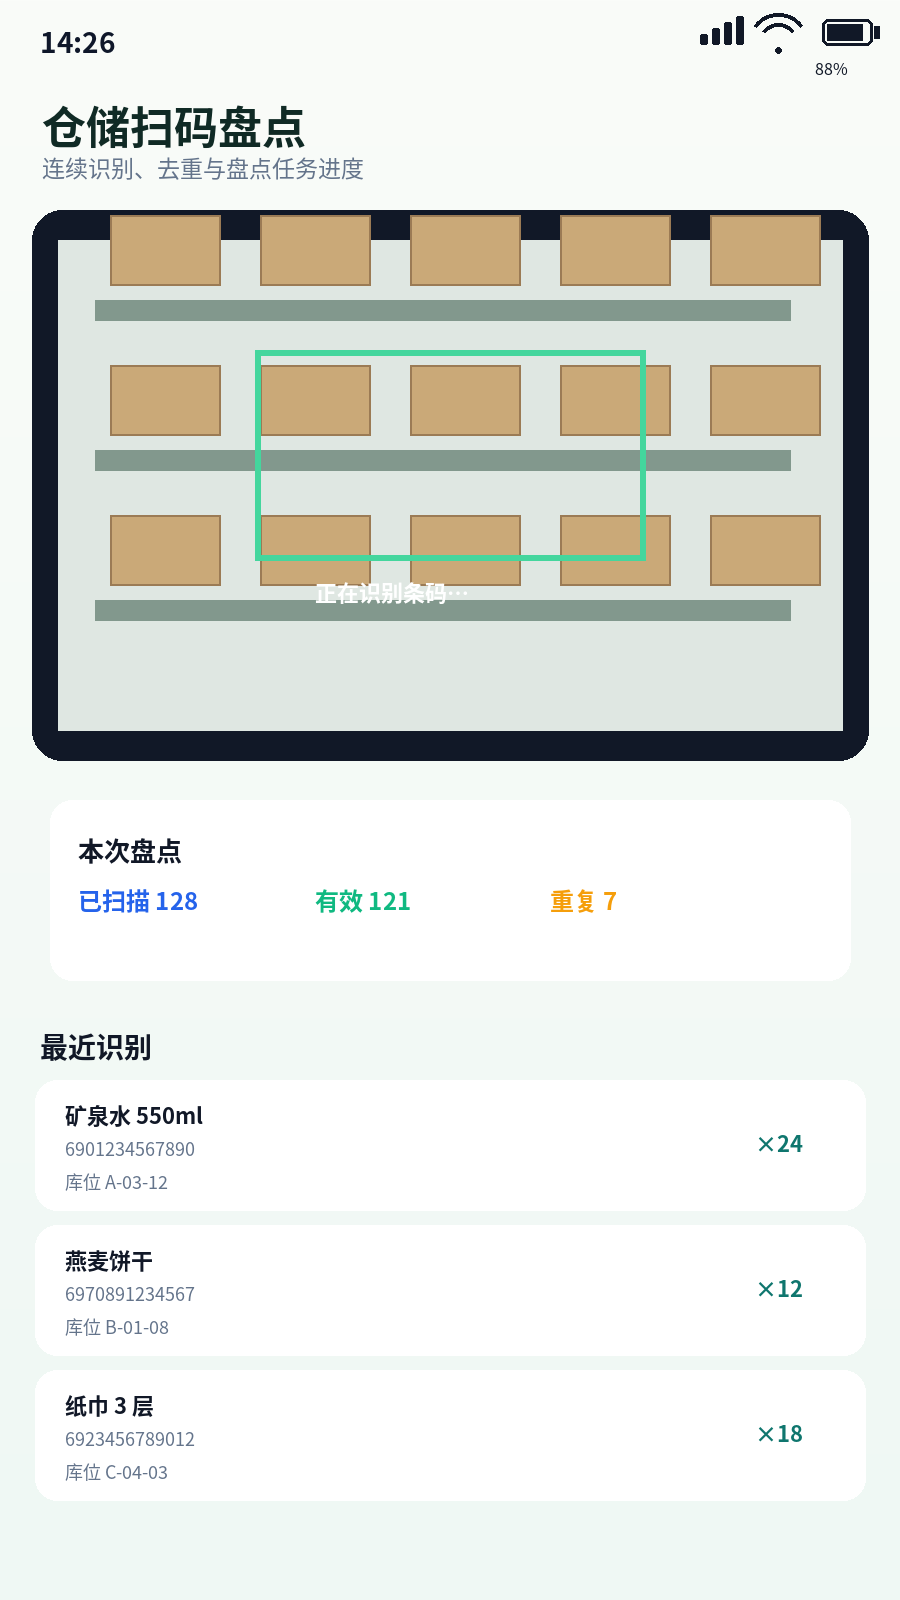
运行页里我最后直接把它们并列展示:128 次识别、121 条有效、7 次重复。下面再列最近识别记录和库位信息。
这样现场人员一眼就能知道系统正在做什么,而不是看到一个不断增长的总数。
六、扫码速度快了以后,批次提交反而成了新的风险点
当连续识别效率提高以后,一个盘点批次很快就会积累上百条明细。
这时候如果用户直接点“入库”,风险会比慢慢手填还大。
所以我们在提交之前又加了一层批次校验:
- 商品主数据是否全部匹配;
- 是否存在待人工确认条目;
- 是否有库位冲突;
- 批次内重复是否已经按规则合并;
- 是否还有未完成的异步查询。
我把提交条件收成了一个非常明确的判断:
canCommit(batch: InventoryBatch): boolean {
  return batch.pendingConfirm.length === 0
    && batch.locationConflicts.length === 0
    && batch.loadingCount === 0
    && batch.items.length > 0
}
真正项目里,条件会比这个更多,但思路差不多:提交按钮不能只看“有没有数据”,而要看这个批次是不是已经达到可提交状态。
七、我最后把“为什么不能提交”也做进了页面
这个调整很重要。
早期版本里,如果批次有异常,提交按钮只是灰掉。用户不知道为什么灰,也不知道去哪儿改。
后来我们改成直接展示提交前校验结果:
- 商品主数据匹配 119 / 121;
- 待人工确认 2 条;
- 库位冲突 1 条;
- 批次内重复已合并 7 次。
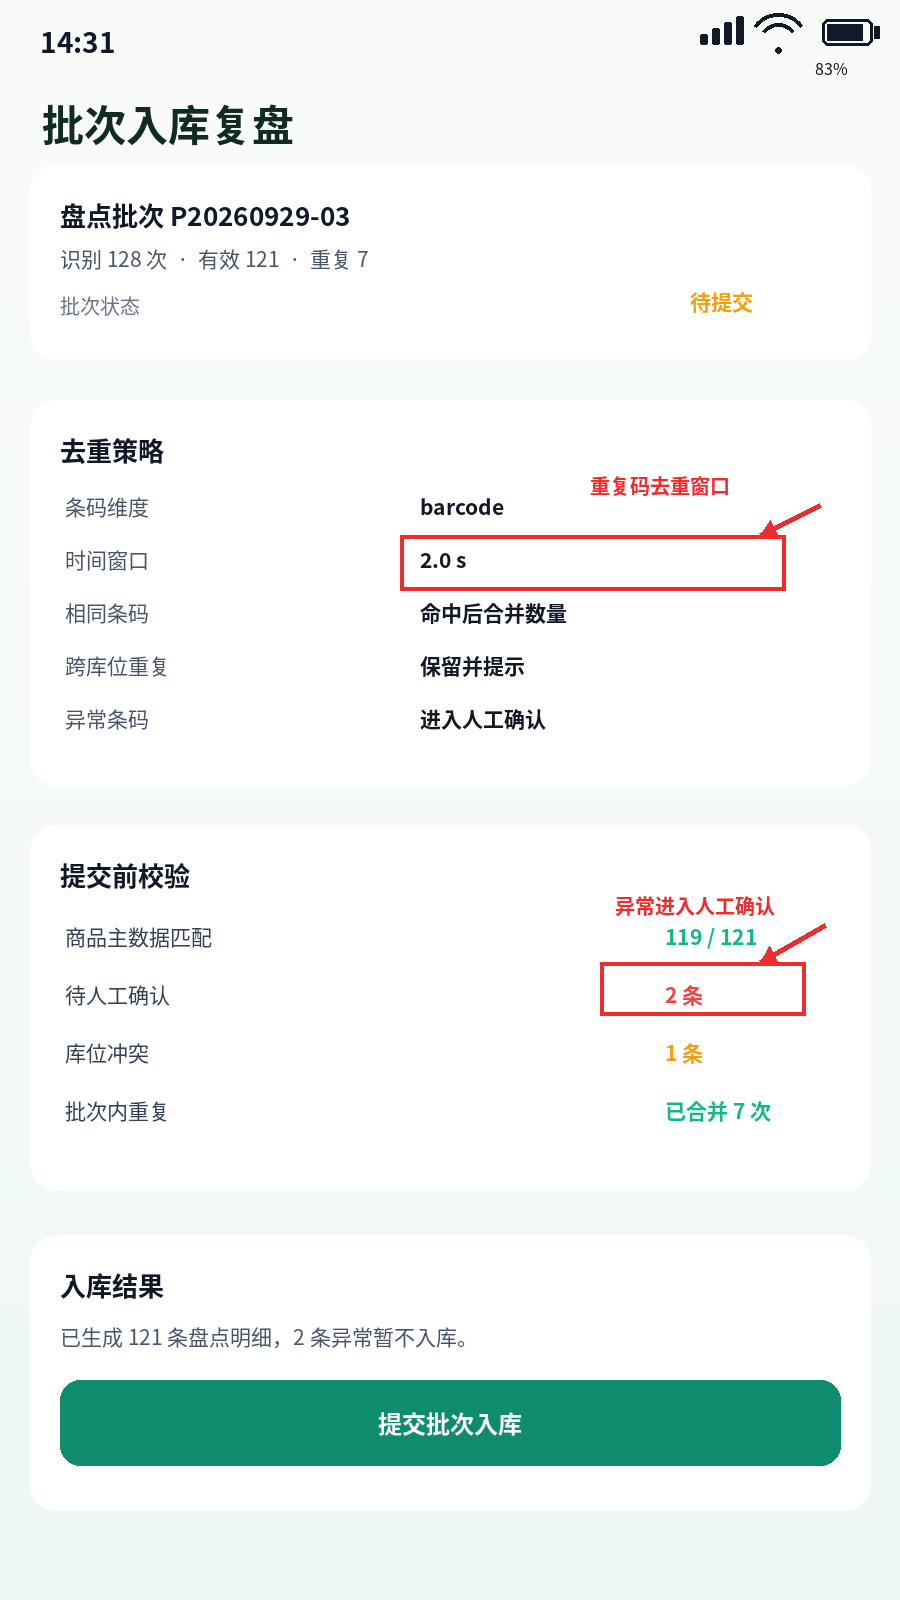
图里我用红色圈和箭头标出了两个最容易忽略的地方:2 秒重复码窗口和异常条码进入人工确认。
这两个点恰好也是这次项目从 Demo 走向可用工具的分界线。
如果没有前者,数量会因为连续识别失真;如果没有后者,一条未知商品就可能让整个现场流程停下来。
八、现场测试之后,我们又改了三个细节
真正去模拟仓库走动以后,还有三个问题是在办公室里没暴露出来的。
1. 识别反馈必须足够轻
每扫一个商品都弹 Toast,会严重干扰连续操作。后来改成轻提示音 + 页面顶部短状态变化,只有异常才做明显提示。
2. 相机画面里要有明确识别区域
如果整个画面都参与识别,相邻货架上的条码很容易一起进来。我们最后给用户一个相对明确的取景区域,引导把目标条码放进中心框。
3. 重复不能只靠用户感觉
现场人员很难记住刚才有没有扫过某个商品。所以每次命中重复时,我们会显示一个短提示:
已识别,数量已合并。
这样用户不会反复对同一商品继续扫码。
九、这次项目真正复盘下来,核心不是 Camera,也不是 Scan
做完以后我反而觉得,这个项目最值得复用的并不是具体识别 API。
真正有价值的是中间那层治理链路:
Camera 帧 → 条码识别 → 时间窗口去重 → 商品匹配 → 库位校验 → 批次合并 → 异常确认 → 提交入库。
如果只看前两步,它还是一个扫码 Demo。
把后面几步做完整以后,它才变成一个真正能放到业务现场里的工具。
这次项目也让我重新确认了一个很朴素的工程判断:能力接通和项目落地之间,往往还隔着一整层业务状态治理。
Camera Kit 和 Scan Kit 负责的是“看见”和“识别”,但真正决定项目能不能用的,是我们怎么处理重复、异常、批次和最终一致性。
这也是这篇复盘最想留下来的东西。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)