
从开发者工单到系统级落地|欣喜见证鸿蒙7.0,将我提出的ASR声源分离方案实现
近期华为Pura X View于9月7日正式发布,整机搭载HarmonyOS 7.0。不少开发者与网友放出实测视频,展示了一项亮眼的语音能力:ASR识别过程中,系统可以精准区分真人发声与设备TTS合成播放音,在嘈杂环境下完成目标说话人定向拾取,过滤设备播放音与环境干扰噪声。见:https://channels.weixin.qq.com/finder-preview/pages/sph?id=AZok4NyxlR
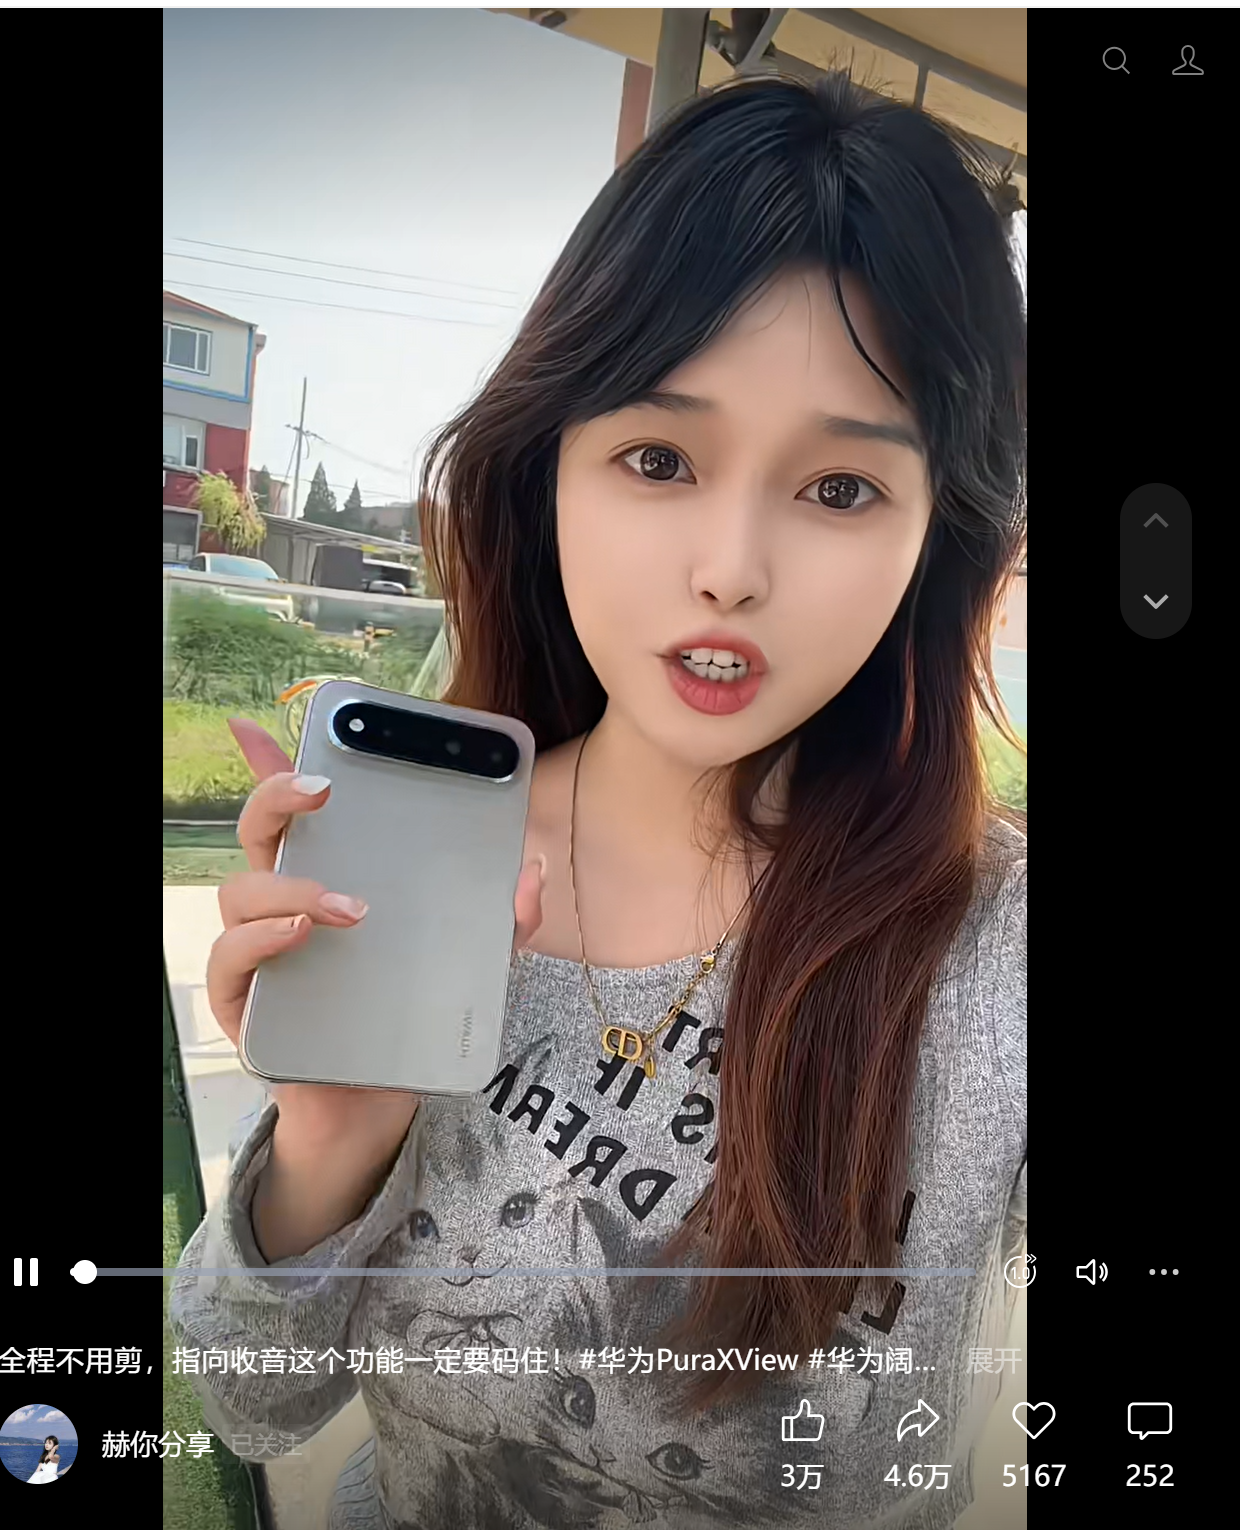
看到这一系统特性正式对外亮相,内心颇多感慨。
去年年末至今年年初,我在基于HarmonyOS 6.0开展语音方向技术研发与方案验证时,就定位到现有ASR链路的一处关键短板:鸿蒙6的语音识别链路,麦克风采集信号未做声源隔离,环境噪声、设备本地TTS输出音频会全部混入识别流,直接导致识别结果被大量无效音频干扰,很多上层业务很难做到商用级交付。
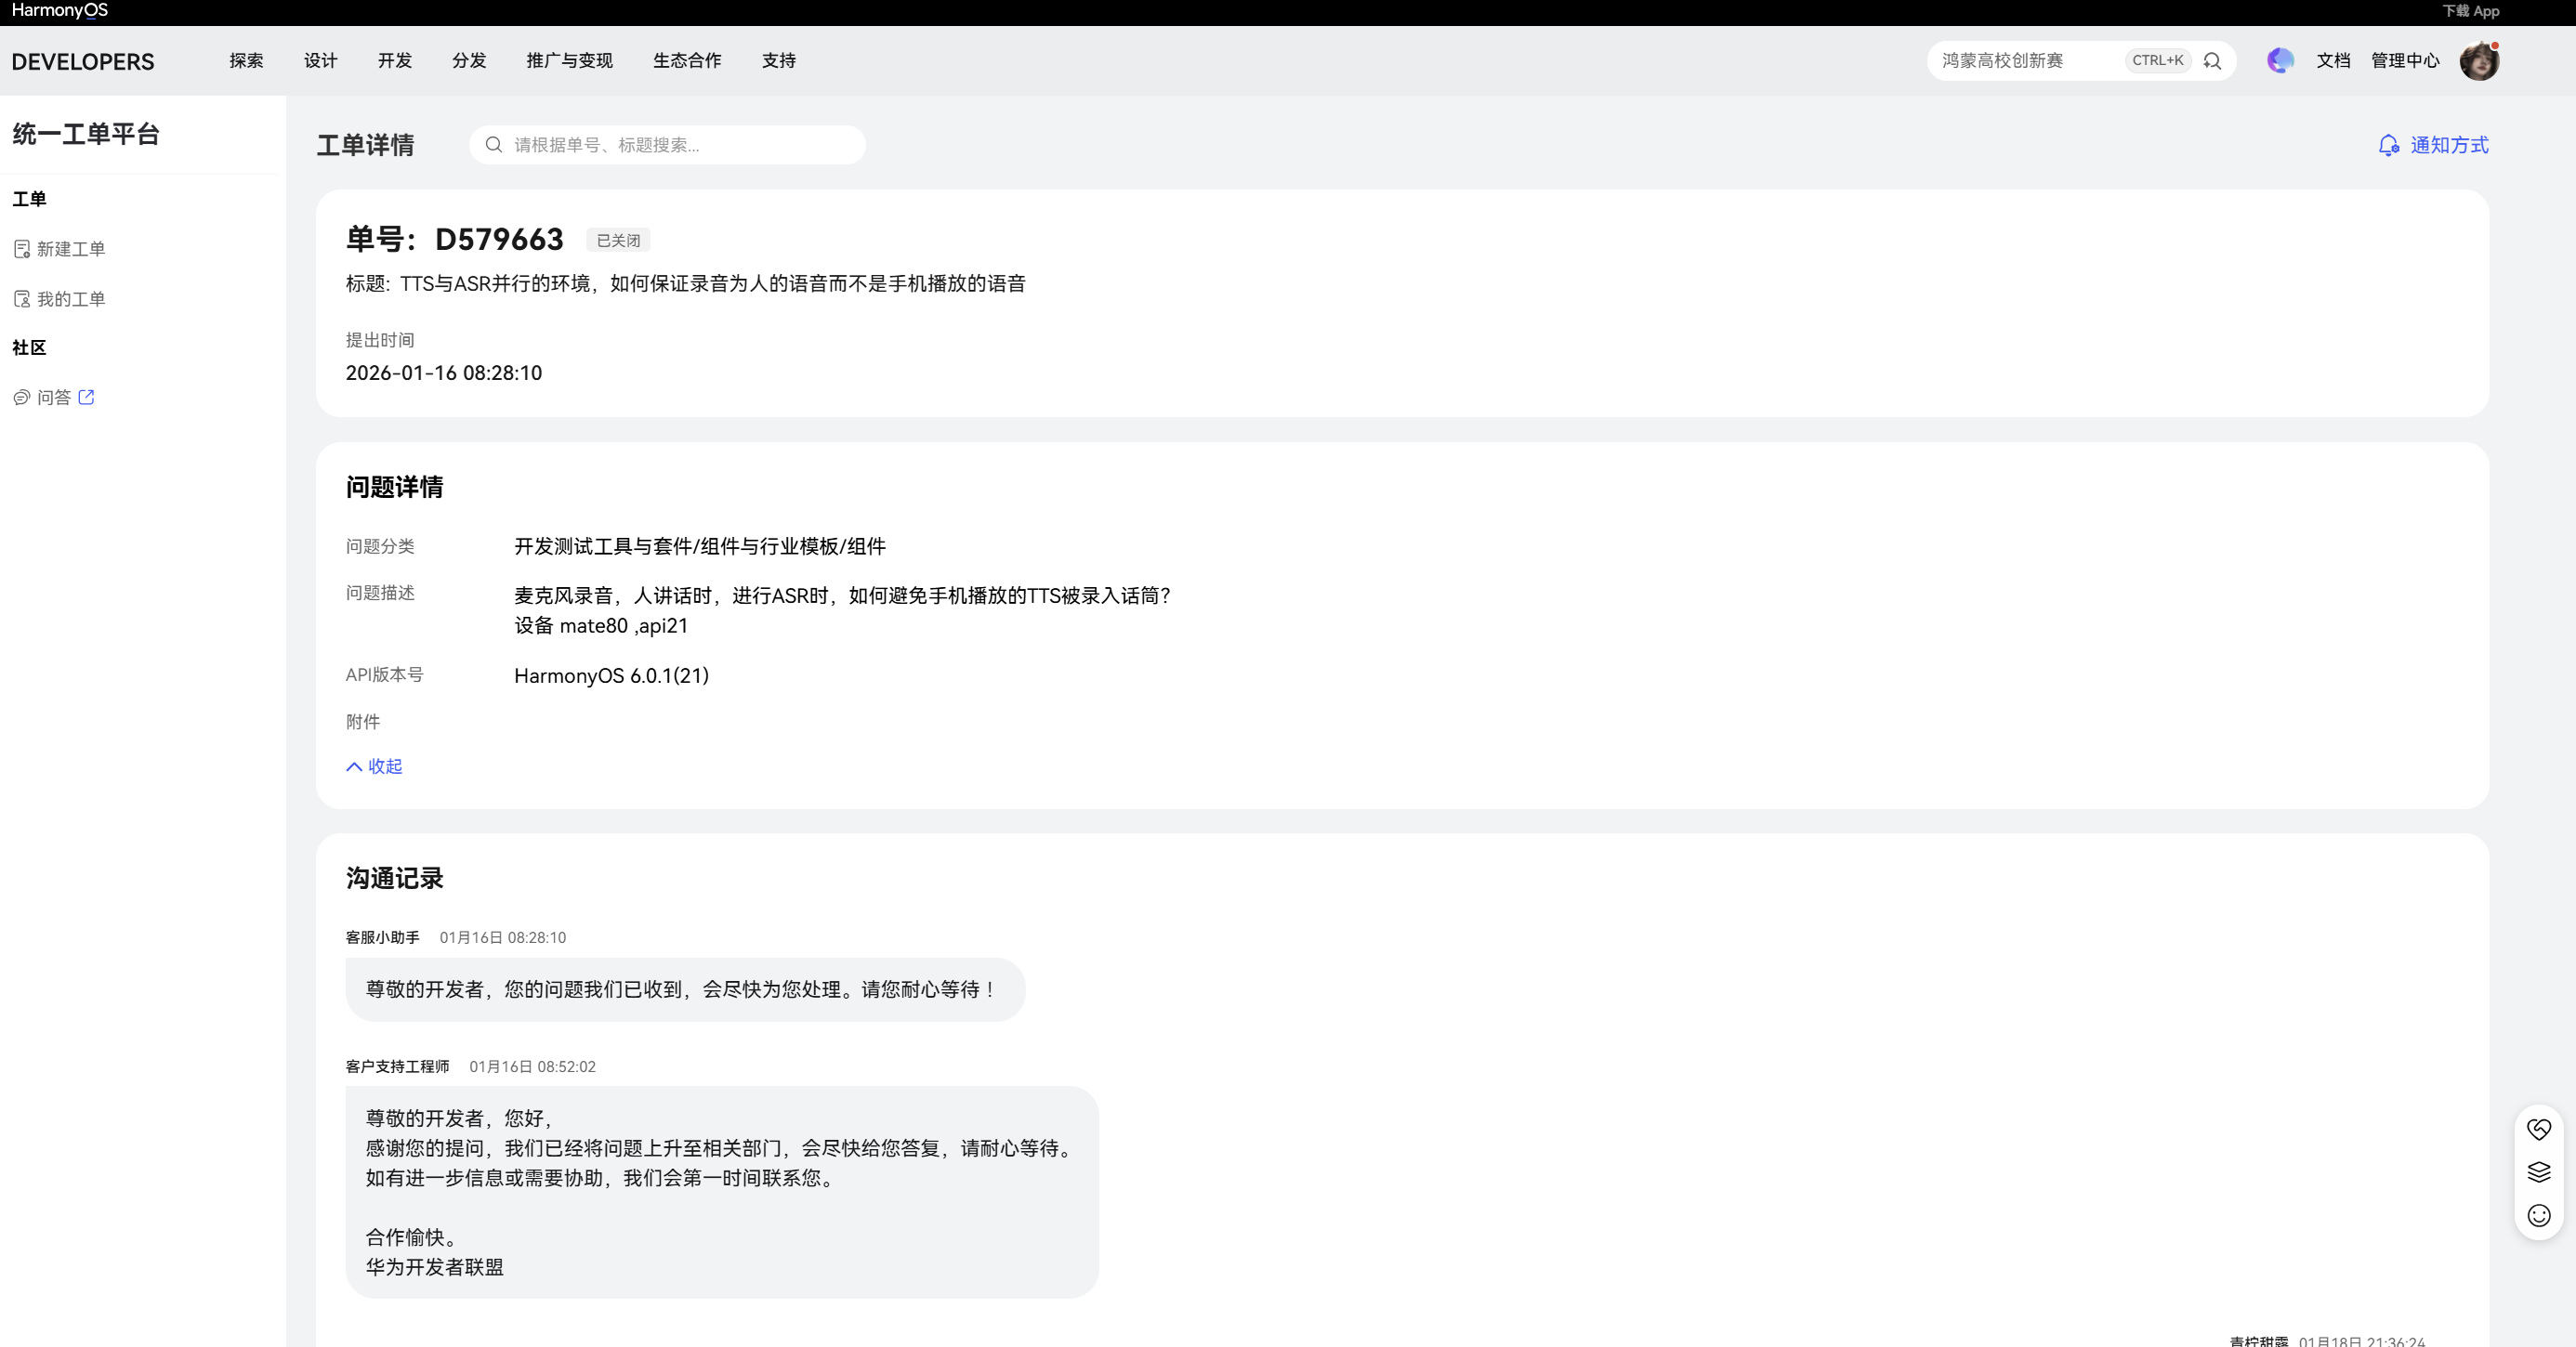
结合自身在语音信号处理领域的积累,我向鸿蒙官方提交技术工单,完整阐述了业务场景、现存缺陷,提出系统层实现声源甄别,隔离TTS播放音与背景噪声,仅将目标说话人语音送入ASR引擎这套优化思路;同时将Sherpa‑ONNX开源语音框架作为技术参考方案,给到鸿蒙研发团队用于方案推演与技术选型参考。
令我印象很深的是,华为鸿蒙团队并没有把这份外部技术建议简单处理闭环。研发团队主动发起线上技术评审会议,以技术对等沟通的姿态,和我深度研讨业务边界、信号处理难点、工程落地约束,针对我提出的整套思路做细致的技术交流探讨。下面是我当时提交的工单截图:
时隔大半年,这套我当初提出的声源区分能力,已经沉淀为HarmonyOS7底层系统能力,随着Pura X View面向海量终端用户落地。
这件事对整个鸿蒙开发者生态,我认为具备很强的参考意义:
- 外部资深开发者的技术洞察,能够真正输入操作系统底层迭代。很多一线做落地的技术人员,会接触到大模型、语音工程真实的复杂场景,这些场景是实验室很难完整覆盖的。我的技术建议能够被官方团队重视,最终固化进系统能力,对我而言是一份莫大的认可。
- 由衷点赞鸿蒙研发团队开放务实的技术态度。愿意倾听外部资深开发者的见解,主动开展对等技术研讨,吸收外部开源框架思路,兼容外部工程师的技术输入,正是这种开放心态,推动鸿蒙系统能力持续迭代变强。
当然必须客观说明:从一份外部技术建议,到成熟、可量产的系统级ASR能力,中间是鸿蒙工程师海量的算法调优、工程打磨、兼容性适配,绝非直接复用外部方案,向鸿蒙底层研发团队致敬。
也期待鸿蒙后续可以把这套声源区分、定向拾音的底层能力,对外开放标准化接口,让广大语音方向开发者,直接调用这套经过量产验证的系统能力,构建更多高质量终端语音应用。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)