
卡买回来了,选错模型才是最贵的错
第四生产力
为什么 Qwen 3.8-27B 是这个尺寸里又强又省的那道
卡买回来那天,才是麻烦的开始。
上一篇我把「自建还是云 API」的账算完了:用量到一个月 1 亿 token 以上,自建开始回本。算完我发现一件更实际的事,买卡不是终点,选模型才是。
我最近一直在帮人看自建部署。最贵的买卡那步大家都迈过去了,钱花在了硬件上,结果一堆人卡在「跑哪个模型」上。有人卡买回来装不下,有人装上了,跑得慢得没法用。
我觉着,选错模型比买错卡更亏。卡买错了是损失,模型选错了,是你花大价钱买的那台设备,从头到尾没发挥出来。
今天不接着算账了,就讲一件事:2026 年你自己部署,跑哪个模型最划算。
答案是 Qwen 3.8-27B。它不是全场最强,但它是你能自己跑的那批开源模型里,又强又省算力的一道。
最狠的一点:记满 128K 字,上一代 Qwen 2.5-32B 的「记忆」要占 32G 显存,它只要 8G。
先把擂台摆对
选模型最容易跑偏的地方,是去跟 GPT-5、Claude Opus 比。
别比。
那是前沿大尺寸加闭源 API 的地盘。你中小企业自部署,数据得出门,还按 token 计费,跟它比既不现实也没必要。
你真正该问的是另一句:我能自己部署的那批开源模型里,27B 这个尺寸的,谁最强、谁最省算力?
擂台摆对,答案才数得清。
怎么知道谁最强
厂商说自己第一,这话听听就行。
我用的是第三方擂台,Artificial Analysis,一个独立做模型评测的网站。它不隶属于任何一家,分数自己跑,10 个基准加成一个总分,置信区间压到 ±1% 以内,方法论公开,被业内不少人当参考。
一句话:它不替你做决定,但它是一张能横向比较的体检表。
数字
就在这张表上,Qwen 3.8-27B 拿了 34 分。
同尺寸开源模型里排第一,中位数才 8,差不多 4 倍。
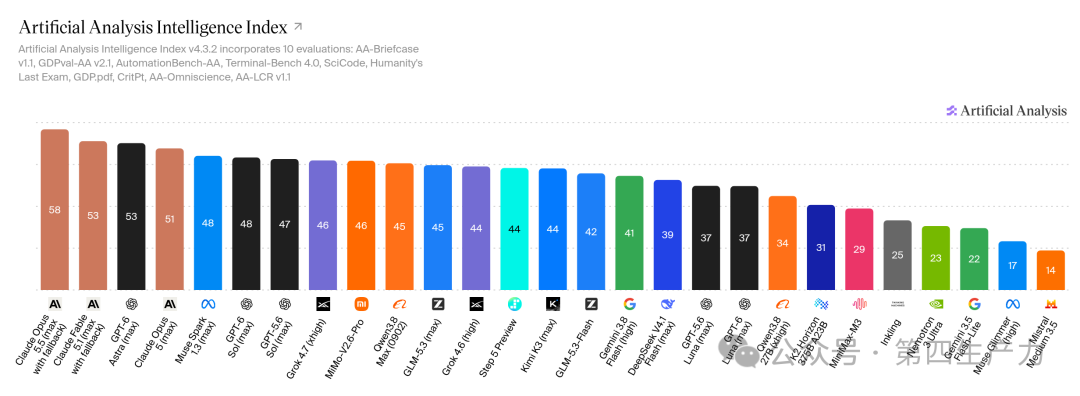
Artificial Analysis 官方智能指数排行榜(v4.3.2,2026-09 导出)。橙色那根 Qwen3.8 27B,34 分,排第 20 位。它前面那一片,要么是闭源模型,要么参数是上 T 的(MiMo、DeepSeek、GLM、Kimi 那批),跟 27B 不在一个量级。
它跟大尺寸模型有差距,也没法和闭源模型相提并论。但放在 27B 这个尺寸的开源模型里,它就是无敌的存在。
它强在哪
34 分之外,还有两样:256K 长上下文,能看图、看视频。
官方给的对照表也能看,比上一代 3.6-27B 强了一截,写代码、操作电脑这几项,整张表都是涨的,不是单点飙高。这数字是厂商自己测的,打个折看,但趋势是真的。
论坛里跑它的人不少。测了两年本地模型的开发者 Simon Willison 说,这是「能跑在笔记本上的模型里,他见过最好的」。
它省在哪
这才是「甜品」俩字的物理原因。
模型有个毛病,上下文一长,显存就被「记忆」吃光。回答前,得把读过的先记着,记多少占多少显存,这块叫 KV cache。
拿同家族的上一代 Qwen 2.5-32B 来算,它的结构是公开的(64 层、8 个记忆头、128 维,BF16)。每个 token 要记 256KB,记满 128K 就是 32G。
上一代 Qwen 2.5-32B 256KB / token 32G 记满 128K 的显存 | Qwen 3.8-27B 64KB / token 8G 记满 128K 的显存 |
同样记 128K,差 4 倍
27B 这个架构不一样。它 64 层里只让 16 层做「完整记忆」,剩下 48 层用「边读边忘、只留要点」的方式。这 4 倍不是调出来的,是架构里只有 1/4 的层在存完整记忆。
落到你能买的卡上:4-bit 量化后权重约 17G,24G 的机器就能跑起来;想喂满 128K,光记忆再占 8G,32G 以上才从容,48G 是舒服的甜点位。
同样记 128K,一个是 8G 一个 32G,这就是「甜品」省的那笔算力。同一张卡能跑更长的上下文,同样的上下文用更小的卡就够,而且数据不用出门,权重 Apache 2.0 免费下载。
做企业 RAG 的同事都知道,长上下文和数据不出门,这两样以前得二选一。这个模型让头一次能一起要。
我自己就在跑
不是纸上谈兵。我们现在生产环境,就是 4 卡昇腾 910B,bf16 精度,跑 Qwen 3.8-27B。
为啥要 4 卡?bf16 下它的权重约 54GB。单张 910B 是 64GB,扣掉长上下文要占的记忆,华为官方实测里 bf16 单卡直接拉不起来。4 卡张量并行一摊,每卡才十几 G,长上下文也放得下。
解码速度(4 卡 910B 实测)
80 tok/s
折成中文 ≈ 40 字/秒,不管喂多少字都不掉速
你读第一句的时候,它早把整段答完了。
快是一方面,还得看它答得对不对。我挑了几道能判对错的硬题给它:
6/6 全过
| 日期 ✓ | 工程 ✓ | 数学 ✓ |
| 应用题 ✓ | 写代码 ✓ | 逻辑 ✓ |
写代码那道,是把它写的代码真的运行一遍、4 组用例全过才算,不是看嘴上说得对。
它唯一的脾气:喂的东西越长,第一个字出来越慢。喂 1.2 万字进去,得先花 15 秒左右读完才吐第一字。短问题秒出,超长文档你得等。
公道话:它也有短板
默认档它爱「想太多」,慢,还啰嗦。一个实测:跑一道题,它产了 3000 多输出 token,光「思考」就烧了 2 万多个 token,在 M5 Max 上花了快 21 分钟。
消费级硬件跑不快。M4 Air 24G 能加载,但每秒不到 10 个 token,能用但不爽;16G 的 Mac 直接卡崩。想跑得爽,得 5090 这种卡,能跑到 150 个 token 每秒往上。
它还有个 bug,某个开关一开就崩,得用社区修好的模板。
所以它是甜品,不是万能。
你到底该不该上
给你三问,两「是」就值得上:
1
你的数据要不要出门?要留在本地,这条加权。
2
你的卡显存 24G 起吗?不够,先解决硬件,或者看更小的模型。
3
你能忍它默认档的慢和啰嗦吗?不能,就把思考档位调低,或切不思考模式。
三问下来都点头,它八成就是你的甜品:自部署,性能强,还省算力。要是数据不出门这条不卡你,或者显存不够,那它不一定是。别硬上。
下一篇
我打算接着写「甜品硬件怎么选」,NVFP4、FP8、BF16 这几个精度,哪个省卡、哪个省显存,一篇一篇算给你看。
你在留言区投一下,下一篇想看哪个:
A · 甜品硬件怎么选(NVFP4 / FP8 / BF16)
B · Qwen 27B 实战部署踩坑(量化档位、MTP、并发)
C · 别的,你说了算
—— 第四生产力 ——
专注企业级 AI 工程实践
RAG|Agent|推理优化|集群调优
从模型能力到业务价值的最后一公里。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)