
浪潮 SD200 Ultra、英伟达 Rubin、华为昇腾960,三条算力路线的运维差异到底在哪?
最近浪潮发布了 SD200 Ultra,和英伟达 Rubin、华为昇腾960 放一起,很多人比参数。但从运维角度看,这三者到底有什么本质区别?
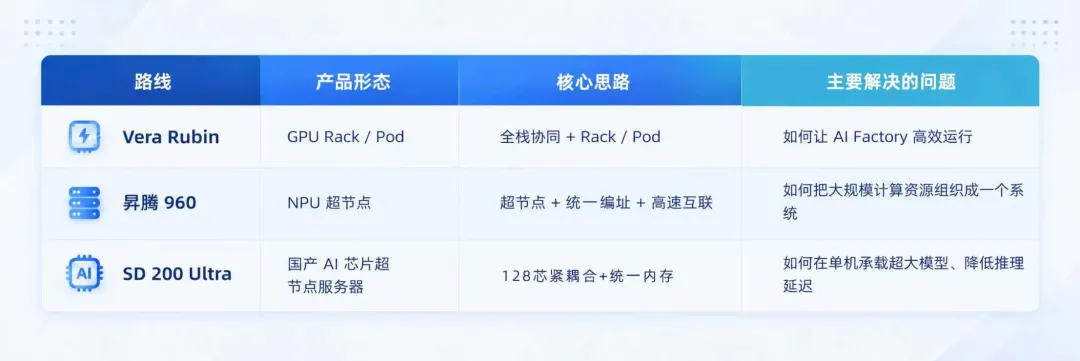
先明确一点,这三者产品形态不同,不能直接比性能排名。
-
Rubin:Vera Rubin NVL72 是机架级系统,72 张 GPU + 36 颗 CPU,NVLink 6 做机架内互联,向外靠 Spectrum-X Ethernet 和 Quantum-X800 InfiniBand 扩展。它拼的是 Rack/Pod 级别的系统协同,运维逻辑也是系统级——液冷、互联、供电,任何一处异常都可能拖垮整个机架。
-
昇腾960:华为超节点路线,最高 4096 张 AI 芯片,统一内存编址,8 EFLOPS FP8、1PB HBM。它解决的是单芯片不够时,用系统规模补上去。而且昇腾960 用 5500 个近封装光引擎替代了 4.8 万颗 800G 光模块,功耗降低超 550 千瓦,系统可用度 99.8%。但拼规模意味着故障域大,一条互联链路出问题可能影响一整片节点。
-
SD200 Ultra:基于国产 AI 芯片,3D Hyper Mesh 架构,单机紧耦合 128 芯,8TB 统一编址显存 + 64TB 内存,单机承载 2.8 万亿参数 Kimi K3,Token 时延 5.85ms。它拼的是单机内部把大模型跑出极致效率,但报错逻辑跟 B300、昇腾都不一样,传统 GPU 运维经验直接失灵。
-
那运维上具体有什么不同?
故障边界完全不一样。
一张 GPU 异常,可能只影响单卡;一个高速互联链路出问题,可能影响整个节点;一个超节点级故障,可能直接中断模型任务。以前运维问“哪张卡坏了”,现在问“故障到底在哪一层”。
维云的做法是按架构分而治之:
-
B300 这类高功耗 GPU 集群,做芯片级维修 + 快速故障定位,缩短停机时间。
-
昇腾这类超节点,做跨节点故障边界判定,区分互联问题还是单卡问题,避免误判整节点下线。
-
SD200 Ultra 这类国产紧耦合架构,提供异构集群运维支持,覆盖硬件诊断、液冷运维、集群故障排查。
维云在保 GPU 服务器超 10 万台,支持 A/H/B 系列 GPU 维修,同时提供 AI 服务器交付、运维与维修服务。三条路线,三套运维逻辑,一套服务能力。
所以结论是什么?
AI 算力竞争已经从单芯片进入系统层。芯片决定算力上限,系统决定算力能不能稳定跑下去。对运维团队来说,未来要面对的是更复杂的异构集群环境,快速定位故障边界、缩短算力中断时间,才是核心能力。
关注维云,持续获取 GPU、AI 服务器、超节点及算力基础设施相关内容。如果你正在关注 AI 算力建设、服务器运维或 GPU 维修,欢迎加入算力技术交流群,一起交流行业动态与技术问题。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)