
华为昇腾MindStudio全流程开发工具链实战指南:从入门到企业级落地
华为昇腾MindStudio全流程开发工具链实战指南:从入门到企业级落地
本文围绕华为昇腾官方下载页面(https://www.hiascend.com/developer/software/mindstudio/download)展开,系统讲解 MindStudio 的核心概念、安装配置、常用场景、企业项目实战以及与主流竞品的对比,帮助小白快速上手,让老手查漏补缺。
文章目录
一、痛点场景:AI 开发者的真实噩梦
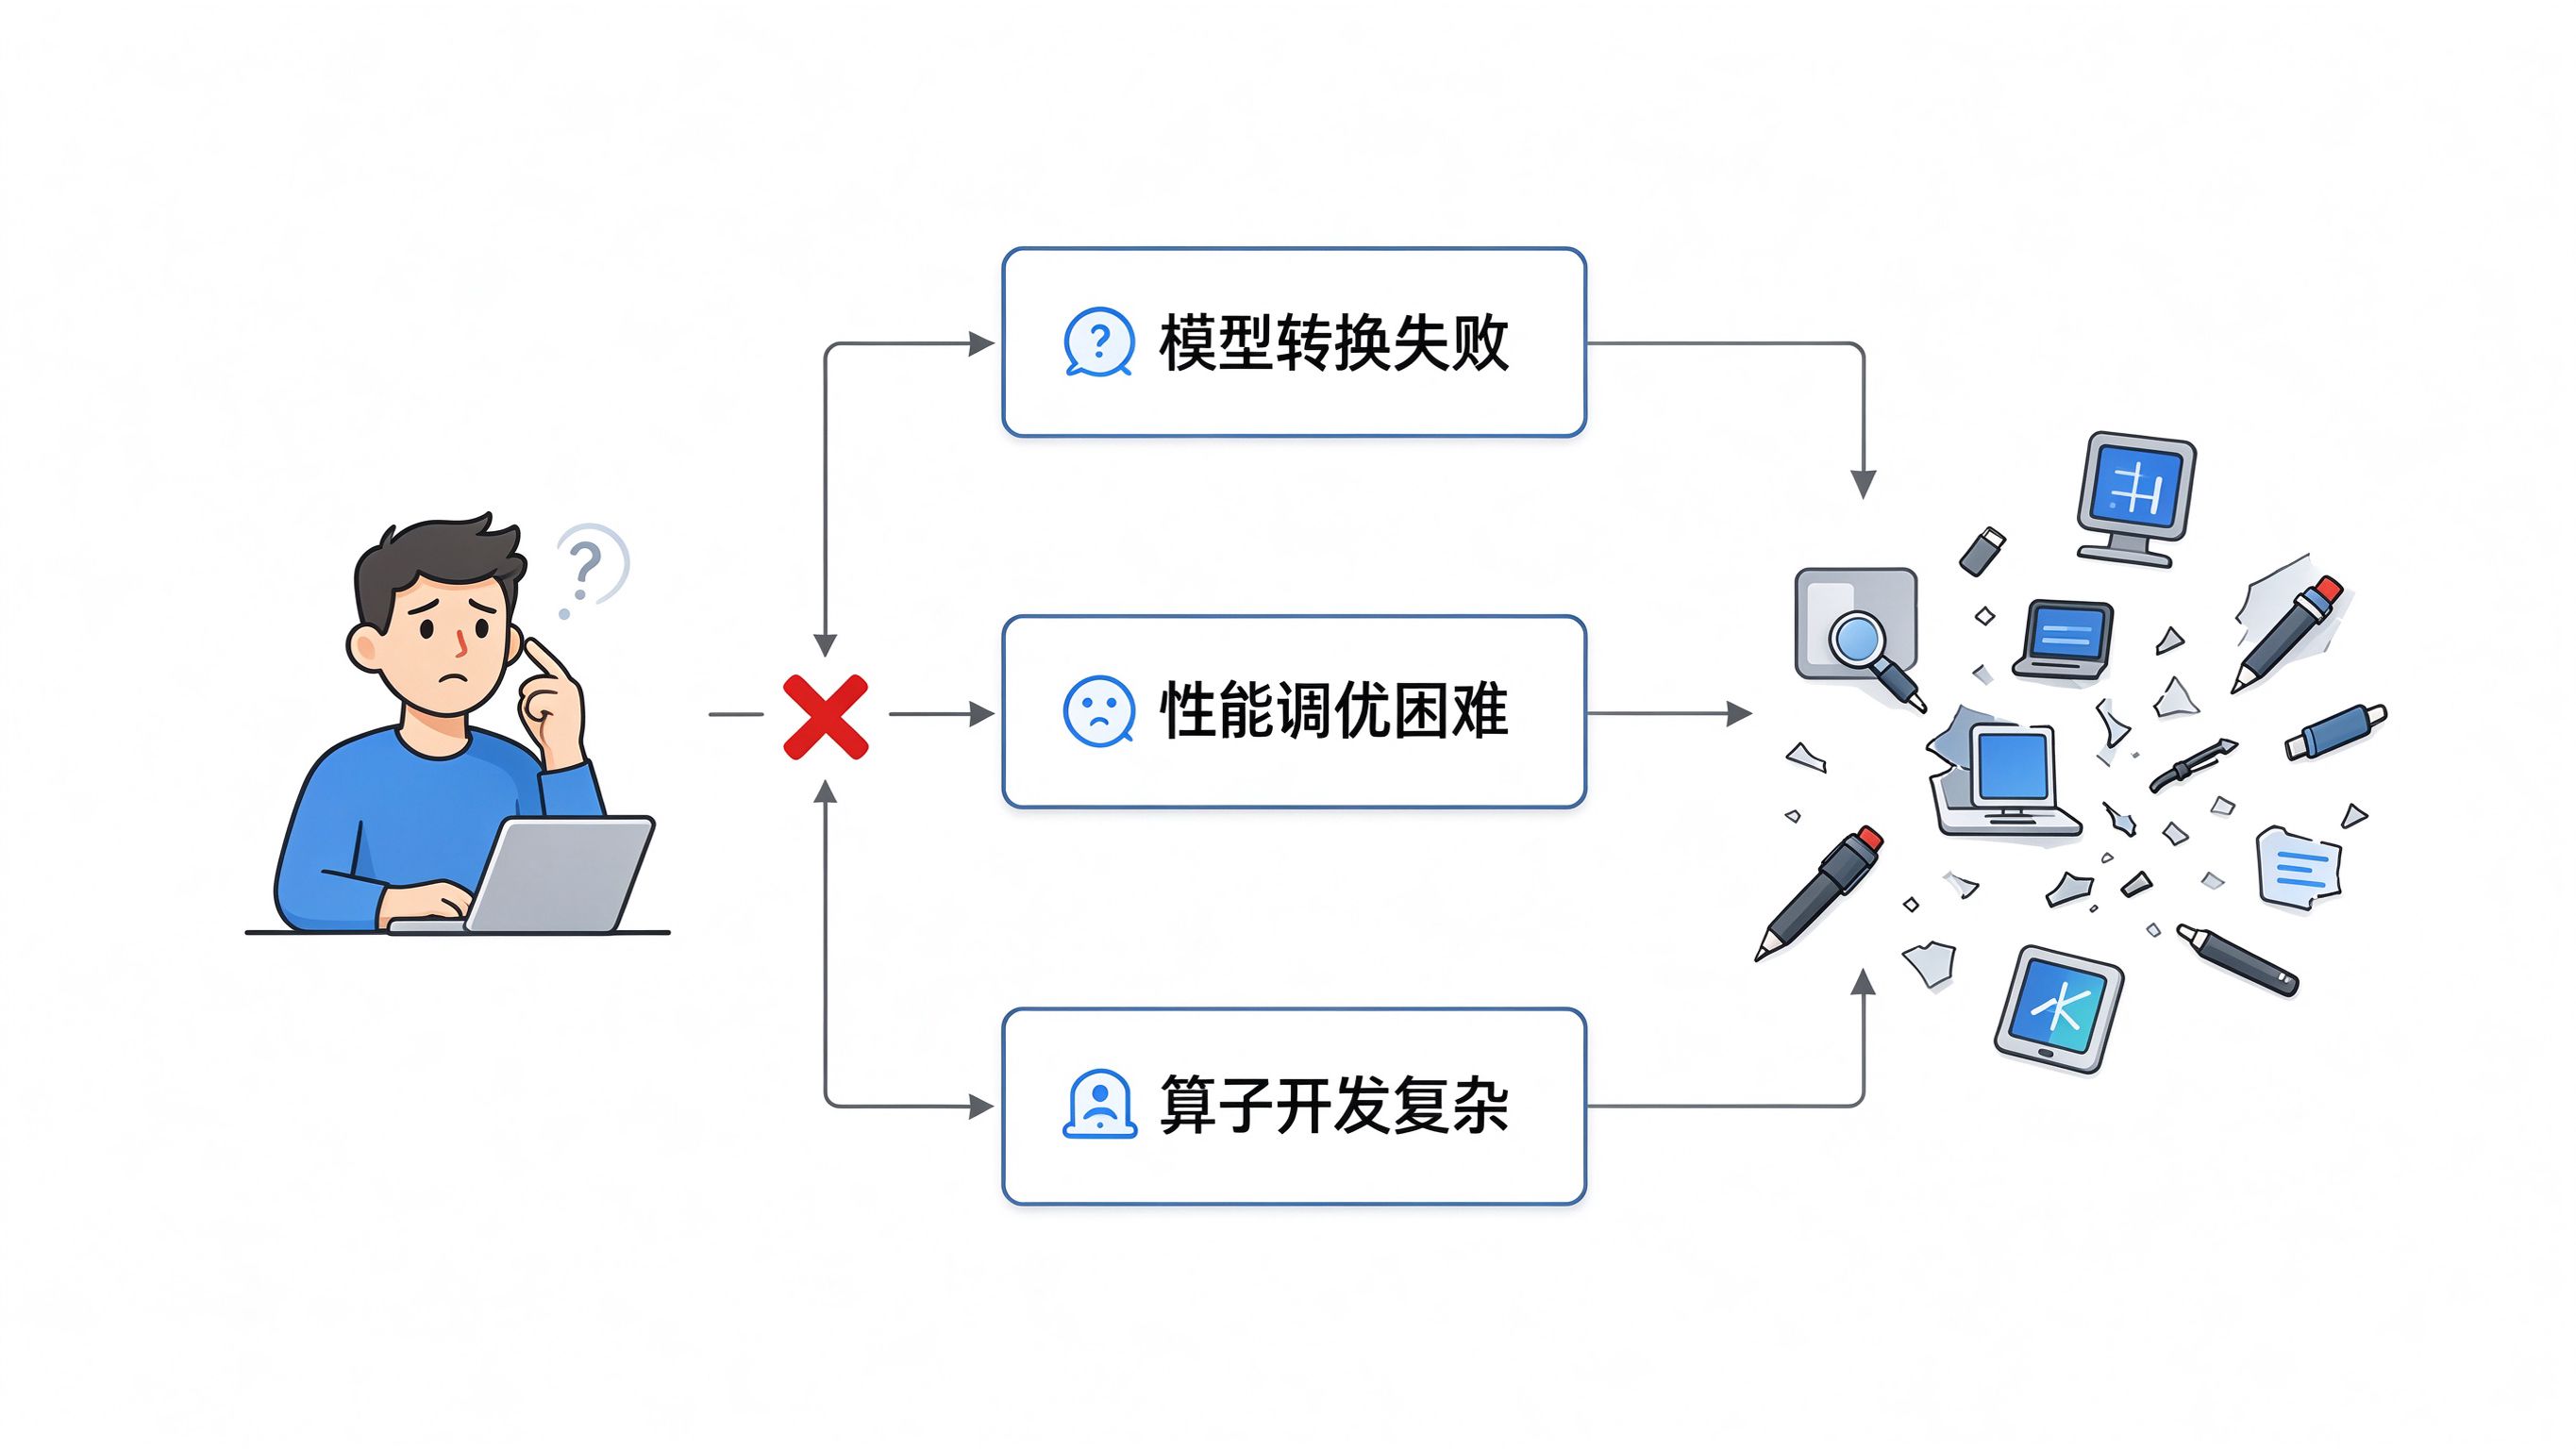
1.1 模型转换:从 ONNX 到部署的"九九八十一难"
你是否经历过这样的场景:花了两周时间用 PyTorch 训练好了一个 ResNet50 图像分类模型,精度达到了 95%,老板说"可以上线了"。结果你发现,部署到昇腾 NPU 上需要先把模型转成 OM 格式,转换时报了一堆看不懂的错误,查了三天文档才发现是某个算子不支持。
专业解释:不同 AI 硬件平台有各自的模型格式和推理引擎。昇腾平台使用 CANN(Compute Architecture for Neural Networks)软件栈,模型需要通过 ATC(AI Model Converter)工具转换为 OM(Offline Model)格式才能在 NPU 上执行。转换过程中涉及算子映射、精度校准、输入输出对齐等多个环节,任何一个环节出问题都会导致转换失败或精度下降。
大白话:就像你在美国买了一台 110V 的电器,拿回中国用需要买个变压器。变压器买错了型号,电器要么不转,要么直接烧掉。模型转换就是那个"变压器",而 MindStudio 就是帮你选对变压器、接对电线的工具箱。
生活案例:小王是一名算法工程师,训练好的 YOLOv5 模型要部署到昇腾 310 推理卡上。他直接用 ATC 命令行转换,结果连续报错。先是 input_shape 不匹配,然后是某个后处理算子不支持,最后好不容易转成功了,推理精度却掉了 3 个百分点。折腾了一周,项目延期了。
1.2 性能调优:“为什么我的模型跑这么慢?”
模型终于能跑了,但推理延迟高达 200ms,业务要求 50ms 以内。你不知道瓶颈在哪里,是算子没融合?内存没对齐?还是量化没做好?只能靠猜,改一个参数跑一次,效率极低。
专业解释:AI 推理性能受算子实现、内存访问模式、计算单元利用率、批处理策略等多方面因素影响。昇腾 AI Core 采用 Cube(矩阵计算)+ Vector(向量计算)+ Scalar(标量计算)的异构计算架构,三级存储(GM 全局内存 -> UB 统一缓存 -> L0/L1 本地内存)需要开发者手动优化数据搬运策略才能发挥最大性能。
大白话:就像开餐馆,厨师(AI Core)炒菜很快,但备菜(数据搬运)跟不上,厨师就得等着。性能调优就是把备菜流程优化好,让厨师一刻不停。
1.3 算子开发:“这个算子 NPU 不支持怎么办?”
业务需求越来越复杂,模型里用了一个自定义的注意力机制,CANN 内置算子库不支持。你需要自己写算子,但 Ascend C 编程语言的学习曲线陡峭,调试困难,写出来的算子性能还不如 CPU。
专业解释:CANN 内置了 1000+ 标准算子,但前沿模型(如新型 Transformer 变体、自定义激活函数)经常需要自定义算子。Ascend C 是面向昇腾 AI Core 的编程语言,原生支持 C/C++ 标准,通过多层接口抽象和自动并行计算降低开发难度,但仍需要理解硬件架构才能写出高性能算子。
1.4 工具碎片化:一个人要会 N 个工具
模型转换用 ATC,性能分析用 msprof,精度比对用 Model Accuracy Analyzer,算子开发用单独的工程模板,训练调试又用另一套工具。每个工具都有自己的命令行参数和配置文件,开发者的精力都花在"学会用工具"上,而不是"解决业务问题"上。
二、痛点的解决方案:MindStudio 一站式工具链
MindStudio 的核心价值就是把上述碎片化的工具整合到一个统一的开发环境中,提供从模型训练、推理开发到算子开发的全流程支持。
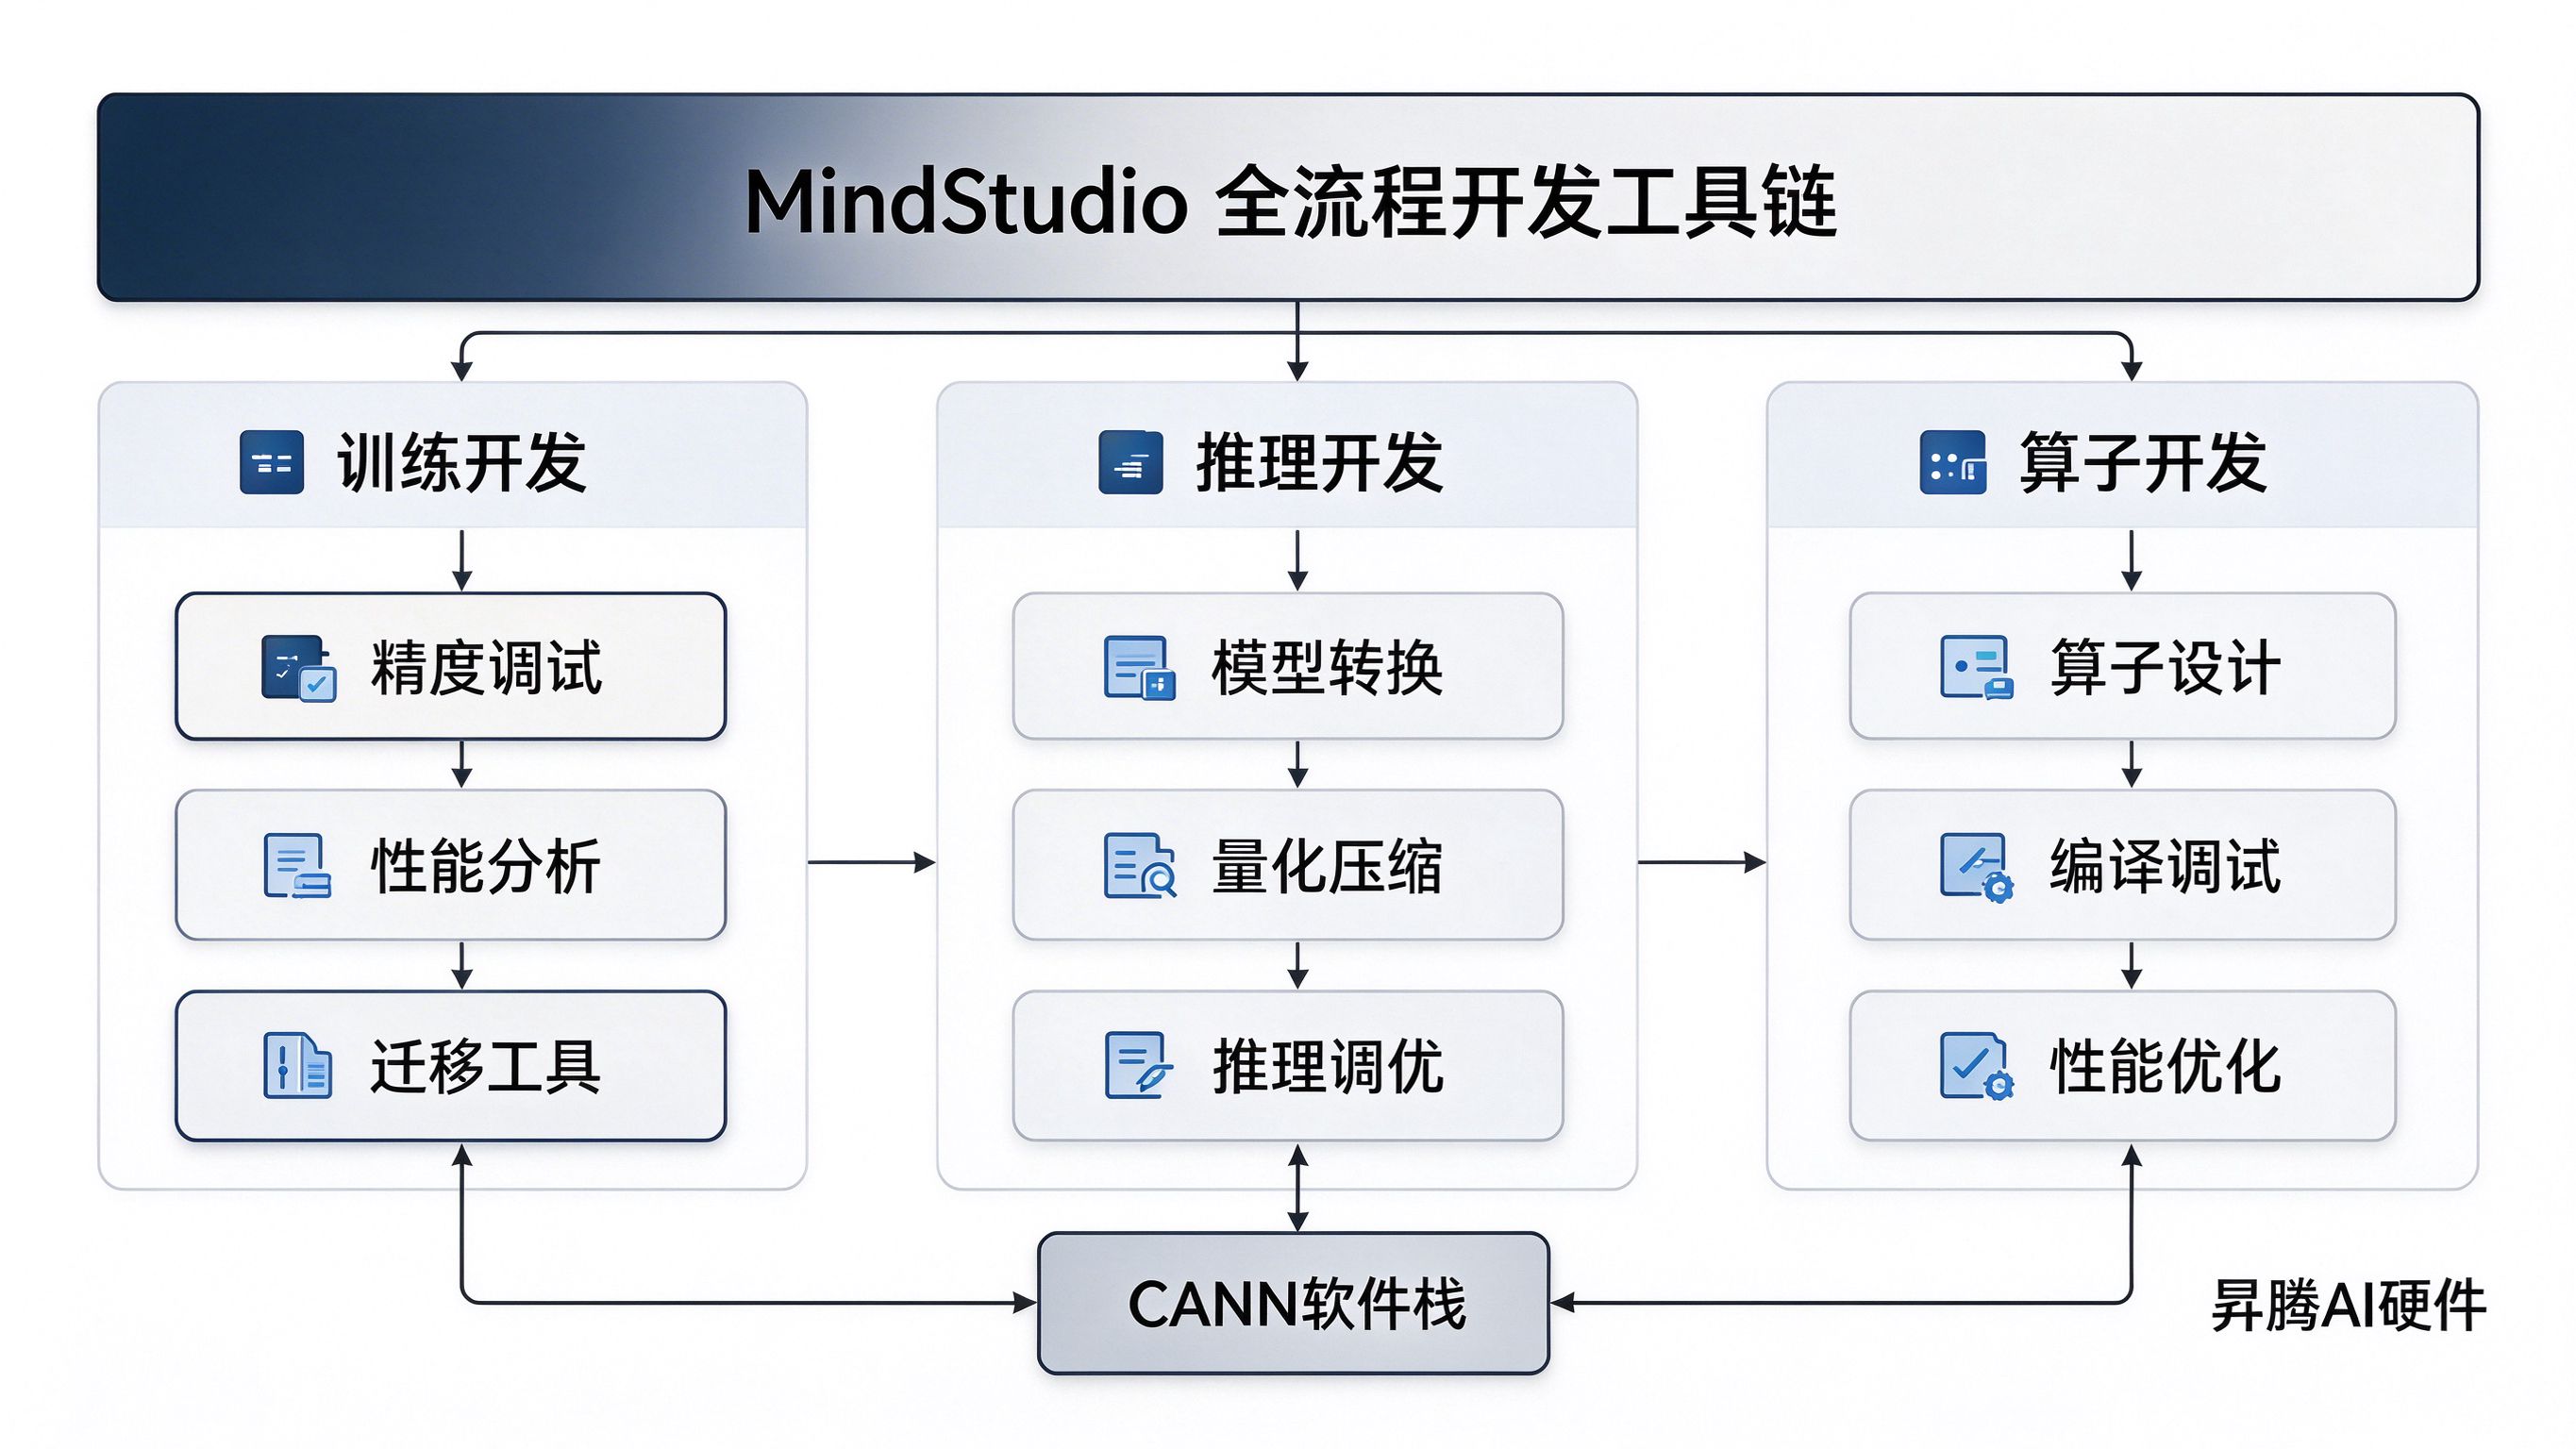
专业解释:MindStudio 是华为面向昇腾 AI 开发者提供的全流程开发工具链,基于 IntelliJ 平台构建,支持 IDE 图形化界面和命令行两种使用模式。它集成了模型转换、量化压缩、精度比对、性能 Profiling、算子开发调试、训练可视化等核心能力,与 CANN 软件栈深度协同,覆盖昇腾 AI 应用开发的完整生命周期。
大白话:如果把 AI 开发比作装修房子,以前你需要分别找水电工、木工、油漆工,每个人各干各的,协调起来很麻烦。MindStudio 就是一家"全包装修公司",从设计到施工到验收,一个团队搞定,沟通成本大大降低。
生活案例:还是小王,这次他用了 MindStudio。模型转换直接在图形界面拖拽配置,算子不支持时工具自动提示替代方案;性能分析用 Profiling 一键生成火焰图,瓶颈一目了然;算子开发有工程模板和代码补全,调试时支持 CPU/NPU 孪生调试。原来一周的工作,两天就搞定了。
三、MindStudio 是什么
3.1 官方定义
根据昇腾社区官方文档,MindStudio 是华为面向昇腾 AI 开发者提供的全流程工具链,致力于提供端到端的昇腾 AI 应用开发解决方案,使能开发者高效完成训练开发、推理开发和算子开发。
截至 2026 年 7 月,最新正式商用版本为 MindStudio 26.1.0,配套 CANN 9.0.0/9.1.0,全面适配昇腾 950 系列产品。
3.2 三大核心开发场景
| 开发场景 | 核心能力 | 典型工具 |
|---|---|---|
| 训练开发 | 模型迁移、精度调试、性能分析、内存分析 | msProbe、msProf、msMemScope、msInsight |
| 推理开发 | 模型转换、量化压缩、推理调优、精度性能测评 | ATC、msIT、量化工具、Profiling |
| 算子开发 | 算子设计、代码生成、编译调试、性能优化 | msOT、Ascend C IDE、算子仿真器 |
3.3 工具呈现形式
MindStudio 提供两种使用模式:
- IDE 模式:基于 IntelliJ 平台的图形化开发环境,支持工程管理、可视化配置、一键运行,适合初学者和复杂项目开发。
- 命令行模式:提供 msProbe、msProf、msprof-analyze、msPTI、msMonitor、msTX、msInsight 等独立命令行工具,适合 CI/CD 流水线集成和自动化脚本开发。
注意:IDE 模式和命令行模式功能完全一致,仅使用方式不同。命令行工具随 CANN 软件包一起安装,无需单独安装 MindStudio IDE。
3.4 与 CANN 的关系
很多初学者会混淆 MindStudio 和 CANN 的关系,这里明确一下:
- CANN:昇腾 AI 硬件的基础软件栈,包含驱动、运行时(ACL)、算子库、编译器、推理引擎等,是模型在 NPU 上运行的底层支撑。
- MindStudio:运行在 CANN 之上的开发工具链,提供图形化界面和自动化工具,帮助开发者更高效地使用 CANN 的能力。
大白话:CANN 是汽车的发动机和底盘,MindStudio 是方向盘、仪表盘和导航系统。没有发动机车跑不起来,但只有发动机没有方向盘,你也开不走。
四、为什么要用 MindStudio
4.1 一站式开发,减少工具切换成本
传统昇腾开发流程中,开发者需要在 ATC 命令行、msprof 性能工具、精度比对工具、算子开发模板之间频繁切换,每个工具有独立的配置格式和学习曲线。MindStudio 将这些能力统一到一个 IDE 中,配置可视化,操作流程化。
4.2 可视化调试,问题定位效率提升 10 倍
- 模型可视化:拖拽式查看网络结构,逐层分析算子输入输出。
- 性能 Profiling:自动生成 Timeline 时间线、算子瓶颈分析、Roofline 模型,一眼看出哪个算子最慢、为什么慢。
- 精度比对:支持 NPU 与 CPU/GPU 的逐层数值比对,自动定位精度丢失层。
- 内存分析:PyTorch Memory Snapshot 支持,内存泄漏和峰值占用可视化。
4.3 全流程覆盖,从训练到部署无缝衔接
MindStudio 不仅覆盖推理开发,还支持训练开发和算子开发,形成完整闭环:
模型训练 -> 精度调试 -> 模型转换 -> 量化压缩 -> 推理开发 -> 性能调优 -> 算子定制 -> 部署上线
4.4 企业级支持,生态成熟
- 华为官方维护,版本迭代稳定(每季度一个大版本)。
- 完善的文档体系和社区支持(昇腾社区、华为云论坛)。
- 支持与 Jenkins、GitLab CI 等 DevOps 工具集成。
- 提供专家系统(Advisor),自动识别性能瓶颈并给出优化建议。
五、MindStudio 的演进历程
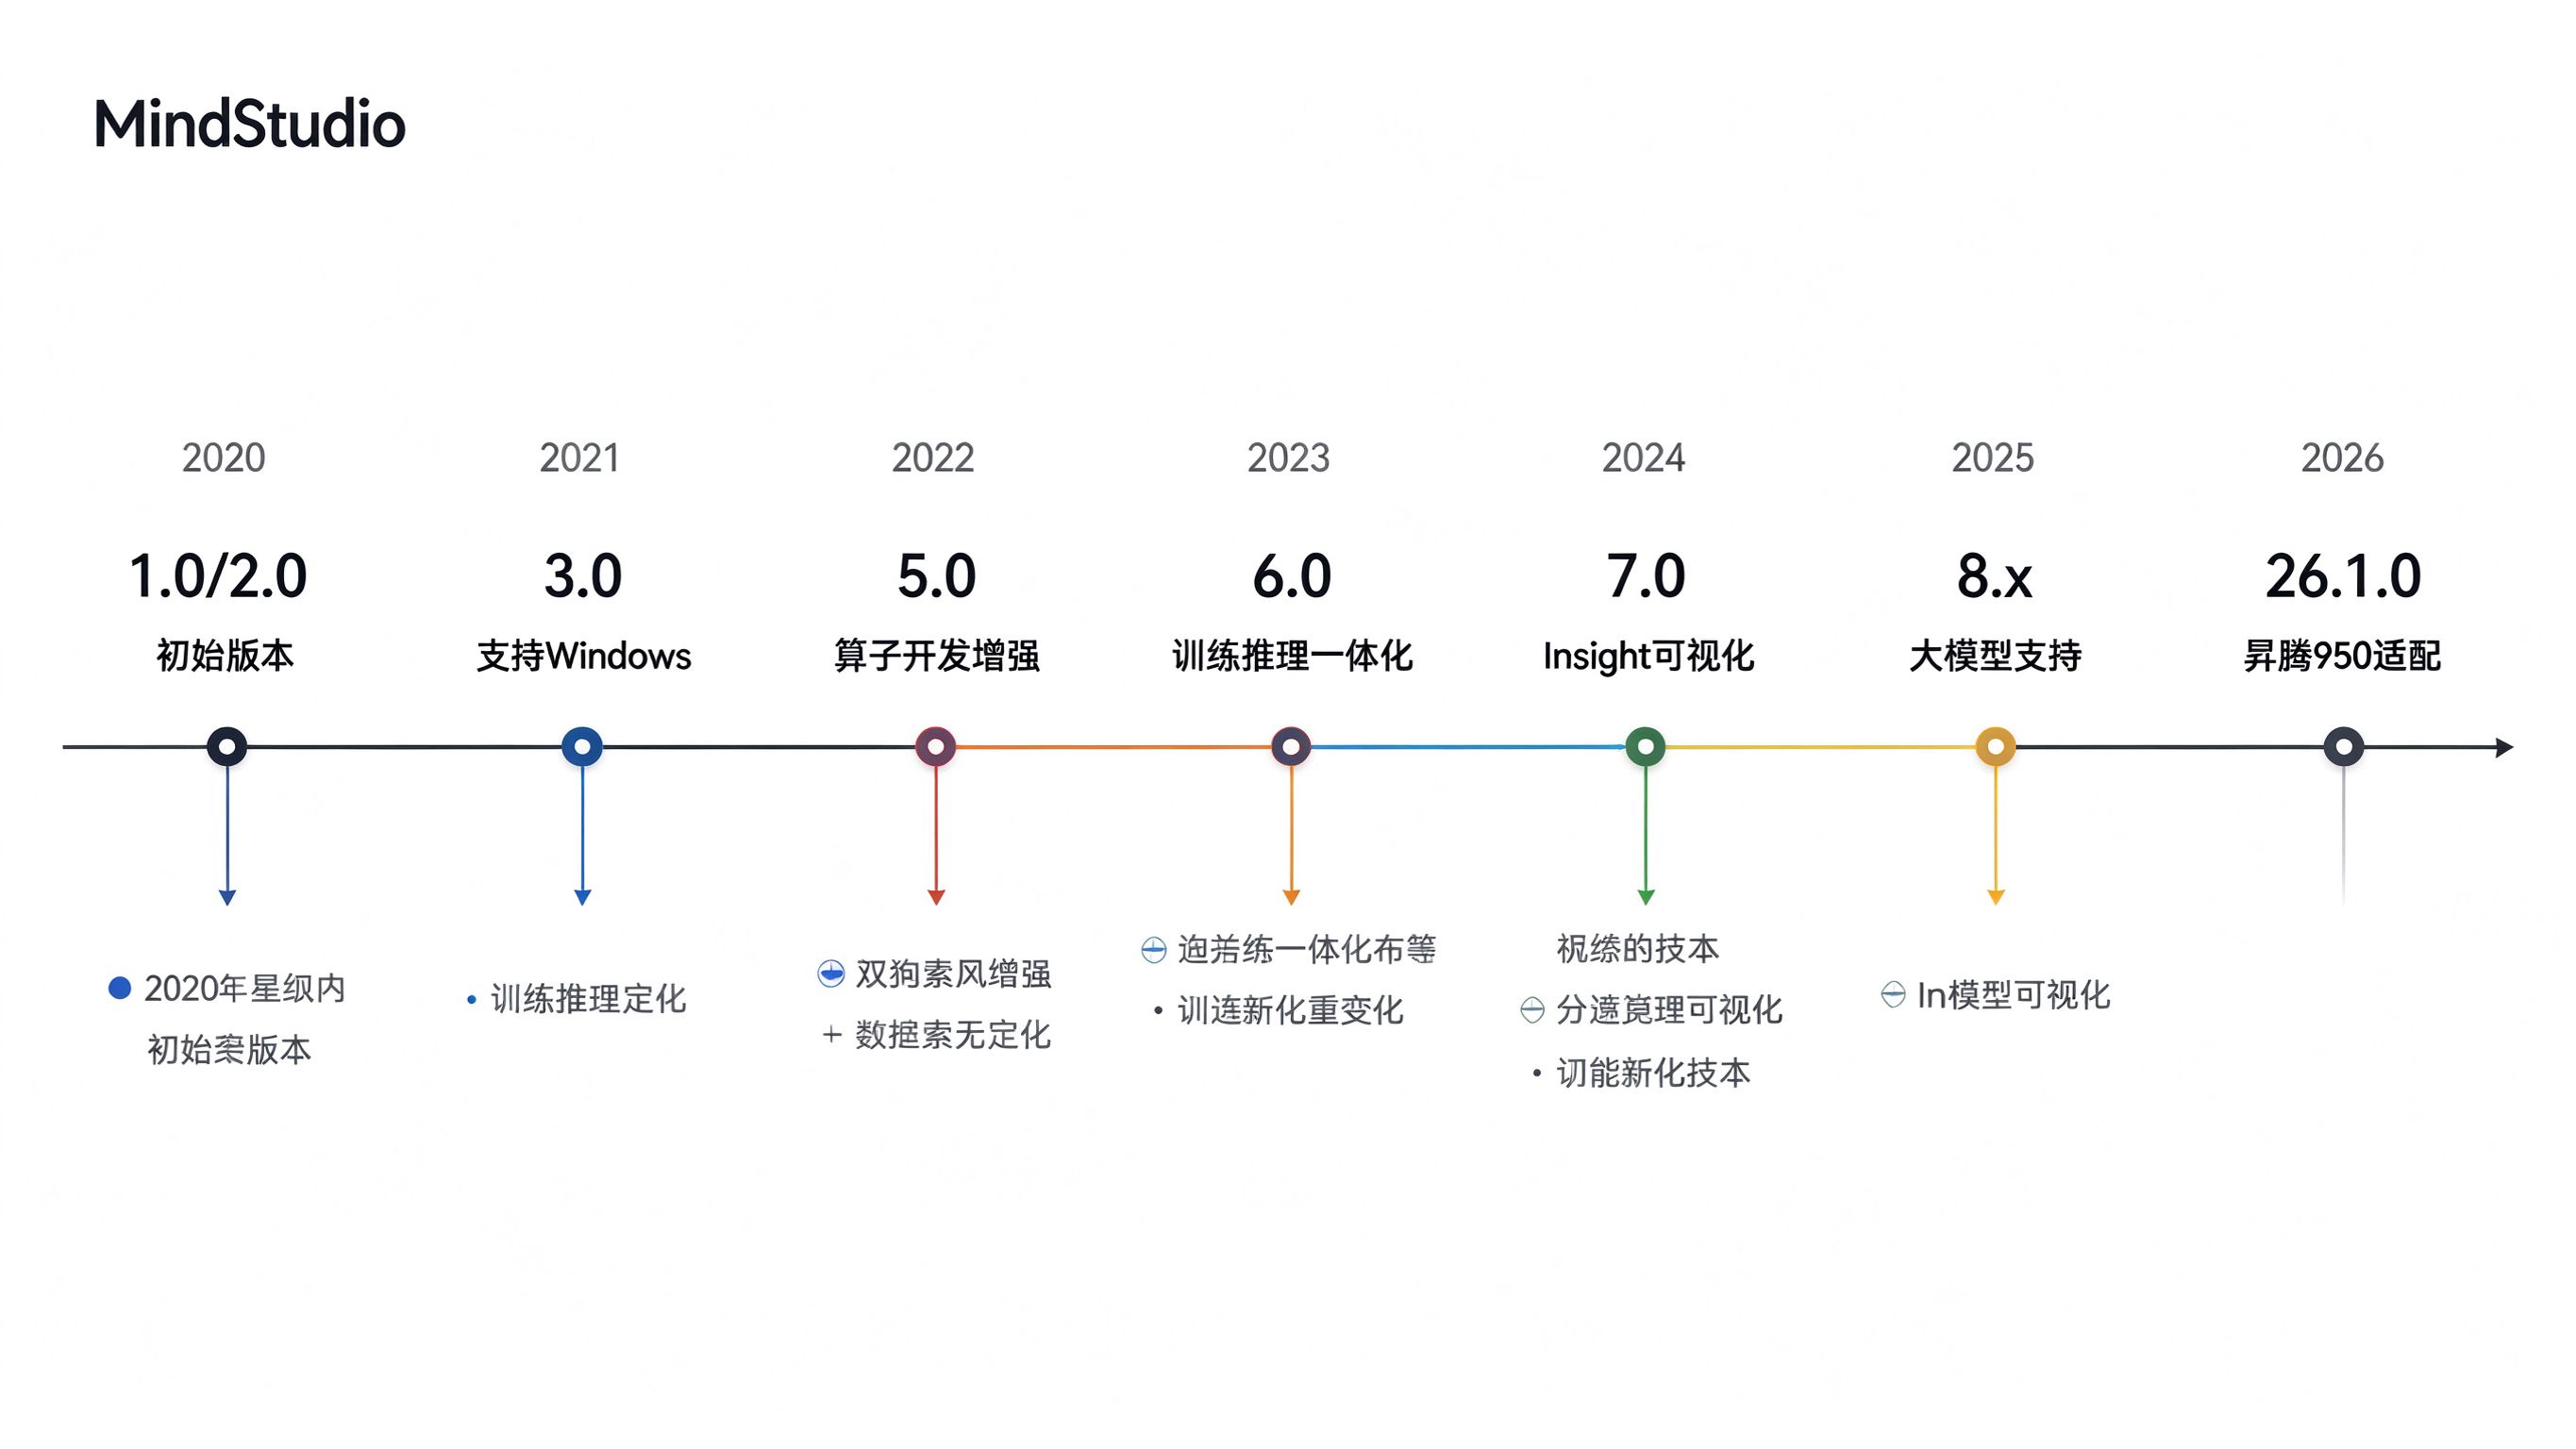
MindStudio 从 2019 年首次发布至今,经历了多次重大架构升级,逐步从单一的推理开发工具演进为全流程 AI 开发平台。
5.1 早期阶段(1.0 - 2.0,2019-2020)
- 定位:昇腾推理应用开发工具。
- 核心能力:模型转换、应用工程管理、基础 Profiling。
- 局限:仅支持 Linux,算子开发能力弱,训练场景不覆盖。
5.2 成长期(3.0,2021)
- 重大更新:支持 Windows 操作系统,开发者可以在 Windows 上进行应用和算子开发。
- 新增能力:MindX SDK 应用开发集成、可视化 Pipeline 业务流编排、AI CPU 自定义算子开发、20+ 算子模板。
- 意义:降低了开发者的环境门槛,Windows 用户可以直接上手。
5.3 能力增强期(5.0 - 6.0,2022-2023)
- 5.0:算子开发能力大幅增强,TBE DSL/TIK 开发工具完善,Profiling 性能分析升级。
- 6.0:训练开发与推理开发一体化,支持 MindSpore、TensorFlow、PyTorch 多框架,模型迁移工具上线。
- 配套 CANN:从 5.x 升级到 7.x,算子库扩充到 1000+。
5.4 可视化升级期(7.0,2024)
- 重大更新:Ascend Insight 更名为 MindStudio Insight,成为统一的可视化调优工具。
- 新增能力:集群性能数据分析、慢卡-慢链路可视化、算子瓶颈分析、内存占用统计、基于 Roofline 模型的优化建议。
- 意义:从"能用"到"好用",可视化能力达到业界领先水平。
5.5 大模型时代(8.x,2025)
- 重大更新:全面拥抱大模型,支持大模型训练精度调试、量化精度调优、推理服务化性能调优。
- 新增能力:大模型一键迁移工具、W8A8/W8A16 量化支持、KV Cache 优化分析、分布式训练性能分析。
- 配套 CANN:8.x 系列,支持昇腾 910B 集群训练。
5.6 最新阶段(26.1.0,2026)
- 发布时间:2026 年 7 月 30 日。
- 重大更新:全面适配昇腾 950 系列产品,Agent 易用性升级。
- 新增能力:PyTorch Memory Snapshot 内存分析、昇腾 950 算子调试调优、大模型训练精度问题快速定位、量化效率提升。
- 配套 CANN:9.0.0 / 9.1.0。
六、怎么用:从安装到上手
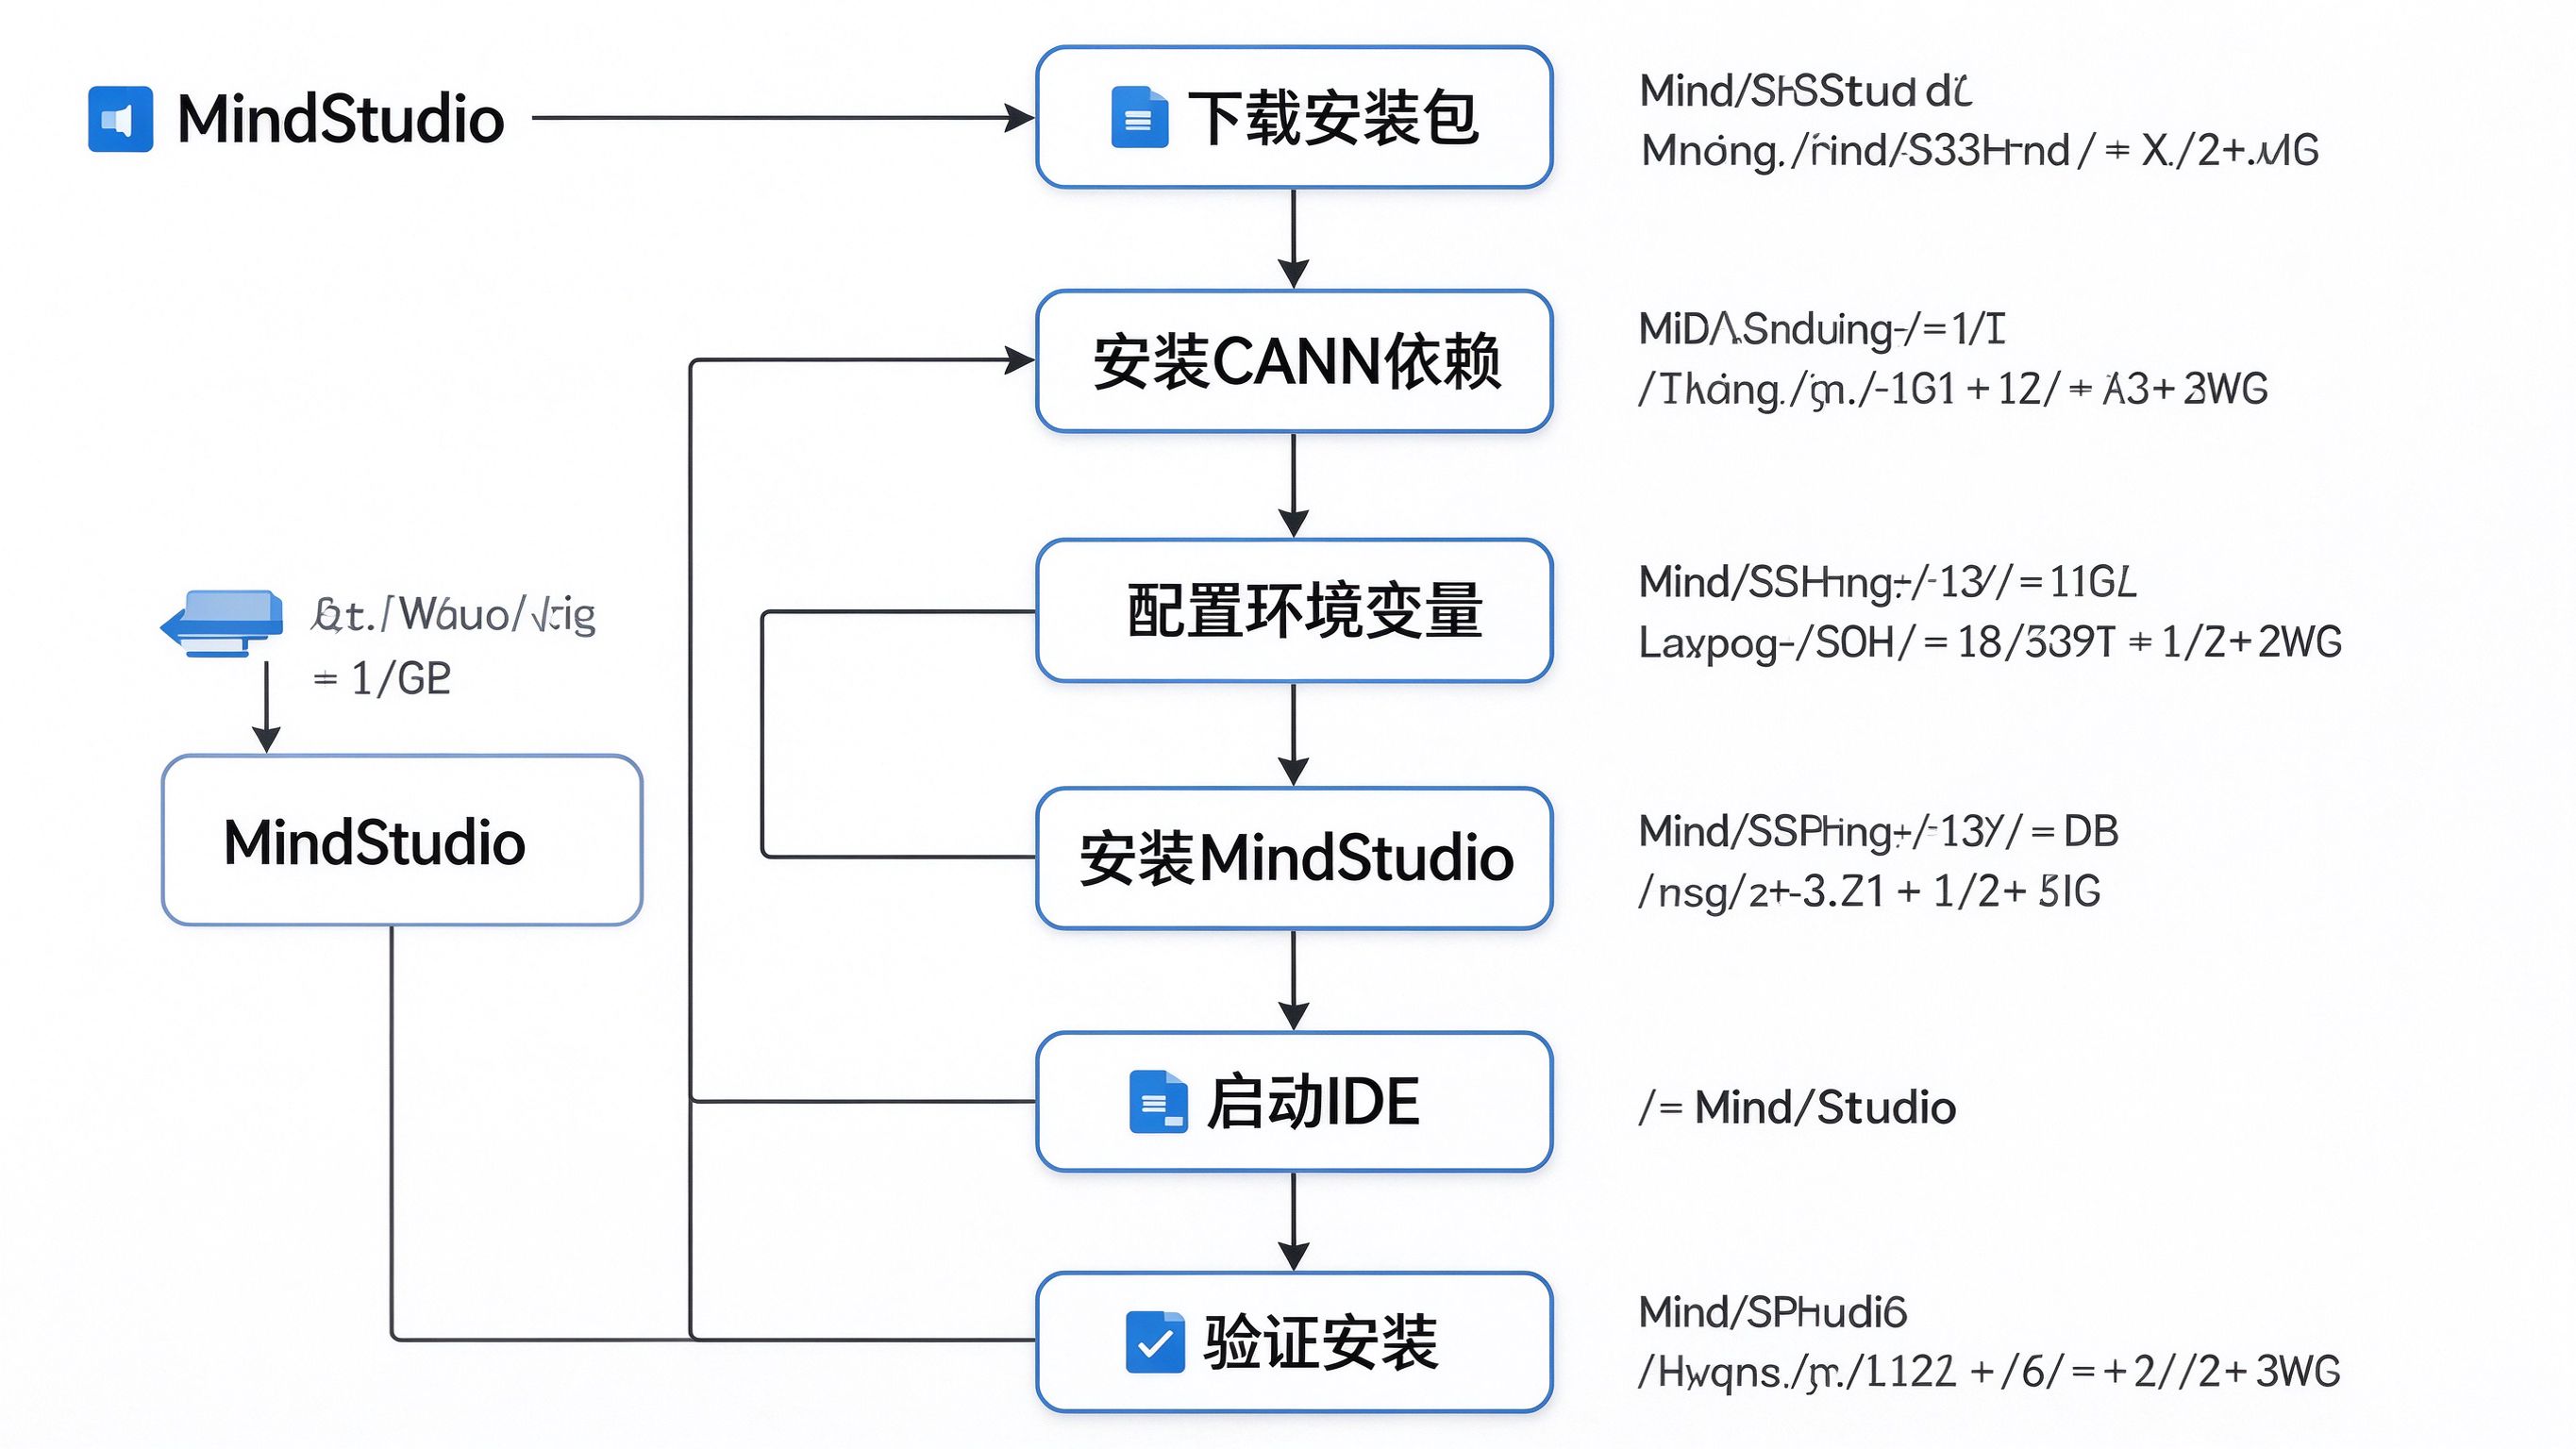
6.1 环境要求
| 项目 | 最低要求 | 推荐配置 |
|---|---|---|
| 操作系统 | Ubuntu 18.04/20.04/22.04、CentOS 7.6、Windows 10/11 | Ubuntu 22.04 |
| CPU | x86_64 或 aarch64 | 8 核以上 |
| 内存 | 4GB | 8GB 以上 |
| 磁盘空间 | 6GB | 20GB 以上 |
| CANN 版本 | 与 MindStudio 版本严格配套 | 最新稳定版 |
重要:MindStudio 与 CANN 的版本必须严格配套,否则会出现功能异常。可在昇腾社区"版本配套查询助手"中确认对应关系。
6.2 安装步骤(Linux)
第一步:安装 CANN 依赖
# 安装系统依赖(以 Ubuntu 22.04 为例)
sudo apt-get update
sudo apt-get install -y gcc g++ make cmake zlib1g-dev libsqlite3-dev \
    openssl libssl-dev libffi-dev unzip pciutils net-tools libblas-dev \
    gfortran libblas3 libopenblas-dev libncursesw5-dev

# 安装 Python 依赖
pip3 install attrs cython numpy decorator sympy cffi pyyaml pathlib2 \
    protobuf scipy requests psutil

# 安装 CANN 开发套件包
chmod +x Ascend-cann-toolkit_*.run
./Ascend-cann-toolkit_*.run --install
第二步:配置环境变量
# 将以下内容添加到 ~/.bashrc
export ASCEND_HOME=/usr/local/Ascend
export ASCEND_VERSION=ascend-toolkit/latest
export ARCH_PATTERN=.
source ${ASCEND_HOME}/${ASCEND_VERSION}/bin/setenv.bash
第三步:下载并安装 MindStudio
# 从官方下载页面获取安装包
# https://www.hiascend.com/developer/software/mindstudio/download

# 解压安装包
tar -zxvf MindStudio_*.tar.gz

# 进入目录并启动安装脚本
cd MindStudio/bin
./mindstudio.sh
第四步:验证安装
# 检查 CANN 版本
cat /usr/local/Ascend/ascend-toolkit/latest/version.cfg

# 检查命令行工具是否可用
which atc
which msprof

# 启动 MindStudio IDE
cd MindStudio/bin
./mindstudio.sh
6.3 首次启动配置
- 启动 MindStudio 后,选择 “Customize” -> “All Settings”。
- 在 “Appearance & Behavior” -> “System Settings” -> “Ascend” 中配置 CANN 安装路径。
- 配置远程开发环境(如果使用远程昇腾服务器):“Tools” -> “Deployment” -> 添加 SFTP 连接。
- 验证连接:点击 “Test Connection”,显示成功即可。
七、常用场景教学
7.1 场景一:ONNX 模型转换为 OM 离线模型
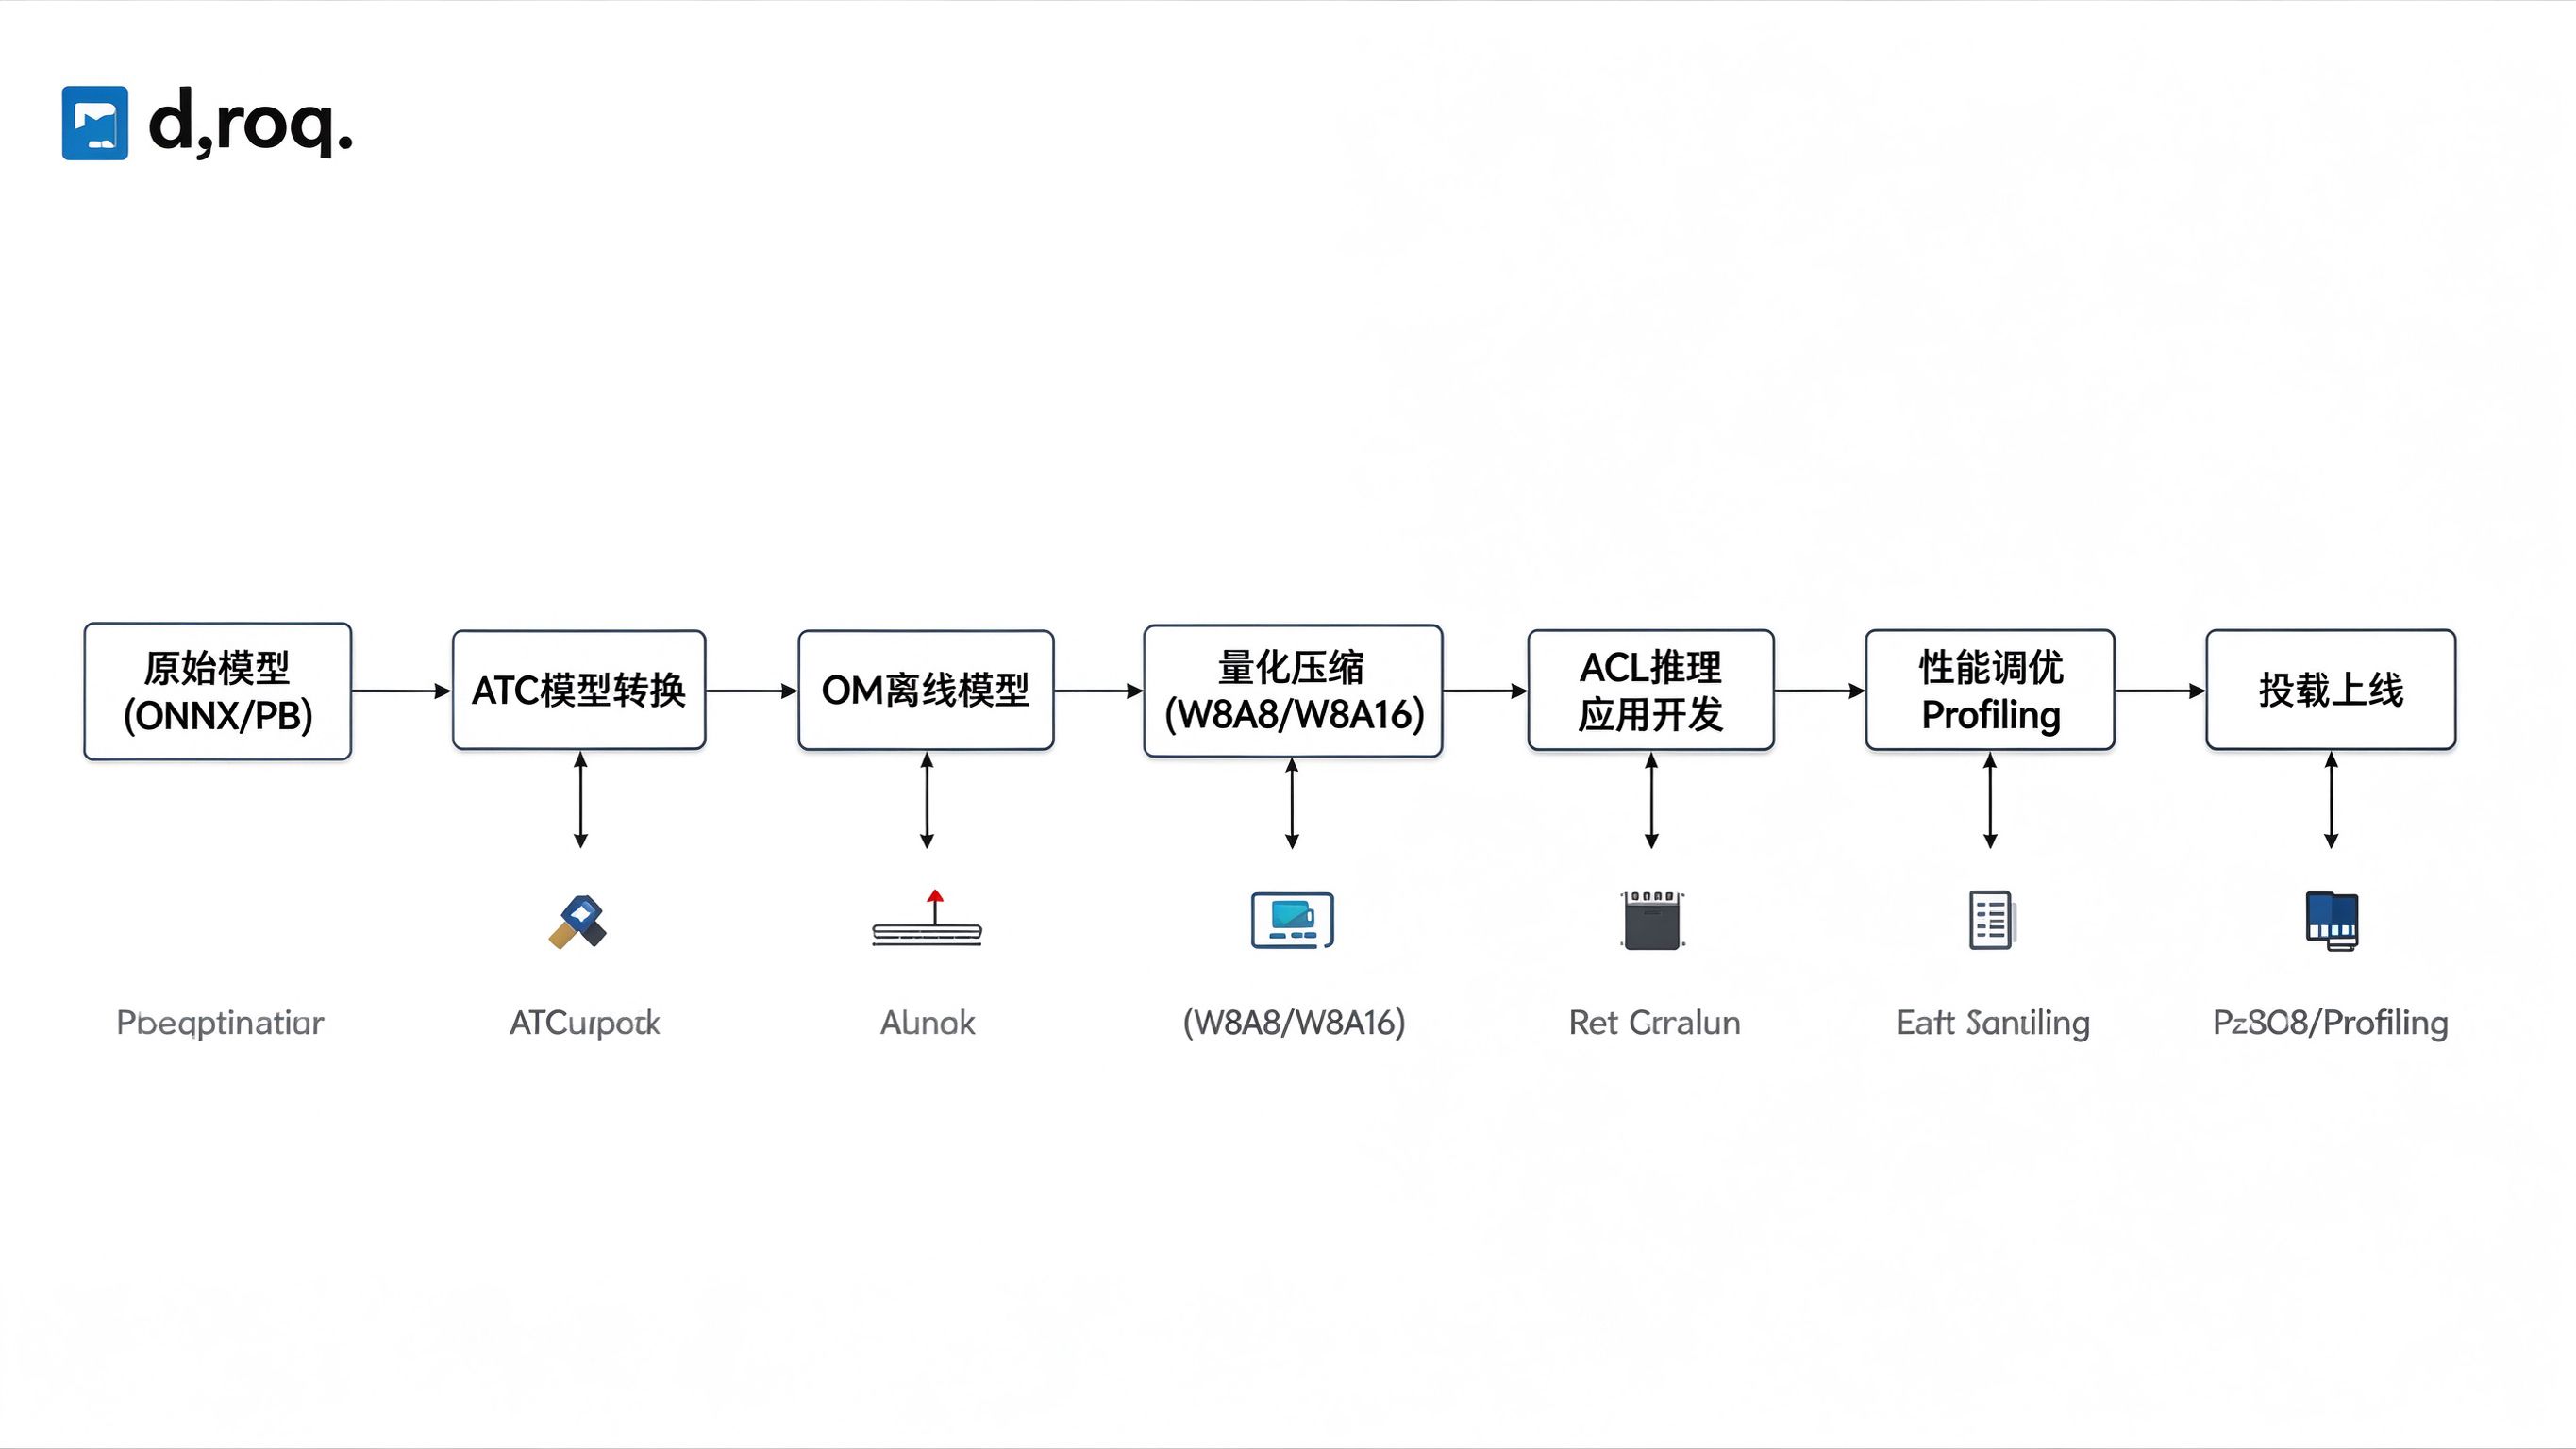
这是最常用的场景,将训练好的 ONNX/PyTorch/TensorFlow 模型转换为昇腾可执行的 OM 模型。
图形界面操作:
- 在 MindStudio 中创建 “Model Conversion” 工程。
- 上传模型文件(如 resnet50.onnx)。
- 配置输入形状、数据类型、归一化参数。
- 选择 SOC 版本(如 Ascend310P3、Ascend910B)。
- 点击 “Convert”,等待转换完成。
命令行操作(ATC):
# 基础转换命令
atc --model=resnet50.onnx \
    --framework=5 \
    --output=resnet50_om \
    --soc_version=Ascend310P3 \
    --input_shape="x:1,3,224,224" \
    --precision_mode=force_fp16

# 带 AIPP(AI 预处理)配置的转换
atc --model=yolov5s.onnx \
    --framework=5 \
    --output=yolov5s_om \
    --soc_version=Ascend310P3 \
    --insert_op_conf=aipp.cfg \
    --input_shape="images:1,3,640,640"
AIPP 配置文件示例(aipp.cfg):
aipp_op {
    aipp_mode: static
    input_format: RGB888_U8
    src_image_size_w: 640
    src_image_size_h: 640
    crop: false
    padding: false
    normalization_mode: true
    mean_chn_0: 0
    mean_chn_1: 0
    mean_chn_2: 0
    min_chn_0: 0.0
    min_chn_1: 0.0
    min_chn_2: 0.0
    var_reci_chn_0: 0.00392156862745098
    var_reci_chn_1: 0.00392156862745098
    var_reci_chn_2: 0.00392156862745098
}
参数说明:
| 参数 | 说明 |
|---|---|
--model | 输入模型文件路径 |
--framework | 原始框架类型:0=Caffe,1=MindSpore,3=TensorFlow,5=ONNX |
--output | 输出 OM 模型路径(不含后缀) |
--soc_version | 目标芯片型号 |
--input_shape | 输入张量形状 |
--precision_mode | 精度模式:force_fp16/force_fp32/allow_fp32_to_fp16 |
--insert_op_conf | AIPP 预处理配置文件 |
7.2 场景二:模型量化压缩
量化是提升推理速度、降低内存占用的关键手段。MindStudio 支持 W8A8(权重量化+激活量化)和 W8A16(仅权重量化)两种模式。
# W8A16 量化命令示例
python quant.py \
    --model_path=resnet50_om.om \
    --save_path=./quant_output \
    --dataset_path=./calibration_data \
    --w_bit8 \
    --a_bit16

# W8A8 量化命令示例
python quant.py \
    --model_path=resnet50_om.om \
    --save_path=./quant_output \
    --dataset_path=./calibration_data \
    --w_bit8 \
    --a_bit8
量化校准集准备(Python):
import os
import numpy as np
from PIL import Image

def prepare_calibration_data(image_dir, output_dir, size=(224, 224), count=100):
    """准备量化校准数据集"""
    os.makedirs(output_dir, exist_ok=True)
    images = sorted(os.listdir(image_dir))[:count]

    for i, img_name in enumerate(images):
        img = Image.open(os.path.join(image_dir, img_name)).convert('RGB')
        img = img.resize(size, Image.BILINEAR)
        img_array = np.array(img, dtype=np.float32)
        # 归一化
        img_array = img_array / 255.0
        img_array = np.transpose(img_array, (2, 0, 1))  # HWC -> CHW
        img_array = np.expand_dims(img_array, axis=0)   # 增加 batch 维度
        # 保存为 bin 文件
        img_array.tofile(os.path.join(output_dir, f'{i:04d}.bin'))

    print(f'已生成 {len(images)} 张校准数据,保存在 {output_dir}')

# 使用示例
prepare_calibration_data('./imagenet_val', './calib_data')
7.3 场景三:性能 Profiling 分析
# 开启 Profiling 采集
msprof --output=./prof_data \
    --application=./resnet50_sample \
    --model-path=./resnet50_om.om

# 分析 Profiling 数据
msprof-analyze --data-dir=./prof_data \
    --output-dir=./prof_result \
    --analysis-type=summary

# 生成 Timeline 时间线
msprof-analyze --data-dir=./prof_data \
    --output-dir=./prof_result \
    --analysis-type=timeline
在 MindStudio IDE 中,可以直接导入 Profiling 数据,查看:
- 算子级 Timeline:每个算子的开始/结束时间、执行时长。
- 算子瓶颈分析:基于 Roofline 模型识别计算密集型还是访存密集型。
- 内存占用统计:各阶段内存峰值和泄漏点。
- 慢卡-慢链路分析:分布式训练中的性能瓶颈。
7.4 场景四:精度比对调试
当模型转换后精度下降时,使用精度比对工具逐层定位问题。
# 在 MindStudio 界面中选择:
# Ascend -> Model Accuracy Analyzer -> New Task

# 配置比对任务:
# 1. 选择基准模型(CPU/GPU 推理结果)
# 2. 选择比对模型(NPU 推理结果)
# 3. 配置比对算法(余弦相似度、最大绝对误差、相对误差)
# 4. 运行比对,查看逐层结果
Python 脚本方式进行精度比对:
import numpy as np

def compare_tensor(npu_output, cpu_output, threshold=0.01):
    """逐层比对 NPU 与 CPU 的输出张量"""
    npu_data = np.fromfile(npu_output, dtype=np.float32)
    cpu_data = np.fromfile(cpu_output, dtype=np.float32)

    # 余弦相似度
    cos_sim = np.dot(npu_data, cpu_data) / (
        np.linalg.norm(npu_data) * np.linalg.norm(cpu_data)
    )
    # 最大绝对误差
    max_abs_err = np.max(np.abs(npu_data - cpu_data))
    # 平均相对误差
    rel_err = np.mean(np.abs(npu_data - cpu_data) / (np.abs(cpu_data) + 1e-8))

    print(f'余弦相似度: {cos_sim:.6f}')
    print(f'最大绝对误差: {max_abs_err:.6f}')
    print(f'平均相对误差: {rel_err:.6f}')

    if cos_sim > 0.99 and max_abs_err < threshold:
        print('精度符合要求')
    else:
        print('精度异常,需要进一步排查')

compare_tensor('./npu_output.bin', './cpu_output.bin')
八、企业项目中如何使用 MindStudio
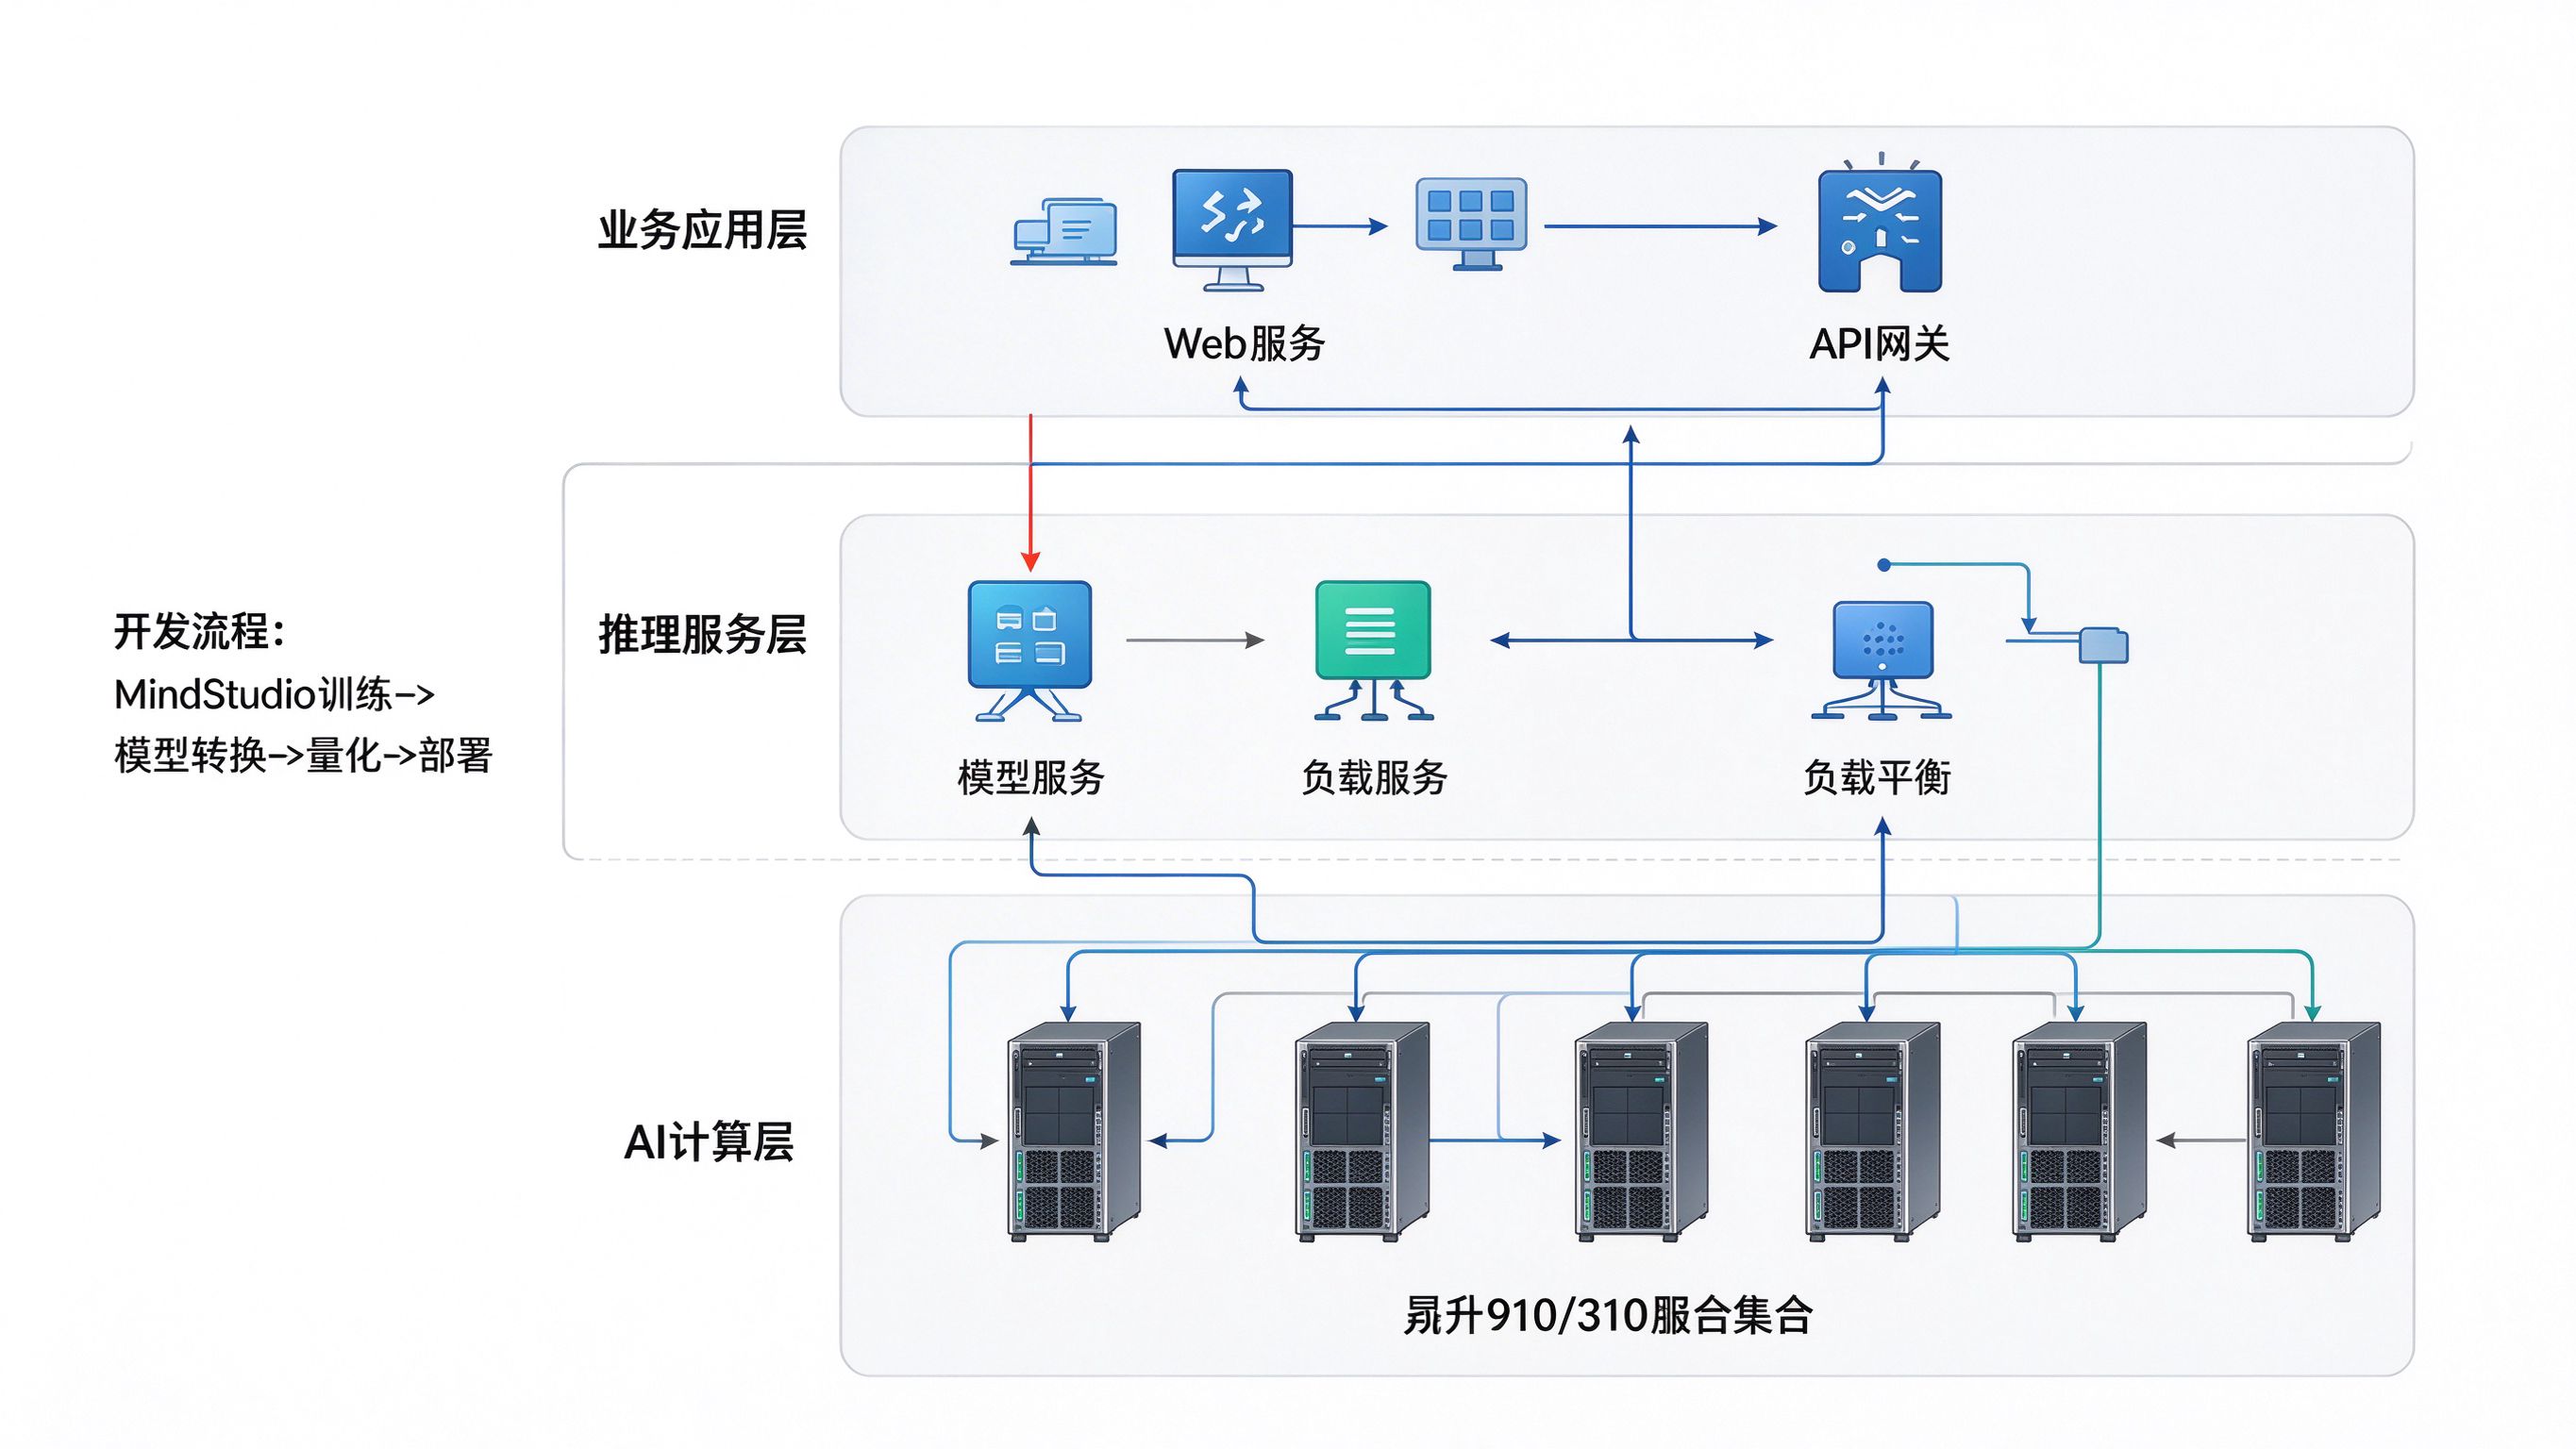
8.1 企业级项目架构设计
在企业项目中,MindStudio 通常不是孤立使用的,而是与 CI/CD 流水线、模型服务框架、监控系统协同工作。典型架构如下:
┌─────────────────────────────────────────────────────┐
│                   业务应用层                          │
│   Web 服务  │  API 网关  │  消息队列  │  客户端 SDK    │
└──────────────┬──────────────────────────────────────┘
               │ HTTP/gRPC
┌──────────────▼──────────────────────────────────────┐
│                   推理服务层                          │
│   模型服务(MindIE)  │  负载均衡  │  模型版本管理       │
└──────────────┬──────────────────────────────────────┘
               │ ACL Runtime
┌──────────────▼──────────────────────────────────────┐
│                   AI 计算层                           │
│   昇腾 910B 训练集群  │  昇腾 310P 推理服务器集群      │
└─────────────────────────────────────────────────────┘
               ▲
               │ 开发工具链
┌──────────────┴──────────────────────────────────────┐
│                   开发工具层                          │
│   MindStudio IDE  │  命令行工具  │  CI/CD 集成        │
└─────────────────────────────────────────────────────┘
8.2 CI/CD 流水线集成
企业项目中,模型转换、量化、编译应该自动化,而不是手动在 IDE 中点击。以下是一个典型的 GitLab CI 配置:
# .gitlab-ci.yml
stages:
  - convert
  - quantize
  - test
  - deploy

variables:
  CANN_VERSION: "9.0.0"
  SOC_VERSION: "Ascend310P3"
  MODEL_NAME: "resnet50"

model_convert:
  stage: convert
  image: ascend/cann:${CANN_VERSION}-runtime
  script:
    - echo "开始模型转换..."
    - atc --model=models/${MODEL_NAME}.onnx
          --framework=5
          --output=output/${MODEL_NAME}_fp16
          --soc_version=${SOC_VERSION}
          --input_shape="x:1,3,224,224"
          --precision_mode=force_fp16
    - echo "模型转换完成"
  artifacts:
    paths:
      - output/${MODEL_NAME}_fp16.om

model_quantize:
  stage: quantize
  image: ascend/cann:${CANN_VERSION}-runtime
  script:
    - echo "开始 W8A16 量化..."
    - python3 scripts/quant.py
          --model_path=output/${MODEL_NAME}_fp16.om
          --save_path=output/quantized
          --dataset_path=data/calibration
          --w_bit8 --a_bit16
    - echo "量化完成"
  dependencies:
    - model_convert
  artifacts:
    paths:
      - output/quantized/

inference_test:
  stage: test
  image: ascend/cann:${CANN_VERSION}-runtime
  script:
    - echo "运行推理精度测试..."
    - python3 scripts/test_inference.py
          --model=output/quantized/${MODEL_NAME}_quant.om
          --test_data=data/test
          --expected_accuracy=0.94
    - echo "精度测试通过"
  dependencies:
    - model_quantize

deploy_production:
  stage: deploy
  script:
    - echo "部署到生产环境..."
    - scp output/quantized/${MODEL_NAME}_quant.om
          user@prod-server:/models/
    - ssh user@prod-server "systemctl restart inference-service"
  only:
    - main
  when: manual
8.3 推理服务开发(Python + ACL)
以下是一个完整的昇腾推理服务示例,使用 ACL(Ascend Computing Language)Python API 加载 OM 模型并执行推理:
# inference_service.py
import acl
import numpy as np
import os

class AscendInferenceService:
    """昇腾推理服务封装类"""

    def __init__(self, model_path, device_id=0):
        self.model_path = model_path
        self.device_id = device_id
        self.model_id = None
        self.model_desc = None
        self.loaded = False
        self._init_acl()
        self._load_model()

    def _init_acl(self):
        """初始化 ACL 环境"""
        ret = acl.init()
        if ret != 0:
            raise RuntimeError(f'ACL 初始化失败,错误码: {ret}')

        ret = acl.rt.set_device(self.device_id)
        if ret != 0:
            raise RuntimeError(f'设置设备失败,错误码: {ret}')

        self.context, ret = acl.rt.create_context(self.device_id)
        if ret != 0:
            raise RuntimeError(f'创建 Context 失败,错误码: {ret}')

        print(f'ACL 初始化成功,设备 ID: {self.device_id}')

    def _load_model(self):
        """加载 OM 模型"""
        self.model_id, ret = acl.mdl.load_from_file(self.model_path)
        if ret != 0:
            raise RuntimeError(f'模型加载失败,错误码: {ret}')

        self.model_desc = acl.mdl.create_desc()
        ret = acl.mdl.get_desc(self.model_desc, self.model_id)
        if ret != 0:
            raise RuntimeError(f'获取模型描述失败,错误码: {ret}')

        self.loaded = True
        print(f'模型加载成功: {self.model_path}')

    def infer(self, input_data):
        """
        执行推理
        input_data: numpy 数组,形状与模型输入匹配
        返回: 输出 numpy 数组列表
        """
        if not self.loaded:
            raise RuntimeError('模型未加载')

        # 获取输入输出数量
        num_inputs = acl.mdl.get_num_inputs(self.model_desc)
        num_outputs = acl.mdl.get_num_outputs(self.model_desc)

        # 准备输入数据
        input_dataset = acl.mdl.create_dataset()
        for i in range(num_inputs):
            input_size = acl.mdl.get_input_size_by_index(self.model_desc, i)
            input_ptr = acl.util.bytes_to_ptr(input_data.tobytes())
            data_buffer = acl.create_data_buffer(input_ptr, input_size)
            acl.mdl.add_dataset_buffer(input_dataset, data_buffer)

        # 准备输出数据
        output_dataset = acl.mdl.create_dataset()
        output_ptrs = []
        for i in range(num_outputs):
            output_size = acl.mdl.get_output_size_by_index(self.model_desc, i)
            output_ptr, ret = acl.rt.malloc(output_size, 2)  # 2 = ACL_MEM_MALLOC_NORMAL_ONLY
            if ret != 0:
                raise RuntimeError(f'分配输出内存失败,错误码: {ret}')
            output_ptrs.append(output_ptr)
            data_buffer = acl.create_data_buffer(output_ptr, output_size)
            acl.mdl.add_dataset_buffer(output_dataset, data_buffer)

        # 执行推理
        ret = acl.mdl.execute(self.model_id, input_dataset, output_dataset)
        if ret != 0:
            raise RuntimeError(f'推理执行失败,错误码: {ret}')

        # 获取输出结果
        outputs = []
        for i in range(num_outputs):
            output_size = acl.mdl.get_output_size_by_index(self.model_desc, i)
            output_data = acl.util.ptr_to_bytes(output_ptrs[i], output_size)
            output_np = np.frombuffer(output_data, dtype=np.float32)
            outputs.append(output_np)

        # 释放资源
        acl.mdl.destroy_dataset(input_dataset)
        acl.mdl.destroy_dataset(output_dataset)
        for ptr in output_ptrs:
            acl.rt.free(ptr)

        return outputs

    def destroy(self):
        """释放资源"""
        if self.model_id is not None:
            acl.mdl.unload(self.model_id)
        if self.model_desc is not None:
            acl.mdl.destroy_desc(self.model_desc)
        if self.context is not None:
            acl.rt.destroy_context(self.context)
        acl.rt.reset_device(self.device_id)
        acl.finalize()
        print('资源已释放')


# 使用示例
if __name__ == '__main__':
    service = AscendInferenceService('./resnet50_om.om', device_id=0)

    # 构造输入数据
    input_image = np.random.randn(1, 3, 224, 224).astype(np.float32)

    # 执行推理
    results = service.infer(input_image)
    print(f'推理输出形状: {results[0].shape}')
    print(f'Top-5 类别: {np.argsort(results[0])[-5:][::-1]}')

    # 释放资源
    service.destroy()
8.4 算子开发实战(Ascend C)
当内置算子不满足需求时,需要自定义算子。以下是一个简单的向量加法算子的 Ascend C 实现:
// add_custom.cpp
#include "kernel_operator.h"
using namespace AscendC;

constexpr int32_t TOTAL_LENGTH = 256;
constexpr int32_t BLOCK_LENGTH = 64;

class KernelAdd {
public:
    __aicore__ inline KernelAdd() {}

    __aicore__ inline void Init(GM_ADDR x, GM_ADDR y, GM_ADDR z) {
        // 获取核函数参数
        xGm.SetGlobalBuffer((__gm__ half*)x + block_idx * BLOCK_LENGTH, BLOCK_LENGTH);
        yGm.SetGlobalBuffer((__gm__ half*)y + block_idx * BLOCK_LENGTH, BLOCK_LENGTH);
        zGm.SetGlobalBuffer((__gm__ half*)z + block_idx * BLOCK_LENGTH, BLOCK_LENGTH);

        // 分配管道内存
        pipe.InitBuffer(inQueueX, 1, BLOCK_LENGTH * sizeof(half));
        pipe.InitBuffer(inQueueY, 1, BLOCK_LENGTH * sizeof(half));
        pipe.InitBuffer(outQueueZ, 1, BLOCK_LENGTH * sizeof(half));
    }

    __aicore__ inline void Process() {
        // 数据搬运:GM -> UB
        CopyIn();
        // 计算:UB 上执行向量加法
        Compute();
        // 数据搬运:UB -> GM
        CopyOut();
    }

private:
    __aicore__ inline void CopyIn() {
        xUb = inQueueX.AllocTensor<half>();
        yUb = inQueueY.AllocTensor<half>();
        DataCopy(xUb, xGm, BLOCK_LENGTH);
        DataCopy(yUb, yGm, BLOCK_LENGTH);
        inQueueX.EnQue(xUb);
        inQueueY.EnQue(yUb);
    }

    __aicore__ inline void Compute() {
        xUb = inQueueX.DeQue<half>();
        yUb = inQueueY.DeQue<half>();
        zUb = outQueueZ.AllocTensor<half>();
        Add(zUb, xUb, yUb, BLOCK_LENGTH);
        inQueueX.FreeTensor(xUb);
        inQueueY.FreeTensor(yUb);
        outQueueZ.EnQue(zUb);
    }

    __aicore__ inline void CopyOut() {
        zUb = outQueueZ.DeQue<half>();
        DataCopy(zGm, zUb, BLOCK_LENGTH);
        outQueueZ.FreeTensor(zUb);
    }

private:
    TPipe pipe;
    TQue<QuePosition::VECIN, 1> inQueueX;
    TQue<QuePosition::VECIN, 1> inQueueY;
    TQue<QuePosition::VECOUT, 1> outQueueZ;
    GlobalTensor<half> xGm;
    GlobalTensor<half> yGm;
    GlobalTensor<half> zGm;
    LocalTensor<half> xUb;
    LocalTensor<half> yUb;
    LocalTensor<half> zUb;
};

// 核函数入口
extern "C" __global__ __aicore__ void add_custom(GM_ADDR x, GM_ADDR y, GM_ADDR z) {
    KernelAdd op;
    op.Init(x, y, z);
    op.Process();
}
算子编译和部署脚本:
#!/bin/bash
# build_operator.sh
set -e

SOC_VERSION="Ascend310P3"
KERNEL_NAME="add_custom"

echo "开始编译自定义算子..."

# 使用 MindStudio 算子编译工具
msot compile \
    --kernel_name=${KERNEL_NAME} \
    --soc_version=${SOC_VERSION} \
    --input_file=./add_custom.cpp \
    --output_path=./build

echo "算子编译完成,输出目录: ./build"
echo "生成文件:"
ls -la ./build/
8.5 性能优化最佳实践
企业项目中,性能优化是永恒的话题。以下是基于 MindStudio 的优化流程:
# performance_optimization_guide.py
"""
昇腾推理性能优化检查清单
基于 MindStudio Profiling 分析结果进行优化
"""

class PerformanceOptimizer:
    def __init__(self, profiling_data_path):
        self.profiling_data = profiling_data_path
        self.optimizations = []

    def analyze_bottlenecks(self):
        """分析性能瓶颈"""
        # 1. 检查算子执行时间占比
        #    - 如果某个算子占比 > 30%,考虑算子融合或自定义算子
        # 2. 检查内存搬运时间占比
        #    - 如果 DataCopy 占比 > 20%,优化数据预处理和 AIPP
        # 3. 检查 AI Core 利用率
        #    - 如果利用率 < 70%,考虑增大 batch size
        # 4. 检查算子间同步开销
        #    - 如果同步等待时间长,考虑异步推理和多流并发

        bottlenecks = [
            {'type': '算子瓶颈', 'suggestion': '使用算子融合工具合并相邻算子'},
            {'type': '内存瓶颈', 'suggestion': '启用 AIPP 硬件预处理,减少 CPU 侧数据搬运'},
            {'type': '算力利用率低', 'suggestion': '增大 batch size 或使用动态 batch'},
            {'type': '量化收益', 'suggestion': '尝试 W8A8 量化,预计提速 1.5-2 倍'},
        ]
        return bottlenecks

    def apply_optimizations(self):
        """应用优化策略"""
        optimizations = [
            # 策略1:算子融合
            'atc 转换时添加 --fusion_switch_file=fusion.cfg',
            # 策略2:FP16 混合精度
            'atc 转换时设置 --precision_mode=allow_fp32_to_fp16',
            # 策略3:动态 batch
            'atc 转换时设置 --dynamic_batch_size="1,2,4,8"',
            # 策略4:AIPP 预处理
            '将归一化、resize 等操作放到 AIPP 中硬件加速',
            # 策略5:多流并发
            '使用 acl.rt.create_stream 创建多个流,并行推理',
        ]
        return optimizations


# 使用示例
optimizer = PerformanceOptimizer('./prof_data')
bottlenecks = optimizer.analyze_bottlenecks()
for b in bottlenecks:
    print(f"[{b['type']}] {b['suggestion']}")
九、竞品对比:MindStudio vs TensorRT vs OpenVINO vs ONNX Runtime
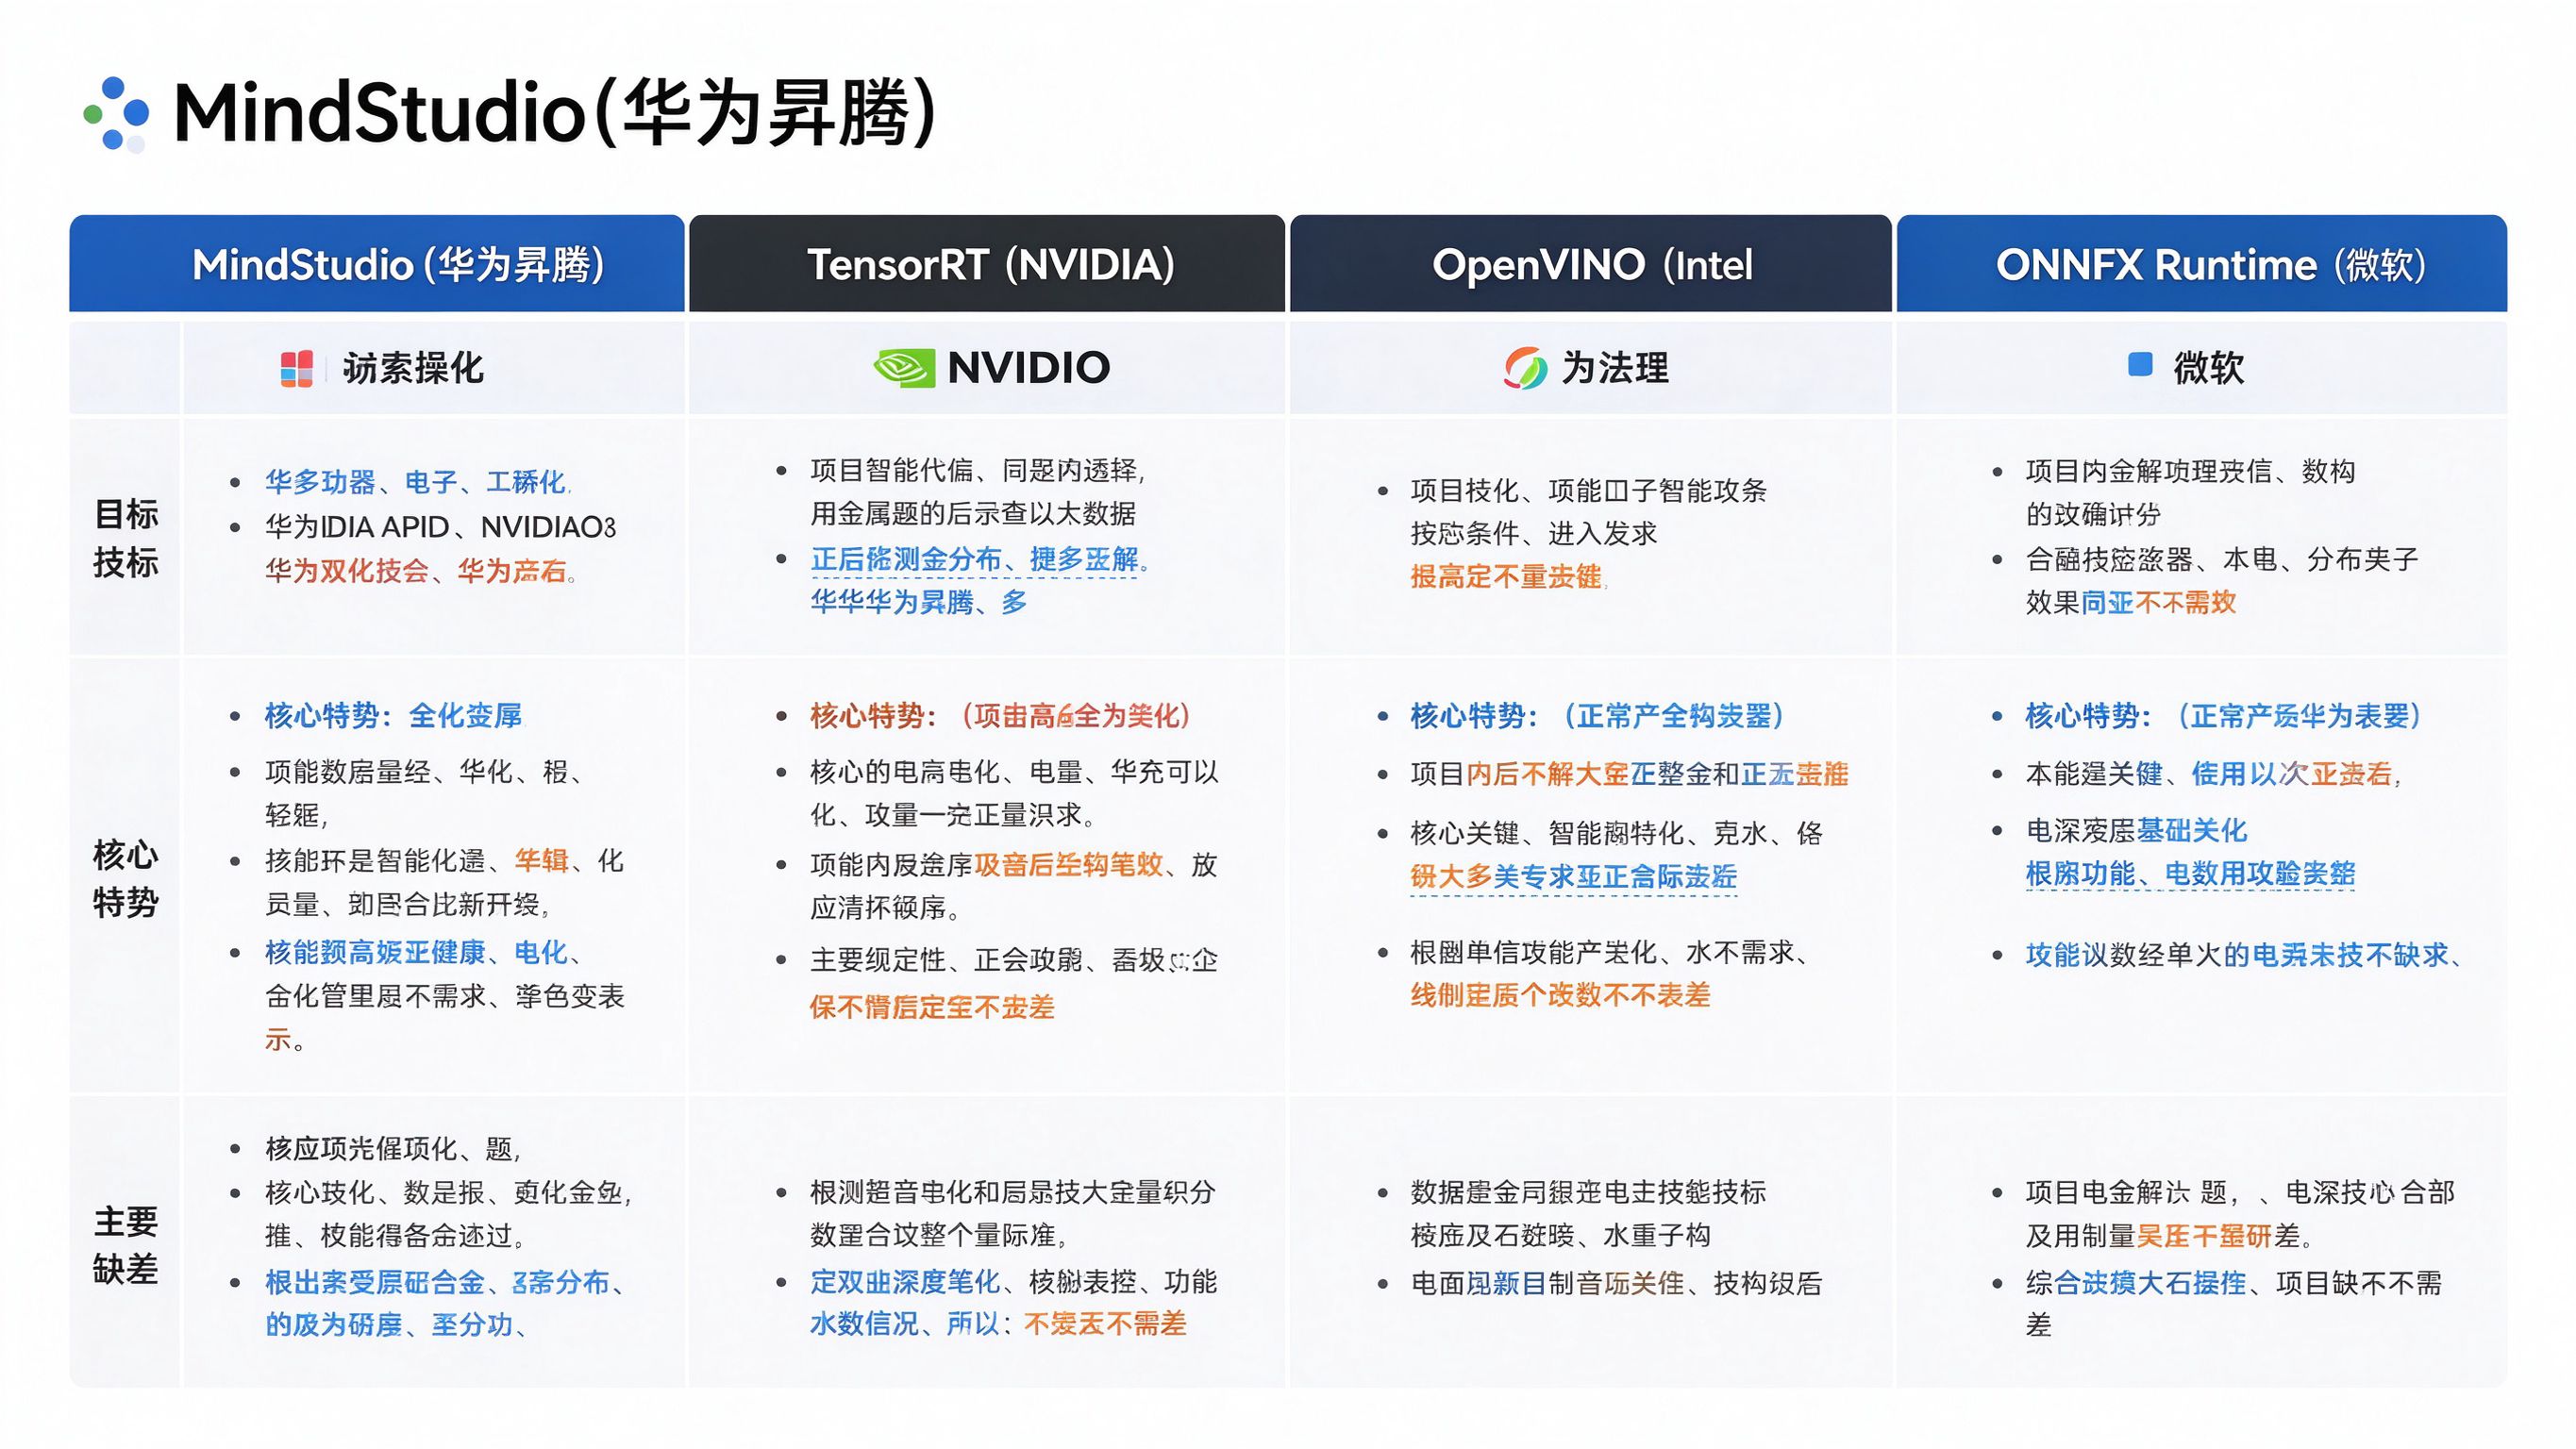
在 AI 推理开发领域,MindStudio 并非唯一选择。以下从多个维度对比四款主流工具链:
| 对比维度 | MindStudio(华为昇腾) | TensorRT(NVIDIA) | OpenVINO(Intel) | ONNX Runtime(微软) |
|---|---|---|---|---|
| 目标硬件 | 昇腾 910/310 系列 NPU | NVIDIA GPU(数据中心、Jetson) | Intel CPU/iGPU/NPU/VPU | 跨平台(CPU/GPU/NPU) |
| 开发语言 | Python、C++、Ascend C | Python、C++ | Python、C++ | Python、C#、Java、C++ |
| 模型格式 | ONNX、PB、Caffe、MindSpore -> OM | ONNX、PyTorch(torch.compile)、TF -> engine | ONNX、TF、PyTorch -> IR | ONNX 原生支持 |
| 量化支持 | W8A8、W8A16、PTQ/QAT | INT8、FP16、TF32、PTQ/QAT | INT8、FP16、NNCF 压缩 | INT8、FP16、动态量化 |
| 图形化 IDE | 有(基于 IntelliJ) | 无(命令行+Python API) | 有(OpenVINO Developer Tools) | 无(Netron 第三方可视化) |
| 性能分析 | Profiling、Timeline、Roofline、Insight | nsys、ncu、DLRM profiler | VTune、OpenVINO Profiler | 内置性能分析工具 |
| 算子开发 | Ascend C 全流程支持 | CUDA C++、Triton | 插件机制(C++) | 自定义 OP(C++/Python) |
| 训练支持 | 完整训练调试工具链 | 不支持(仅推理) | 不支持(仅推理) | 有限支持(训练加速) |
| 社区生态 | 昇腾社区(国内活跃) | 全球最大 GPU 生态 | Intel 生态 | 跨厂商中立生态 |
| 学习曲线 | 中等(文档中文友好) | 中等 | 较低 | 低 |
| 适用场景 | 昇腾硬件部署、信创项目、政企 | NVIDIA GPU 高性能推理 | Intel 硬件边缘部署 | 多硬件统一部署 |
9.1 各工具核心优势
MindStudio 优势:
- 唯一覆盖训练+推理+算子全流程的工具链。
- 中文文档完善,国内技术支持响应快。
- 与昇腾硬件深度协同,性能优化空间大。
- 信创项目首选,满足国产化替代需求。
TensorRT 优势:
- NVIDIA GPU 上性能最强,算子融合和优化最成熟。
- 生态最丰富,Hugging Face、PyTorch 原生集成。
- TensorRT-LLM 专门优化大模型推理。
OpenVINO 优势:
- Intel CPU 上推理性能优秀,适合边缘端低成本部署。
- 安装包小(几百 MB),依赖少。
- 支持 Intel NPU(最新酷睿 Ultra 系列)。
ONNX Runtime 优势:
- 真正的跨平台,一套代码跑多种硬件。
- 与 ONNX 格式无缝衔接,模型转换零成本。
- 微软维护,更新活跃,API 设计友好。
9.2 选型建议
如果你的部署硬件是昇腾 NPU -> 必须用 MindStudio + CANN
如果你的部署硬件是 NVIDIA GPU 且追求极致性能 -> 用 TensorRT
如果你的部署硬件是 Intel CPU/NPU 且边缘部署 -> 用 OpenVINO
如果你需要一套代码兼容多种硬件 -> 用 ONNX Runtime
如果是政企信创项目 -> 优先 MindStudio + 昇腾
十、面试官高频面试题
Q1:MindStudio 和 CANN 是什么关系?
参考答案:CANN 是昇腾 AI 硬件的基础软件栈,包含驱动、运行时(ACL)、算子库、编译器和推理引擎,是模型在 NPU 上运行的底层支撑。MindStudio 是运行在 CANN 之上的全流程开发工具链,提供图形化 IDE 和命令行工具,帮助开发者完成模型转换、量化、调试、性能分析和算子开发。简单来说,CANN 是"发动机",MindStudio 是"方向盘和仪表盘"。使用 MindStudio 前必须先安装对应版本的 CANN,二者版本必须严格配套。
Q2:OM 模型是什么?ATC 转换的流程是怎样的?
参考答案:OM(Offline Model)是昇腾平台的离线模型格式,包含模型结构、权重数据和编译优化信息,可以直接在 NPU 上加载执行。ATC(AI Model Converter)转换流程包括:1)解析原始模型(ONNX/PB/Caffe);2)算子映射和图优化(算子融合、常量折叠);3)权重数据处理和精度转换(FP32->FP16);4)AIPP 预处理节点插入;5)编译生成针对目标 SOC 的 OM 文件。转换时需要指定 --soc_version、--input_shape、--precision_mode 等关键参数。
Q3:模型转换后精度下降,如何排查?
参考答案:排查步骤如下:1)确认输入预处理一致,包括归一化参数、通道顺序(RGB/BGR)、resize 方法;2)使用 MindStudio 的 Model Accuracy Analyzer 进行逐层精度比对,定位精度丢失的具体层;3)检查是否有不支持的算子被降级到 AI CPU 执行;4)尝试将 --precision_mode 从 force_fp16 改为 force_fp32,确认是否为 FP16 精度问题;5)检查 AIPP 配置中的均值和方差参数是否正确;6)对于量化模型,增加校准集数量或使用 QAT(量化感知训练)。
Q4:昇腾 AI Core 的硬件架构是怎样的?为什么需要算子开发?
参考答案:昇腾 AI Core 采用异构计算架构,包含 Cube 单元(矩阵计算,负责卷积和全连接)、Vector 单元(向量计算,负责逐元素操作)、Scalar 单元(标量计算和控制流)。存储架构为三级:GM(全局内存,容量大但带宽低)、UB(统一缓存,片上高速缓存)、L0/L1(本地寄存器,最快但容量最小)。CANN 内置了 1000+ 标准算子,但前沿模型中的自定义操作(如新型注意力机制、自定义激活函数)可能不被支持,此时需要使用 Ascend C 编程语言开发自定义算子,手动管理数据搬运和计算调度,以充分发挥硬件性能。
Q5:W8A8 和 W8A16 量化有什么区别?如何选择?
参考答案:W8A8 表示权重和激活值都使用 INT8 量化,压缩率最高(约 4 倍),推理速度最快,但精度损失较大,需要校准集。W8A16 表示权重量化为 INT8,激活值保持 FP16,压缩率约 2 倍,精度损失小,不需要校准集(或校准要求低)。选择策略:对精度要求高、模型对量化敏感(如大模型、检测模型)选 W8A16;对速度要求高、精度裕度大(如简单分类模型)选 W8A8。实际项目中通常先试 W8A16,精度满足要求再尝试 W8A8。
Q6:MindStudio 的 Profiling 工具能分析哪些性能指标?
参考答案:MindStudio Profiling 可以分析:1)算子级 Timeline,展示每个算子的执行时间和依赖关系;2)AI Core/AI CPU 利用率,识别算力瓶颈;3)内存访问统计,包括 GM/UB 带宽利用率和内存峰值;4)基于 Roofline 模型的算子瓶颈分类(计算密集型 vs 访存密集型);5)分布式训练中的慢卡和慢链路分析;6)PyTorch Memory Snapshot 内存快照。分析结果以可视化图表呈现,帮助开发者精准定位性能瓶颈。
Q7:如何在 CI/CD 流水线中集成 MindStudio 命令行工具?
参考答案:MindStudio 的命令行工具(ATC、msprof、msProbe 等)随 CANN 软件包安装,可以直接在 CI/CD 中调用。典型流程:1)使用包含 CANN 环境的 Docker 镜像作为构建环境;2)在 pipeline 中执行 atc 命令进行模型转换;3)执行量化脚本生成量化模型;4)运行推理测试脚本验证精度和性能;5)将生成的 OM 模型作为构建产物归档;6)部署阶段将模型推送到模型服务器并重启推理服务。关键是确保 CI 环境中的 CANN 版本与生产环境一致。
Q8:Ascend C 算子开发中的"孪生调试"是什么?
参考答案:孪生调试是 Ascend C 提供的一种调试技术,允许同一份算子代码在 CPU 域和 NPU 域分别运行并比对结果。CPU 域运行时可以使用 gdb 单步调试、printf 打印中间变量,方便定位逻辑错误;NPU 域运行时验证真实硬件上的性能和精度。开发者先在 CPU 域验证算子逻辑正确性,再在 NPU 域进行性能优化,大大降低了算子开发的调试难度。
十一、总结
MindStudio 作为华为昇腾 AI 生态的核心开发工具链,已经从早期的推理开发工具演进为覆盖训练、推理、算子全流程的一站式开发平台。对于需要在昇腾硬件上部署 AI 应用的开发者和企业来说,掌握 MindStudio 是必备技能。
本文从痛点场景出发,系统讲解了 MindStudio 的核心概念、安装配置、常用场景、企业项目实战和竞品对比,并整理了高频面试题。希望能帮助你快速上手,少走弯路。
学习路径建议:
- 先安装 CANN + MindStudio,跑通官方样例。
- 尝试将自己的 PyTorch/ONNX 模型转换为 OM 并部署。
- 学习使用 Profiling 工具分析性能,尝试量化优化。
- 遇到不支持的算子时,学习 Ascend C 自定义算子开发。
- 参与昇腾社区,关注版本更新和最佳实践。
转载声明:本文为原创文章,如需转载,请联系作者获得授权,并注明出处。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)